

Jalankan dan edit kode dari Tutorial ini secara online
Jalankan kode| date | language | ex_complete | |
|---|---|---|---|
| 0 | 2017-01-01 | python | 6 |
| 1 | 2017-01-02 | python | 5 |
| 2 | 2017-01-03 | python | 10 |
Anda dapat melihat Index di sisi kiri DataFrame dan bahwa index tersebut terdiri atas bilangan bulat. Ini adalah RangeIndex:
# Check out index
df.index
RangeIndex(start=0, stop=3, step=1)
Kita dapat menggunakan indeks ini untuk mengambil satu atau beberapa baris dari df:
# Slice and dice data
df.loc[:1]
| date | language | ex_complete | |
|---|---|---|---|
| 0 | 2017-01-01 | python | 6 |
| 1 | 2017-01-02 | python | 5 |
Namun, indeks ini tidak begitu informatif. Jika Anda akan memberi label pada baris-baris DataFrame, akan lebih baik jika label tersebut bermakna, jika memungkinkan. Dapatkah Anda melakukannya dengan dataset ini? Cara berpikir yang baik tentang tantangan ini adalah Anda menginginkan pengenal yang unik dan bermakna untuk setiap baris. Periksa kolom-kolomnya dan lihat apakah ada yang memenuhi kriteria ini. Perhatikan bahwa kolom date berisi tanggal yang unik sehingga masuk akal untuk memberi label setiap baris berdasarkan kolom tanggal. Artinya, Anda dapat menjadikan kolom date sebagai indeks DataFrame menggunakan metode .set_index() (catatan: inplace=True berarti Anda benar-benar mengubah DataFrame df secara langsung):
# Set new index
df.set_index(pd.DatetimeIndex(df['date']), inplace=True)
df
| date | language | ex_complete | |
|---|---|---|---|
| date | |||
| 2017-01-01 | 2017-01-01 | python | 6 |
| 2017-01-02 | 2017-01-02 | python | 5 |
| 2017-01-03 | 2017-01-03 | python | 10 |
Ini kemudian memberi df sebuah DateTimeIndex:
# Check out new index
df.index
DatetimeIndex(['2017-01-01', '2017-01-02', '2017-01-03'], dtype='datetime64[ns]', name='date', freq=None)
Sekarang Anda dapat mengambil baris menggunakan DateTimeIndex yang telah dibuat:
# Slice and dice data w/ new index
df.loc['2017-01-02']
date 2017-01-02
language python
ex_complete 5
Name: 2017-01-02 00:00:00, dtype: object
Perhatikan juga bahwa atribut .columns mengembalikan sebuah indeks yang berisi nama kolom dari df:
# Check out columns
df.columns
Index(['date', 'language', 'ex_complete'], dtype='object')
Ini bisa sedikit membingungkan karena ini menyatakan bahwa df.columns bertipe Index. Ini bukan berarti kolom-kolom tersebut adalah indeks DataFrame. Indeks dari df selalu diberikan oleh df.index. Lihat tutorial pandas DataFrames kami untuk mempelajari lebih lanjut tentang indeks. Sekarang saatnya berkenalan dengan indeks hierarkis.
Multi-index pada pandas DataFrame
Bagaimana jika kita memiliki beberapa bahasa dalam dataset kita, seperti yang ada di DataCamp? Coba lihat:
# Import and check out data
df = pd.read_csv('data/user_ex.csv')
df
| date | language | ex_complete | |
|---|---|---|---|
| 0 | 2017-01-01 | python | 6 |
| 1 | 2017-01-02 | python | 5 |
| 2 | 2017-01-03 | python | 10 |
| 3 | 2017-01-01 | r | 8 |
| 4 | 2017-01-02 | r | 8 |
| 5 | 2017-01-03 | r | 8 |
Setiap tanggal kini berkorelasi dengan beberapa baris, satu untuk tiap bahasa. Lihat, misalnya, bahwa tanggal '2017-01-02' muncul pada baris 1 dan 4, masing-masing untuk bahasa Python dan R. Dengan demikian tanggal tidak lagi secara unik menentukan baris. Namun, 'date' dan 'language' secara bersama-sama memang menentukan baris secara unik. Karena itu, kita gunakan keduanya sebagai indeks:
# Set index
df.set_index(['date', 'language'], inplace=True)
df
| ex_complete | ||
|---|---|---|
| date | language | |
| 2017-01-01 | python | 6 |
| 2017-01-02 | python | 5 |
| 2017-01-03 | python | 10 |
| 2017-01-01 | r | 8 |
| 2017-01-02 | r | 8 |
| 2017-01-03 | r | 8 |
Anda kini telah membuat multi-index, atau indeks hierarkis (biasakan diri dengan kedua istilah ini karena keduanya digunakan secara bergantian), dan Anda dapat melihatnya dengan memeriksa indeks sebagai berikut:
# Check out multi-index
df.index
MultiIndex(levels=[['2017-01-01', '2017-01-02', '2017-01-03'], ['python', 'r']],
labels=[[0, 1, 2, 0, 1, 2], [0, 0, 0, 1, 1, 1]],
names=['date', 'language'])
Hal di atas memberi tahu Anda bahwa DataFrame df kini memiliki MultiIndex dengan dua level, yang pertama berdasarkan tanggal, yang kedua berdasarkan bahasa. Ingat bahwa sebelumnya Anda dapat mengambil potongan DataFrame menggunakan indeks dan aksesori .loc: df.loc['2017-01-02']. Untuk dapat melakukan slicing dengan multi-index, Anda perlu mengurutkan indeks terlebih dahulu:
# Sort index
df.sort_index(inplace=True)
df
| ex_complete | ||
|---|---|---|
| date | language | |
| 2017-01-01 | python | 6 |
| r | 8 | |
| 2017-01-02 | python | 5 |
| r | 8 | |
| 2017-01-03 | python | 10 |
| r | 8 |
Sekarang Anda dapat mengambil jumlah latihan R yang diselesaikan pada 2017-01-02 dengan meneruskan sebuah tuple ke aksesori .loc:
# Slice & dice your DataFrame
df.loc[('2017-01-02', 'r')]
ex_complete    8
Name: (2017-01-02, r), dtype: int64
Kapan dan mengapa menggunakan multi-index
Multi-index adalah alat yang kuat untuk analisis dan pengorganisasian data di pandas. Multi-index memungkinkan pengguna membuat indeks hierarkis, yang dapat digunakan untuk mengelompokkan dan mengagregasi data di berbagai dimensi. Multi-index sangat berguna saat bekerja dengan dataset kompleks yang memiliki beberapa tingkat pengelompokan, seperti data keuangan atau deret waktu.
Dengan membuat multi-index, pengguna dapat mengelompokkan data berdasarkan beberapa variabel sekaligus, yang dapat mengungkap wawasan yang mungkin tidak terlihat dari pengelompokan satu tingkat. Misalnya, multi-index dapat digunakan untuk mengelompokkan data sekaligus berdasarkan waktu dan lokasi, sehingga analis dapat memeriksa tren di wilayah tertentu dari waktu ke waktu.
Selain itu, multi-index dapat digunakan untuk memilih dan mensubset data secara efisien, karena indeks menyediakan cara yang nyaman untuk mengakses subset data tertentu. Secara keseluruhan, multi-index adalah alat yang ampuh untuk mengorganisasi, mengelompokkan, dan menganalisis dataset kompleks di pandas, dan merupakan hal yang esensial bagi setiap analis atau ilmuwan data yang bekerja dengan data hierarkis.
Sekarang Anda sudah mengetahui sedikit tentang indeks hierarkis (atau multi-indeks). Saatnya melihat bagaimana indeks tersebut muncul saat bekerja dengan objek groupby.
Indeks Hierarkis, objek groupby, dan Split-Apply-Combine
Dalam tulisan sebelumnya, kita mengeksplorasi objek groupby dan prinsip analitik data split-apply-combine menggunakan data Netflix. Mari penyegaran cepat dengan dataset berbeda, yaitu dataset tips yang tersemat di paket seaborn. 'Tips' berisi fitur seperti tip, total_bill, hari dalam seminggu, dan waktu dalam sehari. Pertama muat dan jelajahi datanya:
# Import and check out data
import seaborn as sns
tips = sns.load_dataset("tips")
tips.head()
| total_bill | tip | sex | smoker | day | time | size | |
|---|---|---|---|---|---|---|---|
| 0 | 16.99 | 1.01 | Female | No | Sun | Dinner | 2 |
| 1 | 10.34 | 1.66 | Male | No | Sun | Dinner | 3 |
| 2 | 21.01 | 3.50 | Male | No | Sun | Dinner | 3 |
| 3 | 23.68 | 3.31 | Male | No | Sun | Dinner | 2 |
| 4 | 24.59 | 3.61 | Female | No | Sun | Dinner | 4 |
Perhatikan bahwa indeks dari tips adalah sebuah RangeIndex:
# Check out index
tips.index
RangeIndex(start=0, stop=244, step=1)
Selalu membantu melakukan EDA visual sebelum terjun ke komputasi dan fungsi pairplot milik seaborn memungkinkan Anda mendapatkan gambaran semua variabel numerik:
# Import pyplot, figures inline, set style, plot pairplot
import matplotlib.pyplot as plt
%matplotlib inline
sns.set()
sns.pairplot(tips, hue='day');
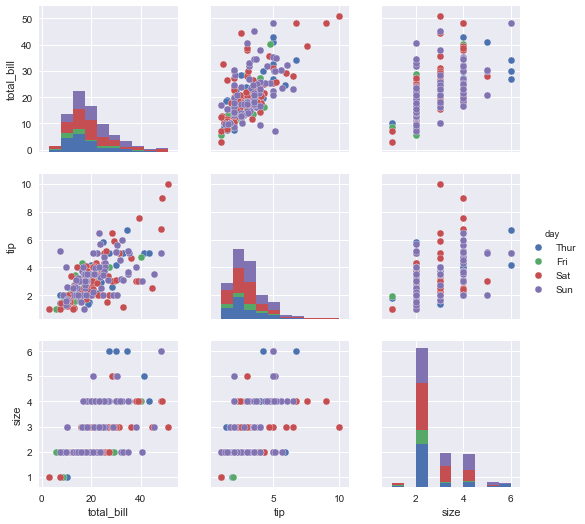
Jika Anda ingin melihat bagaimana rata-rata tip berbeda antara 'perokok' dan 'bukan perokok', Anda dapat membagi DataFrame asli berdasarkan 'smoker' (menggunakan groupby), menerapkan fungsi 'mean' dan menggabungkan menjadi DataFrame baru:
# Get mean of smoker/non-smoker groups
df = tips.groupby('smoker').mean()
df
| total_bill | tip | size | |
|---|---|---|---|
| smoker | |||
| Yes | 20.756344 | 3.008710 | 2.408602 |
| No | 19.188278 | 2.991854 | 2.668874 |
Indeks DataFrame df yang dihasilkan adalah kolom/fitur 'smoker' dari DataFrame 'tips' asli:
# Check out new index
df.index
CategoricalIndex(['Yes', 'No'], categories=['Yes', 'No'], ordered=False, name='smoker', dtype='category')
Jika diinginkan, Anda dapat me-reset indeks sehingga 'smoker' menjadi kolom pada DataFrame:
# Reset the index
df.reset_index()
| smoker | total_bill | tip | size | |
|---|---|---|---|---|
| 0 | Yes | 20.756344 | 3.008710 | 2.408602 |
| 1 | No | 19.188278 | 2.991854 | 2.668874 |
Sekarang saatnya mencari tahu bagaimana indeks hierarkis muncul dari split-apply-combine dan operasi groupby.
Pengelompokan ganda dan indeks hierarkis
Di atas, Anda mengelompokkan dataset tips berdasarkan fitur 'smoker'. Terkadang Anda perlu mengelompokkan sebuah dataset berdasarkan dua fitur. Misalnya, wajar untuk mengelompokkan dataset tips menjadi perokok/bukan perokok & makan malam/makan siang. Untuk melakukannya, Anda meneruskan nama kolom yang ingin dikelompokkan sebagai sebuah list:
# Group by two columns
df = tips.groupby(['smoker','time']).mean()
df
| total_bill | tip | size | ||
|---|---|---|---|---|
| smoker | time | |||
| Yes | Lunch | 17.399130 | 2.834348 | 2.217391 |
| Dinner | 21.859429 | 3.066000 | 2.471429 | |
| No | Lunch | 17.050889 | 2.673778 | 2.511111 |
| Dinner | 20.095660 | 3.126887 | 2.735849 |
Melihat tabel di atas, Anda mungkin dapat melihat bahwa 'smoker' dan 'time' keduanya adalah indeks dari df. Memang demikian dan masuk akal: jika pengelompokan berdasarkan 'smoker' menghasilkan indeks berupa kolom 'smoker' asli, maka pengelompokan berdasarkan dua kolom akan memberi Anda dua indeks. Periksa indeks untuk mengonfirmasi bahwa indeksnya bersifat hierarkis:
# Check out index
df.index
MultiIndex(levels=[['Yes', 'No'], ['Lunch', 'Dinner']],
labels=[[0, 0, 1, 1], [0, 1, 0, 1]],
names=['smoker', 'time'])
Dan benar. Anda kini dapat melakukan banyak hal bermanfaat, seperti mendapatkan jumlah pada tiap pengelompokan:
# Group by two features
tips.groupby(['smoker','time']).size()
smoker time
Yes Lunch 23
Dinner 70
No Lunch 45
Dinner 106
dtype: int64
Anda juga dapat menukar level dari indeks hierarkis sehingga 'time' muncul sebelum 'smoker' di indeks:
# Swap levels of multi-index
df.swaplevel()
| total_bill | tip | size | ||
|---|---|---|---|---|
| time | smoker | |||
| Lunch | Yes | 17.399130 | 2.834348 | 2.217391 |
| Dinner | Yes | 21.859429 | 3.066000 | 2.471429 |
| Lunch | No | 17.050889 | 2.673778 | 2.511111 |
| Dinner | No | 20.095660 | 3.126887 | 2.735849 |
Anda kemudian mungkin ingin menghapus salah satu fitur ini dari indeks hierarkis dan membentuk kolom yang berbeda terhadap fitur tersebut. Anda dapat melakukannya dengan metode unstack:
# Unstack your multi-index
df.unstack()
| total_bill | tip | size | ||||
|---|---|---|---|---|---|---|
| time | Lunch | Dinner | Lunch | Dinner | Lunch | Dinner |
| smoker | ||||||
| Yes | 17.399130 | 21.859429 | 2.834348 | 3.066000 | 2.217391 | 2.471429 |
| No | 17.050889 | 20.095660 | 2.673778 | 3.126887 | 2.511111 | 2.735849 |
Anda dapat melakukan unstack pada fitur terluar dari indeks menggunakan argumen kata kunci 'level':
# Unsstack the outer index
df.unstack(level=0)
| total_bill | tip | size | ||||
|---|---|---|---|---|---|---|
| smoker | Yes | No | Yes | No | Yes | No |
| time | ||||||
| Lunch | 17.399130 | 17.050889 | 2.834348 | 2.673778 | 2.217391 | 2.511111 |
| Dinner | 21.859429 | 20.095660 | 3.066000 | 3.126887 | 2.471429 | 2.735849 |
Hasil unstacking memiliki indeks non-hierarkis, seperti yang mungkin Anda harapkan:
# Check out index
df.unstack().index
CategoricalIndex(['Yes', 'No'], categories=['Yes', 'No'], ordered=False, name='smoker', dtype='category')
Akibatnya, Anda kini dapat melakukan berbagai jenis analisis data terkait pengelompokan ini. Saya mendorong Anda untuk mencobanya.
Indeks Hierarkis dalam Penggunaan Sehari-hari
Dalam tulisan ini, Anda diperkenalkan pada indeks hierarkis (atau multi-indeks) dan telah melihat bagaimana indeks tersebut muncul sebagai konsekuensi alami dari keinginan agar indeks DataFrame memberi label baris secara unik dan bermakna. Anda juga telah melihat bagaimana indeks tersebut muncul saat Anda perlu mengelompokkan data berdasarkan beberapa kolom, menerapkan prinsip split-apply-combine. Semoga Anda bersenang-senang dengan indeks hierarkis dalam pekerjaan Anda.
Tulisan ini dihasilkan dari Jupyter Notebook; Anda dapat menemukannya di repositori ini. Jika Anda memiliki pemikiran, tanggapan, dan/atau renungan, jangan ragu untuk menghubungi saya di Twitter: @hugobowne.
Lihat tutorial pandas DataCamp lainnya yang bermanfaat, termasuk:




Dalam tulisan sebelumnya, Anda melihat bagaimana operasi groupby muncul secara alami melalui prinsip split-apply-combine. Anda meninjau sebuah dataset berisi penilaian pengguna Netflix dan mengelompokkan baris berdasarkan tahun rilis film untuk menghasilkan gambar berikut:
Ini dicapai dengan mengelompokkan berdasarkan satu kolom. Saya sempat menyebutkan bahwa Anda mungkin ingin mengelompokkan berdasarkan beberapa kolom, yang dalam hal ini DataFrame pandas yang dihasilkan akan memiliki multi-index atau indeks hierarkis. Dalam tulisan ini, Anda akan mempelajari apa itu indeks hierarkis dan melihat bagaimana indeks tersebut muncul saat mengelompokkan berdasarkan beberapa fitur data Anda. Anda dapat mempelajari lebih lanjut tentang semua konsep dan praktik ini di kursus Manipulating DataFrames with pandas kami.
Jadi pertama-tama: apa itu indeks hierarkis?
Indeks Hierarkis dan pandas DataFrame
Apa itu Indeks dari sebuah DataFrame?
Sebelum memperkenalkan indeks hierarkis, mari kita ingat kembali apa itu indeks pada pandas DataFrame. Indeks sebuah DataFrame adalah himpunan yang terdiri atas label untuk setiap baris. Mari lihat contohnya. Saya akan terlebih dahulu mengimpor dataset sintetis tentang aktivitas seorang siswa DataCamp bernama Ellie di DataCamp. Kolom-kolomnya adalah tanggal, bahasa pemrograman, dan jumlah latihan yang diselesaikan Ellie hari itu dalam bahasa tersebut. Muat datanya: