

Execute e edite o código deste tutorial online
Executar código| date | language | ex_complete | |
|---|---|---|---|
| 0 | 2017-01-01 | python | 6 |
| 1 | 2017-01-02 | python | 5 |
| 2 | 2017-01-03 | python | 10 |
Você pode ver o Index no lado esquerdo do DataFrame, composto por inteiros. Este é um RangeIndex:
# Check out index
df.index
RangeIndex(start=0, stop=3, step=1)
Podemos usar esse index para fatiar uma ou mais linhas de df:
# Slice and dice data
df.loc[:1]
| date | language | ex_complete | |
|---|---|---|---|
| 0 | 2017-01-01 | python | 6 |
| 1 | 2017-01-02 | python | 5 |
Esse index, porém, não é tão informativo. Se você vai rotular as linhas do seu DataFrame, é melhor fazer isso de forma significativa, sempre que possível. Dá para fazer isso com este conjunto de dados? Uma boa forma de pensar nesse desafio é: você quer um identificador único e significativo para cada linha. Veja as colunas e cheque se alguma atende a esses critérios. Note que a coluna date contém datas únicas, então faz sentido rotular cada linha por ela. Ou seja, você pode transformar a coluna date no index do DataFrame usando o método .set_index() (obs.: inplace=True significa que você está alterando o DataFrame df no próprio objeto):
# Set new index
df.set_index(pd.DatetimeIndex(df['date']), inplace=True)
df
| date | language | ex_complete | |
|---|---|---|---|
| date | |||
| 2017-01-01 | 2017-01-01 | python | 6 |
| 2017-01-02 | 2017-01-02 | python | 5 |
| 2017-01-03 | 2017-01-03 | python | 10 |
Agora df tem um DateTimeIndex:
# Check out new index
df.index
DatetimeIndex(['2017-01-01', '2017-01-02', '2017-01-03'], dtype='datetime64[ns]', name='date', freq=None)
Com isso, você pode fatiar linhas usando o DateTimeIndex que criou:
# Slice and dice data w/ new index
df.loc['2017-01-02']
date 2017-01-02
language python
ex_complete 5
Name: 2017-01-02 00:00:00, dtype: object
Note também que o atributo .columns retorna um index contendo os nomes das colunas de df:
# Check out columns
df.columns
Index(['date', 'language', 'ex_complete'], dtype='object')
Isso pode confundir um pouco porque indica que df.columns é do tipo Index. Isso não significa que as colunas sejam o index do DataFrame. O index de df é sempre dado por df.index. Confira nosso tutorial de DataFrames do pandas para saber mais sobre índices. Agora é hora de conhecer os índices hierárquicos.
O multi-index de um DataFrame do pandas
E se tivéssemos várias linguagens no dataset, como acontece na DataCamp? Veja só:
# Import and check out data
df = pd.read_csv('data/user_ex.csv')
df
| date | language | ex_complete | |
|---|---|---|---|
| 0 | 2017-01-01 | python | 6 |
| 1 | 2017-01-02 | python | 5 |
| 2 | 2017-01-03 | python | 10 |
| 3 | 2017-01-01 | r | 8 |
| 4 | 2017-01-02 | r | 8 |
| 5 | 2017-01-03 | r | 8 |
Cada data agora corresponde a várias linhas, uma para cada linguagem. Veja, por exemplo, que a data '2017-01-02' aparece nas linhas 1 e 4, para Python e R, respectivamente. Assim, a data deixa de identificar a linha de forma única. Porém, 'date' e 'language' juntas identificam as linhas de forma única. Por isso, usamos ambas como index:
# Set index
df.set_index(['date', 'language'], inplace=True)
df
| ex_complete | ||
|---|---|---|
| date | language | |
| 2017-01-01 | python | 6 |
| 2017-01-02 | python | 5 |
| 2017-01-03 | python | 10 |
| 2017-01-01 | r | 8 |
| 2017-01-02 | r | 8 |
| 2017-01-03 | r | 8 |
Agora você criou um multi-index, ou índice hierárquico (fique à vontade com ambos os termos, usados de forma intercambiável), e isso fica claro ao inspecionar o index assim:
# Check out multi-index
df.index
MultiIndex(levels=[['2017-01-01', '2017-01-02', '2017-01-03'], ['python', 'r']],
labels=[[0, 1, 2, 0, 1, 2], [0, 0, 0, 1, 1, 1]],
names=['date', 'language'])
Isso indica que o seu DataFrame df agora tem um MultiIndex com dois níveis: o primeiro é a data e o segundo é a linguagem. Lembre que acima você conseguiu fatiar o DataFrame usando o index e o acessor .loc: df.loc['2017-01-02']. Para poder fatiar com um multi-index, primeiro é preciso ordenar o index:
# Sort index
df.sort_index(inplace=True)
df
| ex_complete | ||
|---|---|---|
| date | language | |
| 2017-01-01 | python | 6 |
| r | 8 | |
| 2017-01-02 | python | 5 |
| r | 8 | |
| 2017-01-03 | python | 10 |
| r | 8 |
Agora você pode selecionar o número de exercícios de R concluídos em 2017-01-02 passando uma tupla para o acessor .loc:
# Slice & dice your DataFrame
df.loc[('2017-01-02', 'r')]
ex_complete    8
Name: (2017-01-02, r), dtype: int64
Quando e por que usar multi-indexes
Multi-indexes são uma ferramenta poderosa para análise e organização de dados no pandas. Eles permitem criar índices hierárquicos que podem ser usados para agrupar e agregar dados em múltiplas dimensões. São particularmente úteis em conjuntos complexos com vários níveis de categorização, como dados financeiros ou séries temporais.
Ao criar um multi-index, você consegue agrupar dados por várias variáveis simultaneamente, o que pode revelar insights que um agrupamento de nível único não mostraria. Por exemplo, é possível agrupar por tempo e localização ao mesmo tempo, permitindo analisar tendências em regiões específicas ao longo do tempo.
Além disso, multi-indexes facilitam a seleção e o subconjunto eficiente dos dados, já que o index fornece um caminho prático para acessar partes específicas do dataset. Em resumo, multi-indexes são essenciais para organizar, agrupar e analisar dados complexos no pandas, e fazem parte do arsenal de qualquer analista ou cientista de dados que trabalhe com estruturas hierárquicas.
Agora que você já conhece índices hierárquicos (ou multi-índices), vamos ver como eles surgem ao trabalhar com objetos groupby.
Índices hierárquicos, objetos groupby e split-apply-combine
Em um post anterior, exploramos objetos groupby e o princípio analítico de split-apply-combine usando dados da Netflix. Vamos relembrar rapidamente com outro dataset, o tips, que vem no pacote seaborn. O 'tips' contém atributos como tip, total_bill, o dia da semana e o horário. Primeiro, carregue e explore os dados:
# Import and check out data
import seaborn as sns
tips = sns.load_dataset("tips")
tips.head()
| total_bill | tip | sex | smoker | day | time | size | |
|---|---|---|---|---|---|---|---|
| 0 | 16.99 | 1.01 | Female | No | Sun | Dinner | 2 |
| 1 | 10.34 | 1.66 | Male | No | Sun | Dinner | 3 |
| 2 | 21.01 | 3.50 | Male | No | Sun | Dinner | 3 |
| 3 | 23.68 | 3.31 | Male | No | Sun | Dinner | 2 |
| 4 | 24.59 | 3.61 | Female | No | Sun | Dinner | 4 |
Note que o index de tips é um RangeIndex:
# Check out index
tips.index
RangeIndex(start=0, stop=244, step=1)
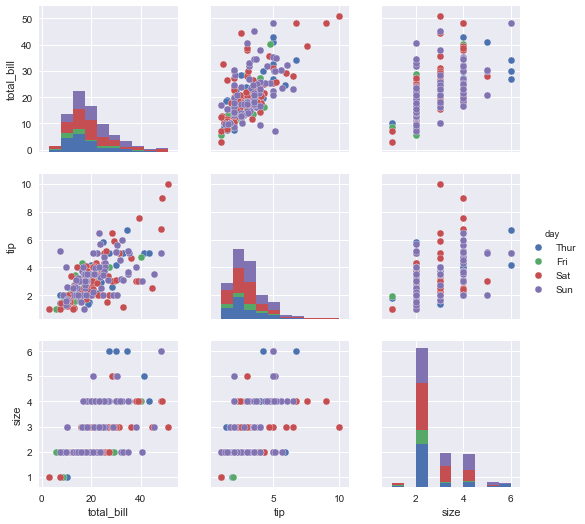
Sempre ajuda fazer uma EDA visual antes de partir para a computação, e a função pairplot do seaborn dá uma visão geral de todas as variáveis numéricas:
# Import pyplot, figures inline, set style, plot pairplot
import matplotlib.pyplot as plt
%matplotlib inline
sns.set()
sns.pairplot(tips, hue='day');
Se você quiser ver como a gorjeta média difere entre "smokers" e "non-smokers", pode dividir o DataFrame original por 'smoker' (usando groupby), aplicar a função mean e combinar em um novo DataFrame:
# Get mean of smoker/non-smoker groups
df = tips.groupby('smoker').mean()
df
| total_bill | tip | size | |
|---|---|---|---|
| smoker | |||
| Yes | 20.756344 | 3.008710 | 2.408602 |
| No | 19.188278 | 2.991854 | 2.668874 |
O index resultante do DataFrame df é a coluna/atributo 'smoker' do DataFrame original 'tips':
# Check out new index
df.index
CategoricalIndex(['Yes', 'No'], categories=['Yes', 'No'], ordered=False, name='smoker', dtype='category')
Se quiser, você pode resetar o index para que 'smoker' volte a ser uma coluna do DataFrame:
# Reset the index
df.reset_index()
| smoker | total_bill | tip | size | |
|---|---|---|---|---|
| 0 | Yes | 20.756344 | 3.008710 | 2.408602 |
| 1 | No | 19.188278 | 2.991854 | 2.668874 |
Agora vamos descobrir como índices hierárquicos surgem a partir de split-apply-combine e operações de groupby.
Agrupamentos múltiplos e índices hierárquicos
Acima, você agrupou o dataset tips pelo atributo 'smoker'. Às vezes será preciso agrupar por dois atributos. Por exemplo, é natural agrupar o tips em smokers/non-smokers & dinner/lunch. Para isso, passe os nomes das colunas como uma lista:
# Group by two columns
df = tips.groupby(['smoker','time']).mean()
df
| total_bill | tip | size | ||
|---|---|---|---|---|
| smoker | time | |||
| Yes | Lunch | 17.399130 | 2.834348 | 2.217391 |
| Dinner | 21.859429 | 3.066000 | 2.471429 | |
| No | Lunch | 17.050889 | 2.673778 | 2.511111 |
| Dinner | 20.095660 | 3.126887 | 2.735849 |
Observando a tabela acima, dá para notar que 'smoker' e 'time' viraram índices de df. Faz sentido: se agrupar por 'smoker' torna o index a coluna original 'smoker', agrupar por duas colunas gera dois índices. Confira o index para confirmar que é hierárquico:
# Check out index
df.index
MultiIndex(levels=[['Yes', 'No'], ['Lunch', 'Dinner']],
labels=[[0, 0, 1, 1], [0, 1, 0, 1]],
names=['smoker', 'time'])
E é isso mesmo. Agora dá para fazer várias coisas úteis, como obter as contagens em cada agrupamento:
# Group by two features
tips.groupby(['smoker','time']).size()
smoker time
Yes Lunch 23
Dinner 70
No Lunch 45
Dinner 106
dtype: int64
Você também pode trocar a ordem dos níveis do índice hierárquico para que 'time' venha antes de 'smoker' no index:
# Swap levels of multi-index
df.swaplevel()
| total_bill | tip | size | ||
|---|---|---|---|---|
| time | smoker | |||
| Lunch | Yes | 17.399130 | 2.834348 | 2.217391 |
| Dinner | Yes | 21.859429 | 3.066000 | 2.471429 |
| Lunch | No | 17.050889 | 2.673778 | 2.511111 |
| Dinner | No | 20.095660 | 3.126887 | 2.735849 |
Em seguida, você pode querer remover um desses atributos do índice hierárquico e formar colunas separadas para esse atributo. Use o método unstack:
# Unstack your multi-index
df.unstack()
| total_bill | tip | size | ||||
|---|---|---|---|---|---|---|
| time | Lunch | Dinner | Lunch | Dinner | Lunch | Dinner |
| smoker | ||||||
| Yes | 17.399130 | 21.859429 | 2.834348 | 3.066000 | 2.217391 | 2.471429 |
| No | 17.050889 | 20.095660 | 2.673778 | 3.126887 | 2.511111 | 2.735849 |
Você pode fazer unstack no nível externo do índice usando o argumento 'level':
# Unsstack the outer index
df.unstack(level=0)
| total_bill | tip | size | ||||
|---|---|---|---|---|---|---|
| smoker | Yes | No | Yes | No | Yes | No |
| time | ||||||
| Lunch | 17.399130 | 17.050889 | 2.834348 | 2.673778 | 2.217391 | 2.511111 |
| Dinner | 21.859429 | 20.095660 | 3.066000 | 3.126887 | 2.471429 | 2.735849 |
O resultado do unstack tem um index não hierárquico, como esperado:
# Check out index
df.unstack().index
CategoricalIndex(['Yes', 'No'], categories=['Yes', 'No'], ordered=False, name='smoker', dtype='category')
Com isso, você pode conduzir vários tipos de análise em relação a esses agrupamentos. Fica o convite para explorar.
Índices hierárquicos no dia a dia
Neste post, você foi apresentado aos índices hierárquicos (ou multi-índices) e viu como eles surgem naturalmente quando queremos que o index identifique as linhas do DataFrame de forma única e significativa. Também viu como eles aparecem quando é preciso agrupar os dados por múltiplas colunas, aplicando o princípio de split-apply-combine. Espero que você se divirta usando índices hierárquicos no seu trabalho.
Este post foi gerado a partir de um Jupyter Notebook; você pode encontrá-lo neste repositório. Se tiver comentários, ideias ou perguntas, fique à vontade para falar comigo no Twitter: @hugobowne.
Confira outros tutoriais práticos de pandas da DataCamp, incluindo:





Em um post anterior, você viu como a operação groupby surge naturalmente a partir do princípio de dividir-aplicar-combinar (split-apply-combine). Analisamos um conjunto de avaliações de usuários da Netflix e agrupamos as linhas pelo ano de lançamento do filme para gerar a figura a seguir:
Isso foi feito agrupando por uma única coluna. Comentei, de passagem, que você pode querer agrupar por várias colunas; nesse caso, o DataFrame do pandas resultante passa a ter um multi-index ou índice hierárquico. Neste post, você vai entender o que são índices hierárquicos e verá como eles surgem quando agrupamos por vários atributos dos dados. Você pode aprender mais sobre esses conceitos e práticas no nosso curso Manipulando DataFrames com pandas.
Então, para começar: o que são índices hierárquicos?
Índices hierárquicos e DataFrames do pandas
O que é o index de um DataFrame?
Antes de apresentar os índices hierárquicos, vale relembrar o que é o index de um DataFrame do pandas. O index de um DataFrame é um conjunto de rótulos, um para cada linha. Vamos ver um exemplo. Primeiro, vou importar um dataset sintético com a atividade de uma aluna hipotética da DataCamp, Ellie. As colunas são uma data, uma linguagem de programação e o número de exercícios que Ellie concluiu naquele dia nessa linguagem. Carregue os dados: