

Chạy và chỉnh sửa mã từ hướng dẫn trực tuyến này
Chạy mã| date | language | ex_complete | |
|---|---|---|---|
| 0 | 2017-01-01 | python | 6 |
| 1 | 2017-01-02 | python | 5 |
| 2 | 2017-01-03 | python | 10 |
Bạn có thể thấy Index ở bên trái của DataFrame và nó gồm các số nguyên. Đây là một RangeIndex:
# Check out index
df.index
RangeIndex(start=0, stop=3, step=1)
Chúng ta có thể dùng index này để cắt lấy một hay nhiều hàng của df:
# Slice and dice data
df.loc[:1]
| date | language | ex_complete | |
|---|---|---|---|
| 0 | 2017-01-01 | python | 6 |
| 1 | 2017-01-02 | python | 5 |
Tuy nhiên, index này không mấy thông tin. Nếu bạn định gắn nhãn cho các hàng của DataFrame, sẽ tốt hơn nếu gắn nhãn theo cách có ý nghĩa, nếu có thể. Bạn có thể làm điều này với bộ dữ liệu đang xét không? Một cách nghĩ hay cho bài toán này là bạn muốn một định danh vừa duy nhất vừa có ý nghĩa cho mỗi hàng. Hãy xem các cột và kiểm tra xem có cột nào đáp ứng tiêu chí này không. Lưu ý rằng cột date chứa các ngày không trùng lặp, nên hợp lý khi dùng cột này để gắn nhãn mỗi hàng. Tức là, bạn có thể đặt cột date làm index của DataFrame bằng phương thức .set_index() (lưu ý: inplace=True nghĩa là bạn thực sự thay đổi DataFrame df tại chỗ):
# Set new index
df.set_index(pd.DatetimeIndex(df['date']), inplace=True)
df
| date | language | ex_complete | |
|---|---|---|---|
| date | |||
| 2017-01-01 | 2017-01-01 | python | 6 |
| 2017-01-02 | 2017-01-02 | python | 5 |
| 2017-01-03 | 2017-01-03 | python | 10 |
Việc này giúp df có một DateTimeIndex:
# Check out new index
df.index
DatetimeIndex(['2017-01-01', '2017-01-02', '2017-01-03'], dtype='datetime64[ns]', name='date', freq=None)
Giờ đây bạn có thể cắt lấy các hàng bằng DateTimeIndex vừa tạo:
# Slice and dice data w/ new index
df.loc['2017-01-02']
date 2017-01-02
language python
ex_complete 5
Name: 2017-01-02 00:00:00, dtype: object
Cũng lưu ý rằng thuộc tính .columns trả về một index chứa tên các cột của df:
# Check out columns
df.columns
Index(['date', 'language', 'ex_complete'], dtype='object')
Điều này có thể hơi gây nhầm lẫn vì nó cho biết df.columns thuộc kiểu Index. Điều này không có nghĩa là các cột là index của DataFrame. Index của df luôn được cho bởi df.index. Xem thêm hướng dẫn về pandas DataFrame của chúng tôi để biết thêm về index: pandas DataFrames tutorial. Giờ là lúc gặp gỡ chỉ mục phân cấp.
Multi-index của một pandas DataFrame
Nếu bộ dữ liệu có nhiều ngôn ngữ như trên DataCamp thì sao? Xem thử nhé:
# Import and check out data
df = pd.read_csv('data/user_ex.csv')
df
| date | language | ex_complete | |
|---|---|---|---|
| 0 | 2017-01-01 | python | 6 |
| 1 | 2017-01-02 | python | 5 |
| 2 | 2017-01-03 | python | 10 |
| 3 | 2017-01-01 | r | 8 |
| 4 | 2017-01-02 | r | 8 |
| 5 | 2017-01-03 | r | 8 |
Mỗi ngày giờ đây tương ứng với nhiều hàng, mỗi hàng cho một ngôn ngữ. Ví dụ, ngày '2017-01-02' xuất hiện ở hàng 1 và 4, lần lượt cho Python và R. Vì vậy, cột date không còn duy nhất xác định hàng nữa. Tuy nhiên, kết hợp 'date' và 'language' thì xác định duy nhất các hàng. Do đó, chúng ta dùng cả hai làm index:
# Set index
df.set_index(['date', 'language'], inplace=True)
df
| ex_complete | ||
|---|---|---|
| date | language | |
| 2017-01-01 | python | 6 |
| 2017-01-02 | python | 5 |
| 2017-01-03 | python | 10 |
| 2017-01-01 | r | 8 |
| 2017-01-02 | r | 8 |
| 2017-01-03 | r | 8 |
Bây giờ bạn đã tạo một multi-index, hay chỉ mục phân cấp (hãy quen với cả hai thuật ngữ vì chúng được dùng thay thế cho nhau), và bạn có thể kiểm tra index như sau:
# Check out multi-index
df.index
MultiIndex(levels=[['2017-01-01', '2017-01-02', '2017-01-03'], ['python', 'r']],
labels=[[0, 1, 2, 0, 1, 2], [0, 0, 0, 1, 1, 1]],
names=['date', 'language'])
Phần trên cho biết DataFrame df hiện có một MultiIndex với hai cấp (level), cấp đầu theo ngày, cấp sau theo ngôn ngữ. Nhớ rằng ở trên bạn có thể cắt DataFrame bằng index và bộ truy cập .loc: df.loc['2017-01-02']. Để có thể cắt bằng multi-index, bạn cần sắp xếp index trước:
# Sort index
df.sort_index(inplace=True)
df
| ex_complete | ||
|---|---|---|
| date | language | |
| 2017-01-01 | python | 6 |
| r | 8 | |
| 2017-01-02 | python | 5 |
| r | 8 | |
| 2017-01-03 | python | 10 |
| r | 8 |
Giờ bạn có thể cắt lấy số bài tập R đã hoàn thành vào ngày 2017-01-02 bằng cách truyền một tuple vào bộ truy cập .loc:
# Slice & dice your DataFrame
df.loc[('2017-01-02', 'r')]
ex_complete    8
Name: (2017-01-02, r), dtype: int64
Khi nào và vì sao nên dùng multi-index
Multi-index là một công cụ mạnh để phân tích và tổ chức dữ liệu trong pandas. Chúng cho phép bạn tạo các chỉ mục phân cấp, có thể dùng để nhóm và tổng hợp dữ liệu theo nhiều chiều. Multi-index đặc biệt hữu ích khi làm việc với các bộ dữ liệu phức tạp có nhiều cấp phân loại, như dữ liệu tài chính hoặc chuỗi thời gian.
Bằng cách tạo multi-index, bạn có thể nhóm dữ liệu theo nhiều biến đồng thời, từ đó khám phá những insight có thể không lộ rõ khi chỉ nhóm một cấp. Ví dụ, multi-index có thể dùng để nhóm dữ liệu theo cả thời gian và địa điểm, cho phép nhà phân tích xem các xu hướng theo từng khu vực theo thời gian.
Ngoài ra, multi-index còn giúp chọn lọc và trích xuất dữ liệu hiệu quả, vì index cung cấp một cách tiện lợi để truy cập các tập con cụ thể. Nhìn chung, multi-index là công cụ mạnh mẽ để tổ chức, nhóm và phân tích các bộ dữ liệu phức tạp trong pandas, và là kỹ năng thiết yếu cho mọi nhà phân tích hoặc nhà khoa học dữ liệu làm việc với dữ liệu phân cấp.
Bây giờ bạn đã biết đôi chút về chỉ mục phân cấp (hay multi-index). Đã đến lúc xem chúng xuất hiện thế nào khi làm việc với các đối tượng groupby.
Chỉ mục phân cấp, đối tượng groupby và nguyên tắc tách - áp dụng - kết hợp
Trong một bài viết trước, chúng tôi đã khám phá các đối tượng groupby và nguyên tắc phân tích dữ liệu tách - áp dụng - kết hợp bằng dữ liệu netflix. Hãy cùng ôn nhanh với một bộ dữ liệu khác, bộ dữ liệu tips (tiền boa) được tích hợp trong gói seaborn. 'Tips' chứa các đặc trưng như tip, total_bill, ngày trong tuần và thời điểm trong ngày. Đầu tiên tải và khám phá dữ liệu:
# Import and check out data
import seaborn as sns
tips = sns.load_dataset("tips")
tips.head()
| total_bill | tip | sex | smoker | day | time | size | |
|---|---|---|---|---|---|---|---|
| 0 | 16.99 | 1.01 | Female | No | Sun | Dinner | 2 |
| 1 | 10.34 | 1.66 | Male | No | Sun | Dinner | 3 |
| 2 | 21.01 | 3.50 | Male | No | Sun | Dinner | 3 |
| 3 | 23.68 | 3.31 | Male | No | Sun | Dinner | 2 |
| 4 | 24.59 | 3.61 | Female | No | Sun | Dinner | 4 |
Lưu ý rằng index của tips là một RangeIndex:
# Check out index
tips.index
RangeIndex(start=0, stop=244, step=1)
Luôn hữu ích khi làm một chút EDA trực quan trước khi đi vào tính toán, và hàm pairplot của seaborn cho phép bạn có cái nhìn tổng quan về tất cả biến số:
# Import pyplot, figures inline, set style, plot pairplot
import matplotlib.pyplot as plt
%matplotlib inline
sns.set()
sns.pairplot(tips, hue='day');
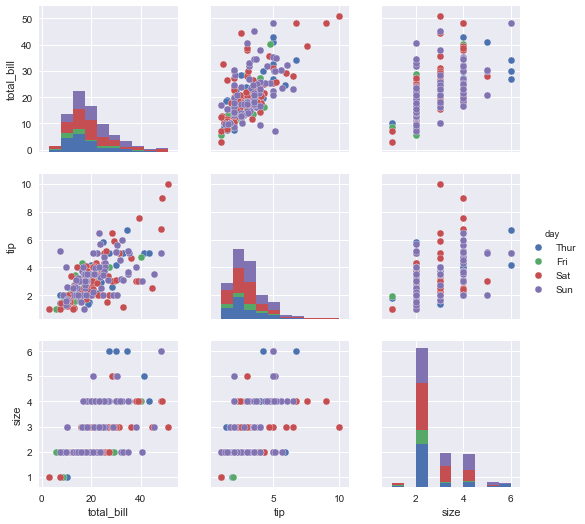
Nếu bạn muốn xem tiền boa trung bình khác nhau thế nào giữa 'smokers' và 'non-smokers', bạn có thể tách DataFrame gốc theo 'smoker' (dùng groupby), áp dụng hàm 'mean' và kết hợp thành một DataFrame mới:
# Get mean of smoker/non-smoker groups
df = tips.groupby('smoker').mean()
df
| total_bill | tip | size | |
|---|---|---|---|
| smoker | |||
| Yes | 20.756344 | 3.008710 | 2.408602 |
| No | 19.188278 | 2.991854 | 2.668874 |
Index của DataFrame df thu được chính là cột/thuộc tính 'smoker' của DataFrame 'tips' gốc:
# Check out new index
df.index
CategoricalIndex(['Yes', 'No'], categories=['Yes', 'No'], ordered=False, name='smoker', dtype='category')
Nếu muốn, bạn có thể reset index để 'smoker' trở thành một cột của DataFrame:
# Reset the index
df.reset_index()
| smoker | total_bill | tip | size | |
|---|---|---|---|---|
| 0 | Yes | 20.756344 | 3.008710 | 2.408602 |
| 1 | No | 19.188278 | 2.991854 | 2.668874 |
Giờ là lúc tìm hiểu cách chỉ mục phân cấp hình thành từ split-apply-combine và các thao tác groupby.
Nhóm theo nhiều cột và chỉ mục phân cấp
Ở trên, bạn đã nhóm bộ dữ liệu tips theo thuộc tính 'smoker'. Đôi khi bạn sẽ cần nhóm theo hai thuộc tính. Ví dụ, tự nhiên là nhóm bộ dữ liệu tips thành hút thuốc/không hút & bữa tối/bữa trưa. Để làm vậy, bạn truyền danh sách tên cột muốn nhóm theo:
# Group by two columns
df = tips.groupby(['smoker','time']).mean()
df
| total_bill | tip | size | ||
|---|---|---|---|---|
| smoker | time | |||
| Yes | Lunch | 17.399130 | 2.834348 | 2.217391 |
| Dinner | 21.859429 | 3.066000 | 2.471429 | |
| No | Lunch | 17.050889 | 2.673778 | 2.511111 |
| Dinner | 20.095660 | 3.126887 | 2.735849 |
Nhìn vào trên, bạn có thể thấy cả 'smoker' và 'time' đều là index của df. Điều này là đúng và hợp lý: nếu nhóm theo 'smoker' khiến index là cột 'smoker' ban đầu, thì nhóm theo hai cột sẽ cho bạn hai index. Kiểm tra index để xác nhận đây là chỉ mục phân cấp:
# Check out index
df.index
MultiIndex(levels=[['Yes', 'No'], ['Lunch', 'Dinner']],
labels=[[0, 0, 1, 1], [0, 1, 0, 1]],
names=['smoker', 'time'])
Và đúng như vậy. Giờ bạn có thể làm nhiều việc hữu ích, như đếm số phần tử trong mỗi nhóm:
# Group by two features
tips.groupby(['smoker','time']).size()
smoker time
Yes Lunch 23
Dinner 70
No Lunch 45
Dinner 106
dtype: int64
Bạn cũng có thể hoán đổi các cấp của chỉ mục phân cấp để 'time' đứng trước 'smoker' trong index:
# Swap levels of multi-index
df.swaplevel()
| total_bill | tip | size | ||
|---|---|---|---|---|
| time | smoker | |||
| Lunch | Yes | 17.399130 | 2.834348 | 2.217391 |
| Dinner | Yes | 21.859429 | 3.066000 | 2.471429 |
| Lunch | No | 17.050889 | 2.673778 | 2.511111 |
| Dinner | No | 20.095660 | 3.126887 | 2.735849 |
Sau đó bạn có thể muốn loại bỏ một trong các thuộc tính này khỏi chỉ mục phân cấp và tạo thành các cột khác nhau theo thuộc tính đó. Bạn có thể làm vậy bằng phương thức unstack:
# Unstack your multi-index
df.unstack()
| total_bill | tip | size | ||||
|---|---|---|---|---|---|---|
| time | Lunch | Dinner | Lunch | Dinner | Lunch | Dinner |
| smoker | ||||||
| Yes | 17.399130 | 21.859429 | 2.834348 | 3.066000 | 2.217391 | 2.471429 |
| No | 17.050889 | 20.095660 | 2.673778 | 3.126887 | 2.511111 | 2.735849 |
Bạn có thể unstack theo thuộc tính ngoài của index bằng tham số 'level':
# Unsstack the outer index
df.unstack(level=0)
| total_bill | tip | size | ||||
|---|---|---|---|---|---|---|
| smoker | Yes | No | Yes | No | Yes | No |
| time | ||||||
| Lunch | 17.399130 | 17.050889 | 2.834348 | 2.673778 | 2.217391 | 2.511111 |
| Dinner | 21.859429 | 20.095660 | 3.066000 | 3.126887 | 2.471429 | 2.735849 |
Kết quả của unstack là một index không phân cấp, như bạn có thể kỳ vọng:
# Check out index
df.unstack().index
CategoricalIndex(['Yes', 'No'], categories=['Yes', 'No'], ordered=False, name='smoker', dtype='category')
Nhờ đó, giờ bạn có thể thực hiện mọi kiểu phân tích dữ liệu theo các nhóm này. Tôi khuyến khích bạn thử.
Chỉ mục phân cấp trong sử dụng hằng ngày
Trong bài viết này, bạn đã được giới thiệu về chỉ mục phân cấp (hay multi-index) và thấy cách chúng xuất hiện như một hệ quả tự nhiên của mong muốn index của DataFrame gán nhãn các hàng một cách duy nhất và có ý nghĩa. Bạn cũng đã thấy cách chúng hình thành khi cần nhóm dữ liệu theo nhiều cột, vận dụng nguyên tắc tách - áp dụng - kết hợp. Hy vọng bạn sẽ thấy thú vị khi sử dụng chỉ mục phân cấp trong công việc.
Bài viết này được tạo từ một Jupyter Notebook; bạn có thể tìm thấy tại kho lưu trữ này. Nếu bạn có bất kỳ suy nghĩ, phản hồi và/hoặc trăn trở nào, hãy cứ liên hệ với tôi trên Twitter: @hugobowne.
Xem thêm các hướng dẫn pandas hữu ích khác của DataCamp, bao gồm:


Trong một bài viết trước, bạn đã thấy cách thao tác groupby hình thành tự nhiên dưới lăng kính nguyên tắc tách - áp dụng - kết hợp (split-apply-combine). Bạn đã xem một bộ dữ liệu về đánh giá của người dùng Netflix và nhóm các hàng theo năm phát hành của phim để tạo ra hình sau:
Điều này đạt được bằng cách nhóm theo một cột. Tôi có đề cập thoáng qua rằng bạn có thể muốn nhóm theo nhiều cột; khi đó DataFrame của pandas sẽ có một multi-index hay chỉ mục phân cấp (hierarchical index). Trong bài viết này, bạn sẽ tìm hiểu chỉ mục phân cấp là gì và cách chúng xuất hiện khi nhóm theo nhiều đặc trưng của dữ liệu. Bạn có thể tìm hiểu thêm về các khái niệm và thực hành này trong khóa học Manipulating DataFrames with pandas của chúng tôi.
Vậy trước hết: chỉ mục phân cấp là gì?
Chỉ mục phân cấp và pandas DataFrame
Chỉ mục (Index) của một DataFrame là gì?
Trước khi giới thiệu chỉ mục phân cấp, tôi muốn bạn nhớ lại chỉ mục của một pandas DataFrame là gì. Chỉ mục của một DataFrame là một tập hợp gồm nhãn cho mỗi hàng. Hãy xem một ví dụ. Tôi sẽ nhập một bộ dữ liệu tổng hợp về hoạt động của Ellie, một học viên DataCamp giả định, trên DataCamp. Các cột gồm có ngày, ngôn ngữ lập trình và số bài tập Ellie hoàn thành hôm đó bằng ngôn ngữ đó. Tải dữ liệu vào: