Kurs
Pandas-Joins für Spreadsheet-Nutzer
4 Std.
4.5K
In einem früheren Beitrag hast du gesehen, wie die groupby-Operation ganz natürlich aus dem Split-Apply-Combine-Prinzip entsteht. Du hast ein Dataset mit Netflix-Bewertungen betrachtet und die Zeilen nach dem Erscheinungsjahr der Filme gruppiert, um die folgende Abbildung zu erzeugen:
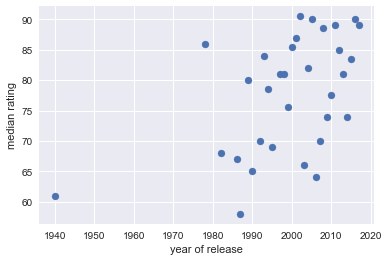
Das wurde erreicht, indem nach einer einzelnen Spalte gruppiert wurde. Ich habe nebenbei erwähnt, dass du auch nach mehreren Spalten gruppieren kannst. In diesem Fall bekommt das resultierende pandas DataFrame einen Multi-Index oder hierarchischen Index. In diesem Beitrag lernst du, was hierarchische Indizes sind und wie sie entstehen, wenn du nach mehreren Merkmalen deiner Daten gruppierst. Mehr zu diesen Konzepten und Praktiken findest du in unserem Kurs Manipulating DataFrames with pandas.
Also zuerst: Was sind hierarchische Indizes?
Bevor wir hierarchische Indizes einführen, rufe dir in Erinnerung, was der Index eines pandas DataFrames ist. Der Index eines DataFrames ist eine Menge, die für jede Zeile ein Label enthält. Schauen wir uns ein Beispiel an. Ich importiere ein synthetisches Dataset zur Aktivität der hypothetischen DataCamp-Studentin Ellie auf DataCamp. Die Spalten sind ein Datum, eine Programmiersprache und die Anzahl der Übungen, die Ellie an diesem Tag in dieser Sprache abgeschlossen hat. Lade die Daten:
# Import pandas
import pandas as pd

# Load in data
df = pd.read_csv('data/user_ex_python.csv')
df
Code aus diesem Tutorial online ausführen und bearbeiten
Code ausführen| date | language | ex_complete | |
|---|---|---|---|
| 0 | 2017-01-01 | python | 6 |
| 1 | 2017-01-02 | python | 5 |
| 2 | 2017-01-03 | python | 10 |
Links siehst du den Index des DataFrames — er besteht aus ganzen Zahlen. Das ist ein RangeIndex:
# Check out index
df.index
RangeIndex(start=0, stop=3, step=1)
Wir können diesen Index nutzen, um eine oder mehrere Zeilen von df herauszuschneiden:
# Slice and dice data
df.loc[:1]
| date | language | ex_complete | |
|---|---|---|---|
| 0 | 2017-01-01 | python | 6 |
| 1 | 2017-01-02 | python | 5 |
Dieser Index ist allerdings nicht sehr aussagekräftig. Wenn du die Zeilen deines DataFrames beschriftest, solltest du das nach Möglichkeit sinnvoll tun. Geht das bei diesem Dataset? Ein guter Ansatz ist, dass du für jede Zeile einen eindeutigen und sinnvollen Bezeichner willst. Prüfe die Spalten und schau, ob eine diese Kriterien erfüllt. Beachte, dass die Spalte date einzigartige Daten enthält. Es bietet sich also an, jede Zeile mit dem Datum zu labeln. Du kannst die Spalte date mit .set_index() zum Index des DataFrames machen (Achtung: inplace=True bedeutet, dass du df direkt veränderst):
# Set new index
df.set_index(pd.DatetimeIndex(df['date']), inplace=True)
df
| date | language | ex_complete | |
|---|---|---|---|
| date | |||
| 2017-01-01 | 2017-01-01 | python | 6 |
| 2017-01-02 | 2017-01-02 | python | 5 |
| 2017-01-03 | 2017-01-03 | python | 10 |
Damit erhält df einen DateTimeIndex:
# Check out new index
df.index
DatetimeIndex(['2017-01-01', '2017-01-02', '2017-01-03'], dtype='datetime64[ns]', name='date', freq=None)
Jetzt kannst du mit dem erstellten DateTimeIndex Zeilen selektieren:
# Slice and dice data w/ new index
df.loc['2017-01-02']
date           2017-01-02
language           python
ex_complete             5
Name: 2017-01-02 00:00:00, dtype: object
Beachte außerdem, dass das Attribut .columns einen Index mit den Spaltennamen von df zurückgibt:
# Check out columns
df.columns
Index(['date', 'language', 'ex_complete'], dtype='object')
Das kann etwas verwirren, weil hier steht, dass df.columns vom Typ Index ist. Das bedeutet nicht, dass die Spalten der Index des DataFrames sind. Der Index von df ist immer df.index. Weitere Infos zu Indizes findest du in unserem pandas DataFrames Tutorial. Zeit für hierarchische Indizes.
Was wäre, wenn unser Dataset mehrere Sprachen hätte, so wie bei DataCamp? Schau mal:
# Import and check out data
df = pd.read_csv('data/user_ex.csv')
df
| date | language | ex_complete | |
|---|---|---|---|
| 0 | 2017-01-01 | python | 6 |
| 1 | 2017-01-02 | python | 5 |
| 2 | 2017-01-03 | python | 10 |
| 3 | 2017-01-01 | r | 8 |
| 4 | 2017-01-02 | r | 8 |
| 5 | 2017-01-03 | r | 8 |
Jedes Datum gehört jetzt zu mehreren Zeilen, je Sprache eine. So kommt z. B. das Datum "2017-01-02" in den Zeilen 1 und 4 vor, für Python bzw. R. Das Datum allein identifiziert die Zeile also nicht mehr eindeutig. Zusammen bilden "date" und "language" jedoch einen eindeutigen Schlüssel. Deshalb verwenden wir beide als Index:
# Set index
df.set_index(['date', 'language'], inplace=True)
df
| ex_complete | ||
|---|---|---|
| date | language | |
| 2017-01-01 | python | 6 |
| 2017-01-02 | python | 5 |
| 2017-01-03 | python | 10 |
| 2017-01-01 | r | 8 |
| 2017-01-02 | r | 8 |
| 2017-01-03 | r | 8 |
Du hast jetzt einen Multi-Index bzw. hierarchischen Index erstellt (gewöhne dich an beide Begriffe — sie werden synonym verwendet). Das erkennst du so:
# Check out multi-index
df.index
MultiIndex(levels=[['2017-01-01', '2017-01-02', '2017-01-03'], ['python', 'r']],
           labels=[[0, 1, 2, 0, 1, 2], [0, 0, 0, 1, 1, 1]],
           names=['date', 'language'])
Das zeigt, dass dein DataFrame df jetzt einen MultiIndex mit zwei Ebenen hat: erst das Datum, dann die Sprache. Oben konntest du den DataFrame mit dem Index und dem .loc-Accessor slicen: df.loc['2017-01-02']. Um mit einem Multi-Index zu slicen, musst du den Index zuerst sortieren:
# Sort index
df.sort_index(inplace=True)
df
| ex_complete | ||
|---|---|---|
| date | language | |
| 2017-01-01 | python | 6 |
| r | 8 | |
| 2017-01-02 | python | 5 |
| r | 8 | |
| 2017-01-03 | python | 10 |
| r | 8 |
Jetzt kannst du die Anzahl der R-Übungen am 2017-01-02 selektieren, indem du ein Tupel an den .loc-Accessor übergibst:
# Slice & dice your DataFrame
df.loc[('2017-01-02', 'r')]
ex_complete    8
Name: (2017-01-02, r), dtype: int64
Multi-Indizes sind in pandas ein starkes Werkzeug für Analyse und Strukturierung. Sie ermöglichen hierarchische Indizes, mit denen sich Daten über mehrere Dimensionen gruppieren und aggregieren lassen. Besonders nützlich sind sie bei komplexen Datensätzen mit mehreren Kategorisierungsebenen, etwa in Finanz- oder Zeitreihendaten.
Mit einem Multi-Index kannst du gleichzeitig nach mehreren Variablen gruppieren und dadurch Muster erkennen, die bei eindimensionaler Gruppierung verborgen bleiben würden. Beispielsweise kannst du nach Zeit und Ort gruppieren und so Trends in bestimmten Regionen über die Zeit untersuchen.
Außerdem lassen sich Daten effizient auswählen und subsetten, da der Index einen bequemen Zugriff auf spezifische Teilmengen bietet. Kurz: Multi-Indizes sind essenziell, um komplexe Datensätze in pandas zu organisieren, zu gruppieren und zu analysieren — ein Muss für alle, die mit hierarchischen Daten arbeiten.
Jetzt weißt du, was hierarchische Indizes (bzw. Multi-Indizes) sind. Schauen wir uns an, wie sie bei groupby-Objekten entstehen.
In einem früheren Beitrag haben wir groupby-Objekte und das analytische Prinzip Split-Apply-Combine anhand von Netflix-Daten untersucht. Machen wir eine kurze Auffrischung mit einem anderen Dataset: dem in seaborn enthaltenen Tipps-Datensatz. "Tips" enthält Merkmale wie tip, total_bill, den Wochentag und die Tageszeit. Lade und erkunde zuerst die Daten:
# Import and check out data
import seaborn as sns
tips = sns.load_dataset("tips")
tips.head()
| total_bill | tip | sex | smoker | day | time | size | |
|---|---|---|---|---|---|---|---|
| 0 | 16.99 | 1.01 | Female | No | Sun | Dinner | 2 |
| 1 | 10.34 | 1.66 | Male | No | Sun | Dinner | 3 |
| 2 | 21.01 | 3.50 | Male | No | Sun | Dinner | 3 |
| 3 | 23.68 | 3.31 | Male | No | Sun | Dinner | 2 |
| 4 | 24.59 | 3.61 | Female | No | Sun | Dinner | 4 |
Beachte, dass der Index von tips ein RangeIndex ist:
# Check out index
tips.index
RangeIndex(start=0, stop=244, step=1)
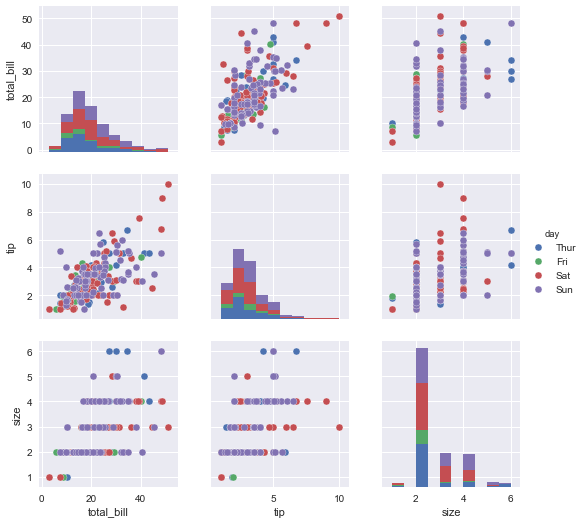
Es hilft immer, vor der Berechnung etwas visuelles EDA zu machen. Die Pairplot-Funktion von seaborn gibt dir einen Überblick über alle numerischen Variablen:
# Import pyplot, figures inline, set style, plot pairplot
import matplotlib.pyplot as plt
%matplotlib inline
sns.set()
sns.pairplot(tips, hue='day');
Wenn du prüfen willst, wie sich das durchschnittliche Trinkgeld zwischen "smokers" und "non-smokers" unterscheidet, kannst du den ursprünglichen DataFrame nach "smoker" splitten (groupby), die Funktion mean anwenden und das Ergebnis kombinieren:
# Get mean of smoker/non-smoker groups
df = tips.groupby('smoker').mean()
df
| total_bill | tip | size | |
|---|---|---|---|
| smoker | |||
| Yes | 20.756344 | 3.008710 | 2.408602 |
| No | 19.188278 | 2.991854 | 2.668874 |
Der resultierende Index des DataFrames df ist die Spalte "smoker" des ursprünglichen DataFrames "tips":
# Check out new index
df.index
CategoricalIndex(['Yes', 'No'], categories=['Yes', 'No'], ordered=False, name='smoker', dtype='category')
Bei Bedarf kannst du den Index zurücksetzen, sodass "smoker" wieder eine Spalte wird:
# Reset the index
df.reset_index()
| smoker | total_bill | tip | size | |
|---|---|---|---|---|
| 0 | Yes | 20.756344 | 3.008710 | 2.408602 |
| 1 | No | 19.188278 | 2.991854 | 2.668874 |
Jetzt schauen wir, wie hierarchische Indizes durch Split-Apply-Combine und groupby entstehen.
Oben hast du den Tipps-Datensatz nach dem Merkmal "smoker" gruppiert. Manchmal musst du nach zwei Merkmalen gruppieren. Naheliegend ist z. B. eine Gruppierung in Raucher/Nichtraucher & Dinner/Lunch. Dazu übergibst du die gewünschten Spaltennamen als Liste:
# Group by two columns
df = tips.groupby(['smoker','time']).mean()
df
| total_bill | tip | size | ||
|---|---|---|---|---|
| smoker | time | |||
| Yes | Lunch | 17.399130 | 2.834348 | 2.217391 |
| Dinner | 21.859429 | 3.066000 | 2.471429 | |
| No | Lunch | 17.050889 | 2.673778 | 2.511111 |
| Dinner | 20.095660 | 3.126887 | 2.735849 |
Wie du siehst, sind sowohl "smoker" als auch "time" Indizes von df. Das ist logisch: Wenn das Gruppieren nach "smoker" diesen Wert zum Index macht, liefert das Gruppieren nach zwei Spalten zwei Index-Ebenen. Prüfe den Index, um zu bestätigen, dass er hierarchisch ist:
# Check out index
df.index
MultiIndex(levels=[['Yes', 'No'], ['Lunch', 'Dinner']],
           labels=[[0, 0, 1, 1], [0, 1, 0, 1]],
           names=['smoker', 'time'])
Genau so ist es. Jetzt kannst du allerlei Nützliches tun, z. B. die Anzahl der Zeilen pro Gruppe bestimmen:
# Group by two features
tips.groupby(['smoker','time']).size()
smoker  time
Yes     Lunch      23
        Dinner     70
No      Lunch      45
        Dinner    106
dtype: int64
Du kannst die Ebenen des hierarchischen Index auch tauschen, sodass "time" vor "smoker" steht:
# Swap levels of multi-index
df.swaplevel()
| total_bill | tip | size | ||
|---|---|---|---|---|
| time | smoker | |||
| Lunch | Yes | 17.399130 | 2.834348 | 2.217391 |
| Dinner | Yes | 21.859429 | 3.066000 | 2.471429 |
| Lunch | No | 17.050889 | 2.673778 | 2.511111 |
| Dinner | No | 20.095660 | 3.126887 | 2.735849 |
Vielleicht möchtest du dann eine dieser Ebenen aus dem hierarchischen Index herauslösen und zu Spalten machen. Das geht mit der Methode unstack:
# Unstack your multi-index
df.unstack()
| total_bill | tip | size | ||||
|---|---|---|---|---|---|---|
| time | Lunch | Dinner | Lunch | Dinner | Lunch | Dinner |
| smoker | ||||||
| Yes | 17.399130 | 21.859429 | 2.834348 | 3.066000 | 2.217391 | 2.471429 |
| No | 17.050889 | 20.095660 | 2.673778 | 3.126887 | 2.511111 | 2.735849 |
Du kannst auch nach der äußeren Ebene des Index "unstacken" — mit dem Keyword-Argument "level":
# Unsstack the outer index
df.unstack(level=0)
| total_bill | tip | size | ||||
|---|---|---|---|---|---|---|
| smoker | Yes | No | Yes | No | Yes | No |
| time | ||||||
| Lunch | 17.399130 | 17.050889 | 2.834348 | 2.673778 | 2.217391 | 2.511111 |
| Dinner | 21.859429 | 20.095660 | 3.066000 | 3.126887 | 2.471429 | 2.735849 |
Das Ergebnis des Unstackings hat erwartungsgemäß einen nicht-hierarchischen Index:
# Check out index
df.unstack().index
CategoricalIndex(['Yes', 'No'], categories=['Yes', 'No'], ordered=False, name='smoker', dtype='category')
Darauf aufbauend kannst du Analysen entlang dieser Gruppierungen durchführen. Probier es aus.
In diesem Beitrag hast du hierarchische Indizes (Multi-Indizes) kennengelernt und gesehen, wie sie entstehen, wenn ein DataFrame-Index die Zeilen eindeutig und sinnvoll kennzeichnen soll. Außerdem hast du gesehen, wie sie auftreten, wenn du deine Daten nach mehreren Spalten gruppierst und damit das Split-Apply-Combine-Prinzip anwendest. Ich wünsche dir viel Spaß mit hierarchischen Indizes in deiner Arbeit.
Dieser Beitrag wurde aus einem Jupyter Notebook generiert. Du findest ihn in diesem Repository. Wenn du Gedanken, Feedback oder Anmerkungen hast, schreib mir gern auf Twitter: @hugobowne.
Schau dir auch weitere hilfreiche pandas-Tutorials von DataCamp an, darunter:
Erfahre mehr über Python und pandas
Kurs
Kurs
Kurs
Tutorial
Sejal Jaiswal
24 Min.
Tutorial
Aditya Sharma
5 Min.
Tutorial
Allan Ouko
11 Min.
Tutorial
Sejal Jaiswal
9 Min.
Tutorial
DataCamp Team
3 Min.
Tutorial
DataCamp Team
5 Min.




