

Bu eğitimdeki kodu çevrimiçi olarak çalıştırın ve düzenleyin
Kodu çalıştır| date | language | ex_complete | |
|---|---|---|---|
| 0 | 2017-01-01 | python | 6 |
| 1 | 2017-01-02 | python | 5 |
| 2 | 2017-01-03 | python | 10 |
DataFrame’in sol tarafında İndeksi görebilirsiniz ve tamsayılardan oluşur. Bu bir RangeIndex’tir:
# Check out index
df.index
RangeIndex(start=0, stop=3, step=1)
Bu indeksi, df’ten bir veya birden fazla satırı dilimlemek için kullanabiliriz:
# Slice and dice data
df.loc[:1]
| date | language | ex_complete | |
|---|---|---|---|
| 0 | 2017-01-01 | python | 6 |
| 1 | 2017-01-02 | python | 5 |
Ancak bu indeks çok bilgilendirici değil. Eğer DataFrame’inizin satırlarını etiketleyecekseniz, mümkünse anlamlı bir şekilde etiketlemek iyi olur. Bunu söz konusu veri setiyle yapabilir misiniz? Bu zorluğu düşünmenin iyi bir yolu, her satır için benzersiz ve anlamlı bir tanımlayıcı istemenizdir. Sütunlara göz atın ve bu ölçütlere uyan bir sütun olup olmadığına bakın. date sütununun benzersiz tarihler içerdiğine dikkat edin; dolayısıyla her satırı tarih sütunuyla etiketlemek mantıklıdır. Yani, date sütununu .set_index() yöntemiyle DataFrame’in indeksi yapabilirsiniz (not: inplace=True, df DataFrame’ini yerinde değiştirdiğiniz anlamına gelir):
# Set new index
df.set_index(pd.DatetimeIndex(df['date']), inplace=True)
df
| date | language | ex_complete | |
|---|---|---|---|
| date | |||
| 2017-01-01 | 2017-01-01 | python | 6 |
| 2017-01-02 | 2017-01-02 | python | 5 |
| 2017-01-03 | 2017-01-03 | python | 10 |
Bu, df’e bir DateTimeIndex verir:
# Check out new index
df.index
DatetimeIndex(['2017-01-01', '2017-01-02', '2017-01-03'], dtype='datetime64[ns]', name='date', freq=None)
Artık oluşturduğunuz DateTimeIndex’i kullanarak satırları dilimleyebilirsiniz:
# Slice and dice data w/ new index
df.loc['2017-01-02']
date 2017-01-02
language python
ex_complete 5
Name: 2017-01-02 00:00:00, dtype: object
Ayrıca .columns özniteliğinin, df’in sütun adlarını içeren bir indeks döndürdüğüne dikkat edin:
# Check out columns
df.columns
Index(['date', 'language', 'ex_complete'], dtype='object')
Bu biraz kafa karıştırıcı olabilir; çünkü burada söylenen, df.columns’ın türünün Index olduğudur. Bu, sütunların DataFrame’in indeksi olduğu anlamına gelmez. df’in indeksi her zaman df.index ile verilir. İndeksler hakkında daha fazla bilgi için pandas DataFrame’leri eğitimimize göz atın. Şimdi hiyerarşik indekslerle tanışma zamanı.
Bir pandas DataFrame’inin Çoklu İndeksi
Veri setimizde birden fazla dil olsaydı, tıpkı DataCamp’te olduğu gibi, ne olurdu? Bakalım:
# Import and check out data
df = pd.read_csv('data/user_ex.csv')
df
| date | language | ex_complete | |
|---|---|---|---|
| 0 | 2017-01-01 | python | 6 |
| 1 | 2017-01-02 | python | 5 |
| 2 | 2017-01-03 | python | 10 |
| 3 | 2017-01-01 | r | 8 |
| 4 | 2017-01-02 | r | 8 |
| 5 | 2017-01-03 | r | 8 |
Artık her tarih birkaç satıra karşılık geliyor; her dil için bir satır. Örneğin, ‘2017-01-02’ tarihinin sırasıyla Python ve R dilleri için 1. ve 4. satırlarda yer aldığına bakın. Dolayısıyla, tarih artık satırı benzersiz olarak belirtmiyor. Ancak ‘date’ ve ‘language’ birlikte satırları benzersiz olarak belirtiyor. Bu nedenle, ikisini de indeks olarak kullanıyoruz:
# Set index
df.set_index(['date', 'language'], inplace=True)
df
| ex_complete | ||
|---|---|---|
| date | language | |
| 2017-01-01 | python | 6 |
| 2017-01-02 | python | 5 |
| 2017-01-03 | python | 10 |
| 2017-01-01 | r | 8 |
| 2017-01-02 | r | 8 |
| 2017-01-03 | r | 8 |
Şimdi bir çoklu indeks ya da hiyerarşik indeks oluşturdunuz (bu terimlerin her ikisiyle de rahat olun; birbirlerinin yerine kullanıldıklarını göreceksiniz) ve bunu aşağıdaki gibi indeksi kontrol ederek görebilirsiniz:
# Check out multi-index
df.index
MultiIndex(levels=[['2017-01-01', '2017-01-02', '2017-01-03'], ['python', 'r']],
labels=[[0, 1, 2, 0, 1, 2], [0, 0, 0, 1, 1, 1]],
names=['date', 'language'])
Yukarıdaki çıktı, DataFrame’inizin df artık iki seviyeye sahip bir MultiIndex’i olduğunu söyler; ilki tarih, ikincisi dil tarafından verilir. Yukarıda, indeksi ve .loc erişimcisini kullanarak DataFrame’i dilimleyebildiğinizi hatırlayın: df.loc('2017-01-02'). Çoklu indeksle dilimleyebilmek için önce indeksi sıralamanız gerekir:
# Sort index
df.sort_index(inplace=True)
df
| ex_complete | ||
|---|---|---|
| date | language | |
| 2017-01-01 | python | 6 |
| r | 8 | |
| 2017-01-02 | python | 5 |
| r | 8 | |
| 2017-01-03 | python | 10 |
| r | 8 |
Artık .loc erişimcisine bir demet (tuple) geçirerek 2017-01-02 tarihinde tamamlanan R alıştırmalarının sayısını dilimleyebilirsiniz:
# Slice & dice your DataFrame
df.loc[('2017-01-02', 'r')]
ex_complete    8
Name: (2017-01-02, r), dtype: int64
Çoklu indeksleri ne zaman ve neden kullanmalı?
Çoklu indeksler, pandas’ta veri analizi ve düzenleme için güçlü bir araçtır. Kullanıcıların hiyerarşik indeksler oluşturmasına olanak tanır; bu da verileri birden fazla boyutta gruplamak ve özetlemek için kullanılabilir. Özellikle finansal ya da zaman serisi gibi çok düzeyli kategorizasyona sahip karmaşık veri setleriyle çalışırken faydalıdır.
Bir çoklu indeks oluşturarak, kullanıcılar verileri aynı anda birden fazla değişkene göre gruplayabilir; bu da tek düzeyli bir gruplamada görünmeyebilecek içgörüleri ortaya çıkarabilir. Örneğin, verileri hem zamana hem de konuma göre gruplamak, analistlerin belirli bölgelerdeki eğilimleri zaman içinde incelemesine olanak tanır.
Ayrıca çoklu indeksler, veriyi verimli biçimde seçmek ve alt kümelere ayırmak için de kullanılabilir; çünkü indeks, verinin belirli alt kümelerine erişmek için kullanışlı bir yol sağlar. Özetle, çoklu indeksler pandas’ta karmaşık veri setlerini düzenlemek, gruplamak ve analiz etmek için güçlü bir araçtır ve hiyerarşik verilerle çalışan her veri analisti veya bilim insanı için temeldir.
Artık hiyerarşik indeksler (ya da çoklu indeksler) hakkında biraz bilgi sahibisiniz. Groupby nesneleriyle çalışırken nasıl ortaya çıktıklarını görme zamanı.
Hiyerarşik İndeksler, groupby Nesneleri ve Split-Apply-Combine
Önceki bir gönderide, netflix verilerini kullanarak groupby nesnelerini ve split-apply-combine veri analizi ilkelerini inceledik. Şimdi, seaborn paketine gömülü tips veri setiyle hızlı bir tazeleme yapalım. ‘Tips’ bahşiş, total_bill, haftanın günü ve günün saati gibi özellikler içerir. Önce veriyi yükleyip inceleyin:
# Import and check out data
import seaborn as sns
tips = sns.load_dataset("tips")
tips.head()
| total_bill | tip | sex | smoker | day | time | size | |
|---|---|---|---|---|---|---|---|
| 0 | 16.99 | 1.01 | Female | No | Sun | Dinner | 2 |
| 1 | 10.34 | 1.66 | Male | No | Sun | Dinner | 3 |
| 2 | 21.01 | 3.50 | Male | No | Sun | Dinner | 3 |
| 3 | 23.68 | 3.31 | Male | No | Sun | Dinner | 2 |
| 4 | 24.59 | 3.61 | Female | No | Sun | Dinner | 4 |
tips’in indeksinin bir RangeIndex olduğuna dikkat edin:
# Check out index
tips.index
RangeIndex(start=0, stop=244, step=1)
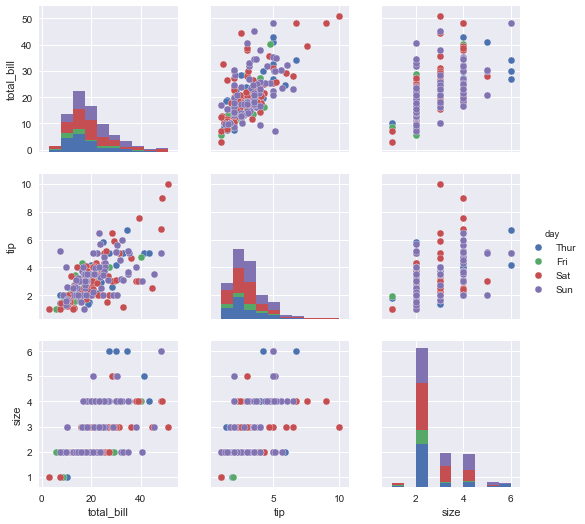
Hesaplamalara dalmadan önce görsel bir EDA yapmak her zaman yardımcı olur ve seaborn’un pairplot fonksiyonu tüm sayısal değişkenlere genel bir bakış sağlar:
# Import pyplot, figures inline, set style, plot pairplot
import matplotlib.pyplot as plt
%matplotlib inline
sns.set()
sns.pairplot(tips, hue='day');
‘smokers’ ve ‘non-smokers’ arasında ortalama bahşişin nasıl farklılaştığını görmek isterseniz, özgün DataFrame’i ‘smoker’ ile bölüp (groupby kullanarak), ‘mean’ fonksiyonunu uygular ve yeni bir DataFrame’e birleştirirsiniz:
# Get mean of smoker/non-smoker groups
df = tips.groupby('smoker').mean()
df
| total_bill | tip | size | |
|---|---|---|---|
| smoker | |||
| Yes | 20.756344 | 3.008710 | 2.408602 |
| No | 19.188278 | 2.991854 | 2.668874 |
Ortaya çıkan df DataFrame’inin indeksi, özgün ‘tips’ DataFrame’inin ‘smoker’ sütunu/özelliğidir:
# Check out new index
df.index
CategoricalIndex(['Yes', 'No'], categories=['Yes', 'No'], ordered=False, name='smoker', dtype='category')
İsterseniz indeksi sıfırlayarak ‘smoker’ın DataFrame’in bir sütunu olmasını sağlayabilirsiniz:
# Reset the index
df.reset_index()
| smoker | total_bill | tip | size | |
|---|---|---|---|---|
| 0 | Yes | 20.756344 | 3.008710 | 2.408602 |
| 1 | No | 19.188278 | 2.991854 | 2.668874 |
Şimdi, hiyerarşik indekslerin split-apply-combine ve groupby işlemlerinden nasıl ortaya çıktığını görelim.
Çoklu gruplamalar ve hiyerarşik indeksler
Yukarıda, tips veri setini ‘smoker’ özelliğine göre grupladınız. Bazen bir veri setini iki özelliğe göre gruplamanız gerekir. Örneğin, tips veri setini sigara içen/içmeyen & akşam yemeği/öğle yemeği olarak gruplamak doğaldır. Bunu yapmak için, gruplanmasını istediğiniz sütun adlarını bir liste olarak geçirirsiniz:
# Group by two columns
df = tips.groupby(['smoker','time']).mean()
df
| total_bill | tip | size | ||
|---|---|---|---|---|
| smoker | time | |||
| Yes | Lunch | 17.399130 | 2.834348 | 2.217391 |
| Dinner | 21.859429 | 3.066000 | 2.471429 | |
| No | Lunch | 17.050889 | 2.673778 | 2.511111 |
| Dinner | 20.095660 | 3.126887 | 2.735849 |
Yukarıdakine bakınca, hem ‘smoker’ hem de ‘time’ın df’in indeksleri olduğunu görebilirsiniz. Bu doğrudur ve mantıklıdır: ‘smoker’a göre gruplamak, indeksin özgün ‘smoker’ sütunu olmasına yol açıyorsa, iki sütuna göre gruplamak size iki indeks verir. Hiyerarşik olduğunu doğrulamak için indeksi kontrol edin:
# Check out index
df.index
MultiIndex(levels=[['Yes', 'No'], ['Lunch', 'Dinner']],
labels=[[0, 0, 1, 1], [0, 1, 0, 1]],
names=['smoker', 'time'])
Ve öyledir. Artık her bir gruptaki sayımları almak gibi bir sürü faydalı şey yapabilirsiniz:
# Group by two features
tips.groupby(['smoker','time']).size()
smoker time
Yes Lunch 23
Dinner 70
No Lunch 45
Dinner 106
dtype: int64
Hiyerarşik indeksin seviyelerini de değiştirebilir, böylece indekste ‘time’ ‘smoker’dan önce gelebilir:
# Swap levels of multi-index
df.swaplevel()
| total_bill | tip | size | ||
|---|---|---|---|---|
| time | smoker | |||
| Lunch | Yes | 17.399130 | 2.834348 | 2.217391 |
| Dinner | Yes | 21.859429 | 3.066000 | 2.471429 |
| Lunch | No | 17.050889 | 2.673778 | 2.511111 |
| Dinner | No | 20.095660 | 3.126887 | 2.735849 |
Daha sonra bu hiyerarşik indeksten bir özelliği kaldırıp, o özelliğe göre farklı sütunlar oluşturmak isteyebilirsiniz. Bunu unstack yöntemiyle yapabilirsiniz:
# Unstack your multi-index
df.unstack()
| total_bill | tip | size | ||||
|---|---|---|---|---|---|---|
| time | Lunch | Dinner | Lunch | Dinner | Lunch | Dinner |
| smoker | ||||||
| Yes | 17.399130 | 21.859429 | 2.834348 | 3.066000 | 2.217391 | 2.471429 |
| No | 17.050889 | 20.095660 | 2.673778 | 3.126887 | 2.511111 | 2.735849 |
Dıştaki indeks özelliğinde unstack yapmak için ‘level’ anahtar argümanını kullanabilirsiniz:
# Unsstack the outer index
df.unstack(level=0)
| total_bill | tip | size | ||||
|---|---|---|---|---|---|---|
| smoker | Yes | No | Yes | No | Yes | No |
| time | ||||||
| Lunch | 17.399130 | 17.050889 | 2.834348 | 2.673778 | 2.217391 | 2.511111 |
| Dinner | 21.859429 | 20.095660 | 3.066000 | 3.126887 | 2.471429 | 2.735849 |
Unstack işleminin sonucu beklendiği gibi hiyerarşik olmayan bir indekse sahiptir:
# Check out index
df.unstack().index
CategoricalIndex(['Yes', 'No'], categories=['Yes', 'No'], ordered=False, name='smoker', dtype='category')
Sonuç olarak, artık bu gruplamalara göre her türlü veri analizini gerçekleştirebilirsiniz. Sizi bunu yapmaya teşvik ediyorum.
Günlük Kullanımda Hiyerarşik İndeksler
Bu yazıda hiyerarşik indekslerle (ya da çoklu indekslerle) tanıştınız ve DataFrame indeksinin satırları benzersiz ve anlamlı şekilde etiketlemesi isteğinin doğal bir sonucu olarak nasıl ortaya çıktıklarını gördünüz. Ayrıca, verinizi birden çok sütuna göre gruplamanız gerektiğinde, split-apply-combine ilkesini çağırarak nasıl ortaya çıktıklarını da gördünüz. Hiyerarşik indekslerle çalışırken keyif almanızı umuyorum.
Bu gönderi bir Jupyter Notebook’tan üretildi; bu depoda bulabilirsiniz. Düşünceleriniz, yanıtlarınız ve/veya üzerinde kafa yorduklarınız olursa, Twitter’da bana ulaşmaktan çekinmeyin: @hugobowne.
DataCamp’in diğer kullanışlı pandas eğitimlerine de göz atın:





Önceki bir gönderide, groupby işleminin nasıl split-apply-combine ilkesinin doğal bir sonucu olarak ortaya çıktığını gördünüz. Netflix kullanıcı puanlarından oluşan bir veri setine göz attınız ve satırları filmin vizyon yılına göre gruplayarak aşağıdaki görseli oluşturdunuz:
Bu, tek bir sütuna göre gruplayarak elde edildi. Arada, birkaç sütuna göre de gruplamak isteyebileceğinizden ve bu durumda ortaya çıkan pandas DataFrame’inin çoklu indeks ya da hiyerarşik indeks ile sonuçlanacağından bahsetmiştim. Bu yazıda, hiyerarşik indekslerin ne olduğunu öğrenecek ve verinizi birkaç özelliğe göre grupladığınızda nasıl ortaya çıktığını göreceksiniz. Bu kavram ve uygulamaların tümü hakkında daha fazlasını pandas ile DataFrame’leri Manipüle Etme kursumuzda bulabilirsiniz.
Önce şunu soralım: Hiyerarşik indeksler nedir?
Hiyerarşik İndeksler ve pandas DataFrame’leri
Bir DataFrame’in İndeksi Nedir?
Hiyerarşik indeksleri tanıtmadan önce, pandas DataFrame’inin indeksinin ne olduğunu hatırlatmak istiyorum. Bir DataFrame’in indeksi, her satır için bir etiketten oluşan bir kümedir. Bir örneğe bakalım. Önce, hayali bir DataCamp öğrencisi Ellie’nin DataCamp’teki aktivitesine ait sentetik bir veri setini içe aktaracağım. Sütunlar bir tarih, bir programlama dili ve Ellie’nin o gün o dilde tamamladığı alıştırma sayısıdır. Veriyi yükleyin: