

Voer de code van deze tutorial online uit en bewerk deze
Code uitvoeren| date | language | ex_complete | |
|---|---|---|---|
| 0 | 2017-01-01 | python | 6 |
| 1 | 2017-01-02 | python | 5 |
| 2 | 2017-01-03 | python | 10 |
Je ziet de index aan de linkerkant van de DataFrame, en die bestaat uit gehele getallen. Dit is een RangeIndex:
# Check out index
df.index
RangeIndex(start=0, stop=3, step=1)
We kunnen deze index gebruiken om één of meerdere rijen uit df te selecteren:
# Slice and dice data
df.loc[:1]
| date | language | ex_complete | |
|---|---|---|---|
| 0 | 2017-01-01 | python | 6 |
| 1 | 2017-01-02 | python | 5 |
Deze index is echter niet zo informatief. Als je de rijen van je DataFrame gaat labelen, is het goed om dat op een betekenisvolle manier te doen, als dat mogelijk is. Kun je dat met deze dataset? Een goede manier om hierover na te denken is dat je een unieke en betekenisvolle identificator voor elke rij wilt. Bekijk de kolommen en kijk of er een aan deze criteria voldoet. Merk op dat de kolom date unieke datums bevat, dus het is logisch om elke rij te labelen met de datumkolom. Dat wil zeggen, je kunt de kolom date de index van de DataFrame maken met de methode .set_index() (n.b. inplace=True betekent dat je de DataFrame df daadwerkelijk ter plekke aanpast):
# Set new index
df.set_index(pd.DatetimeIndex(df['date']), inplace=True)
df
| date | language | ex_complete | |
|---|---|---|---|
| date | |||
| 2017-01-01 | 2017-01-01 | python | 6 |
| 2017-01-02 | 2017-01-02 | python | 5 |
| 2017-01-03 | 2017-01-03 | python | 10 |
Dit geeft df vervolgens een DateTimeIndex:
# Check out new index
df.index
DatetimeIndex(['2017-01-01', '2017-01-02', '2017-01-03'], dtype='datetime64[ns]', name='date', freq=None)
Nu kun je rijen selecteren met de DateTimeIndex die je hebt gemaakt:
# Slice and dice data w/ new index
df.loc['2017-01-02']
date 2017-01-02
language python
ex_complete 5
Name: 2017-01-02 00:00:00, dtype: object
Let ook op dat het attribuut .columns een index teruggeeft die de kolomnamen van df bevat:
# Check out columns
df.columns
Index(['date', 'language', 'ex_complete'], dtype='object')
Dit kan een beetje verwarrend zijn, omdat dit zegt dat df.columns van het type Index is. Dit betekent niet dat de kolommen de index van de DataFrame zijn. De index van df wordt altijd gegeven door df.index. Bekijk onze pandas DataFrames-tutorial voor meer over indexen. Tijd om hiërarchische indexen te leren kennen.
De multi-index van een pandas DataFrame
Wat als we meerdere talen in onze dataset hadden, zoals bij DataCamp? Kijk maar:
# Import and check out data
df = pd.read_csv('data/user_ex.csv')
df
| date | language | ex_complete | |
|---|---|---|---|
| 0 | 2017-01-01 | python | 6 |
| 1 | 2017-01-02 | python | 5 |
| 2 | 2017-01-03 | python | 10 |
| 3 | 2017-01-01 | r | 8 |
| 4 | 2017-01-02 | r | 8 |
| 5 | 2017-01-03 | r | 8 |
Elke datum komt nu overeen met meerdere rijen, één voor elke taal. Zie bijvoorbeeld dat de datum '2017-01-02' voorkomt in rijen 1 en 4, voor respectievelijk Python en R. De datum specificeert de rij dus niet langer uniek. Samen specificeren 'date' en 'language' de rijen echter wél uniek. Daarom gebruiken we beide als index:
# Set index
df.set_index(['date', 'language'], inplace=True)
df
| ex_complete | ||
|---|---|---|
| date | language | |
| 2017-01-01 | python | 6 |
| 2017-01-02 | python | 5 |
| 2017-01-03 | python | 10 |
| 2017-01-01 | r | 8 |
| 2017-01-02 | r | 8 |
| 2017-01-03 | r | 8 |
Je hebt nu een multi-index of hiërarchische index gemaakt (raak vertrouwd met beide termen, want ze worden door elkaar gebruikt), en je kunt dit zien door de index als volgt te bekijken:
# Check out multi-index
df.index
MultiIndex(levels=[['2017-01-01', '2017-01-02', '2017-01-03'], ['python', 'r']],
labels=[[0, 1, 2, 0, 1, 2], [0, 0, 0, 1, 1, 1]],
names=['date', 'language'])
Hieruit blijkt dat je DataFrame df nu een MultiIndex heeft met twee niveaus, het eerste gegeven door de datum, het tweede door de taal. Bedenk dat je hierboven de DataFrame kon slicen met behulp van de index en de .loc-accessor: df.loc['2017-01-02']. Om te kunnen slicen met een multi-index moet je de index eerst sorteren:
# Sort index
df.sort_index(inplace=True)
df
| ex_complete | ||
|---|---|---|
| date | language | |
| 2017-01-01 | python | 6 |
| r | 8 | |
| 2017-01-02 | python | 5 |
| r | 8 | |
| 2017-01-03 | python | 10 |
| r | 8 |
Nu kun je het aantal R-oefeningen dat is voltooid op 2017-01-02 selecteren door een tuple door te geven aan de .loc-accessor:
# Slice & dice your DataFrame
df.loc[('2017-01-02', 'r')]
ex_complete    8
Name: (2017-01-02, r), dtype: int64
Wanneer en waarom multi-indexen gebruiken
Multi-indexen zijn een krachtig hulpmiddel voor data-analyse en -organisatie in pandas. Ze laten je hiërarchische indexen maken, die je kunt gebruiken om data te groeperen en te aggregeren over meerdere dimensies. Multi-indexen zijn vooral handig bij complexe datasets met meerdere niveaus van categorisering, zoals financiële data of tijdreeksen.
Door een multi-index te maken, kun je data tegelijk op meerdere variabelen groeperen, wat inzichten kan opleveren die bij groeperen op één niveau niet zichtbaar zijn. Zo kun je bijvoorbeeld data groeperen op zowel tijd als locatie, zodat analisten trends in specifieke regio’s over de tijd kunnen onderzoeken.
Bovendien kun je met multi-indexen efficiënt selecteren en subsetten, omdat de index een handige manier biedt om specifieke deelverzamelingen van de data te benaderen. Kortom, multi-indexen zijn een krachtig middel om complexe datasets in pandas te organiseren, te groeperen en te analyseren, en zijn onmisbaar voor elke data-analist of -scientist die met hiërarchische data werkt.
Je weet nu het een en ander over hiërarchische indexen (of multi-indexen). Tijd om te zien hoe ze ontstaan bij het werken met groupby-objecten.
Hiërarchische indexen, groupby-objecten en split-apply-combine
In een eerdere post verkenden we groupby-objecten en het data-analytische principe split-apply-combine met netflix-data. Laten we snel opfrissen met een andere dataset: de tips-dataset die is ingebouwd in het pakket seaborn. ‘Tips’ bevat kenmerken zoals tip, total_bill, de dag van de week en het tijdstip. Laad en verken de data eerst:
# Import and check out data
import seaborn as sns
tips = sns.load_dataset("tips")
tips.head()
| total_bill | tip | sex | smoker | day | time | size | |
|---|---|---|---|---|---|---|---|
| 0 | 16.99 | 1.01 | Female | No | Sun | Dinner | 2 |
| 1 | 10.34 | 1.66 | Male | No | Sun | Dinner | 3 |
| 2 | 21.01 | 3.50 | Male | No | Sun | Dinner | 3 |
| 3 | 23.68 | 3.31 | Male | No | Sun | Dinner | 2 |
| 4 | 24.59 | 3.61 | Female | No | Sun | Dinner | 4 |
Merk op dat de index van tips een RangeIndex is:
# Check out index
tips.index
RangeIndex(start=0, stop=244, step=1)
Het helpt altijd om eerst wat visuele EDA te doen voordat je gaat rekenen, en de pairplot-functie van seaborn geeft je een overzicht van alle numerieke variabelen:
# Import pyplot, figures inline, set style, plot pairplot
import matplotlib.pyplot as plt
%matplotlib inline
sns.set()
sns.pairplot(tips, hue='day');
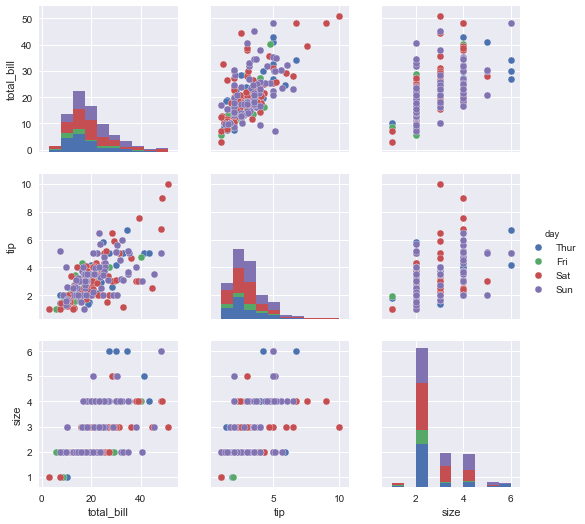
Als je wilt bekijken hoe de gemiddelde fooi verschilt tussen ‘smokers’ en ‘non-smokers’, kun je de oorspronkelijke DataFrame splitsen op ‘smoker’ (met groupby), de functie ‘mean’ toepassen en combineren in een nieuwe DataFrame:
# Get mean of smoker/non-smoker groups
df = tips.groupby('smoker').mean()
df
| total_bill | tip | size | |
|---|---|---|---|
| smoker | |||
| Yes | 20.756344 | 3.008710 | 2.408602 |
| No | 19.188278 | 2.991854 | 2.668874 |
De resulterende index van de DataFrame df is de kolom/feature ‘smoker’ van de oorspronkelijke ‘tips’-DataFrame:
# Check out new index
df.index
CategoricalIndex(['Yes', 'No'], categories=['Yes', 'No'], ordered=False, name='smoker', dtype='category')
Indien gewenst kun je de index resetten zodat ‘smoker’ een kolom van de DataFrame wordt:
# Reset the index
df.reset_index()
| smoker | total_bill | tip | size | |
|---|---|---|---|---|
| 0 | Yes | 20.756344 | 3.008710 | 2.408602 |
| 1 | No | 19.188278 | 2.991854 | 2.668874 |
Nu is het tijd om te ontdekken hoe hiërarchische indexen ontstaan uit split-apply-combine en groupby-bewerkingen.
Meerdere groeperingen en hiërarchische indexen
Hierboven groepeerde je de tips-dataset op basis van de feature ‘smoker’. Soms moet je een dataset groeperen op twee features. Het is bijvoorbeeld logisch om de tips-dataset te verdelen in smokers/non-smokers & dinner/lunch. Hiervoor geef je de kolomnamen waar je op wilt groeperen door als lijst:
# Group by two columns
df = tips.groupby(['smoker','time']).mean()
df
| total_bill | tip | size | ||
|---|---|---|---|---|
| smoker | time | |||
| Yes | Lunch | 17.399130 | 2.834348 | 2.217391 |
| Dinner | 21.859429 | 3.066000 | 2.471429 | |
| No | Lunch | 17.050889 | 2.673778 | 2.511111 |
| Dinner | 20.095660 | 3.126887 | 2.735849 |
Als je hierboven kijkt, zie je mogelijk dat zowel ‘smoker’ als ‘time’ indexen van df zijn. Dat klopt en is logisch: als groeperen op ‘smoker’ ertoe leidt dat de index de oorspronkelijke kolom ‘smoker’ wordt, dan krijg je bij groeperen op twee kolommen twee indexen. Controleer de index om te bevestigen dat deze hiërarchisch is:
# Check out index
df.index
MultiIndex(levels=[['Yes', 'No'], ['Lunch', 'Dinner']],
labels=[[0, 0, 1, 1], [0, 1, 0, 1]],
names=['smoker', 'time'])
En dat is zo. Je kunt nu van alles doen, zoals de aantallen in elke groepering ophalen:
# Group by two features
tips.groupby(['smoker','time']).size()
smoker time
Yes Lunch 23
Dinner 70
No Lunch 45
Dinner 106
dtype: int64
Je kunt ook de niveaus van de hiërarchische index wisselen zodat ‘time’ vóór ‘smoker’ in de index komt:
# Swap levels of multi-index
df.swaplevel()
| total_bill | tip | size | ||
|---|---|---|---|---|
| time | smoker | |||
| Lunch | Yes | 17.399130 | 2.834348 | 2.217391 |
| Dinner | Yes | 21.859429 | 3.066000 | 2.471429 |
| Lunch | No | 17.050889 | 2.673778 | 2.511111 |
| Dinner | No | 20.095660 | 3.126887 | 2.735849 |
Je wilt daarna misschien een van deze features uit de hiërarchische index verwijderen en verschillende kolommen vormen ten opzichte van die feature. Dat kan met de methode unstack:
# Unstack your multi-index
df.unstack()
| total_bill | tip | size | ||||
|---|---|---|---|---|---|---|
| time | Lunch | Dinner | Lunch | Dinner | Lunch | Dinner |
| smoker | ||||||
| Yes | 17.399130 | 21.859429 | 2.834348 | 3.066000 | 2.217391 | 2.471429 |
| No | 17.050889 | 20.095660 | 2.673778 | 3.126887 | 2.511111 | 2.735849 |
Je kunt unstacken op de buitenste feature van de index met het keyword-argument ‘level’:
# Unsstack the outer index
df.unstack(level=0)
| total_bill | tip | size | ||||
|---|---|---|---|---|---|---|
| smoker | Yes | No | Yes | No | Yes | No |
| time | ||||||
| Lunch | 17.399130 | 17.050889 | 2.834348 | 2.673778 | 2.217391 | 2.511111 |
| Dinner | 21.859429 | 20.095660 | 3.066000 | 3.126887 | 2.471429 | 2.735849 |
Het resultaat van unstacken heeft, zoals je zou verwachten, een niet-hiërarchische index:
# Check out index
df.unstack().index
CategoricalIndex(['Yes', 'No'], categories=['Yes', 'No'], ordered=False, name='smoker', dtype='category')
Daardoor kun je nu allerlei soorten data-analyses uitvoeren met betrekking tot deze groeperingen. Ik moedig je aan dat te doen.
Hiërarchische indexen in alledaags gebruik
In deze post heb je kennisgemaakt met hiërarchische indexen (of multi-indexen) en gezien hoe ze op natuurlijke wijze ontstaan uit de wens om een DataFrame-index te hebben die de rijen van je DataFrame uniek en betekenisvol labelt. Je hebt ook gezien hoe ze ontstaan wanneer je je data op meerdere kolommen moet groeperen, volgens het principe van split-apply-combine. Ik hoop dat je plezier hebt met hiërarchische indexen in je werk.
Deze post is gegenereerd vanuit een Jupyter Notebook; je vindt hem in deze repository. Als je gedachten, reacties en/of overpeinzingen hebt, neem gerust contact met me op via Twitter: @hugobowne.
Bekijk ook andere handige pandas-tutorials van DataCamp, waaronder:


In een eerdere post zag je hoe de groupby-bewerking op een natuurlijke manier voortkomt uit het principe split-apply-combine. Je bekeek een dataset met gebruikersbeoordelingen van Netflix en groepeerde de rijen op basis van het uitbrengjaar van de film om de volgende figuur te maken:
Dit werd bereikt door te groeperen op één kolom. Ik noemde terloops dat je ook op meerdere kolommen kunt groeperen; in dat geval krijgt de resulterende pandas DataFrame een multi-index of hiërarchische index. In deze post leer je wat hiërarchische indexen zijn en zie je hoe ze ontstaan wanneer je groepeert op meerdere kenmerken van je data. Je kunt meer leren over al deze concepten en praktijken in onze Manipulating DataFrames with pandas-cursus.
Dus eerst: wat zijn hiërarchische indexen?
Hiërarchische indexen en pandas DataFrames
Wat is de index van een DataFrame?
Voordat we hiërarchische indexen introduceren, wil ik dat je je herinnert wat de index van een pandas DataFrame is. De index van een DataFrame is een verzameling die bestaat uit een label voor elke rij. Laten we een voorbeeld bekijken. Ik importeer eerst een synthetische dataset van de activiteiten van een hypothetische DataCamp-student Ellie op DataCamp. De kolommen zijn een datum, een programmeertaal en het aantal oefeningen dat Ellie die dag in die taal heeft voltooid. Laad de data in: