
Last chance! 50% off DataCamp Premium
Sale ends in
In un post precedente hai visto come l’operazione di groupby emerga in modo naturale attraverso il principio split-apply-combine. Hai esaminato un dataset con le valutazioni degli utenti Netflix e raggruppato le righe per anno di uscita del film per generare la figura seguente:
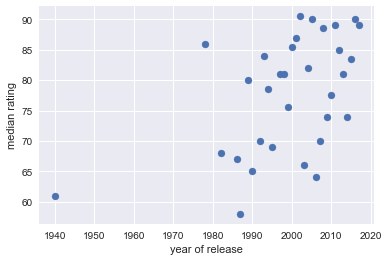
Questo risultato è stato ottenuto raggruppando per una singola colonna. Ho accennato, di sfuggita, che potresti voler raggruppare per più colonne: in tal caso, il DataFrame pandas risultante avrà un multi-index o indice gerarchico. In questo post imparerai cosa sono gli indici gerarchici e vedrai come si generano quando raggruppi in base a più caratteristiche dei tuoi dati. Puoi approfondire tutti questi concetti e pratiche nel nostro corso Manipulating DataFrames with pandas.
Partiamo: cosa sono gli indici gerarchici?
Prima di introdurre gli indici gerarchici, voglio che tu ricordi cos’è l’indice di un DataFrame pandas. L’indice di un DataFrame è un insieme composto da un’etichetta per ogni riga. Vediamo un esempio. Importerò innanzitutto un dataset sintetico con l’attività su DataCamp di Ellie, una studentessa ipotetica. Le colonne sono una data, un linguaggio di programmazione e il numero di esercizi che Ellie ha completato quel giorno in quel linguaggio. Carica i dati:
# Import pandas
import pandas as pd

# Load in data
df = pd.read_csv('data/user_ex_python.csv')
df
Esegui e modifica il codice da questo tutorial online
Esegui codice| date | language | ex_complete | |
|---|---|---|---|
| 0 | 2017-01-01 | python | 6 |
| 1 | 2017-01-02 | python | 5 |
| 2 | 2017-01-03 | python | 10 |
Puoi vedere l’indice sul lato sinistro del DataFrame, ed è composto da interi. Si tratta di un RangeIndex:
# Check out index
df.index
RangeIndex(start=0, stop=3, step=1)
Possiamo usare questo indice per estrarre una o più righe di df:
# Slice and dice data
df.loc[:1]
| date | language | ex_complete | |
|---|---|---|---|
| 0 | 2017-01-01 | python | 6 |
| 1 | 2017-01-02 | python | 5 |
Tuttavia, questo indice non è molto informativo. Se vuoi etichettare le righe del tuo DataFrame, è meglio farlo in modo significativo, quando possibile. Si può fare con questo dataset? Un buon modo di affrontare la cosa è cercare un identificatore univoco e significativo per ogni riga. Dai un’occhiata alle colonne e verifica se qualcuna soddisfa questi criteri. Nota che la colonna date contiene date univoche, quindi ha senso etichettare ogni riga con la data. Cioè, puoi rendere la colonna date l’indice del DataFrame usando il metodo .set_index() (n.b. inplace=True significa che stai modificando effettivamente il DataFrame df in place):
# Set new index
df.set_index(pd.DatetimeIndex(df['date']), inplace=True)
df
| date | language | ex_complete | |
|---|---|---|---|
| date | |||
| 2017-01-01 | 2017-01-01 | python | 6 |
| 2017-01-02 | 2017-01-02 | python | 5 |
| 2017-01-03 | 2017-01-03 | python | 10 |
Questo assegna a df un DateTimeIndex:
# Check out new index
df.index
DatetimeIndex(['2017-01-01', '2017-01-02', '2017-01-03'], dtype='datetime64[ns]', name='date', freq=None)
Ora puoi estrarre righe usando il DateTimeIndex che hai creato:
# Slice and dice data w/ new index
df.loc['2017-01-02']
date           2017-01-02
language           python
ex_complete             5
Name: 2017-01-02 00:00:00, dtype: object
Nota anche che l’attributo .columns restituisce un indice contenente i nomi delle colonne di df:
# Check out columns
df.columns
Index(['date', 'language', 'ex_complete'], dtype='object')
Questo può creare un po’ di confusione, perché indica che df.columns è di tipo Index. Questo non significa che le colonne siano l’indice del DataFrame. L’indice di df è sempre dato da df.index. Dai un’occhiata al nostro tutorial sui DataFrame di pandas per saperne di più sugli indici. Ora è il momento di incontrare gli indici gerarchici.
E se avessimo più linguaggi nel nostro dataset, come succede su DataCamp? Guarda qui:
# Import and check out data
df = pd.read_csv('data/user_ex.csv')
df
| date | language | ex_complete | |
|---|---|---|---|
| 0 | 2017-01-01 | python | 6 |
| 1 | 2017-01-02 | python | 5 |
| 2 | 2017-01-03 | python | 10 |
| 3 | 2017-01-01 | r | 8 |
| 4 | 2017-01-02 | r | 8 |
| 5 | 2017-01-03 | r | 8 |
Ora ogni data corrisponde a più righe, una per ciascun linguaggio. Ad esempio, la data ‘2017-01-02’ appare nelle righe 1 e 4, per i linguaggi Python e R rispettivamente. Quindi la data non specifica più univocamente la riga. Tuttavia, ‘date’ e ‘language’ insieme la specificano in modo univoco. Per questo motivo usiamo entrambe come indice:
# Set index
df.set_index(['date', 'language'], inplace=True)
df
| ex_complete | ||
|---|---|---|
| date | language | |
| 2017-01-01 | python | 6 |
| 2017-01-02 | python | 5 |
| 2017-01-03 | python | 10 |
| 2017-01-01 | r | 8 |
| 2017-01-02 | r | 8 |
| 2017-01-03 | r | 8 |
Hai appena creato un multi-index, o indice gerarchico (abituati a entrambi i termini, li troverai usati in modo intercambiabile), e puoi verificarlo controllando l’indice come segue:
# Check out multi-index
df.index
MultiIndex(levels=[['2017-01-01', '2017-01-02', '2017-01-03'], ['python', 'r']],
           labels=[[0, 1, 2, 0, 1, 2], [0, 0, 0, 1, 1, 1]],
           names=['date', 'language'])
Quanto sopra ti dice che il tuo DataFrame df ora ha un MultiIndex con due livelli, il primo dato dalla data, il secondo dal linguaggio. Ricorda che prima potevi eseguire slicing del DataFrame usando l’indice e l’accessor .loc: df.loc['2017-01-02']. Per poter fare slicing con un multi-index, devi prima ordinarlo:
# Sort index
df.sort_index(inplace=True)
df
| ex_complete | ||
|---|---|---|
| date | language | |
| 2017-01-01 | python | 6 |
| r | 8 | |
| 2017-01-02 | python | 5 |
| r | 8 | |
| 2017-01-03 | python | 10 |
| r | 8 |
Ora puoi estrarre il numero di esercizi in R completati il 2017-01-02 passando una tupla all’accessor .loc:
# Slice & dice your DataFrame
df.loc[('2017-01-02', 'r')]
ex_complete    8
Name: (2017-01-02, r), dtype: int64
I multi-index sono uno strumento potente per l’analisi e l’organizzazione dei dati in pandas. Permettono di creare indici gerarchici, utili per raggruppare e aggregare i dati su più dimensioni. Sono particolarmente utili con dataset complessi che presentano più livelli di categorizzazione, come dati finanziari o serie temporali.
Creando un multi-index, puoi raggruppare i dati simultaneamente per più variabili, rivelando insight che potrebbero non emergere con un raggruppamento a singolo livello. Ad esempio, i multi-index permettono di raggruppare per tempo e località, consentendo di analizzare i trend in specifiche regioni nel tempo.
Inoltre, i multi-index consentono selezioni e sottoinsiemi efficienti, poiché l’indice offre un modo comodo per accedere a subset specifici dei dati. In sintesi, i multi-index sono fondamentali per organizzare, raggruppare e analizzare dataset complessi in pandas e sono essenziali per chiunque lavori con dati gerarchici.
Ora che conosci gli indici gerarchici (o multi-indici), vediamo come emergono lavorando con gli oggetti groupby.
In un post precedente abbiamo esplorato gli oggetti groupby e i principi analitici di split-apply-combine usando dati di Netflix. Facciamo un rapido ripasso con un dataset diverso, il dataset tips incluso nel pacchetto seaborn. ‘Tips’ contiene caratteristiche come tip, total_bill, il giorno della settimana e l’orario. Per prima cosa carica ed esplora i dati:
# Import and check out data
import seaborn as sns
tips = sns.load_dataset("tips")
tips.head()
| total_bill | tip | sex | smoker | day | time | size | |
|---|---|---|---|---|---|---|---|
| 0 | 16.99 | 1.01 | Female | No | Sun | Dinner | 2 |
| 1 | 10.34 | 1.66 | Male | No | Sun | Dinner | 3 |
| 2 | 21.01 | 3.50 | Male | No | Sun | Dinner | 3 |
| 3 | 23.68 | 3.31 | Male | No | Sun | Dinner | 2 |
| 4 | 24.59 | 3.61 | Female | No | Sun | Dinner | 4 |
Nota che l’indice di tips è un RangeIndex:
# Check out index
tips.index
RangeIndex(start=0, stop=244, step=1)
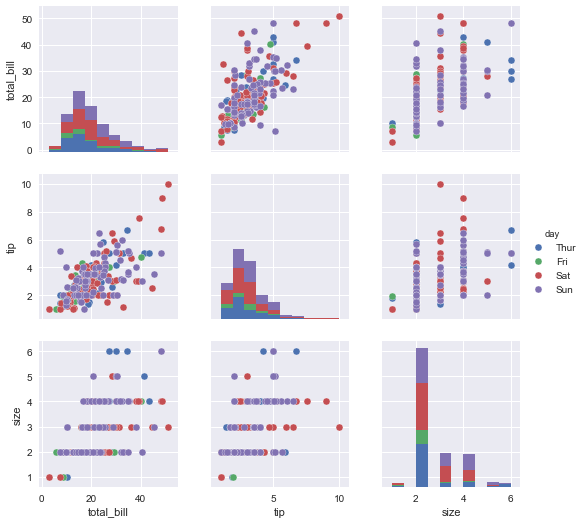
È sempre utile fare un po’ di EDA visiva prima di tuffarsi nei calcoli e la funzione pairplot di seaborn ti permette di avere una panoramica di tutte le variabili numeriche:
# Import pyplot, figures inline, set style, plot pairplot
import matplotlib.pyplot as plt
%matplotlib inline
sns.set()
sns.pairplot(tips, hue='day');
Se vuoi vedere come differisce la mancia media tra ‘smokers’ e ‘non-smokers’, puoi dividere il DataFrame originale per ‘smoker’ (usando groupby), applicare la funzione ‘mean’ e combinare in un nuovo DataFrame:
# Get mean of smoker/non-smoker groups
df = tips.groupby('smoker').mean()
df
| total_bill | tip | size | |
|---|---|---|---|
| smoker | |||
| Yes | 20.756344 | 3.008710 | 2.408602 |
| No | 19.188278 | 2.991854 | 2.668874 |
L’indice risultante del DataFrame df è la colonna/feature ‘smoker’ del DataFrame ‘tips’ originale:
# Check out new index
df.index
CategoricalIndex(['Yes', 'No'], categories=['Yes', 'No'], ordered=False, name='smoker', dtype='category')
Se vuoi, puoi resettare l’indice così che ‘smoker’ torni a essere una colonna del DataFrame:
# Reset the index
df.reset_index()
| smoker | total_bill | tip | size | |
|---|---|---|---|---|
| 0 | Yes | 20.756344 | 3.008710 | 2.408602 |
| 1 | No | 19.188278 | 2.991854 | 2.668874 |
Ora è il momento di vedere come gli indici gerarchici derivino da split-apply-combine e dalle operazioni di groupby.
Qui sopra hai raggruppato il dataset tips in base alla feature ‘smoker’. A volte avrai bisogno di raggruppare un dataset in base a due feature. Ad esempio, è naturale raggruppare tips in fumatori/non fumatori & cena/pranzo. Per farlo, passa come lista i nomi delle colonne per cui vuoi raggruppare:
# Group by two columns
df = tips.groupby(['smoker','time']).mean()
df
| total_bill | tip | size | ||
|---|---|---|---|---|
| smoker | time | |||
| Yes | Lunch | 17.399130 | 2.834348 | 2.217391 |
| Dinner | 21.859429 | 3.066000 | 2.471429 | |
| No | Lunch | 17.050889 | 2.673778 | 2.511111 |
| Dinner | 20.095660 | 3.126887 | 2.735849 |
Guardando sopra, potresti notare che sia ‘smoker’ che ‘time’ sono indici di df. È così e ha senso: se raggruppare per ‘smoker’ rende l’indice la colonna ‘smoker’ originale, raggruppare per due colonne ti darà due indici. Controlla l’indice per confermare che sia gerarchico:
# Check out index
df.index
MultiIndex(levels=[['Yes', 'No'], ['Lunch', 'Dinner']],
           labels=[[0, 0, 1, 1], [0, 1, 0, 1]],
           names=['smoker', 'time'])
Ed è così. Ora puoi fare un sacco di cose utili, come ottenere le frequenze in ciascun raggruppamento:
# Group by two features
tips.groupby(['smoker','time']).size()
smoker  time
Yes     Lunch      23
        Dinner     70
No      Lunch      45
        Dinner    106
dtype: int64
Puoi anche scambiare i livelli dell’indice gerarchico, così che ‘time’ venga prima di ‘smoker’ nell’indice:
# Swap levels of multi-index
df.swaplevel()
| total_bill | tip | size | ||
|---|---|---|---|---|
| time | smoker | |||
| Lunch | Yes | 17.399130 | 2.834348 | 2.217391 |
| Dinner | Yes | 21.859429 | 3.066000 | 2.471429 |
| Lunch | No | 17.050889 | 2.673778 | 2.511111 |
| Dinner | No | 20.095660 | 3.126887 | 2.735849 |
Potresti poi voler rimuovere una di queste feature dall’indice gerarchico e creare colonne diverse rispetto a quella feature. Puoi farlo con il metodo unstack:
# Unstack your multi-index
df.unstack()
| total_bill | tip | size | ||||
|---|---|---|---|---|---|---|
| time | Lunch | Dinner | Lunch | Dinner | Lunch | Dinner |
| smoker | ||||||
| Yes | 17.399130 | 21.859429 | 2.834348 | 3.066000 | 2.217391 | 2.471429 |
| No | 17.050889 | 20.095660 | 2.673778 | 3.126887 | 2.511111 | 2.735849 |
Puoi fare unstack sulla feature esterna dell’indice usando l’argomento ‘level’:
# Unsstack the outer index
df.unstack(level=0)
| total_bill | tip | size | ||||
|---|---|---|---|---|---|---|
| smoker | Yes | No | Yes | No | Yes | No |
| time | ||||||
| Lunch | 17.399130 | 17.050889 | 2.834348 | 2.673778 | 2.217391 | 2.511111 |
| Dinner | 21.859429 | 20.095660 | 3.066000 | 3.126887 | 2.471429 | 2.735849 |
Il risultato di unstack ha un indice non gerarchico, come ti aspetteresti:
# Check out index
df.unstack().index
CategoricalIndex(['Yes', 'No'], categories=['Yes', 'No'], ordered=False, name='smoker', dtype='category')
Di conseguenza, ora puoi eseguire ogni tipo di analisi rispetto a questi raggruppamenti. Ti incoraggio a farlo.
In questo post hai conosciuto gli indici gerarchici (o multi-indici) e visto come nascano come conseguenza naturale del desiderio di avere un indice del DataFrame che etichetti le righe in modo univoco e significativo. Hai anche visto come emergano quando devi raggruppare i dati per più colonne, applicando il principio split-apply-combine. Spero che ti divertirai a usare gli indici gerarchici nel tuo lavoro.
Questo post è stato generato da un Jupyter Notebook; puoi trovarlo in questo repository. Se hai pensieri, commenti e/o riflessioni, contattami su Twitter: @hugobowne.
Dai un’occhiata anche agli altri pratici tutorial su pandas di DataCamp, tra cui:
Approfondisci Python e pandas
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min



