Curso
Uniones en pandas para usuarios de hojas de cálculo
4 h
4.5K
En una entrada anterior, viste cómo la operación groupby surge de forma natural al aplicar el principio de dividir-aplicar-combinar (split-apply-combine). Exploraste un conjunto de datos con valoraciones de usuarios de Netflix y agrupaste las filas por año de estreno de la película para generar la siguiente figura:
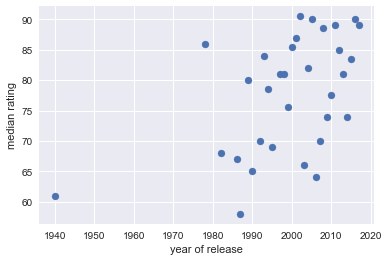
Esto se consiguió agrupando por una sola columna. Comenté de pasada que quizá quieras agrupar por varias columnas; en ese caso, el DataFrame de pandas resultante acaba con un multiíndice o índice jerárquico. En esta entrada aprenderás qué son los índices jerárquicos y verás cómo aparecen al agrupar por varias variables de tus datos. Puedes profundizar en estos conceptos y prácticas en nuestro curso Manipulating DataFrames with pandas.
Empecemos: ¿qué son los índices jerárquicos?
Antes de presentar los índices jerárquicos, recuerda qué es el índice de un DataFrame de pandas. El índice de un DataFrame es un conjunto de etiquetas, una por cada fila. Veamos un ejemplo. Primero voy a importar un conjunto de datos sintético con la actividad en DataCamp de Ellie, una estudiante ficticia de DataCamp. Las columnas son una fecha, un lenguaje de programación y el número de ejercicios que Ellie completó ese día en ese lenguaje. Carga los datos:
# Import pandas
import pandas as pd

# Load in data
df = pd.read_csv('data/user_ex_python.csv')
df
Ejecuta y edita el código de este tutorial en línea
Ejecutar código| date | language | ex_complete | |
|---|---|---|---|
| 0 | 2017-01-01 | python | 6 |
| 1 | 2017-01-02 | python | 5 |
| 2 | 2017-01-03 | python | 10 |
Puedes ver el índice en el lado izquierdo del DataFrame y que está compuesto por enteros. Es un RangeIndex:
# Check out index
df.index
RangeIndex(start=0, stop=3, step=1)
Podemos usar este índice para extraer una o varias filas de df:
# Slice and dice data
df.loc[:1]
| date | language | ex_complete | |
|---|---|---|---|
| 0 | 2017-01-01 | python | 6 |
| 1 | 2017-01-02 | python | 5 |
Sin embargo, este índice no aporta mucha información. Si vas a etiquetar las filas de tu DataFrame, lo ideal es hacerlo de forma significativa, siempre que sea posible. ¿Se puede con este conjunto de datos? Una buena forma de enfocarlo es que necesitas un identificador único y significativo para cada fila. Revisa las columnas y comprueba si alguna cumple estos criterios. Observa que la columna date contiene fechas únicas, así que tiene sentido etiquetar cada fila con la fecha. Es decir, puedes convertir la columna date en el índice del DataFrame con el método .set_index() (nota: inplace=True indica que realmente modificas el DataFrame df en el sitio):
# Set new index
df.set_index(pd.DatetimeIndex(df['date']), inplace=True)
df
| date | language | ex_complete | |
|---|---|---|---|
| date | |||
| 2017-01-01 | 2017-01-01 | python | 6 |
| 2017-01-02 | 2017-01-02 | python | 5 |
| 2017-01-03 | 2017-01-03 | python | 10 |
Esto le da a df un DateTimeIndex:
# Check out new index
df.index
DatetimeIndex(['2017-01-01', '2017-01-02', '2017-01-03'], dtype='datetime64[ns]', name='date', freq=None)
Ahora puedes extraer filas usando el DateTimeIndex que acabas de crear:
# Slice and dice data w/ new index
df.loc['2017-01-02']
date           2017-01-02
language           python
ex_complete             5
Name: 2017-01-02 00:00:00, dtype: object
Ten en cuenta también que el atributo .columns devuelve un índice con los nombres de las columnas de df:
# Check out columns
df.columns
Index(['date', 'language', 'ex_complete'], dtype='object')
Esto puede resultar algo confuso porque lo que indica es que df.columns es de tipo Index. Esto no significa que las columnas sean el índice del DataFrame. El índice de df siempre lo da df.index. Revisa nuestro tutorial de DataFrames de pandas para saber más sobre índices. Ahora es momento de conocer los índices jerárquicos.
¿Y si tuviéramos varios lenguajes en nuestro conjunto de datos, como ocurre en DataCamp? Mira:
# Import and check out data
df = pd.read_csv('data/user_ex.csv')
df
| date | language | ex_complete | |
|---|---|---|---|
| 0 | 2017-01-01 | python | 6 |
| 1 | 2017-01-02 | python | 5 |
| 2 | 2017-01-03 | python | 10 |
| 3 | 2017-01-01 | r | 8 |
| 4 | 2017-01-02 | r | 8 |
| 5 | 2017-01-03 | r | 8 |
Ahora cada fecha corresponde a varias filas, una por lenguaje. Por ejemplo, la fecha «2017-01-02» aparece en las filas 1 y 4, para los lenguajes Python y R, respectivamente. Por tanto, la fecha ya no identifica la fila de forma única. Sin embargo, «date» y «language» juntas sí identifican las filas de forma única. Por eso usamos ambas como índice:
# Set index
df.set_index(['date', 'language'], inplace=True)
df
| ex_complete | ||
|---|---|---|
| date | language | |
| 2017-01-01 | python | 6 |
| 2017-01-02 | python | 5 |
| 2017-01-03 | python | 10 |
| 2017-01-01 | r | 8 |
| 2017-01-02 | r | 8 |
| 2017-01-03 | r | 8 |
Acabas de crear un multiíndice, o índice jerárquico (familiarízate con ambos términos porque se usan indistintamente). Puedes comprobarlo así:
# Check out multi-index
df.index
MultiIndex(levels=[['2017-01-01', '2017-01-02', '2017-01-03'], ['python', 'r']],
           labels=[[0, 1, 2, 0, 1, 2], [0, 0, 0, 1, 1, 1]],
           names=['date', 'language'])
Lo anterior indica que tu DataFrame df ahora tiene un MultiIndex con dos niveles, el primero por fecha y el segundo por lenguaje. Recuerda que arriba podías cortar el DataFrame usando el índice y el accesor .loc: df.loc['2017-01-02']. Para poder hacer slicing con un multiíndice, primero necesitas ordenar el índice:
# Sort index
df.sort_index(inplace=True)
df
| ex_complete | ||
|---|---|---|
| date | language | |
| 2017-01-01 | python | 6 |
| r | 8 | |
| 2017-01-02 | python | 5 |
| r | 8 | |
| 2017-01-03 | python | 10 |
| r | 8 |
Ahora puedes extraer el número de ejercicios de R completados el 2017-01-02 pasando una tupla al accesor .loc:
# Slice & dice your DataFrame
df.loc[('2017-01-02', 'r')]
ex_complete    8
Name: (2017-01-02, r), dtype: int64
Los multiíndices son una herramienta potente para analizar y organizar datos en pandas. Permiten crear índices jerárquicos que pueden usarse para agrupar y agregar datos en múltiples dimensiones. Son especialmente útiles con conjuntos de datos complejos que tienen varios niveles de categorización, como datos financieros o series temporales.
Al crear un multiíndice, puedes agrupar por varias variables a la vez, lo que puede desvelar patrones que no se aprecian con una agrupación de un solo nivel. Por ejemplo, puedes agrupar por tiempo y ubicación a la vez y así analizar tendencias por regiones a lo largo del tiempo.
Además, los multiíndices facilitan seleccionar y filtrar datos de forma eficiente, ya que el índice ofrece una vía cómoda para acceder a subconjuntos específicos. En resumen, son clave para organizar, agrupar y analizar datasets complejos en pandas y resultan imprescindibles para cualquier analista o científico de datos que trabaje con datos jerárquicos.
Ya sabes algo sobre índices jerárquicos (o multiíndices). Veamos ahora cómo aparecen al trabajar con objetos groupby.
En una entrada anterior exploramos los objetos groupby y el principio analítico de dividir-aplicar-combinar usando datos de Netflix. Hagamos un repaso rápido con otro conjunto de datos: tips, que viene incluido en el paquete seaborn. «Tips» contiene variables como tip, total_bill, el día de la semana y la franja horaria. Primero carga y explora los datos:
# Import and check out data
import seaborn as sns
tips = sns.load_dataset("tips")
tips.head()
| total_bill | tip | sex | smoker | day | time | size | |
|---|---|---|---|---|---|---|---|
| 0 | 16.99 | 1.01 | Female | No | Sun | Dinner | 2 |
| 1 | 10.34 | 1.66 | Male | No | Sun | Dinner | 3 |
| 2 | 21.01 | 3.50 | Male | No | Sun | Dinner | 3 |
| 3 | 23.68 | 3.31 | Male | No | Sun | Dinner | 2 |
| 4 | 24.59 | 3.61 | Female | No | Sun | Dinner | 4 |
Observa que el índice de tips es un RangeIndex:
# Check out index
tips.index
RangeIndex(start=0, stop=244, step=1)
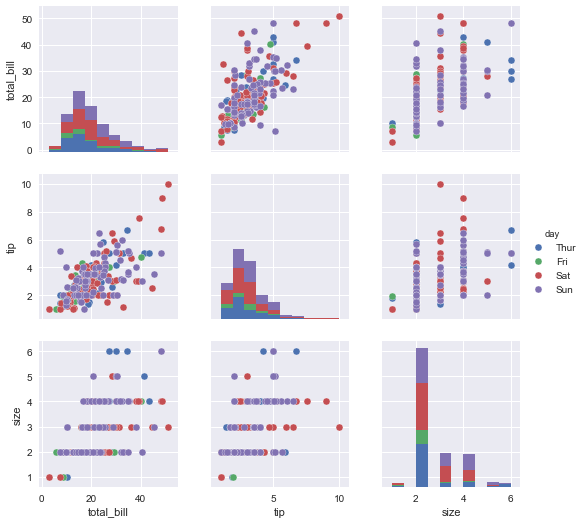
Siempre ayuda hacer algo de EDA visual antes de ponerte a calcular, y la función pairplot de seaborn te permite ver de un vistazo todas las variables numéricas:
# Import pyplot, figures inline, set style, plot pairplot
import matplotlib.pyplot as plt
%matplotlib inline
sns.set()
sns.pairplot(tips, hue='day');
Si quieres comparar la propina media entre «smokers» y «non-smokers», puedes dividir el DataFrame original por «smoker» (usando groupby), aplicar la función «mean» y combinar en un nuevo DataFrame:
# Get mean of smoker/non-smoker groups
df = tips.groupby('smoker').mean()
df
| total_bill | tip | size | |
|---|---|---|---|
| smoker | |||
| Yes | 20.756344 | 3.008710 | 2.408602 |
| No | 19.188278 | 2.991854 | 2.668874 |
El índice resultante del DataFrame df es la columna «smoker» del DataFrame original «tips»:
# Check out new index
df.index
CategoricalIndex(['Yes', 'No'], categories=['Yes', 'No'], ordered=False, name='smoker', dtype='category')
Si quieres, puedes restablecer el índice para que «smoker» vuelva a ser una columna del DataFrame:
# Reset the index
df.reset_index()
| smoker | total_bill | tip | size | |
|---|---|---|---|---|
| 0 | Yes | 20.756344 | 3.008710 | 2.408602 |
| 1 | No | 19.188278 | 2.991854 | 2.668874 |
Ahora verás cómo los índices jerárquicos surgen de dividir-aplicar-combinar y de las operaciones groupby.
Antes agrupaste el conjunto tips según la variable «smoker». A veces necesitarás agrupar un conjunto de datos por dos variables. Por ejemplo, es natural agrupar tips en fumadores/no fumadores y cena/comida. Para hacerlo, pasa los nombres de las columnas por las que quieres agrupar como una lista:
# Group by two columns
df = tips.groupby(['smoker','time']).mean()
df
| total_bill | tip | size | ||
|---|---|---|---|---|
| smoker | time | |||
| Yes | Lunch | 17.399130 | 2.834348 | 2.217391 |
| Dinner | 21.859429 | 3.066000 | 2.471429 | |
| No | Lunch | 17.050889 | 2.673778 | 2.511111 |
| Dinner | 20.095660 | 3.126887 | 2.735849 |
Como puedes ver, tanto «smoker» como «time» son índices de df. Tiene sentido: si al agrupar por «smoker» el índice pasa a ser esa columna original, al agrupar por dos columnas obtienes dos índices. Compruébalo para confirmar que es jerárquico:
# Check out index
df.index
MultiIndex(levels=[['Yes', 'No'], ['Lunch', 'Dinner']],
           labels=[[0, 0, 1, 1], [0, 1, 0, 1]],
           names=['smoker', 'time'])
Y así es. Ahora puedes hacer un buen puñado de cosas útiles, como obtener los recuentos en cada agrupación:
# Group by two features
tips.groupby(['smoker','time']).size()
smoker  time
Yes     Lunch      23
        Dinner     70
No      Lunch      45
        Dinner    106
dtype: int64
También puedes intercambiar los niveles del índice jerárquico para que «time» aparezca antes que «smoker» en el índice:
# Swap levels of multi-index
df.swaplevel()
| total_bill | tip | size | ||
|---|---|---|---|---|
| time | smoker | |||
| Lunch | Yes | 17.399130 | 2.834348 | 2.217391 |
| Dinner | Yes | 21.859429 | 3.066000 | 2.471429 |
| Lunch | No | 17.050889 | 2.673778 | 2.511111 |
| Dinner | No | 20.095660 | 3.126887 | 2.735849 |
Después quizá quieras quitar una de estas variables del índice jerárquico y formar columnas distintas con respecto a esa variable. Puedes hacerlo con el método unstack:
# Unstack your multi-index
df.unstack()
| total_bill | tip | size | ||||
|---|---|---|---|---|---|---|
| time | Lunch | Dinner | Lunch | Dinner | Lunch | Dinner |
| smoker | ||||||
| Yes | 17.399130 | 21.859429 | 2.834348 | 3.066000 | 2.217391 | 2.471429 |
| No | 17.050889 | 20.095660 | 2.673778 | 3.126887 | 2.511111 | 2.735849 |
Puedes «desapilar» por la variable externa del índice usando el argumento de palabra clave «level»:
# Unsstack the outer index
df.unstack(level=0)
| total_bill | tip | size | ||||
|---|---|---|---|---|---|---|
| smoker | Yes | No | Yes | No | Yes | No |
| time | ||||||
| Lunch | 17.399130 | 17.050889 | 2.834348 | 2.673778 | 2.217391 | 2.511111 |
| Dinner | 21.859429 | 20.095660 | 3.066000 | 3.126887 | 2.471429 | 2.735849 |
El resultado de «desapilar» tiene un índice no jerárquico, como cabría esperar:
# Check out index
df.unstack().index
CategoricalIndex(['Yes', 'No'], categories=['Yes', 'No'], ordered=False, name='smoker', dtype='category')
Como resultado, ahora puedes realizar todo tipo de análisis con respecto a estas agrupaciones. Te animo a hacerlo.
En esta entrada has conocido los índices jerárquicos (o multiíndices) y has visto cómo surgen de forma natural cuando quieres que el índice de un DataFrame etiquete las filas de forma única y con sentido. También has visto cómo aparecen cuando necesitas agrupar tus datos por varias columnas, aplicando el principio de dividir-aplicar-combinar. Espero que disfrutes trabajando con índices jerárquicos.
Esta entrada se generó a partir de un Jupyter Notebook; puedes encontrarla en este repositorio. Si tienes ideas, comentarios o reflexiones, escríbeme en Twitter: @hugobowne.
Echa un vistazo a otros tutoriales útiles de pandas en DataCamp, como:
Aprende más sobre Python y pandas
Curso
Curso
Curso
Tutorial
Karlijn Willems
15 min
Tutorial
DataCamp Team
13 min
Tutorial
DataCamp Team
7 min
Tutorial
Vidhi Chugh
15 min
Tutorial
Moez Ali
14 min
Tutorial
Sejal Jaiswal
24 min



