कोर्स
स्प्रेडशीट उपयोगकर्ताओं के लिए Pandas Joins
4 घंटा
4.5K
एक पिछली पोस्ट में, आपने देखा कि groupby ऑपरेशन स्वाभाविक रूप से split-apply-combine सिद्धांत के नजरिए से कैसे आता है। आपने Netflix उपयोगकर्ता रेटिंग्स का एक डेटासेट देखा और फिल्मों के रिलीज़ वर्ष के अनुसार पंक्तियों को समूहित किया ताकि निम्नलिखित चित्र बनाया जा सके:
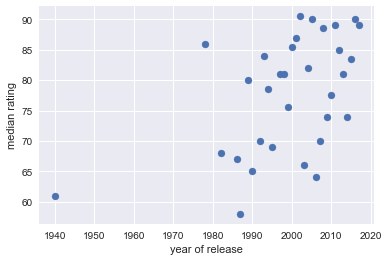
यह एक ही कॉलम द्वारा ग्रुपिंग के जरिए हासिल किया गया था। मैंने राह चलते हुए उल्लेख किया था कि आप कई कॉलम के आधार पर भी ग्रुप करना चाह सकते हैं, जिस स्थिति में परिणामस्वरूप pandas DataFrame में एक मल्टी-इंडेक्स या हाइरार्किकल इंडेक्स होता है। इस पोस्ट में, आप जानेंगे कि हाइरार्किकल इंडेसेज़ क्या होते हैं और देखेंगे कि जब आप अपने डेटा की कई विशेषताओं के आधार पर ग्रुप करते हैं तो वे कैसे उत्पन्न होते हैं। आप इन सभी अवधारणाओं और प्रथाओं के बारे में और अधिक हमारे Manipulating DataFrames with pandas कोर्स में जान सकते हैं।
तो सबसे पहले: हाइरार्किकल इंडेसेज़ क्या हैं?
हाइरार्किकल इंडेसेज़ पेश करने से पहले, मैं चाहता हूँ कि आप याद करें कि pandas DataFrame का इंडेक्स क्या होता है। DataFrame का इंडेक्स एक सेट है जो प्रत्येक पंक्ति के लिए एक लेबल से बना होता है। एक उदाहरण देखते हैं। मैं पहले एक कृत्रिम डेटासेट इम्पोर्ट करूँगा जिसमें काल्पनिक DataCamp छात्र Ellie की DataCamp पर गतिविधि है। कॉलम हैं: एक तारीख, एक प्रोग्रामिंग भाषा और उस भाषा में उस दिन Ellie द्वारा पूरे किए गए अभ्यासों की संख्या। डेटा लोड करें:
# Import pandas
import pandas as pd

# Load in data
df = pd.read_csv('data/user_ex_python.csv')
df
इस ट्यूटोरियल का कोड ऑनलाइन चलाएं और संपादित करें
कोड चलाएं| date | language | ex_complete | |
|---|---|---|---|
| 0 | 2017-01-01 | python | 6 |
| 1 | 2017-01-02 | python | 5 |
| 2 | 2017-01-03 | python | 10 |
आप DataFrame के बाईं ओर इंडेक्स देख सकते हैं और यह पूर्णांकों से बना है। यह एक RangeIndex है:
# Check out index
df.index
RangeIndex(start=0, stop=3, step=1)
हम इस इंडेक्स का उपयोग df की एक या अधिक पंक्तियाँ निकालने के लिए कर सकते हैं:
# Slice and dice data
df.loc[:1]
| date | language | ex_complete | |
|---|---|---|---|
| 0 | 2017-01-01 | python | 6 |
| 1 | 2017-01-02 | python | 5 |
हालाँकि यह इंडेक्स बहुत जानकारीपूर्ण नहीं है। यदि आप अपने DataFrame की पंक्तियों को लेबल करने जा रहे हैं, तो जहाँ तक संभव हो, उन्हें सार्थक तरीके से लेबल करना अच्छा होगा। क्या आप ऐसा वर्तमान डेटासेट के साथ कर सकते हैं? इस चुनौती के बारे में सोचने का अच्छा तरीका यह है कि आप प्रत्येक पंक्ति के लिए एक अद्वितीय और सार्थक पहचानकर्ता चाहते हैं। कॉलम देखें और जाँचें कि क्या कोई इन मानदंडों पर खरा उतरता है। ध्यान दें कि date कॉलम में अनोखी तिथियाँ हैं, इसलिए प्रत्येक पंक्ति को date कॉलम से लेबल करना समझ में आता है। यानी, आप .set_index() मेथड का उपयोग करके date कॉलम को DataFrame का इंडेक्स बना सकते हैं (नोट: inplace=True का मतलब है कि आप वास्तव में DataFrame df को वहीं बदल रहे हैं):
# Set new index
df.set_index(pd.DatetimeIndex(df['date']), inplace=True)
df
| date | language | ex_complete | |
|---|---|---|---|
| date | |||
| 2017-01-01 | 2017-01-01 | python | 6 |
| 2017-01-02 | 2017-01-02 | python | 5 |
| 2017-01-03 | 2017-01-03 | python | 10 |
इससे df को एक DateTimeIndex मिल जाता है:
# Check out new index
df.index
DatetimeIndex(['2017-01-01', '2017-01-02', '2017-01-03'], dtype='datetime64[ns]', name='date', freq=None)
अब आप बनाए गए DateTimeIndex का उपयोग करके पंक्तियाँ निकाल सकते हैं:
# Slice and dice data w/ new index
df.loc['2017-01-02']
date           2017-01-02
language           python
ex_complete             5
Name: 2017-01-02 00:00:00, dtype: object
यह भी ध्यान दें कि .columns एट्रिब्यूट df के कॉलम नामों वाला एक इंडेक्स लौटाता है:
# Check out columns
df.columns
Index(['date', 'language', 'ex_complete'], dtype='object')
यह थोड़ा भ्रमित कर सकता है क्योंकि इसका मतलब है कि df.columns प्रकार Index का है। यह इसका अर्थ नहीं है कि कॉलम DataFrame का इंडेक्स हैं। df का इंडेक्स हमेशा df.index से दिया जाता है। इंडेसेज़ पर अधिक जानकारी के लिए हमारा pandas DataFrames ट्यूटोरियल देखें। अब हाइरार्किकल इंडेसेज़ से मिलते हैं।
क्या होगा यदि हमारे डेटासेट में कई भाषाएँ हों, जैसा कि DataCamp पर हैं? देखें:
# Import and check out data
df = pd.read_csv('data/user_ex.csv')
df
| date | language | ex_complete | |
|---|---|---|---|
| 0 | 2017-01-01 | python | 6 |
| 1 | 2017-01-02 | python | 5 |
| 2 | 2017-01-03 | python | 10 |
| 3 | 2017-01-01 | r | 8 |
| 4 | 2017-01-02 | r | 8 |
| 5 | 2017-01-03 | r | 8 |
अब प्रत्येक तिथि कई पंक्तियों से मेल खाती है, प्रत्येक भाषा के लिए एक। उदाहरण के लिए देखें कि '2017-01-02' तारीख पंक्ति 1 और 4 में क्रमशः Python और R भाषाओं के लिए आती है। इसलिए अब तारीख पंक्ति को अद्वितीय रूप से निर्दिष्ट नहीं करती। हालाँकि, 'date' और 'language' साथ में पंक्तियों को अद्वितीय रूप से निर्दिष्ट करते हैं। इस कारण, हम दोनों को इंडेक्स के रूप में उपयोग करते हैं:
# Set index
df.set_index(['date', 'language'], inplace=True)
df
| ex_complete | ||
|---|---|---|
| date | language | |
| 2017-01-01 | python | 6 |
| 2017-01-02 | python | 5 |
| 2017-01-03 | python | 10 |
| 2017-01-01 | r | 8 |
| 2017-01-02 | r | 8 |
| 2017-01-03 | r | 8 |
अब आपने एक मल्टी-इंडेक्स, या हाइरार्किकल इंडेक्स बनाया है (इन दोनों शब्दों के साथ सहज रहें क्योंकि इन्हें एक-दूसरे के स्थान पर उपयोग किया जाता है), और आप इसे इस तरह इंडेक्स देखकर देख सकते हैं:
# Check out multi-index
df.index
MultiIndex(levels=[['2017-01-01', '2017-01-02', '2017-01-03'], ['python', 'r']],
           labels=[[0, 1, 2, 0, 1, 2], [0, 0, 0, 1, 1, 1]],
           names=['date', 'language'])
ऊपर से पता चलता है कि आपके DataFrame df में अब दो स्तरों वाला MultiIndex है, पहला तारीख द्वारा और दूसरा भाषा द्वारा। याद करें कि ऊपर आप इंडेक्स और .loc एक्सेसर का उपयोग करके DataFrame को स्लाइस कर पाए थे: df.loc['2017-01-02']। मल्टी-इंडेक्स के साथ स्लाइस करने के लिए, आपको पहले इंडेक्स को सॉर्ट करना होगा:
# Sort index
df.sort_index(inplace=True)
df
| ex_complete | ||
|---|---|---|
| date | language | |
| 2017-01-01 | python | 6 |
| r | 8 | |
| 2017-01-02 | python | 5 |
| r | 8 | |
| 2017-01-03 | python | 10 |
| r | 8 |
अब आप .loc एक्सेसर को एक ट्यूपल पास करके 2017-01-02 को पूरे किए गए R अभ्यासों की संख्या निकाल सकते हैं:
# Slice & dice your DataFrame
df.loc[('2017-01-02', 'r')]
ex_complete    8
Name: (2017-01-02, r), dtype: int64
pandas में मल्टी-इंडेक्स डेटा विश्लेषण और संगठन के लिए एक शक्तिशाली टूल हैं। ये आपको हाइरार्किकल इंडेक्स बनाने देते हैं, जिनका उपयोग कई आयामों में डेटा को ग्रुप और एग्रीगेट करने के लिए किया जा सकता है। मल्टी-इंडेक्स विशेष रूप से तब उपयोगी होते हैं जब आप जटिल डेटासेट के साथ काम कर रहे हों जिनमें वर्गीकरण के कई स्तर हों, जैसे वित्तीय या टाइम-सीरीज़ डेटा।
मल्टी-इंडेक्स बनाकर, उपयोगकर्ता एक साथ कई वेरिएबल द्वारा डेटा को ग्रुप कर सकते हैं, जो ऐसे इनसाइट्स प्रकट कर सकता है जो एक-स्तरीय ग्रुपिंग से स्पष्ट न हों। उदाहरण के लिए, मल्टी-इंडेक्स का उपयोग समय और स्थान दोनों के आधार पर डेटा को ग्रुप करने में किया जा सकता है, जिससे विश्लेषक समय के साथ विशिष्ट क्षेत्रों में रुझानों की जाँच कर सकें।
इसके अलावा, मल्टी-इंडेक्स का उपयोग डेटा को कुशलतापूर्वक चुनने और उपसेट करने के लिए किया जा सकता है, क्योंकि इंडेक्स डेटा के विशिष्ट उपसमूहों तक पहुँचने का एक सुविधाजनक तरीका प्रदान करता है। कुल मिलाकर, मल्टी-इंडेक्स pandas में जटिल डेटासेट को व्यवस्थित करने, समूह बनाने और विश्लेषण करने के लिए एक शक्तिशाली टूल हैं, और हाइरार्किकल डेटा के साथ काम करने वाले किसी भी डेटा विश्लेषक या वैज्ञानिक के लिए आवश्यक हैं।
अब आप हाइरार्किकल इंडेसेज़ (या मल्टी-इंडेसेज़) के बारे में थोड़ा जान गए हैं। अब समय है यह देखने का कि वे groupby ऑब्जेक्ट्स के साथ काम करते समय कैसे उत्पन्न होते हैं।
एक पिछली पोस्ट में, हमने groupby ऑब्जेक्ट्स और split-apply-combine के डेटा विश्लेषण सिद्धांतों को netflix डेटा का उपयोग करके खोजा था। आइए एक अलग डेटासेट के साथ एक त्वरित रिफ्रेशर लें, जो seaborn पैकेज में बिल्ट-इन tips डेटासेट है। 'Tips' में tip, total_bill, सप्ताह का दिन और दिन का समय जैसी विशेषताएँ होती हैं। पहले डेटा लोड करें और जाँचें:
# Import and check out data
import seaborn as sns
tips = sns.load_dataset("tips")
tips.head()
| total_bill | tip | sex | smoker | day | time | size | |
|---|---|---|---|---|---|---|---|
| 0 | 16.99 | 1.01 | Female | No | Sun | Dinner | 2 |
| 1 | 10.34 | 1.66 | Male | No | Sun | Dinner | 3 |
| 2 | 21.01 | 3.50 | Male | No | Sun | Dinner | 3 |
| 3 | 23.68 | 3.31 | Male | No | Sun | Dinner | 2 |
| 4 | 24.59 | 3.61 | Female | No | Sun | Dinner | 4 |
ध्यान दें कि tips का इंडेक्स एक RangeIndex है:
# Check out index
tips.index
RangeIndex(start=0, stop=244, step=1)
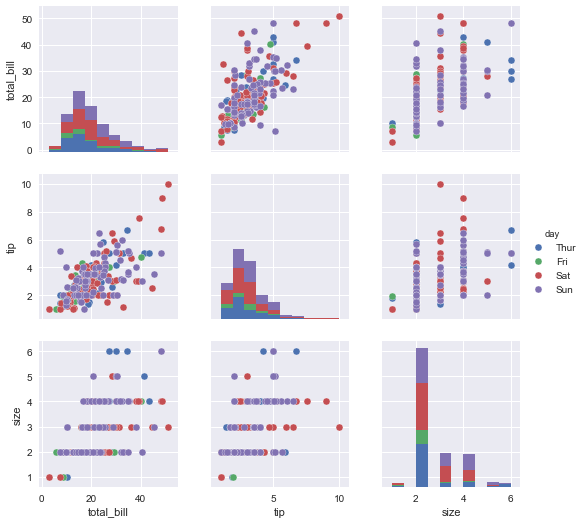
गणना में उतरने से पहले कुछ विजुअल EDA करना हमेशा मददगार होता है और seaborn का pairplot फ़ंक्शन आपको सभी संख्यात्मक वेरिएबल्स का एक अवलोकन देता है:
# Import pyplot, figures inline, set style, plot pairplot
import matplotlib.pyplot as plt
%matplotlib inline
sns.set()
sns.pairplot(tips, hue='day');
यदि आप देखना चाहते हैं कि 'smokers' और 'non-smokers' के बीच औसत टिप कैसे भिन्न होती है, तो आप मूल DataFrame को 'smoker' द्वारा split कर सकते हैं ( groupby का उपयोग करके), 'mean' फ़ंक्शन को apply कर सकते हैं और एक नए DataFrame में combine कर सकते हैं:
# Get mean of smoker/non-smoker groups
df = tips.groupby('smoker').mean()
df
| total_bill | tip | size | |
|---|---|---|---|
| smoker | |||
| Yes | 20.756344 | 3.008710 | 2.408602 |
| No | 19.188278 | 2.991854 | 2.668874 |
परिणामी DataFrame df का इंडेक्स मूल 'tips' DataFrame के 'smoker' कॉलम/फीचर के बराबर है:
# Check out new index
df.index
CategoricalIndex(['Yes', 'No'], categories=['Yes', 'No'], ordered=False, name='smoker', dtype='category')
यदि चाहें, तो आप इंडेक्स रीसेट कर सकते हैं ताकि 'smoker' DataFrame का एक कॉलम बन जाए:
# Reset the index
df.reset_index()
| smoker | total_bill | tip | size | |
|---|---|---|---|---|
| 0 | Yes | 20.756344 | 3.008710 | 2.408602 |
| 1 | No | 19.188278 | 2.991854 | 2.668874 |
अब समय है यह जानने का कि split-apply-combine और groupby ऑपरेशंस से हाइरार्किकल इंडेसेज़ कैसे उत्पन्न होते हैं।
ऊपर, आपने tips डेटासेट को 'smoker' फीचर के अनुसार समूहित किया। कभी-कभी आपको किसी डेटासेट को दो फीचर्स के आधार पर समूहित करने की ज़रूरत होगी। उदाहरण के लिए, tips डेटासेट को smokers/non-smokers और dinner/lunch में समूहित करना स्वाभाविक है। ऐसा करने के लिए, जिन कॉलम नामों द्वारा आप समूहित करना चाहते हैं उन्हें एक सूची के रूप में पास करें:
# Group by two columns
df = tips.groupby(['smoker','time']).mean()
df
| total_bill | tip | size | ||
|---|---|---|---|---|
| smoker | time | |||
| Yes | Lunch | 17.399130 | 2.834348 | 2.217391 |
| Dinner | 21.859429 | 3.066000 | 2.471429 | |
| No | Lunch | 17.050889 | 2.673778 | 2.511111 |
| Dinner | 20.095660 | 3.126887 | 2.735849 |
ऊपर देखते हुए, आप समझ सकते हैं कि 'smoker' और 'time' दोनों df के इंडेक्स हैं। ऐसा ही है और यह समझ में आता है: यदि 'smoker' द्वारा ग्रुप करने से इंडेक्स मूल 'smoker' कॉलम बन जाता है, तो दो कॉलम द्वारा ग्रुपिंग आपको दो इंडेक्स देगी। इंडेक्स की जाँच करें यह पुष्टि करने के लिए कि यह हाइरार्किकल है:
# Check out index
df.index
MultiIndex(levels=[['Yes', 'No'], ['Lunch', 'Dinner']],
           labels=[[0, 0, 1, 1], [0, 1, 0, 1]],
           names=['smoker', 'time'])
और यह है। अब आप कई उपयोगी काम कर सकते हैं, जैसे प्रत्येक ग्रुपिंग में काउंट्स पाना:
# Group by two features
tips.groupby(['smoker','time']).size()
smoker  time
Yes     Lunch      23
        Dinner     70
No      Lunch      45
        Dinner    106
dtype: int64
आप हाइरार्किकल इंडेक्स के स्तरों को स्वैप भी कर सकते हैं ताकि इंडेक्स में 'time' 'smoker' से पहले आए:
# Swap levels of multi-index
df.swaplevel()
| total_bill | tip | size | ||
|---|---|---|---|---|
| time | smoker | |||
| Lunch | Yes | 17.399130 | 2.834348 | 2.217391 |
| Dinner | Yes | 21.859429 | 3.066000 | 2.471429 |
| Lunch | No | 17.050889 | 2.673778 | 2.511111 |
| Dinner | No | 20.095660 | 3.126887 | 2.735849 |
फिर आप हाइरार्किकल इंडेक्स से इन फीचर्स में से किसी एक को हटाना चाह सकते हैं और उस फीचर के अनुरूप अलग-अलग कॉलम बनाना चाह सकते हैं। आप ऐसा unstack मेथड का उपयोग करके कर सकते हैं:
# Unstack your multi-index
df.unstack()
| total_bill | tip | size | ||||
|---|---|---|---|---|---|---|
| time | Lunch | Dinner | Lunch | Dinner | Lunch | Dinner |
| smoker | ||||||
| Yes | 17.399130 | 21.859429 | 2.834348 | 3.066000 | 2.217391 | 2.471429 |
| No | 17.050889 | 20.095660 | 2.673778 | 3.126887 | 2.511111 | 2.735849 |
आप 'level' कीवर्ड आर्ग्युमेंट का उपयोग करके इंडेक्स के बाहरी फीचर पर अनस्टैक कर सकते हैं:
# Unsstack the outer index
df.unstack(level=0)
| total_bill | tip | size | ||||
|---|---|---|---|---|---|---|
| smoker | Yes | No | Yes | No | Yes | No |
| time | ||||||
| Lunch | 17.399130 | 17.050889 | 2.834348 | 2.673778 | 2.217391 | 2.511111 |
| Dinner | 21.859429 | 20.095660 | 3.066000 | 3.126887 | 2.471429 | 2.735849 |
अनस्टैकिंग का परिणाम अपेक्षा के अनुरूप एक गैर-हाइरार्किकल इंडेक्स देता है:
# Check out index
df.unstack().index
CategoricalIndex(['Yes', 'No'], categories=['Yes', 'No'], ordered=False, name='smoker', dtype='category')
परिणामस्वरूप, अब आप इन ग्रुपिंग्स के संदर्भ में सभी प्रकार के डेटा विश्लेषण कर सकते हैं। मैं आपको ऐसा करने के लिए प्रोत्साहित करता हूँ।
इस पोस्ट में, आपको हाइरार्किकल इंडेसेज़ (या मल्टी-इंडेसेज़) से परिचित कराया गया और आपने देखा कि वे कैसे स्वाभाविक रूप से उत्पन्न होते हैं जब आप चाहते हैं कि DataFrame का इंडेक्स आपकी पंक्तियों को अद्वितीय और अर्थपूर्ण तरीके से लेबल करे। आपने यह भी देखा कि जब आपको अपने डेटा को कई कॉलम द्वारा ग्रुप करना होता है, तो split-apply-combine सिद्धांत लागू करते हुए वे कैसे उत्पन्न होते हैं। आशा है कि आप अपने काम में हाइरार्किकल इंडेसेज़ के साथ काम करने का आनंद लेंगे।
यह पोस्ट एक Jupyter Notebook से जेनरेट की गई है; आप इसे इस रिपॉज़िटरी में पा सकते हैं। यदि आपके कोई विचार, प्रतिक्रियाएँ और/या मनन हों, तो बेझिझक मुझसे ट्विटर पर संपर्क करें: @hugobowne।
DataCamp के अन्य उपयोगी pandas ट्यूटोरियल देखें, जिनमें शामिल हैं:
Python और pandas के बारे में और जानें
कोर्स
कोर्स
कोर्स