Cours
Fusions avec pandas pour les utilisateurs de feuilles de calcul
4 h
4.5K
Dans un article précédent, vous avez vu comment l'opération groupby s'inscrit naturellement dans le principe « split-apply-combine ». Vous avez exploré un jeu de données d'évaluations d'utilisateurs Netflix et regroupé les lignes par année de sortie du film pour générer la figure suivante :
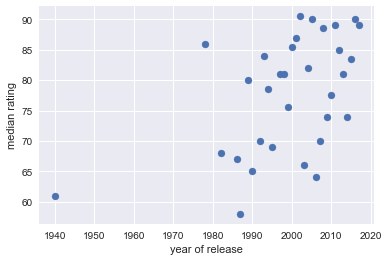
Cela a été obtenu en regroupant selon une seule colonne. J'ai mentionné au passage que vous pourriez vouloir regrouper selon plusieurs colonnes, auquel cas le DataFrame pandas résultant se retrouve avec un multi-index ou index hiérarchique. Dans cet article, vous allez découvrir ce que sont les indices hiérarchiques et voir comment ils émergent lorsque vous regroupez selon plusieurs caractéristiques de vos données. Pour en savoir plus sur ces concepts et pratiques, consultez notre cours Manipuler des DataFrames avec pandas.
Commençons donc par le début : qu'est-ce qu'un index hiérarchique ?
Avant d'introduire les indices hiérarchiques, rappelons ce qu'est l'index d'un DataFrame pandas. L'index d'un DataFrame est un ensemble d'étiquettes, une par ligne. Prenons un exemple. J'importe d'abord un jeu de données synthétiques retraçant l'activité d'Ellie, une étudiante fictive de DataCamp. Les colonnes sont une date, un langage de programmation et le nombre d'exercices qu'Ellie a effectués ce jour-là dans ce langage. Chargeons les données :
# Import pandas
import pandas as pd

# Load in data
df = pd.read_csv('data/user_ex_python.csv')
df
Exécutez et modifiez le code de ce tutoriel en ligne
Exécuter le code| date | language | ex_complete | |
|---|---|---|---|
| 0 | 2017-01-01 | python | 6 |
| 1 | 2017-01-02 | python | 5 |
| 2 | 2017-01-03 | python | 10 |
Vous voyez l'Index sur la gauche du DataFrame, composé d'entiers. Il s'agit d'un RangeIndex :
# Check out index
df.index
RangeIndex(start=0, stop=3, step=1)
Nous pouvons utiliser cet index pour extraire une ou plusieurs lignes de df :
# Slice and dice data
df.loc[:1]
| date | language | ex_complete | |
|---|---|---|---|
| 0 | 2017-01-01 | python | 6 |
| 1 | 2017-01-02 | python | 5 |
Cet index n'est toutefois pas très informatif. Si vous étiquetez les lignes de votre DataFrame, autant le faire de manière pertinente, lorsque c'est possible. Peut-on le faire avec ce jeu de données ? Une bonne approche consiste à rechercher un identifiant à la fois unique et parlant pour chaque ligne. Parcourez les colonnes et voyez si l'une d'elles correspond à ces critères. Remarquez que la colonne date contient des dates uniques, il est donc judicieux d'étiqueter chaque ligne par la date. Autrement dit, vous pouvez faire de la colonne date l'index du DataFrame avec la méthode .set_index() (NB : inplace=True signifie que vous modifiez effectivement le DataFrame df sur place) :
# Set new index
df.set_index(pd.DatetimeIndex(df['date']), inplace=True)
df
| date | language | ex_complete | |
|---|---|---|---|
| date | |||
| 2017-01-01 | 2017-01-01 | python | 6 |
| 2017-01-02 | 2017-01-02 | python | 5 |
| 2017-01-03 | 2017-01-03 | python | 10 |
Le DataFrame df a maintenant un DateTimeIndex :
# Check out new index
df.index
DatetimeIndex(['2017-01-01', '2017-01-02', '2017-01-03'], dtype='datetime64[ns]', name='date', freq=None)
Vous pouvez désormais extraire des lignes en utilisant le DateTimeIndex que vous venez de créer :
# Slice and dice data w/ new index
df.loc['2017-01-02']
date           2017-01-02
language           python
ex_complete             5
Name: 2017-01-02 00:00:00, dtype: object
Notez également que l'attribut .columns renvoie un index contenant les noms de colonnes de df :
# Check out columns
df.columns
Index(['date', 'language', 'ex_complete'], dtype='object')
Cela peut prêter à confusion car cela signifie que df.columns est de type Index. Cela ne veut pas dire que les colonnes sont l'index du DataFrame. L'index de df est toujours df.index. Consultez notre tutoriel sur les DataFrames pandas pour en savoir plus sur les index. Il est temps de découvrir les indices hiérarchiques.
Et si nous avions plusieurs langages dans notre jeu de données, comme c'est le cas sur DataCamp ? Regardez :
# Import and check out data
df = pd.read_csv('data/user_ex.csv')
df
| date | language | ex_complete | |
|---|---|---|---|
| 0 | 2017-01-01 | python | 6 |
| 1 | 2017-01-02 | python | 5 |
| 2 | 2017-01-03 | python | 10 |
| 3 | 2017-01-01 | r | 8 |
| 4 | 2017-01-02 | r | 8 |
| 5 | 2017-01-03 | r | 8 |
Chaque date correspond désormais à plusieurs lignes, une par langage. Par exemple, la date "2017-01-02" apparaît aux lignes 1 et 4, pour les langages Python et R respectivement. La date ne permet donc plus de spécifier de façon unique la ligne. En revanche, « date » et « language » ensemble identifient bien chaque ligne de manière unique. Pour cette raison, nous les utilisons tous deux comme index :
# Set index
df.set_index(['date', 'language'], inplace=True)
df
| ex_complete | ||
|---|---|---|
| date | language | |
| 2017-01-01 | python | 6 |
| 2017-01-02 | python | 5 |
| 2017-01-03 | python | 10 |
| 2017-01-01 | r | 8 |
| 2017-01-02 | r | 8 |
| 2017-01-03 | r | 8 |
Vous avez maintenant créé un multi-index, ou index hiérarchique (familarisez-vous avec ces deux termes, utilisés indifféremment), ce que vous pouvez constater en inspectant l'index comme suit :
# Check out multi-index
df.index
MultiIndex(levels=[['2017-01-01', '2017-01-02', '2017-01-03'], ['python', 'r']],
           labels=[[0, 1, 2, 0, 1, 2], [0, 0, 0, 1, 1, 1]],
           names=['date', 'language'])
Ce qui précède indique que votre DataFrame df possède désormais un MultiIndex à deux niveaux : le premier correspond à la date, le second au langage. Rappelez-vous qu'auparavant, vous pouviez découper le DataFrame via l'index et l'accesseur .loc : df.loc['2017-01-02']. Pour pouvoir découper avec un multi-index, vous devez d'abord trier l'index :
# Sort index
df.sort_index(inplace=True)
df
| ex_complete | ||
|---|---|---|
| date | language | |
| 2017-01-01 | python | 6 |
| r | 8 | |
| 2017-01-02 | python | 5 |
| r | 8 | |
| 2017-01-03 | python | 10 |
| r | 8 |
Vous pouvez maintenant extraire le nombre d'exercices R effectués le 2017-01-02 en passant un tuple à l'accesseur .loc :
# Slice & dice your DataFrame
df.loc[('2017-01-02', 'r')]
ex_complete    8
Name: (2017-01-02, r), dtype: int64
Les multi-index sont un outil puissant pour l'analyse et l'organisation des données avec pandas. Ils permettent de créer des index hiérarchiques, utiles pour grouper et agréger des données sur plusieurs dimensions. Ils sont particulièrement pertinents pour des jeux de données complexes avec plusieurs niveaux de catégorisation, comme les données financières ou les séries temporelles.
En créant un multi-index, vous pouvez regrouper simultanément selon plusieurs variables, ce qui révèle des insights qui échapperaient à un regroupement à un seul niveau. Par exemple, on peut regrouper par période et par localisation afin d'examiner l'évolution des tendances régionales dans le temps.
De plus, les multi-index facilitent la sélection et la création de sous-ensembles, l'index offrant un moyen pratique d'accéder à des segments précis des données. En somme, les multi-index sont essentiels pour organiser, regrouper et analyser des jeux de données complexes dans pandas, et constituent un incontournable pour toute analyste ou data scientist travaillant avec des données hiérarchiques.
Vous en savez maintenant un peu plus sur les indices hiérarchiques (ou multi-index). Voyons comment ils apparaissent lorsque l'on travaille avec des objets groupby.
Dans un article précédent, nous avons exploré les objets groupby et les principes analytiques « split-apply-combine » à l'aide de données Netflix. Faisons un bref rappel avec un autre jeu de données, le jeu de données tips intégré au package seaborn. « Tips » contient des variables comme tip, total_bill, le jour de la semaine et le moment de la journée. Chargeons et explorons d'abord les données :
# Import and check out data
import seaborn as sns
tips = sns.load_dataset("tips")
tips.head()
| total_bill | tip | sex | smoker | day | time | size | |
|---|---|---|---|---|---|---|---|
| 0 | 16.99 | 1.01 | Female | No | Sun | Dinner | 2 |
| 1 | 10.34 | 1.66 | Male | No | Sun | Dinner | 3 |
| 2 | 21.01 | 3.50 | Male | No | Sun | Dinner | 3 |
| 3 | 23.68 | 3.31 | Male | No | Sun | Dinner | 2 |
| 4 | 24.59 | 3.61 | Female | No | Sun | Dinner | 4 |
Notez que l'index de tips est un RangeIndex :
# Check out index
tips.index
RangeIndex(start=0, stop=244, step=1)
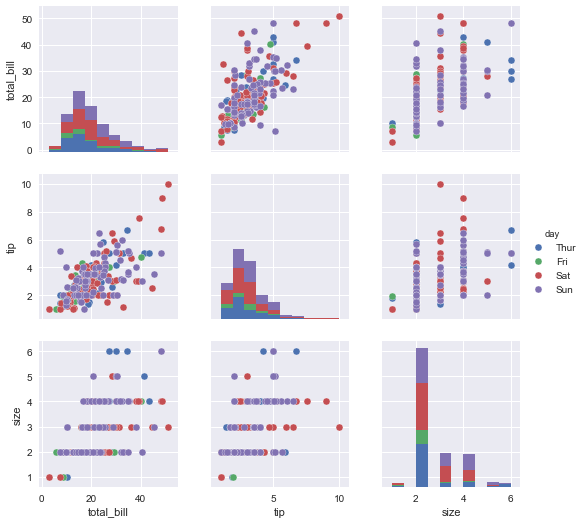
Il est toujours utile de faire un peu d'EDA visuelle avant de passer au calcul, et la fonction pairplot de seaborn permet d'obtenir une vue d'ensemble de toutes les variables numériques :
# Import pyplot, figures inline, set style, plot pairplot
import matplotlib.pyplot as plt
%matplotlib inline
sns.set()
sns.pairplot(tips, hue='day');
Si vous voulez comparer le pourboire moyen entre « fumeurs » et « non-fumeurs », vous pouvez scinder le DataFrame d'origine par « smoker » (avec groupby), appliquer la fonction mean et combiner le tout dans un nouveau DataFrame :
# Get mean of smoker/non-smoker groups
df = tips.groupby('smoker').mean()
df
| total_bill | tip | size | |
|---|---|---|---|
| smoker | |||
| Yes | 20.756344 | 3.008710 | 2.408602 |
| No | 19.188278 | 2.991854 | 2.668874 |
L'index du DataFrame df résultant est la colonne « smoker » du DataFrame tips d'origine :
# Check out new index
df.index
CategoricalIndex(['Yes', 'No'], categories=['Yes', 'No'], ordered=False, name='smoker', dtype='category')
Si besoin, vous pouvez réinitialiser l'index afin que « smoker » redevienne une colonne du DataFrame :
# Reset the index
df.reset_index()
| smoker | total_bill | tip | size | |
|---|---|---|---|---|
| 0 | Yes | 20.756344 | 3.008710 | 2.408602 |
| 1 | No | 19.188278 | 2.991854 | 2.668874 |
Voyons maintenant comment les indices hiérarchiques découlent de split-apply-combine et des opérations groupby.
Ci-dessus, vous avez regroupé le jeu de données tips selon la variable « smoker ». Il arrive que vous ayez besoin de regrouper selon deux variables. Par exemple, il est naturel de regrouper tips en fumeurs/non-fumeurs & dîner/déjeuner. Pour cela, passez la liste des colonnes sur lesquelles regrouper :
# Group by two columns
df = tips.groupby(['smoker','time']).mean()
df
| total_bill | tip | size | ||
|---|---|---|---|---|
| smoker | time | |||
| Yes | Lunch | 17.399130 | 2.834348 | 2.217391 |
| Dinner | 21.859429 | 3.066000 | 2.471429 | |
| No | Lunch | 17.050889 | 2.673778 | 2.511111 |
| Dinner | 20.095660 | 3.126887 | 2.735849 |
À la lecture du tableau ci-dessus, vous voyez que « smoker » et « time » forment tous deux l'index de df. C'est logique : si un groupby sur « smoker » transforme la colonne d'origine « smoker » en index, regrouper selon deux colonnes vous donnera deux niveaux d'index. Vérifiez l'index pour confirmer qu'il est hiérarchique :
# Check out index
df.index
MultiIndex(levels=[['Yes', 'No'], ['Lunch', 'Dinner']],
           labels=[[0, 0, 1, 1], [0, 1, 0, 1]],
           names=['smoker', 'time'])
Et c'est bien le cas. Vous pouvez maintenant faire tout un tas de choses utiles, comme obtenir les effectifs dans chaque regroupement :
# Group by two features
tips.groupby(['smoker','time']).size()
smoker  time
Yes     Lunch      23
        Dinner     70
No      Lunch      45
        Dinner    106
dtype: int64
Vous pouvez également permuter les niveaux de l'index hiérarchique afin que « time » apparaisse avant « smoker » dans l'index :
# Swap levels of multi-index
df.swaplevel()
| total_bill | tip | size | ||
|---|---|---|---|---|
| time | smoker | |||
| Lunch | Yes | 17.399130 | 2.834348 | 2.217391 |
| Dinner | Yes | 21.859429 | 3.066000 | 2.471429 |
| Lunch | No | 17.050889 | 2.673778 | 2.511111 |
| Dinner | No | 20.095660 | 3.126887 | 2.735849 |
Vous souhaiterez ensuite peut-être retirer l'une de ces variables de l'index hiérarchique et créer différentes colonnes pour cette variable. Vous pouvez le faire avec la méthode unstack :
# Unstack your multi-index
df.unstack()
| total_bill | tip | size | ||||
|---|---|---|---|---|---|---|
| time | Lunch | Dinner | Lunch | Dinner | Lunch | Dinner |
| smoker | ||||||
| Yes | 17.399130 | 21.859429 | 2.834348 | 3.066000 | 2.217391 | 2.471429 |
| No | 17.050889 | 20.095660 | 2.673778 | 3.126887 | 2.511111 | 2.735849 |
Vous pouvez désempiler selon la variable externe de l'index via l'argument « level » :
# Unsstack the outer index
df.unstack(level=0)
| total_bill | tip | size | ||||
|---|---|---|---|---|---|---|
| smoker | Yes | No | Yes | No | Yes | No |
| time | ||||||
| Lunch | 17.399130 | 17.050889 | 2.834348 | 2.673778 | 2.217391 | 2.511111 |
| Dinner | 21.859429 | 20.095660 | 3.066000 | 3.126887 | 2.471429 | 2.735849 |
Le résultat du désempilement a un index non hiérarchique, comme on pouvait s'y attendre :
# Check out index
df.unstack().index
CategoricalIndex(['Yes', 'No'], categories=['Yes', 'No'], ordered=False, name='smoker', dtype='category')
Vous pouvez à présent mener toutes sortes d'analyses en fonction de ces regroupements. Je vous encourage à explorer.
Dans cet article, vous avez découvert les indices hiérarchiques (ou multi-index) et vu comment ils apparaissent naturellement lorsque vous voulez un index de DataFrame qui identifie les lignes de manière unique et pertinente. Vous avez aussi vu comment ils émergent lorsque vous devez regrouper vos données par plusieurs colonnes, conformément au principe split-apply-combine. J'espère que vous prendrez plaisir à utiliser les indices hiérarchiques dans vos projets.
Cet article a été généré à partir d'un Jupyter Notebook ; vous pouvez le retrouver dans ce dépôt. Si vous avez des remarques, réactions et/ou réflexions, n'hésitez pas à me contacter sur Twitter : @hugobowne.
Découvrez d'autres tutoriels pratiques sur pandas proposés par DataCamp, notamment :
Approfondissez Python et pandas
Cours
Cours
Cours