机器学习从业者需要同时评估数据质量与其预测模型的性能。
在二元分类任务中,各种指标都能提供帮助——即每个数据点被预测为两类之一的情形。例如,信用审批(批准/不批准)、恶意软件分类(恶意/非恶意)、简历筛选(入围/不入围)、疾病诊断(有病/无病)。甚至A/B 测试也密切相关,本质上是在问:“版本 B 比版本 A 更好吗?”(是/否)。
尽管准确率能快速总结性能,但它可能掩盖模型错误性质的关键信息。例如,一个将所有交易都标记为合法的信用欺诈检测器可能达到 99% 的准确率,却完全无法检测到实际欺诈。敏感性与特异性提供了更细致的洞察,帮助您不仅了解模型正确的频率,还能了解其会产生哪些类型的错误,以及这些错误在具体情境中是否可接受。
在本指南中,您将了解敏感性与特异性的真正含义、各自最适用的场景、它们的计算方法,以及如何通过清晰的真实案例将其切实应用到工作中。
诊断检测与临床决策
敏感性与特异性源于医学评估。将这些指标置于诊断检测与临床决策的视角,有助于厘清本文中的诸多概念。为说明起见,我们将使用两个贯穿示例:疾病检测与信用卡欺诈。
- 诊断检测指用于确认或排除某种疾病的医疗程序。
- 分析检测(Assay)用于测量样本中是否存在某种物质。
- 临床决策是医护人员收集患者信息、权衡诊断与治疗方案,并基于证据做出明智决定的过程。
目标读者
本文面向使用统计推断并希望在决策中理解比准确率更细腻指标的数据实践者。这些指标有助于评估模型会犯哪些类型的错误,以及这些错误在情境中是否可接受。应用包括前述的医学诊断与欺诈检测。其他应用还包括入侵检测、制造业质量控制、垃圾邮件过滤等。
敏感性与特异性的基础概念
在解读或应用敏感性与特异性之前,了解其背后的基本概念至关重要。本节将讨论历史渊源、核心定义、推导与计算。
历史
敏感性与特异性概念起源于生物统计学。尽管更早就出现在医学文献中,生物统计学研究者 Jacob Yerushlamy 在其论文“评估医学诊断方法的统计问题,特别参照 X 光技术”中推广了该术语。
20 世纪 70 年代,接收者操作特征(ROC)曲线(后文将述)成为在临床检测中可视化分析敏感性与特异性的工具。90 年代,机器学习借鉴了这些概念。如今,这些术语广泛用于医疗与机器学习领域,用于衡量系统识别真正例与真负例的能力。
混淆矩阵
设想使用一个机器学习模型来检测信用卡欺诈。在一个包含 10,000 笔交易的样本中,有 9800 笔合法交易与 200 起欺诈案例。
由于我们主要关注欺诈案例,将欺诈记为正类,将非欺诈记为负类。(正负类的指定在某种程度上是任意的;但通常会有显而易见的标注方式。)
运行模型并将预测的欺诈与实际欺诈比对后,我们发现:160 起欺诈被正确标记,9500 笔合法交易被正确识别,300 笔合法交易被错误标记为欺诈,另有 40 起欺诈被模型漏检。
为理清这些数据,通常使用以下命名法。
- 真正例(TP):160 起欺诈被正确标记,
- 真负例(TN):9500 笔合法交易被正确识别,
- 假正例(FP):300 笔合法交易被错误标记为欺诈,且
- 假负例(FN):模型漏检 40 起欺诈。
第二个字母(P 或 N)表示该案例被预测为正或负,第一个字母表示该预测是否为真(T)或假(F)。
因此,“假正例”意味着该案例被预测为正,而该预测是错误的;换言之,预测为正,实际为负。同理,假负例是预测为负,实际为正的案例。
为展示这些信息,我们通常使用“混淆矩阵”,之所以得名,是因为它记录了模型将错误预测与实际结果相混淆的频率(FN、FP)。如下示例:
| |
实际欺诈(正类)
|
实际合法(负类)
|
|
预测欺诈(预测为正)
|
160 (TP)
|
300 (FP)
|
|
预测合法(预测为负)
|
40 (FN)
|
9500 (TN)
|
现在来看行列合计。行和表示总预测数,列和表示总实际数。
| |
实际欺诈(正类)
|
实际合法(负类)
| |
|
预测欺诈(预测为正)
|
160 (TP)
|
300 (FP)
|
460 (TP + FP)
预测为正总数
|
|
预测合法(预测为负)
|
60 (FN)
|
9500 (TN)
|
9540 (FN + TN)预测为负总数
|
| |
200 (TP + FN)实际正类总数
|
9800 (FP + TN)实际负类总数
|
10,000
|
这些合计代表什么?
- 第一行合计(460)表示预测为欺诈的总数(TP + FP)。
- 第二行合计(9540)表示预测为合法的总数(FN + TN)。
- 第一列合计(200)表示实际欺诈的总数(TP + FN)。
- 第二列合计(9800)表示实际合法的总数(FP + TN)。
- 总计(10,000)等于样本总量。
定义
敏感性(亦称真正例率,或召回率)衡量模型正确识别真正例的能力。更准确地说,敏感性是真正例占实际正类的比例,TP / (TP + FN)。
类似地,特异性(真负例率)衡量模型识别真负例的能力。它是真负例占实际负类的比例,TN / (FP + TN)。
从概率角度看,敏感性是在患者确有疾病的条件下,检测为阳性的概率;特异性是在患者并无疾病的条件下,检测为阴性的概率。
计算敏感性与特异性
在我们的欺诈示例中,敏感性 = TP / (TP + FN) = 160/200,即 80%。特异性为 9500/9800,约 97%。
敏感性-特异性的权衡与 ROC 分析
随着模型阈值的变化,敏感性与特异性常常呈反向变动。提升敏感性通常会降低特异性,反之亦然。本节将探讨这种内在权衡,并讨论接收者操作特征(ROC)分析如何通过可视与定量的方法,在不同阈值下评估模型性能。
权衡
我们稍微修改欺诈示例,使假负例增加 20 起,FN = 60。由于实际欺诈总数仍为 200,那么真正例必须减少 20 起(TP = 140)。
| |
实际欺诈(正类)
|
实际合法(负类)
| |
|
预测欺诈(预测为正)
|
140 (TP)
|
300 (FP)
|
460 (TP + FP)
预测为正总数
|
|
预测合法(预测为负)
|
60 (FN)
|
9500 (TN)
|
9540 (FN + TN)预测为负总数
|
| |
200 (TP + FN)实际正类总数
|
9800 (FP + TN)实际负类总数
|
10,000
|
敏感性从 80% 降至 140/200 = 70%。假负例越多,敏感性越低,反之亦然。这意味着高敏感性表示假负例数量较少。
用医学术语来说,高特异性的检测能正确识别大多数没有该病的人。在我们的癌症筛查示例中,高特异性的检测可确保未患癌症的人不会被错误告知患癌。
这说明了敏感性与特异性之间的权衡。少数患者可能会因被误告知患癌而惊慌,但真正患病的人能被正确识别。在这种情况下,更高的特异性是更好的指标。在一个不完美的世界中,我们必须在指标之间的权衡评估基础上做出适当决策。
阈值动态
诊断阈值设定了将检测结果判定为阳性或阴性的临界值。它把连续值(如概率)转换为是/否的界限。通俗而言,它决定在阳性与阴性之间“划线”的位置。
阈值常设为 50%,即 0.50。高于 50% 的概率被视为阳性,低于 50% 则为阴性。
改变阈值会决定哪些案例被视为阳性、哪些被视为阴性。此变化会影响捕获真正例与避免假负例之间的平衡。
例如,考虑一个输出癌症概率的模型。若阈值设为 0.3,模型会将许多人判为阳性。这种方法适合筛查,因为它降低了漏诊的可能性。
然而,它会增加假阳性的风险。若阈值为 0.8,模型会将更少的人判为阳性。此法可减少假阳性,但增加漏诊真实病例的风险。
当阈值改变时,模型在捕获真正例与避免假正例的频率上会发生转移。较低阈值提高敏感性但降低特异性;较高阈值降低敏感性但提高特异性。
ROC 曲线解读
接收者操作特征(ROC)曲线是对比不同分类阈值下敏感性与特异性的常用可视化。ROC 曲线以敏感性为纵轴,对应 1 - 特异性为横轴。曲线上的每个点都代表一个特定阈值。随着阈值变化,模型的敏感性与特异性相应调整,从而描绘出 ROC 曲线。
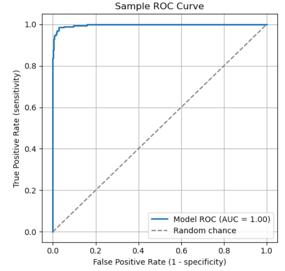
ROC 曲线体现了敏感性与特异性之间的权衡。曲线上关键点:
- (0,1):完美分类器,识别所有真正例而无假负例。
- (0,0):极端模型,将所有样本预测为负,所有正类均被误分。
- (1,1):极端模型,将所有样本预测为正,所有负类均被误分。
对角虚线表示随机水平。沿此线表现的模型没有真正的判别力。
用 ROC 曲线评估模型时,可考虑“曲线下面积”(AUC)。AUC 是曲线下的总面积(积分),表示在所有阈值上的加权平均表现。AUC 越高,表示在区分正负类上的整体能力越强。
|
AUC 分数
|
解读
|
|
1.0
|
完美分类器
|
|
0.9 - 1.0
|
优秀
|
|
0.8 - 0.9
|
良好
|
|
0.7 - 0.8
|
一般
|
|
0.6 - 0.7
|
较差
|
|
0.5
|
无判别力(等同随机猜测)
|
|
< 0.5
|
劣于随机
|
预测值与似然比
本节探讨患病率如何影响检测结果的可靠性。我们还将了解似然比如何将敏感性与特异性整合为单一数值,帮助临床医师在检测后更新诊断概率。
与患病率相关的指标
阳性预测值(PPV),在机器学习中与精确率在数学上等价,反映阳性预测为真的可能性。它衡量被预测为阳性的样本中真正例的比例:PPV = TP / (TP + FP)。
阴性预测值(NPV)反映阴性结果的可靠性。它衡量阴性检测结果中真负例的比例。公式为 NPV = TN / (TN + FN)。
假设我们对 1000 人进行某种疾病检测,其混淆矩阵如下。
| |
实际阳性(患病)
|
实际阴性(健康)
| |
|
预测阳性(患病)
|
80 (TP)
|
20 (FP)
|
100
|
|
预测阴性(健康)
|
10 (FN)
|
890 (TN)
|
900
|
| |
90
|
910
|
1000
|
- PPV = TP / (TP + FP) = 80/100 = 80%。
- NPV = TN / (FN + TN) = 890 / 900 = 98.9%。
作比较,假设患病人数更多(由 90 增至 300),并相应调整混淆矩阵。
| |
实际阳性(患病)
|
实际阴性(健康)
| |
|
预测阳性(患病)
|
270 (TP)
|
70 (FP)
|
340
|
|
预测阴性(健康)
|
30 (FN)
|
630 (TN)
|
660
|
| |
300
|
700
|
1000
|
随着患病率升高,真正例数量随之上升。
- PPV 更高。阳性结果更可能反映真实患病。事实上,PPV = 270 / 300 = 90%,相较此前 80% 提升了 10%。
- NPV 更低。阴性结果的可靠性略降,因为漏诊真实病例的机会增多。可见 NPV = 630 / 700 = 90%,下降了 8.9%。
似然比
似然比将敏感性与特异性合并为一个数值,帮助临床医师根据检测结果更新诊断信心。
概率与赔率
在应用似然比之前,区分概率与赔率非常重要。概率是事件发生的机会,取值在 0 到 1 之间。赔率表示事件发生相对于不发生的可能性。
75% 的概率意味着事件在 100 次中发生 75 次。相应的赔率为 0.75 / (1 - 0.75) = 0.75 / .025 = 3。这表示事件发生的赔率为 3:1。
更一般地,若 p 为事件发生的概率,则 赔率 = p / (1 - p)。从赔率转回概率,p = 赔率 / (1 + 赔率)。
似然比
阳性似然比(LR+)告诉您,与无该病者相比,阳性结果使患病赔率增加了多少。数值越高(>10)表明该检测在“确诊”(rule in)方面效果越好。公式为 LR+ = 敏感性 / (1 - 特异性)。
阴性似然比(LR-)告诉您,与无该病者相比,阴性结果使患病赔率降低了多少。数值越低(< 0.1)表明该检测在“排除”(rule out)疾病方面效果越好。公式为 LR- = (1 - 敏感性) / 特异性。
检后概率
为做出决定,临床医师首先根据患者症状与病史等因素估计检前概率。将该估计与似然比结合,可计算出检后概率。
流程如下。
- 从检前概率 p 开始。
- 转换为赔率。检前赔率 = p / (1 - p)。
- 应用似然比。若检测为阳性,将检前赔率乘以 LR+;若为阴性,乘以 LR-。检后赔率 = 检前赔率 × LR。
- 将检后赔率转回概率。检后概率 = 检后赔率 / (1 + 检后赔率)。
例如,假设检前患病概率为 30%,且 LR+ = 10。检后概率是多少?
- p = 0.3
- 检前赔率 = 0.3/0.7 = 0.43。
- 检后赔率 = 0.43 * 10 = 4.3
- 检后概率 = 4.3 / (1 + 4.3) = 81%。
可见 LR+ 显著改变了概率与诊断信心。
前沿方法与未来方向
随着诊断检测与分类系统日益复杂,新方法不断涌现,以突破传统性能极限。本节将探讨贝叶斯方法如何支持个性化决策阈值,以及 CRISPR 等新技术如何推动分析灵敏度与特异性的前沿。
贝叶斯方法
以先验信念为起点并基于新信息更新,正是贝叶斯统计的核心思想。它提供了一种在新数据面前修正概率的形式化方法。
贝叶斯推理依赖三个关键组成:
- 先验概率:在看到新证据之前的初始信念。(“预报称下雨风险为 60%。”)
- 似然:若信念为真,新证据出现的可能性。(“我听到下雨了,因此预报正确的似然很高。”)
- 后验概率:考虑新证据后的修正信念。通过将先验概率与似然相乘得到。
其数学表述为贝叶斯定理。
P(A|B) = P(B|A) × P(A) / P(B)
其中 P(A|B) 为后验(在 B 条件下 A 的概率),P(B|A) 为似然(在 A 为真时 B 出现的概率),P(A) 为先验,P(B) 为证据。
用贝叶斯方法优化阈值
如我们所见,传统分类模型常用固定阈值(如 0.5)来决定输出标注为正或负。相较之下,贝叶斯方法允许这些阈值根据情境自适应,包括个体风险因素、人口统计特征、行为历史或实时数据等。此灵活性使系统可动态调整阈值,而非依赖一刀切的静态阈值。
设想一个预测心脏病可能性的模型。传统模型可能使用 0.5 的阈值。概率超过 50% 的患者被视为阳性,低于者为阴性。
现在用贝叶斯方法考虑两位假设患者:
- 患者 A:68 岁,终身吸烟者,有心脏病家族史,近期胸痛。
- 患者 B:25 岁,不吸烟,无症状且无相关病史。
两位患者的检测概率均为 0.45。阈值为 0.5 的固定阈值模型会将两者均判为阴性。
然而,贝叶斯模型会纳入先验风险信息,并可结合预测区间使用。对于患者 A,系统可能下调决策阈值,将其标记为需进一步评估。对于患者 B,可能保持原阈值,不建议随访。
如此,贝叶斯方法可根据每位患者的情境量身定制分类阈值,从而得出更符合临床的决策。
高敏感性/特异性分析检测
一种推动分析灵敏度与特异性极限的新兴技术是基于 CRISPR 的诊断。科学家将 CRISPR(成簇规律间隔短回文重复序列)这一基因编辑工具改造用于检测遗传物质。它利用 Cas 蛋白以高灵敏度检测特定核酸序列。
基于 CRISPR 的分析检测已用于癌症的早期发现。便携的癌症诊断工具正被开发用于临床环境。两个重要的平台是 SHERLOCK 与 DETECTR。
CRISPR 检测具有诸多优势。它们具备高灵敏度,能够检测极微量的 DNA 或 RNA。
这使其在识别感染早期、癌症或罕见突变方面极具价值。同时它们提供出色的特异性,能够区分高度相近的遗传序列,从而减少假阳性。其他优势还包括结果快速、设备低成本且便携。
这些检测支持广泛应用,包括传染病检测、癌症诊断与遗传病筛查。研究人员可用机器学习优化向导 RNA 的设计并提升诊断准确性。
CRISPR 检测也面临挑战。多数仅提供二元结果(阳性或阴性)。标准化与可重复性仍令人担忧,因为不同实验室与检测条件下结果会有差异。
此外,这些检测必须满足包括 FDA 与 CLIA 在内的监管要求,需要大量验证、文档与审查。最后,知识产权问题使许可复杂化并放缓商业化进程。
结语
敏感性与特异性在评估诊断检测与分类模型中发挥核心作用。尤其在数据集不平衡或假阳性与假阴性的代价不同的情形下,它们比准确率更具洞察力。结合似然比与 ROC 分析等相关工具,可引导更有见地的解读与更优的决策。
想进一步提升评估模型性能的实战技能?不妨探索以下 DataCamp 资源:


机器学习从业者需要同时评估数据质量与其预测模型的性能。
在二元分类任务中,各种指标都能提供帮助——即每个数据点被预测为两类之一的情形。例如,信用审批(批准/不批准)、恶意软件分类(恶意/非恶意)、简历筛选(入围/不入围)、疾病诊断(有病/无病)。甚至A/B 测试也密切相关,本质上是在问:“版本 B 比版本 A 更好吗?”(是/否)。
尽管准确率能快速总结性能,但它可能掩盖模型错误性质的关键信息。例如,一个将所有交易都标记为合法的信用欺诈检测器可能达到 99% 的准确率,却完全无法检测到实际欺诈。敏感性与特异性提供了更细致的洞察,帮助您不仅了解模型正确的频率,还能了解其会产生哪些类型的错误,以及这些错误在具体情境中是否可接受。
在本指南中,您将了解敏感性与特异性的真正含义、各自最适用的场景、它们的计算方法,以及如何通过清晰的真实案例将其切实应用到工作中。
诊断检测与临床决策
敏感性与特异性源于医学评估。将这些指标置于诊断检测与临床决策的视角,有助于厘清本文中的诸多概念。为说明起见,我们将使用两个贯穿示例:疾病检测与信用卡欺诈。
目标读者
本文面向使用统计推断并希望在决策中理解比准确率更细腻指标的数据实践者。这些指标有助于评估模型会犯哪些类型的错误,以及这些错误在情境中是否可接受。应用包括前述的医学诊断与欺诈检测。其他应用还包括入侵检测、制造业质量控制、垃圾邮件过滤等。
敏感性与特异性的基础概念
在解读或应用敏感性与特异性之前,了解其背后的基本概念至关重要。本节将讨论历史渊源、核心定义、推导与计算。
历史
敏感性与特异性概念起源于生物统计学。尽管更早就出现在医学文献中,生物统计学研究者 Jacob Yerushlamy 在其论文“评估医学诊断方法的统计问题,特别参照 X 光技术”中推广了该术语。
20 世纪 70 年代,接收者操作特征(ROC)曲线(后文将述)成为在临床检测中可视化分析敏感性与特异性的工具。90 年代,机器学习借鉴了这些概念。如今,这些术语广泛用于医疗与机器学习领域,用于衡量系统识别真正例与真负例的能力。
混淆矩阵
设想使用一个机器学习模型来检测信用卡欺诈。在一个包含 10,000 笔交易的样本中,有 9800 笔合法交易与 200 起欺诈案例。
由于我们主要关注欺诈案例,将欺诈记为正类,将非欺诈记为负类。(正负类的指定在某种程度上是任意的;但通常会有显而易见的标注方式。)
运行模型并将预测的欺诈与实际欺诈比对后,我们发现:160 起欺诈被正确标记,9500 笔合法交易被正确识别,300 笔合法交易被错误标记为欺诈,另有 40 起欺诈被模型漏检。
为理清这些数据,通常使用以下命名法。
第二个字母(P 或 N)表示该案例被预测为正或负,第一个字母表示该预测是否为真(T)或假(F)。
因此,“假正例”意味着该案例被预测为正,而该预测是错误的;换言之,预测为正,实际为负。同理,假负例是预测为负,实际为正的案例。
为展示这些信息,我们通常使用“混淆矩阵”,之所以得名,是因为它记录了模型将错误预测与实际结果相混淆的频率(FN、FP)。如下示例:
实际欺诈(正类)
实际合法(负类)
预测欺诈(预测为正)
160 (TP)
300 (FP)
预测合法(预测为负)
40 (FN)
9500 (TN)
现在来看行列合计。行和表示总预测数,列和表示总实际数。
实际欺诈(正类)
实际合法(负类)
预测欺诈(预测为正)
160 (TP)
300 (FP)
460 (TP + FP)
预测为正总数
预测合法(预测为负)
60 (FN)
9500 (TN)
9540 (FN + TN)预测为负总数
200 (TP + FN)实际正类总数
9800 (FP + TN)实际负类总数
10,000
这些合计代表什么?
定义
敏感性(亦称真正例率,或召回率)衡量模型正确识别真正例的能力。更准确地说,敏感性是真正例占实际正类的比例,TP / (TP + FN)。
类似地,特异性(真负例率)衡量模型识别真负例的能力。它是真负例占实际负类的比例,TN / (FP + TN)。
从概率角度看,敏感性是在患者确有疾病的条件下,检测为阳性的概率;特异性是在患者并无疾病的条件下,检测为阴性的概率。
计算敏感性与特异性
在我们的欺诈示例中,敏感性 = TP / (TP + FN) = 160/200,即 80%。特异性为 9500/9800,约 97%。
敏感性-特异性的权衡与 ROC 分析
随着模型阈值的变化,敏感性与特异性常常呈反向变动。提升敏感性通常会降低特异性,反之亦然。本节将探讨这种内在权衡,并讨论接收者操作特征(ROC)分析如何通过可视与定量的方法,在不同阈值下评估模型性能。
权衡
我们稍微修改欺诈示例,使假负例增加 20 起,FN = 60。由于实际欺诈总数仍为 200,那么真正例必须减少 20 起(TP = 140)。
实际欺诈(正类)
实际合法(负类)
预测欺诈(预测为正)
140 (TP)
300 (FP)
460 (TP + FP)
预测为正总数
预测合法(预测为负)
60 (FN)
9500 (TN)
9540 (FN + TN)预测为负总数
200 (TP + FN)实际正类总数
9800 (FP + TN)实际负类总数
10,000
敏感性从 80% 降至 140/200 = 70%。假负例越多,敏感性越低,反之亦然。这意味着高敏感性表示假负例数量较少。
用医学术语来说,高特异性的检测能正确识别大多数没有该病的人。在我们的癌症筛查示例中,高特异性的检测可确保未患癌症的人不会被错误告知患癌。
这说明了敏感性与特异性之间的权衡。少数患者可能会因被误告知患癌而惊慌,但真正患病的人能被正确识别。在这种情况下,更高的特异性是更好的指标。在一个不完美的世界中,我们必须在指标之间的权衡评估基础上做出适当决策。
阈值动态
诊断阈值设定了将检测结果判定为阳性或阴性的临界值。它把连续值(如概率)转换为是/否的界限。通俗而言,它决定在阳性与阴性之间“划线”的位置。
阈值常设为 50%,即 0.50。高于 50% 的概率被视为阳性,低于 50% 则为阴性。
改变阈值会决定哪些案例被视为阳性、哪些被视为阴性。此变化会影响捕获真正例与避免假负例之间的平衡。
例如,考虑一个输出癌症概率的模型。若阈值设为 0.3,模型会将许多人判为阳性。这种方法适合筛查,因为它降低了漏诊的可能性。
然而,它会增加假阳性的风险。若阈值为 0.8,模型会将更少的人判为阳性。此法可减少假阳性,但增加漏诊真实病例的风险。
当阈值改变时,模型在捕获真正例与避免假正例的频率上会发生转移。较低阈值提高敏感性但降低特异性;较高阈值降低敏感性但提高特异性。
ROC 曲线解读
接收者操作特征(ROC)曲线是对比不同分类阈值下敏感性与特异性的常用可视化。ROC 曲线以敏感性为纵轴,对应 1 - 特异性为横轴。曲线上的每个点都代表一个特定阈值。随着阈值变化,模型的敏感性与特异性相应调整,从而描绘出 ROC 曲线。
ROC 曲线体现了敏感性与特异性之间的权衡。曲线上关键点:
对角虚线表示随机水平。沿此线表现的模型没有真正的判别力。
用 ROC 曲线评估模型时,可考虑“曲线下面积”(AUC)。AUC 是曲线下的总面积(积分),表示在所有阈值上的加权平均表现。AUC 越高,表示在区分正负类上的整体能力越强。
AUC 分数
解读
1.0
完美分类器
0.9 - 1.0
优秀
0.8 - 0.9
良好
0.7 - 0.8
一般
0.6 - 0.7
较差
0.5
无判别力(等同随机猜测)
< 0.5
劣于随机
预测值与似然比
本节探讨患病率如何影响检测结果的可靠性。我们还将了解似然比如何将敏感性与特异性整合为单一数值,帮助临床医师在检测后更新诊断概率。
与患病率相关的指标
阳性预测值(PPV),在机器学习中与精确率在数学上等价,反映阳性预测为真的可能性。它衡量被预测为阳性的样本中真正例的比例:PPV = TP / (TP + FP)。
阴性预测值(NPV)反映阴性结果的可靠性。它衡量阴性检测结果中真负例的比例。公式为 NPV = TN / (TN + FN)。
假设我们对 1000 人进行某种疾病检测,其混淆矩阵如下。
实际阳性(患病)
实际阴性(健康)
预测阳性(患病)
80 (TP)
20 (FP)
100
预测阴性(健康)
10 (FN)
890 (TN)
900
90
910
1000
作比较,假设患病人数更多(由 90 增至 300),并相应调整混淆矩阵。
实际阳性(患病)
实际阴性(健康)
预测阳性(患病)
270 (TP)
70 (FP)
340
预测阴性(健康)
30 (FN)
630 (TN)
660
300
700
1000
随着患病率升高,真正例数量随之上升。
似然比
似然比将敏感性与特异性合并为一个数值,帮助临床医师根据检测结果更新诊断信心。
概率与赔率
在应用似然比之前,区分概率与赔率非常重要。概率是事件发生的机会,取值在 0 到 1 之间。赔率表示事件发生相对于不发生的可能性。
75% 的概率意味着事件在 100 次中发生 75 次。相应的赔率为 0.75 / (1 - 0.75) = 0.75 / .025 = 3。这表示事件发生的赔率为 3:1。
更一般地,若 p 为事件发生的概率,则 赔率 = p / (1 - p)。从赔率转回概率,p = 赔率 / (1 + 赔率)。
似然比
阳性似然比(LR+)告诉您,与无该病者相比,阳性结果使患病赔率增加了多少。数值越高(>10)表明该检测在“确诊”(rule in)方面效果越好。公式为 LR+ = 敏感性 / (1 - 特异性)。
阴性似然比(LR-)告诉您,与无该病者相比,阴性结果使患病赔率降低了多少。数值越低(< 0.1)表明该检测在“排除”(rule out)疾病方面效果越好。公式为 LR- = (1 - 敏感性) / 特异性。
检后概率
为做出决定,临床医师首先根据患者症状与病史等因素估计检前概率。将该估计与似然比结合,可计算出检后概率。
流程如下。
例如,假设检前患病概率为 30%,且 LR+ = 10。检后概率是多少?
可见 LR+ 显著改变了概率与诊断信心。
前沿方法与未来方向
随着诊断检测与分类系统日益复杂,新方法不断涌现,以突破传统性能极限。本节将探讨贝叶斯方法如何支持个性化决策阈值,以及 CRISPR 等新技术如何推动分析灵敏度与特异性的前沿。
贝叶斯方法
以先验信念为起点并基于新信息更新,正是贝叶斯统计的核心思想。它提供了一种在新数据面前修正概率的形式化方法。
贝叶斯推理依赖三个关键组成:
其数学表述为贝叶斯定理。
P(A|B) = P(B|A) × P(A) / P(B)
其中 P(A|B) 为后验(在 B 条件下 A 的概率),P(B|A) 为似然(在 A 为真时 B 出现的概率),P(A) 为先验,P(B) 为证据。
用贝叶斯方法优化阈值
如我们所见,传统分类模型常用固定阈值(如 0.5)来决定输出标注为正或负。相较之下,贝叶斯方法允许这些阈值根据情境自适应,包括个体风险因素、人口统计特征、行为历史或实时数据等。此灵活性使系统可动态调整阈值,而非依赖一刀切的静态阈值。
设想一个预测心脏病可能性的模型。传统模型可能使用 0.5 的阈值。概率超过 50% 的患者被视为阳性,低于者为阴性。
现在用贝叶斯方法考虑两位假设患者:
两位患者的检测概率均为 0.45。阈值为 0.5 的固定阈值模型会将两者均判为阴性。
然而,贝叶斯模型会纳入先验风险信息,并可结合预测区间使用。对于患者 A,系统可能下调决策阈值,将其标记为需进一步评估。对于患者 B,可能保持原阈值,不建议随访。
如此,贝叶斯方法可根据每位患者的情境量身定制分类阈值,从而得出更符合临床的决策。
高敏感性/特异性分析检测
一种推动分析灵敏度与特异性极限的新兴技术是基于 CRISPR 的诊断。科学家将 CRISPR(成簇规律间隔短回文重复序列)这一基因编辑工具改造用于检测遗传物质。它利用 Cas 蛋白以高灵敏度检测特定核酸序列。
基于 CRISPR 的分析检测已用于癌症的早期发现。便携的癌症诊断工具正被开发用于临床环境。两个重要的平台是 SHERLOCK 与 DETECTR。
CRISPR 检测具有诸多优势。它们具备高灵敏度,能够检测极微量的 DNA 或 RNA。
这使其在识别感染早期、癌症或罕见突变方面极具价值。同时它们提供出色的特异性,能够区分高度相近的遗传序列,从而减少假阳性。其他优势还包括结果快速、设备低成本且便携。
这些检测支持广泛应用,包括传染病检测、癌症诊断与遗传病筛查。研究人员可用机器学习优化向导 RNA 的设计并提升诊断准确性。
CRISPR 检测也面临挑战。多数仅提供二元结果(阳性或阴性)。标准化与可重复性仍令人担忧,因为不同实验室与检测条件下结果会有差异。
此外,这些检测必须满足包括 FDA 与 CLIA 在内的监管要求,需要大量验证、文档与审查。最后,知识产权问题使许可复杂化并放缓商业化进程。
结语
敏感性与特异性在评估诊断检测与分类模型中发挥核心作用。尤其在数据集不平衡或假阳性与假阴性的代价不同的情形下,它们比准确率更具洞察力。结合似然比与 ROC 分析等相关工具,可引导更有见地的解读与更优的决策。
想进一步提升评估模型性能的实战技能?不妨探索以下 DataCamp 资源: