Makine öğrenmesi uygulayıcıları hem verilerinin kalitesini hem de öngörücü modellerinin performansını değerlendirmelidir.
Çeşitli metrikler yardımcı olabilir; özellikle ikili sınıflandırma görevleri söz konusu olduğunda; yani her bir veri noktasının iki olası kategoriden birine ait olduğunun tahmin edildiği durumlar. Örnekler arasında kredi onayı (onayla/onaylama), kötü amaçlı yazılım sınıflandırması (kötü amaçlı/kötü amaçlı değil), özgeçmiş tarama (kısa listeye al/almama) ve hastalık tanısı (hastalığı var/yok) yer alır. Hatta A/B testleri yakından ilişkilidir; özünde, "B sürümü A sürümünden daha iyi mi?" (evet/hayır) sorusunu sorarlar.
Doğruluk (accuracy) performansa hızlı bir özet sağlasa da, bir modelin hatalarının niteliğine ilişkin kritik bilgileri gizleyebilir. Örneğin, her işlemi yasal olarak etiketleyen bir kredi dolandırıcılığı algılayıcısı %99 doğruluk sağlayabilir, ancak gerçek dolandırıcılıkları tamamen gözden kaçırır. Duyarlılık (sensitivity) ve seçicilik (specificity) daha incelikli içgörüler sunar; bir modelin ne sıklıkla doğru olduğunu değil, aynı zamanda hangi tür hatalar yaptığını ve bu hataların bağlam içinde kabul edilebilir olup olmadığını anlamanıza yardımcı olur.
Bu rehberde, duyarlılık ve seçiciliğin gerçekte ne anlama geldiğini, hangi metrikin ne zaman daha uygun olduğunu, nasıl hesaplandıklarını ve açık, gerçek dünya örnekleriyle işinizde nasıl pratik olarak uygulayabileceğinizi öğreneceksiniz.
Tanısal testler ve klinik karar verme
Duyarlılık ve seçicilik, tıbbi değerlendirmeden doğmuştur. Bu metrikleri tanısal testler ve klinik karar verme merceğinden çerçevelemek, bu yazıdaki birçok kavramı netleştirmeye yardımcı olur. Bunu örneklemek için, iki devam eden örnek kullanacağız: hastalık tespiti ve kredi kartı dolandırıcılığı.
- Tanısal test, bir hastalığı doğrulamak veya dışlamak için kullanılan tıbbi bir işlemdir.
- Analiz (assay) testi, bir örnekte belirli bir maddenin bulunup bulunmadığını ölçer.
- Klinik karar verme, sağlık profesyonellerinin bir hasta hakkında bilgi topladığı, tanı ve tedavi seçeneklerini değerlendirdiği ve kanıta dayalı bilinçli kararlar aldığı süreçtir.
Hedef Kitle
Bu makale, istatistiksel çıkarım kullanan ve daha iyi karar verme için doğruluktan daha incelikli metrikleri anlamak isteyen veri uygulayıcılarına yöneliktir. Bu metrikler, bir modelin hangi tür hatalar yaptığını ve bu hataların bağlam içinde kabul edilebilir olup olmadığını değerlendirmeye yardımcı olur. Uygulamalar arasında gördüğümüz üzere tıbbi tanılar ve dolandırıcılık tespiti yer alır. Diğer uygulamalar arasında izinsiz giriş tespiti, üretimde kalite kontrolü ve spam filtreleme bulunur.
Duyarlılık ve Seçiciliğin Temel Kavramları
Duyarlılığı ve seçiciliği yorumlamadan veya uygulamadan önce, bunların arkasındaki temel kavramları anlamak gerekir. Bu bölümde tarihsel kökenleri, temel tanımları, türetimleri ve hesaplamaları ele alıyoruz.
Tarihçe
Duyarlılık ve seçicilik kavramları biyostatistikte ortaya çıkmıştır. Tıp literatüründe daha önce kullanılmış olsa da, biyostatistik araştırmacısı Jacob Yerushlamy bu terimi "Tıbbi Tanı Yöntemlerinin Değerlendirilmesinde İstatistiksel Sorunlar, Özellikle X-Ray Tekniklerine Özel Referansla" başlıklı makalesinde popülerleştirmiştir.
1970'lerde, alıcı işletim karakteristiği (ROC) eğrisi (ileride açıklanacaktır) klinik testlerde duyarlılık ile seçiciliği görsel olarak analiz etmek için bir araç haline geldi. 1990'larda makine öğrenmesi bu kavramları uyarladı. Günümüzde bu terimler, sistemlerin gerçek pozitifleri ve gerçek negatifleri ne kadar iyi tanımladığını ölçmek için sağlık hizmetlerinde ve makine öğrenmesinde yaygın şekilde kullanılmaktadır.
Karmaşıklık Matrisi (Confusion Matrix)
Bir makine öğrenmesi modelinin sahte kredi kartı işlemlerini tespit etmek için kullanıldığını varsayalım. 10.000 işlemlik bir örneklemde 9.800 yasal işlem ve 200 dolandırıcılık vakası vardır.
Asıl ilgilendiğimiz dolandırıcılık vakaları olduğundan, dolandırıcılık vakalarını pozitif, dolandırıcılık olmayan vakaları negatif olarak belirleyelim. (Hangi vakaların "pozitif" ve "negatif" olarak belirlendiği bir ölçüde keyfidir; ancak genellikle vakaları etiketlemenin bariz bir yolu vardır.)
Modeli çalıştırıp tahmin edilen dolandırıcılık vakalarını gerçek dolandırıcılık vakalarıyla karşılaştırdıktan sonra, 160 dolandırıcılık vakasının doğru biçimde işaretlendiğini, 9.500 yasal işlemin doğru şekilde tanımlandığını, 300 yasal işlemin yanlışlıkla dolandırıcılık olarak işaretlendiğini ve 40 dolandırıcılık vakasının model tarafından kaçırıldığını buluyoruz.
Bu verilerin tümünü düzenli tutmak için aşağıdaki adlandırma yaygın olarak kullanılır.
- Gerçek pozitifler (TP): 160 dolandırıcılık vakası doğru şekilde işaretlenir,
- Gerçek negatifler (TN): 9.500 yasal işlem doğru şekilde tanımlanır,
- Yanlış pozitifler (FP): 300 yasal işlem yanlışlıkla dolandırıcılık olarak işaretlenir ve
- Yanlış negatifler (FN): 40 dolandırıcılık vakası model tarafından kaçırılır.
İkinci harf (P veya N), vakanın pozitif mi yoksa negatif mi olarak tahmin edildiğini ifade eder; ilk harf ise bu tahminin doğru (T) ya da yanlış (F) olup olmadığını belirtir.
Dolayısıyla, "yanlış pozitif", vakanın pozitif olarak tahmin edildiğini ve bu tahminin yanlış olduğunu, diğer bir deyişle, vakanın pozitif olarak tahmin edildiğini ancak gerçekte negatif olduğunu belirtir. Benzer şekilde, yanlış negatif, negatif olarak tahmin edilen ancak gerçekte pozitif olan bir vakadır.
Bu bilgiyi göstermek için, modelin yanlış tahminleri gerçek sonuçlarla (FN, FP) ne sıklıkla karıştırdığını takip ettiği için "karmaşıklık matrisi (confusion matrix)" adı verilen bir tablo kullanılır. İşte bir örnek:
| |
Gerçek Dolandırıcılık (Pozitif)
|
Gerçek Yasal (Negatif)
|
|
Tahmin Edilen Dolandırıcılık (Tahmin Edilen Pozitif)
|
160 (TP)
|
300 (FP)
|
|
Tahmin Edilen Yasal (Tahmin Edilen Negatif)
|
40 (FN)
|
9500 (TN)
|
Şimdi, satır ve sütun toplamlarına bakalım. Satır toplamları toplam tahmin edilen vakaları, sütun toplamları ise toplam gerçek değerleri gösterir.
| |
Gerçek Dolandırıcılık (Pozitif)
|
Gerçek Yasal (Negatif)
| |
|
Tahmin Edilen Dolandırıcılık (Tahmin Edilen Pozitif)
|
160 (TP)
|
300 (FP)
|
460 (TP + FP)
Toplam tahmin edilen pozitifler
|
|
Tahmin Edilen Yasal (Tahmin Edilen Negatif)
|
40 (FN)
|
9500 (TN)
|
9540 (FN + TN)Toplam tahmin edilen negatifler
|
| |
200 (TP + FN)Toplam gerçek pozitifler
|
9800 (FP + TN)Toplam gerçek negatifler
|
10.000
|
Bu toplamlar neyi temsil eder?
- İlk satır toplamı (460), toplam tahmin edilen dolandırıcılık vakalarını (TP + FP) temsil eder.
- İkinci satır toplamı (9540), toplam tahmin edilen yasal vakaları (FN + TN) temsil eder.
- İlk sütun toplamı (200), toplam gerçek dolandırıcılık vakalarını (TP + FN) temsil eder.
- İkinci sütun toplamı (9800), toplam gerçek yasal vakaları (FP + TN) temsil eder
- Genel toplam (10.000), örneklemimizin toplam büyüklüğüne eşittir.
Tanımlar
Duyarlılık (aynı zamanda gerçek pozitif oranı veya anımsama (recall) olarak da bilinir) modelin gerçek pozitifleri doğru biçimde tanımlama yeteneğini ölçer. Daha kesin olarak, duyarlılık, gerçek pozitiflerin gerçek pozitiflere oranıdır, TP / (TP + FN).
Benzer şekilde, seçicilik (gerçek negatif oranı) modelin gerçek negatifleri tanımlama yeteneğini ölçer. Gerçek negatiflerin gerçek negatiflere oranıdır, TN / (FP + TN).
Olasılık açısından bakıldığında, duyarlılık, hastada hastalık varken pozitif bir test sonucu alma olasılığıdır; seçicilik ise hastada hastalık yokken negatif bir test sonucu alma olasılığıdır.
Duyarlılık ve Seçiciliğin Hesaplanması
Dolandırıcılık örneğimizde, duyarlılık = TP / (TP + FN) = 160/200, yani %80. Seçicilik 9500/9800, yani yaklaşık %97'dir.
Duyarlılık-Seçicilik Dengesi ve ROC Analizi
Model eşik değerleri değiştikçe, duyarlılık ve seçicilik çoğu zaman zıt yönlerde hareket eder. Duyarlılığın artırılması genellikle seçiciliği düşürür ve tersi de geçerlidir. Bu bölümde, bu doğuştan gelen dengeyi inceliyor ve Alıcı İşletim Karakteristiği (ROC) analizinin, çeşitli eşiklerde model performansını değerlendirmek için görsel ve nicel bir yaklaşım sunduğunu tartışıyoruz.
Ödünleşimler
Dolandırıcılık örneğini, 20 tane daha yanlış negatif olacak şekilde ayarlayalım, FN = 60. Toplam gerçek dolandırıcılık vaka sayısı hâlâ 200 olduğuna göre, şimdi 20 daha az gerçek pozitif olmalıdır (TP = 140).
| |
Gerçek Dolandırıcılık (Pozitif)
|
Gerçek Yasal (Negatif)
| |
|
Tahmin Edilen Dolandırıcılık (Tahmin Edilen Pozitif)
|
140 (TP)
|
300 (FP)
|
460 (TP + FP)
Toplam tahmin edilen pozitifler
|
|
Tahmin Edilen Yasal (Tahmin Edilen Negatif)
|
60 (FN)
|
9500 (TN)
|
9540 (FN + TN)Toplam tahmin edilen negatifler
|
| |
200 (TP + FN)Toplam gerçek pozitifler
|
9800 (FP + TN)Toplam gerçek negatifler
|
10.000
|
Duyarlılık %80'den 140/200 = %70'e düştü. Yanlış negatif sayısı arttıkça duyarlılık azalır ve tersi de geçerlidir. Bu, yüksek duyarlılığın yanlış negatif sayısının düşük olduğunu gösterdiği anlamına gelir.
Tıbbi açıdan, yüksek seçiciliğe sahip bir test, durumu olmayan çoğu kişiyi doğru şekilde tanımlar. Kanser taraması örneğimizde, yüksek seçiciliğe sahip bir test, kanseri olmayan kişilerin yanlışlıkla kanserleri olduğu söylenmemesini sağlar.
Bu, duyarlılık ve seçicilik arasındaki ödünleşimi ortaya koyar. Birkaç hasta aslında kanserleri olmadığı halde kanserleri olduğu söylendiğinde endişelenebilir, ancak gerçekten hastalığı olanlar doğru şekilde tanımlanır. Bu durumda, yüksek seçicilik daha iyi bir metriktir. Mükemmel olmayan bir dünyada, metrikler arasındaki ödünleşimleri değerlendirerek uygun kararlar vermeliyiz.
Eşik dinamikleri
Bir tanısal eşik, bir test sonucunun pozitif mi negatif mi sayılacağını belirleyen kesme değerini ayarlar. Olasılık gibi sürekli bir değeri evet/hayır kesmesine dönüştürür. Günlük ifadeyle, pozitif ve negatif sonuçlar arasında çizginin nereye çekileceğini belirler.
Eşik genellikle %50 veya 0,50 olarak belirlenir. %50'nin üzerindeki bir olasılık pozitif, %50'den düşük olan negatif kabul edilir.
Eşiklerin değiştirilmesi, hangi vakaların pozitif ve negatif sayılacağını belirler. Bu kayma, gerçek pozitifleri yakalama ile yanlış negatiflerden kaçınma arasındaki dengeyi etkiler.
Örneğin, kanser olasılığını çıktılayan bir modeli düşünün. Eşik 0,3 olarak ayarlanırsa, model birçok kişiyi pozitif olarak sınıflandırır. Bu yaklaşım, vakaları kaçırma olasılığını azalttığı için tarama amacıyla iyi çalışır.
Ancak bu, yanlış pozitif riskini artırır. Eşik 0,8 ise, model daha az kişiyi pozitif olarak sınıflandırır. Bu yaklaşım yanlış pozitifleri azaltır ancak gerçek vakaları kaçırma riskini artırır.
Eşik değiştiğinde, modelin gerçek pozitifleri yakalama sıklığı ve yanlış pozitiflerden kaçınma sıklığı değişir. Daha düşük eşikler duyarlılığı artırır ancak seçiciliği düşürür; daha yüksek eşikler duyarlılığı düşürür ancak seçiciliği artırır.
ROC eğrisinin yorumlanması
Bir Alıcı İşletim Karakteristiği (ROC) eğrisi, duyarlılık ve seçicilik değerleri boyunca sınıflandırma eşiklerini karşılaştırmak için yaygın bir görseldir. ROC eğrisi, duyarlılığı 1 - seçiciliğe karşı çizer. Eğri üzerindeki her nokta belirli bir eşiği temsil eder. Eşik değiştikçe modelin duyarlılığı ve seçiciliği buna göre ayarlanır ve ROC eğrisini izler.
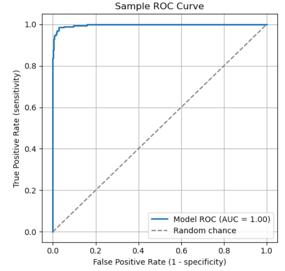
ROC eğrisi, duyarlılık ile seçicilik arasındaki ödünleşimi gösterir. Eğri üzerindeki önemli noktalar:
- (0,1): Yanlış negatif olmadan tüm gerçek pozitifleri tanımlayan kusursuz bir sınıflandırıcı.
- (0,0): Her şeyi negatif olarak tahmin eden ve tüm pozitif vakaları yanlış sınıflandıran aşırı bir model.
- (1,1): Her şeyi pozitif olarak tahmin eden ve tüm negatif vakaları yanlış sınıflandıran aşırı bir model.
Köşegen kesikli çizgi rastlantısal şansı temsil eder. Bu çizgi boyunca performans gösteren bir modelin gerçek bir ayırt edici gücü yoktur.
Bir modeli ROC eğrisiyle değerlendirirken, "Eğri Altındaki Alan"ı (AUC) dikkate alın. AUC, eğrinin altındaki toplam alandır (integral) ve tüm eşikler boyunca performansın ağırlıklı ortalamasını temsil eder. Daha yüksek AUC, pozitif ve negatif sınıflar arasında ayırt etme yeteneğinin genel olarak daha iyi olduğunu gösterir.
|
AUC Skoru
|
Yorum
|
|
1,0
|
Kusursuz sınıflandırıcı
|
|
0,9 - 1,0
|
Mükemmel
|
|
0,8 - 0,9
|
İyi
|
|
0,7 - 0,8
|
Orta
|
|
0,6 - 0,7
|
Zayıf
|
|
0,5
|
Ayırt edicilik yok (rastgele tahmine eşdeğer)
|
|
< 0,5
|
Rastgeleden daha kötü
|
Öngörü Değerleri ve Olabilirlik Oranları
Bu bölümde, görülme sıklığının (prevalansın) test sonuçlarının güvenilirliğini nasıl etkilediğini inceliyoruz. Ayrıca olabilirlik oranlarının, klinisyenlerin test sonrasında tanısal olasılıkları güncellemelerine olanak tanıyan tek bir sayıda duyarlılık ve seçiciliği nasıl birleştirdiğine bakıyoruz.
Prevalansa bağlı metrikler
Pozitif Öngörü Değeri (PPV), makine öğrenmesinde matematiksel olarak kesinliğe (precision) eşdeğerdir ve pozitif bir tahminin doğru olma olasılığını yansıtır. Tahmin edilen pozitiflerin ne kadarının gerçek pozitif olduğunu ölçer: PPV = TP / (TP + FP).
Negatif Öngörü Değeri (NPV), negatif bir sonucun güvenilirliğini yansıtır. Negatif test sonuçlarının ne kadarının gerçek negatif olduğunu ölçer. Formülü NPV = TN / (TN + FN) şeklindedir.
1000 kişiyi aşağıdaki karmaşıklık matrisiyle bir hastalık için test ettiğimizi varsayalım.
| |
Gerçek Pozitif (hasta)
|
Gerçek Negatif (sağlıklı)
| |
|
Tahmin Edilen Pozitif (hasta)
|
80 (TP)
|
20 (FP)
|
100
|
|
Tahmin Edilen Negatif (sağlıklı)
|
10 (FN)
|
890 (TN)
|
900
|
| |
90
|
910
|
1000
|
- PPV = TP / (TP + FP) = 80/100 = %80.
- NPV = TN / (FN + TN) = 890 / 900 = %98,9.
Karşılaştırma için, daha fazla kişinin hasta olduğunu (90 yerine 300) varsayalım ve karmaşıklık matrisini buna göre ayarlayalım.
| |
Gerçek Pozitif (hasta)
|
Gerçek Negatif (sağlıklı)
| |
|
Tahmin Edilen Pozitif (hasta)
|
270 (TP)
|
70 (FP)
|
340
|
|
Tahmin Edilen Negatif (sağlıklı)
|
30 (FN)
|
630 (TN)
|
660
|
| |
300
|
700
|
1000
|
Prevalans arttıkça, gerçek pozitif vaka sayısı yükselir.
- Daha yüksek PPV. Pozitif bir sonuç artık gerçek hastalığı yansıtma olasılığı daha yüksektir. Nitekim PPV = 270 / 300 = %90; önceye kıyasla %80'den %10 artış.
- Daha düşük NPV. Negatif bir sonuç biraz daha az güvenilir hale gelir; çünkü gerçek vakaları kaçırma olasılığı artar. NPV = 630 / 700 = %90; bu da %8,9'luk bir azalmadır.
Olabilirlik oranları
Olabilirlik oranları, klinisyenlerin bir test sonucuna dayanarak tanı konusundaki güvenlerini güncellemelerine yardımcı olan, duyarlılık ve seçiciliği tek bir sayıda birleştirir.
Olasılık ve bahis oranı
Olabilirlik oranlarını uygulamadan önce, olasılık ile bahis oranı (odds) arasındaki farkı ayırt etmek önemlidir. Olasılık, 0 ile 1 arasında bir değerle ifade edilen, bir olayın gerçekleşme şansıdır. Bahis oranı, bir olayın gerçekleşmesinin, gerçekleşmemesine göre ne kadar olası olduğunu temsil eder.
%75 olasılık, olayın 100'de 75 kez gerçekleştiği anlamına gelir. Buna karşılık gelen bahis oranı 0,75 / (1 - 0,75) = 0,75 / .025 = 3'tür. Bu, olayın gerçekleşmesi lehine oranın 3'e 1 olduğu anlamına gelir.
Daha genel olarak, p bir olayın olasılığı ise, bahis oranı = p / (1 - p). Bahis oranından olasılığa dönüşümde p = bahis oranı / (1 + bahis oranı).
Olabilirlik oranları
Pozitif olabilirlik oranı (LR+), pozitif bir sonucun, durumu olmayan birine kıyasla, duruma sahip olma bahis oranını ne kadar artırdığını gösterir. Daha yüksek değerler (>10), testin durumu doğrulamada çok etkili olduğunu gösterir. Formül: LR+ = Duyarlılık / (1 - Seçicilik).
Negatif olabilirlik oranı (LR-), negatif bir sonucun, durumu olmayan birine kıyasla, duruma sahip olma bahis oranını ne kadar azalttığını gösterir. Daha düşük değerler (< 0,1), testin bir durumu dışlamada çok etkili olduğunu gösterir. Formül: LR- = (1 - Duyarlılık) / Seçicilik.
Test sonrası olasılık
Karar verebilmek için klinisyenler, hastanın semptomları ve öyküsü gibi faktörlere dayalı bir test öncesi olasılıkla başlarlar. Bu tahmin, test sonrası olasılığı hesaplamak üzere olabilirlik oranıyla birleştirilir.
İşlem şu şekildedir.
- Test öncesi olasılık p ile başlayın.
- Bahis oranına dönüştürün. Test öncesi bahis oranı = p / (1 - p).
- Olabilirlik oranını uygulayın. Test pozitifse test öncesi bahis oranını LR+ ile, negatifse LR- ile çarpın. Test sonrası bahis oranı = test öncesi bahis oranı x LR.
- Test sonrası bahis oranını tekrar olasılığa dönüştürün. Test sonrası olasılık = Test sonrası bahis oranı / (1 + test sonrası bahis oranı).
Örneğin, hastalık için test öncesi olasılığın %30 ve LR+ = 10 olduğunu varsayalım. Test sonrası olasılık nedir?
- p = 0,3
- Test öncesi bahis oranı = 0,3/0,7 = 0,43.
- Test sonrası bahis oranı = 0,43 * 10 = 4,3
- Test sonrası olasılık = 4,3 / (1 + 4,3) = %81.
LR+'nın olasılığı ve tanı konusundaki güveni anlamlı ölçüde kaydırdığını görüyoruz.
İleri Yöntemler ve Gelecek Yönelimler
Tanısal testler ve sınıflandırma sistemleri daha karmaşık hale geldikçe, geleneksel performans sınırlarını aşmak için yeni yöntemler ortaya çıkıyor. Bu bölümde, Bayesçi yaklaşımların kişiselleştirilmiş karar eşiklerine nasıl imkân verdiğini ve CRISPR tabanlı tanılar gibi yeni teknolojilerin analitik duyarlılık ve seçiciliğin sınırlarını nasıl zorladığını inceliyoruz.
Bayesçi yaklaşımlar
Önceki bir inançla başlayıp yeni bilgilere dayanarak onu güncelleme fikri, Bayes istatistiğinin özünde yatar. Yeni veriler ışığında olasılıkları resmi olarak revize etmenin bir yolunu sunar.
Bayesçi akıl yürütme üç temel bileşene dayanır.
- Önsel olasılık. Bu, yeni kanıtları görmeden önceki ilk inançtır. ("Tahmin yağmur riskinin %60 olduğunu söylüyordu.")
- Olabilirlik. Bu, inanç doğruysa yeni kanıtın ne kadar olası olduğudur. ("Yağmur sesi duydum, dolayısıyla doğru tahmin olasılığı yüksek.")
- Artgösterge (posterior) olasılık. Bu, yeni kanıtlar dikkate alındıktan sonraki revize edilmiş inançtır. Önsel olasılıkla olabilirliğin çarpılmasıyla bulunur.
Bu, matematiksel olarak Bayes teoremi ile tanımlanır.
P(A|B) = P(B|A) x P(A) / P(B)
Burada P(A|B) artgösterge (B verildiğinde A olasılığı), P(B|A) olabilirlik (A doğruyken B'nin olasılığı), P(A) önseldir ve P(B) kanıttır.
Bayesçi yaklaşımlarla eşiklerin optimize edilmesi
Gördüğümüz gibi, geleneksel sınıflandırma modelleri, bir çıktının pozitif veya negatif etiketlenip etiketlenmeyeceğini belirlemek için sıklıkla 0,5 gibi sabit bir eşik uygular. Buna karşılık Bayesçi yaklaşımlar, bireysel risk faktörleri, demografi, davranış geçmişi veya gerçek zamanlı veriler gibi bağlama göre bu eşiklerin uyarlanmasına olanak tanır. Bu esneklik, sistemlerin herkese uyan tek bir sabit eşik yerine eşikleri dinamik olarak ayarlamasını sağlar.
Kalp hastalığı olasılığını tahmin eden bir modeli düşünün. Geleneksel bir model 0,5 eşik değeri kullanabilir. %50'nin üzerindeki olasılığa sahip hastalar pozitif, altında kalanlar negatif kabul edilir.
Şimdi, iki varsayımsal hasta ile bir Bayesçi yaklaşımı düşünün:
- Hasta A, ömür boyu sigara içmiş, kalp hastalığı aile öyküsü olan ve son zamanlarda göğüs ağrısı yaşayan 68 yaşında biridir.
- Hasta B, semptomu veya ilgili öyküsü olmayan 25 yaşında, sigara içmeyen biridir.
Her iki hastaya da test kaynaklı 0,45 olasılığı veriliyor. Eşiği 0,5 olan sabit eşikli bir model bu iki hastayı da negatif olarak değerlendirirdi.
Ancak Bayesçi bir model, önceden bilinen risk bilgilerini içerir ve tahmin aralıkları ile birlikte kullanılabilir. Hasta A için sistem karar eşiğini düşürerek vakayı daha ileri değerlendirme için işaretleyebilir. Hasta B için eşiği aynı tutabilir ve takip önerilmez.
Bu şekilde Bayesçi yöntemler, sınıflandırma eşiğini her hastanın bağlamına göre uyarlayarak daha klinik açıdan uygun kararlar verilmesini sağlar.
Yüksek duyarlılık/seçicilikte analizler
Analitik duyarlılık ve seçiciliğin sınırlarını zorlayan yükselen bir teknoloji CRISPR tabanlı tanılardır. Bilim insanları, bir gen düzenleme aracı olan CRISPR'ı (Clustered Regularly Interspaced Short Palindromic Repeats) genetik materyali algılamak üzere uyarladı. Belirli nükleik asit dizilerini yüksek duyarlılıkla tespit etmek için Cas proteinlerini kullanır.
CRISPR tabanlı analizler kanserin erken tespitinde kullanılmıştır. Klinik ortamlarda kullanım için taşınabilir kanser tanı araçları geliştirilmektedir. İki önemli tanısal platform SHERLOCK ve DETECTR'dır.
CRISPR tabanlı analizler birçok avantaj sunar. Yüksek duyarlılık sağlarlar; böylece çok az miktardaki DNA veya RNA'yı tespit edebilirler.
Bu, erken evre enfeksiyonları, kanseri veya nadir mutasyonları belirlemede onları değerli kılar. Ayrıca olağanüstü seçicilik sunarak birbirine yakın genetik dizileri ayırt etmelerine ve yanlış pozitifleri azaltmalarına olanak tanır. Ek faydalar arasında hızlı sonuçlar ve düşük maliyetli, taşınabilir ekipman yer alır.
Bu analizler, bulaşıcı hastalık tespiti, kanser tanısı ve genetik hastalık taraması dahil geniş bir yelpazede uygulamaları destekler. Araştırmacılar, kılavuz RNA tasarımını optimize etmek ve tanısal doğruluğu artırmak için makine öğrenmesini kullanabilir.
CRISPR tabanlı analizlerin zorlukları da vardır. Çoğu yalnızca ikili bir sonuç (pozitif veya negatif) sağlar. Standardizasyon ve yeniden üretilebilirlik hâlâ endişe konusudur; zira sonuçlar laboratuvarlar ve test koşulları arasında değişkenlik gösterir.
Ayrıca, bu analizlerin FDA ve CLIA onayı dahil düzenleyici gereklilikleri karşılaması gerekir; bu da kapsamlı doğrulama, dokümantasyon ve inceleme gerektirir. Son olarak, fikri mülkiyet konuları lisanslamayı karmaşıklaştırır ve ticarileştirmeyi yavaşlatır.
Sonuç
Duyarlılık ve seçicilik, tanısal testleri ve sınıflandırma modellerini değerlendirmede merkezi bir rol oynar. Özellikle dengesiz veri setlerinde veya yanlış pozitifler ile yanlış negatiflerin farklı maliyetler taşıdığı durumlarda, doğruluktan daha aydınlatıcı olabilirler. Olabilirlik oranları ve ROC analizi gibi ilgili araçlarla birlikte, isabetli yorumlama ve daha iyi karar vermeyi yönlendirirler.
Model performansını değerlendirme konusundaki pratik becerilerinizi derinleştirmek ister misiniz? Şu DataCamp kaynaklarını mutlaka inceleyin:





Makine öğrenmesi uygulayıcıları hem verilerinin kalitesini hem de öngörücü modellerinin performansını değerlendirmelidir.
Çeşitli metrikler yardımcı olabilir; özellikle ikili sınıflandırma görevleri söz konusu olduğunda; yani her bir veri noktasının iki olası kategoriden birine ait olduğunun tahmin edildiği durumlar. Örnekler arasında kredi onayı (onayla/onaylama), kötü amaçlı yazılım sınıflandırması (kötü amaçlı/kötü amaçlı değil), özgeçmiş tarama (kısa listeye al/almama) ve hastalık tanısı (hastalığı var/yok) yer alır. Hatta A/B testleri yakından ilişkilidir; özünde, "B sürümü A sürümünden daha iyi mi?" (evet/hayır) sorusunu sorarlar.
Doğruluk (accuracy) performansa hızlı bir özet sağlasa da, bir modelin hatalarının niteliğine ilişkin kritik bilgileri gizleyebilir. Örneğin, her işlemi yasal olarak etiketleyen bir kredi dolandırıcılığı algılayıcısı %99 doğruluk sağlayabilir, ancak gerçek dolandırıcılıkları tamamen gözden kaçırır. Duyarlılık (sensitivity) ve seçicilik (specificity) daha incelikli içgörüler sunar; bir modelin ne sıklıkla doğru olduğunu değil, aynı zamanda hangi tür hatalar yaptığını ve bu hataların bağlam içinde kabul edilebilir olup olmadığını anlamanıza yardımcı olur.
Bu rehberde, duyarlılık ve seçiciliğin gerçekte ne anlama geldiğini, hangi metrikin ne zaman daha uygun olduğunu, nasıl hesaplandıklarını ve açık, gerçek dünya örnekleriyle işinizde nasıl pratik olarak uygulayabileceğinizi öğreneceksiniz.
Tanısal testler ve klinik karar verme
Duyarlılık ve seçicilik, tıbbi değerlendirmeden doğmuştur. Bu metrikleri tanısal testler ve klinik karar verme merceğinden çerçevelemek, bu yazıdaki birçok kavramı netleştirmeye yardımcı olur. Bunu örneklemek için, iki devam eden örnek kullanacağız: hastalık tespiti ve kredi kartı dolandırıcılığı.
Hedef Kitle
Bu makale, istatistiksel çıkarım kullanan ve daha iyi karar verme için doğruluktan daha incelikli metrikleri anlamak isteyen veri uygulayıcılarına yöneliktir. Bu metrikler, bir modelin hangi tür hatalar yaptığını ve bu hataların bağlam içinde kabul edilebilir olup olmadığını değerlendirmeye yardımcı olur. Uygulamalar arasında gördüğümüz üzere tıbbi tanılar ve dolandırıcılık tespiti yer alır. Diğer uygulamalar arasında izinsiz giriş tespiti, üretimde kalite kontrolü ve spam filtreleme bulunur.
Duyarlılık ve Seçiciliğin Temel Kavramları
Duyarlılığı ve seçiciliği yorumlamadan veya uygulamadan önce, bunların arkasındaki temel kavramları anlamak gerekir. Bu bölümde tarihsel kökenleri, temel tanımları, türetimleri ve hesaplamaları ele alıyoruz.
Tarihçe
Duyarlılık ve seçicilik kavramları biyostatistikte ortaya çıkmıştır. Tıp literatüründe daha önce kullanılmış olsa da, biyostatistik araştırmacısı Jacob Yerushlamy bu terimi "Tıbbi Tanı Yöntemlerinin Değerlendirilmesinde İstatistiksel Sorunlar, Özellikle X-Ray Tekniklerine Özel Referansla" başlıklı makalesinde popülerleştirmiştir.
1970'lerde, alıcı işletim karakteristiği (ROC) eğrisi (ileride açıklanacaktır) klinik testlerde duyarlılık ile seçiciliği görsel olarak analiz etmek için bir araç haline geldi. 1990'larda makine öğrenmesi bu kavramları uyarladı. Günümüzde bu terimler, sistemlerin gerçek pozitifleri ve gerçek negatifleri ne kadar iyi tanımladığını ölçmek için sağlık hizmetlerinde ve makine öğrenmesinde yaygın şekilde kullanılmaktadır.
Karmaşıklık Matrisi (Confusion Matrix)
Bir makine öğrenmesi modelinin sahte kredi kartı işlemlerini tespit etmek için kullanıldığını varsayalım. 10.000 işlemlik bir örneklemde 9.800 yasal işlem ve 200 dolandırıcılık vakası vardır.
Asıl ilgilendiğimiz dolandırıcılık vakaları olduğundan, dolandırıcılık vakalarını pozitif, dolandırıcılık olmayan vakaları negatif olarak belirleyelim. (Hangi vakaların "pozitif" ve "negatif" olarak belirlendiği bir ölçüde keyfidir; ancak genellikle vakaları etiketlemenin bariz bir yolu vardır.)
Modeli çalıştırıp tahmin edilen dolandırıcılık vakalarını gerçek dolandırıcılık vakalarıyla karşılaştırdıktan sonra, 160 dolandırıcılık vakasının doğru biçimde işaretlendiğini, 9.500 yasal işlemin doğru şekilde tanımlandığını, 300 yasal işlemin yanlışlıkla dolandırıcılık olarak işaretlendiğini ve 40 dolandırıcılık vakasının model tarafından kaçırıldığını buluyoruz.
Bu verilerin tümünü düzenli tutmak için aşağıdaki adlandırma yaygın olarak kullanılır.
İkinci harf (P veya N), vakanın pozitif mi yoksa negatif mi olarak tahmin edildiğini ifade eder; ilk harf ise bu tahminin doğru (T) ya da yanlış (F) olup olmadığını belirtir.
Dolayısıyla, "yanlış pozitif", vakanın pozitif olarak tahmin edildiğini ve bu tahminin yanlış olduğunu, diğer bir deyişle, vakanın pozitif olarak tahmin edildiğini ancak gerçekte negatif olduğunu belirtir. Benzer şekilde, yanlış negatif, negatif olarak tahmin edilen ancak gerçekte pozitif olan bir vakadır.
Bu bilgiyi göstermek için, modelin yanlış tahminleri gerçek sonuçlarla (FN, FP) ne sıklıkla karıştırdığını takip ettiği için "karmaşıklık matrisi (confusion matrix)" adı verilen bir tablo kullanılır. İşte bir örnek:
Gerçek Dolandırıcılık (Pozitif)
Gerçek Yasal (Negatif)
Tahmin Edilen Dolandırıcılık (Tahmin Edilen Pozitif)
160 (TP)
300 (FP)
Tahmin Edilen Yasal (Tahmin Edilen Negatif)
40 (FN)
9500 (TN)
Şimdi, satır ve sütun toplamlarına bakalım. Satır toplamları toplam tahmin edilen vakaları, sütun toplamları ise toplam gerçek değerleri gösterir.
Gerçek Dolandırıcılık (Pozitif)
Gerçek Yasal (Negatif)
Tahmin Edilen Dolandırıcılık (Tahmin Edilen Pozitif)
160 (TP)
300 (FP)
460 (TP + FP)
Toplam tahmin edilen pozitifler
Tahmin Edilen Yasal (Tahmin Edilen Negatif)
40 (FN)
9500 (TN)
9540 (FN + TN)Toplam tahmin edilen negatifler
200 (TP + FN)Toplam gerçek pozitifler
9800 (FP + TN)Toplam gerçek negatifler
10.000
Bu toplamlar neyi temsil eder?
Tanımlar
Duyarlılık (aynı zamanda gerçek pozitif oranı veya anımsama (recall) olarak da bilinir) modelin gerçek pozitifleri doğru biçimde tanımlama yeteneğini ölçer. Daha kesin olarak, duyarlılık, gerçek pozitiflerin gerçek pozitiflere oranıdır, TP / (TP + FN).
Benzer şekilde, seçicilik (gerçek negatif oranı) modelin gerçek negatifleri tanımlama yeteneğini ölçer. Gerçek negatiflerin gerçek negatiflere oranıdır, TN / (FP + TN).
Olasılık açısından bakıldığında, duyarlılık, hastada hastalık varken pozitif bir test sonucu alma olasılığıdır; seçicilik ise hastada hastalık yokken negatif bir test sonucu alma olasılığıdır.
Duyarlılık ve Seçiciliğin Hesaplanması
Dolandırıcılık örneğimizde, duyarlılık = TP / (TP + FN) = 160/200, yani %80. Seçicilik 9500/9800, yani yaklaşık %97'dir.
Duyarlılık-Seçicilik Dengesi ve ROC Analizi
Model eşik değerleri değiştikçe, duyarlılık ve seçicilik çoğu zaman zıt yönlerde hareket eder. Duyarlılığın artırılması genellikle seçiciliği düşürür ve tersi de geçerlidir. Bu bölümde, bu doğuştan gelen dengeyi inceliyor ve Alıcı İşletim Karakteristiği (ROC) analizinin, çeşitli eşiklerde model performansını değerlendirmek için görsel ve nicel bir yaklaşım sunduğunu tartışıyoruz.
Ödünleşimler
Dolandırıcılık örneğini, 20 tane daha yanlış negatif olacak şekilde ayarlayalım, FN = 60. Toplam gerçek dolandırıcılık vaka sayısı hâlâ 200 olduğuna göre, şimdi 20 daha az gerçek pozitif olmalıdır (TP = 140).
Gerçek Dolandırıcılık (Pozitif)
Gerçek Yasal (Negatif)
Tahmin Edilen Dolandırıcılık (Tahmin Edilen Pozitif)
140 (TP)
300 (FP)
460 (TP + FP)
Toplam tahmin edilen pozitifler
Tahmin Edilen Yasal (Tahmin Edilen Negatif)
60 (FN)
9500 (TN)
9540 (FN + TN)Toplam tahmin edilen negatifler
200 (TP + FN)Toplam gerçek pozitifler
9800 (FP + TN)Toplam gerçek negatifler
10.000
Duyarlılık %80'den 140/200 = %70'e düştü. Yanlış negatif sayısı arttıkça duyarlılık azalır ve tersi de geçerlidir. Bu, yüksek duyarlılığın yanlış negatif sayısının düşük olduğunu gösterdiği anlamına gelir.
Tıbbi açıdan, yüksek seçiciliğe sahip bir test, durumu olmayan çoğu kişiyi doğru şekilde tanımlar. Kanser taraması örneğimizde, yüksek seçiciliğe sahip bir test, kanseri olmayan kişilerin yanlışlıkla kanserleri olduğu söylenmemesini sağlar.
Bu, duyarlılık ve seçicilik arasındaki ödünleşimi ortaya koyar. Birkaç hasta aslında kanserleri olmadığı halde kanserleri olduğu söylendiğinde endişelenebilir, ancak gerçekten hastalığı olanlar doğru şekilde tanımlanır. Bu durumda, yüksek seçicilik daha iyi bir metriktir. Mükemmel olmayan bir dünyada, metrikler arasındaki ödünleşimleri değerlendirerek uygun kararlar vermeliyiz.
Eşik dinamikleri
Bir tanısal eşik, bir test sonucunun pozitif mi negatif mi sayılacağını belirleyen kesme değerini ayarlar. Olasılık gibi sürekli bir değeri evet/hayır kesmesine dönüştürür. Günlük ifadeyle, pozitif ve negatif sonuçlar arasında çizginin nereye çekileceğini belirler.
Eşik genellikle %50 veya 0,50 olarak belirlenir. %50'nin üzerindeki bir olasılık pozitif, %50'den düşük olan negatif kabul edilir.
Eşiklerin değiştirilmesi, hangi vakaların pozitif ve negatif sayılacağını belirler. Bu kayma, gerçek pozitifleri yakalama ile yanlış negatiflerden kaçınma arasındaki dengeyi etkiler.
Örneğin, kanser olasılığını çıktılayan bir modeli düşünün. Eşik 0,3 olarak ayarlanırsa, model birçok kişiyi pozitif olarak sınıflandırır. Bu yaklaşım, vakaları kaçırma olasılığını azalttığı için tarama amacıyla iyi çalışır.
Ancak bu, yanlış pozitif riskini artırır. Eşik 0,8 ise, model daha az kişiyi pozitif olarak sınıflandırır. Bu yaklaşım yanlış pozitifleri azaltır ancak gerçek vakaları kaçırma riskini artırır.
Eşik değiştiğinde, modelin gerçek pozitifleri yakalama sıklığı ve yanlış pozitiflerden kaçınma sıklığı değişir. Daha düşük eşikler duyarlılığı artırır ancak seçiciliği düşürür; daha yüksek eşikler duyarlılığı düşürür ancak seçiciliği artırır.
ROC eğrisinin yorumlanması
Bir Alıcı İşletim Karakteristiği (ROC) eğrisi, duyarlılık ve seçicilik değerleri boyunca sınıflandırma eşiklerini karşılaştırmak için yaygın bir görseldir. ROC eğrisi, duyarlılığı 1 - seçiciliğe karşı çizer. Eğri üzerindeki her nokta belirli bir eşiği temsil eder. Eşik değiştikçe modelin duyarlılığı ve seçiciliği buna göre ayarlanır ve ROC eğrisini izler.
ROC eğrisi, duyarlılık ile seçicilik arasındaki ödünleşimi gösterir. Eğri üzerindeki önemli noktalar:
Köşegen kesikli çizgi rastlantısal şansı temsil eder. Bu çizgi boyunca performans gösteren bir modelin gerçek bir ayırt edici gücü yoktur.
Bir modeli ROC eğrisiyle değerlendirirken, "Eğri Altındaki Alan"ı (AUC) dikkate alın. AUC, eğrinin altındaki toplam alandır (integral) ve tüm eşikler boyunca performansın ağırlıklı ortalamasını temsil eder. Daha yüksek AUC, pozitif ve negatif sınıflar arasında ayırt etme yeteneğinin genel olarak daha iyi olduğunu gösterir.
AUC Skoru
Yorum
1,0
Kusursuz sınıflandırıcı
0,9 - 1,0
Mükemmel
0,8 - 0,9
İyi
0,7 - 0,8
Orta
0,6 - 0,7
Zayıf
0,5
Ayırt edicilik yok (rastgele tahmine eşdeğer)
< 0,5
Rastgeleden daha kötü
Öngörü Değerleri ve Olabilirlik Oranları
Bu bölümde, görülme sıklığının (prevalansın) test sonuçlarının güvenilirliğini nasıl etkilediğini inceliyoruz. Ayrıca olabilirlik oranlarının, klinisyenlerin test sonrasında tanısal olasılıkları güncellemelerine olanak tanıyan tek bir sayıda duyarlılık ve seçiciliği nasıl birleştirdiğine bakıyoruz.
Prevalansa bağlı metrikler
Pozitif Öngörü Değeri (PPV), makine öğrenmesinde matematiksel olarak kesinliğe (precision) eşdeğerdir ve pozitif bir tahminin doğru olma olasılığını yansıtır. Tahmin edilen pozitiflerin ne kadarının gerçek pozitif olduğunu ölçer: PPV = TP / (TP + FP).
Negatif Öngörü Değeri (NPV), negatif bir sonucun güvenilirliğini yansıtır. Negatif test sonuçlarının ne kadarının gerçek negatif olduğunu ölçer. Formülü NPV = TN / (TN + FN) şeklindedir.
1000 kişiyi aşağıdaki karmaşıklık matrisiyle bir hastalık için test ettiğimizi varsayalım.
Gerçek Pozitif (hasta)
Gerçek Negatif (sağlıklı)
Tahmin Edilen Pozitif (hasta)
80 (TP)
20 (FP)
100
Tahmin Edilen Negatif (sağlıklı)
10 (FN)
890 (TN)
900
90
910
1000
Karşılaştırma için, daha fazla kişinin hasta olduğunu (90 yerine 300) varsayalım ve karmaşıklık matrisini buna göre ayarlayalım.
Gerçek Pozitif (hasta)
Gerçek Negatif (sağlıklı)
Tahmin Edilen Pozitif (hasta)
270 (TP)
70 (FP)
340
Tahmin Edilen Negatif (sağlıklı)
30 (FN)
630 (TN)
660
300
700
1000
Prevalans arttıkça, gerçek pozitif vaka sayısı yükselir.
Olabilirlik oranları
Olabilirlik oranları, klinisyenlerin bir test sonucuna dayanarak tanı konusundaki güvenlerini güncellemelerine yardımcı olan, duyarlılık ve seçiciliği tek bir sayıda birleştirir.
Olasılık ve bahis oranı
Olabilirlik oranlarını uygulamadan önce, olasılık ile bahis oranı (odds) arasındaki farkı ayırt etmek önemlidir. Olasılık, 0 ile 1 arasında bir değerle ifade edilen, bir olayın gerçekleşme şansıdır. Bahis oranı, bir olayın gerçekleşmesinin, gerçekleşmemesine göre ne kadar olası olduğunu temsil eder.
%75 olasılık, olayın 100'de 75 kez gerçekleştiği anlamına gelir. Buna karşılık gelen bahis oranı 0,75 / (1 - 0,75) = 0,75 / .025 = 3'tür. Bu, olayın gerçekleşmesi lehine oranın 3'e 1 olduğu anlamına gelir.
Daha genel olarak, p bir olayın olasılığı ise, bahis oranı = p / (1 - p). Bahis oranından olasılığa dönüşümde p = bahis oranı / (1 + bahis oranı).
Olabilirlik oranları
Pozitif olabilirlik oranı (LR+), pozitif bir sonucun, durumu olmayan birine kıyasla, duruma sahip olma bahis oranını ne kadar artırdığını gösterir. Daha yüksek değerler (>10), testin durumu doğrulamada çok etkili olduğunu gösterir. Formül: LR+ = Duyarlılık / (1 - Seçicilik).
Negatif olabilirlik oranı (LR-), negatif bir sonucun, durumu olmayan birine kıyasla, duruma sahip olma bahis oranını ne kadar azalttığını gösterir. Daha düşük değerler (< 0,1), testin bir durumu dışlamada çok etkili olduğunu gösterir. Formül: LR- = (1 - Duyarlılık) / Seçicilik.
Test sonrası olasılık
Karar verebilmek için klinisyenler, hastanın semptomları ve öyküsü gibi faktörlere dayalı bir test öncesi olasılıkla başlarlar. Bu tahmin, test sonrası olasılığı hesaplamak üzere olabilirlik oranıyla birleştirilir.
İşlem şu şekildedir.
Örneğin, hastalık için test öncesi olasılığın %30 ve LR+ = 10 olduğunu varsayalım. Test sonrası olasılık nedir?
LR+'nın olasılığı ve tanı konusundaki güveni anlamlı ölçüde kaydırdığını görüyoruz.
İleri Yöntemler ve Gelecek Yönelimler
Tanısal testler ve sınıflandırma sistemleri daha karmaşık hale geldikçe, geleneksel performans sınırlarını aşmak için yeni yöntemler ortaya çıkıyor. Bu bölümde, Bayesçi yaklaşımların kişiselleştirilmiş karar eşiklerine nasıl imkân verdiğini ve CRISPR tabanlı tanılar gibi yeni teknolojilerin analitik duyarlılık ve seçiciliğin sınırlarını nasıl zorladığını inceliyoruz.
Bayesçi yaklaşımlar
Önceki bir inançla başlayıp yeni bilgilere dayanarak onu güncelleme fikri, Bayes istatistiğinin özünde yatar. Yeni veriler ışığında olasılıkları resmi olarak revize etmenin bir yolunu sunar.
Bayesçi akıl yürütme üç temel bileşene dayanır.
Bu, matematiksel olarak Bayes teoremi ile tanımlanır.
P(A|B) = P(B|A) x P(A) / P(B)
Burada P(A|B) artgösterge (B verildiğinde A olasılığı), P(B|A) olabilirlik (A doğruyken B'nin olasılığı), P(A) önseldir ve P(B) kanıttır.
Bayesçi yaklaşımlarla eşiklerin optimize edilmesi
Gördüğümüz gibi, geleneksel sınıflandırma modelleri, bir çıktının pozitif veya negatif etiketlenip etiketlenmeyeceğini belirlemek için sıklıkla 0,5 gibi sabit bir eşik uygular. Buna karşılık Bayesçi yaklaşımlar, bireysel risk faktörleri, demografi, davranış geçmişi veya gerçek zamanlı veriler gibi bağlama göre bu eşiklerin uyarlanmasına olanak tanır. Bu esneklik, sistemlerin herkese uyan tek bir sabit eşik yerine eşikleri dinamik olarak ayarlamasını sağlar.
Kalp hastalığı olasılığını tahmin eden bir modeli düşünün. Geleneksel bir model 0,5 eşik değeri kullanabilir. %50'nin üzerindeki olasılığa sahip hastalar pozitif, altında kalanlar negatif kabul edilir.
Şimdi, iki varsayımsal hasta ile bir Bayesçi yaklaşımı düşünün:
Her iki hastaya da test kaynaklı 0,45 olasılığı veriliyor. Eşiği 0,5 olan sabit eşikli bir model bu iki hastayı da negatif olarak değerlendirirdi.
Ancak Bayesçi bir model, önceden bilinen risk bilgilerini içerir ve tahmin aralıkları ile birlikte kullanılabilir. Hasta A için sistem karar eşiğini düşürerek vakayı daha ileri değerlendirme için işaretleyebilir. Hasta B için eşiği aynı tutabilir ve takip önerilmez.
Bu şekilde Bayesçi yöntemler, sınıflandırma eşiğini her hastanın bağlamına göre uyarlayarak daha klinik açıdan uygun kararlar verilmesini sağlar.
Yüksek duyarlılık/seçicilikte analizler
Analitik duyarlılık ve seçiciliğin sınırlarını zorlayan yükselen bir teknoloji CRISPR tabanlı tanılardır. Bilim insanları, bir gen düzenleme aracı olan CRISPR'ı (Clustered Regularly Interspaced Short Palindromic Repeats) genetik materyali algılamak üzere uyarladı. Belirli nükleik asit dizilerini yüksek duyarlılıkla tespit etmek için Cas proteinlerini kullanır.
CRISPR tabanlı analizler kanserin erken tespitinde kullanılmıştır. Klinik ortamlarda kullanım için taşınabilir kanser tanı araçları geliştirilmektedir. İki önemli tanısal platform SHERLOCK ve DETECTR'dır.
CRISPR tabanlı analizler birçok avantaj sunar. Yüksek duyarlılık sağlarlar; böylece çok az miktardaki DNA veya RNA'yı tespit edebilirler.
Bu, erken evre enfeksiyonları, kanseri veya nadir mutasyonları belirlemede onları değerli kılar. Ayrıca olağanüstü seçicilik sunarak birbirine yakın genetik dizileri ayırt etmelerine ve yanlış pozitifleri azaltmalarına olanak tanır. Ek faydalar arasında hızlı sonuçlar ve düşük maliyetli, taşınabilir ekipman yer alır.
Bu analizler, bulaşıcı hastalık tespiti, kanser tanısı ve genetik hastalık taraması dahil geniş bir yelpazede uygulamaları destekler. Araştırmacılar, kılavuz RNA tasarımını optimize etmek ve tanısal doğruluğu artırmak için makine öğrenmesini kullanabilir.
CRISPR tabanlı analizlerin zorlukları da vardır. Çoğu yalnızca ikili bir sonuç (pozitif veya negatif) sağlar. Standardizasyon ve yeniden üretilebilirlik hâlâ endişe konusudur; zira sonuçlar laboratuvarlar ve test koşulları arasında değişkenlik gösterir.
Ayrıca, bu analizlerin FDA ve CLIA onayı dahil düzenleyici gereklilikleri karşılaması gerekir; bu da kapsamlı doğrulama, dokümantasyon ve inceleme gerektirir. Son olarak, fikri mülkiyet konuları lisanslamayı karmaşıklaştırır ve ticarileştirmeyi yavaşlatır.
Sonuç
Duyarlılık ve seçicilik, tanısal testleri ve sınıflandırma modellerini değerlendirmede merkezi bir rol oynar. Özellikle dengesiz veri setlerinde veya yanlış pozitifler ile yanlış negatiflerin farklı maliyetler taşıdığı durumlarda, doğruluktan daha aydınlatıcı olabilirler. Olabilirlik oranları ve ROC analizi gibi ilgili araçlarla birlikte, isabetli yorumlama ve daha iyi karar vermeyi yönlendirirler.
Model performansını değerlendirme konusundaki pratik becerilerinizi derinleştirmek ister misiniz? Şu DataCamp kaynaklarını mutlaka inceleyin: