
Leerpad
Basisprincipes van machine learning in Python
16 uur
Machine learning-practitioners moeten zowel de kwaliteit van hun data als de prestaties van hun voorspellende modellen evalueren.
Verschillende metrics kunnen helpen, vooral bij binaire classificatietaken; waarbij elk datapunt wordt voorspeld tot een van twee mogelijke categorieën te behoren. Voorbeelden zijn kredietgoedkeuring (goedkeuren/niet goedkeuren), malwareclassificatie (kwaadaardig/niet kwaadaardig), cv-screening (op de shortlist/niet op de shortlist) en ziektediagnose (heeft ziekte/heeft geen ziekte). Zelfs A/B-tests zijn nauw verwant en vragen in essentie: "Is versie B beter dan versie A?" (ja/nee).
Hoewel nauwkeurigheid snel een samenvatting van de prestaties geeft, kan het cruciale informatie verhullen over de aard van de fouten van een model. Zo kan een creditcardfraudedetector die elke transactie als legitiem bestempelt 99% nauwkeurigheid behalen en toch volledig falen om echte fraude te detecteren. Sensitiviteit en specificiteit bieden genuanceerdere inzichten: ze helpen je niet alleen begrijpen hoe vaak een model gelijk heeft, maar ook welke soorten fouten het maakt en of die fouten in de context acceptabel zijn.
In deze gids leer je wat sensitiviteit en specificiteit precies betekenen, wanneer elke metric het meest geschikt is, hoe ze worden berekend en hoe je ze in de praktijk toepast met heldere, realistische voorbeelden.
Sensitiviteit en specificiteit vinden hun oorsprong in medische evaluatie. Deze metrics benaderen vanuit de lens van diagnostisch testen en klinische besluitvorming helpt veel concepten in dit artikel te verduidelijken. Ter illustratie gebruiken we twee doorlopende voorbeelden: ziektedetectie en creditcardfraude.
Dit artikel is voor dataprofessionals die statistische inferentie gebruiken en metrics willen begrijpen die genuanceerder zijn dan nauwkeurigheid, om betere beslissingen te nemen. Deze metrics helpen te evalueren welke soorten fouten een model maakt en of die in de context acceptabel zijn. Toepassingen zijn onder meer medische diagnostiek en fraudedetectie, zoals we hebben gezien. Andere toepassingen zijn indringerdetectie, kwaliteitscontrole in de productie en spamfiltering.
Voordat je sensitiviteit en specificiteit interpreteert of toepast, is het essentieel de basisconcepten erachter te begrijpen. In deze sectie bespreken we de historische oorsprong, kerndefinities, afleidingen en berekeningen.
De concepten sensitiviteit en specificiteit vinden hun oorsprong in de biostatistiek. Hoewel ze eerder in de medische literatuur werden gebruikt, populariseerde biostatisticus Jacob Yerushlamy de term in zijn paper "Statistical Problems in Assessing Methods of Medical Diagnosis, with Special Reference to X-Ray Techniques."
In de jaren 70 werd de receiver operating characteristic (ROC)-curve (later beschreven) een hulpmiddel om sensitiviteit versus specificiteit in klinische tests visueel te analyseren. In de jaren 90 nam machine learning deze concepten over. Tegenwoordig worden de termen veel gebruikt in de gezondheidszorg en machine learning om te meten hoe goed systemen echte positieven en echte negatieven identificeren.
Stel dat een machine learning-model wordt gebruikt om frauduleuze creditcardtransacties te detecteren. Van een steekproef van 10.000 transacties zijn er 9800 legitieme transacties en 200 fraudegevallen.
Omdat we primair geïnteresseerd zijn in fraudegevallen, bestempelen we fraudegevallen als positief en niet-fraudegevallen als negatief. (Welke gevallen "positief" en "negatief" worden genoemd, is enigszins arbitrair; meestal is er echter een voor de hand liggende manier om de gevallen te labelen.)
Na het draaien van het model en het vergelijken van voorspelde fraudegevallen met werkelijke fraudegevallen, blijkt dat 160 fraudegevallen correct worden geflagd, 9500 legitieme transacties correct worden geïdentificeerd, 300 legitieme transacties ten onrechte als fraude worden gemarkeerd en 40 fraudegevallen door het model worden gemist.
Om al deze gegevens overzichtelijk te houden, wordt de volgende nomenclatuur vaak gebruikt.
De tweede letter (P of N) verwijst naar of het geval voorspeld werd positief of negatief te zijn, en de eerste letter geeft aan of die voorspelling waar (T) of onwaar (F) was.
Een "false positive" betekent dus dat het geval als positief werd voorspeld en die voorspelling onjuist was; met andere woorden, het geval werd voorspeld positief te zijn, maar was in werkelijkheid negatief. Een false negative is een geval dat als negatief werd voorspeld, maar in werkelijkheid positief is.
Om deze informatie weer te geven, gebruiken we vaak een "confusion matrix", zo genoemd omdat die bijhoudt hoe vaak het model onjuiste voorspellingen verwart met werkelijke uitkomsten (FN, FP). Hier is een voorbeeld:
|
Werkelijke fraude (positief) |
Werkelijk legitiem (negatief) |
|
|
Voorspelde fraude (voorspeld positief) |
160 (TP) |
300 (FP) |
|
Voorspeld legitiem (voorspeld negatief) |
40 (FN) |
9500 (TN) |
Laten we nu naar de rij- en kolomtotaalwaarden kijken. De rijsommen geven het totaal aantal voorspelde gevallen aan en de kolomsommen geven de totalen van de werkelijke gevallen aan.
|
Werkelijke fraude (positief) |
Werkelijk legitiem (negatief) |
||
|
Voorspelde fraude (voorspeld positief) |
160 (TP) |
300 (FP) |
460 (TP + FP) Totaal voorspelde positieven |
|
Voorspeld legitiem (voorspeld negatief) |
60 (FN) |
9500 (TN) |
9540 (FN + TN)Totaal voorspelde negatieven |
|
200 (TP + FN)Totaal werkelijke positieven |
9800 (FP + TN)Totaal werkelijke negatieven |
10.000 |
Wat stellen deze totalen voor?
Sensitiviteit (ook wel true positive rate of recall) meet het vermogen van het model om echte positieven correct te identificeren. Preciezer: sensitiviteit is de verhouding van true positives tot werkelijke positieven, TP / (TP + FN).
Op vergelijkbare wijze meet specificiteit (true negative rate) het vermogen van het model om echte negatieven te identificeren. Het is de verhouding van true negatives tot werkelijke negatieven, TN / (FP + TN).
Vanuit een probabilistisch perspectief is sensitiviteit de kans op een positieve test gegeven dat de patiënt de ziekte heeft, en specificiteit de kans op een negatieve test gegeven dat de patiënt de ziekte niet heeft.
In ons fraudevoorbeeld is sensitiviteit = TP / (TP + FN) = 160/200, ofwel 80%. Specificiteit is 9500/9800, of ongeveer 97%.
Als modeldrempels veranderen, bewegen sensitiviteit en specificiteit vaak in tegengestelde richtingen. Het verhogen van de sensitiviteit verlaagt doorgaans de specificiteit, en omgekeerd. In deze sectie verkennen we deze inherente trade-off en bespreken we hoe Receiver Operating Characteristic (ROC)-analyse een visuele en kwantitatieve aanpak biedt om modelprestaties over verschillende drempels te evalueren.
Laten we het fraudevoorbeeld aanpassen zodat er 20 meer false negatives zijn, FN = 60. Omdat het totale aantal werkelijke fraudegevallen nog steeds 200 is, zijn er nu 20 minder true positives (TP = 140).
|
Werkelijke fraude (positief) |
Werkelijk legitiem (negatief) |
||
|
Voorspelde fraude (voorspeld positief) |
140 (TP) |
300 (FP) |
460 (TP + FP) Totaal voorspelde positieven |
|
Voorspeld legitiem (voorspeld negatief) |
60 (FN) |
9500 (TN) |
9540 (FN + TN)Totaal voorspelde negatieven |
|
200 (TP + FN)Totaal werkelijke positieven |
9800 (FP + TN)Totaal werkelijke negatieven |
10.000 |
De sensitiviteit is gedaald van 80% naar 140/200 = 70%. Naarmate het aantal false negatives toeneemt, daalt de sensitiviteit, en omgekeerd. Dit betekent dat een hoge sensitiviteit aangeeft dat het aantal false negatives laag is.
In medische termen identificeert een test met hoge specificiteit de meeste mensen die de aandoening niet hebben correct. In ons kankerscreeningvoorbeeld zorgt een test met hoge specificiteit ervoor dat mensen die geen kanker hebben niet ten onrechte te horen krijgen dat ze het wel hebben.
Dit illustreert de trade-off tussen sensitiviteit en specificiteit. Een paar patiënten kunnen onnodig ongerust worden als ze te horen krijgen dat ze kanker hebben terwijl dat niet zo is, maar mensen die de ziekte echt hebben worden correct geïdentificeerd. In dit geval is hoge specificiteit een betere metric. In een onvolmaakte wereld moeten we passende beslissingen nemen op basis van een afweging tussen metrics.
Een diagnostische drempel stelt de afkapwaarde vast die bepaalt of een testresultaat als positief of negatief wordt beschouwd. Het zet een continue waarde, zoals een waarschijnlijkheid, om in een ja/nee-afkap. In alledaagse termen: het bepaalt waar je de grens trekt tussen positieve of negatieve resultaten.
De drempel wordt vaak op 50%, of 0,50, gezet. Een waarschijnlijkheid boven 50% geldt als positief, en een lager dan 50% als negatief.
Het wijzigen van de drempels bepaalt welke gevallen als positief en negatief worden beschouwd. Deze verschuiving beïnvloedt de balans tussen het vangen van true positives en het vermijden van false negatives.
Neem bijvoorbeeld een model dat een kans op kanker uitstuurt. Als de drempel op 0,3 staat, classificeert het model veel mensen als positief. Deze aanpak werkt goed voor screening, omdat het de kans verkleint om gevallen te missen.
Het verhoogt echter het risico op false positives. Als de drempel 0,8 is, classificeert het model minder mensen als positief. Deze aanpak vermindert false positives maar verhoogt het risico om echte gevallen te missen.
Wanneer de drempel verandert, verschuift het model hoe vaak het true positives vangt en hoe vaak het false positives vermijdt. Lagere drempels verhogen de sensitiviteit maar verlagen de specificiteit; hogere drempels verlagen de sensitiviteit maar verhogen de specificiteit.
Een Receiver Operating Characteristic (ROC)-curve is een veelgebruikte visual om classificatiedrempels te vergelijken over waarden van sensitiviteit en specificiteit. De ROC-curve zet sensitiviteit uit tegen 1 - specificiteit. Elk punt op de curve vertegenwoordigt een specifieke drempel. Als de drempel verandert, passen de sensitiviteit en specificiteit van het model zich dienovereenkomstig aan, waarmee de ROC-curve wordt getekend.
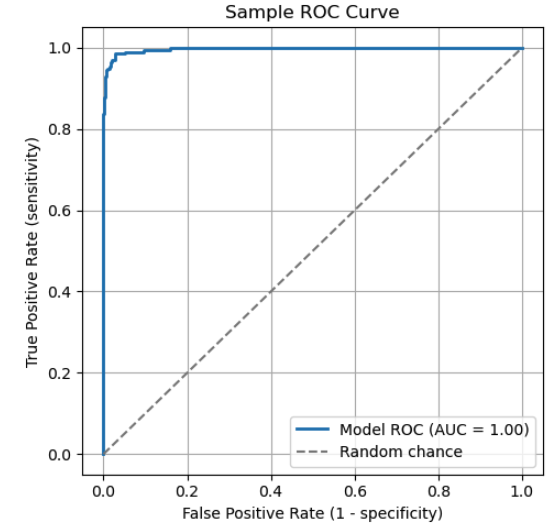
De ROC-curve illustreert de trade-off tussen sensitiviteit en specificiteit. Belangrijke punten op de curve:
De diagonale stippellijn stelt toeval voor. Een model dat langs deze lijn presteert, heeft geen werkelijk onderscheidend vermogen.
Om een model te evalueren met een ROC-curve, kijk je naar de "Area Under the Curve" (AUC). De AUC is het totale gebied (integraal) onder de curve en vertegenwoordigt een gewogen gemiddelde van de prestaties over alle drempels. Een hogere AUC duidt op een beter algeheel vermogen om positieve en negatieve klassen te onderscheiden.
|
AUC-score |
Interpretatie |
|
1,0 |
Perfecte classifier |
|
0,9 - 1,0 |
Uitstekend |
|
0,8 - 0,9 |
Goed |
|
0,7 - 0,8 |
Redelijk |
|
0,6 - 0,7 |
Matig |
|
0,5 |
Geen discriminatie (gelijk aan willekeurig raden) |
|
< 0,5 |
Slechter dan willekeurig |
Predictieve waarden en likelihoodratio's
In deze sectie verkennen we hoe prevalentie de betrouwbaarheid van testresultaten beïnvloedt. We bekijken ook hoe likelihoodratio's sensitiviteit en specificiteit combineren tot één getal waarmee clinici diagnostische waarschijnlijkheden na testen kunnen bijstellen.
De positieve voorspellende waarde (PPV), wiskundig gelijk aan precisie in machine learning, geeft weer hoe waarschijnlijk het is dat een positieve voorspelling klopt. Het meet de verhouding van voorspelde positieven die true positives zijn: PPV = TP / (TP + FP).
De negatieve voorspellende waarde (NPV) geeft de betrouwbaarheid van een negatief resultaat weer. Het meet de verhouding van negatieve testresultaten die true negatives zijn. De formule is NPV = TN / (TN + FN).
Stel dat we 1000 mensen testen op een ziekte met deze confusion matrix.
|
Werkelijk positief (ziek) |
Werkelijk negatief (gezond) |
||
|
Voorspeld positief (ziek) |
80 (TP) |
20 (FP) |
100 |
|
Voorspeld negatief (gezond) |
10 (FN) |
890 (TN) |
900 |
|
90 |
910 |
1000 |
Ter vergelijking, neem aan dat meer mensen ziek zijn (300 in plaats van 90), en pas de confusion matrix dienovereenkomstig aan.
|
Werkelijk positief (ziek) |
Werkelijk negatief (gezond) |
||
|
Voorspeld positief (ziek) |
270 (TP) |
70 (FP) |
340 |
|
Voorspeld negatief (gezond) |
30 (FN) |
630 (TN) |
660 |
|
300 |
700 |
1000 |
Naarmate de prevalentie toeneemt, stijgt het aantal true positive-gevallen.
Likelihoodratio's combineren sensitiviteit en specificiteit tot één getal dat clinici helpt hun vertrouwen in een diagnose bij te stellen op basis van testresultaten.
Voordat je likelihoodratio's toepast, is het belangrijk onderscheid te maken tussen waarschijnlijkheid en odds. Waarschijnlijkheid is de kans dat een gebeurtenis plaatsvindt, uitgedrukt met een waarde tussen 0 en 1. Odds geven aan hoe waarschijnlijk een gebeurtenis is ten opzichte van het niet plaatsvinden ervan.
Een waarschijnlijkheid van 75% betekent dat de gebeurtenis 75 keer op 100 voorkomt. De bijbehorende odds van de gebeurtenis zijn 0,75 / (1 - 0,75) = 0,75 / 0,25 = 3. Dit betekent dat de odds 3 tegen 1 zijn in het voordeel van de gebeurtenis.
Algemener geldt: als p de waarschijnlijkheid van een gebeurtenis is, dan zijn odds = p / (1 - p). Omzetten van odds naar waarschijnlijkheid: p = odds / (1 + odds).
De positieve likelihoodratio (LR+) vertelt hoeveel een positief resultaat de odds op het hebben van de aandoening verhoogt vergeleken met iemand zonder de aandoening. Hogere waarden (>10) suggereren dat de test zeer effectief is om de aandoening aan te tonen. De formule is LR+ = sensitiviteit / (1 - specificiteit).
De negatieve likelihoodratio (LR-) vertelt hoeveel een negatief resultaat de odds op het hebben van de aandoening verlaagt vergeleken met iemand zonder de aandoening. Lagere waarden (< 0,1) suggereren dat de test zeer effectief is om een aandoening uit te sluiten. De formule is LR- = (1 - sensitiviteit) / specificiteit.
Om beslissingen te nemen, beginnen clinici met een pre-testwaarschijnlijkheid die is ingeschat op basis van factoren zoals de symptomen en geschiedenis van de patiënt. Deze schatting wordt gecombineerd met de likelihoodratio om de post-testwaarschijnlijkheid te berekenen.
De procedure is als volgt.
Stel bijvoorbeeld dat de pre-testwaarschijnlijkheid van ziekte 30% is en LR+ = 10. Wat is de post-testwaarschijnlijkheid?
We zien dat LR+ de waarschijnlijkheid en het vertrouwen in een diagnose aanzienlijk heeft verschoven.
Naarmate diagnostische tests en classificatiesystemen complexer worden, ontstaan nieuwe methodologieën die verder gaan dan traditionele prestatielimieten. In deze sectie verkennen we hoe Bayesiaanse benaderingen gepersonaliseerde beslissingsdrempels mogelijk maken en hoe nieuwe technologieën zoals CRISPR-gebaseerde diagnostiek de grenzen van analytische sensitiviteit en specificiteit verleggen.
Het idee om te beginnen met een voorafgaande overtuiging en die bij te werken op basis van nieuwe informatie ligt aan de basis van de Bayesiaanse statistiek. Het biedt een formele manier om waarschijnlijkheden te herzien in het licht van nieuwe data.
Bayesiaans redeneren steunt op drie sleutelcomponenten.
Dit wordt wiskundig beschreven door de stelling van Bayes.
P(A|B) = P(B|A) x P(A) / P(B)
waarbij P(A|B) de posterior is (de kans op A gegeven B), P(B|A) de likelihood (de kans op B gegeven dat A waar is), P(A) de prior is en P(B) het bewijs.
Zoals we hebben gezien, passen traditionele classificatiemodellen vaak een vaste drempel toe, zoals 0,5, om te bepalen of een output als positief of negatief moet worden gelabeld. Bayesiaanse benaderingen maken daarentegen mogelijk dat deze drempels zich aanpassen aan de context, inclusief individuele risicofactoren, demografie, gedragsgeschiedenis of realtime data. Deze flexibiliteit stelt systemen in staat drempels dynamisch aan te passen in plaats van te vertrouwen op een uniforme, statische drempel.
Neem een model dat de kans op hartziekte voorspelt. Een traditioneel model kan een drempel van 0,5 gebruiken. Patiënten met een waarschijnlijkheid boven 50% gelden als positief, en daaronder als negatief.
Beschouw nu een Bayesiaanse aanpak met twee hypothetische patiënten:
Beide patiënten krijgen een door de test gegenereerde waarschijnlijkheid van 0,45. Een model met vaste drempel 0,5 zou beide patiënten als negatief behandelen.
Een Bayesiaans model neemt echter voorafgaande risicoinformatie mee en kan worden gebruikt in combinatie met predictie-intervallen. Voor patiënt A kan het systeem de beslissingsdrempel verlagen en de casus voor verdere evaluatie markeren. Voor patiënt B kan het de drempel handhaven en wordt geen vervolg aanbevolen.
Zo stemmen Bayesiaanse methoden de classificatiedrempel af op de context van elke patiënt, wat leidt tot klinisch passender beslissingen.
Een opkomende technologie die de grenzen van analytische sensitiviteit en specificiteit verlegt, is CRISPR-gebaseerde diagnostiek. Wetenschappers hebben CRISPR (Clustered Regularly Interspaced Short Palindromic Repeats), een gereedschap voor genbewerking, aangepast om genetisch materiaal te detecteren. Het gebruikt Cas-eiwitten om specifieke nucleïnezuursequenties met hoge sensitiviteit te detecteren.
CRISPR-gebaseerde assays zijn gebruikt voor de vroege detectie van kanker. Draagbare kankerdetectietools worden ontwikkeld voor gebruik in klinische omgevingen. Twee belangrijke diagnostische platforms zijn SHERLOCK en DETECTR.
CRISPR-gebaseerde assays bieden veel voordelen. Ze hebben een hoge sensitiviteit en kunnen dus minimale hoeveelheden DNA of RNA detecteren.
Dit maakt ze waardevol voor het identificeren van infecties in een vroeg stadium, kanker of zeldzame mutaties. Ze bieden ook uitzonderlijke specificiteit, waardoor ze nauw verwante genetische sequenties kunnen onderscheiden om false positives te verminderen. Extra voordelen zijn snelle resultaten en goedkope, draagbare apparatuur.
Deze assays ondersteunen een breed scala aan toepassingen, waaronder detectie van infectieziekten, kankerdetectie en screening op genetische aandoeningen. Onderzoekers kunnen machine learning gebruiken om het ontwerp van gids-RNA te optimaliseren en de diagnostische nauwkeurigheid te verbeteren.
CRISPR-gebaseerde assays kennen ook uitdagingen. De meeste geven slechts een binair resultaat (positief of negatief). Standaardisatie en reproduceerbaarheid blijven aandachtspunten, aangezien resultaten variëren tussen laboratoria en testomstandigheden.
Daarnaast moeten deze assays voldoen aan regelgeving, waaronder goedkeuring door FDA en CLIA, wat uitgebreide validatie, documentatie en beoordeling vereist. Tot slot bemoeilijken IP-kwesties de licentieverlening en vertragen ze de commercialisering.
Sensitiviteit en specificiteit spelen een centrale rol bij het evalueren van diagnostische tests en classificatiemodellen. Ze kunnen informatiever zijn dan nauwkeurigheid, vooral bij onevenwichtige datasets of wanneer false positives of false negatives verschillende kosten met zich meebrengen. Samen met aanverwante hulpmiddelen zoals likelihoodratio's en ROC-analyse sturen ze tot een doordachte interpretatie en betere besluitvorming.
Wil je je praktische vaardigheden in het evalueren van modelprestaties verdiepen? Bekijk dan zeker deze DataCamp-bronnen:
Topcursussen bij DataCamp
Leerpad
Cursus
Cursus
blog
Adel Nehme
15 min

