मशीन लर्निंग विशेषज्ञों को अपने डेटा की गुणवत्ता और अपने प्रेडिक्टिव मॉडलों के प्रदर्शन—दोनों—का आकलन करना चाहिए।
विभिन्न मेट्रिक्स मददगार होते हैं, खासकर जब बाइनरी क्लासिफिकेशन टास्क से निपटना हो; यानी जहाँ हर डेटा पॉइंट के लिए दो संभावित श्रेणियों में से एक की भविष्यवाणी की जाती है। उदाहरणों में क्रेडिट अप्रूवल (मंजूर/मंजूर नहीं), मैलवेयर क्लासिफिकेशन (मैलिशस/नॉन-मैलिशस), रिज़्यूमे स्क्रीनिंग (शॉर्टलिस्ट/शॉर्टलिस्ट नहीं), और रोग निदान (रोग है/रोग नहीं है) शामिल हैं। यहां तक कि A/B टेस्ट भी इसी से जुड़े हैं—मूल रूप से पूछते हैं, "क्या वर्ज़न B, वर्ज़न A से बेहतर है?" (हाँ/नहीं)।
हालाँकि एक्युरेसी प्रदर्शन का त्वरित सार देती है, यह किसी मॉडल की त्रुटियों की प्रकृति के बारे में महत्वपूर्ण जानकारी छिपा सकती है। उदाहरण के लिए, यदि कोई क्रेडिट फ्रॉड डिटेक्टर हर लेन-देन को वैध के रूप में लेबल कर दे, तो वह 99% एक्युरेसी पा सकता है, फिर भी वास्तविक धोखाधड़ी का पता लगाने में विफल रहेगा। सेंसिटिविटी और स्पेसिफिसिटी अधिक सूक्ष्म दृष्टि देती हैं—यह समझने में मदद करती हैं कि मॉडल कितनी बार सही है ही नहीं, बल्कि वह किस प्रकार की गलतियाँ करता है और क्या वे संदर्भ में स्वीकार्य हैं।
इस गाइड में, आप जानेंगे कि सेंसिटिविटी और स्पेसिफिसिटी का वास्तविक अर्थ क्या है, किस स्थिति में कौन-सा मेट्रिक अधिक उपयुक्त है, इनकी गणना कैसे होती है, और स्पष्ट, वास्तविक जीवन के उदाहरणों के माध्यम से इन्हें अपने कार्य में व्यावहारिक रूप से कैसे लागू किया जाए।
डायग्नोस्टिक टेस्टिंग और क्लिनिकल निर्णय-निर्माण
सेंसिटिविटी और स्पेसिफिसिटी की उत्पत्ति चिकित्सीय मूल्यांकन में हुई। इन मेट्रिक्स को डायग्नोस्टिक टेस्टिंग और क्लिनिकल निर्णय-निर्माण के दृष्टिकोण से देखने पर इस लेख की कई अवधारणाएँ स्पष्ट होती हैं। उदाहरण के तौर पर, हम दो परिदृश्यों—रोग का पता लगाना और क्रेडिट कार्ड फ्रॉड—का उपयोग करेंगे।
- डायग्नोस्टिक टेस्टिंग किसी रोग की पुष्टि या उसे खारिज करने हेतु प्रयुक्त चिकित्सा प्रक्रिया को संदर्भित करती है।
- असे टेस्टिंग किसी नमूने में किसी विशिष्ट पदार्थ की उपस्थिति मापती है।
- क्लिनिकल निर्णय-निर्माण वह प्रक्रिया है जिसमें स्वास्थ्य-सेवा पेशेवर किसी रोगी के बारे में जानकारी एकत्र करते हैं, निदान और उपचार विकल्पों पर विचार करते हैं, और साक्ष्य के आधार पर सूचित निर्णय लेते हैं।
लक्षित पाठक
यह लेख उन डेटा प्रैक्टिशनर्स के लिए है जो सांख्यिकीय अनुमान का उपयोग करते हैं और बेहतर निर्णय-निर्माण के लिए एक्युरेसी से अधिक सूक्ष्म मेट्रिक्स समझना चाहते हैं। ये मेट्रिक्स यह आकलन करने में मदद करते हैं कि कोई मॉडल किस प्रकार की त्रुटियाँ करता है और क्या वे त्रुटियाँ संदर्भ में स्वीकार्य हैं। अनुप्रयोगों में, जैसा कि हमने देखा, चिकित्सा निदान और फ्रॉड डिटेक्शन शामिल हैं। अन्य अनुप्रयोगों में इंट्रूज़न डिटेक्शन, मैन्युफैक्चरिंग में क्वालिटी कंट्रोल, और स्पैम फ़िल्टरिंग शामिल हैं।
सेंसिटिविटी और स्पेसिफिसिटी की बुनियादी अवधारणाएँ
सेंसिटिविटी और स्पेसिफिसिटी की व्याख्या या उपयोग करने से पहले, इनके पीछे की बुनियादी अवधारणाओं को समझना आवश्यक है। इस खंड में, हम ऐतिहासिक उत्पत्ति, मुख्य परिभाषाएँ, व्युत्पत्तियाँ, और गणनाएँ चर्चा करेंगे।
इतिहास
सेंसिटिविटी और स्पेसिफिसिटी की अवधारणाएँ बायोस्टैटिस्टिक्स में उत्पन्न हुईं। यद्यपि चिकित्सा साहित्य में इनका पहले भी उपयोग हुआ, बायोस्टैटिस्टिक्स शोधकर्ता जैकब येरुशलमी ने अपने पेपर "Statistical Problems in Assessing Methods of Medical Diagnosis, with Special Reference to X-Ray Techniques" में इन शब्दों को लोकप्रिय बनाया।
1970 के दशक में, रिसीवर ऑपरेटिंग कैरेक्टरिस्टिक (ROC) कर्व (आगे वर्णित) क्लिनिकल टेस्टिंग में सेंसिटिविटी बनाम स्पेसिफिसिटी का दृश्य विश्लेषण करने का उपकरण बना। 1990 के दशक में, मशीन लर्निंग ने इन अवधारणाओं को अपनाया। आज, ये शब्द स्वास्थ्य-सेवा और मशीन लर्निंग दोनों में ट्रू पॉज़िटिव्स और ट्रू नेगेटिव्स की पहचान की क्षमता मापने के लिए व्यापक रूप से उपयोग किए जाते हैं।
कन्फ्यूज़न मैट्रिक्स
मान लीजिए एक मशीन लर्निंग मॉडल का उपयोग धोखाधड़ीपूर्ण क्रेडिट कार्ड लेन-देन का पता लगाने के लिए किया जाता है। 10,000 लेन-देन के एक सैंपल में, 9800 वैध (लीजिटिमेट) लेन-देन हैं और 200 मामले फ्रॉड के हैं।
चूँकि हमारी प्राथमिक रुचि फ्रॉड मामलों में है, तो फ्रॉडulent मामलों को पॉज़िटिव और गैर-फ्रॉड मामलों को नेगेटिव मान लेते हैं। (किसे "पॉज़िटिव" और किसे "नेगेटिव" माना जाए, कुछ हद तक मनमाना है; पर प्रायः लेबलिंग का स्पष्ट तरीका होता है।)
मॉडल चलाने और अनुमानित फ्रॉड मामलों की वास्तविक फ्रॉड मामलों से तुलना करने पर पता चलता है कि 160 फ्रॉड मामले सही रूप से फ़्लैग हुए, 9500 वैध लेन-देन सही रूप से पहचाने गए, 300 वैध लेन-देन को गलत तरीके से फ्रॉड के रूप में फ़्लैग किया गया, और 40 फ्रॉड मामले मॉडल से छूट गए।
इन सभी आँकड़ों को व्यवस्थित रखने के लिए, निम्नलिखित शब्दावली का सामान्यतः उपयोग होता है।
- ट्रू पॉज़िटिव्स (TP): 160 फ्रॉड मामले सही रूप से फ़्लैग हुए,
- ट्रू नेगेटिव्स (TN): 9500 वैध लेन-देन सही रूप से पहचाने गए,
- फॉल्स पॉज़िटिव्स (FP): 300 वैध लेन-देन को गलत रूप से फ्रॉड के रूप में फ़्लैग किया गया, और
- फॉल्स नेगेटिव्स (FN): 40 फ्रॉड मामले मॉडल से छूट गए।
दूसरा अक्षर (P या N) बताता है कि केस को पॉज़िटिव या नेगेटिव के रूप में प्रेडिक्ट किया गया था, और पहला अक्षर बताता है कि वह प्रेडिक्शन सही (T) था या गलत (F)।
तो, "फॉल्स पॉज़िटिव" का अर्थ है कि केस को पॉज़िटिव प्रेडिक्ट किया गया था, और वह प्रेडिक्शन गलत था—अर्थात केस वास्तव में नेगेटिव था। इसी प्रकार, फॉल्स नेगेटिव वह केस है जिसे नेगेटिव प्रेडिक्ट किया गया था, पर वह वास्तव में पॉज़िटिव है।
इस जानकारी को प्रदर्शित करने के लिए हम प्रायः "कन्फ्यूज़न मैट्रिक्स" का उपयोग करते हैं—ऐसा इसलिए कहा जाता है क्योंकि यह ट्रैक रखता है कि मॉडल कितनी बार गलत प्रेडिक्शन को वास्तविक परिणामों (FN, FP) से गड़बड़ा देता है। यहाँ एक उदाहरण है:
| |
वास्तविक फ्रॉड (पॉज़िटिव)
|
वास्तविक वैध (नेगेटिव)
|
|
प्रेडिक्टेड फ्रॉड (प्रेडिक्टेड पॉज़िटिव)
|
160 (TP)
|
300 (FP)
|
|
प्रेडिक्टेड वैध (प्रेडिक्टेड नेगेटिव)
|
40 (FN)
|
9500 (TN)
|
अब, पंक्ति और स्तंभ के कुलों पर नज़र डालते हैं। पंक्तियों के योग कुल प्रेडिक्टेड केस दर्शाते हैं और स्तंभों के योग कुल वास्तविक केस।
| |
वास्तविक फ्रॉड (पॉज़िटिव)
|
वास्तविक वैध (नेगेटिव)
| |
|
प्रेडिक्टेड फ्रॉड (प्रेडिक्टेड पॉज़िटिव)
|
160 (TP)
|
300 (FP)
|
460 (TP + FP)
कुल प्रेडिक्टेड पॉज़िटिव्स
|
|
प्रेडिक्टेड वैध (प्रेडिक्टेड नेगेटिव)
|
40 (FN)
|
9500 (TN)
|
9540 (FN + TN) कुल प्रेडिक्टेड नेगेटिव्स
|
| |
200 (TP + FN) कुल वास्तविक पॉज़िटिव्स
|
9800 (FP + TN) कुल वास्तविक नेगेटिव्स
|
10,000
|
ये कुल क्या दर्शाते हैं?
- पहली पंक्ति का कुल (460) कुल अनुमानित फ्रॉड मामलों (TP + FP) को दर्शाता है।
- दूसरी पंक्ति का कुल (9540) कुल अनुमानित वैध मामलों (FN + TN) को दर्शाता है।
- पहले स्तंभ का कुल (200) कुल वास्तविक फ्रॉड मामलों (TP + FN) को दर्शाता है।
- दूसरे स्तंभ का कुल (9800) कुल वास्तविक वैध मामलों (FP + TN) को दर्शाता है।
- ग्रैंड टोटल (10,000) हमारे सैंपल के कुल आकार के बराबर है।
परिभाषाएँ
सेंसिटिविटी (जिसे ट्रू पॉज़िटिव रेट या रिकॉल भी कहा जाता है) मॉडल की ट्रू पॉज़िटिव्स को सही पहचानने की क्षमता मापती है। अधिक सटीक रूप से, सेंसिटिविटी वास्तविक पॉज़िटिव्स में ट्रू पॉज़िटिव्स का अनुपात है, TP / (TP + FN)।
इसी तरह, स्पेसिफिसिटी (ट्रू नेगेटिव रेट) मॉडल की ट्रू नेगेटिव्स को पहचानने की क्षमता मापती है। यह वास्तविक नेगेटिव्स में ट्रू नेगेटिव्स का अनुपात है, TN / (FP + TN)।
प्रायिकतामूलक दृष्टिकोण से, सेंसिटिविटी वह प्रायिकता है कि रोगी को रोग होने पर परीक्षण पॉज़िटिव आए; और स्पेसिफिसिटी वह प्रायिकता है कि रोगी को रोग न होने पर परीक्षण नेगेटिव आए।
सेंसिटिविटी और स्पेसिफिसिटी की गणना
हमारे फ्रॉड उदाहरण में, सेंसिटिविटी = TP / (TP + FN) = 160/200, यानी 80%। स्पेसिफिसिटी 9500/9800 है, यानी लगभग 97%।
सेंसिटिविटी–स्पेसिफिसिटी ट्रेड-ऑफ और ROC विश्लेषण
जैसे-जैसे मॉडल थ्रेशहोल्ड बदलते हैं, सेंसिटिविटी और स्पेसिफिसिटी अक्सर विपरीत दिशाओं में चलती हैं। सेंसिटिविटी बढ़ाने पर आमतौर पर स्पेसिफिसिटी घटती है, और इसके उलट। इस खंड में, हम इस अंतर्निहित ट्रेड-ऑफ की पड़ताल करेंगे और चर्चा करेंगे कि रिसीवर ऑपरेटिंग कैरेक्टरिस्टिक (ROC) विश्लेषण कैसे विभिन्न थ्रेशहोल्ड्स पर मॉडल के प्रदर्शन का दृश्य और परिमाणात्मक आकलन प्रदान करता है।
ट्रेड-ऑफ्स
आइए फ्रॉड उदाहरण में थोड़ा बदलाव करें ताकि फॉल्स नेगेटिव्स 20 और बढ़ जाएँ, FN = 60। चूँकि वास्तविक फ्रॉड मामलों की कुल संख्या अभी भी 200 है, अब ट्रू पॉज़िटिव्स 20 कम होंगे (TP = 140)।
| |
वास्तविक फ्रॉड (पॉज़िटिव)
|
वास्तविक वैध (नेगेटिव)
| |
|
प्रेडिक्टेड फ्रॉड (प्रेडिक्टेड पॉज़िटिव)
|
140 (TP)
|
300 (FP)
|
460 (TP + FP)
कुल प्रेडिक्टेड पॉज़िटिव्स
|
|
प्रेडिक्टेड वैध (प्रेडिक्टेड नेगेटिव)
|
60 (FN)
|
9500 (TN)
|
9540 (FN + TN) कुल प्रेडिक्टेड नेगेटिव्स
|
| |
200 (TP + FN) कुल वास्तविक पॉज़िटिव्स
|
9800 (FP + TN) कुल वास्तविक नेगेटिव्स
|
10,000
|
सेंसिटिविटी 80% से घटकर 140/200 = 70% हो गई है। जैसे-जैसे फॉल्स नेगेटिव्स बढ़ते हैं, सेंसिटिविटी घटती है—और इसके विपरीत। इसका अर्थ है कि उच्च सेंसिटिविटी होने पर फॉल्स नेगेटिव्स की संख्या कम होती है।
चिकित्सीय दृष्टि से, उच्च स्पेसिफिसिटी वाला परीक्षण उन अधिकांश लोगों को सही रूप से पहचानता है जिन्हें वह स्थिति नहीं है। हमारे कैंसर स्क्रीनिंग उदाहरण में, उच्च स्पेसिफिसिटी वाला परीक्षण सुनिश्चित करता है कि जिन लोगों को कैंसर नहीं है उन्हें गलत रूप से बताया न जाए कि उन्हें है।
यह सेंसिटिविटी और स्पेसिफिसिटी के बीच ट्रेड-ऑफ को दर्शाता है। कुछ मरीज तब घबरा सकते हैं जब उन्हें गलत रूप से कैंसर होने की सूचना दी जाए, लेकिन जिन्हें वास्तव में रोग है, वे सही पहचाने जाते हैं। इस स्थिति में, उच्च स्पेसिफिसिटी बेहतर मेट्रिक है। एक अपूर्ण दुनिया में, हमें मेट्रिक्स के बीच ट्रेड-ऑफ का आकलन कर उपयुक्त निर्णय लेने होते हैं।
थ्रेशहोल्ड की गतिशीलता
डायग्नोस्टिक थ्रेशहोल्ड वह कटऑफ मान निर्धारित करता है जो तय करता है कि कोई टेस्ट रिज़ल्ट पॉज़िटिव माना जाएगा या नेगेटिव। यह किसी सतत मान, जैसे प्रायिकता, को हाँ/नहीं कटऑफ में बदल देता है। सामान्य शब्दों में, यह तय करता है कि पॉज़िटिव और नेगेटिव परिणामों के बीच रेखा कहाँ खींची जाए।
थ्रेशहोल्ड अक्सर 50% या 0.50 पर सेट किया जाता है। 50% से अधिक प्रायिकता को पॉज़िटिव और 50% से कम को नेगेटिव माना जाता है।
थ्रेशहोल्ड बदलने से यह तय होता है कि किन मामलों को पॉज़िटिव और किन्हें नेगेटिव माना जाए। यह बदलाव ट्रू पॉज़िटिव्स पकड़ने और फॉल्स नेगेटिव्स से बचने के बीच संतुलन को प्रभावित करता है।
उदाहरण के लिए, मान लें कोई मॉडल कैंसर की प्रायिकता आउटपुट करता है। यदि थ्रेशहोल्ड 0.3 पर सेट है, तो मॉडल कई लोगों को पॉज़िटिव के रूप में वर्गीकृत करेगा। यह स्क्रीनिंग के लिए अच्छा है क्योंकि मामलों के छूटने की संभावना घटती है।
हालाँकि, इससे फॉल्स पॉज़िटिव्स का जोखिम बढ़ता है। यदि थ्रेशहोल्ड 0.8 है, तो मॉडल कम लोगों को पॉज़िटिव के रूप में वर्गीकृत करेगा। यह फॉल्स पॉज़िटिव्स घटाता है लेकिन वास्तविक मामलों के छूटने का जोखिम बढ़ाता है।
जब थ्रेशहोल्ड बदलता है, तो मॉडल इस बात में बदलाव करता है कि वह कितनी बार ट्रू पॉज़िटिव्स पकड़ता है और कितनी बार फॉल्स पॉज़िटिव्स से बचता है। कम थ्रेशहोल्ड सेंसिटिविटी बढ़ाते हैं लेकिन स्पेसिफिसिटी घटाते हैं; उच्च थ्रेशहोल्ड इसके विपरीत करते हैं।
ROC कर्व की व्याख्या
एक रिसीवर ऑपरेटिंग कैरेक्टरिस्टिक (ROC) कर्व एक सामान्य दृश्य साधन है जो सेंसिटिविटी और स्पेसिफिसिटी के मानों पर विभिन्न क्लासिफिकेशन थ्रेशहोल्ड्स की तुलना करता है। ROC कर्व सेंसिटिविटी को 1 - स्पेसिफिसिटी के विरुद्ध प्लॉट करता है। कर्व का हर बिंदु एक विशिष्ट थ्रेशहोल्ड का प्रतिनिधित्व करता है। जैसे-जैसे थ्रेशहोल्ड बदलता है, मॉडल की सेंसिटिविटी और स्पेसिफिसिटी उसी अनुरूप समायोजित होती हैं, और ROC कर्व ट्रेस होता है।
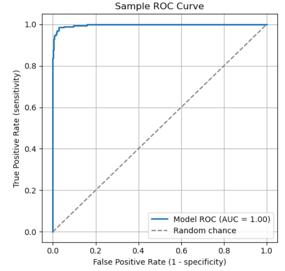
ROC कर्व सेंसिटिविटी और स्पेसिफिसिटी के बीच ट्रेड-ऑफ को दर्शाता है। कर्व पर मुख्य बिंदु:
- (0,1): एक परफेक्ट क्लासिफायर जो सभी ट्रू पॉज़िटिव्स बिना किसी फॉल्स नेगेटिव के पहचानता है।
- (0,0): एक चरम मॉडल जो सब कुछ नेगेटिव प्रेडिक्ट करता है और सभी पॉज़िटिव मामलों को गलत वर्गीकृत करता है।
- (1,1): एक चरम मॉडल जो सब कुछ पॉज़िटिव प्रेडिक्ट करता है और सभी नेगेटिव मामलों को गलत वर्गीकृत करता है।
तिरछी बिंदीदार रेखा यादृच्छिक संभावना का प्रतिनिधित्व करती है। इस रेखा के अनुरूप प्रदर्शन करने वाला मॉडल वास्तविक भेदकारी क्षमता नहीं रखता।
किसी मॉडल का ROC कर्व से मूल्यांकन करने हेतु, "एरिया अंडर द कर्व" (AUC) पर विचार करें। AUC कर्व के नीचे का कुल क्षेत्रफल (इंटीग्रल) है, जो सभी थ्रेशहोल्ड्स पर प्रदर्शन का भारित औसत दर्शाता है। उच्च AUC यह दर्शाता है कि मॉडल पॉज़िटिव और नेगेटिव क्लासों के बीच समग्र रूप से बेहतर भेद कर सकता है।
|
AUC स्कोर
|
व्याख्या
|
|
1.0
|
परफेक्ट क्लासिफायर
|
|
0.9 - 1.0
|
उत्कृष्ट
|
|
0.8 - 0.9
|
अच्छा
|
|
0.7 - 0.8
|
संतोषजनक
|
|
0.6 - 0.7
|
कमज़ोर
|
|
0.5
|
कोई भेद-क्षमता नहीं (यादृच्छिक अनुमान के बराबर)
|
|
< 0.5
|
यादृच्छिक से भी बदतर
|
प्रेडिक्टिव वैल्यूज़ और लाइकलीहुड रेशियो
इस खंड में, हम देखते हैं कि प्रीवलेंस (प्रचलन) टेस्ट परिणामों की विश्वसनीयता को कैसे प्रभावित करता है। हम यह भी देखते हैं कि लाइकलीहुड रेशियो किस तरह सेंसिटिविटी और स्पेसिफिसिटी को एक एकल संख्या में संयोजित करते हैं, जो चिकित्सकों को परीक्षण के बाद डायग्नोस्टिक प्रायिकताओं को अपडेट करने की अनुमति देता है।
प्रिवलेंस-निर्भर मेट्रिक्स
पॉज़िटिव प्रेडिक्टिव वैल्यू (PPV), जो गणितीय रूप से मशीन लर्निंग में प्रिसिशन के समतुल्य है, दर्शाती है कि कोई पॉज़िटिव प्रेडिक्शन सही होने की कितनी संभावना है। यह प्रेडिक्टेड पॉज़िटिव्स में ट्रू पॉज़िटिव्स का अनुपात मापती है: PPV = TP / (TP + FP)।
नेगेटिव प्रेडिक्टिव वैल्यू (NPV) नेगेटिव परिणाम की विश्वसनीयता दर्शाती है। यह नेगेटिव टेस्ट परिणामों में ट्रू नेगेटिव्स का अनुपात मापती है। इसका सूत्र है NPV = TN / (TN + FN)।
मान लीजिए, हम 1000 लोगों का किसी बीमारी के लिए परीक्षण करते हैं और निम्न कन्फ्यूज़न मैट्रिक्स मिलता है।
| |
वास्तविक पॉज़िटिव (बीमार)
|
वास्तविक नेगेटिव (स्वस्थ)
| |
|
प्रेडिक्टेड पॉज़िटिव (बीमार)
|
80 (TP)
|
20 (FP)
|
100
|
|
प्रेडिक्टेड नेगेटिव (स्वस्थ)
|
10 (FN)
|
890 (TN)
|
900
|
| |
90
|
910
|
1000
|
- PPV = TP / (TP + FP) = 80/100 = 80%।
- NPV = TN / (FN + TN) = 890 / 900 = 98.9%।
तुलना हेतु, मान लें अधिक लोग बीमार हैं (90 की जगह 300), और उसी अनुसार कन्फ्यूज़न मैट्रिक्स समायोजित करें।
| |
वास्तविक पॉज़िटिव (बीमार)
|
वास्तविक नेगेटिव (स्वस्थ)
| |
|
प्रेडिक्टेड पॉज़िटिव (बीमार)
|
270 (TP)
|
70 (FP)
|
340
|
|
प्रेडिक्टेड नेगेटिव (स्वस्थ)
|
30 (FN)
|
630 (TN)
|
660
|
| |
300
|
700
|
1000
|
जैसे-जैसे प्रीवलेंस बढ़ता है, ट्रू पॉज़िटिव मामलों की संख्या बढ़ती है।
- उच्च PPV। अब पॉज़िटिव परिणाम वास्तविक बीमारी को अधिक दर्शाता है। वास्तव में, PPV = 270 / 300 = 90%, जो पहले की तुलना में 10% की वृद्धि है।
- कम NPV। नेगेटिव परिणाम थोड़ा कम विश्वसनीय हो जाता है, क्योंकि वास्तविक मामलों के छूटने की अधिक संभावना होती है। यहाँ NPV = 630 / 700 = 90% है, जो 8.9% की कमी है।
लाइकलीहुड रेशियो
लाइकलीहुड रेशियो सेंसिटिविटी और स्पेसिफिसिटी को एक एकल संख्या में संयोजित करते हैं, जो चिकित्सकों को टेस्ट परिणामों के आधार पर निदान में अपने भरोसे को अपडेट करने में मदद करती है।
प्रायिकता बनाम ऑड्स
लाइकलीहुड रेशियो लागू करने से पहले, प्रायिकता और ऑड्स में अंतर करना महत्वपूर्ण है। प्रायिकता किसी घटना के होने की संभावना है, जिसे 0 और 1 के बीच के मान के रूप में व्यक्त किया जाता है। ऑड्स यह दर्शाते हैं कि घटना के होने की संभावना उसके न होने की तुलना में कितनी है।
75% प्रायिकता का अर्थ है कि घटना 100 में 75 बार होती है। इसके अनुरूप घटना के ऑड्स 0.75 / (1 - 0.75) = 0.75 / .025 = 3 हैं। इसका मतलब है कि घटना के होने के ऑड्स 3 से 1 हैं।
सामान्यतः, यदि p किसी घटना की प्रायिकता है, तो ऑड्स = p / (1 - p)। ऑड्स से प्रायिकता में रूपांतरण: p = ऑड्स / (1 + ऑड्स)।
लाइकलीहुड रेशियो
पॉज़िटिव लाइकलीहुड रेशियो (LR+) बताता है कि पॉज़िटिव परिणाम होने पर, बिना स्थिति वाले व्यक्ति की तुलना में, स्थिति होने के ऑड्स कितने बढ़ते हैं। उच्च मान (>10) संकेत देते हैं कि टेस्ट स्थिति को “रूल-इन” करने में अत्यंत प्रभावी है। सूत्र: LR+ = Sensitivity / (1 - Specificity)।
नेगेटिव लाइकलीहुड रेशियो (LR-) बताता है कि नेगेटिव परिणाम होने पर, बिना स्थिति वाले व्यक्ति की तुलना में, स्थिति होने के ऑड्स कितने घटते हैं। कम मान (< 0.1) संकेत देते हैं कि टेस्ट किसी स्थिति को “रूल-आउट” करने में अत्यंत प्रभावी है। सूत्र: LR- = (1 - Sensitivity) / Specificity।
पोस्ट-टेस्ट प्रायिकता
निर्णय लेने हेतु, चिकित्सक प्री-टेस्ट प्रायिकता से शुरू करते हैं, जिसका अनुमान रोगी के लक्षणों और इतिहास जैसे कारकों पर आधारित होता है। इस अनुमान को लाइकलीहुड रेशियो के साथ मिलाकर पोस्ट-टेस्ट प्रायिकता निकाली जाती है।
प्रक्रिया इस प्रकार है।
- प्री-टेस्ट प्रायिकता p से शुरू करें।
- ऑड्स में बदलें। प्री-टेस्ट ऑड्स = p / (1 - p)।
- लाइकलीहुड रेशियो लागू करें। यदि टेस्ट पॉज़िटिव है, तो प्री-टेस्ट ऑड्स को LR+ से गुणा करें; यदि नेगेटिव है, तो LR- से। पोस्ट-टेस्ट ऑड्स = प्री-टेस्ट ऑड्स × LR।
- पोस्ट-टेस्ट ऑड्स को पुनः प्रायिकता में बदलें। पोस्ट-टेस्ट प्रायिकता = पोस्ट-टेस्ट ऑड्स / (1 + पोस्ट-टेस्ट ऑड्स)।
उदाहरण के लिए, मान लें रोग की प्री-टेस्ट प्रायिकता 30% है और LR+ = 10। पोस्ट-टेस्ट प्रायिकता क्या होगी?
- p = 0.3
- प्री-टेस्ट ऑड्स = 0.3/0.7 = 0.43।
- पोस्ट-टेस्ट ऑड्स = 0.43 × 10 = 4.3
- पोस्ट-टेस्ट प्रायिकता = 4.3 / (1 + 4.3) = 81%।
हम देखते हैं कि LR+ ने प्रायिकता और निदान में भरोसे को उल्लेखनीय रूप से बदल दिया।
उन्नत कार्यप्रणालियाँ और भविष्य की दिशाएँ
जैसे-जैसे डायग्नोस्टिक टेस्टिंग और क्लासिफिकेशन सिस्टम जटिल होते जा रहे हैं, नई कार्यप्रणालियाँ पारंपरिक प्रदर्शन सीमाओं से आगे बढ़ने के लिए उभर रही हैं। इस खंड में, हम देखते हैं कि बेयेज़ियन अप्रोच किस तरह वैयक्तिकृत निर्णय थ्रेशहोल्ड सक्षम करते हैं और CRISPR-आधारित डायग्नोस्टिक्स जैसी नई तकनीकें विश्लेषणात्मक सेंसिटिविटी और स्पेसिफिसिटी की सीमाओं को कैसे आगे धकेल रही हैं।
बेयेज़ियन अप्रोच
किसी पूर्व धारणा से शुरू करना और नई जानकारी के आधार पर उसे अपडेट करना बेयेज़ियन सांख्यिकी का मूल है। यह नई डेटा के प्रकाश में प्रायिकताओं को औपचारिक रूप से संशोधित करने का तरीका प्रदान करता है।
बेयेज़ियन तर्क तीन मुख्य घटकों पर आधारित है।
- प्रायर प्रायिकता: नई सूचना देखने से पहले की प्रारंभिक धारणा। ("मौसम पूर्वानुमान ने 60% बारिश की आशंका बताई है।")
- लाइकलीहुड: यदि धारणा सही है तो नई सूचना के देखे जाने की संभावना। ("मैंने बारिश की आवाज़ सुनी, इसलिए सही पूर्वानुमान की संभावना अधिक है।")
- पोस्टेरियर प्रायिकता: नई सूचना पर विचार करने के बाद संशोधित धारणा। यह प्रायर प्रायिकता और लाइकलीहुड के गुणन से मिलती है।
इसे गणितीय रूप से बेयेज़ प्रमेय से व्यक्त किया जाता है।
P(A|B) = P(B|A) × P(A) / P(B)
जहाँ P(A|B) पोस्टेरियर है (B दिए जाने पर A की प्रायिकता), P(B|A) लाइकलीहुड है (A सत्य होने पर B की प्रायिकता), P(A) प्रायर है, और P(B) एविडेंस है।
बेयेज़ियन अप्रोच से थ्रेशहोल्ड का अनुकूलन
जैसा कि हमने देखा, पारंपरिक क्लासिफिकेशन मॉडल अक्सर 0.5 जैसे एक फिक्स्ड थ्रेशहोल्ड का उपयोग करते हैं, यह तय करने के लिए कि आउटपुट को पॉज़िटिव या नेगेटिव लेबल दिया जाए। इसके विपरीत, बेयेज़ियन अप्रोच संदर्भ—जैसे व्यक्तिगत जोखिम कारक, जनसांख्यिकी, व्यवहार इतिहास, या रियल-टाइम डेटा—के आधार पर इन थ्रेशहोल्ड्स को अनुकूलित होने देता है। यह लचीलापन सिस्टम को “वन-साइज़-फिट्स-ऑल” स्थिर थ्रेशहोल्ड पर निर्भर रहने के बजाय, थ्रेशहोल्ड्स को गतिशील रूप से समायोजित करने में सक्षम बनाता है।
मान लें एक मॉडल हृदय रोग की संभावना का अनुमान लगाता है। एक पारंपरिक मॉडल 0.5 का थ्रेशहोल्ड ले सकता है। 50% से अधिक प्रायिकता वाले मरीज पॉज़िटिव माने जाते हैं, और इससे कम वाले नेगेटिव।
अब, दो काल्पनिक मरीजों के साथ एक बेयेज़ियन अप्रोच पर विचार करें:
- मरीज A: 68-वर्षीय, आजीवन धूम्रपायी, हृदय रोग का पारिवारिक इतिहास और हाल में सीने में दर्द।
- मरीज B: 25-वर्षीय, गैर-धूम्रपायी, कोई लक्षण या प्रासंगिक इतिहास नहीं।
दोनों मरीजों को टेस्ट-जनरेटेड प्रायिकता 0.45 मिलती है। 0.5 थ्रेशहोल्ड वाला फिक्स्ड मॉडल इन दोनों मरीजों को नेगेटिव मानेगा।
हालाँकि, एक बेयेज़ियन मॉडल पूर्व जोखिम जानकारी को समाहित करता है और प्रेडिक्शन इंटरवल के साथ प्रयुक्त किया जा सकता है। मरीज A के लिए, सिस्टम निर्णय थ्रेशहोल्ड कम कर सकता है और केस को आगे के मूल्यांकन हेतु फ़्लैग कर सकता है। मरीज B के लिए, यह थ्रेशहोल्ड यथावत रख सकता है और किसी फॉलो-अप की सिफारिश नहीं करेगा।
इस तरह, बेयेज़ियन तरीके प्रत्येक मरीज के संदर्भ के अनुसार क्लासिफिकेशन थ्रेशहोल्ड तय करते हैं, जिससे अधिक चिकित्सीय रूप से उपयुक्त निर्णय निकलते हैं।
उच्च सेंसिटिविटी/स्पेसिफिसिटी वाले असेज़
एक उभरती हुई तकनीक जो विश्लेषणात्मक सेंसिटिविटी और स्पेसिफिसिटी की सीमाओं को आगे बढ़ा रही है, वह है CRISPR-आधारित डायग्नोस्टिक्स। वैज्ञानिकों ने CRISPR (Clustered Regularly Interspaced Short Palindromic Repeats), जो एक जीन-संपादन टूल है, को आनुवांशिक सामग्री का पता लगाने हेतु अनुकूलित किया है। यह Cas प्रोटीन का उपयोग करके उच्च सेंसिटिविटी के साथ विशिष्ट न्यूक्लिक एसिड सीक्वेंस का पता लगाता है।
CRISPR-आधारित असेज़ का उपयोग कैंसर के प्रारंभिक पता लगाने के लिए किया गया है। क्लिनिकल सेटिंग्स में उपयोग हेतु पोर्टेबल कैंसर डायग्नोस्टिक टूल विकसित किए जा रहे हैं। दो महत्वपूर्ण डायग्नोस्टिक प्लेटफ़ॉर्म SHERLOCK और DETECTR हैं।
CRISPR-आधारित असेज़ कई फायदे प्रदान करते हैं। ये उच्च सेंसिटिविटी देते हैं, जिससे DNA या RNA की सूक्ष्मतम मात्राएँ भी पकड़ी जा सकती हैं।
इससे शुरुआती चरण के संक्रमण, कैंसर, या दुर्लभ म्यूटेशन की पहचान में इनका विशेष महत्व है। ये असाधारण स्पेसिफिसिटी भी देते हैं, जिससे नज़दीकी रूप से संबंधित आनुवंशिक सीक्वेंसों में अंतर कर फॉल्स पॉज़िटिव्स घटाए जा सकते हैं। अतिरिक्त लाभों में त्वरित परिणाम और कम लागत, पोर्टेबल उपकरण शामिल हैं।
ये असेज़ व्यापक अनुप्रयोगों का समर्थन करते हैं, जिनमें संक्रामक रोगों का पता लगाना, कैंसर डायग्नोस्टिक्स, और आनुवंशिक रोगों की स्क्रीनिंग शामिल हैं। शोधकर्ता गाइड RNA डिज़ाइन को अनुकूलित करने और डायग्नोस्टिक एक्युरेसी सुधारने हेतु मशीन लर्निंग का उपयोग कर सकते हैं।
CRISPR-आधारित असेज़ चुनौतियों का भी सामना करते हैं। अधिकांश केवल बाइनरी परिणाम (पॉज़िटिव या नेगेटिव) प्रदान करते हैं। मानकीकरण और पुनरुत्पादन क्षमता अभी भी चिंता का विषय हैं, क्योंकि परिणाम प्रयोगशालाओं और परीक्षण स्थितियों में भिन्न हो सकते हैं।
इसके अलावा, इन असेज़ को नियामक आवश्यकताओं—जैसे FDA और CLIA स्वीकृति—को पूरा करना होता है, जिनमें व्यापक वैधता-परीक्षण, दस्तावेज़ीकरण, और समीक्षा शामिल हैं। अंततः, बौद्धिक संपदा (IP) संबंधी मुद्दे लाइसेंसिंग को जटिल बनाते हैं और व्यावसायीकरण को धीमा करते हैं।
निष्कर्ष
सेंसिटिविटी और स्पेसिफिसिटी, डायग्नोस्टिक टेस्ट और क्लासिफिकेशन मॉडलों के मूल्यांकन में केंद्रीय भूमिका निभाते हैं। ये विशेषकर असंतुलित डेटा सेट में या तब, जब फॉल्स पॉज़िटिव्स और फॉल्स नेगेटिव्स की लागतें भिन्न हों, एक्युरेसी से अधिक सूचनात्मक हो सकते हैं। लाइकलीहुड रेशियो और ROC विश्लेषण जैसे संबंधित साधनों के साथ, ये अधिक सूझबूझपूर्ण व्याख्या और बेहतर निर्णय-निर्माण का मार्गदर्शन करते हैं।
मॉडल प्रदर्शन के मूल्यांकन में अपने व्यावहारिक कौशल को गहरा करना चाहते हैं? इन DataCamp संसाधनों को ज़रूर देखें:


मशीन लर्निंग विशेषज्ञों को अपने डेटा की गुणवत्ता और अपने प्रेडिक्टिव मॉडलों के प्रदर्शन—दोनों—का आकलन करना चाहिए।
विभिन्न मेट्रिक्स मददगार होते हैं, खासकर जब बाइनरी क्लासिफिकेशन टास्क से निपटना हो; यानी जहाँ हर डेटा पॉइंट के लिए दो संभावित श्रेणियों में से एक की भविष्यवाणी की जाती है। उदाहरणों में क्रेडिट अप्रूवल (मंजूर/मंजूर नहीं), मैलवेयर क्लासिफिकेशन (मैलिशस/नॉन-मैलिशस), रिज़्यूमे स्क्रीनिंग (शॉर्टलिस्ट/शॉर्टलिस्ट नहीं), और रोग निदान (रोग है/रोग नहीं है) शामिल हैं। यहां तक कि A/B टेस्ट भी इसी से जुड़े हैं—मूल रूप से पूछते हैं, "क्या वर्ज़न B, वर्ज़न A से बेहतर है?" (हाँ/नहीं)।
हालाँकि एक्युरेसी प्रदर्शन का त्वरित सार देती है, यह किसी मॉडल की त्रुटियों की प्रकृति के बारे में महत्वपूर्ण जानकारी छिपा सकती है। उदाहरण के लिए, यदि कोई क्रेडिट फ्रॉड डिटेक्टर हर लेन-देन को वैध के रूप में लेबल कर दे, तो वह 99% एक्युरेसी पा सकता है, फिर भी वास्तविक धोखाधड़ी का पता लगाने में विफल रहेगा। सेंसिटिविटी और स्पेसिफिसिटी अधिक सूक्ष्म दृष्टि देती हैं—यह समझने में मदद करती हैं कि मॉडल कितनी बार सही है ही नहीं, बल्कि वह किस प्रकार की गलतियाँ करता है और क्या वे संदर्भ में स्वीकार्य हैं।
इस गाइड में, आप जानेंगे कि सेंसिटिविटी और स्पेसिफिसिटी का वास्तविक अर्थ क्या है, किस स्थिति में कौन-सा मेट्रिक अधिक उपयुक्त है, इनकी गणना कैसे होती है, और स्पष्ट, वास्तविक जीवन के उदाहरणों के माध्यम से इन्हें अपने कार्य में व्यावहारिक रूप से कैसे लागू किया जाए।
डायग्नोस्टिक टेस्टिंग और क्लिनिकल निर्णय-निर्माण
सेंसिटिविटी और स्पेसिफिसिटी की उत्पत्ति चिकित्सीय मूल्यांकन में हुई। इन मेट्रिक्स को डायग्नोस्टिक टेस्टिंग और क्लिनिकल निर्णय-निर्माण के दृष्टिकोण से देखने पर इस लेख की कई अवधारणाएँ स्पष्ट होती हैं। उदाहरण के तौर पर, हम दो परिदृश्यों—रोग का पता लगाना और क्रेडिट कार्ड फ्रॉड—का उपयोग करेंगे।
लक्षित पाठक
यह लेख उन डेटा प्रैक्टिशनर्स के लिए है जो सांख्यिकीय अनुमान का उपयोग करते हैं और बेहतर निर्णय-निर्माण के लिए एक्युरेसी से अधिक सूक्ष्म मेट्रिक्स समझना चाहते हैं। ये मेट्रिक्स यह आकलन करने में मदद करते हैं कि कोई मॉडल किस प्रकार की त्रुटियाँ करता है और क्या वे त्रुटियाँ संदर्भ में स्वीकार्य हैं। अनुप्रयोगों में, जैसा कि हमने देखा, चिकित्सा निदान और फ्रॉड डिटेक्शन शामिल हैं। अन्य अनुप्रयोगों में इंट्रूज़न डिटेक्शन, मैन्युफैक्चरिंग में क्वालिटी कंट्रोल, और स्पैम फ़िल्टरिंग शामिल हैं।
सेंसिटिविटी और स्पेसिफिसिटी की बुनियादी अवधारणाएँ
सेंसिटिविटी और स्पेसिफिसिटी की व्याख्या या उपयोग करने से पहले, इनके पीछे की बुनियादी अवधारणाओं को समझना आवश्यक है। इस खंड में, हम ऐतिहासिक उत्पत्ति, मुख्य परिभाषाएँ, व्युत्पत्तियाँ, और गणनाएँ चर्चा करेंगे।
इतिहास
सेंसिटिविटी और स्पेसिफिसिटी की अवधारणाएँ बायोस्टैटिस्टिक्स में उत्पन्न हुईं। यद्यपि चिकित्सा साहित्य में इनका पहले भी उपयोग हुआ, बायोस्टैटिस्टिक्स शोधकर्ता जैकब येरुशलमी ने अपने पेपर "Statistical Problems in Assessing Methods of Medical Diagnosis, with Special Reference to X-Ray Techniques" में इन शब्दों को लोकप्रिय बनाया।
1970 के दशक में, रिसीवर ऑपरेटिंग कैरेक्टरिस्टिक (ROC) कर्व (आगे वर्णित) क्लिनिकल टेस्टिंग में सेंसिटिविटी बनाम स्पेसिफिसिटी का दृश्य विश्लेषण करने का उपकरण बना। 1990 के दशक में, मशीन लर्निंग ने इन अवधारणाओं को अपनाया। आज, ये शब्द स्वास्थ्य-सेवा और मशीन लर्निंग दोनों में ट्रू पॉज़िटिव्स और ट्रू नेगेटिव्स की पहचान की क्षमता मापने के लिए व्यापक रूप से उपयोग किए जाते हैं।
कन्फ्यूज़न मैट्रिक्स
मान लीजिए एक मशीन लर्निंग मॉडल का उपयोग धोखाधड़ीपूर्ण क्रेडिट कार्ड लेन-देन का पता लगाने के लिए किया जाता है। 10,000 लेन-देन के एक सैंपल में, 9800 वैध (लीजिटिमेट) लेन-देन हैं और 200 मामले फ्रॉड के हैं।
चूँकि हमारी प्राथमिक रुचि फ्रॉड मामलों में है, तो फ्रॉडulent मामलों को पॉज़िटिव और गैर-फ्रॉड मामलों को नेगेटिव मान लेते हैं। (किसे "पॉज़िटिव" और किसे "नेगेटिव" माना जाए, कुछ हद तक मनमाना है; पर प्रायः लेबलिंग का स्पष्ट तरीका होता है।)
मॉडल चलाने और अनुमानित फ्रॉड मामलों की वास्तविक फ्रॉड मामलों से तुलना करने पर पता चलता है कि 160 फ्रॉड मामले सही रूप से फ़्लैग हुए, 9500 वैध लेन-देन सही रूप से पहचाने गए, 300 वैध लेन-देन को गलत तरीके से फ्रॉड के रूप में फ़्लैग किया गया, और 40 फ्रॉड मामले मॉडल से छूट गए।
इन सभी आँकड़ों को व्यवस्थित रखने के लिए, निम्नलिखित शब्दावली का सामान्यतः उपयोग होता है।
दूसरा अक्षर (P या N) बताता है कि केस को पॉज़िटिव या नेगेटिव के रूप में प्रेडिक्ट किया गया था, और पहला अक्षर बताता है कि वह प्रेडिक्शन सही (T) था या गलत (F)।
तो, "फॉल्स पॉज़िटिव" का अर्थ है कि केस को पॉज़िटिव प्रेडिक्ट किया गया था, और वह प्रेडिक्शन गलत था—अर्थात केस वास्तव में नेगेटिव था। इसी प्रकार, फॉल्स नेगेटिव वह केस है जिसे नेगेटिव प्रेडिक्ट किया गया था, पर वह वास्तव में पॉज़िटिव है।
इस जानकारी को प्रदर्शित करने के लिए हम प्रायः "कन्फ्यूज़न मैट्रिक्स" का उपयोग करते हैं—ऐसा इसलिए कहा जाता है क्योंकि यह ट्रैक रखता है कि मॉडल कितनी बार गलत प्रेडिक्शन को वास्तविक परिणामों (FN, FP) से गड़बड़ा देता है। यहाँ एक उदाहरण है:
वास्तविक फ्रॉड (पॉज़िटिव)
वास्तविक वैध (नेगेटिव)
प्रेडिक्टेड फ्रॉड (प्रेडिक्टेड पॉज़िटिव)
160 (TP)
300 (FP)
प्रेडिक्टेड वैध (प्रेडिक्टेड नेगेटिव)
40 (FN)
9500 (TN)
अब, पंक्ति और स्तंभ के कुलों पर नज़र डालते हैं। पंक्तियों के योग कुल प्रेडिक्टेड केस दर्शाते हैं और स्तंभों के योग कुल वास्तविक केस।
वास्तविक फ्रॉड (पॉज़िटिव)
वास्तविक वैध (नेगेटिव)
प्रेडिक्टेड फ्रॉड (प्रेडिक्टेड पॉज़िटिव)
160 (TP)
300 (FP)
460 (TP + FP)
कुल प्रेडिक्टेड पॉज़िटिव्स
प्रेडिक्टेड वैध (प्रेडिक्टेड नेगेटिव)
40 (FN)
9500 (TN)
9540 (FN + TN) कुल प्रेडिक्टेड नेगेटिव्स
200 (TP + FN) कुल वास्तविक पॉज़िटिव्स
9800 (FP + TN) कुल वास्तविक नेगेटिव्स
10,000
ये कुल क्या दर्शाते हैं?
परिभाषाएँ
सेंसिटिविटी (जिसे ट्रू पॉज़िटिव रेट या रिकॉल भी कहा जाता है) मॉडल की ट्रू पॉज़िटिव्स को सही पहचानने की क्षमता मापती है। अधिक सटीक रूप से, सेंसिटिविटी वास्तविक पॉज़िटिव्स में ट्रू पॉज़िटिव्स का अनुपात है, TP / (TP + FN)।
इसी तरह, स्पेसिफिसिटी (ट्रू नेगेटिव रेट) मॉडल की ट्रू नेगेटिव्स को पहचानने की क्षमता मापती है। यह वास्तविक नेगेटिव्स में ट्रू नेगेटिव्स का अनुपात है, TN / (FP + TN)।
प्रायिकतामूलक दृष्टिकोण से, सेंसिटिविटी वह प्रायिकता है कि रोगी को रोग होने पर परीक्षण पॉज़िटिव आए; और स्पेसिफिसिटी वह प्रायिकता है कि रोगी को रोग न होने पर परीक्षण नेगेटिव आए।
सेंसिटिविटी और स्पेसिफिसिटी की गणना
हमारे फ्रॉड उदाहरण में, सेंसिटिविटी = TP / (TP + FN) = 160/200, यानी 80%। स्पेसिफिसिटी 9500/9800 है, यानी लगभग 97%।
सेंसिटिविटी–स्पेसिफिसिटी ट्रेड-ऑफ और ROC विश्लेषण
जैसे-जैसे मॉडल थ्रेशहोल्ड बदलते हैं, सेंसिटिविटी और स्पेसिफिसिटी अक्सर विपरीत दिशाओं में चलती हैं। सेंसिटिविटी बढ़ाने पर आमतौर पर स्पेसिफिसिटी घटती है, और इसके उलट। इस खंड में, हम इस अंतर्निहित ट्रेड-ऑफ की पड़ताल करेंगे और चर्चा करेंगे कि रिसीवर ऑपरेटिंग कैरेक्टरिस्टिक (ROC) विश्लेषण कैसे विभिन्न थ्रेशहोल्ड्स पर मॉडल के प्रदर्शन का दृश्य और परिमाणात्मक आकलन प्रदान करता है।
ट्रेड-ऑफ्स
आइए फ्रॉड उदाहरण में थोड़ा बदलाव करें ताकि फॉल्स नेगेटिव्स 20 और बढ़ जाएँ, FN = 60। चूँकि वास्तविक फ्रॉड मामलों की कुल संख्या अभी भी 200 है, अब ट्रू पॉज़िटिव्स 20 कम होंगे (TP = 140)।
वास्तविक फ्रॉड (पॉज़िटिव)
वास्तविक वैध (नेगेटिव)
प्रेडिक्टेड फ्रॉड (प्रेडिक्टेड पॉज़िटिव)
140 (TP)
300 (FP)
460 (TP + FP)
कुल प्रेडिक्टेड पॉज़िटिव्स
प्रेडिक्टेड वैध (प्रेडिक्टेड नेगेटिव)
60 (FN)
9500 (TN)
9540 (FN + TN) कुल प्रेडिक्टेड नेगेटिव्स
200 (TP + FN) कुल वास्तविक पॉज़िटिव्स
9800 (FP + TN) कुल वास्तविक नेगेटिव्स
10,000
सेंसिटिविटी 80% से घटकर 140/200 = 70% हो गई है। जैसे-जैसे फॉल्स नेगेटिव्स बढ़ते हैं, सेंसिटिविटी घटती है—और इसके विपरीत। इसका अर्थ है कि उच्च सेंसिटिविटी होने पर फॉल्स नेगेटिव्स की संख्या कम होती है।
चिकित्सीय दृष्टि से, उच्च स्पेसिफिसिटी वाला परीक्षण उन अधिकांश लोगों को सही रूप से पहचानता है जिन्हें वह स्थिति नहीं है। हमारे कैंसर स्क्रीनिंग उदाहरण में, उच्च स्पेसिफिसिटी वाला परीक्षण सुनिश्चित करता है कि जिन लोगों को कैंसर नहीं है उन्हें गलत रूप से बताया न जाए कि उन्हें है।
यह सेंसिटिविटी और स्पेसिफिसिटी के बीच ट्रेड-ऑफ को दर्शाता है। कुछ मरीज तब घबरा सकते हैं जब उन्हें गलत रूप से कैंसर होने की सूचना दी जाए, लेकिन जिन्हें वास्तव में रोग है, वे सही पहचाने जाते हैं। इस स्थिति में, उच्च स्पेसिफिसिटी बेहतर मेट्रिक है। एक अपूर्ण दुनिया में, हमें मेट्रिक्स के बीच ट्रेड-ऑफ का आकलन कर उपयुक्त निर्णय लेने होते हैं।
थ्रेशहोल्ड की गतिशीलता
डायग्नोस्टिक थ्रेशहोल्ड वह कटऑफ मान निर्धारित करता है जो तय करता है कि कोई टेस्ट रिज़ल्ट पॉज़िटिव माना जाएगा या नेगेटिव। यह किसी सतत मान, जैसे प्रायिकता, को हाँ/नहीं कटऑफ में बदल देता है। सामान्य शब्दों में, यह तय करता है कि पॉज़िटिव और नेगेटिव परिणामों के बीच रेखा कहाँ खींची जाए।
थ्रेशहोल्ड अक्सर 50% या 0.50 पर सेट किया जाता है। 50% से अधिक प्रायिकता को पॉज़िटिव और 50% से कम को नेगेटिव माना जाता है।
थ्रेशहोल्ड बदलने से यह तय होता है कि किन मामलों को पॉज़िटिव और किन्हें नेगेटिव माना जाए। यह बदलाव ट्रू पॉज़िटिव्स पकड़ने और फॉल्स नेगेटिव्स से बचने के बीच संतुलन को प्रभावित करता है।
उदाहरण के लिए, मान लें कोई मॉडल कैंसर की प्रायिकता आउटपुट करता है। यदि थ्रेशहोल्ड 0.3 पर सेट है, तो मॉडल कई लोगों को पॉज़िटिव के रूप में वर्गीकृत करेगा। यह स्क्रीनिंग के लिए अच्छा है क्योंकि मामलों के छूटने की संभावना घटती है।
हालाँकि, इससे फॉल्स पॉज़िटिव्स का जोखिम बढ़ता है। यदि थ्रेशहोल्ड 0.8 है, तो मॉडल कम लोगों को पॉज़िटिव के रूप में वर्गीकृत करेगा। यह फॉल्स पॉज़िटिव्स घटाता है लेकिन वास्तविक मामलों के छूटने का जोखिम बढ़ाता है।
जब थ्रेशहोल्ड बदलता है, तो मॉडल इस बात में बदलाव करता है कि वह कितनी बार ट्रू पॉज़िटिव्स पकड़ता है और कितनी बार फॉल्स पॉज़िटिव्स से बचता है। कम थ्रेशहोल्ड सेंसिटिविटी बढ़ाते हैं लेकिन स्पेसिफिसिटी घटाते हैं; उच्च थ्रेशहोल्ड इसके विपरीत करते हैं।
ROC कर्व की व्याख्या
एक रिसीवर ऑपरेटिंग कैरेक्टरिस्टिक (ROC) कर्व एक सामान्य दृश्य साधन है जो सेंसिटिविटी और स्पेसिफिसिटी के मानों पर विभिन्न क्लासिफिकेशन थ्रेशहोल्ड्स की तुलना करता है। ROC कर्व सेंसिटिविटी को 1 - स्पेसिफिसिटी के विरुद्ध प्लॉट करता है। कर्व का हर बिंदु एक विशिष्ट थ्रेशहोल्ड का प्रतिनिधित्व करता है। जैसे-जैसे थ्रेशहोल्ड बदलता है, मॉडल की सेंसिटिविटी और स्पेसिफिसिटी उसी अनुरूप समायोजित होती हैं, और ROC कर्व ट्रेस होता है।
ROC कर्व सेंसिटिविटी और स्पेसिफिसिटी के बीच ट्रेड-ऑफ को दर्शाता है। कर्व पर मुख्य बिंदु:
तिरछी बिंदीदार रेखा यादृच्छिक संभावना का प्रतिनिधित्व करती है। इस रेखा के अनुरूप प्रदर्शन करने वाला मॉडल वास्तविक भेदकारी क्षमता नहीं रखता।
किसी मॉडल का ROC कर्व से मूल्यांकन करने हेतु, "एरिया अंडर द कर्व" (AUC) पर विचार करें। AUC कर्व के नीचे का कुल क्षेत्रफल (इंटीग्रल) है, जो सभी थ्रेशहोल्ड्स पर प्रदर्शन का भारित औसत दर्शाता है। उच्च AUC यह दर्शाता है कि मॉडल पॉज़िटिव और नेगेटिव क्लासों के बीच समग्र रूप से बेहतर भेद कर सकता है।
AUC स्कोर
व्याख्या
1.0
परफेक्ट क्लासिफायर
0.9 - 1.0
उत्कृष्ट
0.8 - 0.9
अच्छा
0.7 - 0.8
संतोषजनक
0.6 - 0.7
कमज़ोर
0.5
कोई भेद-क्षमता नहीं (यादृच्छिक अनुमान के बराबर)
< 0.5
यादृच्छिक से भी बदतर
प्रेडिक्टिव वैल्यूज़ और लाइकलीहुड रेशियो
इस खंड में, हम देखते हैं कि प्रीवलेंस (प्रचलन) टेस्ट परिणामों की विश्वसनीयता को कैसे प्रभावित करता है। हम यह भी देखते हैं कि लाइकलीहुड रेशियो किस तरह सेंसिटिविटी और स्पेसिफिसिटी को एक एकल संख्या में संयोजित करते हैं, जो चिकित्सकों को परीक्षण के बाद डायग्नोस्टिक प्रायिकताओं को अपडेट करने की अनुमति देता है।
प्रिवलेंस-निर्भर मेट्रिक्स
पॉज़िटिव प्रेडिक्टिव वैल्यू (PPV), जो गणितीय रूप से मशीन लर्निंग में प्रिसिशन के समतुल्य है, दर्शाती है कि कोई पॉज़िटिव प्रेडिक्शन सही होने की कितनी संभावना है। यह प्रेडिक्टेड पॉज़िटिव्स में ट्रू पॉज़िटिव्स का अनुपात मापती है: PPV = TP / (TP + FP)।
नेगेटिव प्रेडिक्टिव वैल्यू (NPV) नेगेटिव परिणाम की विश्वसनीयता दर्शाती है। यह नेगेटिव टेस्ट परिणामों में ट्रू नेगेटिव्स का अनुपात मापती है। इसका सूत्र है NPV = TN / (TN + FN)।
मान लीजिए, हम 1000 लोगों का किसी बीमारी के लिए परीक्षण करते हैं और निम्न कन्फ्यूज़न मैट्रिक्स मिलता है।
वास्तविक पॉज़िटिव (बीमार)
वास्तविक नेगेटिव (स्वस्थ)
प्रेडिक्टेड पॉज़िटिव (बीमार)
80 (TP)
20 (FP)
100
प्रेडिक्टेड नेगेटिव (स्वस्थ)
10 (FN)
890 (TN)
900
90
910
1000
तुलना हेतु, मान लें अधिक लोग बीमार हैं (90 की जगह 300), और उसी अनुसार कन्फ्यूज़न मैट्रिक्स समायोजित करें।
वास्तविक पॉज़िटिव (बीमार)
वास्तविक नेगेटिव (स्वस्थ)
प्रेडिक्टेड पॉज़िटिव (बीमार)
270 (TP)
70 (FP)
340
प्रेडिक्टेड नेगेटिव (स्वस्थ)
30 (FN)
630 (TN)
660
300
700
1000
जैसे-जैसे प्रीवलेंस बढ़ता है, ट्रू पॉज़िटिव मामलों की संख्या बढ़ती है।
लाइकलीहुड रेशियो
लाइकलीहुड रेशियो सेंसिटिविटी और स्पेसिफिसिटी को एक एकल संख्या में संयोजित करते हैं, जो चिकित्सकों को टेस्ट परिणामों के आधार पर निदान में अपने भरोसे को अपडेट करने में मदद करती है।
प्रायिकता बनाम ऑड्स
लाइकलीहुड रेशियो लागू करने से पहले, प्रायिकता और ऑड्स में अंतर करना महत्वपूर्ण है। प्रायिकता किसी घटना के होने की संभावना है, जिसे 0 और 1 के बीच के मान के रूप में व्यक्त किया जाता है। ऑड्स यह दर्शाते हैं कि घटना के होने की संभावना उसके न होने की तुलना में कितनी है।
75% प्रायिकता का अर्थ है कि घटना 100 में 75 बार होती है। इसके अनुरूप घटना के ऑड्स 0.75 / (1 - 0.75) = 0.75 / .025 = 3 हैं। इसका मतलब है कि घटना के होने के ऑड्स 3 से 1 हैं।
सामान्यतः, यदि p किसी घटना की प्रायिकता है, तो ऑड्स = p / (1 - p)। ऑड्स से प्रायिकता में रूपांतरण: p = ऑड्स / (1 + ऑड्स)।
लाइकलीहुड रेशियो
पॉज़िटिव लाइकलीहुड रेशियो (LR+) बताता है कि पॉज़िटिव परिणाम होने पर, बिना स्थिति वाले व्यक्ति की तुलना में, स्थिति होने के ऑड्स कितने बढ़ते हैं। उच्च मान (>10) संकेत देते हैं कि टेस्ट स्थिति को “रूल-इन” करने में अत्यंत प्रभावी है। सूत्र: LR+ = Sensitivity / (1 - Specificity)।
नेगेटिव लाइकलीहुड रेशियो (LR-) बताता है कि नेगेटिव परिणाम होने पर, बिना स्थिति वाले व्यक्ति की तुलना में, स्थिति होने के ऑड्स कितने घटते हैं। कम मान (< 0.1) संकेत देते हैं कि टेस्ट किसी स्थिति को “रूल-आउट” करने में अत्यंत प्रभावी है। सूत्र: LR- = (1 - Sensitivity) / Specificity।
पोस्ट-टेस्ट प्रायिकता
निर्णय लेने हेतु, चिकित्सक प्री-टेस्ट प्रायिकता से शुरू करते हैं, जिसका अनुमान रोगी के लक्षणों और इतिहास जैसे कारकों पर आधारित होता है। इस अनुमान को लाइकलीहुड रेशियो के साथ मिलाकर पोस्ट-टेस्ट प्रायिकता निकाली जाती है।
प्रक्रिया इस प्रकार है।
उदाहरण के लिए, मान लें रोग की प्री-टेस्ट प्रायिकता 30% है और LR+ = 10। पोस्ट-टेस्ट प्रायिकता क्या होगी?
हम देखते हैं कि LR+ ने प्रायिकता और निदान में भरोसे को उल्लेखनीय रूप से बदल दिया।
उन्नत कार्यप्रणालियाँ और भविष्य की दिशाएँ
जैसे-जैसे डायग्नोस्टिक टेस्टिंग और क्लासिफिकेशन सिस्टम जटिल होते जा रहे हैं, नई कार्यप्रणालियाँ पारंपरिक प्रदर्शन सीमाओं से आगे बढ़ने के लिए उभर रही हैं। इस खंड में, हम देखते हैं कि बेयेज़ियन अप्रोच किस तरह वैयक्तिकृत निर्णय थ्रेशहोल्ड सक्षम करते हैं और CRISPR-आधारित डायग्नोस्टिक्स जैसी नई तकनीकें विश्लेषणात्मक सेंसिटिविटी और स्पेसिफिसिटी की सीमाओं को कैसे आगे धकेल रही हैं।
बेयेज़ियन अप्रोच
किसी पूर्व धारणा से शुरू करना और नई जानकारी के आधार पर उसे अपडेट करना बेयेज़ियन सांख्यिकी का मूल है। यह नई डेटा के प्रकाश में प्रायिकताओं को औपचारिक रूप से संशोधित करने का तरीका प्रदान करता है।
बेयेज़ियन तर्क तीन मुख्य घटकों पर आधारित है।
इसे गणितीय रूप से बेयेज़ प्रमेय से व्यक्त किया जाता है।
P(A|B) = P(B|A) × P(A) / P(B)
जहाँ P(A|B) पोस्टेरियर है (B दिए जाने पर A की प्रायिकता), P(B|A) लाइकलीहुड है (A सत्य होने पर B की प्रायिकता), P(A) प्रायर है, और P(B) एविडेंस है।
बेयेज़ियन अप्रोच से थ्रेशहोल्ड का अनुकूलन
जैसा कि हमने देखा, पारंपरिक क्लासिफिकेशन मॉडल अक्सर 0.5 जैसे एक फिक्स्ड थ्रेशहोल्ड का उपयोग करते हैं, यह तय करने के लिए कि आउटपुट को पॉज़िटिव या नेगेटिव लेबल दिया जाए। इसके विपरीत, बेयेज़ियन अप्रोच संदर्भ—जैसे व्यक्तिगत जोखिम कारक, जनसांख्यिकी, व्यवहार इतिहास, या रियल-टाइम डेटा—के आधार पर इन थ्रेशहोल्ड्स को अनुकूलित होने देता है। यह लचीलापन सिस्टम को “वन-साइज़-फिट्स-ऑल” स्थिर थ्रेशहोल्ड पर निर्भर रहने के बजाय, थ्रेशहोल्ड्स को गतिशील रूप से समायोजित करने में सक्षम बनाता है।
मान लें एक मॉडल हृदय रोग की संभावना का अनुमान लगाता है। एक पारंपरिक मॉडल 0.5 का थ्रेशहोल्ड ले सकता है। 50% से अधिक प्रायिकता वाले मरीज पॉज़िटिव माने जाते हैं, और इससे कम वाले नेगेटिव।
अब, दो काल्पनिक मरीजों के साथ एक बेयेज़ियन अप्रोच पर विचार करें:
दोनों मरीजों को टेस्ट-जनरेटेड प्रायिकता 0.45 मिलती है। 0.5 थ्रेशहोल्ड वाला फिक्स्ड मॉडल इन दोनों मरीजों को नेगेटिव मानेगा।
हालाँकि, एक बेयेज़ियन मॉडल पूर्व जोखिम जानकारी को समाहित करता है और प्रेडिक्शन इंटरवल के साथ प्रयुक्त किया जा सकता है। मरीज A के लिए, सिस्टम निर्णय थ्रेशहोल्ड कम कर सकता है और केस को आगे के मूल्यांकन हेतु फ़्लैग कर सकता है। मरीज B के लिए, यह थ्रेशहोल्ड यथावत रख सकता है और किसी फॉलो-अप की सिफारिश नहीं करेगा।
इस तरह, बेयेज़ियन तरीके प्रत्येक मरीज के संदर्भ के अनुसार क्लासिफिकेशन थ्रेशहोल्ड तय करते हैं, जिससे अधिक चिकित्सीय रूप से उपयुक्त निर्णय निकलते हैं।
उच्च सेंसिटिविटी/स्पेसिफिसिटी वाले असेज़
एक उभरती हुई तकनीक जो विश्लेषणात्मक सेंसिटिविटी और स्पेसिफिसिटी की सीमाओं को आगे बढ़ा रही है, वह है CRISPR-आधारित डायग्नोस्टिक्स। वैज्ञानिकों ने CRISPR (Clustered Regularly Interspaced Short Palindromic Repeats), जो एक जीन-संपादन टूल है, को आनुवांशिक सामग्री का पता लगाने हेतु अनुकूलित किया है। यह Cas प्रोटीन का उपयोग करके उच्च सेंसिटिविटी के साथ विशिष्ट न्यूक्लिक एसिड सीक्वेंस का पता लगाता है।
CRISPR-आधारित असेज़ का उपयोग कैंसर के प्रारंभिक पता लगाने के लिए किया गया है। क्लिनिकल सेटिंग्स में उपयोग हेतु पोर्टेबल कैंसर डायग्नोस्टिक टूल विकसित किए जा रहे हैं। दो महत्वपूर्ण डायग्नोस्टिक प्लेटफ़ॉर्म SHERLOCK और DETECTR हैं।
CRISPR-आधारित असेज़ कई फायदे प्रदान करते हैं। ये उच्च सेंसिटिविटी देते हैं, जिससे DNA या RNA की सूक्ष्मतम मात्राएँ भी पकड़ी जा सकती हैं।
इससे शुरुआती चरण के संक्रमण, कैंसर, या दुर्लभ म्यूटेशन की पहचान में इनका विशेष महत्व है। ये असाधारण स्पेसिफिसिटी भी देते हैं, जिससे नज़दीकी रूप से संबंधित आनुवंशिक सीक्वेंसों में अंतर कर फॉल्स पॉज़िटिव्स घटाए जा सकते हैं। अतिरिक्त लाभों में त्वरित परिणाम और कम लागत, पोर्टेबल उपकरण शामिल हैं।
ये असेज़ व्यापक अनुप्रयोगों का समर्थन करते हैं, जिनमें संक्रामक रोगों का पता लगाना, कैंसर डायग्नोस्टिक्स, और आनुवंशिक रोगों की स्क्रीनिंग शामिल हैं। शोधकर्ता गाइड RNA डिज़ाइन को अनुकूलित करने और डायग्नोस्टिक एक्युरेसी सुधारने हेतु मशीन लर्निंग का उपयोग कर सकते हैं।
CRISPR-आधारित असेज़ चुनौतियों का भी सामना करते हैं। अधिकांश केवल बाइनरी परिणाम (पॉज़िटिव या नेगेटिव) प्रदान करते हैं। मानकीकरण और पुनरुत्पादन क्षमता अभी भी चिंता का विषय हैं, क्योंकि परिणाम प्रयोगशालाओं और परीक्षण स्थितियों में भिन्न हो सकते हैं।
इसके अलावा, इन असेज़ को नियामक आवश्यकताओं—जैसे FDA और CLIA स्वीकृति—को पूरा करना होता है, जिनमें व्यापक वैधता-परीक्षण, दस्तावेज़ीकरण, और समीक्षा शामिल हैं। अंततः, बौद्धिक संपदा (IP) संबंधी मुद्दे लाइसेंसिंग को जटिल बनाते हैं और व्यावसायीकरण को धीमा करते हैं।
निष्कर्ष
सेंसिटिविटी और स्पेसिफिसिटी, डायग्नोस्टिक टेस्ट और क्लासिफिकेशन मॉडलों के मूल्यांकन में केंद्रीय भूमिका निभाते हैं। ये विशेषकर असंतुलित डेटा सेट में या तब, जब फॉल्स पॉज़िटिव्स और फॉल्स नेगेटिव्स की लागतें भिन्न हों, एक्युरेसी से अधिक सूचनात्मक हो सकते हैं। लाइकलीहुड रेशियो और ROC विश्लेषण जैसे संबंधित साधनों के साथ, ये अधिक सूझबूझपूर्ण व्याख्या और बेहतर निर्णय-निर्माण का मार्गदर्शन करते हैं।
मॉडल प्रदर्शन के मूल्यांकन में अपने व्यावहारिक कौशल को गहरा करना चाहते हैं? इन DataCamp संसाधनों को ज़रूर देखें: