
Programma
Fondamenti di apprendimento automatico in Python
16 ore
Chi lavora nel machine learning deve valutare sia la qualità dei propri dati sia le prestazioni dei modelli predittivi.
Esistono varie metriche utili, soprattutto quando si affrontano problemi di classificazione binaria, in cui ogni dato viene assegnato a una di due possibili categorie. Esempi includono approvazione del credito (approva/non approva), classificazione di malware (malevolo/non malevolo), screening dei CV (seleziona/non seleziona) e diagnosi di malattie (ha la malattia/non ha la malattia). Anche i test A/B sono strettamente correlati, perché di fatto chiedono: "La versione B è migliore della versione A?" (sì/no).
Sebbene l'accuratezza offra un riepilogo rapido delle prestazioni, può nascondere informazioni cruciali sulla natura degli errori del modello. Per esempio, un rilevatore di frodi con carta di credito che etichetta ogni transazione come legittima potrebbe raggiungere il 99% di accuratezza, ma fallire completamente nell'individuare le frodi reali. Sensibilità e specificità offrono una visione più sfumata: aiutano a capire non solo quanto spesso un modello ha ragione, ma anche quali tipi di errori commette e se quegli errori sono accettabili nel contesto.
In questa guida vedrai cosa significano davvero sensibilità e specificità, quando ciascuna metrica è più appropriata, come si calcolano e come applicarle in pratica nel tuo lavoro attraverso esempi chiari e reali.
Sensibilità e specificità nascono nella valutazione medica. Inquadrare queste metriche attraverso la lente dei test diagnostici e del processo decisionale clinico aiuta a chiarire molti concetti dell'articolo. Per illustrare, useremo due esempi ricorrenti: rilevamento di malattie e frodi con carta di credito.
Questo articolo è per chi lavora con i dati e usa l'inferenza statistica e vuole comprendere metriche più sfumate dell'accuratezza per prendere decisioni migliori. Queste metriche aiutano a valutare quali tipi di errori compie un modello e se quegli errori sono accettabili nel contesto. Le applicazioni includono diagnostica medica e rilevamento di frodi, come visto. Altre applicazioni: rilevamento delle intrusioni, controllo qualità in produzione e filtraggio dello spam.
Prima di interpretare o applicare sensibilità e specificità, è essenziale capirne i concetti di base. In questa sezione trattiamo origini storiche, definizioni chiave, derivazioni e calcoli.
I concetti di sensibilità e specificità hanno origine nella biostatistica. Sebbene fossero già usati in letteratura medica, il biostatistico Jacob Yerushlamy ha reso popolare il termine nel suo articolo "Statistical Problems in Assessing Methods of Medical Diagnosis, with Special Reference to X-Ray Techniques."
Negli anni ’70, la curva ROC (receiver operating characteristic, descritta più avanti) è diventata uno strumento per analizzare visivamente sensibilità e specificità nei test clinici. Negli anni ’90, il machine learning ha adottato questi concetti. Oggi i termini sono ampiamente usati in sanità e ML per misurare quanto bene i sistemi identificano veri positivi e veri negativi.
Supponiamo di usare un modello di machine learning per rilevare transazioni con carta di credito fraudolente. Su un campione di 10.000 transazioni, 9800 sono legittime e 200 sono casi di frode.
Poiché ci interessano soprattutto i casi di frode, indichiamo i casi fraudolenti come positivi e quelli non fraudolenti come negativi. (La scelta di cosa etichettare come "positivo" e "negativo" è in parte arbitraria; di solito però c’è un modo ovvio di etichettare i casi.)
Dopo aver eseguito il modello e confrontato i casi di frode previsti con quelli reali, troviamo che 160 casi di frode sono correttamente segnalati, 9500 transazioni legittime sono correttamente identificate, 300 transazioni legittime sono segnate erroneamente come frode e 40 casi di frode non vengono intercettati dal modello.
Per tenere in ordine questi dati, si usa comunemente la seguente nomenclatura.
La seconda lettera (P o N) indica se il caso è stato previsto come positivo o negativo, e la prima lettera indica se tale previsione era vera (T) o falsa (F).
Quindi, un "falso positivo" indica che il caso è stato previsto come positivo e la previsione era falsa, ovvero il caso è stato previsto come positivo ma in realtà era negativo. Allo stesso modo, un falso negativo è un caso previsto come negativo ma che in realtà è positivo.
Per visualizzare queste informazioni, si usa comunemente una "matrice di confusione", così chiamata perché tiene traccia di quante volte il modello confonde previsioni errate con risultati reali (FN, FP). Ecco un esempio:
|
Frode reale (Positivo) |
Legittima reale (Negativo) |
|
|
Frode prevista (Positivo previsto) |
160 (TP) |
300 (FP) |
|
Legittima prevista (Negativo previsto) |
40 (FN) |
9500 (TN) |
Ora guardiamo ai totali per righe e colonne. Le somme di riga indicano i casi previsti totali e le somme di colonna gli effettivi totali.
|
Frode reale (Positivo) |
Legittima reale (Negativo) |
||
|
Frode prevista (Positivo previsto) |
160 (TP) |
300 (FP) |
460 (TP + FP) Totale positivi previsti |
|
Legittima prevista (Negativo previsto) |
40 (FN) |
9500 (TN) |
9540 (FN + TN) Totale negativi previsti |
|
200 (TP + FN) Totale positivi reali |
9800 (FP + TN) Totale negativi reali |
10.000 |
Cosa rappresentano questi totali?
Sensibilità (nota anche come tasso di veri positivi o recall) misura la capacità del modello di identificare correttamente i veri positivi. Più precisamente, è la proporzione di veri positivi sui positivi reali, TP / (TP + FN).
Analogamente, la specificità (tasso di veri negativi) misura la capacità del modello di identificare i veri negativi. È la proporzione di veri negativi sui negativi reali, TN / (FP + TN).
Dal punto di vista probabilistico, la sensibilità è la probabilità di un test positivo dato che il paziente ha la malattia, e la specificità è la probabilità di un test negativo dato che il paziente non ha la malattia.
Nel nostro esempio di frode, sensibilità = TP / (TP + FN) = 160/200, cioè 80%. La specificità è 9500/9800, circa il 97%.
Al variare delle soglie del modello, sensibilità e specificità spesso si muovono in direzioni opposte. Aumentare la sensibilità tipicamente riduce la specificità, e viceversa. In questa sezione esploriamo questo trade-off intrinseco e come l'analisi ROC (Receiver Operating Characteristic) offra un approccio visivo e quantitativo per valutare le prestazioni del modello su varie soglie.
Modifichiamo l'esempio di frode in modo che ci siano 20 falsi negativi in più, FN = 60. Poiché il numero totale di casi di frode reali è ancora 200, ora ci saranno 20 veri positivi in meno (TP = 140).
|
Frode reale (Positivo) |
Legittima reale (Negativo) |
||
|
Frode prevista (Positivo previsto) |
140 (TP) |
300 (FP) |
460 (TP + FP) Totale positivi previsti |
|
Legittima prevista (Negativo previsto) |
60 (FN) |
9500 (TN) |
9540 (FN + TN) Totale negativi previsti |
|
200 (TP + FN) Totale positivi reali |
9800 (FP + TN) Totale negativi reali |
10.000 |
La sensibilità è scesa dall'80% a 140/200 = 70%. All'aumentare dei falsi negativi, la sensibilità diminuisce, e viceversa. Ciò significa che un'alta sensibilità indica un numero basso di falsi negativi.
In termini medici, un test con alta specificità identifica correttamente la maggior parte delle persone che non hanno la condizione. Nel nostro esempio di screening oncologico, un test con alta specificità assicura che chi non ha il cancro non venga informato erroneamente di averlo.
Questo illustra il trade-off tra sensibilità e specificità. Alcuni pazienti potrebbero allarmarsi quando gli viene detto che hanno il cancro quando in realtà non è così, ma chi ha davvero la malattia viene identificato correttamente. In questo caso, una specificità elevata è una metrica migliore. In un mondo imperfetto, dobbiamo prendere decisioni appropriate valutando i compromessi tra le metriche.
Una soglia diagnostica stabilisce il valore di cutoff che determina se un risultato è considerato positivo o negativo. Converte un valore continuo, come una probabilità, in un confine sì/no. In termini semplici, determina dove tracciare la linea tra risultati positivi e negativi.
La soglia è spesso impostata al 50%, o 0,50. Una probabilità superiore al 50% è considerata positiva, inferiore al 50% negativa.
Modificando le soglie si determina quali casi sono considerati positivi e quali negativi. Questo spostamento influisce sull'equilibrio tra intercettare veri positivi ed evitare falsi negativi.
Per esempio, considera un modello che restituisce la probabilità di cancro. Se la soglia è fissata a 0,3, il modello classifica molte persone come positive. Questo approccio funziona bene per lo screening perché riduce la possibilità di perdere casi.
Tuttavia, aumenta il rischio di falsi positivi. Se la soglia è 0,8, il modello classifica meno persone come positive. Questo riduce i falsi positivi ma aumenta il rischio di perdere casi reali.
Quando la soglia cambia, il modello modifica la frequenza con cui intercetta i veri positivi e con cui evita i falsi positivi. Soglie più basse aumentano la sensibilità ma riducono la specificità; soglie più alte riducono la sensibilità ma aumentano la specificità.
Una curva ROC (Receiver Operating Characteristic) è un grafico usato di frequente per confrontare le soglie di classificazione in termini di sensibilità e specificità. La curva ROC rappresenta la sensibilità in funzione di 1 - specificità. Ogni punto sulla curva rappresenta una specifica soglia. Al variare della soglia, sensibilità e specificità del modello si adeguano di conseguenza, tracciando la curva ROC.
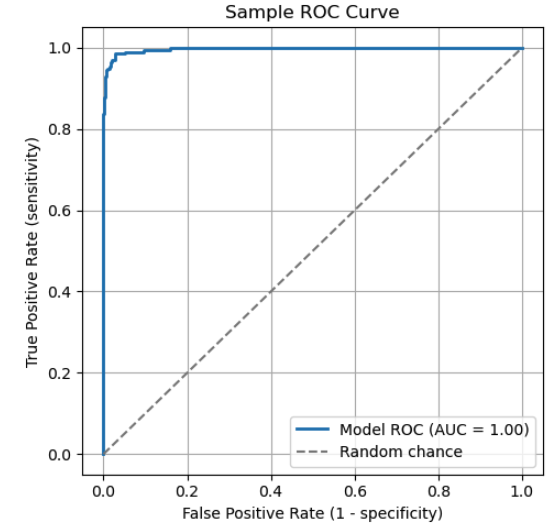
La curva ROC illustra il trade-off tra sensibilità e specificità. Punti chiave sulla curva:
La linea tratteggiata diagonale rappresenta il caso casuale. Un modello che si comporta su questa linea non ha reale potere discriminante.
Per valutare un modello tramite una curva ROC, considera l'"Area Sotto la Curva" (AUC). L'AUC è l'area totale (integrale) sotto la curva e rappresenta una media pesata delle prestazioni su tutte le soglie. Un'AUC più alta indica una migliore capacità complessiva di distinguere tra classi positive e negative.
|
Punteggio AUC |
Interpretazione |
|
1,0 |
Classificatore perfetto |
|
0,9 - 1,0 |
Eccellente |
|
0,8 - 0,9 |
Buono |
|
0,7 - 0,8 |
Discreto |
|
0,6 - 0,7 |
Scarso |
|
0,5 |
Nessuna discriminazione (equivalente al caso casuale) |
|
< 0,5 |
Peggio del caso casuale |
Valori predittivi e rapporti di verosimiglianza
In questa sezione esploriamo come la prevalenza influenzi l'affidabilità dei risultati dei test. Vediamo anche come i rapporti di verosimiglianza combinino sensibilità e specificità in un unico numero che consente ai clinici di aggiornare le probabilità diagnostiche dopo il test.
Il Valore Predittivo Positivo (PPV), matematicamente equivalente alla precision in machine learning, riflette quanto è probabile che una previsione positiva sia corretta. Misura la proporzione di positivi previsti che sono veri positivi: PPV = TP / (TP + FP).
Il Valore Predittivo Negativo (NPV) riflette l'affidabilità di un risultato negativo. Misura la proporzione di risultati negativi che sono veri negativi. La formula è NPV = TN / (TN + FN).
Supponiamo di testare 1000 persone per una malattia con questa matrice di confusione.
|
Positivi reali (malati) |
Negativi reali (sani) |
||
|
Positivi previsti (malati) |
80 (TP) |
20 (FP) |
100 |
|
Negativi previsti (sani) |
10 (FN) |
890 (TN) |
900 |
|
90 |
910 |
1000 |
Per confronto, supponi che più persone siano malate (300 invece di 90) e adatta di conseguenza la matrice di confusione.
|
Positivi reali (malati) |
Negativi reali (sani) |
||
|
Positivi previsti (malati) |
270 (TP) |
70 (FP) |
340 |
|
Negativi previsti (sani) |
30 (FN) |
630 (TN) |
660 |
|
300 |
700 |
1000 |
All'aumentare della prevalenza, cresce il numero di veri positivi.
I rapporti di verosimiglianza combinano sensibilità e specificità in un unico valore che aiuta i clinici ad aggiornare la fiducia in una diagnosi in base ai risultati del test.
Prima di applicare i rapporti di verosimiglianza, è importante distinguere tra probabilità e odds. La probabilità è la possibilità che un evento si verifichi, espressa da un valore tra 0 e 1. Le odds rappresentano quanto è probabile che un evento accada rispetto al non accadere.
Una probabilità del 75% significa che l'evento si verifica 75 volte su 100. Le odds corrispondenti sono 0,75 / (1 - 0,75) = 0,75 / 0,25 = 3. Significa odds di 3 a 1 a favore che l'evento accada.
Più in generale, se p è la probabilità di un evento, allora odds = p / (1 - p). Convertendo dalle odds alla probabilità, p = odds / (1 + odds).
Il rapporto di verosimiglianza positivo (LR+) indica di quanto un risultato positivo aumenta le odds di avere la condizione rispetto a chi non ce l'ha. Valori più alti (>10) suggeriscono che il test è molto efficace per confermare la condizione. La formula è LR+ = Sensibilità / (1 - Specificità).
Il rapporto di verosimiglianza negativo (LR-) indica di quanto un risultato negativo riduce le odds di avere la condizione rispetto a chi non ce l'ha. Valori più bassi (< 0,1) suggeriscono che il test è molto efficace per escludere una condizione. La formula è LR- = (1 - Sensibilità) / Specificità.
Per prendere decisioni, i clinici partono da una probabilità pre-test stimata in base a fattori come sintomi e storia del paziente. Questa stima viene combinata con il rapporto di verosimiglianza per calcolare la probabilità post-test.
La procedura è la seguente.
Per esempio, supponi che la probabilità pre-test di malattia sia del 30% e LR+ = 10. Qual è la probabilità post-test?
Vediamo che LR+ ha spostato significativamente la probabilità e la fiducia nella diagnosi.
Con l'aumentare della complessità dei test diagnostici e dei sistemi di classificazione, emergono nuove metodologie per superare i limiti tradizionali di prestazione. In questa sezione esploriamo come gli approcci bayesiani consentano soglie decisionali personalizzate e come tecnologie innovative come le diagnosi basate su CRISPR stiano spingendo i confini della sensibilità e specificità analitica.
L'idea di partire da una credenza a priori e aggiornarla in base a nuove informazioni è al centro della statistica bayesiana. Fornisce un modo formale per rivedere le probabilità alla luce di nuovi dati.
Il ragionamento bayesiano si basa su tre componenti chiave.
Questo è descritto matematicamente dal teorema di Bayes.
P(A|B) = P(B|A) x P(A) / P(B)
dove P(A|B) è la posteriore (la probabilità di A dato B), P(B|A) è la verosimiglianza (la probabilità di B dato che A è vero), P(A) è la prior e P(B) è l'evidenza.
Come abbiamo visto, i modelli di classificazione tradizionali applicano spesso una soglia fissa, ad esempio 0,5, per decidere se un output debba essere etichettato come positivo o negativo. Gli approcci bayesiani, invece, consentono di adattare queste soglie in base al contesto, inclusi fattori di rischio individuali, demografia, storia comportamentale o dati in tempo reale. Questa flessibilità permette di regolare dinamicamente le soglie, invece di affidarsi a un'unica soglia statica valida per tutti.
Considera un modello che predice la probabilità di malattia cardiaca. Un modello tradizionale potrebbe usare una soglia di 0,5. I pazienti con probabilità superiore al 50% sono considerati positivi, gli altri negativi.
Ora considera un approccio bayesiano con due pazienti ipotetici:
Entrambi ricevono una probabilità generata dal test pari a 0,45. Un modello a soglia fissa di 0,5 tratterebbe entrambi come negativi.
Un modello bayesiano, però, incorpora le informazioni di rischio a priori e può essere usato insieme a intervalli di previsione. Per il paziente A il sistema può abbassare la soglia decisionale, segnalando il caso per ulteriori valutazioni. Per il paziente B può mantenere la soglia e non raccomandare follow-up.
In questo modo, i metodi bayesiani adattano la soglia di classificazione al contesto di ciascun paziente, portando a decisioni più appropriate dal punto di vista clinico.
Una tecnologia emergente che spinge i limiti della sensibilità e specificità analitica è la diagnostica basata su CRISPR. Gli scienziati hanno adattato CRISPR (Clustered Regularly Interspaced Short Palindromic Repeats), uno strumento di editing genetico, per rilevare materiale genetico. Utilizza proteine Cas per rilevare specifiche sequenze di acidi nucleici con alta sensibilità.
Gli assay basati su CRISPR sono stati usati per la diagnosi precoce del cancro. Sono in sviluppo strumenti diagnostici oncologici portatili per l'uso in ambito clinico. Due importanti piattaforme diagnostiche sono SHERLOCK e DETECTR.
Gli assay basati su CRISPR offrono molti vantaggi. Hanno alta sensibilità, quindi possono rilevare quantità minime di DNA o RNA.
Questo li rende utili per identificare infezioni in fase iniziale, cancro o mutazioni rare. Offrono anche un'eccezionale specificità, permettendo di distinguere tra sequenze genetiche strettamente correlate per ridurre i falsi positivi. Ulteriori vantaggi includono risultati rapidi e apparecchiature portatili a basso costo.
Questi assay supportano un'ampia gamma di applicazioni, tra cui rilevamento di malattie infettive, diagnostica oncologica e screening di malattie genetiche. I ricercatori possono usare il machine learning per ottimizzare il design degli RNA guida e migliorare l'accuratezza diagnostica.
Gli assay basati su CRISPR presentano anche sfide. La maggior parte fornisce solo un risultato binario (positivo o negativo). Standardizzazione e riproducibilità restano criticità, poiché i risultati variano tra laboratori e condizioni di test.
Inoltre, questi assay devono soddisfare requisiti normativi, inclusi approvazioni FDA e CLIA, che richiedono ampia validazione, documentazione e revisioni. Infine, questioni di proprietà intellettuale complicano le licenze e rallentano la commercializzazione.
Sensibilità e specificità svolgono un ruolo centrale nella valutazione di test diagnostici e modelli di classificazione. Possono essere più informative dell'accuratezza, soprattutto con dataset sbilanciati o quando falsi positivi e falsi negativi hanno costi diversi. Insieme a strumenti correlati come rapporti di verosimiglianza e analisi ROC, guidano un'interpretazione più consapevole e decisioni migliori.
Vuoi approfondire le tue competenze pratiche nella valutazione delle prestazioni di un modello? Esplora queste risorse DataCamp:
I migliori corsi DataCamp
Programma
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



