
Program
Dasar-Dasar Pembelajaran Mesin dalam Python
16 jam
Praktisi machine learning harus mengevaluasi baik kualitas data mereka maupun kinerja model prediktif mereka.
Berbagai metrik dapat membantu, khususnya saat menangani tugas klasifikasi biner; yaitu ketika setiap titik data diprediksi masuk ke salah satu dari dua kategori yang mungkin. Contohnya termasuk persetujuan kredit (setujui/jangan setujui), klasifikasi malware (berbahaya/tidak berbahaya), penyaringan CV (masukkan daftar pendek/jangan masukkan daftar pendek), dan diagnosis penyakit (memiliki penyakit/tidak memiliki penyakit). Bahkan uji A/B sangat terkait, pada dasarnya menanyakan, "Apakah versi B lebih baik daripada versi A?" (ya/tidak).
Walaupun akurasi memberi ringkasan cepat tentang kinerja, metrik ini bisa menyembunyikan informasi penting mengenai sifat kesalahan model. Misalnya, detektor penipuan kartu kredit yang memberi label setiap transaksi sebagai sah mungkin mencapai akurasi 99%, namun sama sekali gagal mendeteksi penipuan aktual. Sensitivitas dan spesifisitas menawarkan wawasan yang lebih bernuansa, membantu Anda memahami tidak hanya seberapa sering model benar, tetapi juga jenis kesalahan apa yang dibuat dan apakah kesalahan tersebut dapat diterima dalam konteksnya.
Dalam panduan ini, Anda akan mempelajari apa arti sebenarnya dari sensitivitas dan spesifisitas, kapan masing-masing metrik paling tepat digunakan, bagaimana cara menghitungnya, dan bagaimana menerapkannya secara praktis dalam pekerjaan Anda melalui contoh nyata yang jelas.
Sensitivitas dan spesifisitas berasal dari evaluasi medis. Membingkai metrik ini melalui lensa pengujian diagnostik dan pengambilan keputusan klinis membantu memperjelas banyak konsep dalam artikel ini. Untuk mengilustrasikan, kami akan menggunakan dua contoh berkelanjutan, deteksi penyakit dan penipuan kartu kredit.
Artikel ini ditujukan bagi praktisi data yang menggunakan inferensi statistik dan ingin memahami metrik yang lebih bernuansa daripada akurasi untuk pengambilan keputusan yang lebih baik. Metrik ini membantu mengevaluasi jenis kesalahan yang dibuat model dan apakah kesalahan tersebut dapat diterima dalam konteksnya. Aplikasinya mencakup diagnosis medis dan deteksi penipuan, seperti yang telah kita lihat. Aplikasi lainnya termasuk deteksi intrusi, pengendalian kualitas dalam manufaktur, dan penyaringan spam.
Sebelum menafsirkan atau menerapkan sensitivitas dan spesifisitas, penting untuk memahami konsep dasar di baliknya. Pada bagian ini, kita membahas asal-usul historis, definisi inti, turunan, dan perhitungannya.
Konsep sensitivitas dan spesifisitas berakar dari biostatistika. Meskipun digunakan lebih awal dalam literatur medis, peneliti biostatistika Jacob Yerushlamy mempopulerkan istilah tersebut dalam makalahnya "Statistical Problems in Assessing Methods of Medical Diagnosis, with Special Reference to X-Ray Techniques."
Pada 1970-an, kurva receiver operating characteristic (ROC) (yang akan dibahas nanti) menjadi alat untuk menganalisis secara visual sensitivitas versus spesifisitas dalam pengujian klinis. Pada 1990-an, machine learning mengadaptasi konsep-konsep ini. Saat ini, istilah tersebut digunakan luas di layanan kesehatan dan machine learning untuk mengukur sebaik apa sistem mengidentifikasi true positive dan true negative.
Misalkan sebuah model machine learning digunakan untuk mendeteksi transaksi kartu kredit yang curang. Dari sampel 10.000 transaksi, terdapat 9.800 transaksi sah dan 200 kasus penipuan.
Karena kita terutama tertarik pada kasus penipuan, mari tetapkan kasus penipuan sebagai positif, dan kasus non-penipuan sebagai negatif. (Kasus mana yang ditetapkan sebagai "positif" dan "negatif" agak arbitrer; namun biasanya ada cara yang jelas untuk memberi label pada kasus.)
Setelah menjalankan model dan membandingkan kasus penipuan yang diprediksi dengan kasus penipuan aktual, kita menemukan bahwa 160 kasus penipuan ditandai dengan benar, 9.500 transaksi sah diidentifikasi dengan benar, 300 transaksi sah secara keliru ditandai sebagai penipuan, dan 40 kasus penipuan luput dari model.
Untuk menjaga semua data ini tetap jelas, nomenklatur berikut umumnya digunakan.
Huruf kedua (P atau N) merujuk pada apakah kasus diprediksi positif atau negatif, dan huruf pertama menunjukkan apakah prediksi tersebut benar (T) atau salah (F).
Jadi, "false positive" menunjukkan bahwa kasus diprediksi positif, dan prediksi itu salah, atau dengan kata lain, kasus diprediksi positif tetapi sebenarnya negatif. Demikian pula, false negative adalah kasus yang diprediksi negatif, tetapi sebenarnya positif.
Untuk menampilkan informasi ini, kita biasanya menggunakan "confusion matrix," dinamakan demikian karena matriks ini mencatat seberapa sering model mengacaukan prediksi yang salah dengan hasil sebenarnya (FN, FP). Berikut contohnya:
|
Penipuan Aktual (Positif) |
Sah Aktual (Negatif) |
|
|
Diprediksi Penipuan (Diprediksi Positif) |
160 (TP) |
300 (FP) |
|
Diprediksi Sah (Diprediksi Negatif) |
40 (FN) |
9500 (TN) |
Sekarang, mari kita lihat total baris dan kolom. Penjumlahan baris menunjukkan total kasus yang diprediksi dan penjumlahan kolom menunjukkan total aktual.
|
Penipuan Aktual (Positif) |
Sah Aktual (Negatif) |
||
|
Diprediksi Penipuan (Diprediksi Positif) |
160 (TP) |
300 (FP) |
460 (TP + FP) Total diprediksi positif |
|
Diprediksi Sah (Diprediksi Negatif) |
40 (FN) |
9500 (TN) |
9540 (FN + TN)Total diprediksi negatif |
|
200 (TP + FN)Total aktual positif |
9800 (FP + TN)Total aktual negatif |
10.000 |
Apa yang diwakili oleh total ini?
Sensitivitas (juga dikenal sebagai true positive rate, atau recall) mengukur kemampuan model untuk mengidentifikasi true positive dengan benar. Lebih tepatnya, sensitivitas adalah proporsi true positive terhadap actual positive, TP / (TP + FN).
Serupa, spesifisitas (true negative rate) mengukur kemampuan model untuk mengidentifikasi true negative. Ini adalah proporsi true negative terhadap actual negative, TN / (FP + TN).
Dari sudut pandang probabilistik, sensitivitas adalah probabilitas hasil tes positif dengan syarat pasien memiliki penyakit, dan spesifisitas adalah probabilitas hasil tes negatif dengan syarat pasien tidak memiliki penyakit.
Dalam contoh penipuan kita, sensitivitas = TP / (TP + FN) = 160/200, atau 80%. Spesifisitas adalah 9500/9800, atau sekitar 97%.
Saat ambang model berubah, sensitivitas dan spesifisitas sering bergerak berlawanan arah. Meningkatkan sensitivitas biasanya mengurangi spesifisitas, dan sebaliknya. Pada bagian ini, kita mengeksplorasi pertukaran bawaan ini dan membahas bagaimana analisis Receiver Operating Characteristic (ROC) memberikan pendekatan visual dan kuantitatif untuk mengevaluasi kinerja model di berbagai ambang.
Mari kita ubah contoh penipuan sehingga terdapat 20 false negative lebih banyak, FN = 60. Karena total jumlah kasus penipuan aktual masih 200, kini harus ada 20 true positive lebih sedikit (TP = 140).
|
Penipuan Aktual (Positif) |
Sah Aktual (Negatif) |
||
|
Diprediksi Penipuan (Diprediksi Positif) |
140 (TP) |
300 (FP) |
460 (TP + FP) Total diprediksi positif |
|
Diprediksi Sah (Diprediksi Negatif) |
60 (FN) |
9500 (TN) |
9540 (FN + TN)Total diprediksi negatif |
|
200 (TP + FN)Total aktual positif |
9800 (FP + TN)Total aktual negatif |
10.000 |
Sensitivitas turun dari 80% menjadi 140/200 = 70%. Saat jumlah false negative naik, sensitivitas turun, dan sebaliknya. Ini berarti sensitivitas tinggi menunjukkan jumlah false negative rendah.
Dalam istilah medis, tes dengan spesifisitas tinggi mengidentifikasi dengan benar sebagian besar orang yang tidak memiliki kondisi tersebut. Dalam contoh skrining kanker, tes dengan spesifisitas tinggi memastikan orang yang tidak memiliki kanker tidak diberi tahu secara keliru bahwa mereka memilikinya.
Ini menggambarkan pertukaran antara sensitivitas dan spesifisitas. Beberapa pasien mungkin cemas ketika diberi tahu bahwa mereka mengidap kanker padahal sebenarnya tidak, tetapi orang yang benar-benar mengidap penyakit tersebut diidentifikasi dengan benar. Dalam kasus ini, spesifisitas tinggi adalah metrik yang lebih baik. Di dunia yang tidak sempurna, kita harus membuat keputusan yang tepat berdasarkan evaluasi pertukaran antar metrik.
Ambang diagnostik menetapkan nilai batas yang menentukan apakah suatu hasil tes dianggap positif atau negatif. Ambang ini mengubah nilai kontinu, seperti probabilitas, menjadi batas ya/tidak. Dalam istilah sehari-hari, ambang menentukan di mana menarik garis antara hasil positif atau negatif.
Ambang sering ditetapkan pada 50%, atau 0,50. Probabilitas di atas 50% dianggap positif, dan yang kurang dari 50% dianggap negatif.
Mengubah ambang menentukan kasus mana yang dianggap positif dan negatif. Pergeseran ini memengaruhi keseimbangan antara menangkap true positive dan menghindari false negative.
Misalnya, pertimbangkan model yang menghasilkan probabilitas kanker. Jika ambang ditetapkan pada 0,3, model mengklasifikasikan banyak orang sebagai positif. Pendekatan ini cocok untuk skrining karena mengurangi kemungkinan melewatkan kasus.
Namun, hal ini meningkatkan risiko false positive. Jika ambang 0,8, model mengklasifikasikan lebih sedikit orang sebagai positif. Pendekatan ini mengurangi false positive tetapi meningkatkan risiko melewatkan kasus sebenarnya.
Ketika ambang berubah, model mengubah seberapa sering ia menangkap true positive dan seberapa sering ia menghindari false positive. Ambang yang lebih rendah meningkatkan sensitivitas namun mengurangi spesifisitas; ambang yang lebih tinggi menurunkan sensitivitas namun meningkatkan spesifisitas.
Sebuah kurva Receiver Operating Characteristic (ROC) adalah visual umum untuk membandingkan ambang klasifikasi di sepanjang nilai sensitivitas dan spesifisitas. Kurva ROC memplot sensitivitas terhadap 1 - spesifisitas. Setiap titik pada kurva merepresentasikan ambang tertentu. Saat ambang berubah, sensitivitas dan spesifisitas model menyesuaikan, membentuk jejak kurva ROC.
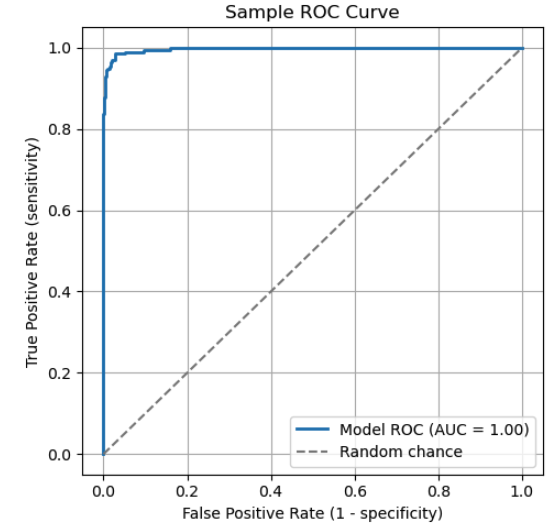
Kurva ROC menggambarkan pertukaran antara sensitivitas dan spesifisitas. Titik-titik kunci pada kurva:
Garis putus-putus diagonal mewakili peluang acak. Model yang berkinerja di sepanjang garis ini tidak memiliki daya diskriminatif nyata.
Untuk mengevaluasi model menggunakan kurva ROC, pertimbangkan "Area Under the Curve" (AUC). AUC adalah total area (integral) di bawah kurva, yang merepresentasikan rata-rata berbobot kinerja di semua ambang. AUC yang lebih tinggi menunjukkan kemampuan keseluruhan yang lebih baik untuk membedakan antara kelas positif dan negatif.
|
Skor AUC |
Interpretasi |
|
1,0 |
Klasifier sempurna |
|
0,9 - 1,0 |
Sangat baik |
|
0,8 - 0,9 |
Baik |
|
0,7 - 0,8 |
Cukup |
|
0,6 - 0,7 |
Kurang |
|
0,5 |
Tidak ada diskriminasi (setara dengan menebak acak) |
|
< 0,5 |
Lebih buruk dari acak |
Nilai Prediktif dan Rasio Likelihood
Pada bagian ini, kita mengeksplorasi bagaimana prevalensi memengaruhi keandalan hasil tes. Kita juga melihat bagaimana rasio likelihood menggabungkan sensitivitas dan spesifisitas ke dalam satu angka yang memungkinkan klinisi memperbarui probabilitas diagnostik setelah pengujian.
Positive Predictive Value (PPV), yang secara matematis setara dengan precision dalam machine learning, mencerminkan seberapa besar kemungkinan prediksi positif itu benar. Ini mengukur proporsi prediksi positif yang merupakan true positive: PPV = TP / (TP + FP).
Negative Predictive Value (NPV) mencerminkan keandalan hasil negatif. Ini mengukur proporsi hasil tes negatif yang merupakan true negative. Rumusnya adalah NPV = TN / (TN + FN).
Misalkan kita menguji 1.000 orang untuk suatu penyakit dengan confusion matrix berikut.
|
Aktual Positif (sakit) |
Aktual Negatif (sehat) |
||
|
Diprediksi Positif (sakit) |
80 (TP) |
20 (FP) |
100 |
|
Diprediksi Negatif (sehat) |
10 (FN) |
890 (TN) |
900 |
|
90 |
910 |
1000 |
Sebagai perbandingan, anggap lebih banyak orang yang sakit (300 alih-alih 90), dan sesuaikan confusion matrix-nya.
|
Aktual Positif (sakit) |
Aktual Negatif (sehat) |
||
|
Diprediksi Positif (sakit) |
270 (TP) |
70 (FP) |
340 |
|
Diprediksi Negatif (sehat) |
30 (FN) |
630 (TN) |
660 |
|
300 |
700 |
1000 |
Saat prevalensi meningkat, jumlah kasus true positive naik.
Rasio likelihood menggabungkan sensitivitas dan spesifisitas menjadi satu angka yang membantu klinisi memperbarui keyakinan mereka terhadap diagnosis berdasarkan hasil tes.
Sebelum menerapkan rasio likelihood, penting untuk membedakan antara probabilitas dan odds. Probabilitas adalah peluang suatu peristiwa akan terjadi, diekspresikan dengan nilai antara 0 dan 1. Odds mewakili seberapa mungkin suatu peristiwa terjadi relatif terhadap tidak terjadinya.
Probabilitas 75% berarti peristiwa terjadi 75 kali dari 100. Odds yang bersesuaian adalah 0,75 / (1 - 0,75) = 0,75 / .025 = 3. Ini berarti odds-nya 3 banding 1 mendukung terjadinya peristiwa tersebut.
Secara umum, jika p adalah probabilitas suatu peristiwa, maka odds = p / (1 - p). Mengonversi dari odds ke probabilitas, p = odds / (1 + odds).
Rasio likelihood positif (LR+) memberi tahu seberapa besar hasil positif meningkatkan odds memiliki kondisi tersebut dibandingkan seseorang yang tidak memilikinya. Nilai yang lebih tinggi (>10) menunjukkan tes sangat efektif untuk menegakkan kondisi. Rumusnya adalah LR+ = Sensitivitas / (1 - Spesifisitas).
Rasio likelihood negatif (LR-) memberi tahu seberapa besar hasil negatif menurunkan odds memiliki kondisi tersebut dibandingkan seseorang yang tidak memilikinya. Nilai yang lebih rendah (< 0,1) menunjukkan tes sangat efektif untuk menyingkirkan suatu kondisi. Rumusnya adalah LR- = (1 - Sensitivitas) / Spesifisitas.
Untuk membuat keputusan, klinisi memulai dengan probabilitas prates yang diestimasi berdasarkan faktor-faktor seperti gejala dan riwayat pasien. Estimasi ini digabungkan dengan rasio likelihood untuk menghitung probabilitas pascates.
Prosedurnya sebagai berikut.
Sebagai contoh, misalkan probabilitas prates penyakit adalah 30% dan LR+ = 10. Berapa probabilitas pascatesnya?
Kita melihat bahwa LR+ secara signifikan menggeser probabilitas dan keyakinan dalam diagnosis.
Seiring pengujian diagnostik dan sistem klasifikasi menjadi lebih kompleks, metodologi baru bermunculan untuk melampaui batas kinerja tradisional. Pada bagian ini, kita mengeksplorasi bagaimana pendekatan Bayesian memungkinkan ambang keputusan yang dipersonalisasi dan bagaimana teknologi baru seperti diagnostik berbasis CRISPR mendorong batas sensitivitas dan spesifisitas analitik.
Gagasan memulai dengan keyakinan awal dan memperbaruinya berdasarkan informasi baru merupakan inti dari statistika Bayesian. Ini menyediakan cara formal untuk merevisi probabilitas berdasarkan data baru.
Penalaran Bayesian bergantung pada tiga komponen kunci.
Hal ini dijelaskan secara matematis oleh teorema Bayes.
P(A|B) = P(B|A) x P(A) / P(B)
di mana P(A|B) adalah posterior (probabilitas A dengan syarat B), P(B|A) adalah likelihood (probabilitas B dengan syarat A benar), P(A) adalah prior, dan P(B) adalah bukti.
Seperti yang telah kita lihat, model klasifikasi tradisional sering menerapkan ambang tetap, seperti 0,5, untuk menentukan apakah keluaran harus diberi label positif atau negatif. Sebaliknya, pendekatan Bayesian memungkinkan ambang ini beradaptasi berdasarkan konteks, termasuk faktor risiko individu, demografi, riwayat perilaku, atau data waktu nyata. Fleksibilitas ini memungkinkan sistem menyesuaikan ambang secara dinamis, alih-alih mengandalkan ambang statis yang sama untuk semua.
Pertimbangkan model yang memprediksi kemungkinan penyakit jantung. Model tradisional mungkin menggunakan ambang 0,5. Pasien dengan probabilitas di atas 50% dianggap positif, dan yang di bawah dianggap negatif.
Sekarang, pertimbangkan pendekatan Bayesian dengan dua pasien hipotetis:
Kedua pasien menerima probabilitas hasil tes sebesar 0,45. Model ambang tetap dengan ambang 0,5 akan memperlakukan keduanya sebagai negatif.
Namun, model Bayesian menggabungkan informasi risiko prior dan dapat digunakan bersama dengan interval prediksi. Untuk pasien A, sistem dapat menurunkan ambang keputusan, menandai kasus untuk evaluasi lanjutan. Untuk pasien B, sistem dapat mempertahankan ambang, dan tidak ada tindak lanjut yang direkomendasikan.
Dengan cara ini, metode Bayesian menyesuaikan ambang klasifikasi dengan konteks masing-masing pasien, menghasilkan keputusan yang lebih tepat secara klinis.
Teknologi yang muncul dan mendorong batas sensitivitas serta spesifisitas analitik adalah diagnostik berbasis CRISPR. Ilmuwan mengadaptasi CRISPR (Clustered Regularly Interspaced Short Palindromic Repeats), alat penyunting gen, untuk mendeteksi materi genetik. Teknologi ini memanfaatkan protein Cas untuk mendeteksi sekuens asam nukleat tertentu dengan sensitivitas tinggi.
Asai berbasis CRISPR telah digunakan untuk deteksi dini kanker. Alat diagnostik kanker portabel sedang dikembangkan untuk digunakan di lingkungan klinis. Dua platform diagnostik penting adalah SHERLOCK dan DETECTR.
Asai berbasis CRISPR menawarkan banyak keunggulan. Asai ini memberikan sensitivitas tinggi, sehingga dapat mendeteksi sejumlah kecil DNA atau RNA.
Hal ini membuatnya berharga untuk mengidentifikasi infeksi tahap awal, kanker, atau mutasi langka. Asai ini juga menawarkan spesifisitas yang luar biasa, memungkinkannya membedakan antara sekuens genetik yang sangat mirip untuk mengurangi false positive. Manfaat tambahan termasuk hasil yang cepat serta peralatan berbiaya rendah dan portabel.
Asai ini mendukung berbagai aplikasi, termasuk deteksi penyakit menular, diagnostik kanker, dan skrining penyakit genetik. Peneliti dapat menggunakan machine learning untuk mengoptimalkan desain RNA pemandu (guide RNA) dan meningkatkan akurasi diagnostik.
Asai berbasis CRISPR juga menghadapi tantangan. Sebagian besar hanya memberikan hasil biner (positif atau negatif). Standardisasi dan reproduktibilitas tetap menjadi perhatian, karena hasil bervariasi antar laboratorium dan kondisi pengujian.
Selain itu, asai ini harus memenuhi persyaratan regulasi, termasuk persetujuan FDA dan CLIA, yang memerlukan validasi, dokumentasi, dan tinjauan ekstensif. Terakhir, isu HKI mempersulit perizinan dan memperlambat komersialisasi.
Sensitivitas dan spesifisitas memainkan peran sentral dalam mengevaluasi tes diagnostik dan model klasifikasi. Keduanya bisa lebih informatif daripada akurasi, terutama pada himpunan data yang tidak seimbang atau ketika false positive atau false negative memiliki biaya yang berbeda. Bersama dengan alat terkait seperti rasio likelihood dan analisis ROC, metrik ini memandu interpretasi yang lebih tajam dan pengambilan keputusan yang lebih baik.
Ingin memperdalam keterampilan praktis Anda dalam mengevaluasi kinerja model? Pastikan untuk menjelajahi sumber daya DataCamp berikut:
Kursus Teratas DataCamp
Program
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt



