Người làm machine learning cần đánh giá cả chất lượng dữ liệu và hiệu năng của mô hình dự đoán.
Nhiều thước đo có thể hỗ trợ, đặc biệt khi xử lý bài toán phân loại nhị phân; trong đó mỗi điểm dữ liệu được dự đoán thuộc một trong hai nhóm. Ví dụ gồm phê duyệt tín dụng (duyệt/không duyệt), phân loại malware (độc hại/không độc hại), sàng lọc hồ sơ (vào danh sách rút gọn/không vào), và chẩn đoán bệnh (có bệnh/không có bệnh). Ngay cả thử nghiệm A/B cũng liên quan chặt chẽ, về bản chất là hỏi: "Phiên bản B có tốt hơn phiên bản A không?" (có/không).
Mặc dù độ chính xác cho cái nhìn nhanh về hiệu năng, nó có thể che khuất thông tin quan trọng về bản chất lỗi của mô hình. Chẳng hạn, một bộ phát hiện gian lận thẻ tín dụng gán mọi giao dịch là hợp lệ có thể đạt 99% độ chính xác, nhưng hoàn toàn bỏ sót gian lận thực. Độ nhạy và độ đặc hiệu cung cấp góc nhìn tinh tế hơn, giúp bạn hiểu không chỉ mức độ đúng của mô hình, mà còn kiểu lỗi nó mắc phải và liệu các lỗi đó có chấp nhận được trong ngữ cảnh hay không.
Trong hướng dẫn này, bạn sẽ học ý nghĩa thực sự của độ nhạy và độ đặc hiệu, khi nào mỗi chỉ số phù hợp nhất, cách tính toán, và cách áp dụng vào công việc qua các ví dụ rõ ràng, sát thực tế.
Xét nghiệm chẩn đoán và ra quyết định lâm sàng
Độ nhạy và độ đặc hiệu bắt nguồn từ đánh giá y khoa. Xem các chỉ số này qua lăng kính xét nghiệm chẩn đoán và ra quyết định lâm sàng giúp làm rõ nhiều khái niệm trong bài. Để minh họa, chúng ta sẽ dùng hai ví dụ xuyên suốt: phát hiện bệnh và gian lận thẻ tín dụng.
- Xét nghiệm chẩn đoán là thủ thuật y khoa dùng để xác nhận hoặc loại trừ một bệnh.
- Xét nghiệm định tính/định lượng (assay) đo xem một chất nào đó có hiện diện trong mẫu hay không.
- Ra quyết định lâm sàng là quá trình nhân viên y tế thu thập thông tin về bệnh nhân, cân nhắc các lựa chọn chẩn đoán và điều trị, rồi đưa ra quyết định dựa trên bằng chứng.
Đối tượng độc giả
Bài viết dành cho người làm dữ liệu sử dụng suy luận thống kê và muốn hiểu các thước đo tinh tế hơn độ chính xác để ra quyết định tốt hơn. Các chỉ số này giúp đánh giá mô hình mắc lỗi gì và liệu những lỗi đó có chấp nhận được trong bối cảnh hay không. Ứng dụng bao gồm chẩn đoán y khoa và phát hiện gian lận như đã nêu. Ứng dụng khác: phát hiện xâm nhập, kiểm soát chất lượng trong sản xuất, và lọc thư rác.
Các khái niệm nền tảng về độ nhạy và độ đặc hiệu
Trước khi diễn giải hay áp dụng độ nhạy và độ đặc hiệu, cần hiểu các khái niệm cơ bản đằng sau chúng. Phần này bàn về nguồn gốc lịch sử, định nghĩa cốt lõi, suy dẫn và cách tính.
Lịch sử
Các khái niệm độ nhạy và độ đặc hiệu có nguồn gốc trong thống kê sinh học. Dù đã được dùng sớm hơn trong y văn, nhà nghiên cứu thống kê sinh học Jacob Yerushlamy đã phổ biến thuật ngữ này trong bài báo "Statistical Problems in Assessing Methods of Medical Diagnosis, with Special Reference to X-Ray Techniques."
Vào thập niên 1970, đường cong ROC (sẽ mô tả sau) trở thành công cụ trực quan để phân tích độ nhạy so với độ đặc hiệu trong xét nghiệm lâm sàng. Thập niên 1990, machine learning tiếp nhận các khái niệm này. Ngày nay, thuật ngữ được dùng rộng rãi trong y tế và machine learning để đo lường mức độ hệ thống nhận diện đúng dương tính và âm tính.
Ma trận nhầm lẫn
Giả sử một mô hình machine learning dùng để phát hiện giao dịch thẻ tín dụng gian lận. Trong mẫu 10.000 giao dịch, có 9.800 giao dịch hợp lệ và 200 trường hợp gian lận.
Vì chúng ta quan tâm chủ yếu đến gian lận, hãy gán trường hợp gian lận là dương tính, và không gian lận là âm tính. (Việc gán "dương tính" hay "âm tính" phần nào tùy ý; tuy nhiên, thường có cách gán hiển nhiên.)
Sau khi chạy mô hình và so sánh dự đoán gian lận với gian lận thực, ta thấy 160 trường hợp gian lận được gắn cờ đúng, 9.500 giao dịch hợp lệ được nhận diện đúng, 300 giao dịch hợp lệ bị gắn nhầm là gian lận, và 40 trường hợp gian lận bị mô hình bỏ sót.
Để theo dõi dữ liệu này, người ta thường dùng danh pháp sau.
- Dương tính thật (TP): 160 trường hợp gian lận được gắn cờ đúng,
- Âm tính thật (TN): 9.500 giao dịch hợp lệ được nhận diện đúng,
- Dương tính giả (FP): 300 giao dịch hợp lệ bị gắn nhầm là gian lận, và
- Âm tính giả (FN): 40 trường hợp gian lận bị mô hình bỏ sót.
Chữ thứ hai (P hoặc N) chỉ trường hợp được dự đoán là dương hay âm tính, và chữ đầu tiên cho biết dự đoán đó đúng (T) hay sai (F).
Vậy, "dương tính giả" nghĩa là trường hợp được dự đoán dương tính, nhưng dự đoán đó sai, hay nói cách khác, được dự đoán dương tính nhưng thực tế là âm tính. Tương tự, âm tính giả là trường hợp dự đoán âm tính nhưng thực tế là dương tính.
Để hiển thị thông tin này, ta thường dùng "ma trận nhầm lẫn", gọi vậy vì nó theo dõi tần suất mô hình nhầm lẫn dự đoán sai với kết quả thực (FN, FP). Ví dụ như sau:
| |
Gian lận thực (Dương tính)
|
Hợp lệ thực (Âm tính)
|
|
Dự đoán gian lận (Dự đoán dương tính)
|
160 (TP)
|
300 (FP)
|
|
Dự đoán hợp lệ (Dự đoán âm tính)
|
40 (FN)
|
9500 (TN)
|
Giờ hãy xem tổng theo hàng và cột. Tổng hàng biểu thị tổng số ca dự đoán; tổng cột biểu thị tổng số ca thực tế.
| |
Gian lận thực (Dương tính)
|
Hợp lệ thực (Âm tính)
| |
|
Dự đoán gian lận (Dự đoán dương tính)
|
160 (TP)
|
300 (FP)
|
460 (TP + FP)
Tổng dương tính dự đoán
|
|
Dự đoán hợp lệ (Dự đoán âm tính)
|
60 (FN)
|
9500 (TN)
|
9540 (FN + TN)Tổng âm tính dự đoán
|
| |
200 (TP + FN)Tổng dương tính thực
|
9800 (FP + TN)Tổng âm tính thực
|
10,000
|
Các tổng này biểu thị gì?
- Tổng hàng đầu (460) là tổng số ca dự đoán gian lận (TP + FP).
- Tổng hàng thứ hai (9540) là tổng số ca dự đoán hợp lệ (FN + TN).
- Tổng cột đầu (200) là tổng số ca gian lận thực (TP + FN).
- Tổng cột thứ hai (9800) là tổng số ca hợp lệ thực (FP + TN)
- Tổng cộng (10.000) bằng kích thước mẫu của chúng ta.
Định nghĩa
Độ nhạy (còn gọi là tỷ lệ dương tính thật, hay recall) đo khả năng mô hình nhận diện đúng các dương tính. Cụ thể, độ nhạy là tỷ lệ dương tính thật trên dương tính thực, TP / (TP + FN).
Tương tự, độ đặc hiệu (tỷ lệ âm tính thật) đo khả năng mô hình nhận diện đúng các âm tính. Công thức là tỷ lệ âm tính thật trên âm tính thực, TN / (FP + TN).
Theo góc nhìn xác suất, độ nhạy là xác suất xét nghiệm dương tính khi bệnh nhân có bệnh, và độ đặc hiệu là xác suất xét nghiệm âm tính khi bệnh nhân không có bệnh.
Tính độ nhạy và độ đặc hiệu
Trong ví dụ gian lận, độ nhạy = TP / (TP + FN) = 160/200, tức 80%. Độ đặc hiệu là 9500/9800, xấp xỉ 97%.
Sự đánh đổi giữa độ nhạy - độ đặc hiệu và phân tích ROC
Khi thay đổi ngưỡng mô hình, độ nhạy và độ đặc hiệu thường biến động theo chiều ngược nhau. Tăng độ nhạy thường làm giảm độ đặc hiệu, và ngược lại. Phần này khám phá sự đánh đổi cố hữu đó và cách phân tích ROC (Receiver Operating Characteristic) cung cấp phương pháp trực quan và định lượng để đánh giá hiệu năng mô hình qua nhiều ngưỡng khác nhau.
Sự đánh đổi
Hãy chỉnh ví dụ gian lận sao cho có thêm 20 âm tính giả, FN = 60. Vì tổng số ca gian lận thực vẫn là 200, nên số dương tính thật giảm 20 (TP = 140).
| |
Gian lận thực (Dương tính)
|
Hợp lệ thực (Âm tính)
| |
|
Dự đoán gian lận (Dự đoán dương tính)
|
140 (TP)
|
300 (FP)
|
460 (TP + FP)
Tổng dương tính dự đoán
|
|
Dự đoán hợp lệ (Dự đoán âm tính)
|
60 (FN)
|
9500 (TN)
|
9540 (FN + TN)Tổng âm tính dự đoán
|
| |
200 (TP + FN)Tổng dương tính thực
|
9800 (FP + TN)Tổng âm tính thực
|
10,000
|
Độ nhạy giảm từ 80% xuống 140/200 = 70%. Khi số âm tính giả tăng, độ nhạy giảm, và ngược lại. Điều này có nghĩa độ nhạy cao cho thấy số âm tính giả thấp.
Theo y khoa, một xét nghiệm có độ đặc hiệu cao sẽ nhận diện đúng hầu hết những người không mắc bệnh. Trong ví dụ sàng lọc ung thư, xét nghiệm có độ đặc hiệu cao giúp người không mắc ung thư không bị báo nhầm là có.
Điều này minh họa sự đánh đổi giữa độ nhạy và độ đặc hiệu. Một vài bệnh nhân có thể hoang mang khi bị báo có ung thư trong khi thực tế không, nhưng những người thực sự mắc bệnh lại được nhận diện đúng. Trong trường hợp này, độ đặc hiệu cao là thước đo tốt hơn. Trong thế giới không hoàn hảo, chúng ta phải đưa ra quyết định phù hợp dựa trên đánh giá các đánh đổi giữa các chỉ số.
Động học ngưỡng
Ngưỡng chẩn đoán đặt giá trị cắt để xác định một kết quả xét nghiệm là dương hay âm tính. Nó chuyển một giá trị liên tục, như xác suất, thành mức cắt có/không. Nói đơn giản, nó xác định ranh giới giữa kết quả dương và âm.
Ngưỡng thường đặt ở 50%, hay 0,50. Xác suất trên 50% được coi là dương tính, thấp hơn 50% là âm tính.
Thay đổi ngưỡng sẽ quyết định trường hợp nào được coi là dương hay âm tính. Sự dịch chuyển này ảnh hưởng cân bằng giữa việc bắt được dương tính thật và tránh âm tính giả.
Ví dụ, xét mô hình xuất ra xác suất mắc ung thư. Nếu ngưỡng đặt ở 0,3, mô hình phân loại nhiều người là dương tính. Cách tiếp cận này phù hợp cho sàng lọc vì giảm khả năng bỏ sót ca bệnh.
Tuy nhiên, nó làm tăng nguy cơ dương tính giả. Nếu ngưỡng là 0,8, mô hình phân loại ít người là dương tính hơn. Cách này giảm dương tính giả nhưng tăng rủi ro bỏ sót ca thực.
Khi ngưỡng thay đổi, mô hình thay đổi tần suất bắt được dương tính thật và tần suất tránh được dương tính giả. Ngưỡng thấp tăng độ nhạy nhưng giảm độ đặc hiệu; ngưỡng cao giảm độ nhạy nhưng tăng độ đặc hiệu.
Diễn giải đường cong ROC
Đường cong ROC (Receiver Operating Characteristic) là hình trực quan phổ biến để so sánh các ngưỡng phân loại theo các giá trị độ nhạy và độ đặc hiệu. Đường ROC vẽ độ nhạy theo 1 - độ đặc hiệu. Mỗi điểm trên đường cong đại diện cho một ngưỡng cụ thể. Khi ngưỡng thay đổi, độ nhạy và độ đặc hiệu của mô hình điều chỉnh tương ứng, vẽ nên đường ROC.
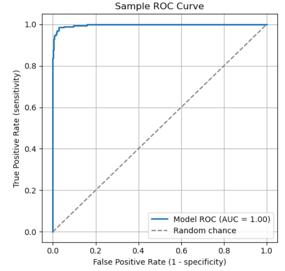
Đường ROC minh họa sự đánh đổi giữa độ nhạy và độ đặc hiệu. Các điểm chính trên đường cong:
- (0,1): Bộ phân loại hoàn hảo, nhận diện mọi dương tính thật mà không có âm tính giả.
- (0,0): Mô hình cực đoan dự đoán tất cả là âm tính, phân loại sai mọi ca dương tính.
- (1,1): Mô hình cực đoan dự đoán tất cả là dương tính, phân loại sai mọi ca âm tính.
Đường chéo nét đứt biểu thị may rủi ngẫu nhiên. Mô hình hoạt động dọc theo đường này không có sức phân biệt thực sự.
Để đánh giá mô hình bằng đường ROC, hãy xét "Diện tích dưới đường cong" (AUC). AUC là tổng diện tích (tích phân) dưới đường cong, đại diện cho trung bình có trọng số hiệu năng trên mọi ngưỡng. AUC cao hơn cho thấy khả năng phân biệt giữa lớp dương và âm tổng thể tốt hơn.
|
Điểm AUC
|
Diễn giải
|
|
1.0
|
Bộ phân loại hoàn hảo
|
|
0.9 - 1.0
|
Xuất sắc
|
|
0.8 - 0.9
|
Tốt
|
|
0.7 - 0.8
|
Khá
|
|
0.6 - 0.7
|
Kém
|
|
0.5
|
Không phân biệt (tương đương đoán ngẫu nhiên)
|
|
< 0.5
|
Tệ hơn ngẫu nhiên
|
Giá trị dự đoán và tỉ số khả dĩ
Phần này khám phá cách tỷ lệ hiện mắc ảnh hưởng đến độ tin cậy của kết quả xét nghiệm. Chúng ta cũng xem tỉ số khả dĩ kết hợp độ nhạy và độ đặc hiệu thành một con số, cho phép bác sĩ cập nhật xác suất chẩn đoán sau xét nghiệm.
Các thước đo phụ thuộc tỷ lệ hiện mắc
Giá trị dự đoán dương (PPV), về mặt toán học tương đương precision trong machine learning, phản ánh khả năng một dự đoán dương tính là đúng. Nó đo tỷ lệ dương tính thật trong các dương tính dự đoán: PPV = TP / (TP + FP).
Giá trị dự đoán âm (NPV) phản ánh độ tin cậy của kết quả âm tính. Nó đo tỷ lệ âm tính thật trong các kết quả âm tính. Công thức: NPV = TN / (TN + FN).
Giả sử ta xét nghiệm 1.000 người mắc một bệnh với ma trận nhầm lẫn sau.
| |
Dương tính thực (ốm)
|
Âm tính thực (khỏe)
| |
|
Dự đoán dương tính (ốm)
|
80 (TP)
|
20 (FP)
|
100
|
|
Dự đoán âm tính (khỏe)
|
10 (FN)
|
890 (TN)
|
900
|
| |
90
|
910
|
1000
|
- PPV = TP / (TP + FP) = 80/100 = 80%.
- NPV = TN / (FN + TN) = 890 / 900 = 98,9%.
Để so sánh, giả sử có nhiều người ốm hơn (300 thay vì 90), và điều chỉnh ma trận nhầm lẫn tương ứng.
| |
Dương tính thực (ốm)
|
Âm tính thực (khỏe)
| |
|
Dự đoán dương tính (ốm)
|
270 (TP)
|
70 (FP)
|
340
|
|
Dự đoán âm tính (khỏe)
|
30 (FN)
|
630 (TN)
|
660
|
| |
300
|
700
|
1000
|
Khi tỷ lệ hiện mắc tăng, số ca dương tính thật tăng.
- PPV cao hơn. Kết quả dương tính giờ có khả năng phản ánh bệnh thực hơn. Thực tế, PPV = 270 / 300 = 90%, so với 80% trước đó, tăng 10%.
- NPV thấp hơn. Kết quả âm tính kém tin cậy hơn đôi chút, vì có nhiều cơ hội bỏ sót ca thực. Ta thấy NPV = 630 / 700 = 90%, giảm 8,9%.
Tỉ số khả dĩ (Likelihood ratios)
Tỉ số khả dĩ kết hợp độ nhạy và độ đặc hiệu thành một con số giúp bác sĩ cập nhật mức độ tin cậy trong chẩn đoán dựa trên kết quả xét nghiệm.
Xác suất và tỷ lệ cược (odds)
Trước khi áp dụng tỉ số khả dĩ, cần phân biệt giữa xác suất và tỷ lệ cược (odds). Xác suất là khả năng một sự kiện xảy ra, biểu diễn bằng giá trị giữa 0 và 1. Tỷ lệ cược biểu thị mức khả năng sự kiện xảy ra so với không xảy ra.
Xác suất 75% nghĩa là sự kiện xảy ra 75 lần trong 100 lần. Tỷ lệ cược tương ứng là 0,75 / (1 - 0,75) = 0,75 / .025 = 3. Nghĩa là tỷ lệ cược là 3 ăn 1 nghiêng về khả năng sự kiện xảy ra.
Tổng quát, nếu p là xác suất sự kiện, thì odds = p / (1 - p). Đổi từ odds sang xác suất, p = odds / (1 + odds).
Tỉ số khả dĩ
Tỉ số khả dĩ dương (LR+) cho biết kết quả dương tính làm tăng tỷ lệ cược mắc bệnh bao nhiêu so với người không mắc. Giá trị cao (>10) gợi ý xét nghiệm rất hiệu quả để khẳng định bệnh. Công thức: LR+ = Độ nhạy / (1 - Độ đặc hiệu).
Tỉ số khả dĩ âm (LR-) cho biết kết quả âm tính làm giảm tỷ lệ cược mắc bệnh bao nhiêu so với người không mắc. Giá trị thấp (< 0,1) gợi ý xét nghiệm rất hiệu quả để loại trừ bệnh. Công thức: LR- = (1 - Độ nhạy) / Độ đặc hiệu.
Xác suất sau xét nghiệm
Để ra quyết định, bác sĩ bắt đầu với xác suất trước xét nghiệm dựa trên triệu chứng và tiền sử. Ước lượng này được kết hợp với tỉ số khả dĩ để tính xác suất sau xét nghiệm.
Quy trình như sau.
- Bắt đầu với xác suất trước xét nghiệm p.
- Chuyển sang odds. Odds trước xét nghiệm = p / (1 - p).
- Áp dụng tỉ số khả dĩ. Nếu xét nghiệm dương tính, nhân odds trước xét nghiệm với LR+; nếu âm tính, nhân với LR-. Odds sau xét nghiệm = odds trước xét nghiệm x LR.
- Chuyển odds sau xét nghiệm về xác suất. Xác suất sau xét nghiệm = Odds sau xét nghiệm / (1 + odds sau xét nghiệm).
Ví dụ, giả sử xác suất trước xét nghiệm mắc bệnh là 30% và LR+ = 10. Xác suất sau xét nghiệm là bao nhiêu?
- p = 0,3
- Odds trước xét nghiệm = 0,3/0,7 = 0,43.
- Odds sau xét nghiệm = 0,43 * 10 = 4,3
- Xác suất sau xét nghiệm = 4,3 / (1 + 4,3) = 81%.
Ta thấy LR+ đã làm thay đổi đáng kể xác suất và mức độ tin cậy chẩn đoán.
Phương pháp nâng cao và hướng đi tương lai
Khi xét nghiệm chẩn đoán và hệ thống phân loại trở nên phức tạp hơn, các phương pháp mới xuất hiện để vượt qua giới hạn hiệu năng truyền thống. Phần này khám phá cách tiếp cận Bayes cho phép cá nhân hóa ngưỡng quyết định và cách các công nghệ mới như chẩn đoán dựa trên CRISPR đang đẩy giới hạn của độ nhạy và độ đặc hiệu phân tích.
Cách tiếp cận Bayes
Ý tưởng bắt đầu với niềm tin tiên nghiệm và cập nhật nó dựa trên thông tin mới nằm ở trung tâm của thống kê Bayes. Nó cung cấp cách thức chính quy để điều chỉnh xác suất khi có dữ liệu mới.
Lý luận Bayes dựa trên ba thành phần chính.
- Xác suất tiên nghiệm (prior). Đây là niềm tin ban đầu trước khi thấy bằng chứng mới. ("Dự báo nói có 60% khả năng mưa.")
- Độ khả dĩ (likelihood). Đây là mức độ khả năng của bằng chứng mới nếu niềm tin là đúng. ("Tôi nghe tiếng mưa, nên khả dĩ của dự báo đúng là cao.")
- Xác suất hậu nghiệm (posterior). Đây là niềm tin đã điều chỉnh sau khi xét bằng chứng mới. Nó được tìm bằng cách nhân xác suất tiên nghiệm với độ khả dĩ.
Điều này được mô tả bằng định lý Bayes về mặt toán học.
P(A|B) = P(B|A) x P(A) / P(B)
trong đó P(A|B) là hậu nghiệm (xác suất A khi biết B), P(B|A) là độ khả dĩ (xác suất B khi A đúng), P(A) là tiên nghiệm, và P(B) là bằng chứng.
Tối ưu ngưỡng bằng phương pháp Bayes
Như đã thấy, các mô hình phân loại truyền thống thường áp một ngưỡng cố định, như 0,5, để quyết định đầu ra dán nhãn dương hay âm. Ngược lại, cách tiếp cận Bayes cho phép ngưỡng thích ứng theo bối cảnh, gồm yếu tố nguy cơ cá nhân, nhân khẩu học, lịch sử hành vi, hoặc dữ liệu thời gian thực. Tính linh hoạt này giúp hệ thống điều chỉnh ngưỡng động, thay vì phụ thuộc một ngưỡng tĩnh dùng cho tất cả.
Xét mô hình dự đoán khả năng mắc bệnh tim. Mô hình truyền thống có thể dùng ngưỡng 0,5. Bệnh nhân có xác suất trên 50% được coi là dương tính, thấp hơn là âm tính.
Giờ xét cách tiếp cận Bayes với hai bệnh nhân giả định:
- Bệnh nhân A 68 tuổi, hút thuốc lâu năm, có tiền sử gia đình mắc bệnh tim và vừa đau ngực.
- Bệnh nhân B 25 tuổi, không hút thuốc, không có triệu chứng hay tiền sử liên quan.
Cả hai nhận xác suất do xét nghiệm tạo ra là 0,45. Mô hình ngưỡng cố định 0,5 sẽ coi cả hai là âm tính.
Tuy nhiên, mô hình Bayes kết hợp thông tin nguy cơ tiên nghiệm và có thể dùng kèm với khoảng dự đoán. Với bệnh nhân A, hệ thống có thể hạ ngưỡng quyết định, gắn cờ để đánh giá thêm. Với bệnh nhân B, có thể giữ nguyên ngưỡng và không khuyến nghị theo dõi.
Bằng cách này, phương pháp Bayes điều chỉnh ngưỡng phân loại theo bối cảnh từng bệnh nhân, dẫn tới quyết định phù hợp lâm sàng hơn.
Assay có độ nhạy/đặc hiệu cao
Công nghệ mới nổi đẩy giới hạn độ nhạy và độ đặc hiệu phân tích là chẩn đoán dựa trên CRISPR. Các nhà khoa học đã điều chỉnh CRISPR (Clustered Regularly Interspaced Short Palindromic Repeats), công cụ chỉnh sửa gen, để phát hiện vật liệu di truyền. Nó sử dụng protein Cas để phát hiện các trình tự acid nucleic đặc hiệu với độ nhạy cao.
Assay dựa trên CRISPR đã được dùng để phát hiện sớm ung thư. Các thiết bị chẩn đoán ung thư di động đang được phát triển để dùng trong lâm sàng. Hai nền tảng chẩn đoán quan trọng là SHERLOCK và DETECTR.
Các assay dựa trên CRISPR mang lại nhiều lợi thế. Chúng có độ nhạy cao, có thể phát hiện lượng DNA hoặc RNA rất nhỏ.
Điều này giúp hữu ích trong nhận diện nhiễm trùng giai đoạn sớm, ung thư, hoặc đột biến hiếm. Chúng cũng có độ đặc hiệu vượt trội, cho phép phân biệt các trình tự di truyền rất gần nhau để giảm dương tính giả. Các lợi ích khác gồm trả kết quả nhanh và thiết bị giá rẻ, di động.
Những assay này hỗ trợ nhiều ứng dụng, bao gồm phát hiện bệnh truyền nhiễm, chẩn đoán ung thư và sàng lọc bệnh di truyền. Các nhà nghiên cứu có thể dùng machine learning để tối ưu thiết kế RNA dẫn đường và cải thiện độ chính xác chẩn đoán.
Assay dựa trên CRISPR cũng đối mặt thách thức. Đa số chỉ cho kết quả nhị phân (dương hoặc âm). Chuẩn hóa và tái lập vẫn là mối lo, vì kết quả khác nhau giữa các phòng thí nghiệm và điều kiện xét nghiệm.
Ngoài ra, các assay này phải đáp ứng yêu cầu quản lý, gồm phê duyệt FDA và CLIA, đòi hỏi thẩm định, tài liệu và rà soát rộng rãi. Cuối cùng, vấn đề IP làm phức tạp cấp phép và làm chậm thương mại hóa.
Kết luận
Độ nhạy và độ đặc hiệu đóng vai trò trung tâm trong đánh giá xét nghiệm chẩn đoán và mô hình phân loại. Chúng có thể sâu sắc hơn độ chính xác, đặc biệt trong tập dữ liệu mất cân bằng hoặc khi chi phí dương tính giả/âm tính giả khác nhau. Cùng với các công cụ liên quan như tỉ số khả dĩ và phân tích ROC, chúng định hướng diễn giải thấu đáo và ra quyết định tốt hơn.
Muốn nâng cao kỹ năng thực hành đánh giá hiệu năng mô hình? Hãy khám phá các tài nguyên DataCamp sau:


Người làm machine learning cần đánh giá cả chất lượng dữ liệu và hiệu năng của mô hình dự đoán.
Nhiều thước đo có thể hỗ trợ, đặc biệt khi xử lý bài toán phân loại nhị phân; trong đó mỗi điểm dữ liệu được dự đoán thuộc một trong hai nhóm. Ví dụ gồm phê duyệt tín dụng (duyệt/không duyệt), phân loại malware (độc hại/không độc hại), sàng lọc hồ sơ (vào danh sách rút gọn/không vào), và chẩn đoán bệnh (có bệnh/không có bệnh). Ngay cả thử nghiệm A/B cũng liên quan chặt chẽ, về bản chất là hỏi: "Phiên bản B có tốt hơn phiên bản A không?" (có/không).
Mặc dù độ chính xác cho cái nhìn nhanh về hiệu năng, nó có thể che khuất thông tin quan trọng về bản chất lỗi của mô hình. Chẳng hạn, một bộ phát hiện gian lận thẻ tín dụng gán mọi giao dịch là hợp lệ có thể đạt 99% độ chính xác, nhưng hoàn toàn bỏ sót gian lận thực. Độ nhạy và độ đặc hiệu cung cấp góc nhìn tinh tế hơn, giúp bạn hiểu không chỉ mức độ đúng của mô hình, mà còn kiểu lỗi nó mắc phải và liệu các lỗi đó có chấp nhận được trong ngữ cảnh hay không.
Trong hướng dẫn này, bạn sẽ học ý nghĩa thực sự của độ nhạy và độ đặc hiệu, khi nào mỗi chỉ số phù hợp nhất, cách tính toán, và cách áp dụng vào công việc qua các ví dụ rõ ràng, sát thực tế.
Xét nghiệm chẩn đoán và ra quyết định lâm sàng
Độ nhạy và độ đặc hiệu bắt nguồn từ đánh giá y khoa. Xem các chỉ số này qua lăng kính xét nghiệm chẩn đoán và ra quyết định lâm sàng giúp làm rõ nhiều khái niệm trong bài. Để minh họa, chúng ta sẽ dùng hai ví dụ xuyên suốt: phát hiện bệnh và gian lận thẻ tín dụng.
Đối tượng độc giả
Bài viết dành cho người làm dữ liệu sử dụng suy luận thống kê và muốn hiểu các thước đo tinh tế hơn độ chính xác để ra quyết định tốt hơn. Các chỉ số này giúp đánh giá mô hình mắc lỗi gì và liệu những lỗi đó có chấp nhận được trong bối cảnh hay không. Ứng dụng bao gồm chẩn đoán y khoa và phát hiện gian lận như đã nêu. Ứng dụng khác: phát hiện xâm nhập, kiểm soát chất lượng trong sản xuất, và lọc thư rác.
Các khái niệm nền tảng về độ nhạy và độ đặc hiệu
Trước khi diễn giải hay áp dụng độ nhạy và độ đặc hiệu, cần hiểu các khái niệm cơ bản đằng sau chúng. Phần này bàn về nguồn gốc lịch sử, định nghĩa cốt lõi, suy dẫn và cách tính.
Lịch sử
Các khái niệm độ nhạy và độ đặc hiệu có nguồn gốc trong thống kê sinh học. Dù đã được dùng sớm hơn trong y văn, nhà nghiên cứu thống kê sinh học Jacob Yerushlamy đã phổ biến thuật ngữ này trong bài báo "Statistical Problems in Assessing Methods of Medical Diagnosis, with Special Reference to X-Ray Techniques."
Vào thập niên 1970, đường cong ROC (sẽ mô tả sau) trở thành công cụ trực quan để phân tích độ nhạy so với độ đặc hiệu trong xét nghiệm lâm sàng. Thập niên 1990, machine learning tiếp nhận các khái niệm này. Ngày nay, thuật ngữ được dùng rộng rãi trong y tế và machine learning để đo lường mức độ hệ thống nhận diện đúng dương tính và âm tính.
Ma trận nhầm lẫn
Giả sử một mô hình machine learning dùng để phát hiện giao dịch thẻ tín dụng gian lận. Trong mẫu 10.000 giao dịch, có 9.800 giao dịch hợp lệ và 200 trường hợp gian lận.
Vì chúng ta quan tâm chủ yếu đến gian lận, hãy gán trường hợp gian lận là dương tính, và không gian lận là âm tính. (Việc gán "dương tính" hay "âm tính" phần nào tùy ý; tuy nhiên, thường có cách gán hiển nhiên.)
Sau khi chạy mô hình và so sánh dự đoán gian lận với gian lận thực, ta thấy 160 trường hợp gian lận được gắn cờ đúng, 9.500 giao dịch hợp lệ được nhận diện đúng, 300 giao dịch hợp lệ bị gắn nhầm là gian lận, và 40 trường hợp gian lận bị mô hình bỏ sót.
Để theo dõi dữ liệu này, người ta thường dùng danh pháp sau.
Chữ thứ hai (P hoặc N) chỉ trường hợp được dự đoán là dương hay âm tính, và chữ đầu tiên cho biết dự đoán đó đúng (T) hay sai (F).
Vậy, "dương tính giả" nghĩa là trường hợp được dự đoán dương tính, nhưng dự đoán đó sai, hay nói cách khác, được dự đoán dương tính nhưng thực tế là âm tính. Tương tự, âm tính giả là trường hợp dự đoán âm tính nhưng thực tế là dương tính.
Để hiển thị thông tin này, ta thường dùng "ma trận nhầm lẫn", gọi vậy vì nó theo dõi tần suất mô hình nhầm lẫn dự đoán sai với kết quả thực (FN, FP). Ví dụ như sau:
Gian lận thực (Dương tính)
Hợp lệ thực (Âm tính)
Dự đoán gian lận (Dự đoán dương tính)
160 (TP)
300 (FP)
Dự đoán hợp lệ (Dự đoán âm tính)
40 (FN)
9500 (TN)
Giờ hãy xem tổng theo hàng và cột. Tổng hàng biểu thị tổng số ca dự đoán; tổng cột biểu thị tổng số ca thực tế.
Gian lận thực (Dương tính)
Hợp lệ thực (Âm tính)
Dự đoán gian lận (Dự đoán dương tính)
160 (TP)
300 (FP)
460 (TP + FP)
Tổng dương tính dự đoán
Dự đoán hợp lệ (Dự đoán âm tính)
60 (FN)
9500 (TN)
9540 (FN + TN)Tổng âm tính dự đoán
200 (TP + FN)Tổng dương tính thực
9800 (FP + TN)Tổng âm tính thực
10,000
Các tổng này biểu thị gì?
Định nghĩa
Độ nhạy (còn gọi là tỷ lệ dương tính thật, hay recall) đo khả năng mô hình nhận diện đúng các dương tính. Cụ thể, độ nhạy là tỷ lệ dương tính thật trên dương tính thực, TP / (TP + FN).
Tương tự, độ đặc hiệu (tỷ lệ âm tính thật) đo khả năng mô hình nhận diện đúng các âm tính. Công thức là tỷ lệ âm tính thật trên âm tính thực, TN / (FP + TN).
Theo góc nhìn xác suất, độ nhạy là xác suất xét nghiệm dương tính khi bệnh nhân có bệnh, và độ đặc hiệu là xác suất xét nghiệm âm tính khi bệnh nhân không có bệnh.
Tính độ nhạy và độ đặc hiệu
Trong ví dụ gian lận, độ nhạy = TP / (TP + FN) = 160/200, tức 80%. Độ đặc hiệu là 9500/9800, xấp xỉ 97%.
Sự đánh đổi giữa độ nhạy - độ đặc hiệu và phân tích ROC
Khi thay đổi ngưỡng mô hình, độ nhạy và độ đặc hiệu thường biến động theo chiều ngược nhau. Tăng độ nhạy thường làm giảm độ đặc hiệu, và ngược lại. Phần này khám phá sự đánh đổi cố hữu đó và cách phân tích ROC (Receiver Operating Characteristic) cung cấp phương pháp trực quan và định lượng để đánh giá hiệu năng mô hình qua nhiều ngưỡng khác nhau.
Sự đánh đổi
Hãy chỉnh ví dụ gian lận sao cho có thêm 20 âm tính giả, FN = 60. Vì tổng số ca gian lận thực vẫn là 200, nên số dương tính thật giảm 20 (TP = 140).
Gian lận thực (Dương tính)
Hợp lệ thực (Âm tính)
Dự đoán gian lận (Dự đoán dương tính)
140 (TP)
300 (FP)
460 (TP + FP)
Tổng dương tính dự đoán
Dự đoán hợp lệ (Dự đoán âm tính)
60 (FN)
9500 (TN)
9540 (FN + TN)Tổng âm tính dự đoán
200 (TP + FN)Tổng dương tính thực
9800 (FP + TN)Tổng âm tính thực
10,000
Độ nhạy giảm từ 80% xuống 140/200 = 70%. Khi số âm tính giả tăng, độ nhạy giảm, và ngược lại. Điều này có nghĩa độ nhạy cao cho thấy số âm tính giả thấp.
Theo y khoa, một xét nghiệm có độ đặc hiệu cao sẽ nhận diện đúng hầu hết những người không mắc bệnh. Trong ví dụ sàng lọc ung thư, xét nghiệm có độ đặc hiệu cao giúp người không mắc ung thư không bị báo nhầm là có.
Điều này minh họa sự đánh đổi giữa độ nhạy và độ đặc hiệu. Một vài bệnh nhân có thể hoang mang khi bị báo có ung thư trong khi thực tế không, nhưng những người thực sự mắc bệnh lại được nhận diện đúng. Trong trường hợp này, độ đặc hiệu cao là thước đo tốt hơn. Trong thế giới không hoàn hảo, chúng ta phải đưa ra quyết định phù hợp dựa trên đánh giá các đánh đổi giữa các chỉ số.
Động học ngưỡng
Ngưỡng chẩn đoán đặt giá trị cắt để xác định một kết quả xét nghiệm là dương hay âm tính. Nó chuyển một giá trị liên tục, như xác suất, thành mức cắt có/không. Nói đơn giản, nó xác định ranh giới giữa kết quả dương và âm.
Ngưỡng thường đặt ở 50%, hay 0,50. Xác suất trên 50% được coi là dương tính, thấp hơn 50% là âm tính.
Thay đổi ngưỡng sẽ quyết định trường hợp nào được coi là dương hay âm tính. Sự dịch chuyển này ảnh hưởng cân bằng giữa việc bắt được dương tính thật và tránh âm tính giả.
Ví dụ, xét mô hình xuất ra xác suất mắc ung thư. Nếu ngưỡng đặt ở 0,3, mô hình phân loại nhiều người là dương tính. Cách tiếp cận này phù hợp cho sàng lọc vì giảm khả năng bỏ sót ca bệnh.
Tuy nhiên, nó làm tăng nguy cơ dương tính giả. Nếu ngưỡng là 0,8, mô hình phân loại ít người là dương tính hơn. Cách này giảm dương tính giả nhưng tăng rủi ro bỏ sót ca thực.
Khi ngưỡng thay đổi, mô hình thay đổi tần suất bắt được dương tính thật và tần suất tránh được dương tính giả. Ngưỡng thấp tăng độ nhạy nhưng giảm độ đặc hiệu; ngưỡng cao giảm độ nhạy nhưng tăng độ đặc hiệu.
Diễn giải đường cong ROC
Đường cong ROC (Receiver Operating Characteristic) là hình trực quan phổ biến để so sánh các ngưỡng phân loại theo các giá trị độ nhạy và độ đặc hiệu. Đường ROC vẽ độ nhạy theo 1 - độ đặc hiệu. Mỗi điểm trên đường cong đại diện cho một ngưỡng cụ thể. Khi ngưỡng thay đổi, độ nhạy và độ đặc hiệu của mô hình điều chỉnh tương ứng, vẽ nên đường ROC.
Đường ROC minh họa sự đánh đổi giữa độ nhạy và độ đặc hiệu. Các điểm chính trên đường cong:
Đường chéo nét đứt biểu thị may rủi ngẫu nhiên. Mô hình hoạt động dọc theo đường này không có sức phân biệt thực sự.
Để đánh giá mô hình bằng đường ROC, hãy xét "Diện tích dưới đường cong" (AUC). AUC là tổng diện tích (tích phân) dưới đường cong, đại diện cho trung bình có trọng số hiệu năng trên mọi ngưỡng. AUC cao hơn cho thấy khả năng phân biệt giữa lớp dương và âm tổng thể tốt hơn.
Điểm AUC
Diễn giải
1.0
Bộ phân loại hoàn hảo
0.9 - 1.0
Xuất sắc
0.8 - 0.9
Tốt
0.7 - 0.8
Khá
0.6 - 0.7
Kém
0.5
Không phân biệt (tương đương đoán ngẫu nhiên)
< 0.5
Tệ hơn ngẫu nhiên
Giá trị dự đoán và tỉ số khả dĩ
Phần này khám phá cách tỷ lệ hiện mắc ảnh hưởng đến độ tin cậy của kết quả xét nghiệm. Chúng ta cũng xem tỉ số khả dĩ kết hợp độ nhạy và độ đặc hiệu thành một con số, cho phép bác sĩ cập nhật xác suất chẩn đoán sau xét nghiệm.
Các thước đo phụ thuộc tỷ lệ hiện mắc
Giá trị dự đoán dương (PPV), về mặt toán học tương đương precision trong machine learning, phản ánh khả năng một dự đoán dương tính là đúng. Nó đo tỷ lệ dương tính thật trong các dương tính dự đoán: PPV = TP / (TP + FP).
Giá trị dự đoán âm (NPV) phản ánh độ tin cậy của kết quả âm tính. Nó đo tỷ lệ âm tính thật trong các kết quả âm tính. Công thức: NPV = TN / (TN + FN).
Giả sử ta xét nghiệm 1.000 người mắc một bệnh với ma trận nhầm lẫn sau.
Dương tính thực (ốm)
Âm tính thực (khỏe)
Dự đoán dương tính (ốm)
80 (TP)
20 (FP)
100
Dự đoán âm tính (khỏe)
10 (FN)
890 (TN)
900
90
910
1000
Để so sánh, giả sử có nhiều người ốm hơn (300 thay vì 90), và điều chỉnh ma trận nhầm lẫn tương ứng.
Dương tính thực (ốm)
Âm tính thực (khỏe)
Dự đoán dương tính (ốm)
270 (TP)
70 (FP)
340
Dự đoán âm tính (khỏe)
30 (FN)
630 (TN)
660
300
700
1000
Khi tỷ lệ hiện mắc tăng, số ca dương tính thật tăng.
Tỉ số khả dĩ (Likelihood ratios)
Tỉ số khả dĩ kết hợp độ nhạy và độ đặc hiệu thành một con số giúp bác sĩ cập nhật mức độ tin cậy trong chẩn đoán dựa trên kết quả xét nghiệm.
Xác suất và tỷ lệ cược (odds)
Trước khi áp dụng tỉ số khả dĩ, cần phân biệt giữa xác suất và tỷ lệ cược (odds). Xác suất là khả năng một sự kiện xảy ra, biểu diễn bằng giá trị giữa 0 và 1. Tỷ lệ cược biểu thị mức khả năng sự kiện xảy ra so với không xảy ra.
Xác suất 75% nghĩa là sự kiện xảy ra 75 lần trong 100 lần. Tỷ lệ cược tương ứng là 0,75 / (1 - 0,75) = 0,75 / .025 = 3. Nghĩa là tỷ lệ cược là 3 ăn 1 nghiêng về khả năng sự kiện xảy ra.
Tổng quát, nếu p là xác suất sự kiện, thì odds = p / (1 - p). Đổi từ odds sang xác suất, p = odds / (1 + odds).
Tỉ số khả dĩ
Tỉ số khả dĩ dương (LR+) cho biết kết quả dương tính làm tăng tỷ lệ cược mắc bệnh bao nhiêu so với người không mắc. Giá trị cao (>10) gợi ý xét nghiệm rất hiệu quả để khẳng định bệnh. Công thức: LR+ = Độ nhạy / (1 - Độ đặc hiệu).
Tỉ số khả dĩ âm (LR-) cho biết kết quả âm tính làm giảm tỷ lệ cược mắc bệnh bao nhiêu so với người không mắc. Giá trị thấp (< 0,1) gợi ý xét nghiệm rất hiệu quả để loại trừ bệnh. Công thức: LR- = (1 - Độ nhạy) / Độ đặc hiệu.
Xác suất sau xét nghiệm
Để ra quyết định, bác sĩ bắt đầu với xác suất trước xét nghiệm dựa trên triệu chứng và tiền sử. Ước lượng này được kết hợp với tỉ số khả dĩ để tính xác suất sau xét nghiệm.
Quy trình như sau.
Ví dụ, giả sử xác suất trước xét nghiệm mắc bệnh là 30% và LR+ = 10. Xác suất sau xét nghiệm là bao nhiêu?
Ta thấy LR+ đã làm thay đổi đáng kể xác suất và mức độ tin cậy chẩn đoán.
Phương pháp nâng cao và hướng đi tương lai
Khi xét nghiệm chẩn đoán và hệ thống phân loại trở nên phức tạp hơn, các phương pháp mới xuất hiện để vượt qua giới hạn hiệu năng truyền thống. Phần này khám phá cách tiếp cận Bayes cho phép cá nhân hóa ngưỡng quyết định và cách các công nghệ mới như chẩn đoán dựa trên CRISPR đang đẩy giới hạn của độ nhạy và độ đặc hiệu phân tích.
Cách tiếp cận Bayes
Ý tưởng bắt đầu với niềm tin tiên nghiệm và cập nhật nó dựa trên thông tin mới nằm ở trung tâm của thống kê Bayes. Nó cung cấp cách thức chính quy để điều chỉnh xác suất khi có dữ liệu mới.
Lý luận Bayes dựa trên ba thành phần chính.
Điều này được mô tả bằng định lý Bayes về mặt toán học.
P(A|B) = P(B|A) x P(A) / P(B)
trong đó P(A|B) là hậu nghiệm (xác suất A khi biết B), P(B|A) là độ khả dĩ (xác suất B khi A đúng), P(A) là tiên nghiệm, và P(B) là bằng chứng.
Tối ưu ngưỡng bằng phương pháp Bayes
Như đã thấy, các mô hình phân loại truyền thống thường áp một ngưỡng cố định, như 0,5, để quyết định đầu ra dán nhãn dương hay âm. Ngược lại, cách tiếp cận Bayes cho phép ngưỡng thích ứng theo bối cảnh, gồm yếu tố nguy cơ cá nhân, nhân khẩu học, lịch sử hành vi, hoặc dữ liệu thời gian thực. Tính linh hoạt này giúp hệ thống điều chỉnh ngưỡng động, thay vì phụ thuộc một ngưỡng tĩnh dùng cho tất cả.
Xét mô hình dự đoán khả năng mắc bệnh tim. Mô hình truyền thống có thể dùng ngưỡng 0,5. Bệnh nhân có xác suất trên 50% được coi là dương tính, thấp hơn là âm tính.
Giờ xét cách tiếp cận Bayes với hai bệnh nhân giả định:
Cả hai nhận xác suất do xét nghiệm tạo ra là 0,45. Mô hình ngưỡng cố định 0,5 sẽ coi cả hai là âm tính.
Tuy nhiên, mô hình Bayes kết hợp thông tin nguy cơ tiên nghiệm và có thể dùng kèm với khoảng dự đoán. Với bệnh nhân A, hệ thống có thể hạ ngưỡng quyết định, gắn cờ để đánh giá thêm. Với bệnh nhân B, có thể giữ nguyên ngưỡng và không khuyến nghị theo dõi.
Bằng cách này, phương pháp Bayes điều chỉnh ngưỡng phân loại theo bối cảnh từng bệnh nhân, dẫn tới quyết định phù hợp lâm sàng hơn.
Assay có độ nhạy/đặc hiệu cao
Công nghệ mới nổi đẩy giới hạn độ nhạy và độ đặc hiệu phân tích là chẩn đoán dựa trên CRISPR. Các nhà khoa học đã điều chỉnh CRISPR (Clustered Regularly Interspaced Short Palindromic Repeats), công cụ chỉnh sửa gen, để phát hiện vật liệu di truyền. Nó sử dụng protein Cas để phát hiện các trình tự acid nucleic đặc hiệu với độ nhạy cao.
Assay dựa trên CRISPR đã được dùng để phát hiện sớm ung thư. Các thiết bị chẩn đoán ung thư di động đang được phát triển để dùng trong lâm sàng. Hai nền tảng chẩn đoán quan trọng là SHERLOCK và DETECTR.
Các assay dựa trên CRISPR mang lại nhiều lợi thế. Chúng có độ nhạy cao, có thể phát hiện lượng DNA hoặc RNA rất nhỏ.
Điều này giúp hữu ích trong nhận diện nhiễm trùng giai đoạn sớm, ung thư, hoặc đột biến hiếm. Chúng cũng có độ đặc hiệu vượt trội, cho phép phân biệt các trình tự di truyền rất gần nhau để giảm dương tính giả. Các lợi ích khác gồm trả kết quả nhanh và thiết bị giá rẻ, di động.
Những assay này hỗ trợ nhiều ứng dụng, bao gồm phát hiện bệnh truyền nhiễm, chẩn đoán ung thư và sàng lọc bệnh di truyền. Các nhà nghiên cứu có thể dùng machine learning để tối ưu thiết kế RNA dẫn đường và cải thiện độ chính xác chẩn đoán.
Assay dựa trên CRISPR cũng đối mặt thách thức. Đa số chỉ cho kết quả nhị phân (dương hoặc âm). Chuẩn hóa và tái lập vẫn là mối lo, vì kết quả khác nhau giữa các phòng thí nghiệm và điều kiện xét nghiệm.
Ngoài ra, các assay này phải đáp ứng yêu cầu quản lý, gồm phê duyệt FDA và CLIA, đòi hỏi thẩm định, tài liệu và rà soát rộng rãi. Cuối cùng, vấn đề IP làm phức tạp cấp phép và làm chậm thương mại hóa.
Kết luận
Độ nhạy và độ đặc hiệu đóng vai trò trung tâm trong đánh giá xét nghiệm chẩn đoán và mô hình phân loại. Chúng có thể sâu sắc hơn độ chính xác, đặc biệt trong tập dữ liệu mất cân bằng hoặc khi chi phí dương tính giả/âm tính giả khác nhau. Cùng với các công cụ liên quan như tỉ số khả dĩ và phân tích ROC, chúng định hướng diễn giải thấu đáo và ra quyết định tốt hơn.
Muốn nâng cao kỹ năng thực hành đánh giá hiệu năng mô hình? Hãy khám phá các tài nguyên DataCamp sau: