La funzione sigmoide è un concetto importante nella data science e nel machine learning, alla base di algoritmi come la regressione logistica e le reti neurali. Aiuta a convertire dati numerici complessi in probabilità più facili da interpretare. O, più precisamente, trasforma un input a valori reali (spesso il risultato di un modello lineare) in un output simile a una probabilità compreso tra 0 e 1.
La sigmoide è quindi essenziale per attività come prevedere esiti binari (decisioni sì/no o vero/falso) e fare previsioni informate nei modelli di machine learning per la classificazione. Nel resto di questo tutorial spiegherò le proprietà matematiche, le applicazioni e anche alcune delle sue limitazioni.
Che cos'è la funzione sigmoide?
Alla base, la funzione sigmoide è un'equazione matematica che mappa qualsiasi numero reale a un valore compreso tra 0 e 1, rendendola ideale per output probabilistici. La sua formula è riportata di seguito:
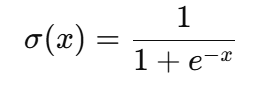
Dove:
- x è l'input della funzione.
- e è la base del logaritmo naturale (circa 2,718).
La funzione sigmoide è ampiamente usata nella data science in due modi principali:
- Classificazione binaria: la sigmoide trasforma l'output di un modello in un punteggio di probabilità, che può poi essere usato per compiti come prevedere insolvenze su prestiti, rilevare frodi o identificare email di spam.
- Funzione di attivazione: nelle reti neurali, la sigmoide aggiunge non linearità, permettendo al modello di apprendere pattern complessi nei dati.
Proprietà matematiche della funzione sigmoide
La funzione sigmoide presenta diverse proprietà matematiche che la rendono una scelta popolare per varie applicazioni.
Proprietà chiave
- Intervallo: i valori in output della sigmoide sono sempre compresi tra 0 e 1, motivo per cui funziona bene per stimare probabilità in attività come la classificazione binaria.
- Monotonicità: la funzione è monotonamente crescente, cioè all'aumentare dell'input aumenta anche l'output e non diminuisce mai. Questa coerenza è utile quando si modellano relazioni tra variabili.
- Derivabilità: la funzione sigmoide è completamente derivabile, ovvero è possibile calcolarne la derivata in ogni punto. Questa proprietà è cruciale per tecniche di ottimizzazione come il backpropagation, utilizzate per addestrare le reti neurali.
- Non linearità: la funzione sigmoide introduce non linearità, permettendo ai modelli di apprendere pattern e frontiere decisionali più complessi. Questo è essenziale per compiti in cui semplici relazioni lineari non sono sufficienti.
Visualizzare la funzione sigmoide
La caratteristica curva a S della funzione sigmoide è il suo elemento più riconoscibile. Questa curva mostra come i valori di input vengano compressi nell'intervallo 0-1.
Ecco una semplice visualizzazione:
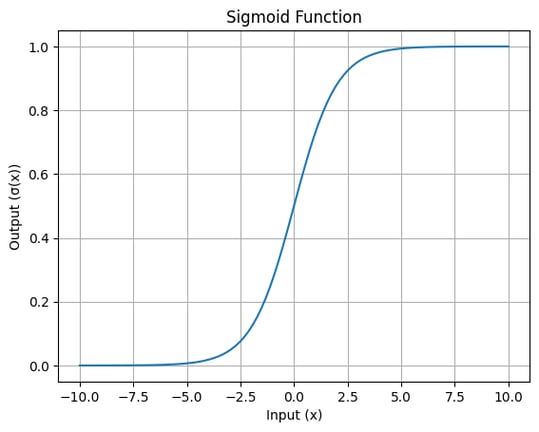
Curva a S della funzione sigmoide: immagine dell'autore
Il ruolo della sigmoide nella regressione logistica
Nella regressione logistica, la funzione sigmoide viene usata per convertire la combinazione lineare delle caratteristiche di input in un punteggio di probabilità:
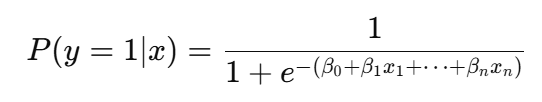
Più nello specifico, la funzione sigmoide viene usata per modellare esiti binari, cioè aiuta a prevedere se qualcosa appartiene a una di due categorie, come "sì" o "no", “default” o “no-default”, "spam" o "non spam".
La funzione prende il risultato di una combinazione lineare delle caratteristiche di input e lo trasforma in un valore di probabilità tra 0 e 1. Questa probabilità rappresenta quanto è probabile che l'input appartenga a una determinata classe.
Per esempio, se l'output dell'equazione lineare è due, la sigmoide lo convertirà in una probabilità (ad esempio 0,88), che indica un 88% di probabilità che l'input appartenga alla classe positiva. Supponiamo che la soglia sia fissata a 0,5, che determina la classificazione. Ora, se la probabilità è superiore a 0,5, il modello predice la classe positiva; altrimenti, predice la classe negativa.
Perché questa trasformazione è necessaria? Perché gli output grezzi del modello lineare non sono direttamente interpretabili come probabilità. Usando la sigmoide, la regressione logistica non solo fornisce classificazioni ma offre anche un chiaro significato probabilistico, particolarmente utile in applicazioni come la previsione del rischio, la classificazione del churn o il rilevamento di frodi. Questa interpretazione probabilistica consente a chi decide di impostare soglie personalizzate in base alle esigenze specifiche di un compito.
Applicazioni nelle reti neurali
La funzione sigmoide svolge un ruolo fondamentale nelle reti neurali come funzione di attivazione.
Ruolo della funzione di attivazione
Il ruolo principale della sigmoide come funzione di attivazione è prendere la somma pesata degli input dal livello precedente e trasformarla in un valore di output tra 0 e 1. Questa trasformazione è utile per introdurre non linearità nel modello, consentendo agli strati nascosti in una rete neurale profonda di apprendere relazioni complesse e risolvere problemi che non possono essere separati con linee rette, come il riconoscimento di immagini o l'elaborazione del linguaggio naturale.
Problema del gradiente che svanisce
Tuttavia, la sigmoide ha dei limiti, il principale dei quali è il problema del gradiente che svanisce. Per valori di input molto grandi o molto piccoli, l'output della funzione satura vicino a 1 o 0 e il suo gradiente diventa quasi nullo. Questo rallenta l'apprendimento nelle reti neurali dense perché i pesi vengono aggiornati troppo lentamente durante l'addestramento.
Funzioni di attivazione alternative
Per affrontare questo limite, spesso si usano altre funzioni di attivazione come ReLU (Rectified Linear Unit) e Tanh. ReLU è computazionalmente più semplice ed evita il problema del gradiente che svanisce per input positivi. Tanh, come la sigmoide, ha forma a S ma produce valori tra -1 e 1, risultando centrata in zero e più efficiente in certi scenari. Queste alternative hanno in gran parte sostituito la sigmoide nelle reti profonde, tranne che negli strati di output per compiti come la classificazione binaria.
Considerazioni chiave e limitazioni
Sebbene la funzione sigmoide presenti molti vantaggi, comporta anche alcune criticità che possono influenzarne le prestazioni in determinate situazioni.
Problema di saturazione
La sigmoide può saturare quando i valori di input sono troppo grandi (positivi) o troppo piccoli (negativi). La saturazione significa che l'output si avvicina molto a 0 o 1 e il gradiente (tasso di variazione) diventa quasi nullo.
Questo è problematico perché, quando il gradiente è vicino a zero, il modello fatica ad apprendere durante l'addestramento. Di conseguenza, si rallentano gli aggiornamenti nei metodi di ottimizzazione basati sul gradiente come il backpropagation.
Output non centrato in zero
Un'altra limitazione della sigmoide è che il suo output è compreso tra 0 e 1 e non è centrato in zero. Questo significa che tutti gli output sono positivi, il che può spostare la distribuzione degli input in una rete neurale e rendere l'ottimizzazione più lenta. Al contrario, funzioni come Tanh hanno output tra -1 e 1, aiutano a mantenere la media delle attivazioni più vicina a zero e accelerano la convergenza.
Costo computazionale
La funzione sigmoide si basa sull'operazione esponenziale, che è computazionalmente costosa rispetto a funzioni di attivazione più semplici come ReLU (Rectified Linear Unit). Per esempio, la formula della sigmoide è:
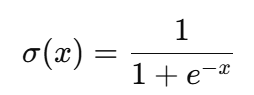
Qui, il calcolo esponenziale è più intensivo dal punto di vista computazionale rispetto alle operazioni in ReLU, che coinvolgono solo confronti e funzioni lineari, ed è dato da:
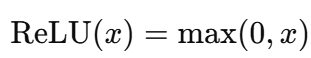
Per le reti neurali moderne, soprattutto quelle con molti livelli e neuroni, il costo di eseguire ripetutamente l'operazione esponenziale si accumula, ed è qui che si impiegano le alternative.
Conclusione
La funzione sigmoide è uno strumento importante nella data science, soprattutto per attività come la regressione logistica e come funzione di attivazione nelle reti neurali. Aiuta a trasformare gli input in probabilità e introduce non linearità nei modelli, rendendoli in grado di gestire pattern complessi. Tuttavia, presenta alcune criticità, come la saturazione, l'assenza di output centrati in zero e costi computazionali più elevati, che possono influire sulla sua efficienza nelle reti profonde.
Sebbene le tecniche moderne abbiano introdotto alternative, l'importanza della sigmoide nel plasmare le metodologie della data science non può essere sopravvalutata. Se vuoi approfondire come funziona e vederla in azione, esplora i nostri corsi e tutorial interattivi su reti neurali e regressione logistica. Il nostro Introduction to Deep Learning in Python è un'ottima opzione.





La funzione sigmoide è un concetto importante nella data science e nel machine learning, alla base di algoritmi come la regressione logistica e le reti neurali. Aiuta a convertire dati numerici complessi in probabilità più facili da interpretare. O, più precisamente, trasforma un input a valori reali (spesso il risultato di un modello lineare) in un output simile a una probabilità compreso tra 0 e 1.
La sigmoide è quindi essenziale per attività come prevedere esiti binari (decisioni sì/no o vero/falso) e fare previsioni informate nei modelli di machine learning per la classificazione. Nel resto di questo tutorial spiegherò le proprietà matematiche, le applicazioni e anche alcune delle sue limitazioni.
Che cos'è la funzione sigmoide?
Alla base, la funzione sigmoide è un'equazione matematica che mappa qualsiasi numero reale a un valore compreso tra 0 e 1, rendendola ideale per output probabilistici. La sua formula è riportata di seguito:
Dove:
La funzione sigmoide è ampiamente usata nella data science in due modi principali:
Proprietà matematiche della funzione sigmoide
La funzione sigmoide presenta diverse proprietà matematiche che la rendono una scelta popolare per varie applicazioni.
Proprietà chiave
Visualizzare la funzione sigmoide
La caratteristica curva a S della funzione sigmoide è il suo elemento più riconoscibile. Questa curva mostra come i valori di input vengano compressi nell'intervallo 0-1.
Ecco una semplice visualizzazione:
Curva a S della funzione sigmoide: immagine dell'autore
Il ruolo della sigmoide nella regressione logistica
Nella regressione logistica, la funzione sigmoide viene usata per convertire la combinazione lineare delle caratteristiche di input in un punteggio di probabilità:
Più nello specifico, la funzione sigmoide viene usata per modellare esiti binari, cioè aiuta a prevedere se qualcosa appartiene a una di due categorie, come "sì" o "no", “default” o “no-default”, "spam" o "non spam".
La funzione prende il risultato di una combinazione lineare delle caratteristiche di input e lo trasforma in un valore di probabilità tra 0 e 1. Questa probabilità rappresenta quanto è probabile che l'input appartenga a una determinata classe.
Per esempio, se l'output dell'equazione lineare è due, la sigmoide lo convertirà in una probabilità (ad esempio 0,88), che indica un 88% di probabilità che l'input appartenga alla classe positiva. Supponiamo che la soglia sia fissata a 0,5, che determina la classificazione. Ora, se la probabilità è superiore a 0,5, il modello predice la classe positiva; altrimenti, predice la classe negativa.
Perché questa trasformazione è necessaria? Perché gli output grezzi del modello lineare non sono direttamente interpretabili come probabilità. Usando la sigmoide, la regressione logistica non solo fornisce classificazioni ma offre anche un chiaro significato probabilistico, particolarmente utile in applicazioni come la previsione del rischio, la classificazione del churn o il rilevamento di frodi. Questa interpretazione probabilistica consente a chi decide di impostare soglie personalizzate in base alle esigenze specifiche di un compito.
Applicazioni nelle reti neurali
La funzione sigmoide svolge un ruolo fondamentale nelle reti neurali come funzione di attivazione.
Ruolo della funzione di attivazione
Il ruolo principale della sigmoide come funzione di attivazione è prendere la somma pesata degli input dal livello precedente e trasformarla in un valore di output tra 0 e 1. Questa trasformazione è utile per introdurre non linearità nel modello, consentendo agli strati nascosti in una rete neurale profonda di apprendere relazioni complesse e risolvere problemi che non possono essere separati con linee rette, come il riconoscimento di immagini o l'elaborazione del linguaggio naturale.
Problema del gradiente che svanisce
Tuttavia, la sigmoide ha dei limiti, il principale dei quali è il problema del gradiente che svanisce. Per valori di input molto grandi o molto piccoli, l'output della funzione satura vicino a 1 o 0 e il suo gradiente diventa quasi nullo. Questo rallenta l'apprendimento nelle reti neurali dense perché i pesi vengono aggiornati troppo lentamente durante l'addestramento.
Funzioni di attivazione alternative
Per affrontare questo limite, spesso si usano altre funzioni di attivazione come ReLU (Rectified Linear Unit) e Tanh. ReLU è computazionalmente più semplice ed evita il problema del gradiente che svanisce per input positivi. Tanh, come la sigmoide, ha forma a S ma produce valori tra -1 e 1, risultando centrata in zero e più efficiente in certi scenari. Queste alternative hanno in gran parte sostituito la sigmoide nelle reti profonde, tranne che negli strati di output per compiti come la classificazione binaria.
Considerazioni chiave e limitazioni
Sebbene la funzione sigmoide presenti molti vantaggi, comporta anche alcune criticità che possono influenzarne le prestazioni in determinate situazioni.
Problema di saturazione
La sigmoide può saturare quando i valori di input sono troppo grandi (positivi) o troppo piccoli (negativi). La saturazione significa che l'output si avvicina molto a 0 o 1 e il gradiente (tasso di variazione) diventa quasi nullo.
Questo è problematico perché, quando il gradiente è vicino a zero, il modello fatica ad apprendere durante l'addestramento. Di conseguenza, si rallentano gli aggiornamenti nei metodi di ottimizzazione basati sul gradiente come il backpropagation.
Output non centrato in zero
Un'altra limitazione della sigmoide è che il suo output è compreso tra 0 e 1 e non è centrato in zero. Questo significa che tutti gli output sono positivi, il che può spostare la distribuzione degli input in una rete neurale e rendere l'ottimizzazione più lenta. Al contrario, funzioni come Tanh hanno output tra -1 e 1, aiutano a mantenere la media delle attivazioni più vicina a zero e accelerano la convergenza.
Costo computazionale
La funzione sigmoide si basa sull'operazione esponenziale, che è computazionalmente costosa rispetto a funzioni di attivazione più semplici come ReLU (Rectified Linear Unit). Per esempio, la formula della sigmoide è:
Qui, il calcolo esponenziale è più intensivo dal punto di vista computazionale rispetto alle operazioni in ReLU, che coinvolgono solo confronti e funzioni lineari, ed è dato da:
Per le reti neurali moderne, soprattutto quelle con molti livelli e neuroni, il costo di eseguire ripetutamente l'operazione esponenziale si accumula, ed è qui che si impiegano le alternative.
Conclusione
La funzione sigmoide è uno strumento importante nella data science, soprattutto per attività come la regressione logistica e come funzione di attivazione nelle reti neurali. Aiuta a trasformare gli input in probabilità e introduce non linearità nei modelli, rendendoli in grado di gestire pattern complessi. Tuttavia, presenta alcune criticità, come la saturazione, l'assenza di output centrati in zero e costi computazionali più elevati, che possono influire sulla sua efficienza nelle reti profonde.
Sebbene le tecniche moderne abbiano introdotto alternative, l'importanza della sigmoide nel plasmare le metodologie della data science non può essere sopravvalutata. Se vuoi approfondire come funziona e vederla in azione, esplora i nostri corsi e tutorial interattivi su reti neurali e regressione logistica. Il nostro Introduction to Deep Learning in Python è un'ottima opzione.