De sigmoidfunctie is een belangrijk concept in data science en machine learning en drijft algoritmen als logistische regressie en neurale netwerken aan. Ze helpt om complexe numerieke gegevens om te zetten in kansen die makkelijker te interpreteren zijn. Of, preciezer gezegd: ze zet een reële invoerwaarde (dit is vaak het resultaat van een lineair model) om in een kansachtig resultaat tussen 0 en 1.
De sigmoid is daarom essentieel voor taken zoals het voorspellen van binaire uitkomsten (ja/nee- of waar/onwaar-beslissingen) en het maken van onderbouwde voorspellingen in classification machine learning modellen. In de rest van deze tutorial leg ik de wiskundige eigenschappen, toepassingen en ook enkele beperkingen uit.
Wat is de sigmoidfunctie?
In de kern is de sigmoidfunctie een wiskundige vergelijking die elke reële waarde afbeeldt op een waarde tussen 0 en 1, waardoor ze ideaal is voor probabilistische outputs. De formule staat hieronder:
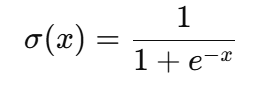
Waarbij:
- x de invoer van de functie is.
- e de basis is van de natuurlijke logaritme (ongeveer 2,718).
De sigmoidfunctie wordt in data science op twee hoofdmanieren gebruikt:
- Binaire classificatie: de sigmoidfunctie zet de output van een model om in een kansscore, die vervolgens kan worden gebruikt voor taken zoals het voorspellen van wanbetalingen, het detecteren van fraude of het identificeren van spammails.
- Activatiefunctie: in neurale netwerken voegt de sigmoidfunctie non-lineariteit toe, waardoor het model complexe patronen in data kan leren.
Wiskundige eigenschappen van de sigmoidfunctie
De sigmoidfunctie heeft verschillende wiskundige eigenschappen die haar tot een populaire keuze maken voor uiteenlopende toepassingen.
Belangrijkste eigenschappen
- Bereik: de outputwaarden van de sigmoidfunctie liggen altijd tussen 0 en 1, wat ze geschikt maakt voor het schatten van kansen in taken zoals binaire classificatie.
- Monotoniciteit: de functie is monotoon stijgend: als de invoer toeneemt, neemt de output ook toe, en daalt nooit. Deze consistentie is handig bij het modelleren van relaties tussen variabelen.
- Differentieerbaarheid: de sigmoidfunctie is overal differentieerbaar, wat betekent dat je op elk punt de afgeleide kunt berekenen. Deze eigenschap is cruciaal voor optimalisatietechnieken zoals backpropagation, die worden gebruikt om neurale netwerken te trainen.
- Non-lineariteit: de sigmoidfunctie introduceert non-lineariteit, waardoor modellen complexere patronen en beslissingsgrenzen kunnen leren. Dit is essentieel bij taken waar eenvoudige lineaire verbanden niet volstaan.
De sigmoidfunctie visualiseren
De karakteristieke S-vormige curve van de sigmoidfunctie is haar meest herkenbare kenmerk. Deze curve laat zien hoe invoerwaarden worden samengedrukt tot het bereik van 0 tot 1.
Hier is een eenvoudige visualisatie:
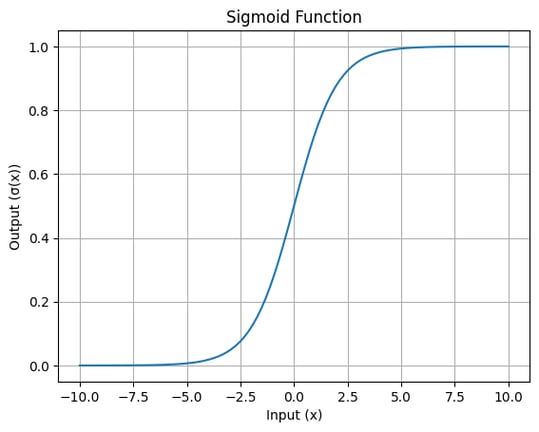
S-vormige curve van de sigmoidfunctie: afbeelding door de auteur
De rol van de sigmoid in logistische regressie
Bij logistische regressie wordt de sigmoidfunctie gebruikt om de lineaire combinatie van invoerkenmerken om te zetten in een kansscore:
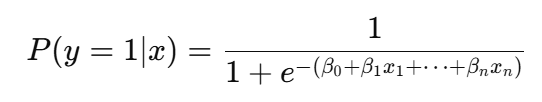
Concreet wordt de sigmoidfunctie gebruikt om binaire uitkomsten te modelleren: ze helpt voorspellen of iets tot een van twee categorieën behoort, zoals "ja" of "nee", “wanbetaling” of “geen wanbetaling”, "spam" of "geen spam".
De functie neemt het resultaat van een lineaire combinatie van invoerkenmerken en zet dit om in een kanswaarde tussen 0 en 1. Deze kans geeft aan hoe waarschijnlijk het is dat de invoer tot een bepaalde klasse behoort.
Als bijvoorbeeld de output van de lineaire vergelijking twee is, zet de sigmoidfunctie dit om in een kans (bijv. 0,88), wat een kans van 88% aangeeft dat de invoer tot de positieve klasse behoort. Stel dat de drempel op 0,5 is gezet, wat de classificatie bepaalt. Als de kanswaarde boven 0,5 ligt, voorspelt het model de positieve klasse; anders voorspelt het de negatieve klasse.
Waarom is deze transformatie überhaupt nodig? Omdat rauwe outputs van het lineaire model niet rechtstreeks als kansen te interpreteren zijn. Door de sigmoidfunctie te gebruiken, levert logistische regressie niet alleen classificaties op, maar ook een duidelijke probabilistische interpretatie, wat vooral nuttig is bij toepassingen zoals risicovoorspelling, churnclassificatie of fraudedetectie. Deze probabilistische interpretatie stelt besluitvormers in staat om aangepaste drempels in te stellen op basis van de specifieke behoeften van een taak.
Toepassingen in neurale netwerken
De sigmoidfunctie speelt een sleutelrol in neurale netwerken als activatiefunctie.
Rol als activatiefunctie
De primaire rol van de sigmoidfunctie als activatiefunctie is om de gewogen som van inputs uit de vorige laag om te zetten in een outputwaarde tussen 0 en 1. Deze transformatie is nuttig om non-lineariteit in het model te introduceren, waardoor de verborgen lagen in een deep neural network complexe relaties kunnen leren en problemen kunnen oplossen die niet met rechte lijnen te scheiden zijn, zoals beeldherkenning of natuurlijke taalverwerking.
Het verdwijnende-gradiënt-probleem
De sigmoidfunctie kent echter beperkingen, waarvan het belangrijkste het probleem van de verdwijnende gradiënt is. Bij zeer grote of zeer kleine invoerwaarden raakt de output van de functie verzadigd dicht bij 1 of 0, en wordt de gradiënt vrijwel nul. Dit vertraagt het leerproces in dichte neurale netwerken, omdat de gewichten tijdens het trainen nog maar heel langzaam worden bijgewerkt.
Alternatieve activatiefuncties
Om deze beperking te ondervangen, worden vaak andere activatiefuncties zoals ReLU (Rectified Linear Unit) en Tanh gebruikt. ReLU is computationeel eenvoudiger en vermijdt het verdwijnende-gradiënt-probleem voor positieve inputs. Tanh is, net als sigmoid, S-vormig maar geeft waarden tussen -1 en 1, waardoor deze nulgecentreerd is en in bepaalde scenario’s efficiënter kan zijn. Deze alternatieven hebben de sigmoid grotendeels vervangen in diepe netwerken, behalve in de outputlagen voor taken zoals binaire classificatie.
Belangrijke aandachtspunten en beperkingen
Hoewel de sigmoidfunctie veel voordelen heeft, brengt ze ook uitdagingen met zich mee die de prestaties in bepaalde situaties kunnen beïnvloeden.
Verzadigingsprobleem
De sigmoidfunctie kan verzadigen wanneer de invoerwaarden te groot (positief) of te klein (negatief) zijn. Verzadiging betekent dat de output heel dicht bij 0 of 1 komt en de gradiënt (veranderingssnelheid) bijna nul wordt.
Dat is problematisch, want wanneer de gradiënt bijna nul is, heeft het model moeite om te leren tijdens het trainen. Hierdoor vertragen de updates in gradiëntgebaseerde optimalisatiemethoden zoals backpropagation.
Niet nulgecentreerde output
Een andere beperking van de sigmoidfunctie is dat de output tussen 0 en 1 ligt en niet nulgecentreerd is. Dit betekent dat alle outputs positief zijn, wat de verdeling van inputs in een neuraal netwerk kan verschuiven en de optimalisatie kan vertragen. Ter vergelijking: functies zoals Tanh hebben outputs van -1 tot 1, waardoor het gemiddelde van de activaties dichter bij nul blijft en de convergentie versnelt.
Computationele kosten
De sigmoidfunctie is afhankelijk van de exponentiële bewerking, die computationeel duurder is dan eenvoudigere activatiefuncties zoals ReLU (Rectified Linear Unit). De sigmoidformule is bijvoorbeeld:
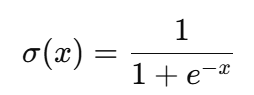
Hier is de exponentiële berekening computationeel intensiever dan de bewerkingen in ReLU, die alleen vergelijkingen en lineaire functies omvatten, en luidt als volgt:
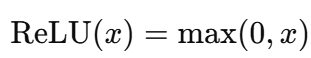
Voor moderne neurale netwerken, vooral die met veel lagen en neuronen, telt de kost van het herhaaldelijk uitvoeren van de exponentiële bewerking op, en dan worden alternatieven ingezet.
Conclusie
De sigmoidfunctie is een belangrijk hulpmiddel in data science, vooral voor taken zoals logistische regressie en als activatiefunctie in neurale netwerken. Ze helpt om inputs om te zetten in kansen en introduceert non-lineariteit in modellen, waardoor ze complexe patronen kunnen aanpakken. Er zijn echter ook uitdagingen, zoals verzadiging, het ontbreken van nulgecentreerde outputs en hogere computationele kosten, die de efficiëntie in diepe netwerken kunnen beïnvloeden.
Hoewel moderne technieken alternatieven hebben geïntroduceerd, kan het belang van de sigmoidfunctie bij het vormgeven van data science-methodologieën niet worden overschat. Wil je dieper ingaan op hoe ze werkt en haar in actie zien? Bekijk dan onze interactieve cursussen en tutorials over neurale netwerken en logistische regressie. Onze Introduction to Deep Learning in Python is een uitstekende optie.




De sigmoidfunctie is een belangrijk concept in data science en machine learning en drijft algoritmen als logistische regressie en neurale netwerken aan. Ze helpt om complexe numerieke gegevens om te zetten in kansen die makkelijker te interpreteren zijn. Of, preciezer gezegd: ze zet een reële invoerwaarde (dit is vaak het resultaat van een lineair model) om in een kansachtig resultaat tussen 0 en 1.
De sigmoid is daarom essentieel voor taken zoals het voorspellen van binaire uitkomsten (ja/nee- of waar/onwaar-beslissingen) en het maken van onderbouwde voorspellingen in classification machine learning modellen. In de rest van deze tutorial leg ik de wiskundige eigenschappen, toepassingen en ook enkele beperkingen uit.
Wat is de sigmoidfunctie?
In de kern is de sigmoidfunctie een wiskundige vergelijking die elke reële waarde afbeeldt op een waarde tussen 0 en 1, waardoor ze ideaal is voor probabilistische outputs. De formule staat hieronder:
Waarbij:
De sigmoidfunctie wordt in data science op twee hoofdmanieren gebruikt:
Wiskundige eigenschappen van de sigmoidfunctie
De sigmoidfunctie heeft verschillende wiskundige eigenschappen die haar tot een populaire keuze maken voor uiteenlopende toepassingen.
Belangrijkste eigenschappen
De sigmoidfunctie visualiseren
De karakteristieke S-vormige curve van de sigmoidfunctie is haar meest herkenbare kenmerk. Deze curve laat zien hoe invoerwaarden worden samengedrukt tot het bereik van 0 tot 1.
Hier is een eenvoudige visualisatie:
S-vormige curve van de sigmoidfunctie: afbeelding door de auteur
De rol van de sigmoid in logistische regressie
Bij logistische regressie wordt de sigmoidfunctie gebruikt om de lineaire combinatie van invoerkenmerken om te zetten in een kansscore:
Concreet wordt de sigmoidfunctie gebruikt om binaire uitkomsten te modelleren: ze helpt voorspellen of iets tot een van twee categorieën behoort, zoals "ja" of "nee", “wanbetaling” of “geen wanbetaling”, "spam" of "geen spam".
De functie neemt het resultaat van een lineaire combinatie van invoerkenmerken en zet dit om in een kanswaarde tussen 0 en 1. Deze kans geeft aan hoe waarschijnlijk het is dat de invoer tot een bepaalde klasse behoort.
Als bijvoorbeeld de output van de lineaire vergelijking twee is, zet de sigmoidfunctie dit om in een kans (bijv. 0,88), wat een kans van 88% aangeeft dat de invoer tot de positieve klasse behoort. Stel dat de drempel op 0,5 is gezet, wat de classificatie bepaalt. Als de kanswaarde boven 0,5 ligt, voorspelt het model de positieve klasse; anders voorspelt het de negatieve klasse.
Waarom is deze transformatie überhaupt nodig? Omdat rauwe outputs van het lineaire model niet rechtstreeks als kansen te interpreteren zijn. Door de sigmoidfunctie te gebruiken, levert logistische regressie niet alleen classificaties op, maar ook een duidelijke probabilistische interpretatie, wat vooral nuttig is bij toepassingen zoals risicovoorspelling, churnclassificatie of fraudedetectie. Deze probabilistische interpretatie stelt besluitvormers in staat om aangepaste drempels in te stellen op basis van de specifieke behoeften van een taak.
Toepassingen in neurale netwerken
De sigmoidfunctie speelt een sleutelrol in neurale netwerken als activatiefunctie.
Rol als activatiefunctie
De primaire rol van de sigmoidfunctie als activatiefunctie is om de gewogen som van inputs uit de vorige laag om te zetten in een outputwaarde tussen 0 en 1. Deze transformatie is nuttig om non-lineariteit in het model te introduceren, waardoor de verborgen lagen in een deep neural network complexe relaties kunnen leren en problemen kunnen oplossen die niet met rechte lijnen te scheiden zijn, zoals beeldherkenning of natuurlijke taalverwerking.
Het verdwijnende-gradiënt-probleem
De sigmoidfunctie kent echter beperkingen, waarvan het belangrijkste het probleem van de verdwijnende gradiënt is. Bij zeer grote of zeer kleine invoerwaarden raakt de output van de functie verzadigd dicht bij 1 of 0, en wordt de gradiënt vrijwel nul. Dit vertraagt het leerproces in dichte neurale netwerken, omdat de gewichten tijdens het trainen nog maar heel langzaam worden bijgewerkt.
Alternatieve activatiefuncties
Om deze beperking te ondervangen, worden vaak andere activatiefuncties zoals ReLU (Rectified Linear Unit) en Tanh gebruikt. ReLU is computationeel eenvoudiger en vermijdt het verdwijnende-gradiënt-probleem voor positieve inputs. Tanh is, net als sigmoid, S-vormig maar geeft waarden tussen -1 en 1, waardoor deze nulgecentreerd is en in bepaalde scenario’s efficiënter kan zijn. Deze alternatieven hebben de sigmoid grotendeels vervangen in diepe netwerken, behalve in de outputlagen voor taken zoals binaire classificatie.
Belangrijke aandachtspunten en beperkingen
Hoewel de sigmoidfunctie veel voordelen heeft, brengt ze ook uitdagingen met zich mee die de prestaties in bepaalde situaties kunnen beïnvloeden.
Verzadigingsprobleem
De sigmoidfunctie kan verzadigen wanneer de invoerwaarden te groot (positief) of te klein (negatief) zijn. Verzadiging betekent dat de output heel dicht bij 0 of 1 komt en de gradiënt (veranderingssnelheid) bijna nul wordt.
Dat is problematisch, want wanneer de gradiënt bijna nul is, heeft het model moeite om te leren tijdens het trainen. Hierdoor vertragen de updates in gradiëntgebaseerde optimalisatiemethoden zoals backpropagation.
Niet nulgecentreerde output
Een andere beperking van de sigmoidfunctie is dat de output tussen 0 en 1 ligt en niet nulgecentreerd is. Dit betekent dat alle outputs positief zijn, wat de verdeling van inputs in een neuraal netwerk kan verschuiven en de optimalisatie kan vertragen. Ter vergelijking: functies zoals Tanh hebben outputs van -1 tot 1, waardoor het gemiddelde van de activaties dichter bij nul blijft en de convergentie versnelt.
Computationele kosten
De sigmoidfunctie is afhankelijk van de exponentiële bewerking, die computationeel duurder is dan eenvoudigere activatiefuncties zoals ReLU (Rectified Linear Unit). De sigmoidformule is bijvoorbeeld:
Hier is de exponentiële berekening computationeel intensiever dan de bewerkingen in ReLU, die alleen vergelijkingen en lineaire functies omvatten, en luidt als volgt:
Voor moderne neurale netwerken, vooral die met veel lagen en neuronen, telt de kost van het herhaaldelijk uitvoeren van de exponentiële bewerking op, en dan worden alternatieven ingezet.
Conclusie
De sigmoidfunctie is een belangrijk hulpmiddel in data science, vooral voor taken zoals logistische regressie en als activatiefunctie in neurale netwerken. Ze helpt om inputs om te zetten in kansen en introduceert non-lineariteit in modellen, waardoor ze complexe patronen kunnen aanpakken. Er zijn echter ook uitdagingen, zoals verzadiging, het ontbreken van nulgecentreerde outputs en hogere computationele kosten, die de efficiëntie in diepe netwerken kunnen beïnvloeden.
Hoewel moderne technieken alternatieven hebben geïntroduceerd, kan het belang van de sigmoidfunctie bij het vormgeven van data science-methodologieën niet worden overschat. Wil je dieper ingaan op hoe ze werkt en haar in actie zien? Bekijk dan onze interactieve cursussen en tutorials over neurale netwerken en logistische regressie. Onze Introduction to Deep Learning in Python is een uitstekende optie.