结构方程模型(SEM)使我们能够研究变量之间的因果关系,并理解每个变量如何对整体表现做出贡献。SEM 将因子分析与多元回归分析相结合,用于分析多个变量之间的关系,是一项功能强大的工具。这有点类似于我们在日常生活中,会同时考虑体态、自信与沟通能力等因素如何共同影响面试表现。
接下来,我们将探索 SEM 的概念、应用,以及用 Python 实现的实用示例。如果您对一些核心概念(例如潜在因子)还不熟悉,也可以试试我们的因子分析课程。
什么是结构方程模型?
结构方程模型用于表征潜在变量与观测变量之间的因果关系。观测变量是我们可以直接测量的;潜在构念(latent constructs)则是据以推断、无法直接测量的。
为有效刻画这些关系,SEM 通常分为两个主要部分:测量模型与结构模型。测量模型用于刻画观测变量与其对应潜在变量之间的关系;结构模型则用于刻画潜在变量之间的关系。
研究者为何使用结构方程模型?
相关与回归等统计技术在研究复杂的多元关系时效率不足。SEM 适合对通过含误测量得到的复杂、多维构念进行建模。它还很有用,因为它有助于明确一个关系体系。传统方法帮助我们研究一个因变量与一组预测变量。虽然相关不等于因果,但 SEM 有助于我们理解观测变量与潜在构念之间的因果关系。
SEM 的一些应用包括:
- 社会科学:可用于研究文化价值观对不同社会中人类行为的影响。
- 教育:可用于调查研究生的在校体验。例如,对美国博士生辍学率进行建模。
- 疾病风险建模:可用于疾病风险建模,以评估如糖尿病或心脏病等疾病的风险。
结构方程模型的核心概念
以下是结构方程模型中的一些核心概念:
- 观测变量:直接从研究中测量得到的变量。例如问卷题目的作答。
- 潜在变量:由研究中的观测变量推断得到的变量。例如,从学生的学业表现评分推断其智力水平。
- 内生变量:也称因变量。例如在y = x1 + x2 + x3中,y 是内生变量,因为它取决于x1、x2、…、xn的取值。
- 外生变量:即自变量。例如,运动员的睡眠时长独立于所使用的公路赛车类型。
- 测量模型:用于刻画潜在构念与观测变量之间的关系。验证性因子分析框架用于检验测量模型的潜在假设。
- 结构模型:用于研究潜在构念之间的因果关系。通常通过路径分析以图示方式表示。
结构方程模型的统计假设
虽然 SEM 非常适合建模因果关系,但它对数据有一些前提假设,包括:
- 线性性:SEM 假设潜在构念与观测变量之间关系为线性。它不适用于非线性数据集,否则可能产生错误结果。
- 多重共线性:SEM 假设观测变量之间的多重共线性较小。例如,运动员的睡眠时长与营养摄入可能高度相关;SEM 假设这些变量之间的相关性较低。
- 抽样 假设:对于 SEM 任务,通常需要至少 200 的充分样本量以获得良好结果。虽然不需要像 LLM 那样的大规模数据集,但样本量过小可能导致不准确的结果。
- 多变量 正态性:SEM 假设数据服从多元正态分布。不适用于非正态数据。您可以进行检验以判断正态性。
- 缺失 数据:SEM 假设数据完整。 SEM 处理缺失数据的一种方式是假设数据随机缺失。缺失数据可能干扰模型估计。
- 设定 误差:SEM 假设所定义的模型被正确设定,即测量模型与结构模型至少包含所有相关变量。
结构方程模型的类型
结构方程模型有不同类型(无特定先后顺序):
- 路径分析:一种 SEM 类型,也是回归模型的扩展,仅处理观测变量(也称预测变量)。路径图用箭头直观展示这些关系的方向性。
- 验证性因子分析(CFA):一种用于检验测量模型效度的 SEM 类型。它用于验证观测数据是否符合预先设定的模型。
- 潜在变量结构模型(LVSM):建模潜在构念与观测变量之间的关系,同时也建模潜在构念之间的关系。
- 潜在增长模型:一种专门用于刻画随时间变化的 SEM 类型。用于研究潜在变量(如心理特质或行为)的变化轨迹,并同时考虑个体与群体层面的变化。
Python 中的结构方程模型示例
在 Python 中开发一个 SEM 模型只需几个步骤;我们可以使用 semopy 库来简化流程。以下教程假设您已熟悉 Python 语法。
安装必要的库
pip install semopy技术支持
注意:针对 macOS 用户。如果您在安装该软件包时遇到如下错误:
ExecutableNotFound: failed to execute PosixPath('dot'), make sure the Graphviz executables are on your systems' PATH技术支持
请在终端通过 homebrew 安装 graphviz
brew install graphviz技术支持
定义构念
在下载数据集并创建模型之前,先花一点时间定义我们的各个构念。也就是说,我们需要识别潜在变量与观测变量。在本数据集中,观测变量已作为带标签的特征提供,分别为 x1 到 x3 以及 y1 到 y8。我们要研究的潜在变量名称如下,稍后会解释其含义:ind60、dem60、dem65。
观测变量
潜在变量
-
ind60:工业化的外生潜在变量。
-
dem60:1960 年民主程度的内生潜在变量。
-
dem65:1965 年民主程度的内生潜在变量。
构建测量模型
目标是定义一个理论模型,来明确潜在构念与观测变量之间的关系。
ind60 =~ x1 + x2 + x3
demo60 =~ y1 + y2 + y3 + y4
dem65 =~ y5 + y6 + y7 + y8技术支持
设定结构模型
此处我们将设定潜在构念之间的关系。
dem60 ~ ind60
dem65 ~ ind60 + dem60技术支持
设定相关关系
此处我们要指定彼此高度相关的变量。
y1 ~~ y5
y2 ~~ y4
y2 ~~ y6
y3 ~~ y7
y4 ~~ y8
y6 ~~ y5技术支持
准备数据集
在本教程中,我们将使用 semopy 提供的 PoliticalDemocracy.csv 数据集。您可以通过访问该 GitHub 仓库进行下载。
Import pandas as pd
data = pd.read_csv('PoliticalDemocracy.csv')技术支持
定义 SEM 模型
我们需要将结构与测量的定义合并为一个模型规范。
model_spec = """
# Measurement model
ind60 =~ x1 + x2 + x3
dem60 =~ y1 + y2 + y3 + y4
dem65 =~ y5 + y6 + y7 + y8
# regressions
dem60 ~ ind60
dem65 ~ ind60 + dem60
# Correlations
y1 ~~ y5
y2 ~~ y4
y2 ~~ y6
y3 ~~ y7
y4 ~~ y8
y6 ~~ y5
"""技术支持
接下来,我们定义模型并拟合数据
import semopy
model = semopy.Model(model_spec)
model.fit(data)
print(model.inspect())技术支持
解读结果
我们将绘制模型结果,以理解路径表示。该图将保存为 political_sem_model.png。
semopy.semplot(model, 'political_sem_model.png')
print("SEM Model diagram saved as 'political_sem_model.png'.")
img = plt.imread('political_sem_model.png')
plt.imshow(img)
plt.axis('off')
plt.show()技术支持
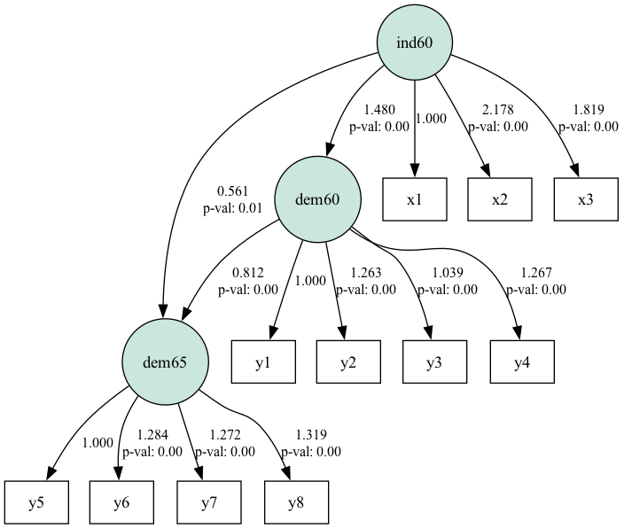
政治民主数据集的 SEM 路径图。来源:作者绘制
图中展示了路径如何连接潜在构念(圆形)与观测变量。路径系数越接近 1 或 -1,变量间关系越强;接近 0 则关系较弱。
表中的标准差处于合理范围。更大的数值可能表明多重共线性或模型设定不当。p 值用于判断路径系数的统计显著性;p 值小于 0.05 通常表示路径具有统计显著性。我们看到有 2 处 p 值大于 0.05。
总体而言,结果表明 ind60 对 dem60 有显著影响,而 dem60 反过来又对 dem65 有显著影响。
评估模型拟合度
为评估 SEM 的拟合度,假设模型应与观测到的关系相匹配。可使用多种拟合指标来评估模型与数据的拟合优度。常用指标包括:
- 卡方检验:比较观测协方差矩阵与模型隐含的协方差矩阵。非显著的卡方通常表示拟合良好。
- 近似均方根误差(RMSEA):评估模型在调整复杂度后对数据的近似拟合程度。小于 0.05 且不超过 0.08 的数值通常可接受。
SEM 的常见挑战与解决方案
结构方程模型方法的一些常见挑战包括:
- 数据非正态:SEM 通常假设数据服从正态分布。使用非正态数据可能影响标准误、p 值和拟合指数,导致不可靠的估计。可以采用数据变换技术使数据更接近正态。
- 缺失数据: SEM 需要完整数据。缺失数据会导致结果偏倚。您可以利用如全信息极大似然(FIML)等似然估计方法来处理。
- 模型拟合:当假设模型与观测数据不匹配时,会对变量关系产生误导性的解读。您可以基于理论对模型进行调整,或使用修正指数。
结论
本文深入回顾了 SEM 的应用、实现、优势与局限。SEM 是检验观测变量与潜在变量之间复杂关系及因果交互的有力工具。您不妨在下一次分析项目中用 Python 或 R 试一试。
如果您对结构方程模型的理念感兴趣但更偏好 R,可以学习用 R 中 lavaan 进行结构方程模型课程,其中包含详细的分步指导。您也可以开启R 统计学家职业路径。如果您专注于 Python,可查阅 semopy 文档以了解更多 Python 中 SEM 的用例。最后,如果您对既能预测又能解释的高级 Python 模型,以及模型结构与特征选择等主题感兴趣,欢迎尝试我们的Python 机器学习科学家职业路径。


结构方程模型(SEM)使我们能够研究变量之间的因果关系,并理解每个变量如何对整体表现做出贡献。SEM 将因子分析与多元回归分析相结合,用于分析多个变量之间的关系,是一项功能强大的工具。这有点类似于我们在日常生活中,会同时考虑体态、自信与沟通能力等因素如何共同影响面试表现。
接下来,我们将探索 SEM 的概念、应用,以及用 Python 实现的实用示例。如果您对一些核心概念(例如潜在因子)还不熟悉,也可以试试我们的因子分析课程。
什么是结构方程模型?
结构方程模型用于表征潜在变量与观测变量之间的因果关系。观测变量是我们可以直接测量的;潜在构念(latent constructs)则是据以推断、无法直接测量的。
为有效刻画这些关系,SEM 通常分为两个主要部分:测量模型与结构模型。测量模型用于刻画观测变量与其对应潜在变量之间的关系;结构模型则用于刻画潜在变量之间的关系。
研究者为何使用结构方程模型?
相关与回归等统计技术在研究复杂的多元关系时效率不足。SEM 适合对通过含误测量得到的复杂、多维构念进行建模。它还很有用,因为它有助于明确一个关系体系。传统方法帮助我们研究一个因变量与一组预测变量。虽然相关不等于因果,但 SEM 有助于我们理解观测变量与潜在构念之间的因果关系。
SEM 的一些应用包括:
结构方程模型的核心概念
以下是结构方程模型中的一些核心概念:
结构方程模型的统计假设
虽然 SEM 非常适合建模因果关系,但它对数据有一些前提假设,包括:
结构方程模型的类型
结构方程模型有不同类型(无特定先后顺序):
Python 中的结构方程模型示例
在 Python 中开发一个 SEM 模型只需几个步骤;我们可以使用
semopy库来简化流程。以下教程假设您已熟悉 Python 语法。安装必要的库
注意:针对 macOS 用户。如果您在安装该软件包时遇到如下错误:
请在终端通过 homebrew 安装
graphviz定义构念
在下载数据集并创建模型之前,先花一点时间定义我们的各个构念。也就是说,我们需要识别潜在变量与观测变量。在本数据集中,观测变量已作为带标签的特征提供,分别为
x1到x3以及y1到y8。我们要研究的潜在变量名称如下,稍后会解释其含义:ind60、dem60、dem65。观测变量
y1:新闻自由,1960 年y2:政治反对派自由,1960 年y3:选举公正性,1960 年y4:民选立法机关效能,1960 年y5-y8:分别与y1-y4相同的变量,于 1965 年测量x1:人均国民生产总值(GNP),1960 年x2:人均能源消耗量,1960 年x3:产业部门就业占比,1960 年潜在变量
ind60:工业化的外生潜在变量。dem60:1960 年民主程度的内生潜在变量。dem65:1965 年民主程度的内生潜在变量。构建测量模型
目标是定义一个理论模型,来明确潜在构念与观测变量之间的关系。
设定结构模型
此处我们将设定潜在构念之间的关系。
设定相关关系
此处我们要指定彼此高度相关的变量。
准备数据集
在本教程中,我们将使用
semopy提供的PoliticalDemocracy.csv数据集。您可以通过访问该 GitHub 仓库进行下载。定义 SEM 模型
我们需要将结构与测量的定义合并为一个模型规范。
接下来,我们定义模型并拟合数据
解读结果
我们将绘制模型结果,以理解路径表示。该图将保存为
political_sem_model.png。政治民主数据集的 SEM 路径图。来源:作者绘制
图中展示了路径如何连接潜在构念(圆形)与观测变量。路径系数越接近 1 或 -1,变量间关系越强;接近 0 则关系较弱。
表中的标准差处于合理范围。更大的数值可能表明多重共线性或模型设定不当。p 值用于判断路径系数的统计显著性;p 值小于 0.05 通常表示路径具有统计显著性。我们看到有 2 处 p 值大于 0.05。
总体而言,结果表明
ind60对dem60有显著影响,而dem60反过来又对dem65有显著影响。评估模型拟合度
为评估 SEM 的拟合度,假设模型应与观测到的关系相匹配。可使用多种拟合指标来评估模型与数据的拟合优度。常用指标包括:
SEM 的常见挑战与解决方案
结构方程模型方法的一些常见挑战包括:
结论
本文深入回顾了 SEM 的应用、实现、优势与局限。SEM 是检验观测变量与潜在变量之间复杂关系及因果交互的有力工具。您不妨在下一次分析项目中用 Python 或 R 试一试。
如果您对结构方程模型的理念感兴趣但更偏好 R,可以学习用 R 中 lavaan 进行结构方程模型课程,其中包含详细的分步指导。您也可以开启R 统计学家职业路径。如果您专注于 Python,可查阅 semopy 文档以了解更多 Python 中 SEM 的用例。最后,如果您对既能预测又能解释的高级 Python 模型,以及模型结构与特征选择等主题感兴趣,欢迎尝试我们的Python 机器学习科学家职业路径。