Lernpfad
Containerisierung hat die Art und Weise revolutioniert, wie Engineering-Teams Anwendungen managen und skalieren – besonders in Datenmanagement, Analytics und Machine Learning. Durch das Verpacken von Anwendungen in isolierte, schlanke Umgebungen sorgen Container für gleichbleibende Performance von der Entwicklung bis in den Betrieb.
Unter den verfügbaren Plattformen ist Docker die populärste Lösung. Durch Flexibilität und einfache Handhabung können Data Professionals reproduzierbare, skalierbare und effiziente Pipelines aufbauen und die Zusammenarbeit im Team fördern.
In diesem Artikel stellen wir dir einen praxisnahen Lernplan für Docker vor – inklusive der Schritte, um deine erste einfache Anwendung zu deployen. Los geht’s!
Was ist Docker und warum lohnt es sich, es zu lernen?
Docker ist eine Open-Source-Plattform, die Bereitstellung, Skalierung und Verwaltung von Anwendungen durch Containerisierung vereinfacht.
Container sind leichtgewichtige, portable Umgebungen, die alles enthalten, was eine Anwendung zum Laufen braucht – Code, Runtime, Bibliotheken und Einstellungen – und so konsistente Performance über unterschiedliche Systeme hinweg sicherstellen. In Datenprojekten wird Docker genutzt, um diese Container zu bauen und zu verwalten, sodass Anwendungen zuverlässig auf jeder Infrastruktur laufen.
Im Gegensatz zu virtuellen Maschinen (VMs), die ein eigenes Betriebssystem und einen Hypervisor benötigen, virtualisiert Docker nur die Anwendungsschicht. Dadurch starten Container schneller, benötigen weniger Ressourcen und sind einfacher zu konfigurieren.
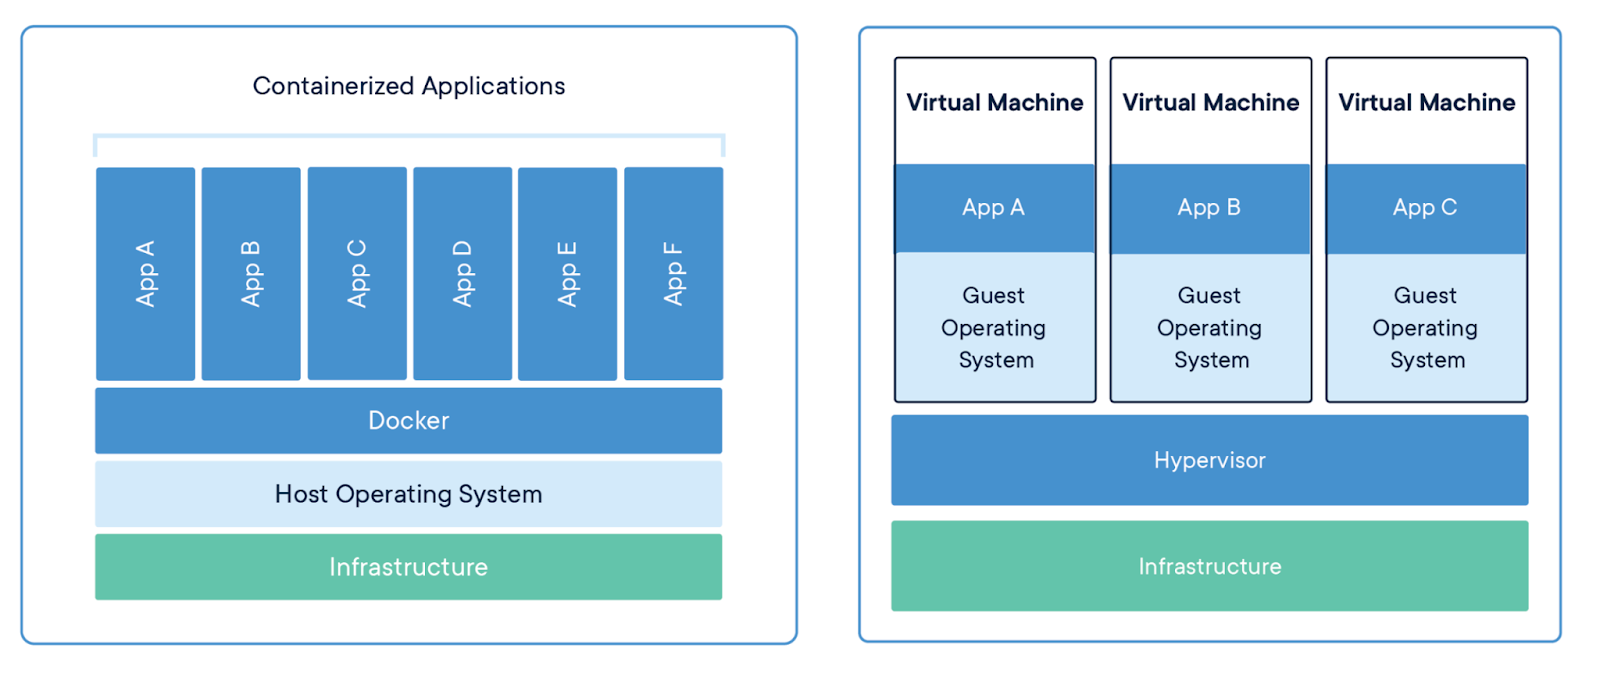
Containerisierte Anwendungen versus virtuelle Maschinen. Bildquelle: Docker
Für Data Professionals schafft Docker reproduzierbare Umgebungen und sorgt dafür, dass Datenpipelines von der Entwicklung bis in die Produktion einheitlich laufen. Es minimiert Abhängigkeitskonflikte, strafft Workflows und verbessert die Teamarbeit durch standardisierte, teilbare Umgebungen.
Außerdem integriert sich Docker mit beliebten Datentools wie Jupyter, TensorFlow und Apache Hadoop.
Wenn du Docker beherrschst, steigerst du deine Produktivität, optimierst Workflows und machst deine Projekte skalierbar und leicht ausrollbar!
Docker von Grund auf lernen: Dein erstes Deployment
Am besten lernst du Docker, indem du direkt loslegst. Ich führe dich jetzt durch dein erstes einfaches Deployment. Danach schauen wir uns Lernpläne an, um dein Wissen zu vertiefen.
Schritt 1: Zentrale Konzepte verstehen
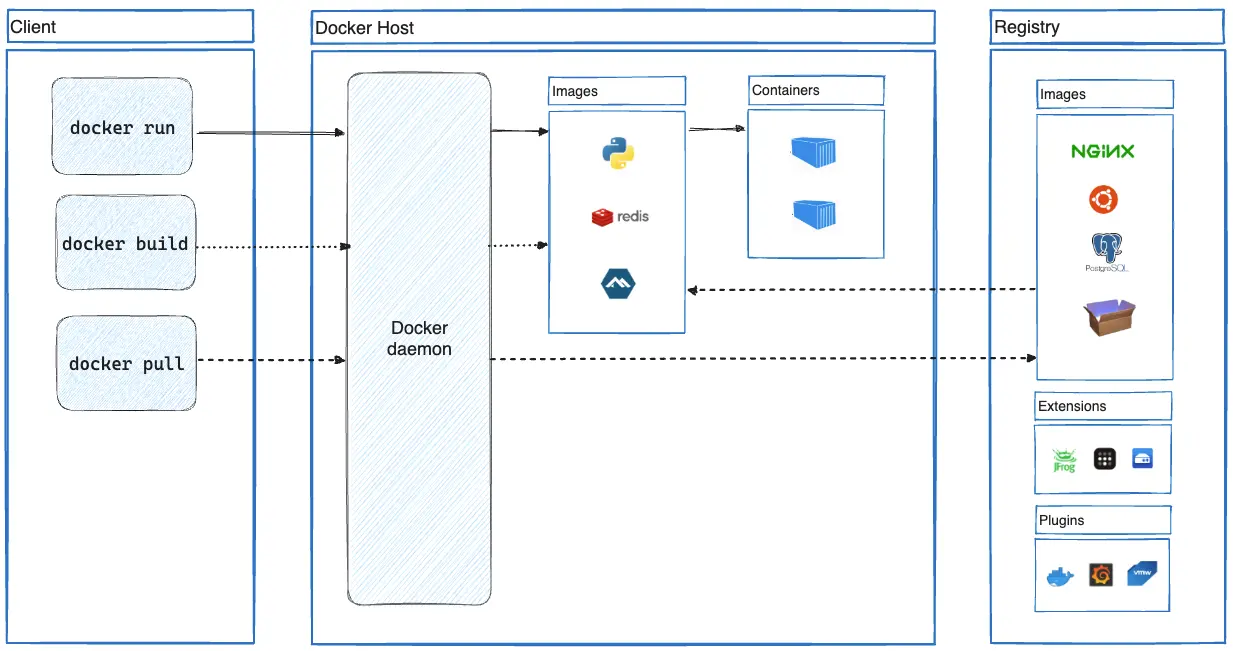
Bevor du praktisch mit Docker arbeitest, solltest du die wichtigsten Grundlagen kennen. Hier ist eine Übersicht der zentralen Docker-Konzepte:
- Container: Leichtgewichtige, isolierte Einheiten, die eine Anwendung inklusive aller Abhängigkeiten bündeln – so läuft sie in verschiedenen Umgebungen konsistent.
- Images: Ein Docker-Image ist ein schreibgeschütztes Template, aus dem Container erstellt werden. Es enthält alles zum Ausführen der Anwendung – inklusive Code, Bibliotheken und Systemtools. Images werden in der Regel aus Dockerfiles gebaut.
- Dockerfile: Eine Textdatei mit Anweisungen, wie ein Docker-Image gebaut wird. Sie beschreibt Schritte wie Software installieren, Dateien kopieren und die Umgebung konfigurieren.
- Docker Hub: Docker Hub ist ein öffentliches Registry, in dem du Docker-Images speichern, teilen und herunterladen kannst – der zentrale Ort für Distribution und Wiederverwendung vorkonfigurierter Umgebungen.
- Volumes: Mit Volumes persistierst du Daten, die in Docker-Containern erzeugt oder genutzt werden. So bleiben wichtige Daten über den Lebenszyklus eines Containers hinaus erhalten.
- Networks: Docker-Netzwerke ermöglichen die Kommunikation zwischen Containern. Jeder Container kann mit einem oder mehreren Netzwerken verbunden werden und so sicher Daten austauschen.

Überblick zur Docker-Architektur. Bildquelle: Docker
Dieses Basiswissen solltest du beherrschen, bevor du Anwendungen mit Docker deployest. Mit diesem Fundament wirst du in der Praxis deutlich schneller vorankommen.
Der Kurs Introduction to Docker kann dir dabei helfen, dein aktuelles Wissen gezielt zu festigen.
Schritt 2: Docker installieren
Um Docker zu nutzen, installierst du es zunächst auf deinem System. Unten findest du Anleitungen für verschiedene Plattformen. Für detaillierte Schritte folge der offiziellen Docker-Dokumentation.
1. Docker unter Windows installieren
Voraussetzungen:
- Windows 10 64-bit: Pro, Enterprise oder Education (Build 19041 oder höher)
- Windows 11 64-bit: Home, Pro, Enterprise oder Education
- WSL 2 Backend
Schritte:
1. WSL 2 (Windows Subsystem for Linux) aktivieren:
- PowerShell als Administrator öffnen.
- Folgende Befehle ausführen:
dism.exe /online /enable-feature /featurename:Microsoft-Windows-Subsystem-Linux /all /norestart
dism.exe /online /enable-feature /featurename:VirtualMachinePlatform /all /norestart wsl --set-default-version 2
2. Docker Desktop für Windows installieren:
- Docker Desktop von der offiziellen Website herunterladen.
- Installer ausführen und den Anweisungen folgen.
- Während der Installation WSL 2 als Standard-Backend auswählen.
3. Docker Desktop starten:
- Docker Desktop über das Startmenü öffnen.
- Docker sollte automatisch starten, sonst manuell starten.
4. Installation prüfen:
- PowerShell oder Eingabeaufforderung öffnen.
- Diesen Befehl ausführen, um die Installation zu prüfen:
sudo docker --version
Offizielle Dokumentation: Docker Desktop für Windows
2. Docker unter macOS installieren
Voraussetzungen:
- macOS 10.15 oder neuer
Schritte:
1. Docker Desktop für macOS herunterladen:
- Auf die offizielle Docker-Website gehen und den Docker-Desktop-Installer herunterladen.
2. Docker Desktop installieren:
- Die heruntergeladene
.dmg-Datei öffnen. - Das Docker-Icon in den Programme-Ordner ziehen.
3. Docker Desktop starten:
- Docker aus dem Programme-Ordner öffnen.
- Dem Installationsassistenten folgen und das Setup abschließen.
4. Installation prüfen:
- Ein Terminal öffnen.
- Folgenden Befehl ausführen, um die Docker-Installation zu prüfen:
docker --version
Offizielle Dokumentation: Docker Desktop für Mac
3. Docker unter Linux installieren
Unterstützte Distributionen:
- Ubuntu
- Debian
- Fedora
- CentOS
- RHEL
Schritte für Ubuntu/Debian:
1. Alte Versionen deinstallieren:
- Vor der Installation von Docker Engine störende Pakete mit diesem Befehl entfernen:
for pkg in docker.io docker-doc docker-compose podman-docker containerd runc; do sudo apt-get remove $pkg; done
2. Das apt-Repository von Docker einrichten:
- Folgende Befehle ausführen:
sudo apt-get update
sudo apt-get install ca-certificates curl
sudo install -m 0755 -d /etc/apt/keyrings
sudo curl -fsSL https://download.docker.com/linux/ubuntu/gpg -o /etc/apt/keyrings/docker.asc
sudo chmod a+r /etc/apt/keyrings/docker.asc
echo "deb [arch=$(dpkg --print-architecture) signed-by=/etc/apt/keyrings/docker.asc] https://download.docker.com/linux/ubuntu $(. /etc/os-release && echo "$VERSION_CODENAME") stable" | sudo tee /etc/apt/sources.list.d/docker.list > /dev/null
sudo apt-get update
3. Docker-Pakete installieren:
- Docker Engine und weitere Komponenten installieren:
sudo apt-get install docker-ce docker-ce-cli containerd.io docker-buildx-plugin docker-compose-plugin
4. Installation prüfen:
- Diesen Befehl ausführen, um zu prüfen, ob Docker installiert ist:
sudo docker --version
Offizielle Dokumentation: Docker Engine auf Debian
Werde Dateningenieur
Schritt 3: Starte deinen ersten Container
Jetzt, da Docker installiert ist, startest du deinen ersten Container. Wir beginnen mit dem einfachen hello-world-Image, ideal für den Einstieg.
1. Öffne dein Terminal (unter Windows Eingabeaufforderung) und führe folgenden Befehl aus:
sudo docker run hello-world
Dieser Befehl weist Docker an, lokal nach dem hello-world-Image zu suchen. Falls es nicht vorhanden ist, lädt Docker das Image aus dem Docker Hub und führt es anschließend aus.
Wenn Docker korrekt installiert ist, siehst du die Nachricht „Hello from Docker!“ sowie Details zum Ablauf. Damit ist bestätigt, dass Docker das Image gezogen, einen Container erstellt und den Code darin ausgeführt hat.
Schritt 4: Baue dein erstes Docker-Image
In diesem Schritt erstellst du ein eigenes Docker-Image für ein kleines Data-Science-Projekt. Das Image enthält Python und gängige Data-Science-Bibliotheken wie pandas, NumPy und scikit-learn.
1. Lege ein neues Verzeichnis an:
-
- Erstelle ein neues Projektverzeichnis und wechsle hinein:
mkdir my-data-science-app
cd my-data-science-app
2. Erstelle ein Dockerfile:
Lege in diesem Verzeichnis eine Datei namens Dockerfile an (ohne Dateiendung):
# Use an official Python runtime as a parent image
FROM python:3.8-slim
# Set the working directory in the container
WORKDIR /app
# Copy the current directory contents into the container at /app
COPY . /app
# Install any needed packages specified in requirements.txt
RUN pip install --no-cache-dir -r requirements.txt
# Make port 8888 available to the world outside this container
EXPOSE 8888
# Run a Jupyter notebook server when the container launches
CMD ["jupyter", "notebook", "--ip=0.0.0.0", "--port=8888", "--no-browser", "--allow-root"]
Das Dockerfile macht Folgendes:
FROM python:3.8-slim: Setzt das Basis-Image auf Python 3.8 in der schlanken Variante – ideal für eine leichtgewichtige Data-Science-Umgebung.WORKDIR /app: Legt das Arbeitsverzeichnis im Container auf /app fest. Alle folgenden Befehle laufen dort.COPY . /app: Kopiert alle Dateien aus deinem aktuellen Host-Verzeichnis in das Verzeichnis/appim Container. Typischerweise sind das deine Skripte und Konfigurationen.RUN pip install --no-cache-dir -r requirements.txt: Installiert die inrequirements.txtgelisteten Python-Bibliotheken. Üblich sind pandas, NumPy und scikit-learn.EXPOSE 8888: Öffnet Port 8888 zum Host – der Standardport für Jupyter Notebooks.CMD ["jupyter", "notebook", "--ip=0.0.0.0", "--port=8888", "--no-browser", "--allow-root"]: Startet beim Container-Start einen Jupyter-Notebook-Server, auf den du im Browser zugreifen kannst.
3. Erstelle die Datei requirements.txt:
Lege im selben Verzeichnis eine requirements.txt an und liste die benötigten Python-Pakete auf:
pandas
numpy
scikit-learn
matplotlib
Diese Datei definiert die Python-Bibliotheken, die im Container installiert werden.
4. Docker-Image bauen:
- Baue dein Docker-Image mit folgendem Befehl, sobald Dockerfile und
requirements.txtbereit sind:
sudo docker build -t my-data-science-app .
Der obige Befehl macht Folgendes:
docker build: Startet den Build-Prozess für ein Docker-Image.-t my-data-science-app: Vergibt mit -t das Tag „my-data-science-app“..: Der Punkt definiert den Build-Kontext, also das aktuelle Verzeichnis. Docker nutzt dessen Dateien für den Build.
5. Docker-Image ausführen:
Nach dem Build kannst du dein neues Image als Container starten:
sudo docker run -p 8888:8888 my-data-science-app
Das bedeutet im Detail:
docker run: Startet einen Container auf Basis des angegebenen Images.-p 8888:8888: Mappt Port 8888 deines Rechners auf Port 8888 im Container, damit du vialocalhost:8888auf Jupyter Notebook zugreifen kannst.my-data-science-app: Das auszuführende Image.
Schritt 5: Docker Compose nutzen
Docker Compose ist unverzichtbar, um Multi-Container-Anwendungen zu verwalten. In Data-Science-Projekten brauchst du oft getrennte Container für verschiedene Komponenten – etwa Jupyter, eine Datenbank zur Speicherung und ein Visualisierungstool.
Mit Docker Compose definierst du diese Services in einer YAML-Datei und startest deine gesamte Umgebung mit einem einzigen Befehl.
1. Erstelle eine docker-compose.yml-Datei:
- Lege im Projektverzeichnis eine Datei
docker-compose.ymlan und füge folgende Zeilen ein:
version: '3.8'
services:
jupyter:
image: jupyter/scipy-notebook:latest
volumes:
- ./notebooks:/home/joelwembo/work
ports:
- "8888:8888"
environment:
- JUPYTER_ENABLE_LAB=yes
postgres:
image: postgres:13-alpine
environment:
POSTGRES_USER: myuser
POSTGRES_PASSWORD: mypassword
POSTGRES_DB: mydatabase
volumes:
- postgres_data:/var/lib/postgresql/data
ports:
- "5432:5432"
redis:
image: redis:alpine
ports:
- "6379:6379"
volumes:
postgres_data:
Das macht die Docker-Compose-Datei im Einzelnen:
version: '3.8': Definiert die Version des Compose-Dateiformats. 3.8 ist weit verbreitet und funktionsreich.services:: Hier definierst du die verschiedenen Container (Services) deiner Anwendung.jupyter:: Service für eine Jupyter-Notebook-Umgebung zur interaktiven Datenanalyse.image: jupyter/scipy-notebook:latest: Verwendet ein Jupyter-Image mit beliebten Data-Science-Bibliotheken wie NumPy, pandas und matplotlib.volumes: - ./notebooks:/home/joelwembo/work: Bindet das Notebooks-Verzeichnis vom Host nach/home/joelwembo/workim Container ein, um Notebooks zu persistieren und zu teilen. Hinweis: Das ist mein persönlicher Pfad – bei dir sieht er anders aus.ports: - "8888:8888": Mappt Port 8888 des Hosts auf Port 8888 im Container – Standard für Jupyter.environment: - JUPYTER_ENABLE_LAB=yes: Aktiviert JupyterLab als leistungsfähigere Oberfläche.postgres:: Service für eine PostgreSQL-Datenbank, häufig zur Verwaltung großer Datensätze.image: postgres:13-alpine: PostgreSQL 13 auf Basis von Alpine Linux (leichtgewichtig).environment:: Umgebungsvariablen für Benutzer, Passwort und Datenbankname.volumes: - postgres_data:/var/lib/postgresql/data: Bindet ein Volume ein, um Daten der Datenbank persistent zu speichern.ports: - "5432:5432": Mappt den Standardport von PostgreSQL (5432) auf den Host.redis:: Service für einen Redis-Server als schneller In-Memory-Store oder Cache.image: redis:alpine: Redis-Image auf Basis von Alpine.ports: - "6379:6379": Mappt den Standardport von Redis.volumes:: Definiert benannte Volumes, die zwischen Services geteilt oder über Neustarts erhalten bleiben können.postgres_data:: Erzeugt ein benanntes Volume für PostgreSQL-Daten.
Um deine Multi-Container-App zu starten, genügt folgender Befehl:
sudo docker compose up
Der Befehl baut (falls nötig) die Images und startet die in docker-compose.yml definierten Container. So laufen Webanwendung und Redis zusammen und können gemäß Konfiguration miteinander kommunizieren.
Du hast soeben deine erste Docker-Anwendung deployed! Stark, oder? Jetzt entwickeln wir einen Plan für dein kontinuierliches Lernen.
Ein Beispiel-Lernplan für Docker
Hier ist ein Wochenplan, dem du folgen kannst. Passe ihn gern an deine Bedürfnisse an.
Wenn du einen klareren Lernpfad brauchst, ist der Containerization and Virtualization with Docker and Kubernetes Skill Track perfekt für dich. Er umfasst vier essenzielle Kurse.
Woche 1: Mit den Docker-Grundlagen vertraut werden
- Ziel: Die Kernkonzepte von Docker und grundlegende Befehle verstehen.
- Aufgaben:
- Docker installieren und Docker Desktop einrichten.
- Docker-Befehle lernen:
docker run,docker ps,docker stop,docker rmusw. - Einfache Container für Tools wie Ubuntu oder Alpine starten und Basisbefehle ausprobieren.
- Offizielle Docker-Images erkunden und Container für einfache Visualisierungstools starten (z. B. ein schlichtes matplotlib-Setup).
- Ressourcen: Containerization and Virtualization Concepts Kurs, Introduction to Docker Kurs.
Woche 2: Docker-Images für Datentools bauen und ausführen
- Ziel: Eigene Docker-Images erstellen und verwalten.
- Aufgaben:
- Ein Dockerfile für eine Basis-Data-Analysis-Umgebung schreiben (z. B. Python mit pandas und NumPy).
- Das Docker-Image mit docker build erstellen.
- Container aus deinem Image starten und Tools wie Jupyter Notebook testen.
- Dockerfiles für TensorFlow und PostgreSQL erstellen, inkl. korrekter Konfiguration und Verknüpfung.
- Ressourcen: Introduction to Docker Kurs.
Woche 3: Docker Compose erkunden
- Ziel: Docker Compose für Multi-Container-Setups verstehen und nutzen.
- Aufgaben:
- Docker Compose installieren und die Grundlagen lernen.
docker-compose.yml-Dateien schreiben, um Multi-Container-Anwendungen zu definieren.- Mit Beispielen üben – z. B. eine Webanwendung mit Datenbank-Backend (Flask + PostgreSQL).
- Mit verschiedenen Konfigurationen und Service-Abhängigkeiten experimentieren.
- Ressourcen: Intermediate Docker Kurs.
Woche 4: Tiefer einsteigen in Docker Networking und Volumes
- Ziel: Docker-Netzwerke und Speicheroptionen meistern.
- Aufgaben:
- Docker-Netzwerke verstehen und erstellen (bridge, host, overlay).
- Eigene Netzwerke anlegen und Container verbinden.
- Docker-Volumes für persistente Speicherung erkunden und managen.
- Ein Setup implementieren, in dem Container über ein Custom-Netzwerk kommunizieren und Volumes zur Persistenz nutzen.
- Ressourcen: Intermediate Docker Kurs.
Woche 5: Docker-Container in Produktion deployen und betreiben
- Ziel: Container-Deployment und -Betrieb in Produktionsumgebungen verstehen.
- Aufgaben:
- Best Practices für das Bereitstellen von Containern lernen (z. B. Docker Hub oder private Registry).
- Container-Orchestrierung mit Docker Swarm erkunden: Services erstellen und verwalten.
- Container skalieren und Logs verwalten.
- Eine containerisierte Anwendung in Staging oder Produktion deployen.
- Ressourcen: Intermediate Docker Kurs.
Woche 6: Einführung in Kubernetes zur Container-Orchestrierung
- Ziel: Kubernetes kennenlernen, um containerisierte Anwendungen zu skalieren und zu managen.
- Aufgaben:
- Eine lokale Kubernetes-Umgebung einrichten (z. B. Minikube oder Kind).
- Kubernetes-Grundlagen lernen: Pods, Services, Deployments und Namespaces.
- Eine einfache containerisierte Anwendung auf Kubernetes deployen.
- Skalierung und Betrieb mit Kubernetes erkunden – z. B. den Umgang mit einem containerisierten Tool wie Jupyter.
- Ressourcen: Introduction to Kubernetes Kurs.
Tipps und Wege, Docker zu lernen
Zum Schluss ein paar Tipps und Best Practices, die deinen Lernweg mit Docker beschleunigen.
Regelmäßig üben
Konsequente Praxis ist der Schlüssel, um Docker zu meistern. Starte mit kleinen persönlichen Projekten, etwa indem du eine einfache Website containerisierst oder eine lokale Entwicklungsumgebung aufsetzt.
Mit wachsender Routine kannst du dich an komplexere Aufgaben wagen – zum Beispiel eine Multi-Container-Anwendung bauen oder einen Webserver deployen.
Regelmäßiges Experimentieren mit verschiedenen Use Cases – etwa eigene Docker-Images erstellen oder eine CI/CD-Pipeline konfigurieren – vertieft dein Verständnis und festigt die Kernkonzepte. Auch Online-Challenges oder Übungen zu Docker sind ideal, um deine Kompetenzen strukturiert und zielgerichtet zu testen und auszubauen.
Online-Ressourcen nutzen
Online-Ressourcen sind unbezahlbar für den Docker-Einstieg. Die offizielle Docker-Dokumentation ist ein hervorragender Startpunkt mit fundierten, aktuellen Inhalten.
Darüber hinaus gibt es viele umfassende Kurse auf Plattformen wie DataCamp, die dich strukturiert durchs Lernen führen.
Wenn du visuell lernst, bieten YouTube-Tutorials vom offiziellen Docker-Kanal und anderen Lehrenden leicht zugängliche Inhalte zur Vertiefung.
Der Docker-Community beitreten
Der Austausch mit der Docker-Community bringt dich schnell weiter. Nimm an Foren wie den Docker Community Forums oder Reddit teil, um Ideen zu teilen, Fragen zu stellen und Erfahrungen mit anderen Lernenden und Profis auszutauschen.
Auch Meetups, Webinare oder Konferenzen helfen dir, am Puls der Zeit zu bleiben und dein Netzwerk zu erweitern.
An Open-Source-Projekten mitarbeiten
Beiträge zu Open-Source-Projekten, die Docker einsetzen, sind großartig, um praxisnahe Erfahrung zu sammeln.
Auf GitHub findest du zahlreiche Möglichkeiten zur Zusammenarbeit an Docker-Projekten. So lernst du von anderen und setzt deine Skills in unterschiedlichen Kontexten ein. Die Kollaboration zeigt dir verschiedene Herangehensweisen und Lösungen – ideal, um Dockers Möglichkeiten besser zu verstehen.
Up to date bleiben
Bleib außerdem über aktuelle Entwicklungen bei Docker informiert. Lies den offiziellen Blog und die Release Notes für neue Features oder Änderungen. Diskussionen in Foren und sozialen Medien halten dich zudem über Trends und Best Practices auf dem Laufenden – so schärfst du deine Docker-Kompetenzen kontinuierlich.
Mit regelmäßiger Praxis, aktiver Community-Beteiligung und kontinuierlichem Lernen baust du ein starkes Docker-Fundament auf und bist für neue Entwicklungen bestens gerüstet.
Fazit
Docker hat Deployment und Datenmanagement neu definiert, indem Anwendungen samt Abhängigkeiten in isolierten Containern gebündelt werden. Damit löst du typische Probleme wie inkonsistente Umgebungen und sorgst für konsistente, skalierbare und effiziente Workflows – ideal für Data Professionals.
Dieser Guide hat dir die Grundlagen bis hin zum praktischen Deployment vermittelt. Um noch tiefer einzusteigen, schau dir die Kurse Introduction to Docker und Intermediate Docker auf DataCamp an. Wenn du weitergehende Orchestrierung beherrschen willst, ist Kubernetes genauso wichtig – starte mit dem Kurs Introduction to Kubernetes.
Wenn du regelmäßig übst, Ressourcen nutzt und dich mit der Community austauschst, schöpfst du das volle Potenzial von Docker für komplexe Datenumgebungen aus.
Lass dich für deine Traumrolle als Data Engineer zertifizieren
Unsere Zertifizierungsprogramme helfen dir, dich von anderen abzuheben und potenziellen Arbeitgebern zu beweisen, dass deine Fähigkeiten für den Job geeignet sind.

FAQs
Wie lange dauert es, Docker zu lernen?
Wie lange es dauert, Docker zu lernen, hängt von deiner Vorerfahrung ab. Für Einsteiger genügen ein paar Tage, um die Basics wie Container, Images und Dockerfiles zu verstehen. Für ein tieferes Verständnis – inklusive Docker Compose und Kubernetes – plane einige Wochen mit regelmäßiger Praxis ein.
Muss ich nach Docker auch Kubernetes lernen?
Docker ist die Basis der Containerisierung, doch Kubernetes ist wertvoll, um große Deployments über viele Container hinweg zu orchestrieren und zu managen. Nachdem du Docker gemeistert hast, ist Kubernetes sehr zu empfehlen – vor allem für komplexe Anwendungen oder wenn du Skalierung und Container-Management automatisieren willst.
Welche Projekte eignen sich, um Docker zu üben?
Für praktische Erfahrung mit Docker kannst du mit kleinen Projekten starten – etwa eine persönliche Website containerisieren oder eine lokale Entwicklungsumgebung für eine Web-App aufsetzen. Später kannst du eine Multi-Container-Anwendung mit Docker Compose bauen oder eine einfache CI/CD-Pipeline deployen. Übe außerdem, indem du zu Open-Source-Projekten beiträgst, die Docker nutzen.
Ist Docker für Data Professionals notwendig?
Ja, Docker ist für Data Professionals äußerst nützlich. Du baust damit reproduzierbare Umgebungen, sodass deine Datenpipelines von Dev bis Prod konsistent funktionieren. Docker vereinfacht das Abhängigkeitsmanagement und fördert die Zusammenarbeit – ein zentrales Tool für moderne Daten-Workflows.
Welche Ressourcen sind am besten, um Docker zu lernen?
Zu den besten Ressourcen für den Einstieg in Docker gehören:
- Die offizielle Dokumentation von Docker
- DataCamps Introduction to Docker und Intermediate Docker Kurse
- YouTube-Tutorials vom offiziellen Docker-Kanal
- Docker-Community-Foren und GitHub-Repositories für Praxis und Zusammenarbeit
AWS Certified Cloud Solutions Architect, DevOps, Cloud Engineer mit umfassenden Kenntnissen der Hochverfügbarkeitsarchitektur und -konzepte. Ich kenne mich mit Cloud-Engineering und DevOps aus und bin versiert darin, Open-Source-Ressourcen zur Ausführung von Unternehmensanwendungen zu nutzen. Ich entwickle cloudbasierte Anwendungen mit AWS, AWS CDK, AWS SAM, CloudFormation, Serverless Framework, Terraform und Django.
