Curso
Introducción a la importación de datos en Python
3 h
340.8K
Con el aumento del volumen, la variedad y la velocidad de los datos, centrarse en crear conjuntos de datos de calidad y bien estructurados es más importante que nunca, ya que influyen directamente en la precisión de los insights y en la eficacia de las decisiones en cualquier sector.
Unos datos mal organizados o con errores pueden llevar a conclusiones equivocadas y suponer pérdidas de tiempo, dinero y recursos. Aquí es donde el data wrangling entra en juego como el proceso esencial que convierte datos en bruto y desestructurados en un formato limpio y ordenado, listo para su análisis.
El data wrangling comprende una serie de pasos para garantizar que los datos sean precisos, fiables y estén adaptados a las necesidades concretas del análisis. Dominarlo te permite aprovechar todo el potencial de tus datos y convertirlos en insights accionables que impulsan decisiones informadas y, en última instancia, mejores resultados.
El data wrangling es el proceso de transformar datos en bruto a un formato más utilizable. Implica limpiar, estructurar y enriquecer los datos para dejarlos listos para el análisis.
Imagina que recibes un dataset enorme: está desordenado, con valores ausentes, incoherencias e información irrelevante. El data wrangling es como un conjunto de herramientas que te ayuda a poner en orden esos datos para que queden organizados y consistentes.
El data wrangling es clave para asegurar que tus datos tengan calidad y estén bien estructurados, algo imprescindible para un análisis fiable. Los datos limpios y estructurados son la base de todos los pasos posteriores del flujo de trabajo de datos: desde crear un modelo de aprendizaje automático hasta generar visualizaciones o realizar análisis estadísticos.
Los datos de calidad reducen el riesgo de errores y sesgos en el análisis, lo que se traduce en insights más sólidos. Entender su importancia es fundamental, porque impacta directamente en la validez de las decisiones que se toman a partir de esos datos.
Un mal data wrangling puede derivar en conclusiones erróneas con consecuencias importantes en aplicaciones reales. Por eso, dominar este proceso es imprescindible para cualquiera que quiera tomar decisiones basadas en datos.
El data wrangling suele incluir 5 pasos principales:
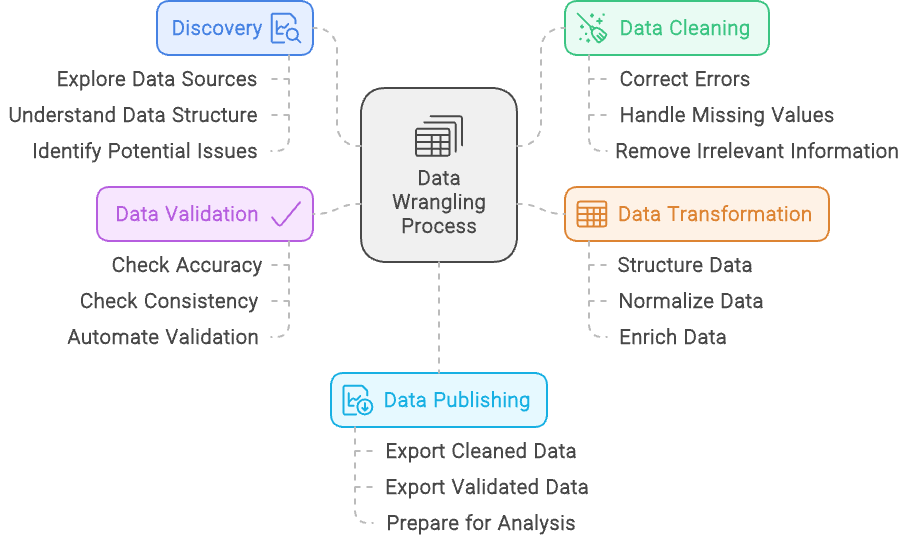
El proceso de data wrangling - creado con Napkin.ai
Ya hemos visto los cinco pasos, pero vamos a profundizar en cada uno:
La fase de descubrimiento en data wrangling es como observar un puzle antes de empezar a montarlo. Consiste en examinar el dataset para entender con qué estás trabajando: tipos de datos, fuentes y estructura.
Igual que clasificarías las piezas por color o por bordes, el descubrimiento te ayuda a categorizar y reconocer patrones en los datos, sentando las bases para el trabajo posterior.
También sirve para detectar posibles problemas, como piezas que faltan o colores que no encajan en el puzle.
En este paso identificas incidencias en los datos, como incoherencias, valores ausentes o patrones inesperados. Detectarlas a tiempo te permite planificar cómo abordarlas en los pasos siguientes y llegar antes a un dataset limpio y utilizable.
La limpieza de datos consiste en depurar tu dataset para asegurar que sea preciso y fiable.
Incluye tareas como corregir errores, gestionar valores ausentes y resolver incoherencias. Por ejemplo, si tu dataset contiene entradas duplicadas de una misma persona o transacción, la limpieza implica eliminarlas para no sesgar los resultados.
Además, si detectas formatos inconsistentes (como números de teléfono con distintos formatos), los estandarizas a uno único. El objetivo es mejorar la calidad e integridad del dato para habilitar un análisis preciso y con sentido.
La transformación de datos es el proceso de modificar y mejorar el dataset para ajustarlo a los requisitos del análisis. Implica estructurar los datos, por ejemplo, reconfigurándolos al formato deseado o combinando varias fuentes en una estructura coherente.
La normalización es otra pieza clave: ajustar valores a una escala o formato común, como convertir todas las divisas a una moneda única o unificar unidades de medida.
También incluye enriquecer el dataset añadiendo variables nuevas o integrando fuentes externas para aportar más contexto o insights. Por ejemplo, puedes calcular métricas a partir de datos existentes o incorporar información adicional de otras bases de datos para tener una visión más completa.
El objetivo es preparar los datos para que su uso sea más útil y relevante de cara a un análisis en profundidad.
La validación de datos verifica la exactitud y la fiabilidad del dataset mediante comprobaciones sistemáticas y procesos automatizados. Es un paso crítico para confirmar que los datos son correctos y consistentes.
Durante la validación realizas diversas comprobaciones para detectar discrepancias, como comparar con valores de referencia o validar frente a reglas y restricciones predefinidas. Los procesos automáticos pueden incluir scripts que señalen anomalías o incoherencias y verifiquen que los datos cumplen formatos y rangos esperados.
La meta es detectar problemas antes de usar los datos en el análisis, evitando que los errores contaminen los resultados. Al verificar rigurosamente la precisión y fiabilidad, te aseguras de que los insights se basen en información de confianza.
La publicación de datos es el último paso del proceso, cuando los datos limpios y estructurados se ponen a disposición para el análisis y la toma de decisiones. Supone preparar los datos para su difusión, a menudo creando cuadros de mando, informes o visualizaciones interactivas que los hagan accesibles y comprensibles para las partes interesadas.
En esta etapa puedes configurar canalizaciones o interfaces que permitan consultar e interactuar con los datos, entregándolos en el formato que mejor se ajuste a cada necesidad.
El objetivo es ofrecer insights claros y accionables que faciliten decisiones informadas y una comunicación eficaz de hallazgos en toda la organización. Publicar bien los datos garantiza que el esfuerzo del data wrangling se traduzca en resultados útiles y prácticos.
Los términos data wrangling y data cleaning suelen usarse como sinónimos, pero se refieren a aspectos distintos de la preparación de datos. Aunque ambos son esenciales, cumplen funciones diferentes y conllevan tareas distintas. Entender la diferencia aclara sus roles y ayuda a gestionar cada parte con eficacia.
Data wrangling es un proceso integral que transforma los datos en bruto en un formato adecuado para el análisis. Abarca varias etapas: adquisición, estructuración, limpieza y validación. Su objetivo es preparar datos de fuentes diversas para analizarlos y extraer insights con eficacia. Garantiza que los datos estén organizados, sean precisos y estén listos para un análisis detallado.
Data cleaning, por su parte, es un subconjunto específico del data wrangling. Se centra únicamente en mejorar la calidad del dato corrigiendo errores e incoherencias. Incluye tareas como eliminar duplicados, corregir erratas, gestionar valores ausentes y estandarizar formatos. Aunque es una parte crucial, es solo uno de los pasos dentro del proceso más amplio.
En pocas palabras, el data wrangling es el marco general que prepara los datos para el análisis, con múltiples pasos para abordar distintos aspectos. El data cleaning es un componente de ese marco, dedicado específicamente a mejorar la precisión y la consistencia del dato.
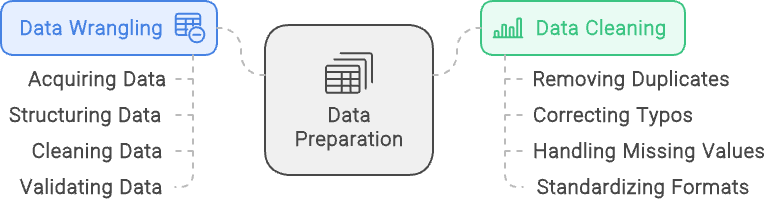
Data wrangling vs. data cleaning: el data wrangling se centra en estructurar y validar los datos, mientras que el data cleaning se enfoca en garantizar datos limpios y de calidad. Imagen creada con napkin.ai
Hay muchas formas de hacer data wrangling: desde herramientas básicas con interfaz gráfica como Excel o Alteryx hasta programación con lenguajes como R y Python. Aquí exploramos varias opciones.
Para tareas sencillas, hojas de cálculo como Microsoft Excel y Google Sheets son la opción habitual. Son muy accesibles y ofrecen una interfaz familiar, ideal para ordenar, filtrar y hacer limpiezas básicas. Son especialmente útiles con datasets pequeños o para quienes empiezan en data wrangling.
Gracias a sus funciones y fórmulas integradas, permiten calcular y manipular datos rápidamente sin grandes conocimientos técnicos.
Para manipulaciones complejas y automatización, Python y R son ampliamente utilizados. Python, con librerías potentes como Pandas, NumPy y OpenRefine, es excelente para manejar grandes volúmenes de datos y realizar transformaciones complejas.
R, con paquetes como dplyr y tidyr, es otra gran opción, muy valorada en entornos estadísticos y académicos por su potencia analítica. Ambos lenguajes ofrecen gran flexibilidad para crear flujos personalizados y automatizar tareas repetitivas, ideales cuando las necesidades de wrangling son más sofisticadas.
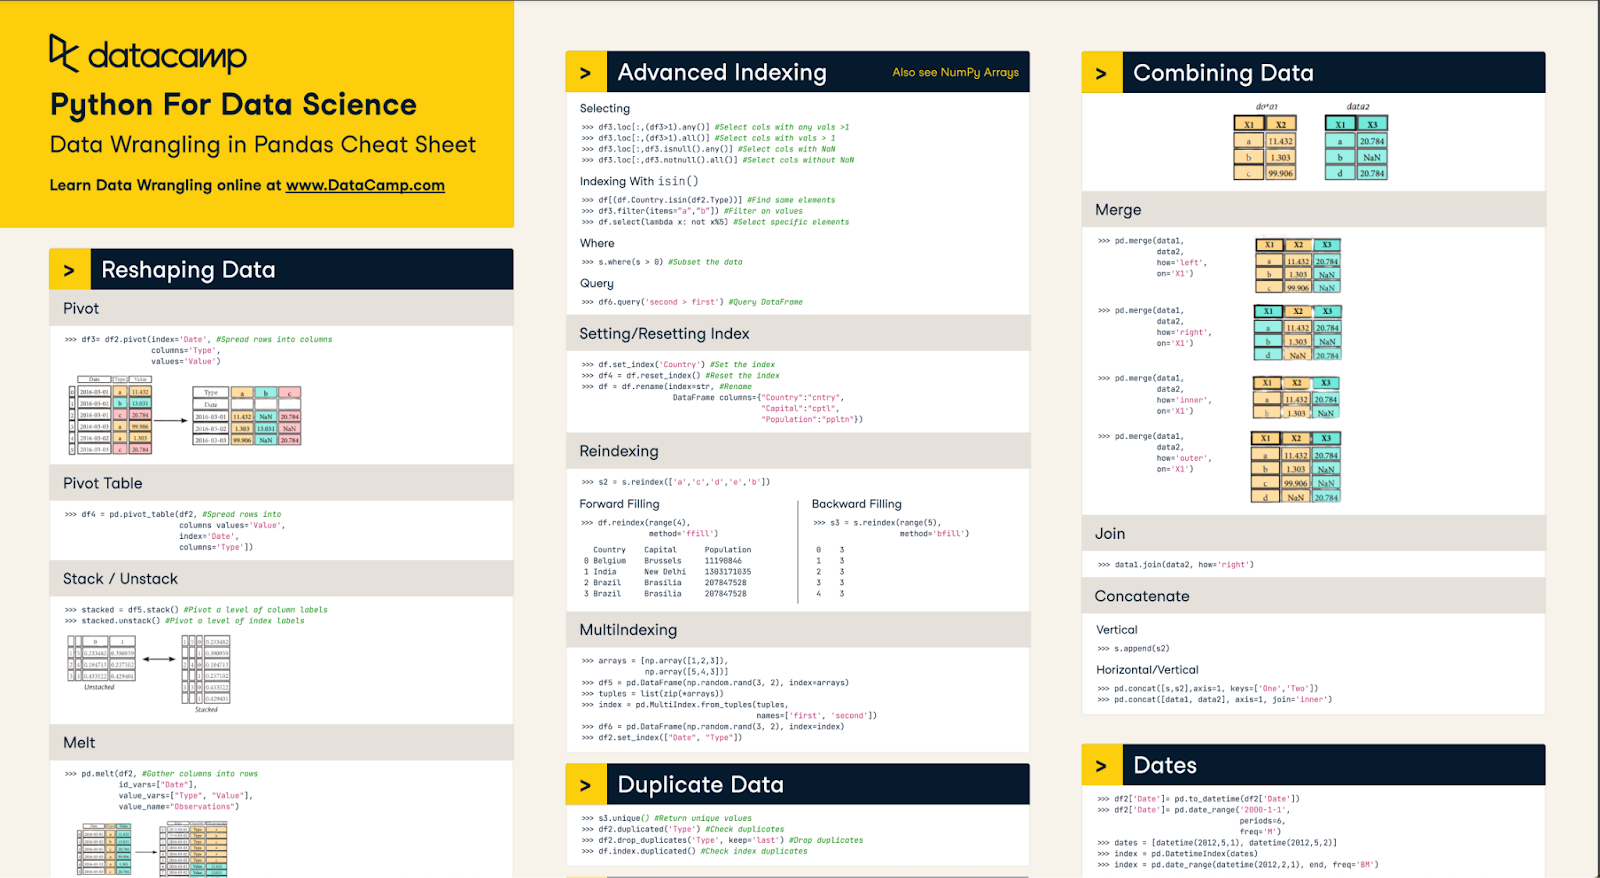
Nuestra chuleta de data wrangling con Pandas te ayudará a dominar muchos básicos
Las herramientas dedicadas están pensadas para agilizar el data wrangling y ofrecen funciones avanzadas que simplifican tareas complejas. Son ideales para quien necesita soluciones potentes y accesibles para limpiar, estructurar y preparar datos sin programar en profundidad.
Alteryx es una de las líderes, con una interfaz de arrastrar y soltar que permite depurar, combinar y transformar datos de múltiples fuentes con facilidad. Incluye multitud de herramientas integradas para filtrar, unir y agregar datos.
La versión en la nube, Alteryx Designer Cloud, amplía estas capacidades con una plataforma escalable y colaborativa. Permite a los equipos trabajar en tiempo real con grandes volúmenes y flujos complejos en distintos entornos. En local o en la nube, Alteryx garantiza datos bien preparados y listos para un análisis de valor.
Para proyectos de datos de extremo a extremo, plataformas integradas como KNIME, Apache NiFi y Microsoft Power BI son habituales. No solo cubren el wrangling, también ofrecen integración, análisis y visualización en un mismo entorno.
KNIME destaca por su interfaz modular basada en nodos para construir flujos complejos de forma visual. Apache NiFi es excelente gestionando y automatizando flujos de datos entre sistemas, mientras que Power BI combina preparación de datos con potentes visualizaciones. Son ideales cuando hace falta preparar, analizar y compartir datos sin fricciones, con un enfoque holístico para la toma de decisiones basada en datos.
Hay muchas opciones para hacer data wrangling con Python. Dos paquetes principales son Pandas y NumPy. Ambos incorporan herramientas potentes para aplicar fácilmente técnicas clave de wrangling a tus datasets.
Gran parte del procesamiento de datos sucede en Python, así que dominar estos paquetes es esencial para cualquier profesional de datos. Entre las técnicas clave: limpieza a alto nivel (p. ej., eliminar nulos), combinación de datasets y gestión de valores ausentes.
A menudo hay que limpiar los datos en Python antes de utilizarlos. Esto puede incluir eliminar espacios en blanco sobrantes en cadenas, suprimir valores nulos o corregir tipos de datos, entre otros.
Cada dataset es distinto y tendrá sus necesidades, así que explóralo para entender si requiere limpieza adicional. Practicar técnicas y habilidades de código es una gran manera de aprender las distintas formas de limpiar datos en Python.
Al limpiar cadenas, un problema frecuente son los espacios en blanco al inicio o al final. Esto puede generar fallos al parsear por longitud, posición o coincidencia. La mejor forma de tratarlo es usar el método str.strip() sobre una serie.
# Example utilizes a pandas series
# If working with a dataframe, call the series using df[col] syntax
s = pd.Series(['1. Ant.  ', '2. Bee!\n', '3. Cat?\t', np.nan, 10, True])
# It is important to include the .str or else the method will not work
s.str.strip()
Eliminar valores nulos en Pandas es sencillo. Más adelante veremos cómo rellenarlos. Puedes usar el método dropna(). Tiene parámetros opcionales para definir las condiciones exactas para eliminar filas/columnas, pero por defecto elimina cualquier fila con algún valor nulo.
# For any dataframe
df = pd.DataFrame({"name": ['Alfred', 'Batman', 'Catwoman'],
                   "toy": [np.nan, 'Batmobile', 'Bullwhip'],
                   "born": [pd.NaT, pd.Timestamp("1940-04-25"), pd.NaT]}
df.dropna()
El método .astype() permite cambiar el tipo de datos de una serie, pero corregir tipos es algo más delicado: hay que asegurar que cada valor de la serie de Pandas cumpla el tipo objetivo.
Por ejemplo, convertir una serie de tipo objeto a entero implica que todos sus valores sean enteros. Si hay uno solo que no lo sea, el método dará error. Puedes forzarlo convirtiendo valores inválidos a nulos, pero quizá convenga investigar por qué algunos no se convierten.
Unir DataFrames en Pandas es similar a hacer joins en SQL. Por defecto, merge() realiza un inner join. Sin embargo, sí une con nulos, así que cuidado. Para hacer un merge debes usar una clave concreta. Puedes unir por varias columnas o por el índice.
# Create two dataframes
df1 = pd.DataFrame({'lkey': ['foo', 'bar', 'baz', 'foo'],
                    'value': [1, 2, 3, 5]})
df2 = pd.DataFrame({'rkey': ['foo', 'bar', 'baz', 'foo'],
                    'value': [5, 6, 7, 8]})
# merge the df1 DataFrame to the df2 DataFrame using the columns key and rkey as keys
df1.merge(df2, left_on='lkey', right_on='rkey')
Este código combina ambos DataFrames según las claves de lkey y rkey. Los valores sin correspondencia se descartan y te quedas con los coincidentes. Puedes cambiar el tipo de unión a left/right/outer. Es una forma potente de unir datasets de distintas fuentes.
El tratamiento exacto de los valores ausentes depende del caso de uso. Hay que considerar por qué falta el dato. Si es por un error técnico, quizá convenga arreglarlo antes de analizar y ver si se puede recuperar histórico.
A veces podemos ignorar valores faltantes sin afectar el análisis. Si el histórico es importante y no se puede recuperar, habrá que imputarlo. Veamos cómo rellenar información ausente.
El método principal en Pandas es fillna(). Para cadenas, por ejemplo: df.fillna(value='missing'). Lo interesante es combinar fillna() con funciones de NumPy como mean(), median() y funciones lambda para imputar valores de forma matemática.
Alternativamente, métodos como interpolate() pueden rellenar huecos algorítmicamente si tus datos están ordenados (por ejemplo, por tiempo). La meta es imputar lo más fielmente posible a la realidad.
Hacer data wrangling en SQL puede ser muy eficaz, sobre todo si tu base de datos está en la nube. Así limitas el procesamiento en tu máquina local y el tráfico de red.
El foco principal es acotar el alcance de los datos que fluyen por las canalizaciones mediante una correcta extracción, transformación y carga. Para ello filtramos datos, unimos tablas de referencia y hacemos agregaciones.
La forma principal de filtrar en SQL es con la cláusula WHERE. Es sencilla de usar y muy potente. Las condiciones pueden ser igualdades simples, búsquedas de cadenas similares o incluso subconsultas. También puedes combinar condiciones con AND y OR.
Un filtrado simple por un valor concreto podría verse así:
SELECT *
FROM sample_table
WHERE sample_col = 23
Usar LIKE o IN aporta flexibilidad a WHERE. Por ejemplo, esta consulta busca nombres que empiezan por J gracias al comodín % y apellidos IN la lista indicada.
SELECT *
FROM sample_table
WHERE name LIKE ‘J%’ /* looks for people whose name starts with J */
AND last_name IN (‘Smith’, ‘Rockefeller’, ‘Williams’) /* Looks for people whose last name is in this list */
Por último, las subconsultas permiten filtrar según resultados de otra tabla. Un ejemplo típico es obtener IDs de clientes a partir de una fecha concreta.
SELECT *
FROM sample_table
WHERE customer_id IN (SELECT id FROM reference_table WHERE date >= ‘2024-01-01’)
Combinando estas técnicas te aseguras de que la entrada sea exactamente lo que buscas y de que el tamaño del dataset sea mínimo. Un uso muy potente es eliminar duplicados mediante filtros. También puedes usar HAVING para agregaciones y QUALIFY con funciones de ventana.
Hacer joins nos permite incorporar información adicional. SQL ofrece INNER, OUTER, LEFT y RIGHT. Con INNER y OUTER decidimos qué datos conservar: INNER mantiene solo coincidencias en ambos lados; OUTER conserva también no coincidentes según el lado (izquierdo o derecho).
El LEFT mantiene los datos de la tabla izquierda y el RIGHT los de la derecha. Además del FULL OUTER JOIN, que une todo de ambas tablas.
Un ejemplo de join sería:
SELECT *
FROM a
LEFT OUTER JOIN
b
WHERE a.id = b.id
Aquí la tabla a está a la izquierda y b a la derecha. El LEFT OUTER JOIN indica: une por a.id = b.id, pero si no hay coincidencia, conserva todas las filas de a. Los joins son clave para incorporar datos necesarios en tu entrada.
Otra herramienta es GROUP BY para agregar. Simplifica los datos y permite preprocesarlos antes de enviarlos por la canalización. Es útil para calcular estadísticas resumidas. Por ejemplo, ventas totales por ID de cliente:
SELECT
Customer_ID,
SUM(sales)
FROM sample_table
GROUP BY Customer_ID
Hay multitud de funciones de agregación como SUM, MEAN, MAX y MIN que ayudan a entender los datos rápidamente. Aprovechar las agregaciones simplifica la entrada a las canalizaciones.
En esta sección veremos ejemplos y casos de uso de técnicas de data wrangling. Nos centraremos en: estandarizar datos, combinar fuentes y procesar texto.
Estandarizar datos a las mismas unidades es importante. Si mides lo mismo con unidades o divisas diferentes, puedes tener problemas en el análisis.
Veamos un ejemplo sencillo en SQL para convertir distintas divisas a USD. Supongamos dos tablas: sales (ventas por región) y currency_exchange (tipos de cambio por región y día). La conversión podría ser:
SELECT
a.sale_id,
a.region,
CASE WHEN region <> ‘US’
	THEN a.sale_price * b.exchange_rate
	ELSE a.sale_price
END AS sale_price
FROM sales AS a
LEFT OUTER JOIN
currency_exchange AS b
WHERE a.region = b.region
Tomamos sale_id y region de sales y unimos con currency_exchange por región para obtener el tipo de cambio. A menudo también se usa la fecha para aplicar el tipo de ese día.
Una parte clave del wrangling es preparar datos para modelos de machine learning. Muchos modelos recientes se centran en lenguaje natural, y un paso previo habitual es el análisis de sentimiento con texto.
Un paso crítico es normalizar y eliminar puntuación. Dado que la puntuación y las mayúsculas pueden no aportar contexto relevante para el modelo, suele ser mejor normalizar.
Para ello utilizaremos paquetes básicos de Python y re. Aquí tienes un ejemplo para quitar puntuación, pasar a minúsculas y recortar espacios en blanco.
# import regex
import re

# input string
test_string = "       Python 3.0, released in 2008, was a major revision of the language that is not completely backward compatible and much Python 2 code does not run unmodified on Python 3. With Python 2's end-of-life, only Python 3.6.x[30] and later are supported, with older versions still supporting e.g. Windows 7 (and old installers not restricted to 64-bit Windows)."
# remove whitespaces
no_space_string = test_string.strip()

# convert to lower case
lower_string = no_space_string .lower()

# remove numbers
no_number_string = re.sub(r'\d+','',lower_string)
print(no_number_string)
Este fragmento es una buena base para quitar espacios, convertir a minúsculas y eliminar números/datos no alfabéticos.
El data wrangling es esencial para preparar datos de cara a modelos de machine learning y análisis. En Python, paquetes como pandas y numpy, junto con diversos métodos de SQL como WHERE y GROUP BY, nos permiten dejar los datos a punto.
Dominar estas técnicas es clave para triunfar como profesional de datos. Si quieres profundizar en data wrangling, echa un vistazo a estos recursos:
Top DataCamp Courses
Curso
Curso
programa
blog
Matt Crabtree
10 min
blog
Matt Crabtree
15 min
blog
Javier Canales Luna
12 min
blog
Abid Ali Awan
13 min
blog
Elena Kosourova
14 min
blog
Matt Crabtree
9 min