
Curso
Introdução à importação de dados em Python
3 h
341K
Com o aumento do volume, da variedade e da velocidade dos dados, construir conjuntos de dados de qualidade e bem estruturados ficou mais crítico do que nunca, já que eles influenciam diretamente a precisão dos insights e a eficácia das decisões em todos os setores.
Dados mal organizados ou com falhas podem levar a conclusões equivocadas, gerando perda de tempo, dinheiro e recursos. É aqui que o data wrangling entra como o processo essencial que transforma dados brutos e não estruturados em um formato limpo e organizado, pronto para análise.
O data wrangling envolve uma série de etapas para garantir que os dados fiquem precisos, confiáveis e ajustados às necessidades específicas da análise. Ao dominar data wrangling, você libera todo o potencial dos seus dados, transformando-os em insights acionáveis que embasam decisões e impulsionam resultados.
Data wrangling é o processo de transformar dados brutos em um formato mais utilizável. Isso envolve limpar, estruturar e enriquecer os dados para deixá-los prontos para análise.
Imagine que você acabou de receber um grande dataset — ele é bagunçado, com valores ausentes, inconsistências e informações irrelevantes. O data wrangling funciona como um kit de ferramentas para arrumar esses dados, garantindo organização e consistência.
Data wrangling é importante para assegurar que seus dados sejam de alta qualidade e bem estruturados — algo crucial para análises precisas. Dados limpos e estruturados são a base de todas as etapas seguintes do fluxo de dados — seja para treinar um modelo de machine learning, gerar visualizações ou realizar análises estatísticas.
Dados de qualidade reduzem o risco de erros e vieses na sua análise, levando a insights mais confiáveis. Entender a importância do data wrangling é fundamental, pois ele impacta diretamente a validade das decisões tomadas com base nesses dados.
Dados mal trabalhados podem levar a conclusões falhas, com consequências significativas em aplicações reais. Por isso, dominar data wrangling é essencial para quem leva a sério decisões orientadas por dados.
Existem 5 etapas principais no data wrangling:
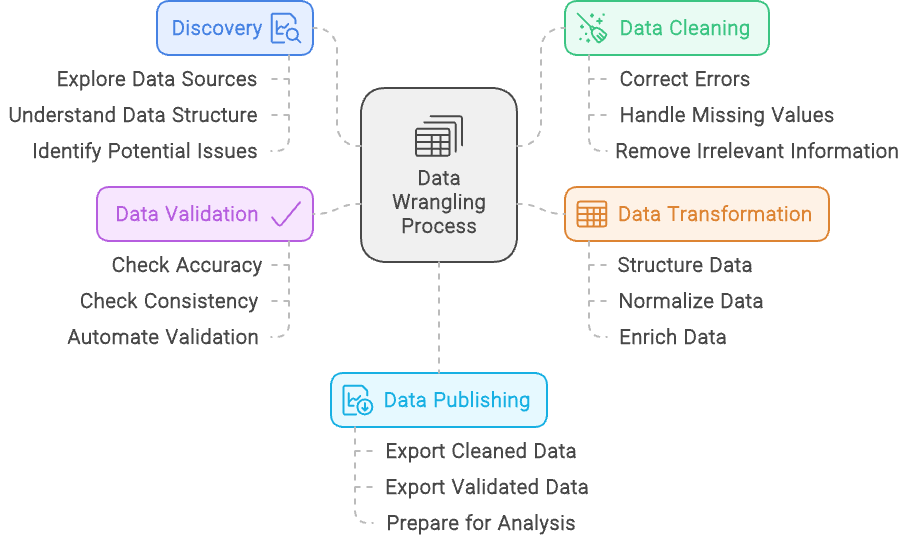
O processo de data wrangling — criado com Napkin.ai
Já vimos as cinco etapas do data wrangling, mas vamos detalhar cada uma delas:
A etapa de descoberta no data wrangling é como dar a primeira olhada em um quebra-cabeça antes de começar a montá-lo. Envolve examinar o dataset para entender com o que você está lidando — tipos de dados, fontes e como eles estão estruturados.
Assim como você separaria peças por cor ou formato das bordas, a descoberta ajuda a categorizar e reconhecer padrões nos dados, preparando o terreno para o trabalho seguinte.
Mas a descoberta também é sobre identificar possíveis problemas — como peças faltando ou cores trocadas no quebra-cabeça.
Nessa etapa, você identifica questões nos dados, como inconsistências, valores ausentes ou padrões inesperados. Ao revelar esses desafios logo no início, é possível planejar como tratá-los nas próximas etapas do data wrangling, garantindo um caminho mais tranquilo até chegar a um dataset limpo e utilizável.
Data cleaning envolve refinar o dataset para garantir precisão e confiabilidade.
Esse processo inclui tratar problemas como corrigir erros, lidar com valores ausentes e resolver inconsistências. Por exemplo, se seu dataset contém entradas duplicadas da mesma pessoa ou transação, a limpeza envolve remover os duplicados para evitar vieses nos resultados.
Além disso, se encontrar registros com formatação incorreta — como números de telefone em formatos diferentes — você deve padronizá-los. O objetivo é elevar a qualidade e a integridade dos dados, deixando-os prontos para análises precisas e relevantes.
Data transformation é o processo de modificar e aprimorar o dataset para alinhá-lo às necessidades da análise. Isso inclui estruturar os dados — como remodelá-los para um formato desejado — ou combinar múltiplas fontes em uma estrutura coesa.
Normalizar dados é outro ponto-chave: ajustar valores para uma escala ou formato comum, como converter todas as moedas para uma única divisa ou padronizar unidades de medida.
A transformação também pode enriquecer o dataset adicionando novas variáveis ou integrando fontes externas para trazer mais contexto e insights. Por exemplo, você pode calcular novas métricas com base nos dados existentes ou anexar informações adicionais de outros bancos para ter um panorama mais completo.
O objetivo é preparar os dados de um jeito que aumente sua usabilidade e relevância para análises profundas.
Data validation garante a exatidão e a confiabilidade do dataset por meio de checagens sistemáticas e processos automatizados. Essa etapa é crítica para confirmar que os dados estão corretos e consistentes.
Durante a validação, você executa diversas verificações para identificar discrepâncias — como comparar dados com benchmarks conhecidos ou validar contra regras e restrições predefinidas. Processos automatizados podem incluir scripts que sinalizam anomalias ou inconsistências, garantindo conformidade com formatos e faixas esperadas.
O objetivo é detectar problemas antes que os dados sejam usados na análise, evitando que erros afetem os resultados. Ao verificar rigorosamente a precisão e a confiabilidade, você garante que os insights gerados se baseiem em informações confiáveis.
A publicação de dados é a etapa final do processo de data wrangling, quando os dados limpos e estruturados são disponibilizados para análise e tomada de decisão. Aqui, você prepara os dados para disseminação, muitas vezes criando dashboards, relatórios ou visualizações interativas que os tornem acessíveis e compreensíveis para as partes interessadas.
Nessa etapa, você pode configurar pipelines ou interfaces que permitam aos usuários consultar e interagir com os dados, garantindo a entrega no formato adequado às suas necessidades.
A meta é oferecer insights claros e acionáveis, possibilitando decisões informadas e facilitando a comunicação dos achados pela organização. Ao publicar os dados de forma eficaz, você garante que todo o trabalho de data wrangling se traduza em resultados práticos e relevantes.
Os termos data wrangling e data cleaning costumam ser usados como sinônimos, mas tratam de aspectos diferentes da preparação de dados. Embora ambos sejam essenciais para deixar os dados prontos para análise, eles têm objetivos distintos e envolvem tarefas diferentes. Entender a diferença ajuda a clarificar seus papéis e a garantir que cada etapa seja conduzida com eficiência.
Data Wrangling é um processo abrangente que transforma dados brutos em um formato adequado para análise. Engloba várias etapas, incluindo aquisição, estruturação, limpeza e validação dos dados. O objetivo é preparar dados de fontes diversas para que possam ser analisados de forma eficaz e gerar insights. Esse processo garante que os dados estejam organizados, precisos e prontos para uma análise detalhada.
Data Cleaning, por sua vez, é um subconjunto específico do data wrangling. Ele se concentra exclusivamente em melhorar a qualidade dos dados, corrigindo erros e inconsistências. Isso inclui remover registros duplicados, corrigir typos, tratar valores ausentes e padronizar formatos. Embora crucial, a limpeza é apenas uma etapa dentro do processo mais amplo.
Em resumo, o data wrangling é a estrutura geral para preparar dados para análise, incluindo múltiplas etapas para lidar com diferentes aspectos da preparação. O data cleaning é um componente dessa estrutura, dedicado especificamente a aumentar a precisão e a consistência dos dados.
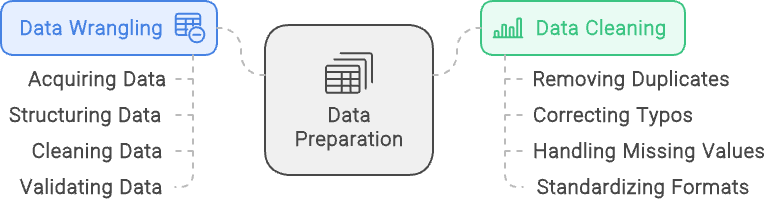
Data wrangling vs. data cleaning: data wrangling foca em estruturar e validar dados, enquanto data cleaning garante dados limpos e de qualidade. Imagem criada com napkin.ai
Há várias maneiras de fazer data wrangling: usando ferramentas gráficas essenciais como Excel ou Alteryx e também programando com linguagens como R e Python. Vamos explorar algumas opções.
Para tarefas simples de data wrangling, planilhas como Microsoft Excel e Google Sheets costumam ser as opções preferidas. São ferramentas muito acessíveis, com interface familiar, ideais para ordenar, filtrar e fazer limpezas básicas. Planilhas são especialmente úteis para datasets menores ou para quem está começando a aprender sobre data wrangling.
Com funções e fórmulas nativas, elas permitem realizar cálculos e manipular dados rapidamente, sem exigir conhecimento técnico avançado.
Para manipulações mais complexas e automação, linguagens como Python e R são amplamente utilizadas. Python, com bibliotecas poderosas como Pandas, NumPy e OpenRefine, é excelente para lidar com grandes volumes e realizar transformações intrincadas.
R, com pacotes como dplyr e tidyr, também é uma ótima opção — muito popular nas comunidades estatística e acadêmica por suas capacidades robustas de análise. Ambas oferecem alta flexibilidade, permitindo criar fluxos personalizados e automatizar tarefas repetitivas — ideais para profissionais que lidam com necessidades mais sofisticadas de data wrangling.
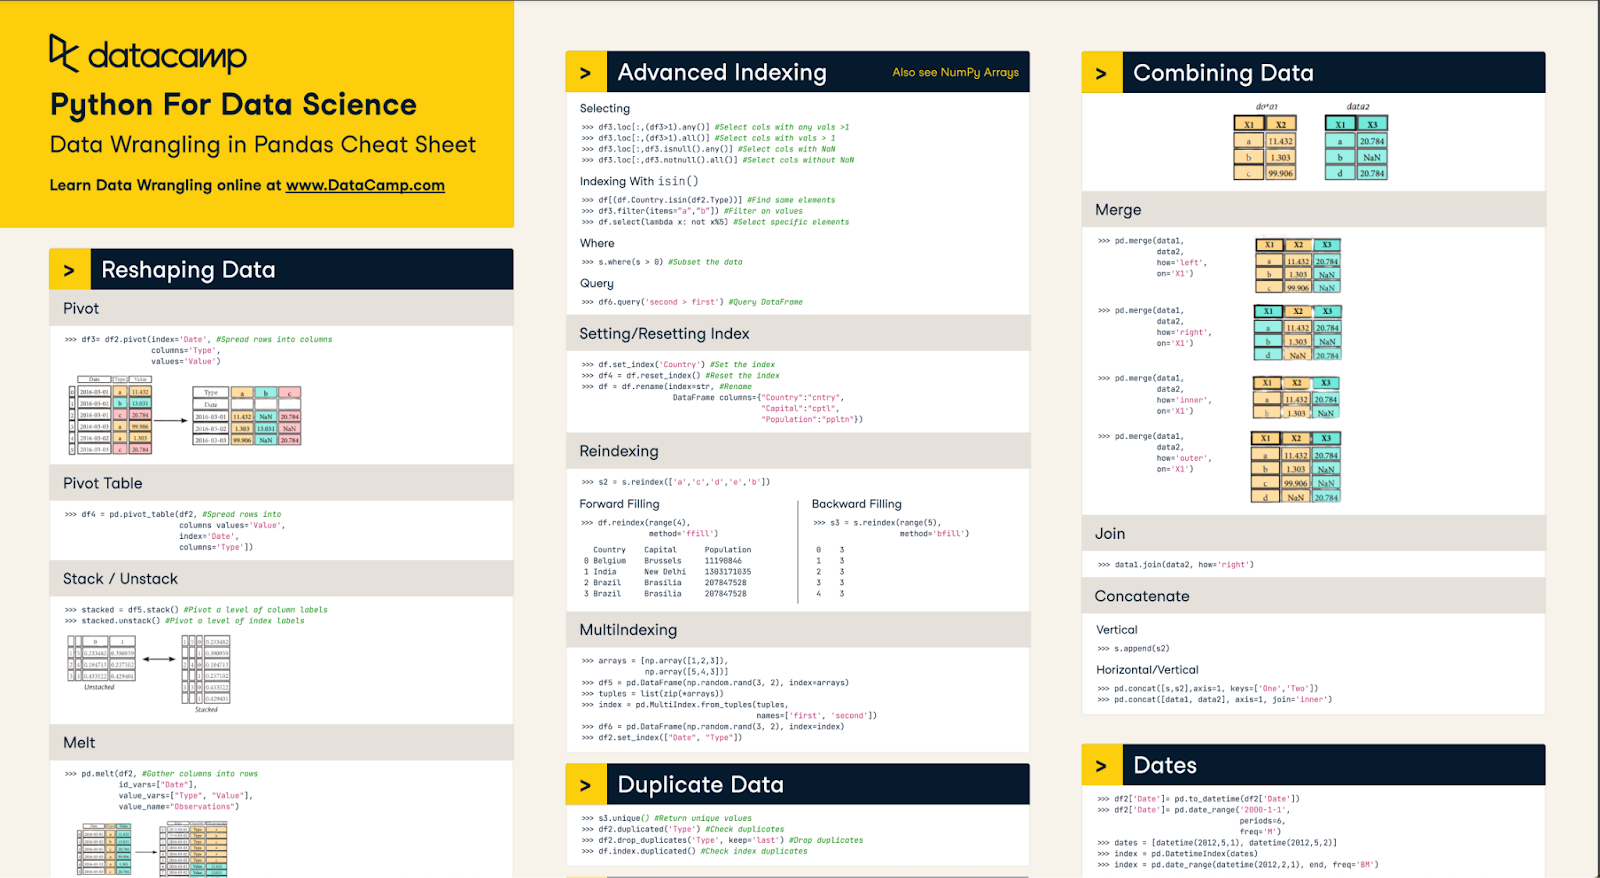
Nosso cheat sheet de data wrangling em Pandas pode ajudar você a dominar o básico
Ferramentas dedicadas foram criadas especificamente para agilizar o processo de data wrangling, oferecendo recursos avançados que simplificam tarefas complexas. Elas são ideais para quem precisa de soluções poderosas e acessíveis para limpar, estruturar e preparar dados sem depender tanto de código.
Alteryx é um dos líderes nessa categoria, conhecido por sua interface intuitiva de arrastar e soltar, que permite limpar, combinar e transformar dados de múltiplas fontes com facilidade. Ele traz várias ferramentas nativas de manipulação, facilitando tarefas como filtrar, unir e agregar dados.
O Alteryx Designer Cloud, baseado em nuvem, amplia essas capacidades com uma plataforma escalável e colaborativa para data wrangling. Ele permite que times trabalhem em tempo real, lidando com grandes volumes e fluxos complexos de forma eficiente em diferentes ambientes. Seja on-premises ou na nuvem, o Alteryx garante dados bem preparados e prontos para análises valiosas.
Para projetos de dados ponta a ponta, plataformas integradas como KNIME, Apache NiFi e Microsoft Power BI são muito usadas. Além de dar suporte ao data wrangling, elas também oferecem integração, análise e visualização em um único ambiente.
O KNIME é conhecido por sua interface modular baseada em nós, que permite construir workflows complexos de forma visual. O Apache NiFi se destaca na orquestração e automação de fluxos de dados entre sistemas, enquanto o Power BI combina preparação de dados com visualizações poderosas. Essas plataformas são ideais quando é preciso preparar, analisar e compartilhar dados de ponta a ponta, oferecendo uma abordagem holística para decisões orientadas por dados.
Existem muitas opções para fazer data wrangling com Python. Dois pacotes principais são Pandas e NumPy. Eles oferecem ferramentas poderosas que permitem aplicar facilmente técnicas essenciais de data wrangling aos seus datasets.
Grande parte do processamento de dados acontece em Python, então dominar esses pacotes é fundamental para qualquer profissional da área. Entre as técnicas mais importantes estão limpeza de alto nível (por exemplo, remoção de nulos), união de datasets e tratamento de valores ausentes.
Muitas vezes os dados precisam ser limpos em Python antes de serem usados. Isso pode incluir remover espaços em branco no início/fim de strings, descartar valores nulos ou corrigir tipos de dados, entre outros.
Cada dataset é diferente e terá suas próprias necessidades, então explore seus dados para entender se é preciso limpar algo a mais. Praticar diferentes técnicas e habilidades de código é uma ótima maneira de aprender todas as formas como podemos limpar dados em Python.
Ao limpar strings, um dos problemas comuns é o espaço em branco à esquerda/direita. Isso pode atrapalhar ao analisar strings por comprimento, posição ou correspondência. A melhor forma de lidar com isso é usar o método str.strip() em uma série.
# Example utilizes a pandas series
# If working with a dataframe, call the series using df[col] syntax
s = pd.Series(['1. Ant.  ', '2. Bee!\n', '3. Cat?\t', np.nan, 10, True])
# It is important to include the .str or else the method will not work
s.str.strip()
Remover valores nulos no Pandas é fácil. Vamos falar sobre preenchimento de nulos mais adiante. Você pode simplesmente usar o método dropna(). Há parâmetros opcionais para definir condições específicas para descartar linhas/colunas, mas o comportamento padrão é remover qualquer linha que tenha ao menos um valor nulo.
# For any dataframe
df = pd.DataFrame({"name": ['Alfred', 'Batman', 'Catwoman'],
                   "toy": [np.nan, 'Batmobile', 'Bullwhip'],
                   "born": [pd.NaT, pd.Timestamp("1940-04-25"), pd.NaT]}
df.dropna()
O método .astype() permite alterar o tipo de dados de uma série, mas corrigir tipos pode ser mais complicado, pois é preciso garantir que todos os valores na série do Pandas correspondam ao tipo desejado.
Por exemplo, converter uma série de objetos para inteiro pressupõe que todo valor é inteiro. Se houver um único valor que não seja inteiro, o método gerará erro. Você pode forçar a conversão (coerce) transformando inválidos em nulos, mas pode valer mais a pena investigar por que certos valores não estão sendo convertidos.
Fazer merge de DataFrames no Pandas é semelhante a fazer joins no SQL. O comportamento padrão de merge() é realizar um inner join. No entanto, ele faz junção em nulos, então tenha cuidado. Para mesclar, é preciso usar uma chave específica. Você pode unir por várias colunas ou até pelo índice.
# Create two dataframes
df1 = pd.DataFrame({'lkey': ['foo', 'bar', 'baz', 'foo'],
                    'value': [1, 2, 3, 5]})
df2 = pd.DataFrame({'rkey': ['foo', 'bar', 'baz', 'foo'],
                    'value': [5, 6, 7, 8]})
# merge the df1 DataFrame to the df2 DataFrame using the columns key and rkey as keys
df1.merge(df2, left_on='lkey', right_on='rkey')
O código acima une os dois DataFrames com base na correspondência das colunas lkey e rkey. Valores sem correspondência são descartados e ficam apenas os combinados. Porém, é possível alterar o tipo de merge para left/right/outer. Essa é uma ferramenta poderosa para permitir que cientistas de dados reúnam datasets de diferentes fontes.
Quando falamos de valores ausentes, a metodologia exata varia conforme o caso de negócio. É importante considerar por que o valor está ausente. Se for por erro técnico, talvez devamos corrigir o problema antes de analisar os dados e tentar recuperar o histórico.
Em alguns casos, podemos usar o restante dos dados e simplesmente ignorar o valor ausente. Se o histórico é importante e irrecuperável, precisamos preencher os dados faltantes. Vamos ver como preencher informações ausentes.
O principal método é o fillna() do Pandas. Para strings, dá para preencher nulos assim: df.fillna(value='missing') — o que pode ser suficiente! O legal desse método é que podemos ser criativos. Combinando fillna() com funções do NumPy como mean(), median() e funções lambda, dá para preencher valores ausentes de forma matemática.
Alternativamente, o Pandas também tem métodos como interpolate() que preenchem lacunas de forma algorítmica se seus dados forem ordenados (por exemplo, séries temporais). A ideia é preencher de maneira mais precisa possível, refletindo a realidade dos dados.
Realizar data wrangling em SQL pode ser uma forma eficaz de processar dados, especialmente se seu banco estiver na nuvem. Isso reduz o volume processado pela sua máquina local e o tráfego de entrada/saída na rede.
O foco principal é limitar o escopo dos dados que fluem pelos pipelines por meio de extração, transformação e carregamento adequados. Algumas formas de fazer isso são filtrando dados, unindo tabelas de referência e realizando agregações.
A principal maneira de filtrar tabelas em SQL é usando a cláusula WHERE. Ela é simples de usar e extremamente poderosa. As condições podem ser igualdades simples, buscas por padrões de string ou até subconsultas. Você pode combinar várias condições com AND e OR!
Um filtro básico para buscar um valor específico em uma coluna pode ser assim:
SELECT *
FROM sample_table
WHERE sample_col = 23
Usar LIKE ou IN dá mais flexibilidade ao WHERE. Por exemplo, a consulta abaixo busca pessoas cujo nome começa com J (graças ao curinga %) e cujo sobrenome está IN na lista fornecida.
SELECT *
FROM sample_table
WHERE name LIKE ‘J%’ /* looks for people whose name starts with J */
AND last_name IN (‘Smith’, ‘Rockefeller’, ‘Williams’) /* Looks for people whose last name is in this list */
Por fim, usar subconsultas confere flexibilidade à filtragem, com base nos resultados de outra tabela. Um exemplo comum é encontrar uma lista de IDs de clientes após uma determinada data/hora.
SELECT *
FROM sample_table
WHERE customer_id IN (SELECT id FROM reference_table WHERE date >= ‘2024-01-01’)
Usar uma combinação dessas técnicas garante entradas de dados exatamente do jeito que você precisa e reduz o tamanho dos datasets. Um uso poderoso de filtros é remover duplicados e já ir limpando seu conjunto. Técnicas mais avançadas incluem filtros HAVING para agregações e QUALIFY com funções de janela.
Fazer joins permite trazer informações extras necessárias ao dataset. O SQL possui diversos tipos: INNER, OUTER, LEFT e RIGHT. Em INNER e OUTER, definimos o que manter. INNER mantém apenas o que casa dos dois lados; OUTER mantém também o que não casa, dependendo do lado (left ou right).
O LEFT mantém os dados do lado esquerdo do join e o RIGHT os do lado direito. Você pode combinar LEFT e RIGHT com INNER e OUTER, além do FULL OUTER JOIN, que une todos os dados das duas tabelas.
Um exemplo de join seria:
SELECT *
FROM a
LEFT OUTER JOIN
b
WHERE a.id = b.id
A consulta acima tem a tabela a à esquerda (primeira) e b à direita (segunda). O LEFT OUTER JOIN diz: una os dados de a e b onde a.id = b.id, mas, se não houver correspondência, mantenha tudo de a. Joins são ferramentas poderosas para trazer dados adicionais necessários na sua entrada.
Um recurso final que podemos usar em SQL para data wrangling é a cláusula GROUP BY para realizar agregações. Ela simplifica os dados e permite pré-processar parte do volume antes de seguir no pipeline. Agregar é poderoso para calcular estatísticas de resumo. Veja um exemplo de total de vendas por ID de cliente:
SELECT
Customer_ID,
SUM(sales)
FROM sample_table
GROUP BY Customer_ID
Há várias funções de agregação — SUM, MEAN, MAX, MIN — que ajudam a entender rapidamente os dados. Usá-las bem simplifica a entrada de dados nos pipelines.
Nesta seção, vamos cobrir exemplos práticos e casos de uso de técnicas de data wrangling. Os principais objetivos serão: padronização de dados, união de fontes e processamento de texto.
Padronizar dados nas mesmas unidades é importante. Se você mede a mesma coisa em unidades ou moedas diferentes, isso pode causar problemas na análise.
Vamos ver um exemplo simples de conversão de diferentes moedas para USD em SQL. Suponha duas tabelas: a tabela sales, com vendas por região, e a currency_exchange, com taxas de câmbio por região e por dia. Uma conversão poderia ser assim:
SELECT
a.sale_id,
a.region,
CASE WHEN region <> ‘US’
	THEN a.sale_price * b.exchange_rate
	ELSE a.sale_price
END AS sale_price
FROM sales AS a
LEFT OUTER JOIN
currency_exchange AS b
WHERE a.region = b.region
Aqui, pegamos sale_id e region da tabela sales e fazemos join com a tabela de referência currency_exchange pela região para obter a taxa de câmbio. Muitas vezes, há uma coluna de data para usar a taxa do dia.
Uma parte importante do data wrangling é preparar dados para modelos de machine learning. Recentemente, muitos modelos focam em processamento de linguagem natural e, como etapa anterior, fazemos análise de sentimento com dados de texto.
Um passo crítico é a preparação do texto por normalização e remoção de pontuação. Como pontuação e capitalização muitas vezes não agregam contexto relevante ao modelo, costuma ser melhor normalizar.
Para isso, vamos usar pacotes básicos de Python e o módulo re. Veja abaixo um exemplo de remoção de pontuação, normalização para caixa baixa e corte de espaços.
# import regex
import re

# input string
test_string = "       Python 3.0, released in 2008, was a major revision of the language that is not completely backward compatible and much Python 2 code does not run unmodified on Python 3. With Python 2's end-of-life, only Python 3.6.x[30] and later are supported, with older versions still supporting e.g. Windows 7 (and old installers not restricted to 64-bit Windows)."
# remove whitespaces
no_space_string = test_string.strip()

# convert to lower case
lower_string = no_space_string .lower()

# remove numbers
no_number_string = re.sub(r'\d+','',lower_string)
print(no_number_string)
O snippet acima fornece uma ótima base para remover espaços, converter para minúsculas e remover números/dados não alfabéticos.
Data wrangling é um componente crítico para preparar dados para modelos de machine learning e análises. Há inúmeras ferramentas em Python — como os pacotes pandas e numpy — e diversos recursos em SQL — como as cláusulas WHERE e GROUP BY — que nos ajudam a preparar os dados.
Dominar essas técnicas é essencial para o sucesso de qualquer profissional de dados. Se quiser se aprofundar em data wrangling, confira estes recursos:
Principais cursos da DataCamp
Curso
Curso
Programa