Cours
Introduction à l'importation de données en Python
3 h
340.9K
Avec l’augmentation du volume, de la variété et de la vélocité des données, la création de jeux de données de qualité et bien structurés est plus cruciale que jamais, car ils influencent directement la précision des insights et l’efficacité des décisions dans tous les secteurs.
Des données mal organisées ou défaillantes peuvent mener à de mauvaises conclusions, avec des pertes de temps, d’argent et de ressources. C’est là que le data wrangling s’impose comme un processus essentiel pour transformer des données brutes et non structurées en un format propre et organisé, prêt pour l’analyse.
Le data wrangling suit une série d’étapes pour garantir des données exactes, fiables et adaptées aux besoins spécifiques de l’analyse. En le maîtrisant, vous libérez tout le potentiel de vos données et les transformez en insights actionnables pour des décisions éclairées — gage de succès.
Le data wrangling est le processus qui consiste à transformer des données brutes en un format plus exploitable. Il s’agit de nettoyer, structurer et enrichir les données pour les rendre prêtes à l’analyse.
Imaginez que vous veniez de recevoir un énorme jeu de données : il est désordonné, avec des valeurs manquantes, des incohérences et des informations inutiles. Le data wrangling est une boîte à outils pour remettre de l’ordre, assurer la cohérence et organiser ces données.
Il est indispensable pour garantir une donnée de qualité et bien structurée — un prérequis pour toute analyse fiable. Des données propres et structurées servent de fondation à toutes les étapes suivantes du workflow data, que vous construisiez un modèle d’apprentissage automatique, des visualisations ou des analyses statistiques.
Des données de qualité réduisent le risque d’erreurs et de biais dans l’analyse, et mènent à des insights plus solides. Comprendre l’importance du data wrangling est clé, car il impacte directement la validité des décisions prises à partir de ces données.
Un data wrangling mal exécuté peut conduire à des conclusions erronées, avec des conséquences bien réelles. Maîtriser ces techniques est donc essentiel pour quiconque souhaite prendre des décisions basées sur les données.
Le data wrangling comprend 5 étapes principales :
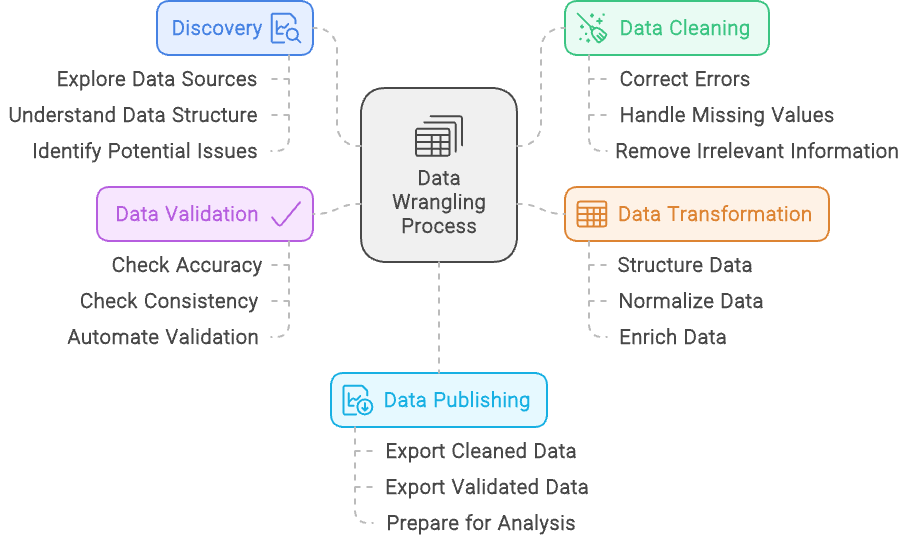
Le processus de data wrangling — créé avec Napkin.ai
Nous avons présenté les cinq étapes du data wrangling. Regardons-les maintenant de plus près :
L’étape de découverte revient à observer un puzzle avant de commencer à l’assembler. On examine le jeu de données pour comprendre sa nature, ses sources et sa structure.
Comme on trie des pièces par couleur ou par bord, la découverte aide à catégoriser les données et à repérer des motifs, en posant les bases du travail à venir.
Elle sert aussi à détecter les problèmes potentiels — comme des pièces manquantes ou des couleurs qui ne correspondent pas.
À ce stade, vous identifiez les incohérences, valeurs manquantes ou schémas inattendus. En les révélant tôt, vous pouvez planifier leur traitement dans les étapes suivantes et avancer plus sereinement vers un jeu de données propre et exploitable.
Le nettoyage des données consiste à affiner votre jeu de données pour en assurer l’exactitude et la fiabilité.
Il s’agit notamment de corriger les erreurs, de gérer les valeurs manquantes et de résoudre les incohérences. Par exemple, si votre jeu de données contient des doublons pour une même personne ou transaction, le nettoyage consiste à les supprimer pour ne pas biaiser les résultats.
De même, si certains champs sont mal formatés, comme des numéros de téléphone avec des formats variables, vous les standardisez. L’objectif est d’améliorer la qualité et l’intégrité globales des données afin de permettre une analyse fiable et pertinente.
La transformation des données vise à modifier et enrichir votre jeu de données pour l’aligner sur les exigences de l’analyse. Cela inclut la structuration (reformatage, remodelage) et la consolidation de plusieurs sources dans une structure cohérente.
La normalisation est un autre volet clé : ramener les valeurs à une même échelle ou à un même format, par exemple convertir toutes les monnaies dans une devise unique ou harmoniser les unités de mesure.
La transformation comprend aussi l’enrichissement du jeu de données en ajoutant de nouvelles variables ou en intégrant des sources externes pour plus de contexte. Vous pouvez, par exemple, calculer de nouveaux indicateurs à partir des données existantes ou compléter avec des informations issues d’autres bases.
Le but est de préparer des données plus pertinentes et directement exploitables pour une analyse approfondie.
La validation des données consiste à s’assurer de leur exactitude et de leur fiabilité via des contrôles systématiques et des processus automatisés. Cette étape est décisive pour confirmer que les données sont correctes et cohérentes.
Vous effectuez des vérifications pour détecter les écarts, en comparant par exemple les données à des références connues ou à des règles et contraintes prédéfinies. Des scripts peuvent repérer automatiquement les anomalies et s’assurer du respect des formats et plages attendus.
L’objectif est d’identifier les problèmes avant l’analyse, afin d’éviter qu’ils n’affectent les résultats. En vérifiant rigoureusement la qualité des données, vous garantissez des insights fondés sur une information fiable.
La publication des données est la dernière étape du data wrangling : les données nettoyées et structurées sont mises à disposition pour l’analyse et la prise de décision. Elle implique de préparer la diffusion, souvent via des tableaux de bord, rapports ou visualisations interactives, afin de les rendre accessibles et compréhensibles pour les parties prenantes.
Vous pouvez mettre en place des pipelines ou interfaces permettant d’interroger et de manipuler les données, en les livrant dans un format adapté aux besoins des utilisateurs.
Le but est d’apporter des insights clairs et actionnables, de soutenir des décisions éclairées et de faciliter le partage des résultats dans l’organisation. Une publication efficace garantit que le travail de préparation se traduit par des résultats concrets et utiles.
Les termes data wrangling et data cleaning sont souvent employés comme des synonymes, mais ils désignent des volets différents de la préparation des données. Tous deux sont indispensables, mais leurs objectifs et tâches diffèrent. Comprendre cette distinction clarifie les rôles et garantit un traitement efficace de chaque aspect de la préparation.
Le data wrangling est un processus global visant à transformer des données brutes en un format exploitable. Il couvre plusieurs étapes, de l’acquisition à la structuration, au nettoyage et à la validation. Son but est de préparer des données issues de sources diverses pour une analyse efficace et génératrice d’insights, en s’assurant qu’elles sont organisées, exactes et prêtes pour une étude approfondie.
Le data cleaning, en revanche, est un sous-ensemble spécifique du data wrangling. Il se concentre sur l’amélioration de la qualité en corrigeant erreurs et incohérences : suppression de doublons, correction de fautes de frappe, traitement des valeurs manquantes, standardisation des formats, etc. C’est une étape cruciale, mais elle ne constitue qu’une partie du processus global.
En bref, le data wrangling est le cadre global de préparation à l’analyse, englobant plusieurs étapes. Le data cleaning en est un composant clé, dédié à l’amélioration de l’exactitude et de la cohérence des données.
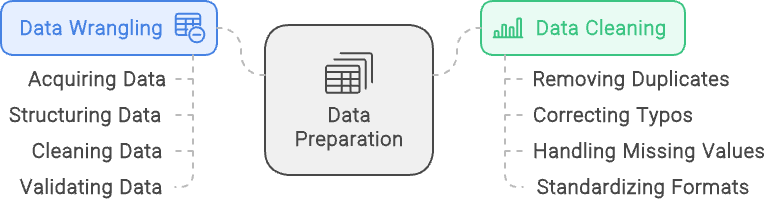
Data wrangling vs data cleaning : le data wrangling met l’accent sur la structuration et la validation des données tandis que le data cleaning vise à garantir des données propres et de qualité. Image créée avec napkin.ai
Il existe de nombreuses façons de préparer les données, via des outils GUI fondamentaux comme Excel ou Alteryx, ou via le code avec des langages comme R et Python. Voici quelques options.
Pour des tâches simples, des tableurs comme Microsoft Excel et Google Sheets sont souvent privilégiés. Accessibles et familiers, ils sont idéaux pour trier, filtrer et effectuer des nettoyages basiques. Particulièrement utiles pour de petits jeux de données ou pour débuter en data wrangling.
Leurs fonctions et formules intégrées permettent de calculer et de manipuler rapidement les données, sans compétences techniques poussées.
Pour des manipulations plus complexes et l’automatisation, Python et R sont très répandus. Python, avec des bibliothèques puissantes comme Pandas, NumPy et OpenRefine, excelle sur les grands volumes et les transformations complexes.
R, avec des packages comme dplyr et tidyr, est une autre option solide, très appréciée dans les milieux statistiques et académiques. Ces deux langages offrent une grande flexibilité pour écrire des workflows sur mesure et automatiser les tâches répétitives, idéals pour des besoins de wrangling plus avancés.
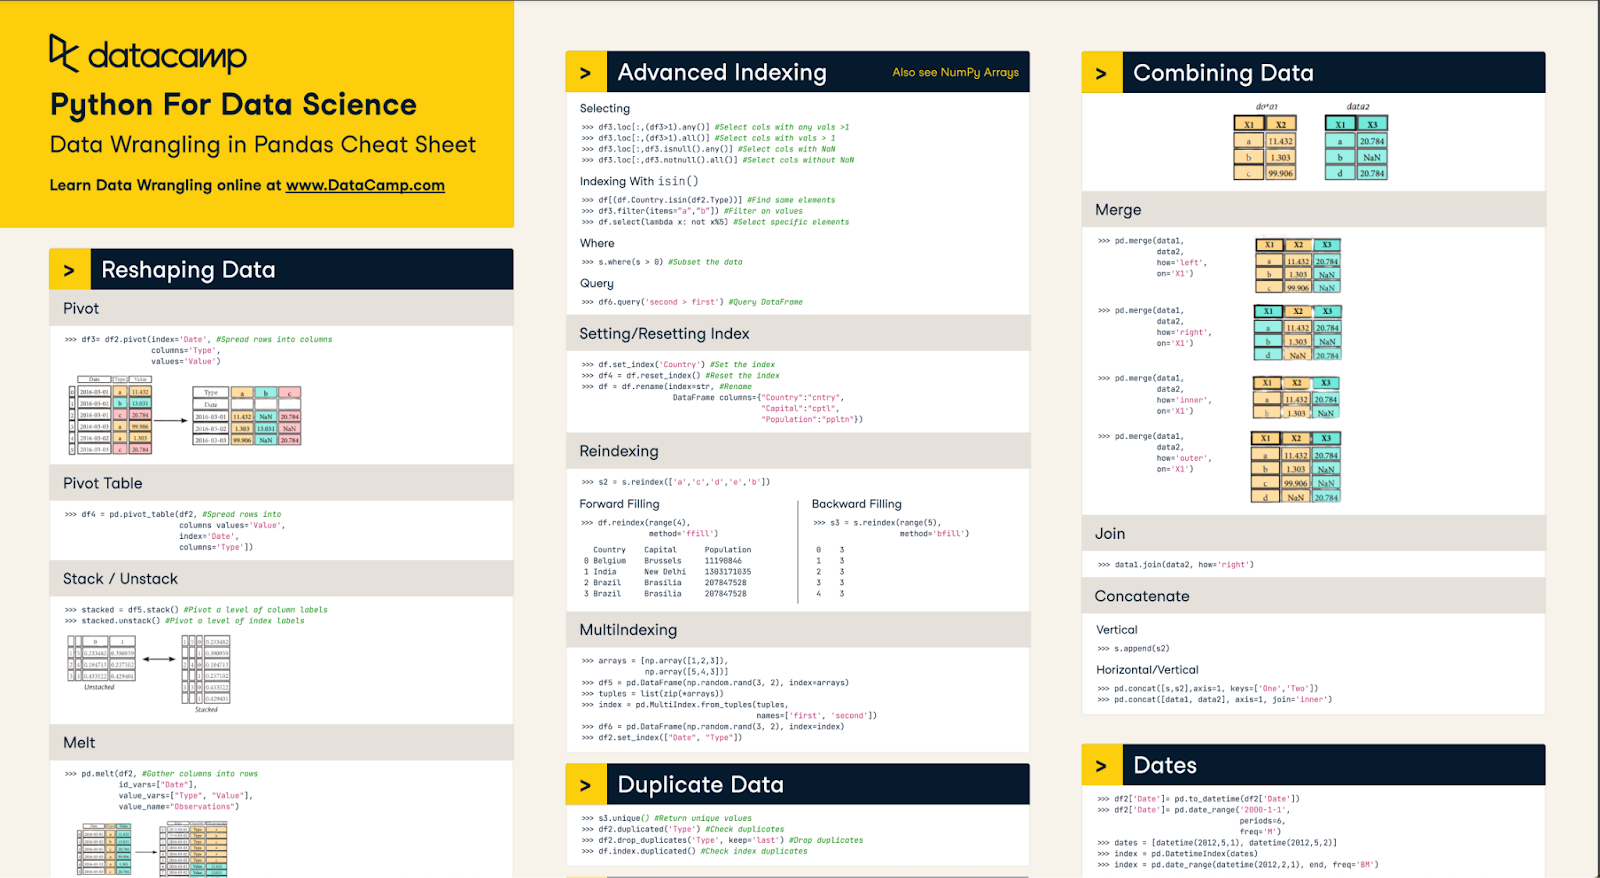
Notre cheat sheet Data Wrangling in Pandas vous aide à maîtriser les bases
Des outils dédiés sont conçus pour fluidifier le data wrangling et simplifier des tâches complexes grâce à des fonctionnalités avancées. Idéal pour disposer de solutions puissantes et accessibles afin de nettoyer, structurer et préparer les données sans coder intensivement.
Alteryx est un leader du marché, reconnu pour son interface glisser-déposer intuitive qui permet de nettoyer, combiner et transformer des données issues de multiples sources. Il intègre de nombreux outils pour filtrer, joindre et agréger facilement.
La solution cloud Alteryx Designer Cloud renforce ces capacités avec une plateforme collaborative et scalable. Les équipes peuvent travailler en temps réel, traiter de grands volumes et des workflows complexes, sur site comme dans le cloud, pour livrer des données prêtes à l’analyse.
Pour des projets de données de bout en bout, des plateformes intégrées comme KNIME, Apache NiFi et Microsoft Power BI sont couramment utilisées. Elles couvrent le wrangling mais aussi l’intégration, l’analyse et la visualisation dans un même environnement.
KNIME est réputée pour son interface modulaire par nœuds, Apache NiFi pour la gestion et l’automatisation des flux entre systèmes, tandis que Power BI associe préparation des données et visualisation puissante. Idéal pour des projets où préparer, analyser et partager doivent s’enchaîner sans couture, au service de décisions basées sur les données.
Les options sont nombreuses en Python. Deux packages phares sont Pandas et NumPy. Ils offrent des fonctions puissantes pour appliquer facilement les techniques clés de wrangling.
Une grande part du traitement des données se fait en Python : maîtriser ces packages est donc indispensable. Parmi les incontournables : le nettoyage haut niveau (par exemple supprimer les valeurs nulles), la fusion de jeux de données et la gestion des valeurs manquantes.
Il est fréquent de devoir nettoyer les données en Python avant de les exploiter. Cela peut impliquer la suppression des espaces en fin/début de chaîne, l’élimination des valeurs nulles ou la correction des types, entre autres.
Chaque jeu de données est différent et a ses propres besoins : explorez-le pour savoir si un nettoyage supplémentaire s’impose. La pratique de diverses techniques et la montée en compétences en code sont les meilleurs moyens d’apprendre toutes les façons de nettoyer des données en Python.
Pour nettoyer des chaînes de caractères, un problème fréquent est la présence d’espaces au début/à la fin. Cela peut gêner l’analyse par longueur, position ou correspondance. La meilleure manière de traiter ce cas est d’utiliser la méthode str.strip() sur une série.
# Example utilizes a pandas series
# If working with a dataframe, call the series using df[col] syntax
s = pd.Series(['1. Ant.  ', '2. Bee!\n', '3. Cat?\t', np.nan, 10, True])
# It is important to include the .str or else the method will not work
s.str.strip()
Supprimer les valeurs nulles dans Pandas est simple. Nous verrons plus loin comment les imputer. Vous pouvez utiliser la méthode dropna(). Des paramètres optionnels permettent d’ajuster précisément les conditions de suppression des lignes/colonnes, mais par défaut toute ligne contenant au moins une valeur nulle est supprimée.
# For any dataframe
df = pd.DataFrame({"name": ['Alfred', 'Batman', 'Catwoman'],
                   "toy": [np.nan, 'Batmobile', 'Bullwhip'],
                   "born": [pd.NaT, pd.Timestamp("1940-04-25"), pd.NaT]}
df.dropna()
La méthode .astype() permet de changer le type d’une série, mais la correction des types est un peu plus délicate : toutes les valeurs de la série doivent correspondre au type ciblé.
Par exemple, convertir une série d’objets en entiers suppose que chaque valeur soit un entier. La moindre valeur non entière provoquera une erreur. Vous pouvez choisir de forcer la conversion et transformer les valeurs invalides en nulles, mais il est souvent préférable d’enquêter sur les raisons qui empêchent la conversion.
Fusionner des DataFrames dans Pandas ressemble aux jointures en SQL. Par défaut, merge() effectue une jointure interne (inner join). Attention : il joindra aussi sur des valeurs nulles. Une fusion nécessite une clé ; vous pouvez joindre via diverses colonnes voire via l’index.
# Create two dataframes
df1 = pd.DataFrame({'lkey': ['foo', 'bar', 'baz', 'foo'],
                    'value': [1, 2, 3, 5]})
df2 = pd.DataFrame({'rkey': ['foo', 'bar', 'baz', 'foo'],
                    'value': [5, 6, 7, 8]})
# merge the df1 DataFrame to the df2 DataFrame using the columns key and rkey as keys
df1.merge(df2, left_on='lkey', right_on='rkey')
Ce code fusionne les deux DataFrames selon les clés des colonnes lkey et rkey. Les valeurs sans correspondance sont écartées et seules les correspondances sont conservées. Vous pouvez modifier le comportement pour réaliser des jointures left/right/outer. Un outil puissant pour rassembler des données issues de sources variées.
La stratégie à adopter dépend du cas d’usage. Il faut d’abord comprendre pourquoi la valeur manque. Si c’est dû à un problème technique, mieux vaut le corriger avant l’analyse et tenter de reconstituer l’historique.
Parfois, on peut ignorer la valeur manquante si le reste des données suffit. Si l’historique est important et irrécupérable, il faut alors imputer les données. Voyons comment renseigner ces informations manquantes.
La méthode principale est fillna() de Pandas. Pour des chaînes de caractères, vous pouvez par exemple faire : df.fillna(value=’missing’). L’intérêt est sa flexibilité : en combinant fillna() avec des fonctions NumPy (mean(), median()) et des lambdas, vous pouvez imputer mathématiquement des valeurs manquantes.
Autre option : des méthodes comme interpolate() remplissent algorithmquement des trous si les données sont ordonnées (p. ex. séries temporelles). L’objectif est d’imputer au plus juste pour refléter la réalité.
Effectuer du wrangling en SQL est très efficace, notamment si votre base est dans le cloud. Cela limite le traitement local et les transferts réseau.
L’enjeu principal en SQL est de restreindre le volume de données circulant dans les pipelines via une bonne extraction, transformation et chargement. Pour cela : filtrage, jointure avec des tables de référence et agrégations.
Le moyen principal de filtrer en SQL est la clause WHERE. Elle est simple à utiliser mais extrêmement puissante. Les conditions peuvent être des égalités, des recherches de chaînes similaires, ou des sous-requêtes. Vous pouvez combiner plusieurs conditions avec AND et OR.
Un filtrage simple sur la valeur d’une colonne peut ressembler à ceci :
SELECT *
FROM sample_table
WHERE sample_col = 23
Des opérateurs comme LIKE ou IN apportent de la souplesse. Par exemple, la requête suivante cherche les prénoms commençant par J grâce au joker % et les noms de famille IN dans la liste donnée.
SELECT *
FROM sample_table
WHERE name LIKE ‘J%’ /* looks for people whose name starts with J */
AND last_name IN (‘Smith’, ‘Rockefeller’, ‘Williams’) /* Looks for people whose last name is in this list */
Enfin, les sous-requêtes offrent une grande flexibilité, en se basant sur les résultats d’une autre table. Exemple courant : retrouver des identifiants clients après une date donnée.
SELECT *
FROM sample_table
WHERE customer_id IN (SELECT id FROM reference_table WHERE date >= ‘2024-01-01’)
En combinant ces techniques, vous obtenez exactement les données recherchées en minimisant la taille des jeux de données. Un usage puissant des filtres est aussi d’éliminer les doublons. Parmi les techniques avancées : la clause HAVING pour filtrer après agrégation, et QUALIFY avec des fonctions de fenêtre.
Les jointures permettent d’ajouter des informations utiles. SQL propose INNER, OUTER, LEFT et RIGHT. Avec INNER et OUTER, on choisit ce qui est conservé : INNER garde uniquement les correspondances, OUTER conserve aussi les non-correspondances selon le côté (LEFT ou RIGHT).
La jointure LEFT conserve toutes les lignes de gauche, RIGHT toutes celles de droite. On peut combiner avec FULL OUTER JOIN pour joindre toutes les données des deux tables.
Exemple de jointure :
SELECT *
FROM a
LEFT OUTER JOIN
b
WHERE a.id = b.id
Ici, la table a est à gauche et b à droite. Le LEFT OUTER JOIN indique : joindre a et b là où a.id = b.id, et conserver toutes les lignes de a même sans correspondance. Les jointures sont essentielles pour enrichir votre entrée de données.
Un dernier outil utile en SQL est la clause GROUP BY pour agréger. Elle simplifie les données et permet un pré-traitement avant l’aval du pipeline. L’agrégation sert à calculer des statistiques de synthèse. Exemple : total des ventes par identifiant client :
SELECT
Customer_ID,
SUM(sales)
FROM sample_table
GROUP BY Customer_ID
Les fonctions d’agrégation sont nombreuses : SUM, MEAN, MAX, MIN… Elles aident à comprendre rapidement les données et réduisent le volume à faire transiter.
Cette section présente des exemples concrets de techniques de wrangling. Nous nous concentrons sur : la standardisation des données, la fusion de sources et le traitement de texte.
Standardiser les unités est essentiel. Mesurer la même chose avec des unités différentes (ou des devises différentes) peut fausser l’analyse.
Voyons un exemple simple en SQL de conversion de devises en USD. Supposons deux tables : sales contient des ventes par région, et currency_exchange les taux de change par région et par jour. Une conversion peut ressembler à :
SELECT
a.sale_id,
a.region,
CASE WHEN region <> ‘US’
	THEN a.sale_price * b.exchange_rate
	ELSE a.sale_price
END AS sale_price
FROM sales AS a
LEFT OUTER JOIN
currency_exchange AS b
WHERE a.region = b.region
On récupère sale_id et region depuis sales, puis on joint la table de référence currency_exchange sur la région pour obtenir le taux. Souvent, on ajoute une date pour utiliser le taux du jour.
Une part majeure du wrangling consiste à préparer des données pour des modèles de machine learning. Récemment, beaucoup de modèles portent sur le traitement du langage naturel, avec en amont des analyses de sentiment sur des textes.
Une étape clé est la normalisation du texte et la suppression de la ponctuation. Puisque la ponctuation et la capitalisation apportent parfois peu de contexte au modèle, il est souvent préférable de normaliser.
Pour cela, utilisons des packages Python de base et re. Exemple pour supprimer la ponctuation, passer en minuscules et supprimer les espaces superflus.
# import regex
import re

# input string
test_string = "       Python 3.0, released in 2008, was a major revision of the language that is not completely backward compatible and much Python 2 code does not run unmodified on Python 3. With Python 2's end-of-life, only Python 3.6.x[30] and later are supported, with older versions still supporting e.g. Windows 7 (and old installers not restricted to 64-bit Windows)."
# remove whitespaces
no_space_string = test_string.strip()

# convert to lower case
lower_string = no_space_string .lower()

# remove numbers
no_number_string = re.sub(r'\d+','',lower_string)
print(no_number_string)
Ce snippet constitue une bonne base pour supprimer les espaces, convertir en minuscules et enlever les chiffres/éléments non alphabétiques.
Le data wrangling est un pilier de la préparation des données pour les modèles d’apprentissage automatique et l’analyse. En Python, des packages comme pandas et numpy, et en SQL des clauses comme WHERE ou GROUP BY, permettent de préparer efficacement vos données.
La maîtrise de ces techniques est essentielle pour réussir en tant que professionnel des données. Pour aller plus loin sur le data wrangling, consultez les ressources suivantes :
Meilleurs cours DataCamp
Cours
Cours
Cursus
blog
Kurtis Pykes
15 min
blog
Zoumana Keita
15 min
Tutoriel
Samuel Shaibu
9 min
Tutoriel
Mark Pedigo
10 min
Tutoriel
DataCamp Team
3 min
Tutoriel
Sejal Jaiswal
24 min