
Kurs
Einführung in das Importieren von Daten in Python
3 Std.
340.4K
Mit der wachsenden Menge, Vielfalt und Geschwindigkeit von Daten ist es wichtiger denn je, qualitativ hochwertige, gut strukturierte Datensätze aufzubauen – sie bestimmen direkt, wie präzise Insights sind und wie wirkungsvoll Entscheidungen in allen Branchen ausfallen.
Schlecht organisierte oder fehlerhafte Daten führen leicht zu falschen Schlussfolgerungen – kosten Zeit, Geld und Ressourcen. Hier kommt Data Wrangling ins Spiel: der entscheidende Prozess, der rohe, unstrukturierte Daten in ein sauberes, geordnetes Format für die Analyse überführt.
Data Wrangling umfasst eine Reihe von Schritten, um Daten akkurat, verlässlich und passgenau für die jeweilige Analyse aufzubereiten. Wenn du Data Wrangling beherrschst, schöpfst du das volle Potenzial deiner Daten aus – und verwandelst sie in umsetzbare Insights, die fundierte Entscheidungen ermöglichen und Erfolg treiben.
Data Wrangling ist der Prozess, rohe Daten in ein besser nutzbares Format zu transformieren. Dazu gehört es, Daten zu bereinigen, zu strukturieren und anzureichern, sodass sie für die Analyse bereitstehen.
Stell dir vor, du erhältst einen riesigen Datensatz – unübersichtlich, mit fehlenden Werten, Inkonsistenzen und irrelevanten Informationen. Data Wrangling ist wie ein Werkzeugkasten, mit dem du diesen Datensatz aufräumst, ordnest und konsistent machst.
Data Wrangling ist entscheidend, um Datenqualität und Struktur sicherzustellen – die Basis für präzise Analysen. Saubere, strukturierte Daten bilden das Fundament aller weiteren Schritte im Datenworkflow – ob du ein Machine-Learning-Modell baust, Visualisierungen erstellst oder statistisch auswertest.
Hochwertige Daten verringern das Risiko von Fehlern und Verzerrungen in der Analyse und führen zu verlässlicheren Erkenntnissen. Das Verständnis für die Bedeutung von Data Wrangling ist zentral, denn es beeinflusst direkt die Gültigkeit der darauf basierenden Entscheidungen.
Schlecht aufbereitetes Datenmaterial kann zu fehlerhaften Schlussfolgerungen führen – mit spürbaren Folgen in der Praxis. Wer ernsthaft datenbasiert entscheiden will, muss Data Wrangling beherrschen.
Die fünf wichtigsten Schritte im Data Wrangling sind:
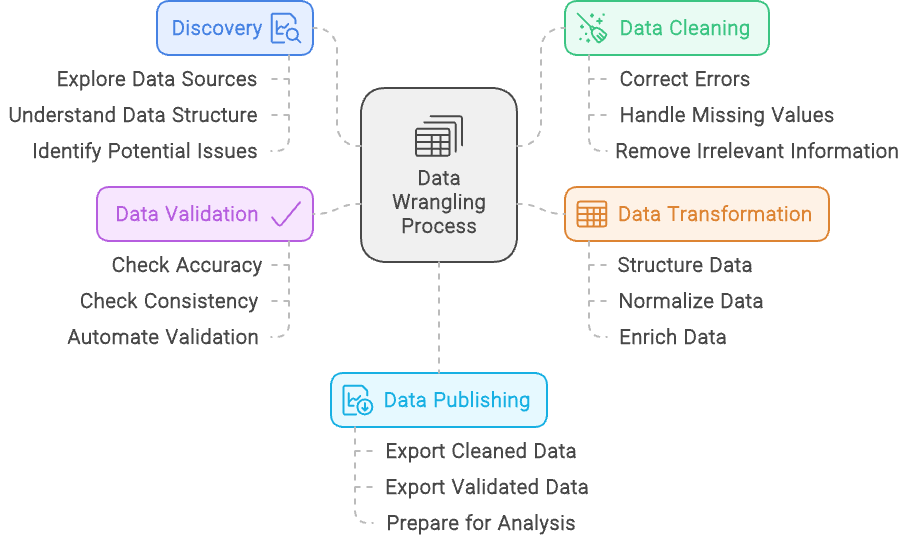
Der Data-Wrangling-Prozess – erstellt mit Napkin.ai
Wir haben die fünf Schritte umrissen – schauen wir uns jeden im Detail an:
Der Discovery-Schritt ähnelt dem ersten Blick auf ein Puzzle, bevor du die Teile zusammenfügst. Du prüfst den Datensatz und bekommst ein klares Bild davon, womit du arbeitest – Datentypen, Quellen und Struktur.
So wie man Puzzleteile nach Farbe oder Kanten sortiert, hilft dir Discovery dabei, Daten zu kategorisieren und Muster zu erkennen – und legt die Basis für die weitere Arbeit.
Discovery bedeutet auch, potenzielle Probleme früh zu entdecken – wie fehlende Teile oder nicht passende Farben im Puzzle.
In diesem Schritt identifizierst du Inkonsistenzen, fehlende Werte oder unerwartete Muster. Wenn du diese Hürden früh erkennst, kannst du sie in den nächsten Phasen gezielt angehen – für einen reibungslosen Weg zu einem sauberen, nutzbaren Datensatz.
Data Cleaning verfeinert deinen Datensatz, damit er korrekt und verlässlich ist.
Dazu gehören u. a. das Korrigieren von Fehlern, der Umgang mit fehlenden Werten und das Beheben von Inkonsistenzen. Enthält dein Datensatz z. B. Dubletten derselben Person oder Transaktion, entfernst du sie, damit Ergebnisse nicht verzerrt werden.
Sind Einträge uneinheitlich formatiert – etwa Telefonnummern in verschiedenen Formaten –, standardisierst du sie. Ziel ist es, Qualität und Integrität der Daten zu erhöhen, damit Analysen präzise und aussagekräftig sind.
Data Transformation passt deinen Datensatz an die Anforderungen der Analyse an. Dazu zählen das Umformen in das gewünschte Format oder das Zusammenführen mehrerer Quellen zu einer kohärenten Struktur.
Ein zentraler Aspekt ist die Normalisierung – also Werte auf eine gemeinsame Skala oder ein einheitliches Format zu bringen, z. B. alle Währungen in eine Währung umzurechnen oder Maßeinheiten zu standardisieren.
Außerdem kannst du den Datensatz anreichern, etwa durch neue Variablen oder externe Quellen für mehr Kontext. So lassen sich zusätzliche Kennzahlen berechnen oder Informationen aus weiteren Datenbanken ergänzen, um ein vollständigeres Bild zu erhalten.
Ziel der Datentransformation ist es, die Nutzbarkeit und Relevanz der Daten für die tiefergehende Analyse zu maximieren.
Data Validation stellt mit systematischen Checks und Automation sicher, dass dein Datensatz korrekt und konsistent ist. Dieser Schritt ist kritisch, um Verlässlichkeit zu bestätigen.
Du führst Prüfungen durch, etwa Abgleiche mit Benchmarks oder Validierung gegen vordefinierte Regeln und Constraints. Skripte können Anomalien oder Inkonsistenzen markieren und sicherstellen, dass Formate und Wertebereiche eingehalten werden.
Ziel ist, Probleme zu erkennen, bevor Daten analysiert werden – damit Fehler nicht in die Ergebnisse einfließen. Durch sorgfältige Validierung stellst du sicher, dass Insights auf belastbaren Informationen basieren.
Die Datenbereitstellung ist der finale Schritt, in dem bereinigte und strukturierte Daten für Analysen und Entscheidungen verfügbar gemacht werden. Dazu gehört die Aufbereitung für die Verteilung – oft über Dashboards, Reports oder interaktive Visualisierungen, damit Stakeholder die Daten leicht verstehen und nutzen können.
Du richtest ggf. Datenpipelines oder Schnittstellen ein, über die Nutzer Daten abfragen und damit interagieren können – in einem Format, das ihren Anforderungen entspricht.
Ziel ist es, klare, handlungsrelevante Insights zu liefern, fundierte Entscheidungen zu ermöglichen und Ergebnisse unternehmensweit zu kommunizieren. So zahlt sich die Aufbereitung in konkreten, praktischen Ergebnissen aus.
Die Begriffe Data Wrangling und Data Cleaning werden oft synonym verwendet, bezeichnen aber unterschiedliche Aspekte der Datenvorbereitung. Beide sind essenziell – sie verfolgen jedoch verschiedene Zwecke und Aufgaben. Wer den Unterschied kennt, kann beide Bereiche gezielt und wirksam abdecken.
Data Wrangling ist ein übergreifender Prozess, der Rohdaten in ein analysierbares Format überführt. Er umfasst mehrere Phasen: Daten erfassen, strukturieren, bereinigen und validieren. Ziel ist es, Daten aus unterschiedlichen Quellen so aufzubereiten, dass sie effektiv analysiert und für Insights genutzt werden können. Dadurch werden Daten organisiert, genau und bereit für tiefgehende Analysen.
Data Cleaning ist hingegen ein spezifischer Teil des Wranglings. Es konzentriert sich ausschließlich darauf, die Datenqualität zu erhöhen, indem Fehler und Inkonsistenzen behoben werden. Dazu zählen u. a. das Entfernen doppelter Einträge, das Korrigieren von Tippfehlern, der Umgang mit fehlenden Werten und die Standardisierung von Formaten. Cleaning ist ein zentraler Schritt im Wrangling – aber eben nur einer innerhalb des Gesamtprozesses.
Kurz gesagt: Data Wrangling ist der gesamte Rahmen der Datenvorbereitung mit mehreren Schritten. Data Cleaning ist ein integraler Bestandteil davon und fokussiert speziell auf Genauigkeit und Konsistenz der Daten.
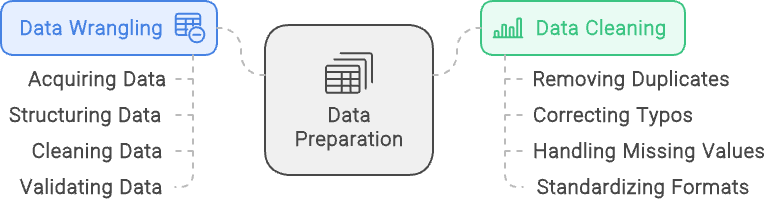
Data Wrangling vs. Data Cleaning: Data Wrangling fokussiert auf Strukturierung und Validierung, während Data Cleaning dafür sorgt, dass saubere, hochwertige Daten vorliegen. Bild erstellt mit napkin.ai
Data Wrangling lässt sich auf viele Arten umsetzen – mit GUI-basierten Tools wie Excel oder Alteryx ebenso wie per Code in Sprachen wie R und Python. Hier ein Überblick über einige Optionen.
Für einfache Aufgaben sind Tabellenkalkulationen wie Microsoft Excel und Google Sheets oft erste Wahl. Sie sind leicht zugänglich und vertraut, ideal zum Sortieren, Filtern und für grundlegende Bereinigungen – besonders bei kleineren Datensätzen oder für den Einstieg ins Data Wrangling.
Dank integrierter Funktionen und Formeln lassen sich Berechnungen schnell durchführen und Daten ohne großes technisches Vorwissen bearbeiten.
Für komplexere Transformationen und Automatisierung werden vor allem Python und R genutzt. Python ist mit Bibliotheken wie Pandas, NumPy und OpenRefine stark bei großen Datensätzen und komplexen Transformationen.
R mit Paketen wie dplyr und tidyr ist besonders in Statistik und Forschung beliebt – mit starken Analysefähigkeiten. Beide Sprachen sind flexibel, erlauben eigene Workflows per Skript und automatisieren Routineaufgaben – ideal für anspruchsvolles Data Wrangling.
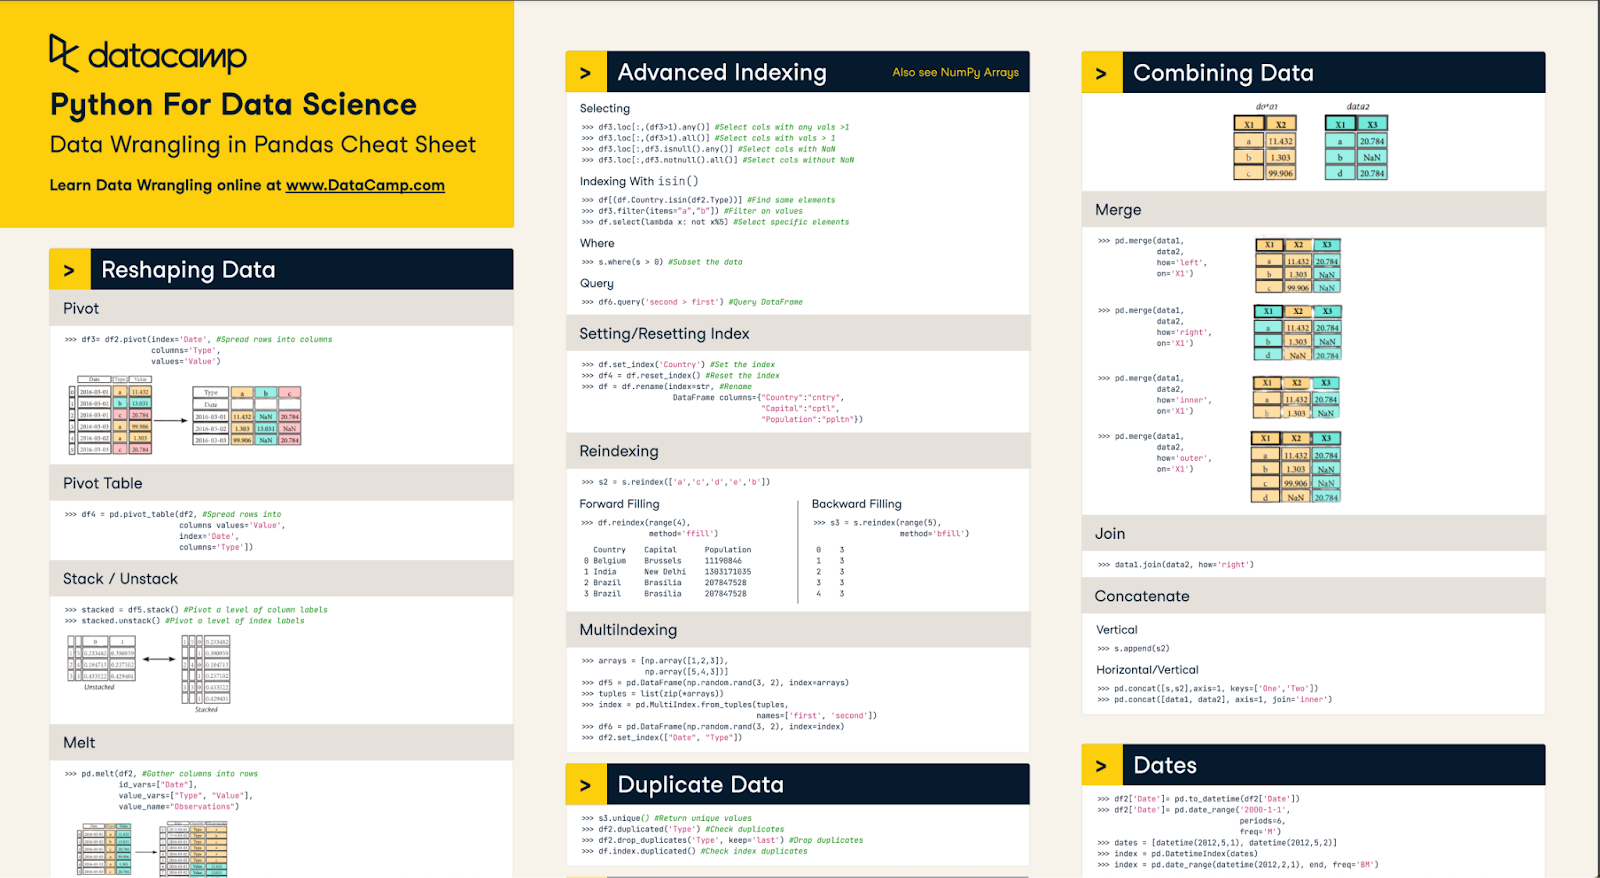
Unser Cheat Sheet zu Data Wrangling mit Pandas hilft dir, die Grundlagen schnell zu meistern
Spezialisierte Tools sind gezielt für Data Wrangling entwickelt und bieten erweiterte Funktionen, die komplexe Aufgaben vereinfachen. Sie eignen sich für alle, die leistungsstarke und zugleich zugängliche Lösungen zum Bereinigen, Strukturieren und Vorbereiten von Daten brauchen – ohne viel zu programmieren.
Alteryx ist hier ein führendes Tool – bekannt für seine intuitive Drag-and-drop-Oberfläche, mit der sich Daten aus vielen Quellen leicht bereinigen, zusammenführen und transformieren lassen. Zahlreiche integrierte Bausteine machen Filter-, Join- oder Aggregationsaufgaben unkompliziert.
Die Cloud-Lösung Alteryx Designer Cloud erweitert diese Möglichkeiten: skalierbar, kollaborativ und ideal für große Datensätze und komplexe Workflows in unterschiedlichen Umgebungen. Ob on-premises oder in der Cloud – Alteryx stellt sicher, dass Daten präzise vorbereitet und analysebereit sind.
Für umfassende Datenprojekte mit End-to-End-Anspruch werden integrierte Plattformen wie KNIME, Apache NiFi und Microsoft Power BI eingesetzt. Sie vereinen Data Wrangling, Integration, Analyse und Visualisierung in einer Umgebung.
KNIME ist bekannt für seine modulare, node-basierte Oberfläche zur visuellen Workflow-Erstellung. Apache NiFi glänzt beim Orchestrieren von Datenflüssen zwischen Systemen, während Power BI Datenaufbereitung mit starker Visualisierung kombiniert. Ideal, wenn Daten nahtlos vorbereitet, analysiert und geteilt werden sollen – für durchgängig datengetriebene Entscheidungen.
Für Data Wrangling mit Python gibt es viele Ansätze. Zwei zentrale Pakete sind Pandas und NumPy. Beide bieten mächtige Funktionen, mit denen sich zentrale Wrangling-Techniken einfach auf Datensätze anwenden lassen.
Ein Großteil der Datenverarbeitung passiert in Python – die Pakete zu beherrschen ist daher Pflicht für Data Professionals. Wichtige Basics sind u. a. High-Level-Bereinigung (z. B. Nulls entfernen), das Zusammenführen von Datensätzen und der Umgang mit fehlenden Werten.
Oft müssen Daten in Python bereinigt werden, bevor sie nutzbar sind – z. B. Leerzeichen am Stringende entfernen, Nullwerte droppen oder Datentypen korrigieren.
Jeder Datensatz ist anders – prüfe daher, ob zusätzliche Reinigung nötig ist. Übung mit verschiedenen Techniken und Code-Beispielen ist der beste Weg, die vielen Möglichkeiten zum Datenbereinigen in Python kennenzulernen.
Bei Strings sind führende/nachgestellte Leerzeichen ein häufiger Stolperstein. Das stört beim Parsen nach Länge, Position oder beim Matching. Am besten nutzt du dafür die Methode str.strip() auf einer Series.
# Example utilizes a pandas series
# If working with a dataframe, call the series using df[col] syntax
s = pd.Series(['1. Ant.  ', '2. Bee!\n', '3. Cat?\t', np.nan, 10, True])
# It is important to include the .str or else the method will not work
s.str.strip()
Nullwerte in Pandas zu droppen ist simpel. Wie man fehlende Werte füllt, behandeln wir später. Verwende einfach dropna(). Über optionale Parameter kannst du genau steuern, wann Zeilen/Spalten fallen – standardmäßig wird jede Zeile mit mindestens einem Nullwert entfernt.
# For any dataframe
df = pd.DataFrame({"name": ['Alfred', 'Batman', 'Catwoman'],
                   "toy": [np.nan, 'Batmobile', 'Bullwhip'],
                   "born": [pd.NaT, pd.Timestamp("1940-04-25"), pd.NaT]}
df.dropna()
Mit .astype() änderst du den Datentyp einer Series. Das ist heikel, weil jeder Wert zum Zieltyp passen muss.
Wenn du z. B. eine Objekt-Series in Integer wandelst, müssen alle Werte Integer sein. Schon ein einziger abweichender Wert führt zum Fehler. Du kannst per Coercion ungültige Werte in Null umwandeln – oft lohnt es sich aber, erst zu prüfen, warum bestimmte Werte nicht konvertiert werden.
DataFrames in Pandas zu mergen ähnelt SQL-Joins. Standardmäßig führt merge() einen Inner Join aus. Achtung: Es join’t auch auf Nulls. Für einen Merge brauchst du einen Schlüssel – du kannst auf mehreren Spalten oder dem Index joinen.
# Create two dataframes
df1 = pd.DataFrame({'lkey': ['foo', 'bar', 'baz', 'foo'],
                    'value': [1, 2, 3, 5]})
df2 = pd.DataFrame({'rkey': ['foo', 'bar', 'baz', 'foo'],
                    'value': [5, 6, 7, 8]})
# merge the df1 DataFrame to the df2 DataFrame using the columns key and rkey as keys
df1.merge(df2, left_on='lkey', right_on='rkey')
Der obige Code merged die DataFrames über die Schlüssel in lkey und rkey. Nicht passende Werte fallen beim Inner Join heraus. Du kannst das Verhalten anpassen: Left/Right/Outer Joins sind ebenfalls möglich. So lassen sich unterschiedliche Quellen effektiv zusammenführen.
Wie man mit fehlenden Werten umgeht, hängt vom Use Case ab. Zuerst klären: Warum fehlt der Wert? Bei technischen Fehlern sollte man diese beheben und – wenn möglich – historische Daten wiederherstellen, bevor man analysiert.
Manchmal kann man fehlende Werte ignorieren. Sind historische Daten wichtig und nicht wiederherstellbar, müssen Lücken gefüllt werden. So gehst du vor:
Die zentrale Methode ist fillna() in Pandas. Für Strings kannst du z. B. einfach df.fillna(value=’missing’) nutzen – oft reicht das schon. In Kombination mit NumPy-Funktionen wie mean(), median() oder mit Lambda-Funktionen kannst du fehlende Werte auch rechnerisch plausibel füllen.
Alternativ bietet Pandas interpolate(), um geordnete Daten (z. B. Zeitreihen) algorithmisch zu vervollständigen. Ziel ist, Werte möglichst realitätsnah zu schätzen.
Data Wrangling in SQL ist besonders effizient, wenn deine Datenbank in der Cloud läuft. So reduzierst du lokale Verarbeitung und Datenübertragung über Netzwerke.
Der Fokus liegt darauf, den Datendurchsatz in Pipelines gezielt zu begrenzen – durch sauberes Extrahieren, Transformieren und Laden. Dazu gehören Filtern, Joins mit Referenztabellen und Aggregationen.
Tabellen filterst du primär mit WHERE. Die Syntax ist einfach, die Möglichkeiten sind groß: von einfachen Vergleichen über String-Muster bis zu Subqueries. Mehrere Bedingungen kannst du mit AND und OR kombinieren.
Ein simples Beispiel für das Filtern eines bestimmten Spaltenwerts:
SELECT *
FROM sample_table
WHERE sample_col = 23
Komplexere Ausdrücke wie LIKE oder IN machen WHERE flexibler. Das nächste Beispiel sucht Personen, deren Name mit J beginnt (Wildcard %) und deren Nachname IN der Liste enthalten ist.
SELECT *
FROM sample_table
WHERE name LIKE ‘J%’ /* looks for people whose name starts with J */
AND last_name IN (‘Smith’, ‘Rockefeller’, ‘Williams’) /* Looks for people whose last name is in this list */
Mit Subqueries kannst du noch dynamischer filtern – z. B. basierend auf Ergebnissen einer anderen Tabelle, etwa Kundennummern nach einem Stichtag.
SELECT *
FROM sample_table
WHERE customer_id IN (SELECT id FROM reference_table WHERE date >= ‘2024-01-01’)
So stellst du sicher, dass genau die benötigten Daten einfließen und Datensätze möglichst klein bleiben. Mächtig ist Filtering auch zum Entfernen von Duplikaten. Fortgeschrittene Techniken sind HAVING für Aggregationen und QUALIFY mit Fensterfunktionen.
Joins liefern Zusatzinformationen für deinen Datensatz. SQL kennt u. a. INNER, OUTER, LEFT und RIGHT. INNER behält nur gematchte Zeilen, OUTER auch ungematchte – abhängig von der Seite (left/right).
Beim LEFT-Join bleiben alle Zeilen der linken Tabelle, beim RIGHT-Join alle der rechten. Du kannst sie mit INNER/OUTER kombinieren oder FULL OUTER JOIN nutzen, der alle Zeilen beider Tabellen vereint.
Ein Beispiel:
SELECT *
FROM a
LEFT OUTER JOIN
b
WHERE a.id = b.id
Hier steht Tabelle a links (zuerst genannt), b rechts (zweitgenannt). Der LEFT OUTER JOIN verbindet a und b über a.id = b.id und behält alle Zeilen aus a, auch wenn es keine Entsprechung in b gibt. Joins sind essenziell, um benötigte Zusatzdaten einzubinden.
GROUP BY ermöglicht Aggregationen – ideal, um Daten zu verdichten und vorzuverarbeiten, bevor sie weiter in die Pipeline gehen. Aggregationen liefern schnelle Übersichten, z. B. Gesamtsales pro Kundennummer:
SELECT
Customer_ID,
SUM(sales)
FROM sample_table
GROUP BY Customer_ID
Es gibt zahlreiche Funktionen wie SUM, MEAN, MAX und MIN, mit denen du schnell ein Gefühl für deine Daten bekommst. Nutze Aggregationen, um den Dateneinfluss auf nachgelagerte Pipelines zu reduzieren.
In diesem Abschnitt zeigen wir praxisnahe Beispiele für Data-Wrangling-Techniken. Im Fokus: Daten standardisieren, Quellen zusammenführen und Text verarbeiten.
Einheitliche Einheiten sind entscheidend. Wenn dasselbe in unterschiedlichen Maßeinheiten oder Währungen gemessen wird, verfälscht das Analysen.
Ein einfaches Beispiel ist die Umrechnung verschiedener Währungen in USD per SQL. Angenommen, es gibt zwei Tabellen: sales mit Verkäufen je Region und currency_exchange mit Wechselkursen je Region und Tag. Eine mögliche Umsetzung:
SELECT
a.sale_id,
a.region,
CASE WHEN region <> ‘US’
	THEN a.sale_price * b.exchange_rate
	ELSE a.sale_price
END AS sale_price
FROM sales AS a
LEFT OUTER JOIN
currency_exchange AS b
WHERE a.region = b.region
Hier werden sale_id und region aus sales gezogen und über die Region mit der Referenztabelle currency_exchange verbunden, um den Wechselkurs zu erhalten. Häufig spielt auch das Datum eine Rolle, um den tagesaktuellen Kurs zu nutzen.
Ein großer Teil des Wranglings bereitet Daten für Machine-Learning-Modelle vor. Viele aktuelle Modelle arbeiten mit natürlicher Sprache – ein typischer Vorläufer ist Sentiment-Analyse auf Textdaten.
Wichtig ist dabei die Normalisierung von Text und das Entfernen von Interpunktion. Groß-/Kleinschreibung oder Satzzeichen liefern oft wenig Mehrwert und werden besser vereinheitlicht.
Dafür nutzen wir Standard-Python-Module und re. Unten ein Beispiel zum Entfernen von Satzzeichen, zur Kleinschreibung und zum Trimmen von Leerzeichen.
# import regex
import re

# input string
test_string = "       Python 3.0, released in 2008, was a major revision of the language that is not completely backward compatible and much Python 2 code does not run unmodified on Python 3. With Python 2's end-of-life, only Python 3.6.x[30] and later are supported, with older versions still supporting e.g. Windows 7 (and old installers not restricted to 64-bit Windows)."
# remove whitespaces
no_space_string = test_string.strip()

# convert to lower case
lower_string = no_space_string .lower()

# remove numbers
no_number_string = re.sub(r'\d+','',lower_string)
print(no_number_string)
Dieser Snippet bildet eine gute Basis, um Leerzeichen zu entfernen, alles in Kleinbuchstaben zu wandeln und Zahlen/nichtalphabetische Zeichen zu löschen.
Data Wrangling ist ein zentraler Bestandteil der Vorbereitung für Machine-Learning-Modelle und Analysen. In Python helfen dir Pakete wie pandas und numpy, in SQL stehen dir u. a. WHERE- und GROUP BY-Klauseln zur Verfügung, um Daten gezielt aufzubereiten.
Die Beherrschung dieser Techniken ist für angehende Datenprofis unverzichtbar. Wenn du tiefer einsteigen möchtest, empfehlen wir diese Ressourcen:
Top-DataCamp-Kurse
Kurs
Kurs
Lernpfad