Curso
Cómo escribir código Python eficiente
4 h
155.5K
Cada vez que pulsas Ctrl+Z para deshacer un error, haces clic en el botón de retroceso del navegador o ves cómo una función recursiva desenrolla sus resultados, estás utilizando una pila. Como están tan integradas en el software que usas a diario, a menudo interactúas con pilas sin darte ni cuenta.
En este artículo veremos qué es una pila, la lógica que hay detrás, compararemos distintas estrategias de implementación con las librerías estándar de Python y las aplicaremos para resolver problemas algorítmicos.
Te recomiendo hacer nuestro curso sobre Writing Efficient Python Code para combinar tu conocimiento de estructuras de datos con buenas prácticas de rendimiento, y tener a mano la Python Basics Cheat Sheet como referencia rápida.
Antes de ver código, conviene entender la base conceptual que hace de la pila en Python una herramienta tan potente. Veamos el principio clave detrás de las pilas y cómo se diferencian de otras estructuras de datos habituales.
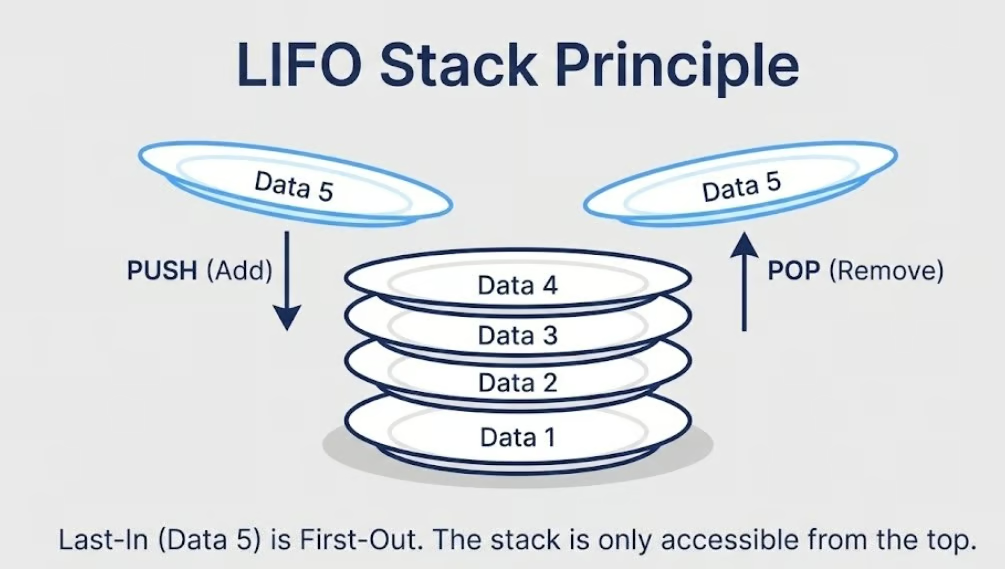
Una pila es una estructura de datos lineal que sigue el principio Last-In-First-Out (LIFO, último en entrar, primero en salir). Es decir, el elemento añadido más recientemente es siempre el primero en eliminarse. Piensa en una pila de platos en una cafetería: apilas los nuevos arriba y siempre coges primero el de arriba. Nunca sacas un plato del medio o del fondo. El acceso está totalmente restringido a la parte superior.
Esta única restricción —acceso solo por arriba— es lo que da a las pilas su predictibilidad y eficiencia. Cada elemento entra y sale por el mismo extremo, lo que mantiene las operaciones simples y rápidas.
Algo a tener en cuenta desde el principio es que Python no incluye un tipo primitivo de pila dedicado, como sí hacen otros lenguajes. No hay ninguna palabra clave stack ni una clase integrada. En su lugar, Python ofrece alternativas integradas muy sólidas como lists, collections.deque y queue.LifoQueue, que pueden comportarse como pilas. Veremos cada una en detalle más adelante.
Entender qué es una pila resulta mucho más claro cuando ves qué no es. Las dos estructuras con las que más se comparan son las colas y las listas estándar de Python.
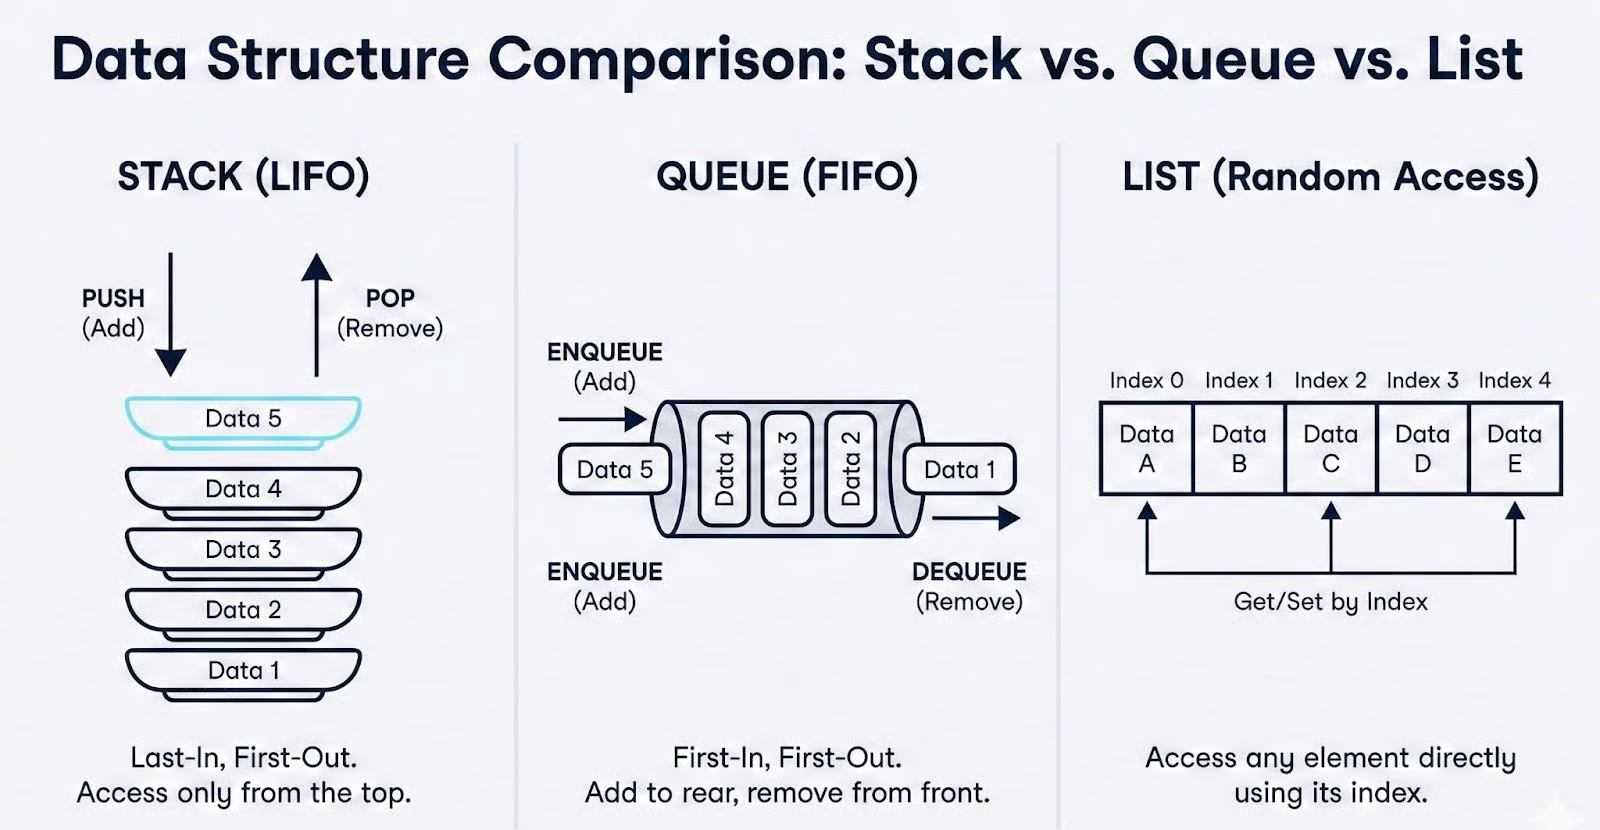
Una cola sigue el principio First-In-First-Out (FIFO), justo lo contrario de una pila. En una cola, los elementos se añaden por detrás y se eliminan por delante, como una fila de gente esperando en una taquilla. Pilas y colas son lineales y restringen cómo accedes a los elementos, pero lo hacen en direcciones opuestas.
Elegir la equivocada puede romper silenciosamente la lógica de un algoritmo. Por ejemplo, sustituir una pila por una cola en una búsqueda en profundidad la convertiría en una búsqueda en anchura, con resultados totalmente distintos.
Una lista estándar de Python, en cambio, ofrece acceso aleatorio. Puedes leer, insertar o borrar elementos en cualquier índice con operaciones como my_list[3] o my_list.insert(2, value). Esta flexibilidad es útil en muchos contextos, pero también significa que nada impide que accedas o modifiques accidentalmente elementos en medio de la estructura.
Cuando implementas un algoritmo que depende de un orden LIFO estricto, como backtracking, análisis sintáctico o funcionalidad de deshacer, la naturaleza sin restricciones de una lista puede introducir errores sutiles.
Por eso el patrón de acceso restringido de una pila es una característica, no una limitación. Al permitir interactuar solo con el elemento superior, una pila en Python refuerza la corrección por diseño. No puedes desencolar del extremo equivocado ni sobrescribir un elemento enterrado en la estructura.
En el diseño de algoritmos, restricciones como estas mantienen tu lógica limpia y tu código predecible.
Ahora que sabemos qué es una pila en Python y cómo se diferencia de otras estructuras, veamos las operaciones fundamentales que toda pila admite y analicemos su eficiencia.
Toda implementación de pila se basa en un conjunto reducido de operaciones estándar, independientemente del lenguaje. Son los ladrillos que usarás siempre que trabajes con una pila.
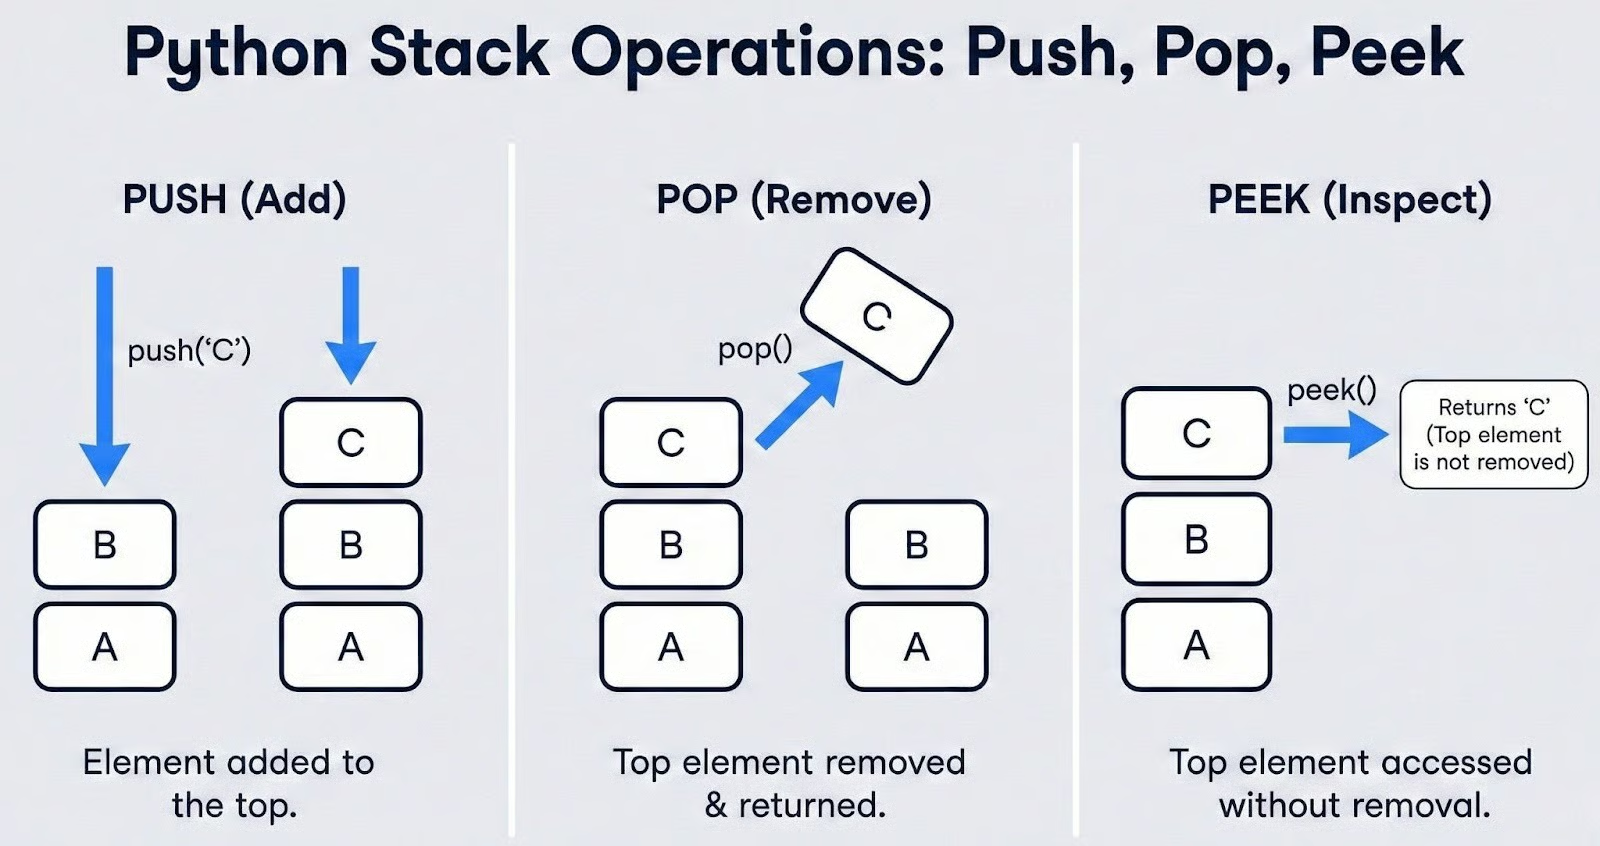
Push añade un elemento a la parte superior. Si la pila contiene [A, B] y haces push de C, la pila pasa a ser [A, B, C], con C arriba.
Pop elimina y devuelve el elemento que está arriba. Siguiendo el ejemplo, hacer pop en [A, B, C] devuelve C y deja la pila como [A, B].
Peek (a veces llamada top) te permite ver el elemento superior sin retirarlo. Es útil cuando tu lógica necesita inspeccionar el valor superior antes de decidir si hacer pop, un patrón frecuente en análisis de expresiones y problemas de paréntesis balanceados.
Además de estas tres operaciones clave, dos métodos auxiliares son importantes para escribir código con pilas seguro y sin errores:
is_empty() comprueba si la pila contiene elementos. Llamar a pop o peek en una pila vacía es una fuente habitual de errores en tiempo de ejecución, así que comprobar primero si está vacía es un buen hábito de programación defensiva.
size() devuelve cuántos elementos hay en la pila. Es útil para seguir la profundidad de una recursión o cuántos elementos quedan por procesar.
Por último, conviene definir un término que verás en libros y entrevistas: Stack Underflow. Es la condición de error que se produce cuando intentas hacer pop o peek en una pila vacía. No hay nada que quitar ni ver, así que la operación no es válida.
La excepción o el comportamiento exacto dependen de la implementación. Veremos cómo lo maneja Python concretamente cuando analicemos list, deque y LifoQueue en la siguiente sección.
Una de las grandes razones por las que las pilas se usan tanto en algoritmos es su eficiencia. Desglosemos la complejidad temporal y espacial de cada operación.
Push es O(1). En una implementación eficiente, añadir un elemento arriba es una operación de tiempo constante. La pila no necesita desplazar ni reordenar elementos; simplemente coloca el nuevo al final. Esto se cumple con collections.deque y, en el caso amortizado, con list de Python.
Pop es O(1). Quitar el elemento superior es igual de rápido. Se accede a la última posición, se devuelve el valor y se decrementa el contador interno. Tampoco hay desplazamientos.
Peek es O(1). Ver el elemento superior sin retirarlo es una consulta directa por índice, también de tiempo constante.
Buscar es O(n). Aquí se ve la contrapartida deliberada de las pilas. Si necesitas saber si un valor concreto existe en la pila, no queda otra que recorrer sus n elementos de arriba a abajo.
Las pilas no están pensadas para búsquedas arbitrarias. Sacrifican capacidad de búsqueda a cambio de push y pop rápidos y predecibles. Si tu caso requiere búsquedas frecuentes, mejor usa un set o un diccionario.
La complejidad espacial es O(n). Una pila con n elementos requiere memoria proporcional a n. No hay sobrecarga oculta más allá de almacenar los elementos y una pequeña constante para la contabilidad interna.
Resumen rápido:
|
Operación |
Complejidad temporal |
Notas |
|
Push |
O(1) |
Tiempo constante. O(1) amortizado para listas de Python |
|
Pop |
O(1) |
Tiempo constante |
|
Peek |
O(1) |
Acceso directo al elemento superior |
|
Búsqueda |
O(n) |
Hay que recorrer todos los elementos |
|
Espacio |
O(n) |
Lineal en el número de elementos almacenados |
La idea clave: una pila en Python está optimizada para inserciones y eliminaciones rápidas en un solo extremo. Si la usas para lo que está diseñada —gestionar acceso ordenado LIFO—, el rendimiento es excelente. Si te ves buscando en una pila con regularidad, es señal de que deberías reconsiderar la estructura de datos.
Con la teoría y el análisis de complejidad vistos, toca escribir código. Python ofrece tres formas principales de implementar una pila, cada una con sus ventajas y concesiones. Recorremos las tres y vemos cuándo conviene cada una.
La forma más directa de crear una pila en Python es con la list integrada. Como las listas son arrays dinámicos que permiten añadir y quitar por el final, se ajustan naturalmente al comportamiento de una pila.
El método .append() actúa como push y .pop() sin argumentos elimina y devuelve el último elemento. Veámoslo en este ejemplo:
# Creación de una pila con una lista de Python
stack = []

# Push de elementos
stack.append(10)
stack.append(20)
stack.append(30)
print(stack)

# Pop del elemento superior
top = stack.pop()
print(top)
print(stack)

# Peek del elemento superior
print(stack[-1])
[10, 20, 30]
30
[10, 20]
20Funciona bien, pero debes tratar con cuidado el caso de pila vacía. En Python, tanto .pop() como stack[-1] lanzan IndexError cuando la lista está vacía. Así es como Python refleja la condición de Stack Underflow que definimos antes.
La mejor práctica es envolver estas llamadas en un bloque try/except o comprobar si está vacía antes de acceder al tope, como en este ejemplo:
# Gestión de Stack Underflow con try/except
stack = []

try:
    stack.pop()
except IndexError:
    print("Stack Underflow: cannot pop from an empty stack")

try:
    top = stack[-1]
except IndexError:
    print("Stack Underflow: cannot peek at an empty stack")

# Alternativamente, comprueba antes de acceder
if stack:
    top = stack.pop()
else:
    print("Stack is empty")
Stack Underflow: cannot pop from an empty stack
Stack Underflow: cannot peek at an empty stack
Stack is emptyHay un matiz de rendimiento interesante. Las listas de Python se respaldan con arrays dinámicos. Cuando llamas a .append(), la operación suele ser O(1) instantánea. Sin embargo, cuando el array interno se queda sin espacio preasignado, Python debe reservar un bloque mayor y copiar todos los elementos.
Esta reasignación ocasional hace que .append() sea O(1) amortizada y no estrictamente O(1). En la práctica, el retraso es poco frecuente y breve, pero en aplicaciones sensibles a latencia o en tiempo real, esta imprevisibilidad puede importar.
Aun con este matiz, .append() y .pop() sobre una lista son la opción preferida para la mayoría de tareas sencillas con pilas. No requiere imports, la sintaxis es familiar y la mayoría de desarrolladores lo dominan: una buena elección por defecto para scripts, prototipos y problemas de entrevista donde prima la sencillez.
Si necesitas un rendimiento O(1) constante sin las pausas ocasionales por reasignación, collections.deque es la mejora recomendada. Su nombre viene de "double-ended queue", pero funciona a la perfección como pila de alto rendimiento en Python. Nuestro ejemplo anterior con sintaxis de deque queda así:
from collections import deque

# Creación de una pila con deque
stack = deque()

# Push de elementos
stack.append(10)
stack.append(20)
stack.append(30)
print(stack)

# Pop del elemento superior
top = stack.pop()
print(top)
print(stack)

# Peek del elemento superior
print(stack[-1])
deque([10, 20, 30])
30
deque([10, 20])
20Observa que la interfaz es idéntica al enfoque con listas. .append(), .pop() y [-1] funcionan igual. El comportamiento de IndexError al acceder en vacío también es el mismo, así que no necesitas cambiar tu código de manejo de errores:
from collections import deque

stack = deque()

try:
    stack.pop()
except IndexError:
    print("Stack Underflow: cannot pop from an empty deque stack")
Stack Underflow: cannot pop from an empty deque stackLa diferencia crítica está por debajo. Un deque se implementa como una lista doblemente enlazada de bloques de tamaño fijo, no como un único array. Esto significa que nunca necesita reasignar y copiar toda la estructura cuando crece.
Cada .append() y .pop() es O(1) real y garantizado, no amortizado, sino constante. Para trabajo algorítmico con miles o millones de pushes y pops, esta consistencia suma.
La biblioteca estándar también incluye queue.LifoQueue, una implementación de pila pensada para programas multihilo. El "LIFO" del nombre confirma el orden Last-In-First-Out, pero la interfaz y el comportamiento difieren de los dos enfoques anteriores. Veámoslo:
from queue import LifoQueue

# Creación de una pila segura para hilos
stack = LifoQueue()

# Push con .put()
stack.put(10)
stack.put(20)
stack.put(30)
print(stack.qsize())

# Pop con .get()
top = stack.get()
print(top)
print(stack.qsize())
3
30
2Lo primero que notarás es el cambio de sintaxis. Push pasa a ser .put() y pop es .get(). Esta nomenclatura viene del patrón productor-consumidor del módulo queue, donde un hilo "pone" elementos y otro los "obtiene".
Hay dos diferencias de comportamiento importantes.
Primero, LifoQueue no tiene un método seguro de peek. No hay forma integrada de ver el elemento superior sin retirarlo. Podrías acceder a atributos internos, pero hacerlo en un contexto multihilo invalida el objetivo de usar una clase thread-safe y arriesga condiciones de carrera.
Segundo, LifoQueue no lanza IndexError cuando intentas obtener de una pila vacía. Por defecto, .get() se bloquea: pausa el hilo que llama y espera indefinidamente hasta que otro hilo haga put de un elemento. Si quieres comportamiento no bloqueante, puedes pasar block=False, que lanza una excepción queue.Empty. Veámoslo:
from queue import LifoQueue, Empty

stack = LifoQueue()

# get no bloqueante lanza Empty, no IndexError
try:
    stack.get(block=False)
except Empty:
    print("Stack is empty — no items to get")
Stack is empty — no items to getPor el mecanismo interno de bloqueo que hace a LifoQueue segura para hilos, sus operaciones tienen más sobrecarga que list o deque. Es una mala elección para código monohilo. Úsala solo cuando tengas varios hilos produciendo y consumiendo datos en paralelo; en cualquier otro caso, opta por deque o list.
Con tres opciones disponibles, aquí tienes una comparativa para guiar tu decisión:
|
Característica |
|
|
|
|
Import necesario |
No |
Sí ( |
Sí ( |
|
Método push |
|
|
|
|
Método pop |
|
|
|
|
Método peek |
|
|
Sin método seguro |
|
Error en vacío |
|
|
Bloquea o |
|
Velocidad push/pop |
O(1) amortizada |
O(1) real |
O(1) con sobrecarga de bloqueo |
|
Segura para hilos |
No |
No |
Sí |
|
Ideal para |
Scripts simples, prototipos |
Algoritmos, código crítico en rendimiento |
Productor-consumidor multihilo |
Este es mi marco de decisión para elegir la mejor implementación:
Usa list cuando necesites una pila rápida sin imports, como en scripts, notebooks y pizarras en entrevistas.
Usa collections.deque cuando escribas código algorítmico, proceses grandes volúmenes de datos o el rendimiento importe.
Usa queue.LifoQueue solo cuando tengas un escenario multihilo natural con acceso concurrente.
También verás tutoriales que implementan una pila desde cero con una lista enlazada personalizada, donde cada nodo guarda un valor y un puntero al de abajo. En mi opinión, es un ejercicio didáctico valioso que profundiza en cómo funcionan internamente las pilas y cómo se encadenan las referencias en memoria.
Sin embargo, en código de producción en Python, una pila con lista enlazada casi siempre es más lenta que un deque por la sobrecarga de crear objetos nodo individuales. Para trabajo real, collections.deque ofrece la mejor combinación de velocidad, claridad y fiabilidad.
Saber implementar una pila en Python es solo la mitad. Su verdadero valor se ve cuando resuelven problemas que serían mucho más complejos sin el orden LIFO. Veamos tres aplicaciones clásicas que aparecen constantemente en entrevistas, sistemas software y diseño de algoritmos.
El problema de paréntesis balanceados es de los más preguntados con pilas. Dada una cadena con corchetes como (), [] y {}, debes determinar si cada apertura tiene su cierre correspondiente en el orden correcto.
La lógica encaja perfecto con una pila. Al recorrer la cadena de izquierda a derecha, haces push de cada apertura. Al encontrar un cierre, haces pop del tope y compruebas si coincide.
Si la pila está vacía cuando intentas hacer pop, o si el par no coincide, la cadena no está balanceada. Tras procesarla entera, la pila debe estar vacía. Cualquier apertura restante significa que algo no se cerró. Veámoslo en acción:
from collections import deque

def is_balanced(expression):
    stack = deque()
    matching = {')': '(', ']': '[', '}': '{'}

    for char in expression:
        if char in '([{':
            stack.append(char)
        elif char in ')]}':
            if not stack:
                return False  # cierre sin apertura
            if stack.pop() != matching[char]:
                return False  # par no coincidente

    return len(stack) == 0  # si está balanceada, la pila queda vacía

# Casos de prueba
print(is_balanced("([])"))
print(is_balanced("{[()]}"))
print(is_balanced("([)]"))
print(is_balanced("(("))
print(is_balanced(""))
True
True
False
False
TrueSigamos "{[()]}" paso a paso para ver la pila en acción:
|
Carácter |
Acción |
Estado de la pila |
|
|
Push |
|
|
|
Push |
|
|
|
Push |
|
|
|
Pop |
|
|
|
Pop |
|
|
|
Pop |
|
La pila queda vacía al final, así que la expresión está balanceada.
Esta misma lógica va mucho más allá de las entrevistas. Los compiladores e intérpretes la usan para validar sintaxis, asegurando que cada etiqueta, corchete o delimitador de apertura en el código fuente tenga su cierre correcto.
Si alguna vez has visto SyntaxError: unexpected EOF en Python, has visto una variante de esta comprobación. Validadores de HTML, parsers de JSON e incluso linters de ficheros de configuración dependen de este enfoque basado en pilas.
Depth-first search es uno de los algoritmos básicos de recorrido de grafos, y la pila es la estructura que lo impulsa. La idea es sencilla: empiezas en un nodo y exploras lo más profundo posible por una rama antes de retroceder para probar la siguiente. La naturaleza LIFO de una pila en Python hace que este comportamiento de "ir profundo primero" ocurra de forma natural.
En cursos introductorios se enseña DFS con recursión, donde la pila de llamadas gestiona implícitamente el orden del recorrido. Pero el enfoque recursivo tiene una limitación práctica: el límite de recursión por defecto de Python es de 1.000 frames.
Para grafos grandes o muy anidados, esto provoca RecursionError. La versión iterativa, que usa una pila explícita, evita el problema y te da control total sobre el recorrido.
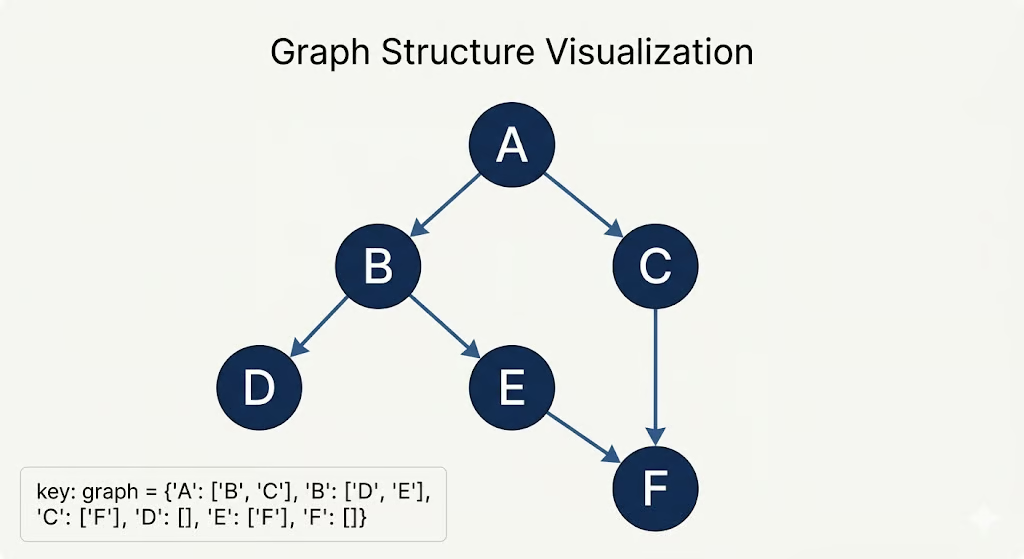
Veamos un ejemplo de código. Haremos un DFS en el siguiente grafo:
from collections import deque

def dfs_iterative(graph, start):
    visited = set()
    stack = deque()
    stack.append(start)
    traversal_order = []

    while stack:
        node = stack.pop()
        if node not in visited:
            visited.add(node)
            traversal_order.append(node)
            # Empuja vecinos a la pila
            # Invertir para mantener el orden izquierda-derecha tras hacer pop LIFO
            for neighbor in reversed(graph[node]):
                if neighbor not in visited:
                    stack.append(neighbor)

    return traversal_order

# Grafo de ejemplo como lista de adyacencia
graph = {
    'A': ['B', 'C'],
    'B': ['D', 'E'],
    'C': ['F'],
    'D': [],
    'E': ['F'],
    'F': []
}

print(dfs_iterative(graph, 'A'))
['A', 'B', 'D', 'E', 'F', 'C']Sigamos la ejecución para ver cómo la pila gobierna el recorrido:
|
Paso |
Pop |
Vecinos apilados |
Pila |
Visitados |
|
1 |
A |
B, C |
|
|
|
2 |
B |
D, E |
|
|
|
3 |
D |
(ninguno) |
|
|
|
4 |
E |
F |
|
|
|
5 |
F |
(ninguno) |
|
|
|
6 |
C |
F (ya visitado) |
|
|
Observa cómo el orden LIFO fuerza al algoritmo a explorar por completo las ramas A → B → D y A → B → E → F antes de retroceder para visitar C. Esto es justo lo que diferencia DFS de BFS, que usa una cola y explora todos los vecinos a la profundidad actual antes de bajar más.
El patrón iterativo de DFS funciona para árboles, grafos dirigidos y no dirigidos. También es la base de algoritmos como ordenación topológica, detección de ciclos y resolución de laberintos y puzles.
Si has usado un editor de texto, una app de dibujo o una hoja de cálculo, te has apoyado en deshacer y rehacer sin pensar en cómo funciona por debajo. El mecanismo es elegante y se basa exactamente en dos pilas.
Una pila de deshacer guarda cada acción o estado a medida que el usuario hace cambios. Cuando pulsa deshacer, el estado actual se hace pop de la pila de deshacer y se hace push en la pila de rehacer.
Si luego pulsa rehacer, el estado se hace pop de la pila de rehacer y se vuelve a hacer push a la de deshacer. Si realiza un cambio nuevo tras deshacer, la pila de rehacer se limpia. No puedes rehacer algo que ha sido sobrescrito por una acción nueva. Veámoslo con código:
from collections import deque

class TextEditor:
    def __init__(self):
        self.content = ""
        self.undo_stack = deque()
        self.redo_stack = deque()

    def type_text(self, text):
        """Registrar el estado actual y aplicar texto nuevo."""
        self.undo_stack.append(self.content)
        self.content += text
        self.redo_stack.clear()  # una acción nueva invalida el historial de rehacer

    def undo(self):
        """Volver al estado anterior."""
        if not self.undo_stack:
            print("Nothing to undo")
            return
        self.redo_stack.append(self.content)
        self.content = self.undo_stack.pop()

    def redo(self):
        """Reaplicar la última acción deshecha."""
        if not self.redo_stack:
            print("Nothing to redo")
            return
        self.undo_stack.append(self.content)
        self.content = self.redo_stack.pop()

    def show(self):
        print(f'Content: "{self.content}"')

# Demostración del flujo deshacer/rehacer
editor = TextEditor()
editor.type_text("Hello")
editor.show()

editor.type_text(" World")
editor.show()

editor.type_text("!")
editor.show()

editor.undo()
editor.show()

editor.undo()
editor.show()

editor.redo()
editor.show()

editor.type_text(" Python")
editor.show()

editor.redo()
Content: "Hello"
Content: "Hello World"
Content: "Hello World!"
Content: "Hello World"
Content: "Hello"
Content: "Hello World"
Content: "Hello World Python"
Nothing to redoEl flujo de estados entre ambas pilas sigue un patrón claro:
|
Acción |
Pila de deshacer |
Contenido |
Pila de rehacer |
|
Escribir "Hello" |
|
|
|
|
Escribir " World" |
|
|
|
|
Escribir "!" |
|
|
|
|
Deshacer |
|
|
|
|
Deshacer |
|
|
|
|
Rehacer |
|
|
|
|
Escribir " Python" |
|
|
|
Este patrón de dos pilas no se limita a editores de texto. Aparece allí donde el usuario necesita ir hacia atrás y adelante en una secuencia de cambios (prácticamente en todas partes):
El principio subyacente es siempre el mismo. Una pila de Python guarda el historial, la otra el futuro, y el orden LIFO garantiza que siempre vuelvas primero al estado más reciente.
Las pilas también desempeñan un papel importante bajo el capó de cualquier programa de Python, y potencian técnicas de optimización que pueden reducir drásticamente la complejidad temporal de ciertos problemas. Veamos ambas dimensiones.
Cada vez que llamas a una función en Python, ocurre algo entre bambalinas que no controlas directamente. Python empuja un nuevo frame en una estructura interna llamada pila de llamadas (call stack). Ese frame contiene las variables locales de la función, sus parámetros y un puntero a la línea que inició la llamada.
Cuando la función termina, su frame se hace pop de la call stack y el control vuelve al llamador.
Puedes inspeccionar este comportamiento con un ejemplo sencillo:
def function_c():
    print("Inside function_c")
    # En este punto, la call stack contiene:
    # [main → function_a → function_b → function_c]  (top)

def function_b():
    print("Inside function_b")
    function_c()

def function_a():
    print("Inside function_a")
    function_b()

function_a()
Inside function_a
Inside function_b
Inside function_cCuando se ejecuta function_c, la call stack tiene cuatro frames apilados. A medida que cada función completa, su frame se desapila en orden LIFO: primero function_c, luego function_b, después function_a y, por último, el ámbito del módulo principal.
Este es exactamente el mecanismo que hace que la recursión funcione. Cada llamada recursiva empuja un nuevo frame con sus variables locales, y los resultados se desenrollan al desapilarse los frames. Veámoslo:
def factorial(n):
    if n <= 1:
        return 1
    return n * factorial(n - 1)

print(factorial(5))

# Call stack en el punto más profundo:
# factorial(1)  ← tope (devuelve 1)
# factorial(2)  ← esperando factorial(1)
# factorial(3)  ← esperando factorial(2)
# factorial(4)  ← esperando factorial(3)
# factorial(5) ← esperando factorial(4)120El problema surge cuando la recursión es demasiado profunda. Python fija por defecto un límite de 1.000 frames para evitar que la call stack consuma toda la memoria. Si tu función recursiva supera ese límite, Python lanza RecursionError. Veámoslo:
def infinite_recursion(n):
    return infinite_recursion(n + 1)

try:
    infinite_recursion(0)
except RecursionError:
    print("RecursionError: maximum recursion depth exceeded")
RecursionError: maximum recursion depth exceededPuedes consultar y modificar este límite con el módulo sys, aunque aumentarlo debe hacerse con cautela:
import sys

print(sys.getrecursionlimit())
sys.setrecursionlimit(5000) # Aumenta con precaución5000La distinción importante es que la call stack es una estructura de nivel sistema gestionada por el intérprete de Python. No puedes hacer push o pop en ella directamente. Las pilas list, deque y LifoQueue que construimos antes son estructuras definidas por el usuario que viven en el heap de tu programa. Sirven a propósitos distintos, pero todas siguen el principio LIFO.
Una pila monótona es una variación especializada en la que los elementos se mantienen en orden no decreciente o no creciente (a veces estrictamente, según el problema). Cada vez que empujas un elemento nuevo, primero desapilas los que violarían la restricción de orden. Es la clave para resolver toda una clase de problemas de optimización en tiempo lineal.
El ejemplo clásico es Next Greater Element: dado un array de enteros, encuentra el primer elemento mayor a la derecha de cada uno. El enfoque de fuerza bruta con bucles anidados es O(n²). Para cada elemento, escaneas todo lo que hay a su derecha. Una pila monótona lo resuelve en O(n).
La idea es recorrer el array de derecha a izquierda, manteniendo una pila decreciente. Para cada elemento, haces pop de todo lo que sea menor o igual que él. Esos valores nunca podrán ser el "siguiente mayor" de ningún elemento futuro a la izquierda.
Lo que quede arriba de la pila tras los pops es la respuesta para el elemento actual. Luego empujas el elemento actual a la pila. Veámoslo con código. Observa que -1 en este caso significa que no hay un elemento mayor a la derecha:
from collections import deque

def next_greater_element(nums):
    n = len(nums)
    result = [-1] * n  # por defecto: no se encontró mayor
    stack = deque()     # pila decreciente monótona (guarda valores)

    # Recorrer de derecha a izquierda
    for i in range(n - 1, -1, -1):
        # Desapila elementos que no son mayores que el actual
        while stack and stack[-1] <= nums[i]:
            stack.pop()

        # Si la pila no está vacía, el tope es el siguiente mayor
        if stack:
            result[i] = stack[-1]

        # Empuja el elemento actual
        stack.append(nums[i])

    return result

nums = [4, 5, 2, 25, 7, 18]
print(next_greater_element(nums))
[5, 25, 25, -1, 18, -1]Sigamos la ejecución para ver cómo se mantiene la propiedad monótona:
|
Paso (derecha a izquierda) |
Actual |
Pila antes |
Pops |
Siguiente mayor |
Pila después |
|
|
18 |
|
— |
-1 |
|
|
|
7 |
|
— |
18 |
|
|
|
25 |
|
7,18 |
-1 |
|
|
|
2 |
|
— |
25 |
|
|
|
5 |
|
2 |
25 |
|
|
|
4 |
|
— |
5 |
|
Fíjate en que cada elemento se empuja exactamente una vez y se desapila como mucho una vez en todo el recorrido. Por eso la complejidad temporal total es O(n) a pesar del bucle while interno. El número acumulado de pushes y pops en todas las iteraciones no supera 2n.
Como comenté, hay muchos problemas similares que el patrón de pila monótona acelera de O(n²) a O(n), entre ellos:
En todos los casos, la idea central es la misma: la restricción monótona te permite descartar elementos que ya no pueden influir en resultados futuros, podando efectivamente el espacio de búsqueda de cuadrático a lineal.
La pila es de las primeras estructuras de datos que aprende cualquier programador y de las últimas de las que deja de sacar partido; paradójicamente, justo lo contrario de su naturaleza LIFO.
En este artículo hemos visto cómo esta restricción LIFO ayuda en múltiples escenarios: desde validar corchetes anidados y dirigir recorridos DFS, hasta gestionar estados de deshacer/rehacer y optimizar problemas de arrays con pilas monótonas.
Si te quedas con una recomendación, que sea esta: usa collections.deque como tu implementación de pila en Python por defecto, salvo que tengas un motivo específico para no hacerlo.
Como siguiente paso, te recomiendo nuestro curso de Data Structures and Algorithms in Python.
Cursos de Python
Curso
Curso
programa
Tutorial
Sejal Jaiswal
24 min
Tutorial
Allan Ouko
7 min
Tutorial
Abid Ali Awan
7 min
Tutorial
Stephen Gruppetta
12 min
Tutorial
Allan Ouko
7 min
Tutorial
Théo Vanderheyden
12 min