Cours
Écrire du code Python efficace
4 h
155.6K
Chaque fois que vous appuyez sur Ctrl+Z pour annuler une action, cliquez sur le bouton Précédent de votre navigateur, ou regardez une fonction récursive dérouler ses résultats, vous vous appuyez sur une pile. Comme elles sont profondément intégrées aux logiciels que vous utilisez au quotidien, vous interagissez souvent avec des piles sans même vous en rendre compte.
Dans cet article, nous allons voir ce qu’est une pile, la logique au cœur des piles, comparer différentes stratégies d’implémentation en nous appuyant sur les bibliothèques standard de Python, puis les appliquer pour résoudre des problèmes algorithmiques.
Je vous recommande notre cours sur Writing Efficient Python Code pour associer vos connaissances en structures de données aux bonnes pratiques de performance, et de garder sous la main la Python Basics Cheat Sheet comme aide‑mémoire.
Avant de passer au code, il est important de comprendre le socle conceptuel qui fait de la pile Python un outil aussi puissant. Voyons le principe fondamental des piles et en quoi elles diffèrent d’autres structures de données courantes.
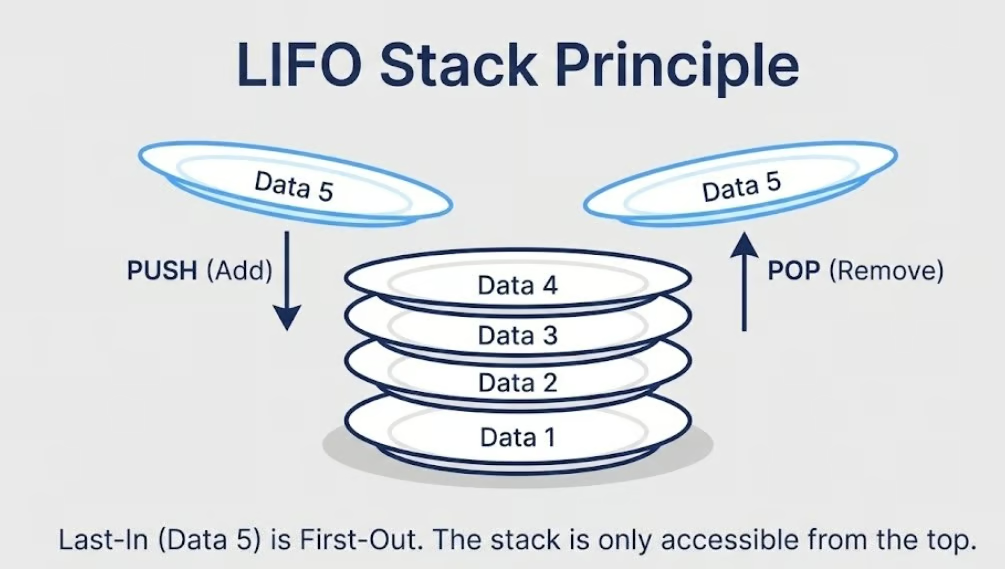
Une pile est une structure de données linéaire qui suit le principe Last‑In‑First‑Out (LIFO). Cela signifie que l’élément ajouté le plus récemment est toujours le premier retiré. Imaginez une pile d’assiettes dans une cafétéria : vous posez les nouvelles assiettes au-dessus et vous prenez toujours la plus haute en premier. Vous ne récupérez jamais une assiette au milieu ou au fond. L’accès est entièrement limité au sommet.
Cette contrainte unique — l’accès par le sommet uniquement — confère aux piles leur prédictibilité et leur efficacité. Chaque élément entre et sort par la même extrémité, ce qui garde les opérations simples et rapides.
À noter dès le départ : Python ne fournit pas un type de pile dédié et primitif comme d’autres langages. Il n’existe pas de mot‑clé stack ni de classe intégrée. À la place, Python propose des alternatives robustes intégrées comme les listes, collections.deque et queue.LifoQueue, qui peuvent toutes se comporter comme des piles. Nous détaillerons chacune de ces implémentations plus loin.
Comprendre ce qu’est une pile devient plus clair quand on voit ce qu’elle n’est pas. Les deux structures le plus souvent comparées aux piles sont les files (queues) et les listes Python standard.
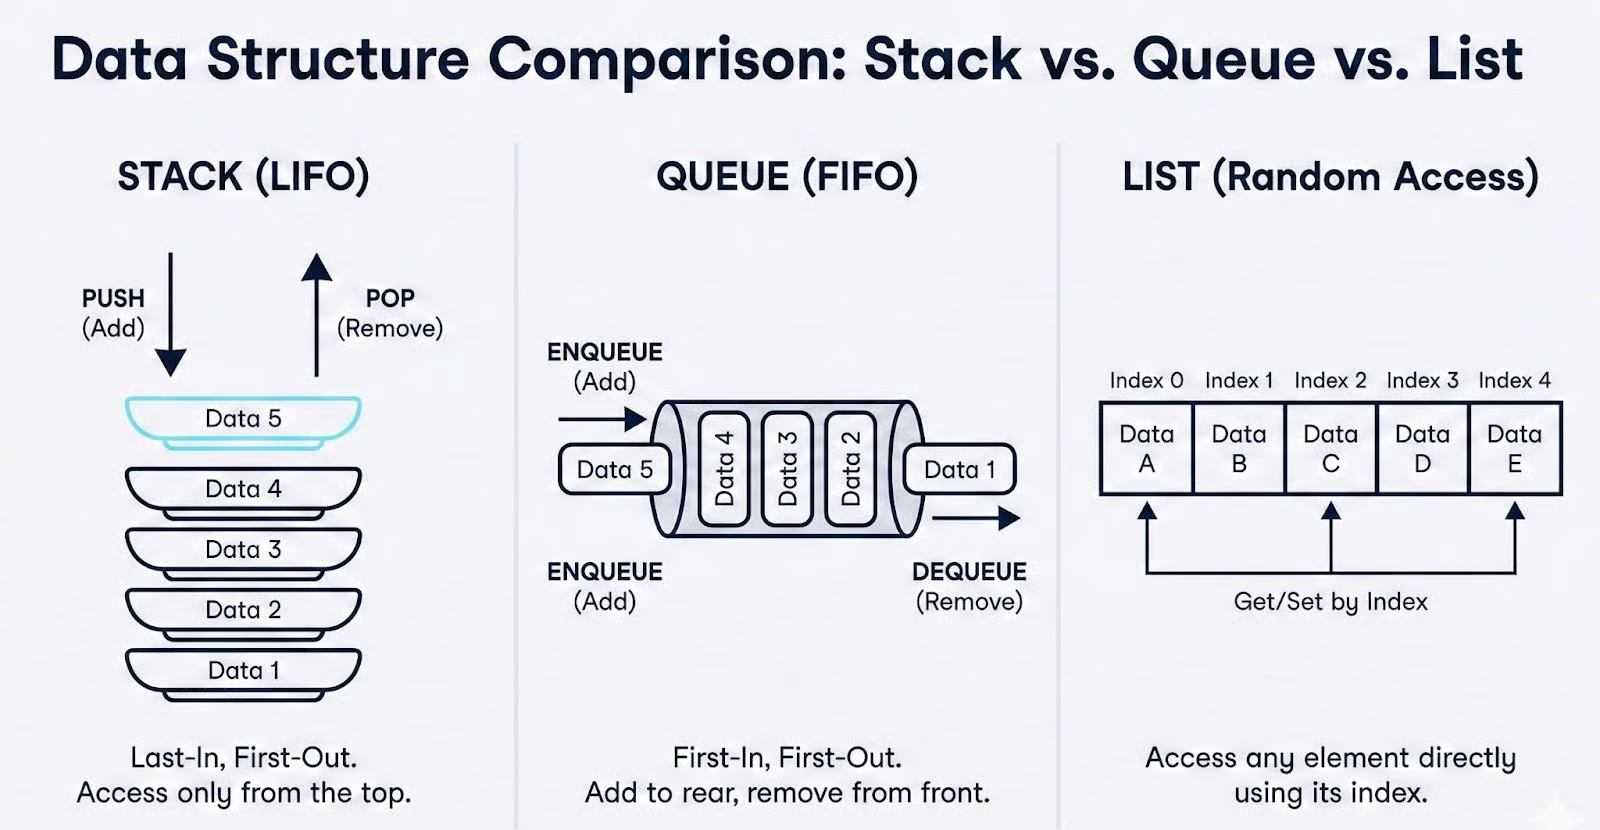
Une file suit le principe First‑In‑First‑Out (FIFO), à l’opposé d’une pile. Dans une file, les éléments sont ajoutés à l’arrière et retirés à l’avant, comme une file d’attente au guichet. Piles et files sont linéaires et limitent l’accès aux éléments, mais dans des sens opposés.
Choisir la mauvaise structure peut casser silencieusement la logique d’un algorithme. Par exemple, remplacer une pile par une file dans une recherche en profondeur (DFS) la transformerait en recherche en largeur (BFS), avec des résultats totalement différents.
Une liste Python standard offre un accès aléatoire. Vous pouvez lire, insérer ou supprimer des éléments à n’importe quel indice via des opérations comme my_list[3] ou my_list.insert(2, value). Cette flexibilité est utile dans de nombreux contextes, mais elle n’empêche pas d’accéder ou de modifier par erreur des éléments au milieu de la structure.
Lorsque vous implémentez un algorithme qui dépend strictement de l’ordre LIFO, comme le backtracking, l’analyse syntaxique ou une fonctionnalité d’annulation, la liberté d’une liste peut introduire des bugs subtils.
C’est précisément pour cela que le schéma d’accès restreint d’une pile est un atout, pas une limitation. En n’autorisant l’interaction qu’avec l’élément au sommet, une pile Python impose la justesse par conception. Vous ne pouvez pas retirer depuis le mauvais côté ni écraser un élément enfoui dans la structure.
En conception d’algorithmes, ce type de contrainte maintient une logique claire et un code prévisible.
Maintenant que nous savons ce qu’est une pile Python et en quoi elle diffère d’autres structures, voyons les opérations fondamentales que toute pile propose et analysons leur efficacité.
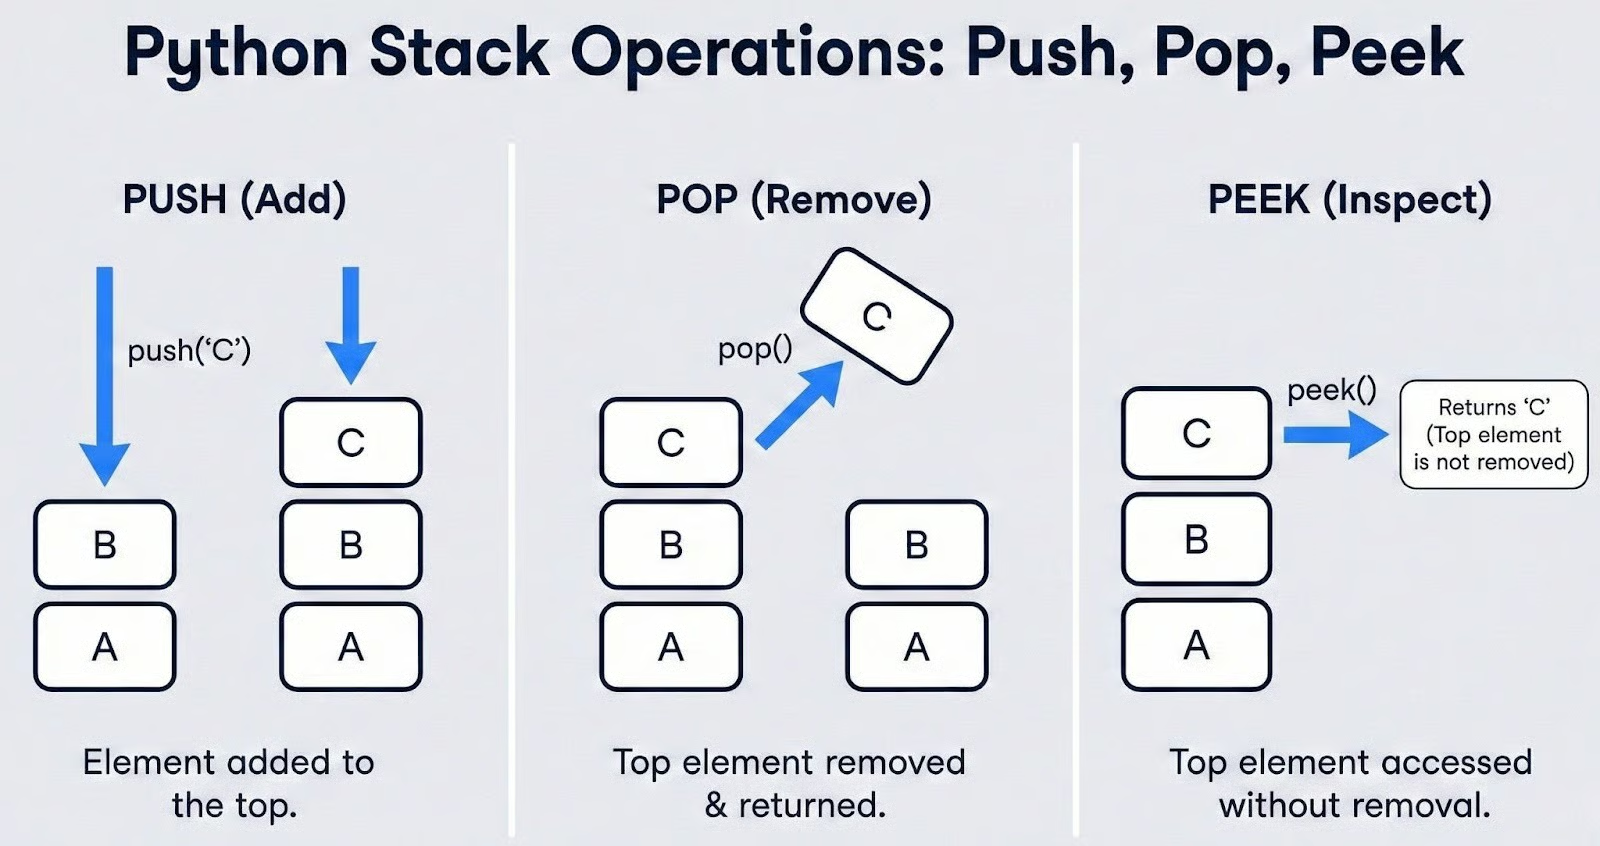
Toute implémentation de pile repose sur un petit ensemble d’opérations standard, quel que soit le langage. Ce sont les briques de base à chaque utilisation d’une pile.
Push ajoute un élément au sommet de la pile. Si la pile contient [A, B] et que vous poussez C, la pile devient [A, B, C], avec C au sommet.
Pop retire et renvoie l’élément actuellement au sommet. En reprenant l’exemple, dépiler [A, B, C] renvoie C et laisse [A, B].
Peek (parfois appelé top) permet de consulter l’élément au sommet sans le retirer. Utile quand votre logique doit inspecter la valeur courante avant de décider de dépiler, un schéma fréquent en analyse d’expressions et vérification de parenthèses équilibrées.
En plus de ces trois opérations centrales, deux méthodes d’assistance sont importantes pour écrire un code de pile sûr et sans erreurs :
is_empty() vérifie si la pile contient des éléments. Appeler pop ou peek sur une pile vide est une source classique d’erreurs d’exécution, donc tester l’état vide d’abord est une bonne habitude de programmation défensive.
size() renvoie le nombre d’éléments présents. Utile pour suivre la profondeur d’une récursion ou le nombre d’éléments restant à traiter.
Enfin, définissons un terme courant dans les manuels et les entretiens : le débordement inférieur de pile (Stack Underflow). C’est la condition d’erreur quand on tente de dépiler ou de consulter le sommet d’une pile vide. Il n’y a rien à retirer ni à voir, donc l’opération est invalide.
L’exception ou le comportement exact dépend de l’implémentation. Nous verrons comment Python le gère concrètement avec list, deque et LifoQueue dans la section suivante.
L’une des grandes raisons de l’usage massif des piles en algorithmique est leur efficacité. Décomposons la complexité en temps et en espace de chaque opération.
Push est en O(1). Dans une implémentation efficace, ajouter un élément au sommet se fait en temps constant. La pile n’a pas à décaler ou réorganiser les éléments existants. Elle place simplement le nouvel élément à la fin. Cela vaut pour collections.deque et, en cas amorti, pour la list intégrée de Python.
Pop est en O(1). Retirer l’élément du sommet est tout aussi rapide. La pile accède directement à la dernière position, renvoie la valeur et décrémente son compteur interne, sans décalage d’autres éléments.
Peek est en O(1). Consulter l’élément au sommet sans le retirer est un accès direct par indice, donc également en temps constant.
Search est en O(n). C’est le compromis assumé des piles. Pour savoir si une valeur existe quelque part, vous devez parcourir les n éléments du sommet vers le bas.
Les piles ne sont pas conçues pour les recherches arbitraires. Elles sacrifient cette capacité au profit d’opérations push/pop rapides et prévisibles. Si votre cas d’usage exige des recherches fréquentes, préférez un set ou un dictionnaire.
La complexité spatiale est en O(n). Une pile contenant n éléments nécessite une mémoire proportionnelle à n, sans surcoût caché autre que le petit constantiel de gestion interne.
Résumé rapide :
|
Opération |
Complexité temps |
Notes |
|
Push |
O(1) |
Temps constant. O(1) amorti pour les listes Python |
|
Pop |
O(1) |
Temps constant |
|
Peek |
O(1) |
Accès direct au sommet |
|
Search |
O(n) |
Parcours de tous les éléments |
|
Espace |
O(n) |
Linéaire au nombre d’éléments stockés |
À retenir : une pile Python est optimisée pour des insertions et suppressions rapides d’un seul côté. Tant que vous l’utilisez pour ce à quoi elle est conçue — gérer un accès ordonné LIFO — elle délivre d’excellentes performances. Si vous vous surprenez à rechercher régulièrement dans une pile, reconsidérez la structure de données.
Après la théorie et l’analyse de complexité, passons au code. Python propose trois façons principales d’implémenter une pile, chacune avec ses forces et compromis. Parcourons-les et voyons comment choisir selon le cas d’usage.
La façon la plus simple de créer une pile Python est d’utiliser la list intégrée. Les listes sont des tableaux dynamiques qui permettent d’ajouter et de retirer des éléments par la fin, ce qui colle naturellement au comportement d’une pile.
La méthode .append() joue le rôle de push, et .pop() sans argument retire et renvoie le dernier élément. Voyons cela avec un exemple :
# Creating a stack using a Python list
stack = []

# Push elements
stack.append(10)
stack.append(20)
stack.append(30)
print(stack)

# Pop the top element
top = stack.pop()
print(top)
print(stack)

# Peek at the top element
print(stack[-1])
[10, 20, 30]
30
[10, 20]
20Cela fonctionne bien, mais il faut gérer soigneusement le cas de la pile vide. En Python, .pop() comme stack[-1] lèvent un IndexError quand la liste est vide. C’est ainsi que Python signale la condition de Stack Underflow vue plus haut.
La bonne pratique consiste à encapsuler ces appels dans un bloc try/except ou à vérifier l’état avant d’accéder au sommet, comme ci‑dessous :
# Handling Stack Underflow with try/except
stack = []

try:
    stack.pop()
except IndexError:
    print("Stack Underflow: cannot pop from an empty stack")

try:
    top = stack[-1]
except IndexError:
    print("Stack Underflow: cannot peek at an empty stack")

# Alternatively, check before accessing
if stack:
    top = stack.pop()
else:
    print("Stack is empty")
Stack Underflow: cannot pop from an empty stack
Stack Underflow: cannot peek at an empty stack
Stack is emptyIl existe une nuance de performance à comprendre. Les listes Python sont adossées à des tableaux dynamiques. Quand vous appelez .append(), l’opération est en général instantanée (O(1)). Mais lorsque le tableau interne manque d’espace préalloué, Python doit allouer un bloc plus grand et copier tous les éléments.
Ce réallouage occasionnel rend .append() en O(1) amorti plutôt qu’en O(1) strict. En pratique, le surcoût est rare et bref, mais pour des applications sensibles à la latence ou temps réel, cette imprévisibilité peut compter.
Malgré cela, .append() et .pop() sur une liste restent l’approche privilégiée pour la plupart des tâches simples. L’absence d’import, la syntaxe familière et l’adoption large en font un bon choix par défaut — en particulier pour les scripts, prototypes et entretiens où la simplicité prime.
Si vous avez besoin d’un O(1) constant sans latence de réallocation, collections.deque est la montée en gamme recommandée. Le nom signifie « double‑ended queue », mais il fonctionne parfaitement comme pile Python haute performance. Notre exemple précédent s’écrit ainsi avec deque :
from collections import deque

# Creating a stack using deque
stack = deque()

# Push elements
stack.append(10)
stack.append(20)
stack.append(30)
print(stack)

# Pop the top element
top = stack.pop()
print(top)
print(stack)

# Peek at the top element
print(stack[-1])
deque([10, 20, 30])
30
deque([10, 20])
20Remarquez que l’interface est identique à l’approche avec liste. .append(), .pop() et [-1] fonctionnent de la même façon. Le comportement IndexError en cas d’accès à vide est inchangé, donc votre gestion d’erreur ne nécessite pas de modification :
from collections import deque

stack = deque()

try:
    stack.pop()
except IndexError:
    print("Stack Underflow: cannot pop from an empty deque stack")
Stack Underflow: cannot pop from an empty deque stackLa différence clé est interne. Un deque est implémenté comme une liste doublement chaînée de blocs de taille fixe, plutôt qu’un tableau unique. Il n’a donc pas à réallouer et copier toute la structure lors de sa croissance.
Chaque .append() et .pop() est un vrai O(1) garanti, non pas amorti mais constant. Pour des charges algorithmiques avec des milliers ou millions de push/pop, cette constance fait la différence.
La bibliothèque standard inclut aussi queue.LifoQueue, une implémentation de pile pensée pour les programmes multi‑threads. Le « LIFO » du nom confirme l’ordre Last‑In‑First‑Out, mais l’interface et le comportement diffèrent des deux approches précédentes. Exemple :
from queue import LifoQueue

# Creating a thread-safe stack
stack = LifoQueue()

# Push elements using .put()
stack.put(10)
stack.put(20)
stack.put(30)
print(stack.qsize())

# Pop the top element using .get()
top = stack.get()
print(top)
print(stack.qsize())
3
30
2Premier constat : la syntaxe change. Push devient .put() et pop devient .get(). Ces noms viennent du modèle producteur‑consommateur du module queue, où un thread « dépose » (put) et un autre « récupère » (get).
Deux différences comportementales importantes :
Premièrement, LifoQueue n’a pas de méthode sûre pour peek. Il n’existe pas de moyen intégré de consulter le sommet sans le retirer. Accéder aux attributs internes en contexte multi‑threads va à l’encontre de l’objectif de sûreté et expose à des conditions de concurrence.
Deuxièmement, LifoQueue ne lève pas IndexError quand vous tentez de récupérer un élément sur une pile vide. Par défaut, .get() est bloquant : il met en pause le thread appelant en attendant indéfiniment qu’un autre thread dépose un élément. Pour un comportement non bloquant, passez block=False, ce qui lève une exception queue.Empty. Exemple :
from queue import LifoQueue, Empty

stack = LifoQueue()

# Non-blocking get raises Empty, not IndexError
try:
    stack.get(block=False)
except Empty:
    print("Stack is empty — no items to get")
Stack is empty — no items to getÀ cause du verrouillage interne qui rend LifoQueue thread‑safe, ses opérations ont plus de surcoût que list ou deque. C’est donc un mauvais choix en mono‑thread. Utilisez LifoQueue uniquement en présence de multiples threads produisant et consommant des données en parallèle, et préférez deque ou list dans tous les autres cas.
Avec trois options disponibles, voici une comparaison pour guider votre choix :
|
Critère |
|
|
|
|
Import nécessaire |
Non |
Oui ( |
Oui ( |
|
Méthode push |
|
|
|
|
Méthode pop |
|
|
|
|
Méthode peek |
|
|
Pas de méthode sûre |
|
Erreur pile vide |
|
|
Bloque ou |
|
Vitesse push/pop |
O(1) amorti |
Vrai O(1) |
O(1) avec surcoût de verrou |
|
Sûr pour threads |
Non |
Non |
Oui |
|
Idéal pour |
Scripts simples, prototypage |
Algorithmes, code critique en performance |
Producteur‑consommateur multi‑threads |
Voici ma grille de décision pour choisir la meilleure implémentation :
Utilisez list quand vous avez besoin d’une pile rapide sans import, par exemple dans des scripts, notebooks et exercices d’entretien.
Utilisez collections.deque pour du code algorithmique, des traitements volumineux, ou dès que la performance compte.
Utilisez queue.LifoQueue uniquement si vous avez un scénario multi‑threads naturel avec accès concurrent.
Vous verrez aussi des tutoriels qui implémentent une pile Python from scratch avec une liste chaînée personnalisée, où chaque nœud porte une valeur et un pointeur vers le nœud du dessous. À mon avis, c’est un exercice pédagogique utile pour approfondir le fonctionnement interne d’une pile et la gestion des références en mémoire.
Cependant, en production Python, une pile en liste chaînée est presque toujours plus lente qu’un deque à cause du surcoût de création de nœuds. Pour le monde réel, collections.deque offre le meilleur compromis entre vitesse, clarté et fiabilité.
Savoir implémenter une pile en Python n’est que la moitié de l’équation. La vraie valeur apparaît quand on les voit résoudre des problèmes bien plus complexes sans l’ordre LIFO. Explorons trois applications classiques qu’on retrouve en entretiens, dans les systèmes logiciels et la conception d’algorithmes.
Le problème des parenthèses équilibrées est l’une des questions de pile les plus fréquentes en entretien technique. Étant donnée une chaîne contenant des crochets comme (), [] et {}, il faut déterminer si chaque ouverture a une fermeture correspondante dans le bon ordre.
La logique correspond parfaitement à une pile : en parcourant la chaîne de gauche à droite, on pousse chaque ouverture sur la pile. À la rencontre d’une fermeture, on dépile le sommet et on vérifie si cela correspond.
Si la pile est vide au moment de dépiler, ou si l’élément dépilé ne correspond pas, la chaîne n’est pas équilibrée. Après tout le parcours, la pile doit être vide. Toute ouverture restante signifie qu’un élément n’a pas été fermé. Démonstration :
from collections import deque

def is_balanced(expression):
    stack = deque()
    matching = {')': '(', ']': '[', '}': '{'}

    for char in expression:
        if char in '([{':
            stack.append(char)
        elif char in ')]}':
            if not stack:
                return False  # closing bracket with nothing to match
            if stack.pop() != matching[char]:
                return False  # mismatched pair

    return len(stack) == 0  # stack should be empty if balanced

# Test cases
print(is_balanced("([])"))
print(is_balanced("{[()]}"))
print(is_balanced("([)]"))
print(is_balanced("(("))
print(is_balanced(""))
True
True
False
False
TrueSuivons "{[()]}" pas à pas pour voir la pile en action :
|
Caractère |
Action |
État de la pile |
|
|
Push |
|
|
|
Push |
|
|
|
Push |
|
|
|
Pop |
|
|
|
Pop |
|
|
|
Pop |
|
La pile est vide à la fin : l’expression est bien équilibrée.
Cette logique dépasse largement les entretiens. Les compilateurs et interpréteurs l’utilisent pour valider la syntaxe, en s’assurant que chaque balise, crochet ou délimiteur a bien sa contrepartie.
Si vous avez déjà vu SyntaxError: unexpected EOF en Python, vous avez observé une variante de cette vérification. Les validateurs HTML, parseurs JSON et même des linters de fichiers de configuration s’appuient sur cette approche à base de pile.
La recherche en profondeur est un algorithme fondamental de parcours de graphe, et la pile en est la structure motrice. L’idée : partir d’un nœud, explorer au maximum une branche avant de revenir en arrière pour essayer la suivante. La nature LIFO d’une pile Python induit naturellement ce comportement « aller en profondeur d’abord ».
Les cours introductifs enseignent souvent la DFS en récursif, où la pile d’appels gère implicitement l’ordre de parcours. Mais cette approche a une limite pratique : la limite de récursion par défaut de Python est de 1000 trames.
Pour des graphes grands ou très profonds, cela conduit à un RecursionError. La version itérative, qui utilise une pile explicite, évite ce problème et vous donne un contrôle total sur le parcours.
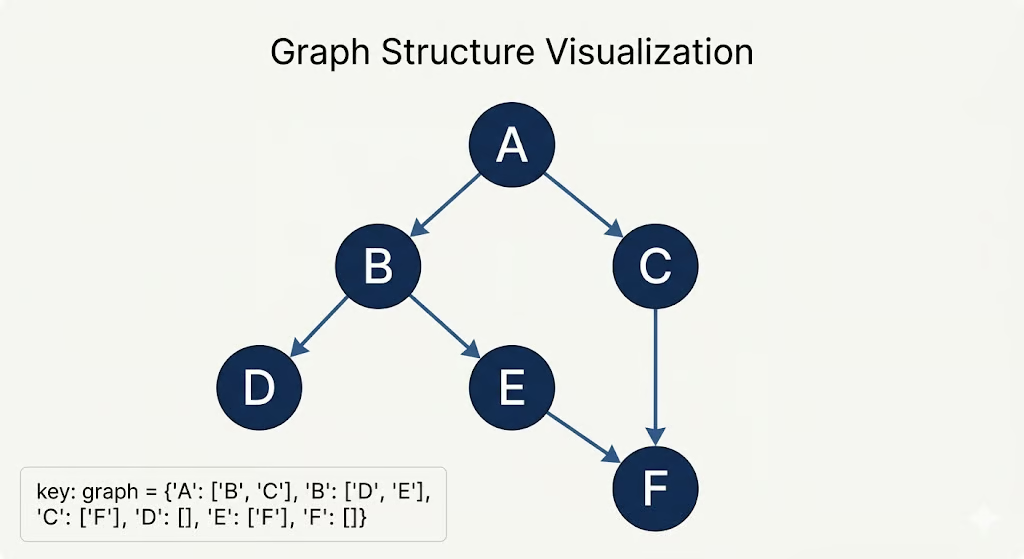
Voici un exemple de code. Nous effectuons une DFS sur le graphe suivant :
from collections import deque

def dfs_iterative(graph, start):
    visited = set()
    stack = deque()
    stack.append(start)
    traversal_order = []

    while stack:
        node = stack.pop()
        if node not in visited:
            visited.add(node)
            traversal_order.append(node)
            # Push neighbors onto the stack
            # Reverse to maintain left-to-right order after LIFO popping
            for neighbor in reversed(graph[node]):
                if neighbor not in visited:
                    stack.append(neighbor)

    return traversal_order

# Example graph represented as an adjacency list
graph = {
    'A': ['B', 'C'],
    'B': ['D', 'E'],
    'C': ['F'],
    'D': [],
    'E': ['F'],
    'F': []
}

print(dfs_iterative(graph, 'A'))
['A', 'B', 'D', 'E', 'F', 'C']Traçons l’exécution pour voir comment la pile gouverne le parcours :
|
Étape |
Pop |
Voisins poussés |
Pile |
Visités |
|
1 |
A |
B, C |
|
|
|
2 |
B |
D, E |
|
|
|
3 |
D |
(aucun) |
|
|
|
4 |
E |
F |
|
|
|
5 |
F |
(aucun) |
|
|
|
6 |
C |
F (déjà visité) |
|
|
Remarquez comme l’ordonnancement LIFO force l’algorithme à explorer entièrement les branches A → B → D et A → B → E → F avant de revenir visiter C. C’est précisément ce qui distingue DFS de BFS, qui utilise une file et explore tous les voisins au niveau courant avant d’aller plus loin.
Le schéma DFS itératif fonctionne pour les arbres, graphes dirigés et non dirigés. C’est aussi la base d’algorithmes avancés comme le tri topologique, la détection de cycles, ou la résolution de labyrinthes et puzzles.
Si vous avez déjà utilisé un éditeur de texte, un logiciel de dessin ou un tableur, vous avez profité d’undo/redo sans penser à son fonctionnement interne. Le mécanisme est élégant et repose sur deux piles.
Une pile d’annulation (undo) stocke chaque action ou état au fil des modifications. Lors d’un undo, l’état courant est dépilé d’undo et poussé sur une pile redo.
Si l’utilisateur déclenche ensuite redo, l’état est dépilé de redo et repoussé sur undo. Si une nouvelle modification intervient après un undo, la pile redo est vidée : on ne peut pas rétablir ce qui a été remplacé par une nouvelle action. Exemple :
from collections import deque

class TextEditor:
    def __init__(self):
        self.content = ""
        self.undo_stack = deque()
        self.redo_stack = deque()

    def type_text(self, text):
        """Record current state and apply new text."""
        self.undo_stack.append(self.content)
        self.content += text
        self.redo_stack.clear()  # new action invalidates redo history

    def undo(self):
        """Revert to the previous state."""
        if not self.undo_stack:
            print("Nothing to undo")
            return
        self.redo_stack.append(self.content)
        self.content = self.undo_stack.pop()

    def redo(self):
        """Re-apply the last undone action."""
        if not self.redo_stack:
            print("Nothing to redo")
            return
        self.undo_stack.append(self.content)
        self.content = self.redo_stack.pop()

    def show(self):
        print(f'Content: "{self.content}"')

# Demonstrate the undo/redo flow
editor = TextEditor()
editor.type_text("Hello")
editor.show()

editor.type_text(" World")
editor.show()

editor.type_text("!")
editor.show()

editor.undo()
editor.show()

editor.undo()
editor.show()

editor.redo()
editor.show()

editor.type_text(" Python")
editor.show()

editor.redo()
Content: "Hello"
Content: "Hello World"
Content: "Hello World!"
Content: "Hello World"
Content: "Hello"
Content: "Hello World"
Content: "Hello World Python"
Nothing to redoLe flux d’états entre les deux piles suit un schéma clair :
|
Action |
Pile undo |
Contenu |
Pile redo |
|
Saisie « Hello » |
|
|
|
|
Saisie « World » |
|
|
|
|
Saisie « ! » |
|
|
|
|
Undo |
|
|
|
|
Undo |
|
|
|
|
Redo |
|
|
|
|
Saisie « Python » |
|
|
|
Ce motif à deux piles ne se limite pas aux éditeurs de texte. On le retrouve partout où les utilisateurs doivent pouvoir revenir en arrière et avancer dans une séquence de changements :
Le principe reste le même : une pile Python suit l’historique, l’autre le futur, et l’ordre LIFO garantit un retour au dernier état en priorité.
Les piles jouent aussi un rôle clé sous le capot de tout programme Python, et elles alimentent des techniques d’optimisation qui réduisent drastiquement la complexité de certains problèmes. Voyons ces deux dimensions.
Chaque fois que vous appelez une fonction en Python, il se passe quelque chose en coulisses. Python empile une nouvelle trame (frame) sur une structure interne appelée pile d’appels. Cette trame contient les variables locales de la fonction, ses paramètres et un pointeur vers la ligne qui a initié l’appel.
Quand la fonction termine, sa trame est dépilée et l’exécution revient à l’appelant.
Vous pouvez observer ce comportement avec un exemple simple :
def function_c():
    print("Inside function_c")
    # At this point, the call stack holds:
    # [main → function_a → function_b → function_c]  (top)

def function_b():
    print("Inside function_b")
    function_c()

def function_a():
    print("Inside function_a")
    function_b()

function_a()
Inside function_a
Inside function_b
Inside function_cLorsque function_c s’exécute, la pile d’appels compte quatre trames empilées. À mesure que chaque fonction se termine, sa trame est dépilée en ordre LIFO : d’abord function_c, puis function_b, puis function_a, et enfin le module principal.
C’est exactement ce qui rend la récursion possible. Chaque appel récursif empile une nouvelle trame avec ses propres variables locales, et les résultats se déroulent à mesure que les trames sont dépilées. Exemple :
def factorial(n):
    if n <= 1:
        return 1
    return n * factorial(n - 1)

print(factorial(5))

# Call stack at deepest point:
# factorial(1)  ← top (returns 1)
# factorial(2)  ← waiting for factorial(1)
# factorial(3)  ← waiting for factorial(2)
# factorial(4)  ← waiting for factorial(3)
# factorial(5) ← waiting for factorial(4)120Le problème survient quand la récursion va trop loin. Python fixe une limite de récursion par défaut à 1000 trames pour éviter que la pile d’appels ne consomme toute la mémoire. Si votre fonction récursive dépasse cette limite, Python lève un RecursionError. Exemple :
def infinite_recursion(n):
    return infinite_recursion(n + 1)

try:
    infinite_recursion(0)
except RecursionError:
    print("RecursionError: maximum recursion depth exceeded")
RecursionError: maximum recursion depth exceededVous pouvez consulter et modifier cette limite via le module sys, en restant prudent :
import sys

print(sys.getrecursionlimit())
sys.setrecursionlimit(5000) # Increase with caution5000Point important : la pile d’appels est une structure système gérée par l’interpréteur Python. Vous ne pouvez pas y pousser ou en dépiler directement. Les piles list, deque et LifoQueue vues plus haut sont des structures définies par l’utilisateur, en mémoire tas de votre programme. Elles ont des buts différents, mais suivent toutes le principe LIFO.
Une pile monotone est une variante spécialisée où les éléments sont maintenus dans un ordre non croissant ou non décroissant (parfois strict, selon le problème). À chaque insertion, on dépile d’abord tous les éléments qui violeraient cette contrainte. C’est la clé pour résoudre toute une classe de problèmes d’optimisation en temps linéaire.
L’exemple classique est celui du prochain élément plus grand (Next Greater Element) : pour chaque entier d’un tableau, trouver le premier élément strictement plus grand à droite. Une approche naïve en boucles imbriquées est en O(n²). Une pile monotone le résout en O(n).
L’astuce consiste à parcourir le tableau de droite à gauche en maintenant une pile décroissante. Pour chaque élément, on dépile tout ce qui est inférieur ou égal. Ces valeurs ne pourront jamais être le « prochain plus grand » pour un élément plus à gauche.
Ce qui reste au sommet après dépilage est la réponse pour l’élément courant. Puis on pousse l’élément courant sur la pile. Exemple (ici, -1 signifie qu’il n’y a pas d’élément plus grand à droite) :
from collections import deque

def next_greater_element(nums):
    n = len(nums)
    result = [-1] * n  # default: no greater element found
    stack = deque()     # monotonic decreasing stack (stores values)

    # Traverse from right to left
    for i in range(n - 1, -1, -1):
        # Pop elements that are not greater than current
        while stack and stack[-1] <= nums[i]:
            stack.pop()

        # If stack is not empty, top is the next greater element
        if stack:
            result[i] = stack[-1]

        # Push current element onto the stack
        stack.append(nums[i])

    return result

nums = [4, 5, 2, 25, 7, 18]
print(next_greater_element(nums))
[5, 25, 25, -1, 18, -1]Traçons l’exécution pour voir comment la propriété monotone est maintenue :
|
Étape (droite vers gauche) |
Courant |
Pile avant |
Dépile |
Plus grand suivant |
Pile après |
|
|
18 |
|
— |
-1 |
|
|
|
7 |
|
— |
18 |
|
|
|
25 |
|
7,18 |
-1 |
|
|
|
2 |
|
— |
25 |
|
|
|
5 |
|
2 |
25 |
|
|
|
4 |
|
— |
5 |
|
Notez que chaque élément est empilé exactement une fois et dépilé au plus une fois sur l’ensemble du parcours. C’est pourquoi la complexité temps totale reste en O(n) malgré la boucle while interne : le nombre cumulé d’opérations push et pop n’excède jamais 2n.
Comme indiqué plus haut, de nombreux problèmes similaires bénéficient de ce motif de pile monotone, passant de O(n²) à O(n), notamment :
Dans chaque cas, l’idée clé est la même : la contrainte monotone permet d’éliminer les éléments qui ne peuvent plus influencer les résultats futurs, réduisant l’espace de recherche du quadratique au linéaire.
La pile est l’une des premières structures apprises par les développeurs, et l’une des dernières dont on cesse de découvrir de nouveaux usages — ce qui est, ironiquement, l’inverse de sa nature LIFO.
Dans cet article, nous avons vu comment cette contrainte LIFO est utile dans de nombreux scénarios : validation de crochets imbriqués, parcours DFS, gestion d’états d’undo/redo et optimisation de problèmes de tableaux avec des piles monotones.
S’il ne fallait retenir qu’une recommandation : utilisez collections.deque comme implémentation de pile Python par défaut, sauf besoin spécifique contraire.
Pour aller plus loin, je vous recommande notre cours sur Data Structures and Algorithms in Python.
Cours Python
Cours
Cours
Cursus