Kurs
Effizienten Python-Code schreiben
4 Std.
155.5K
Jedes Mal, wenn du mit Strg+Z einen Fehler rückgängig machst, im Browser auf „Zurück“ klickst oder eine rekursive Funktion ihre Ergebnisse abwickeln siehst, verlässt du dich auf einen Stack. Weil Stacks so tief in der Software stecken, die du täglich nutzt, arbeitest du oft mit ihnen, ohne es zu merken.
In diesem Artikel schauen wir uns an, was ein Stack ist, die Logik dahinter, vergleichen verschiedene Implementierungsstrategien mit Pythons Standardbibliothek und setzen sie ein, um algorithmische Probleme zu lösen.
Ich empfehle dir unseren Kurs zu Writing Efficient Python Code, um dein Wissen über Datenstrukturen mit Performance-Best-Practices zu kombinieren, und halte das Python Basics Cheat Sheet griffbereit als schnelle Referenz.
Bevor wir in den Code eintauchen, ist es wichtig, das Konzept zu verstehen, das den Python-Stack so mächtig macht. Schauen wir uns das Kernprinzip hinter Stacks an und wie sie sich von anderen gängigen Datenstrukturen unterscheiden.
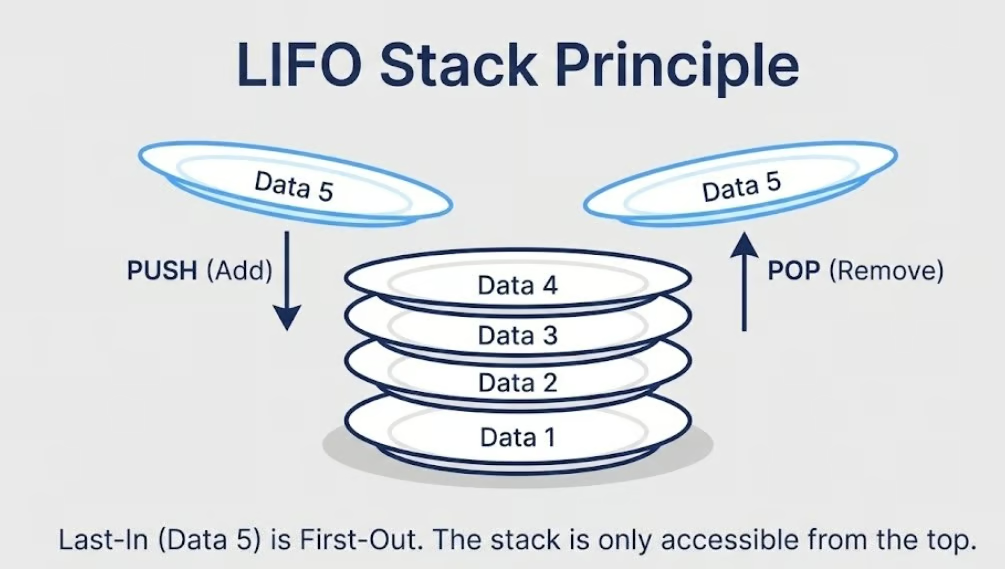
Ein Stack ist eine lineare Datenstruktur, die dem Last-In-First-Out-Prinzip (LIFO) folgt. Das bedeutet: Das zuletzt hinzugefügte Element wird als erstes entfernt. Denk an einen Stapel Teller in der Mensa. Du legst neue Teller oben drauf und nimmst immer den obersten zuerst. Du ziehst nie einen Teller aus der Mitte oder von unten. Der Zugriff ist ausschließlich oben möglich.
Genau diese Einschränkung – nur Zugriff von oben – macht Stacks so vorhersehbar und effizient. Jedes Element gelangt am selben Ende hinein und hinaus. Das hält die Operationen einfach und schnell.
Wichtig zu wissen: Python liefert keinen eigenen primitiven Stack-Typ wie manche andere Sprachen. Es gibt kein stack-Schlüsselwort und keine eingebaute Klasse. Stattdessen bietet Python robuste Alternativen wie lists, collections.deque und queue.LifoQueue, die sich alle wie Stacks verhalten. Wir sehen uns diese Implementierungen später im Detail an.
Am besten versteht man einen Stack, wenn man sieht, was er nicht ist. Am häufigsten werden Stacks mit Queues und normalen Python-Listen verglichen.
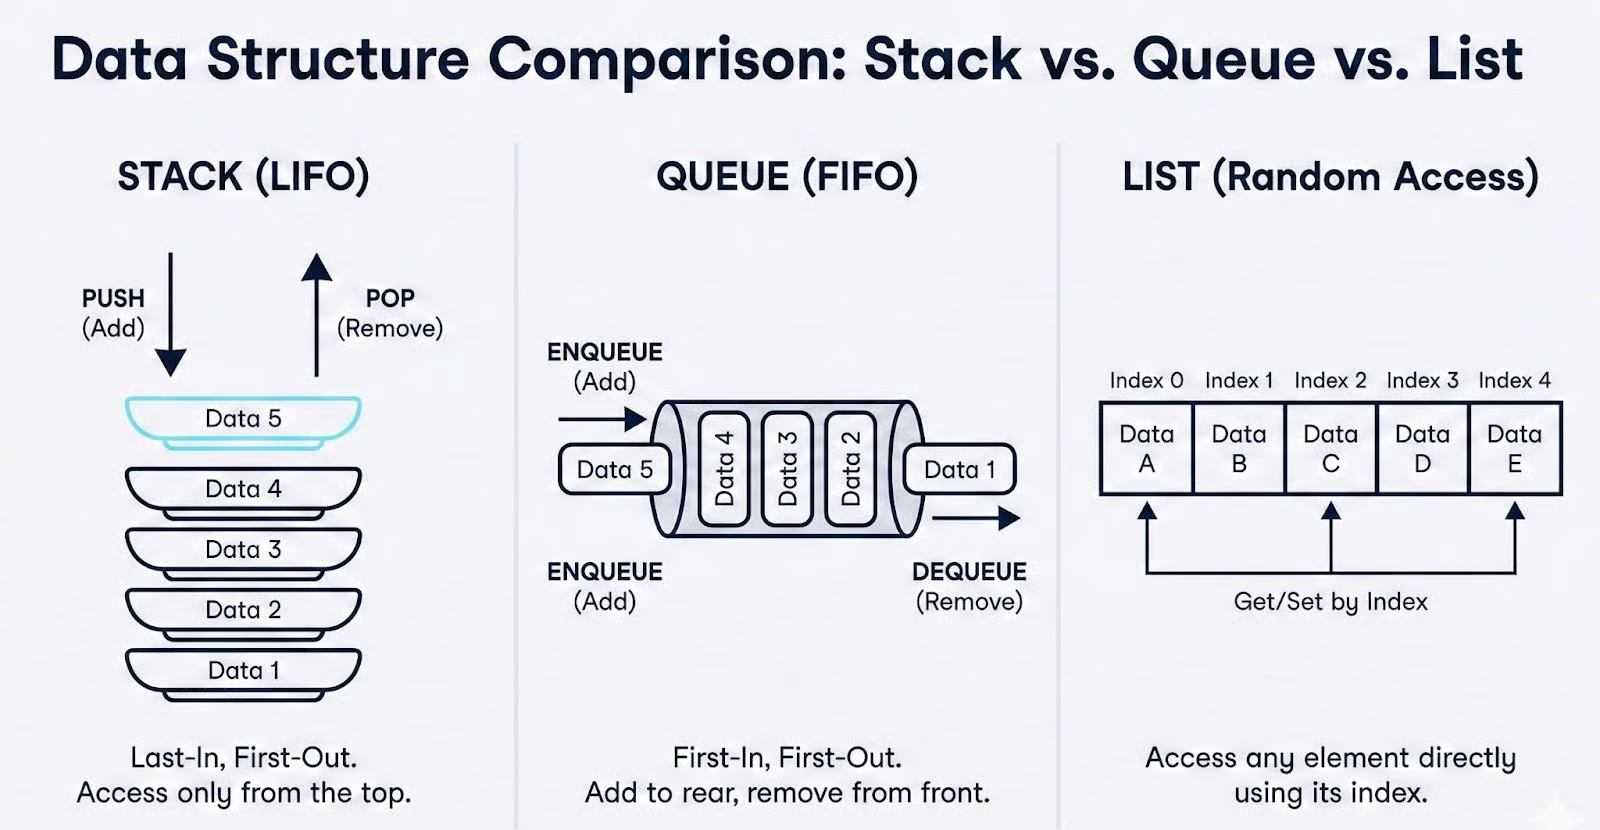
Eine Queue folgt dem First-In-First-Out-Prinzip (FIFO) – dem Gegenteil eines Stacks. In einer Queue werden Elemente hinten angefügt und vorne entnommen, wie eine Schlange am Ticketschalter. Beide sind linear und schränken den Zugriff ein, aber in entgegengesetzter Richtung.
Die falsche Wahl kann die Logik eines Algorithmus still und leise kippen. Ersetzt du etwa in einer Depth-First-Suche einen Stack durch eine Queue, wird daraus eine Breadth-First-Suche – mit völlig anderen Ergebnissen.
Eine normale Python-Liste erlaubt wahlfreien Zugriff. Du kannst Elemente an jedem Index lesen, einfügen oder löschen, z. B. mit my_list[3] oder my_list.insert(2, value). Diese Flexibilität ist oft hilfreich, verhindert aber nicht, dass du versehentlich Elemente in der Mitte veränderst.
Wenn du einen Algorithmus mit strengem LIFO-Prinzip implementierst – etwa Backtracking, Syntax-Parsing oder Undo-Funktionalität –, kann die fehlende Einschränkung einer Liste subtile Bugs verursachen.
Genau deshalb ist das eingeschränkte Zugriffsmuster eines Stacks ein Feature, kein Nachteil. Indem nur der Top-Eintrag zugänglich ist, erzwingt ein Python-Stack strukturell Korrektheit. Du kannst nicht versehentlich vom falschen Ende entfernen oder ein tief liegendes Element überschreiben.
In der Algorithmusentwicklung sorgen genau solche Constraints dafür, dass deine Logik sauber bleibt und dein Code berechenbar ist.
Jetzt, da wir wissen, was ein Python-Stack ist und wie er sich unterscheidet, schauen wir auf die Basisoperationen jedes Stacks und deren Effizienz.
Jede Stack-Implementierung basiert auf wenigen Standard-Operationen – unabhängig von der Programmiersprache. Das sind deine Bausteine beim Arbeiten mit Stacks.
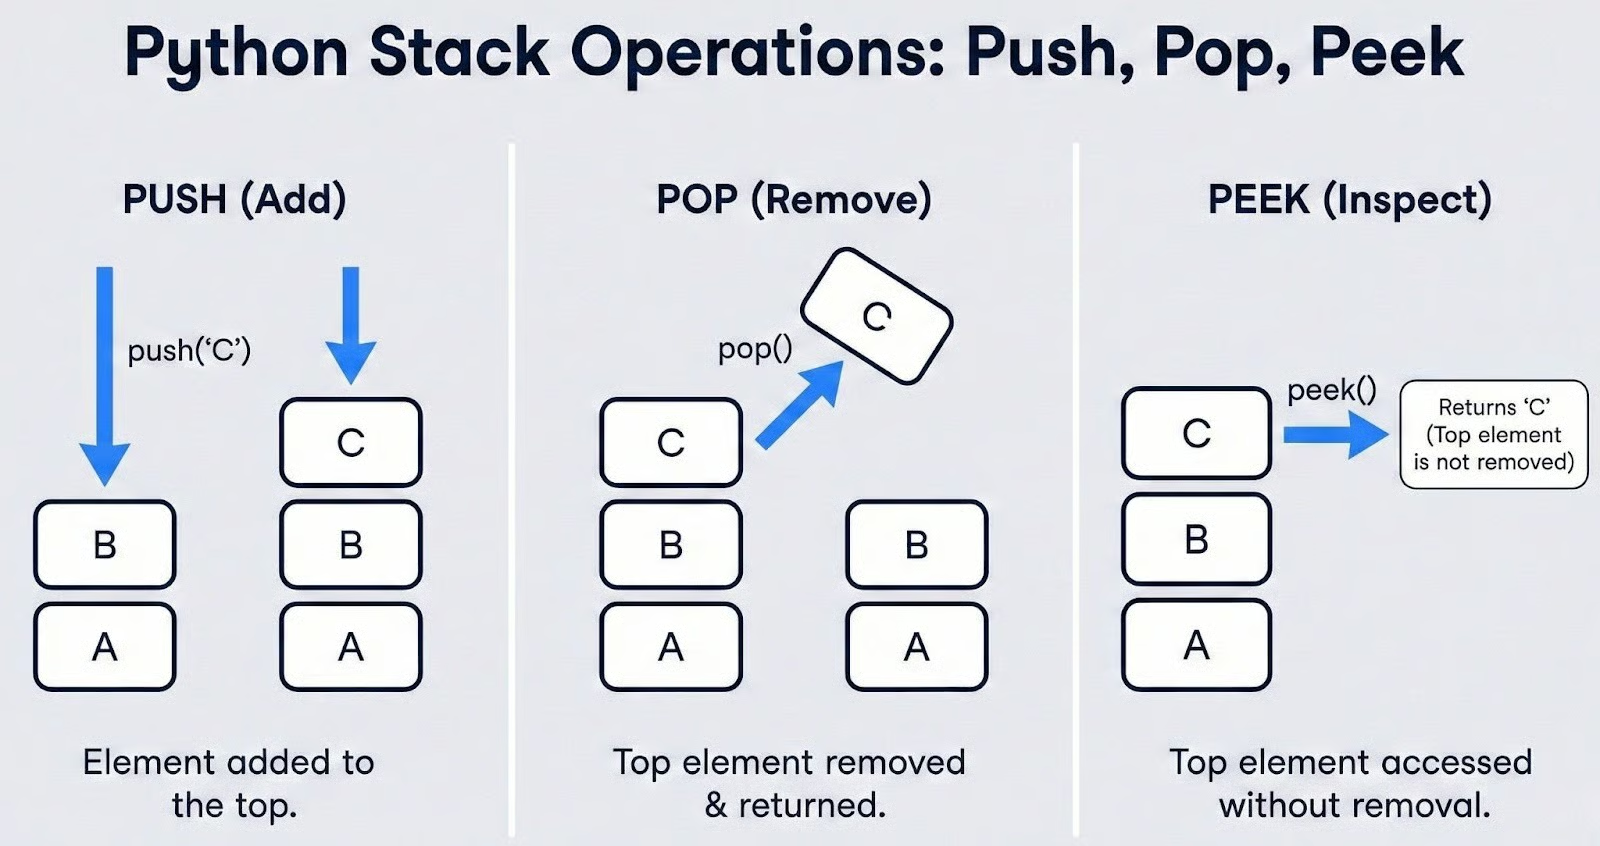
Push fügt ein Element oben auf den Stack. Enthält der Stack [A, B] und du pushst C, wird daraus [A, B, C] – mit C ganz oben.
Pop entfernt und liefert das aktuelle Top-Element. Beim Pop von [A, B, C] erhältst du C, übrig bleibt [A, B].
Peek (auch „top“) zeigt das Top-Element an, ohne es zu entfernen. Nützlich, wenn du den Wert vor einer Entscheidung prüfen willst – etwa beim Parsen von Ausdrücken oder beim Klammernausgleich.
Zusätzlich sind zwei Hilfsmethoden wichtig, um fehlerfreien Stack-Code zu schreiben:
is_empty() prüft, ob der Stack Elemente enthält. Pop oder Peek auf einem leeren Stack ist eine häufige Laufzeitfalle – prüfe daher zuerst auf Leerheit.
size() liefert die aktuelle Anzahl der Elemente. Praktisch, um die Tiefe einer Rekursion nachzuverfolgen oder offene Aufgaben zu zählen.
Außerdem ein Begriff aus Lehrbüchern und Interviews: Stack Underflow. Das ist der Fehlerzustand, wenn du von einem leeren Stack popst oder peeks. Es gibt nichts zu entfernen oder anzusehen – die Operation ist ungültig.
Welche Exception oder welches Verhalten auftritt, hängt von der Implementierung ab. Wie Python das bei list, deque und LifoQueue handhabt, sehen wir im nächsten Abschnitt.
Ein Hauptgrund für den breiten Einsatz von Stacks ist ihre Effizienz. Zerlegen wir die Zeit- und Platzkomplexität der Operationen.
Push ist O(1). In einer effizienten Stack-Implementierung ist das Hinzufügen oben konstant schnell. Es müssen keine Elemente verschoben werden. Das gilt für collections.deque und – amortisiert – auch für Pythons eingebaute list.
Pop ist O(1). Das Entfernen des Top-Elements ist ebenso konstant schnell. Der letzte Index wird direkt adressiert.
Peek ist O(1). Das Top-Element ansehen ohne Entfernen ist ebenfalls ein direkter Indexzugriff.
Search ist O(n). Hier zeigt sich der Trade-off. Ob ein bestimmter Wert im Stack existiert, lässt sich nur durch lineares Scannen der n Elemente feststellen.
Stacks sind nicht für beliebige Lookups gedacht. Sie tauschen Suchfähigkeit gegen schnelle, vorhersagbare Push/Pop-Operationen. Wenn du oft suchst, passt eher ein Set oder ein Dictionary.
Platzkomplexität ist O(n). Ein Stack mit n Elementen benötigt Speicher proportional zu n – plus einen kleinen konstanten Overhead für die interne Verwaltung.
Hier eine kurze Zusammenfassung:
|
Operation |
Zeitkomplexität |
Anmerkungen |
|
Push |
O(1) |
Konstant. Amortisiert O(1) für Python-Listen |
|
Pop |
O(1) |
Konstant |
|
Peek |
O(1) |
Direkter Zugriff auf das Top-Element |
|
Search |
O(n) |
Alle Elemente müssen gescannt werden |
|
Space |
O(n) |
Linear in der Elementanzahl |
Die Quintessenz: Ein Python-Stack ist für schnelles Einfügen und Entfernen an einem Ende optimiert. Setzt du ihn dafür ein – geordneter LIFO-Zugriff –, liefert er exzellente Performance. Musst du regelmäßig darin suchen, ist das ein Signal, die Datenstruktur zu überdenken.
Nach der Theorie geht’s an den Code. Python bietet drei primäre Wege, einen Stack zu implementieren – mit unterschiedlichen Stärken und Trade-offs. Gehen wir sie durch und entscheiden, was wann passt.
Am direktesten erstellst du einen Python-Stack mit der eingebauten list. Listen sind dynamische Arrays mit Hinzufügen/Entfernen am Ende – ideal für Stack-Verhalten.
Die Methode .append() dient als Push, .pop() ohne Argument entfernt und liefert das letzte Element. Hier ein Beispiel:
# Creating a stack using a Python list
stack = []

# Push elements
stack.append(10)
stack.append(20)
stack.append(30)
print(stack)

# Pop the top element
top = stack.pop()
print(top)
print(stack)

# Peek at the top element
print(stack[-1])
[10, 20, 30]
30
[10, 20]
20Das funktioniert gut, aber du musst leere Stacks korrekt behandeln. In Python werfen sowohl .pop() als auch stack[-1] einen IndexError, wenn die Liste leer ist. So signalisiert Python den zuvor definierten Stack-Underflow.
Best Practice ist, Aufrufe in einen try/except-Block zu packen oder vorab die Leerheit zu prüfen – wie hier:
# Handling Stack Underflow with try/except
stack = []

try:
    stack.pop()
except IndexError:
    print("Stack Underflow: cannot pop from an empty stack")

try:
    top = stack[-1]
except IndexError:
    print("Stack Underflow: cannot peek at an empty stack")

# Alternatively, check before accessing
if stack:
    top = stack.pop()
else:
    print("Stack is empty")
Stack Underflow: cannot pop from an empty stack
Stack Underflow: cannot peek at an empty stack
Stack is emptyEin Performance-Detail ist wichtig: Listen basieren auf dynamischen Arrays. .append() ist meist O(1). Läuft der vorallozierte Speicher jedoch voll, muss Python einen größeren Block anlegen und alle Elemente kopieren.
Dieses gelegentliche Reallocating macht .append() amortisiert O(1) statt streng O(1). In der Praxis ist das selten und kurz, aber in latenzkritischen Umgebungen kann es zählen.
Trotzdem sind .append() und .pop() auf einer Liste für die meisten einfachen Stack-Aufgaben die erste Wahl. Keine Imports, vertraute Syntax, große Verbreitung – ideal für Skripte, Prototypen und Interviews, wo Schlichtheit zählt.
Wenn du konsistente O(1)-Performance ohne Reallocation willst, ist collections.deque das empfohlene Upgrade. Der Name steht für „double-ended queue“, funktioniert aber hervorragend als performanter Python-Stack. Unser Beispiel mit deque sieht so aus:
from collections import deque

# Creating a stack using deque
stack = deque()

# Push elements
stack.append(10)
stack.append(20)
stack.append(30)
print(stack)

# Pop the top element
top = stack.pop()
print(top)
print(stack)

# Peek at the top element
print(stack[-1])
deque([10, 20, 30])
30
deque([10, 20])
20Die Schnittstelle ist identisch zur List-Variante. .append(), .pop() und [-1] funktionieren genauso. Auch IndexError bei leerem Zugriff bleibt gleich – deine Fehlerbehandlung muss nicht geändert werden:
from collections import deque

stack = deque()

try:
    stack.pop()
except IndexError:
    print("Stack Underflow: cannot pop from an empty deque stack")
Stack Underflow: cannot pop from an empty deque stackDer entscheidende Unterschied steckt unter der Haube: Eine deque ist als doppelt verkettete Liste aus Blöcken implementiert, nicht als einzelnes Array. Sie muss beim Wachsen nie den gesamten Speicher kopieren.
Jedes .append() und .pop() ist garantiert echtes O(1) – nicht amortisiert, sondern konsistent. Bei Algorithmen mit tausenden oder Millionen Operationen summiert sich das.
Die Standardbibliothek enthält auch queue.LifoQueue – eine Stack-Implementierung speziell für Multithreading. „LIFO“ bestätigt die Reihenfolge, aber die Schnittstelle unterscheidet sich von den beiden vorherigen Ansätzen. Ein Beispiel:
from queue import LifoQueue

# Creating a thread-safe stack
stack = LifoQueue()

# Push elements using .put()
stack.put(10)
stack.put(20)
stack.put(30)
print(stack.qsize())

# Pop the top element using .get()
top = stack.get()
print(top)
print(stack.qsize())
3
30
2Auffällig ist die andere Syntax. Push heißt .put(), Pop heißt .get(). Die Benennung kommt aus dem Producer-Consumer-Muster des queue-Moduls.
Zwei Verhaltensunterschiede sind wichtig.
Erstens hat LifoQueue keine sichere Peek-Methode. Es gibt keinen eingebauten Weg, das Top-Element ohne Entfernen zu sehen. Interne Attribute auszulesen, unterläuft die Thread-Sicherheit und birgt Race Conditions.
Zweitens wirft LifoQueue beim Zugriff auf einen leeren Stack keinen IndexError. Standardmäßig blockiert .get() – es wartet unbegrenzt, bis ein anderes Thread ein Element puttet. Für nicht-blockierendes Verhalten setzt du block=False; dann wird queue.Empty geworfen. Beispiel:
from queue import LifoQueue, Empty

stack = LifoQueue()

# Non-blocking get raises Empty, not IndexError
try:
    stack.get(block=False)
except Empty:
    print("Stack is empty — no items to get")
Stack is empty — no items to getWegen der internen Locks für Thread-Sicherheit hat LifoQueue mehr Overhead als list oder deque. Für Single-Thread-Code ist das ungeeignet. Nutze LifoQueue nur bei natürlichem Multithreading mit gleichzeitigem Zugriff – sonst deque oder list.
Mit drei Optionen hilft dieser Direktvergleich bei der Entscheidung:
|
Feature |
|
|
|
|
Import nötig |
Nein |
Ja ( |
Ja ( |
|
Push-Methode |
|
|
|
|
Pop-Methode |
|
|
|
|
Peek-Methode |
|
|
Keine sichere Methode |
|
Fehler bei Leerheit |
|
|
Blockiert oder |
|
Push/Pop-Geschwindigkeit |
Amortisiert O(1) |
Echtes O(1) |
O(1) mit Lock-Overhead |
|
Thread-sicher |
Nein |
Nein |
Ja |
|
Am besten für |
Einfache Skripte, Prototyping |
Algorithmen, performancekritischen Code |
Multithreaded Producer-Consumer |
Hier ist mein Entscheidungsrahmen:
Nutze list, wenn du schnell einen Stack ohne Imports brauchst – z. B. in Skripten, Notebooks und Whiteboard-Interviews.
Nutze collections.deque, wenn du algorithmisch arbeitest, große Daten verarbeitest oder Performance zählt.
Nutze queue.LifoQueue nur bei natürlichem Multithreading mit konkurrierendem Zugriff.
Du wirst auch Tutorials sehen, die einen Python-Stack per eigener Linked-List-Klasse bauen, wobei jeder Knoten einen Wert und einen Zeiger nach unten hält. Das ist als Lernübung wertvoll und vertieft dein Verständnis für interne Arbeitsweise und Speicherreferenzen.
In Produktionscode ist ein verketteter Listen-Stack jedoch fast immer langsamer als eine deque, da für jeden Knoten ein Objekt erzeugt werden muss. Für die Praxis liefert collections.deque die beste Kombination aus Geschwindigkeit, Klarheit und Zuverlässigkeit.
Die Implementierung ist nur die halbe Miete. Der eigentliche Wert von Stacks zeigt sich, wenn sie Probleme lösen, die ohne LIFO deutlich komplexer wären. Hier drei Klassiker aus Interviews, Softwaresystemen und der Algorithmik.
Das Klammernbalance-Problem ist eine der häufigsten Stack-Fragen. Gegeben ist ein String mit Klammern wie (), [] und {}. Zu prüfen ist, ob jede öffnende Klammer in der richtigen Reihenfolge eine passende schließende hat.
Die Logik passt perfekt zu einem Stack. Beim Scannen von links nach rechts pushst du jede öffnende Klammer. Bei einer schließenden Klammer popst du das Top-Element und prüfst die Übereinstimmung.
Ist der Stack leer, wenn du popst, oder passt das Paar nicht, ist der String unausgeglichen. Nach dem kompletten Durchlauf muss der Stack leer sein. Übrig gebliebene Öffner bedeuten: Etwas wurde nicht geschlossen. So sieht das im Code aus:
from collections import deque

def is_balanced(expression):
    stack = deque()
    matching = {')': '(', ']': '[', '}': '{'}

    for char in expression:
        if char in '([{':
            stack.append(char)
        elif char in ')]}':
            if not stack:
                return False  # closing bracket with nothing to match
            if stack.pop() != matching[char]:
                return False  # mismatched pair

    return len(stack) == 0  # stack should be empty if balanced

# Test cases
print(is_balanced("([])"))
print(is_balanced("{[()]}"))
print(is_balanced("([)]"))
print(is_balanced("(("))
print(is_balanced(""))
True
True
False
False
TrueGehen wir "{[()]}" Schritt für Schritt durch, um den Stack in Aktion zu sehen:
|
Zeichen |
Aktion |
Stack-Zustand |
|
|
Push |
|
|
|
Push |
|
|
|
Push |
|
|
|
Pop |
|
|
|
Pop |
|
|
|
Pop |
|
Der Stack ist am Ende leer – der Ausdruck ist balanciert.
Diese Logik geht weit über Interviewfragen hinaus. Compiler und Interpreter nutzen sie für Syntaxprüfungen, damit jede öffnende Klammer, jedes Tag oder Trennzeichen ein korrektes Gegenstück hat.
Wenn du schon einmal SyntaxError: unexpected EOF in Python gesehen hast, war das eine Variante dieser Prüfung. HTML-Validatoren, JSON-Parser und sogar Linter für Konfigdateien stützen sich auf dieses Stack-Muster.
Depth-First Search ist eine grundlegende Graphdurchquerung – und ein Stack treibt sie an. Die Idee: Starte an einem Knoten, geh so weit wie möglich in einem Ast, bevor du zurückspringst. Das LIFO-Prinzip sorgt dafür, dass „zuerst in die Tiefe“ natürlich passiert.
Oft wird DFS rekursiv gelehrt, wobei der Call-Stack die Reihenfolge implizit steuert. Praktischer Haken: Pythons Standardgrenze liegt bei 1.000 Frames.
Bei großen oder tiefen Graphen führt das zu RecursionError. Die iterative Variante mit explizitem Stack vermeidet das und gibt dir die volle Kontrolle.
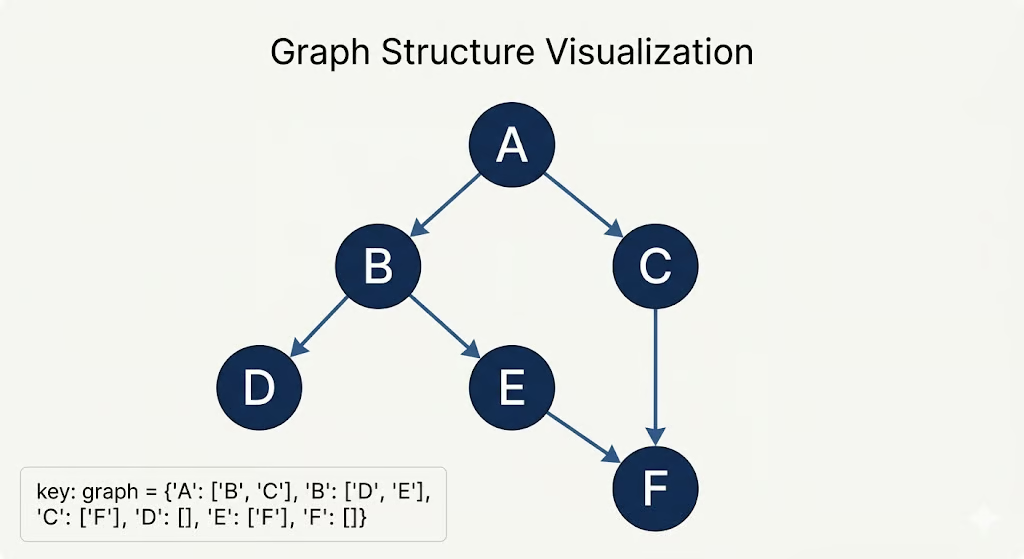
Hier ein Codebeispiel. Wir durchlaufen folgenden Graphen:
from collections import deque

def dfs_iterative(graph, start):
    visited = set()
    stack = deque()
    stack.append(start)
    traversal_order = []

    while stack:
        node = stack.pop()
        if node not in visited:
            visited.add(node)
            traversal_order.append(node)
            # Push neighbors onto the stack
            # Reverse to maintain left-to-right order after LIFO popping
            for neighbor in reversed(graph[node]):
                if neighbor not in visited:
                    stack.append(neighbor)

    return traversal_order

# Example graph represented as an adjacency list
graph = {
    'A': ['B', 'C'],
    'B': ['D', 'E'],
    'C': ['F'],
    'D': [],
    'E': ['F'],
    'F': []
}

print(dfs_iterative(graph, 'A'))
['A', 'B', 'D', 'E', 'F', 'C']So steuert der Stack die Traversierung:
|
Schritt |
Pop |
Nachbarn pushen |
Stack |
Besucht |
|
1 |
A |
B, C |
|
|
|
2 |
B |
D, E |
|
|
|
3 |
D |
(keine) |
|
|
|
4 |
E |
F |
|
|
|
5 |
F |
(keine) |
|
|
|
6 |
C |
F (bereits besucht) |
|
|
Beachte, wie das LIFO-Prinzip die Zweige A → B → D und A → B → E → F vollständig erkunden lässt, bevor C besucht wird. Genau das unterscheidet DFS von BFS, das eine Queue nutzt und Ebene für Ebene arbeitet.
Dieses iterative DFS-Muster funktioniert für Bäume, gerichtete und ungerichtete Graphen. Es ist zudem die Basis für Topological Sorting, Zyklendetektion sowie Maze- und Puzzle-Lösungen.
Ob Texteditor, Zeichenprogramm oder Tabellenkalkulation – Undo/Redo ist allgegenwärtig. Das dahinterliegende Muster ist elegant und basiert exakt auf zwei Stacks.
Ein Undo-Stack speichert jeden Zustand bei Änderungen. Beim Undo wird der aktuelle Zustand vom Undo-Stack gepoppt und auf den Redo-Stack gepusht.
Bei Redo wird vom Redo-Stack gepoppt und zurück auf den Undo-Stack gepusht. Nimmt der Nutzer nach einem Undo eine neue Änderung vor, wird der Redo-Stack geleert. Überschriebene Zukunft lässt sich nicht wiederherstellen. Beispiel:
from collections import deque

class TextEditor:
    def __init__(self):
        self.content = ""
        self.undo_stack = deque()
        self.redo_stack = deque()

    def type_text(self, text):
        """Record current state and apply new text."""
        self.undo_stack.append(self.content)
        self.content += text
        self.redo_stack.clear()  # new action invalidates redo history

    def undo(self):
        """Revert to the previous state."""
        if not self.undo_stack:
            print("Nothing to undo")
            return
        self.redo_stack.append(self.content)
        self.content = self.undo_stack.pop()

    def redo(self):
        """Re-apply the last undone action."""
        if not self.redo_stack:
            print("Nothing to redo")
            return
        self.undo_stack.append(self.content)
        self.content = self.redo_stack.pop()

    def show(self):
        print(f'Content: "{self.content}"')

# Demonstrate the undo/redo flow
editor = TextEditor()
editor.type_text("Hello")
editor.show()

editor.type_text(" World")
editor.show()

editor.type_text("!")
editor.show()

editor.undo()
editor.show()

editor.undo()
editor.show()

editor.redo()
editor.show()

editor.type_text(" Python")
editor.show()

editor.redo()
Content: "Hello"
Content: "Hello World"
Content: "Hello World!"
Content: "Hello World"
Content: "Hello"
Content: "Hello World"
Content: "Hello World Python"
Nothing to redoDer Zustandsfluss zwischen den beiden Stacks folgt einem klaren Muster:
|
Aktion |
Undo-Stack |
Content |
Redo-Stack |
|
Type "Hello" |
|
|
|
|
Type " World" |
|
|
|
|
Type "!" |
|
|
|
|
Undo |
|
|
|
|
Undo |
|
|
|
|
Redo |
|
|
|
|
Type " Python" |
|
|
|
Dieses Zwei-Stack-Muster gibt es überall dort, wo Nutzer durch eine Änderungshistorie vor und zurück gehen können (also fast überall):
Das Prinzip bleibt gleich: Ein Python-Stack hält die Vergangenheit, der andere die Zukunft, und LIFO sorgt dafür, dass du stets zum zuletzt genutzten Zustand zurückkehrst.
Stacks spielen auch unter der Haube jeder Python-Anwendung eine Rolle und ermöglichen Optimierungen, die die Laufzeit bestimmter Probleme drastisch senken können. Sehen wir uns beides an.
Bei jedem Funktionsaufruf in Python passiert etwas im Hintergrund: Python schiebt einen neuen Frame auf eine interne Datenstruktur, den Call-Stack. Dieser Frame enthält die lokalen Variablen, die Parameter und einen Zeiger auf die aufrufende Stelle.
Wenn die Funktion endet, wird ihr Frame vom Call-Stack gepoppt und die Kontrolle kehrt zum Aufrufer zurück.
Das lässt sich mit einem einfachen Beispiel beobachten:
def function_c():
    print("Inside function_c")
    # At this point, the call stack holds:
    # [main → function_a → function_b → function_c]  (top)

def function_b():
    print("Inside function_b")
    function_c()

def function_a():
    print("Inside function_a")
    function_b()

function_a()
Inside function_a
Inside function_b
Inside function_cWenn function_c läuft, liegen vier Frames auf dem Call-Stack. Beim Beenden werden die Frames in LIFO-Reihenfolge gepoppt: zuerst function_c, dann function_b, dann function_a, zuletzt der Hauptkontext.
So funktioniert auch Rekursion. Jeder rekursive Aufruf pusht einen neuen Frame mit eigenen lokalen Variablen; beim Zurückkehren werden die Frames abgebaut. Beispiel:
def factorial(n):
    if n <= 1:
        return 1
    return n * factorial(n - 1)

print(factorial(5))

# Call stack at deepest point:
# factorial(1)  ← top (returns 1)
# factorial(2)  ← waiting for factorial(1)
# factorial(3)  ← waiting for factorial(2)
# factorial(4)  ← waiting for factorial(3)
# factorial(5) ← waiting for factorial(4)120Das Problem entsteht bei zu tiefer Rekursion. Python setzt standardmäßig ein Limit von 1.000 Frames, damit der Call-Stack nicht den gesamten Speicher frisst. Überschreitet deine Funktion das Limit, wirft Python RecursionError. Beispiel:
def infinite_recursion(n):
    return infinite_recursion(n + 1)

try:
    infinite_recursion(0)
except RecursionError:
    print("RecursionError: maximum recursion depth exceeded")
RecursionError: maximum recursion depth exceededDu kannst dieses Limit mit dem Modul sys abfragen und ändern – aber mit Vorsicht:
import sys

print(sys.getrecursionlimit())
sys.setrecursionlimit(5000) # Increase with caution5000Wichtig ist die Unterscheidung: Der Call-Stack ist eine Systemstruktur des Interpreters. Du kannst nicht direkt darauf pushen oder poppen. Die Stacks mit list, deque und LifoQueue sind benutzerdefinierte Datenstrukturen im Heap deines Programms. Sie dienen anderen Zwecken, folgen aber demselben LIFO-Prinzip.
Ein monotoner Stack ist eine Variante, bei der die Elemente in nicht abnehmender oder nicht zunehmender Reihenfolge gehalten werden (manchmal streng). Beim Push eines neuen Elements popst du vorher alle Einträge, die die Ordnung verletzen würden. So lassen sich ganze Klassen von Optimierungsproblemen in linearer Zeit lösen.
Das klassische Beispiel ist „Next Greater Element“: Für jedes Element eines Arrays soll das erste größere Element rechts davon gefunden werden. Die naive Lösung mit Doppelschleife braucht O(n²). Ein monotoner Stack schafft O(n).
Die Einsicht: Du traversierst von rechts nach links und hältst einen absteigenden Stack. Für jedes Element popst du alles, was kleiner oder gleich ist – diese Werte können nie das „nächste größere“ für ein späteres linkes Element sein.
Was nach dem Popping oben liegt, ist die Antwort für das aktuelle Element. Danach pushst du das aktuelle Element. Hier ein Beispiel. -1 bedeutet: Es gibt rechts kein größeres Element:
from collections import deque

def next_greater_element(nums):
    n = len(nums)
    result = [-1] * n  # default: no greater element found
    stack = deque()     # monotonic decreasing stack (stores values)

    # Traverse from right to left
    for i in range(n - 1, -1, -1):
        # Pop elements that are not greater than current
        while stack and stack[-1] <= nums[i]:
            stack.pop()

        # If stack is not empty, top is the next greater element
        if stack:
            result[i] = stack[-1]

        # Push current element onto the stack
        stack.append(nums[i])

    return result

nums = [4, 5, 2, 25, 7, 18]
print(next_greater_element(nums))
[5, 25, 25, -1, 18, -1]So bleibt die Monotonie erhalten:
|
Schritt (rechts → links) |
Aktuell |
Stack vorher |
Pop |
Nächstgrößeres |
Stack nachher |
|
|
18 |
|
— |
-1 |
|
|
|
7 |
|
— |
18 |
|
|
|
25 |
|
7,18 |
-1 |
|
|
|
2 |
|
— |
25 |
|
|
|
5 |
|
2 |
25 |
|
|
|
4 |
|
— |
5 |
|
Beachte: Jedes Element wird genau einmal gepusht und höchstens einmal gepoppt. Deshalb ist die Zeitkomplexität trotz innerer while-Schleife O(n). Die Gesamtzahl der Push- und Pop-Operationen überschreitet nie 2n, selbst über alle Iterationen.
Viele verwandte Probleme lassen sich mit dem monotonen Stack ebenfalls von O(n²) auf O(n) drücken, darunter:
In allen Fällen gilt: Die monotone Eigenschaft erlaubt es, Elemente zu verwerfen, die künftige Ergebnisse nicht mehr beeinflussen können – das reduziert den Suchraum von quadratisch auf linear.
Der Stack gehört zu den ersten Datenstrukturen, die Programmierende lernen – und zu denen, für die man am längsten neue Einsätze findet. Ironischerweise das Gegenteil seines LIFO-Prinzips.
Wir haben gesehen, wie dieses Constraint in vielen Szenarien hilft: vom Klammernausgleich und DFS-Traversen über Undo/Redo bis hin zur Optimierung von Array-Problemen mit monotonen Stacks.
Wenn du nur eine Empfehlung mitnimmst, dann diese: Nutze collections.deque als Standard-Implementierung für Python-Stacks – es sei denn, es spricht etwas Konkretes dagegen.
Als nächsten Schritt empfehle ich unseren Kurs zu Data Structures and Algorithms in Python.
Python-Kurse
Kurs
Kurs
Lernpfad