Curso
Escrevendo código Python eficiente
4 h
155.5K
Sempre que você aperta Ctrl+Z para desfazer um erro, clica no botão de voltar do navegador ou observa uma função recursiva desfazer seus resultados, você está contando com uma pilha (stack). Como elas estão profundamente embutidas nos softwares que você usa no dia a dia, você interage com pilhas sem nem perceber.
Neste artigo, vamos ver o que é uma pilha, a lógica por trás desse conceito, comparar diferentes estratégias de implementação usando as bibliotecas nativas do Python e aplicá-las para resolver problemas algorítmicos.
Recomendo fazer nosso curso so Writing Efficient Python Code para combinar seu conhecimento de estruturas de dados com boas práticas de performance e manter o Python Basics Cheat Sheet à mão como referência rápida.
Antes de ver o código, é importante entender a base conceitual que torna a pilha em Python uma ferramenta tão poderosa. Vamos olhar o princípio central por trás das pilhas e ver como elas diferem de outras estruturas de dados comuns.
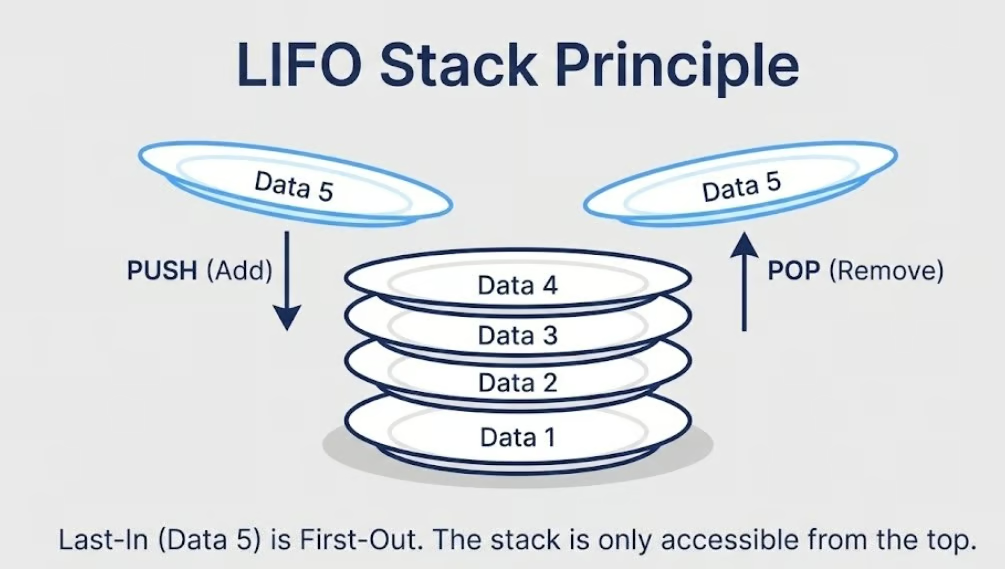
Uma pilha é uma estrutura de dados linear que segue o princípio Last-In-First-Out (LIFO). Isso significa que o elemento adicionado mais recentemente é sempre o primeiro a ser removido. Pense em uma pilha de pratos no bandejão: você coloca pratos novos por cima e sempre pega o de cima primeiro. Você nunca tira do meio ou do fundo. O acesso é restrito ao topo.
Essa única restrição — acesso apenas pelo topo — é o que dá às pilhas sua previsibilidade e eficiência. Todo elemento entra e sai pelo mesmo lado, o que mantém as operações simples e rápidas.
Um ponto importante logo de início: o Python não vem com um tipo primitivo de pilha dedicado, como outras linguagens. Não existe palavra-chave stack nem classe nativa. Em vez disso, o Python oferece alternativas robustas como lists, collections.deque e queue.LifoQueue, que podem se comportar como pilhas. Vamos ver cada implementação em detalhe mais adiante.
Entender o que é uma pilha fica mais claro quando vemos o que ela não é. As duas estruturas mais comparadas com pilhas são filas (queues) e listas padrão do Python.
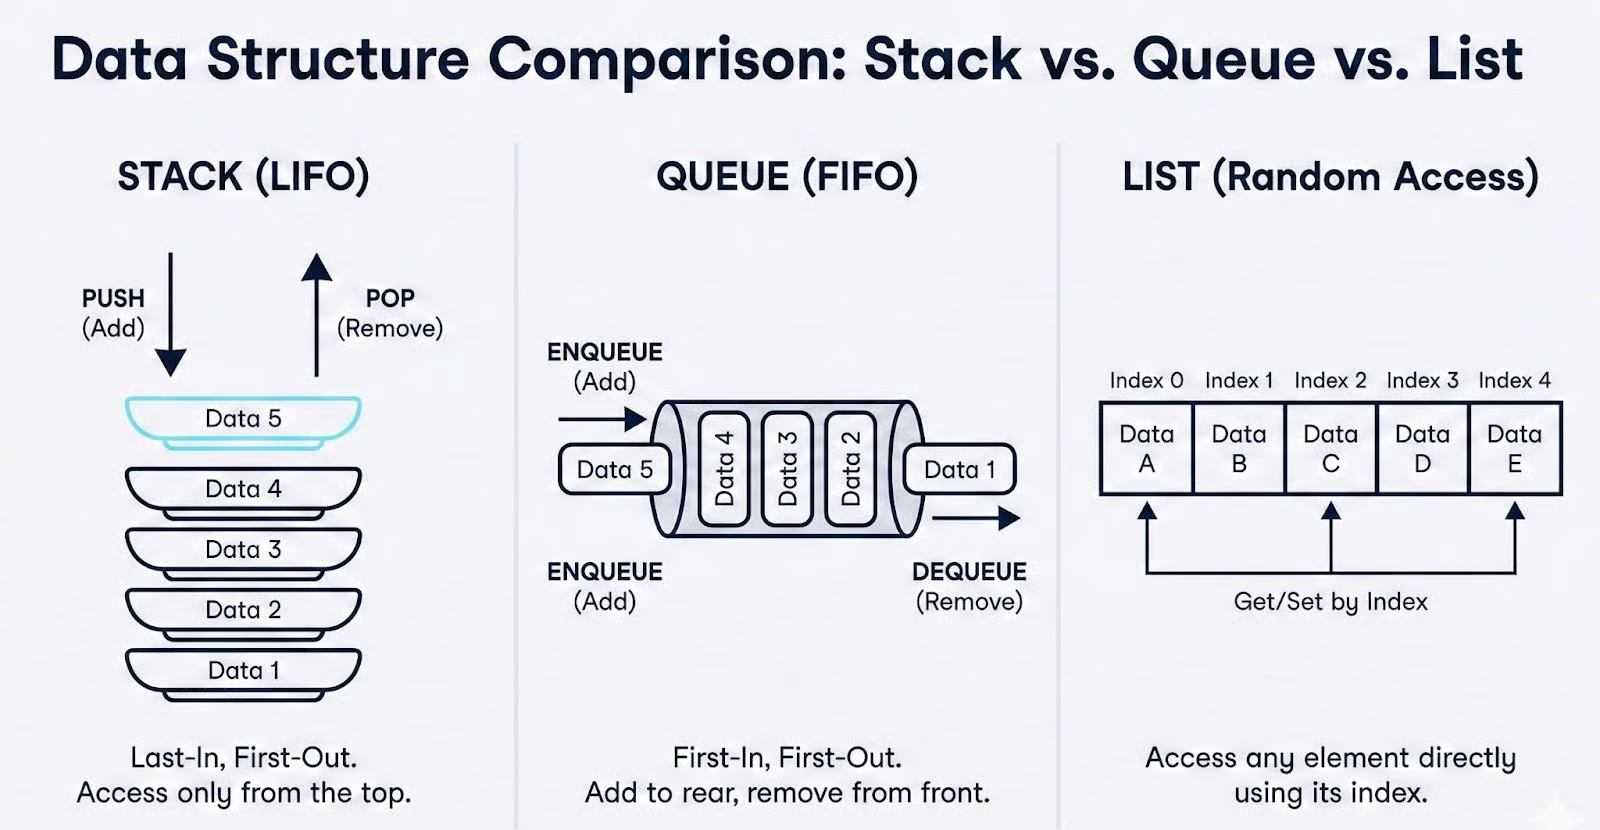
Uma fila segue o princípio First-In-First-Out (FIFO), o oposto de uma pilha. Numa fila, elementos são adicionados no fim e removidos do início, como uma fila de pessoas no guichê. Pilhas e filas são lineares e restringem como você acessa elementos, mas em direções opostas.
Escolher a estrutura errada pode quebrar silenciosamente a lógica de um algoritmo. Por exemplo, substituir uma pilha por uma fila em uma busca em profundidade a transformaria em uma busca em largura, produzindo resultados totalmente diferentes.
Uma lista padrão do Python, por outro lado, oferece acesso aleatório. Você pode ler, inserir ou excluir elementos em qualquer índice com operações como my_list[3] ou my_list.insert(2, value). Essa flexibilidade é útil em muitos contextos, mas também significa que nada impede você de acessar ou modificar acidentalmente elementos no meio da estrutura.
Quando você implementa um algoritmo que depende de uma ordem LIFO estrita — como backtracking, análise de sintaxe ou funcionalidade de desfazer — a natureza sem restrições de uma lista pode introduzir bugs sutis.
É exatamente por isso que o padrão de acesso restrito de uma pilha é um recurso, não uma limitação. Ao permitir interação apenas com o elemento do topo, uma pilha em Python reforça a correção por design. Você não consegue remover do lado errado nem sobrescrever um elemento enterrado no meio da estrutura.
Em design de algoritmos, restrições como essas mantêm sua lógica limpa e seu código previsível.
Agora que entendemos o que é uma pilha em Python e como ela difere de outras estruturas, vamos olhar as operações fundamentais que toda pilha suporta e analisar sua eficiência.
Toda implementação de pilha se baseia em um pequeno conjunto de operações padrão, independentemente da linguagem. Esses são os blocos que você usará sempre que trabalhar com pilhas.
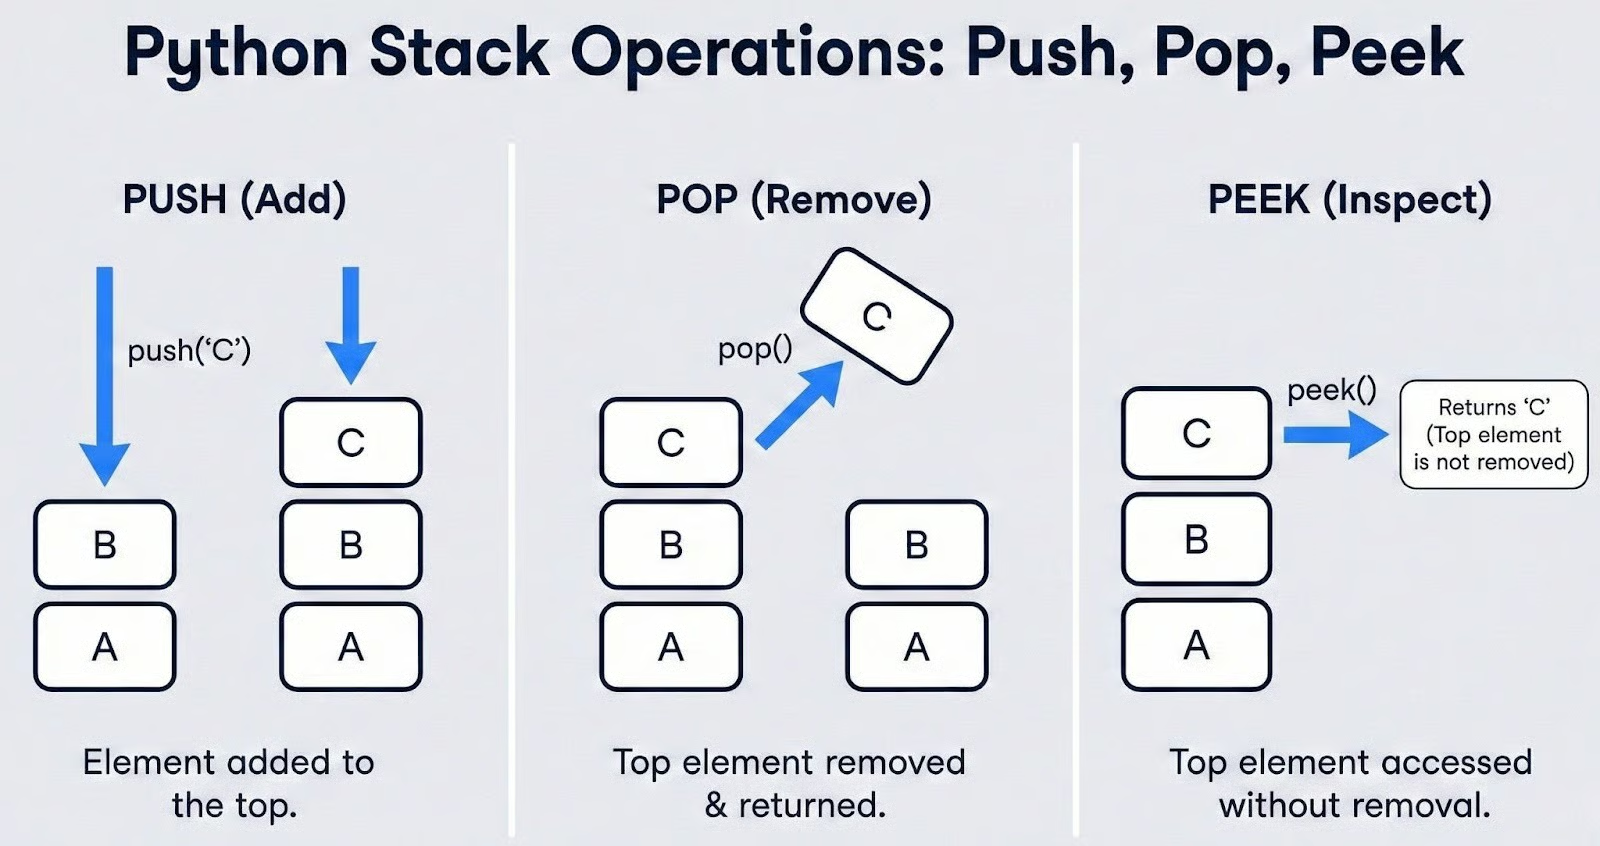
Push adiciona um elemento ao topo da pilha. Se a pilha contém [A, B] e você faz push de C, ela vira [A, B, C], com C no topo.
Pop remove e retorna o elemento que está no topo. No exemplo acima, fazer pop de [A, B, C] retorna C e deixa a pilha como [A, B].
Peek (às vezes chamado de top) permite visualizar o elemento do topo sem removê-lo. Isso é útil quando sua lógica precisa inspecionar o valor do topo antes de decidir fazer um pop — padrão comum em análise de expressões e checagem de parênteses balanceados.
Além dessas três operações centrais, dois métodos auxiliares são importantes para escrever código com pilha de forma segura e sem erros:
is_empty() verifica se a pilha contém elementos. Chamar pop ou peek em uma pilha vazia é uma fonte comum de erros em tempo de execução, então checar se está vazia é um hábito de programação defensiva que você deve adotar cedo.
size() retorna o número atual de elementos na pilha. Isso ajuda quando você precisa acompanhar a profundidade de uma recursão ou quantos itens ainda faltam processar.
Por fim, vale definir um termo que você verá em livros e entrevistas: Stack Underflow. É a condição de erro que ocorre quando você tenta fazer pop ou peek de uma pilha vazia. Não há nada para remover ou visualizar, então a operação é inválida.
A exceção ou o comportamento exato dependem da implementação. Veremos como o Python lida com isso na prática ao analisar list, deque e LifoQueue na próxima seção.
Um dos maiores motivos para pilhas serem tão usadas em algoritmos é sua eficiência. Vamos detalhar a complexidade de tempo e espaço de cada operação.
Push é O(1). Em uma implementação eficiente de pilha, adicionar um elemento ao topo é uma operação de tempo constante. A pilha não precisa deslocar nem reorganizar elementos; apenas coloca o novo item no fim. Isso vale para collections.deque e, no caso amortizado, para list do Python.
Pop é O(1). Remover o elemento do topo é igualmente rápido. A pilha acessa a última posição diretamente, retorna o valor e decrementa seu contador interno. Novamente, sem deslocar outros elementos.
Peek é O(1). Visualizar o topo sem remover é um acesso direto por índice, portanto também constante.
Busca é O(n). Aqui aparece o trade-off deliberado das pilhas. Se você precisa saber se um valor específico existe em algum lugar da pilha, não há alternativa a não ser percorrer todos os n elementos do topo para a base.
Pilhas não foram feitas para consultas arbitrárias. Elas sacrificam capacidade de busca em troca de push e pop rápidos e previsíveis. Se seu caso de uso exige buscas frequentes, outra estrutura — como set ou dict — é mais adequada.
Complexidade de espaço é O(n). Uma pilha com n elementos requer memória proporcional a n. Não há overhead oculto além do necessário para armazenar os elementos e uma pequena constante para o controle interno da estrutura.
Resumo rápido:
|
Operação |
Complexidade de tempo |
Observações |
|
Push |
O(1) |
Tempo constante. O(1) amortizado para listas do Python |
|
Pop |
O(1) |
Tempo constante |
|
Peek |
O(1) |
Acesso direto ao topo |
|
Busca |
O(n) |
Precisa varrer todos os elementos |
|
Espaço |
O(n) |
Linear no número de elementos armazenados |
O ponto-chave é que uma pilha em Python é otimizada para inserção e remoção rápidas em uma das extremidades. Enquanto você a usar para o que ela foi feita — gerenciar acesso ordenado do tipo LIFO — o desempenho é excelente. No momento em que você se pegar buscando em uma pilha com frequência, é sinal de repensar a escolha da estrutura.
Com a teoria e a análise de complexidade resolvidas, é hora de escrever código. O Python oferece três formas principais de implementar uma pilha, cada uma com pontos fortes e trade-offs. Vamos ver todas e entender qual se encaixa melhor no seu caso.
A forma mais direta de criar uma pilha em Python é com a list nativa. Como listas são arrays dinâmicos que suportam adicionar e remover elementos do fim, elas mapeiam naturalmente para o comportamento de pilha.
O método .append() funciona como push, e .pop() sem argumento remove e retorna o último elemento. Veja o exemplo:
# Creating a stack using a Python list
stack = []

# Push elements
stack.append(10)
stack.append(20)
stack.append(30)
print(stack)

# Pop the top element
top = stack.pop()
print(top)
print(stack)

# Peek at the top element
print(stack[-1])
[10, 20, 30]
30
[10, 20]
20Funciona bem, mas você precisa tratar com cuidado o caso de pilha vazia. No Python, tanto .pop() quanto stack[-1] disparam IndexError quando a lista está vazia. É assim que o Python expõe o Stack Underflow que definimos antes.
A boa prática é envolver essas chamadas em um try/except ou checar se está vazia antes de acessar o topo, como no exemplo:
# Handling Stack Underflow with try/except
stack = []

try:
    stack.pop()
except IndexError:
    print("Stack Underflow: cannot pop from an empty stack")

try:
    top = stack[-1]
except IndexError:
    print("Stack Underflow: cannot peek at an empty stack")

# Alternatively, check before accessing
if stack:
    top = stack.pop()
else:
    print("Stack is empty")
Stack Underflow: cannot pop from an empty stack
Stack Underflow: cannot peek at an empty stack
Stack is emptyHá um detalhe de performance a entender. Listas Python são apoiadas por arrays dinâmicos. Ao chamar .append(), a operação geralmente é O(1) instantânea. No entanto, quando o array interno fica sem espaço pré-alocado, o Python precisa alocar um bloco maior de memória e copiar todos os elementos.
Essa realocação ocasional torna .append() O(1) amortizado, e não O(1) estrito. Na prática, o atraso é raro e curto, mas em aplicações sensíveis a latência ou em tempo real, essa imprevisibilidade pode importar.
Apesar disso, .append() e .pop() em listas são a abordagem preferida para a maioria das tarefas simples com pilha. Zero imports, sintaxe familiar e ampla adoção tornam essa a escolha padrão — especialmente para scripts, protótipos e entrevistas em que simplicidade conta.
Se você precisa de O(1) consistente sem as pausas de realocação, collections.deque é o upgrade recomendado. O nome significa "fila de duas pontas", mas funciona perfeitamente como uma pilha de alta performance em Python. Nosso exemplo anterior fica assim com deque:
from collections import deque

# Creating a stack using deque
stack = deque()

# Push elements
stack.append(10)
stack.append(20)
stack.append(30)
print(stack)

# Pop the top element
top = stack.pop()
print(top)
print(stack)

# Peek at the top element
print(stack[-1])
deque([10, 20, 30])
30
deque([10, 20])
20Perceba que a interface é idêntica à abordagem com lista. .append(), .pop() e [-1] funcionam igual. O IndexError em acessos vazios também é o mesmo, então seu tratamento de erro não precisa mudar:
from collections import deque

stack = deque()

try:
    stack.pop()
except IndexError:
    print("Stack Underflow: cannot pop from an empty deque stack")
Stack Underflow: cannot pop from an empty deque stackA diferença crucial está por baixo dos panos. Um deque é implementado como uma lista duplamente ligada de blocos de tamanho fixo, não um único array. Isso significa que ele nunca precisa realocar e copiar toda a estrutura ao crescer.
Cada .append() e .pop() é um verdadeiro O(1) garantido — não amortizado, mas consistente. Para cargas algorítmicas com milhares ou milhões de operações, essa consistência soma muito.
A biblioteca padrão do Python também inclui queue.LifoQueue, uma implementação de pilha pensada para programas multithread. O "LIFO" no nome confirma a ordem Last-In-First-Out, mas a interface e o comportamento são diferentes das abordagens anteriores. Veja o exemplo:
from queue import LifoQueue

# Creating a thread-safe stack
stack = LifoQueue()

# Push elements using .put()
stack.put(10)
stack.put(20)
stack.put(30)
print(stack.qsize())

# Pop the top element using .get()
top = stack.get()
print(top)
print(stack.qsize())
3
30
2A primeira coisa a notar é a mudança de sintaxe. Push vira .put() e pop vira .get(). Essa nomenclatura vem do padrão produtor-consumidor do módulo queue, em que uma thread "coloca" itens e outra "retira".
Há duas diferenças comportamentais importantes.
Primeiro, LifoQueue não tem um método seguro de peek. Não há forma integrada de ver o topo sem removê-lo. Você até poderia acessar atributos internos, mas em contexto multithread isso anula o propósito de usar uma classe thread-safe e arrisca condições de corrida.
Segundo, LifoQueue não levanta IndexError ao tentar retirar de uma pilha vazia. Por padrão, .get() bloqueia: ele pausa a thread chamadora e espera indefinidamente até outra thread inserir um item. Se você quiser comportamento não bloqueante, passe block=False, que levanta a exceção queue.Empty. Veja:
from queue import LifoQueue, Empty

stack = LifoQueue()

# Non-blocking get raises Empty, not IndexError
try:
    stack.get(block=False)
except Empty:
    print("Stack is empty — no items to get")
Stack is empty — no items to getPor causa do mecanismo de bloqueio interno que torna LifoQueue thread-safe, suas operações têm mais overhead do que list ou deque. Isso a torna uma má escolha para código single-thread. Use LifoQueue somente quando houver múltiplas threads produzindo e consumindo dados em paralelo; nos demais casos, prefira deque ou list.
Com três opções disponíveis, aqui vai uma comparação lado a lado para orientar sua decisão:
|
Recurso |
|
|
|
|
Import necessário |
Não |
Sim ( |
Sim ( |
|
Método de push |
|
|
|
|
Método de pop |
|
|
|
|
Método de peek |
|
|
Sem método seguro |
|
Erro em vazio |
|
|
Bloqueia ou |
|
Velocidade push/pop |
O(1) amortizado |
O(1) verdadeiro |
O(1) com overhead de lock |
|
Thread-safe |
Não |
Não |
Sim |
|
Melhor para |
Scripts simples, prototipagem |
Algoritmos, código crítico de performance |
Produtor-consumidor multithread |
Aqui está meu critério para escolher a melhor implementação:
Use list quando precisar de uma pilha rápida sem imports — scripts, notebooks e quadros de entrevistas.
Use collections.deque ao escrever código algorítmico, processar grandes volumes de dados ou em qualquer coisa onde performance importa.
Use queue.LifoQueue apenas quando houver um cenário naturalmente multithread com acesso concorrente.
Você também pode encontrar tutoriais que implementam uma pilha do zero usando uma classe de lista ligada, em que cada nó guarda um valor e um ponteiro para o nó abaixo. Na minha opinião, é um exercício educacional valioso, que aprofunda o entendimento de como pilhas funcionam internamente e como referências de memória se encadeiam.
Mas, em código Python de produção, uma pilha com lista ligada quase sempre é mais lenta que um deque por causa do overhead de criar objetos nó individuais. Para trabalho real em Python, collections.deque oferece a melhor combinação de velocidade, clareza e confiabilidade.
Entender como implementar uma pilha em Python é só metade do caminho. O valor real das pilhas aparece quando você as vê resolvendo problemas que seriam bem mais complexos sem a ordem LIFO. Vamos ver três aplicações clássicas que aparecem o tempo todo em entrevistas, sistemas de software e design de algoritmos.
O problema de parênteses balanceados é um dos mais frequentes em entrevistas técnicas. Dada uma string contendo colchetes, como (), [] e {}, você precisa determinar se todo abre possui um fecha correspondente na ordem correta.
A lógica mapeia perfeitamente para uma pilha. Ao varrer a string da esquerda para a direita, faça push de cada abertura na pilha. Ao encontrar um fechamento, faça pop do topo e verifique se corresponde.
Se a pilha estiver vazia quando você tentar dar pop, ou se o elemento do topo não corresponder, a string está desbalanceada. Após processar a string inteira, a pilha deve estar vazia. Qualquer abertura sobrando significa algo sem fechamento. Vamos ver em ação:
from collections import deque

def is_balanced(expression):
    stack = deque()
    matching = {')': '(', ']': '[', '}': '{'}

    for char in expression:
        if char in '([{':
            stack.append(char)
        elif char in ')]}':
            if not stack:
                return False  # closing bracket with nothing to match
            if stack.pop() != matching[char]:
                return False  # mismatched pair

    return len(stack) == 0  # stack should be empty if balanced

# Test cases
print(is_balanced("([])"))
print(is_balanced("{[()]}"))
print(is_balanced("([)]"))
print(is_balanced("(("))
print(is_balanced(""))
True
True
False
False
TrueVamos acompanhar "{[()]}" passo a passo para ver a pilha em ação:
|
Caractere |
Ação |
Estado da pilha |
|
|
Push |
|
|
|
Push |
|
|
|
Push |
|
|
|
Pop |
|
|
|
Pop |
|
|
|
Pop |
|
A pilha fica vazia no final, então a expressão está balanceada.
Essa mesma lógica vai muito além de entrevistas. Compiladores e interpretadores a usam para validar sintaxe, garantindo que toda tag, colchete ou delimitador de abertura no código-fonte tenha seu fechamento adequado.
Se você já viu a mensagem SyntaxError: unexpected EOF em Python, viu uma forma desse tipo de checagem em ação. Validadores de HTML, parsers de JSON e até linters de arquivos de configuração usam variações dessa abordagem baseada em pilha.
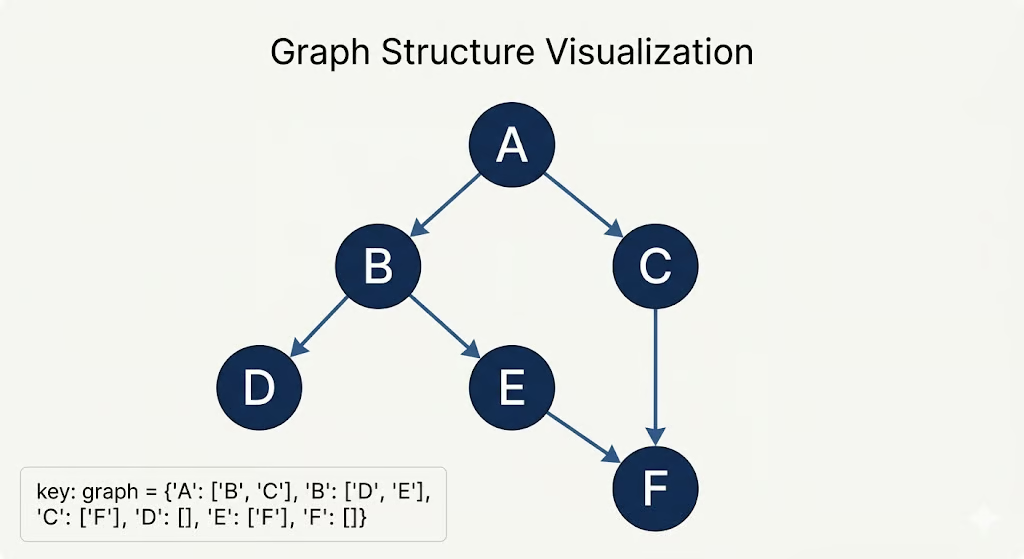
Depth-first search é um dos algoritmos fundamentais de travessia de grafos, e a pilha é a estrutura que o impulsiona. A ideia é simples: começar em um nó, explorar o máximo possível por um ramo antes de voltar (backtrack) para tentar o próximo. A natureza LIFO da pilha é o que faz esse "ir fundo primeiro" acontecer naturalmente.
A maioria dos cursos introdutórios ensina DFS com recursão, onde a pilha de chamadas (call stack) gerencia a ordem de travessia implicitamente. Porém, a abordagem recursiva tem uma limitação prática: o limite padrão de recursão do Python é 1.000 frames.
Para grafos grandes ou profundamente aninhados, isso leva a RecursionError. A versão iterativa, que usa uma pilha explícita, evita esse problema e dá controle total sobre a travessia.
Vamos ver um exemplo. Faremos DFS no grafo abaixo:
from collections import deque

def dfs_iterative(graph, start):
    visited = set()
    stack = deque()
    stack.append(start)
    traversal_order = []

    while stack:
        node = stack.pop()
        if node not in visited:
            visited.add(node)
            traversal_order.append(node)
            # Push neighbors onto the stack
            # Reverse to maintain left-to-right order after LIFO popping
            for neighbor in reversed(graph[node]):
                if neighbor not in visited:
                    stack.append(neighbor)

    return traversal_order

# Example graph represented as an adjacency list
graph = {
    'A': ['B', 'C'],
    'B': ['D', 'E'],
    'C': ['F'],
    'D': [],
    'E': ['F'],
    'F': []
}

print(dfs_iterative(graph, 'A'))
['A', 'B', 'D', 'E', 'F', 'C']Vamos acompanhar a execução para ver como a pilha governa a travessia:
|
Passo |
Pop |
Empurra vizinhos |
Pilha |
Visitados |
|
1 |
A |
B, C |
|
|
|
2 |
B |
D, E |
|
|
|
3 |
D |
(nenhum) |
|
|
|
4 |
E |
F |
|
|
|
5 |
F |
(nenhum) |
|
|
|
6 |
C |
F (já visitado) |
|
|
Perceba como a ordenação LIFO força o algoritmo a explorar totalmente os ramos A → B → D e A → B → E → F antes de voltar para visitar C. É isso que distingue DFS de BFS, que usa uma fila e explora todos os vizinhos no nível atual antes de ir mais fundo.
O padrão iterativo de DFS mostrado aqui funciona para árvores, grafos dirigidos e não dirigidos. Também é a base para algoritmos como ordenação topológica, detecção de ciclos e solução de labirintos e quebra-cabeças.
Se você já usou um editor de texto, aplicativo de desenho ou planilha, você contou com desfazer/refazer sem pensar no que acontece por baixo. O mecanismo é elegante — e roda com exatamente duas pilhas.
Uma pilha de desfazer armazena cada ação ou estado conforme o usuário faz mudanças. Quando o usuário aciona desfazer, o estado atual é removido da pilha de desfazer e empurrado para a pilha de refazer.
Se o usuário então aciona refazer, o estado é removido da pilha de refazer e volta para a pilha de desfazer. Se o usuário faz uma mudança nova após desfazer, a pilha de refazer é limpa. Você não pode refazer algo que foi sobrescrito por uma nova ação. Veja o exemplo:
from collections import deque

class TextEditor:
    def __init__(self):
        self.content = ""
        self.undo_stack = deque()
        self.redo_stack = deque()

    def type_text(self, text):
        """Record current state and apply new text."""
        self.undo_stack.append(self.content)
        self.content += text
        self.redo_stack.clear()  # new action invalidates redo history

    def undo(self):
        """Revert to the previous state."""
        if not self.undo_stack:
            print("Nothing to undo")
            return
        self.redo_stack.append(self.content)
        self.content = self.undo_stack.pop()

    def redo(self):
        """Re-apply the last undone action."""
        if not self.redo_stack:
            print("Nothing to redo")
            return
        self.undo_stack.append(self.content)
        self.content = self.redo_stack.pop()

    def show(self):
        print(f'Content: "{self.content}"')

# Demonstrate the undo/redo flow
editor = TextEditor()
editor.type_text("Hello")
editor.show()

editor.type_text(" World")
editor.show()

editor.type_text("!")
editor.show()

editor.undo()
editor.show()

editor.undo()
editor.show()

editor.redo()
editor.show()

editor.type_text(" Python")
editor.show()

editor.redo()
Content: "Hello"
Content: "Hello World"
Content: "Hello World!"
Content: "Hello World"
Content: "Hello"
Content: "Hello World"
Content: "Hello World Python"
Nothing to redoO fluxo de estados entre as duas pilhas segue um padrão claro:
|
Ação |
Pilha de desfazer |
Conteúdo |
Pilha de refazer |
|
Digita "Hello" |
|
|
|
|
Digita " World" |
|
|
|
|
Digita "!" |
|
|
|
|
Desfazer |
|
|
|
|
Desfazer |
|
|
|
|
Refazer |
|
|
|
|
Digita " Python" |
|
|
|
Esse padrão de duas pilhas não se limita a editores de texto. Ele aparece em qualquer lugar onde usuários precisam andar para trás e para frente em uma sequência de mudanças (basicamente, em todo lugar):
O princípio é sempre o mesmo: uma pilha rastreia o histórico, a outra rastreia o futuro, e a ordem LIFO garante que você sempre retorne primeiro ao estado mais recente.
Pilhas também desempenham um papel importante por baixo dos panos de todo programa Python que você executa e alimentam técnicas de otimização que podem reduzir drasticamente a complexidade de certos problemas. Vamos ver essas duas dimensões.
Sempre que você chama uma função em Python, algo acontece nos bastidores que você não controla diretamente. O Python empilha (push) um novo frame em uma estrutura interna chamada call stack. Esse frame mantém as variáveis locais da função, seus parâmetros e um ponteiro de volta para a linha de código que iniciou a chamada.
Quando a função termina, seu frame é removido (pop) da call stack e o controle retorna para quem chamou.
Você pode inspecionar esse comportamento com um exemplo simples:
def function_c():
    print("Inside function_c")
    # At this point, the call stack holds:
    # [main → function_a → function_b → function_c]  (top)

def function_b():
    print("Inside function_b")
    function_c()

def function_a():
    print("Inside function_a")
    function_b()

function_a()
Inside function_a
Inside function_b
Inside function_cQuando function_c executa, a call stack tem quatro frames empilhados. À medida que cada função termina, seu frame é removido em ordem LIFO: function_c termina primeiro, depois function_b, depois function_a e, por fim, o escopo do módulo principal.
Esse é exatamente o mecanismo que faz a recursão funcionar. Cada chamada recursiva empilha um novo frame com suas próprias variáveis locais, e os resultados se desenrolam conforme os frames são removidos. Veja:
def factorial(n):
    if n <= 1:
        return 1
    return n * factorial(n - 1)

print(factorial(5))

# Call stack at deepest point:
# factorial(1)  ← top (returns 1)
# factorial(2)  ← waiting for factorial(1)
# factorial(3)  ← waiting for factorial(2)
# factorial(4)  ← waiting for factorial(3)
# factorial(5) ← waiting for factorial(4)120O problema surge quando a recursão vai fundo demais. O Python define um limite padrão de 1.000 frames para evitar que a call stack consuma toda a memória disponível. Se sua função recursiva exceder esse limite, o Python levanta RecursionError. Veja:
def infinite_recursion(n):
    return infinite_recursion(n + 1)

try:
    infinite_recursion(0)
except RecursionError:
    print("RecursionError: maximum recursion depth exceeded")
RecursionError: maximum recursion depth exceededVocê pode verificar e modificar esse limite usando o módulo sys, mas aumente com cautela:
import sys

print(sys.getrecursionlimit())
sys.setrecursionlimit(5000) # Increase with caution5000A distinção importante é que a call stack é uma estrutura de sistema gerenciada pelo interpretador Python. Você não pode fazer push ou pop nela diretamente. As pilhas com list, deque e LifoQueue que construímos antes são estruturas definidas pelo usuário que vivem na heap do seu programa. Servem a propósitos diferentes, mas seguem o mesmo princípio LIFO.
Uma pilha monotônica é uma variação especializada em que os elementos são mantidos em ordem não crescente ou não decrescente (ou estritamente, dependendo do problema). Toda vez que você faz push de um novo elemento, primeiro remove (pop) todos os que violariam a restrição de ordem. Ela é a chave para resolver toda uma classe de problemas de otimização em tempo linear.
O exemplo clássico é o Next Greater Element: dada uma lista de inteiros, encontre o primeiro elemento à direita que seja maior que cada elemento. A abordagem ingênua com laços aninhados roda em O(n²). Para cada elemento, você varre tudo à direita. Uma pilha monotônica resolve em O(n).
O insight é percorrer o array da direita para a esquerda, mantendo uma pilha decrescente. Para cada elemento, você remove da pilha tudo que for menor ou igual a ele. Esses valores nunca serão o "próximo maior" de nenhum elemento à esquerda.
O que permanecer no topo da pilha após os pops é a resposta para o elemento atual. Depois, você empilha o elemento atual. Veja o exemplo. Note que -1 aqui significa que não há número maior à direita daquele:
from collections import deque

def next_greater_element(nums):
    n = len(nums)
    result = [-1] * n  # default: no greater element found
    stack = deque()     # monotonic decreasing stack (stores values)

    # Traverse from right to left
    for i in range(n - 1, -1, -1):
        # Pop elements that are not greater than current
        while stack and stack[-1] <= nums[i]:
            stack.pop()

        # If stack is not empty, top is the next greater element
        if stack:
            result[i] = stack[-1]

        # Push current element onto the stack
        stack.append(nums[i])

    return result

nums = [4, 5, 2, 25, 7, 18]
print(next_greater_element(nums))
[5, 25, 25, -1, 18, -1]Vamos acompanhar a execução para ver como a propriedade monotônica é mantida:
|
Passo (direita → esquerda) |
Atual |
Pilha antes |
Pops |
Próximo maior |
Pilha depois |
|
|
18 |
|
— |
-1 |
|
|
|
7 |
|
— |
18 |
|
|
|
25 |
|
7,18 |
-1 |
|
|
|
2 |
|
— |
25 |
|
|
|
5 |
|
2 |
25 |
|
|
|
4 |
|
— |
5 |
|
Repare que cada elemento é empilhado exatamente uma vez e removido no máximo uma vez em toda a travessia. Por isso a complexidade de tempo total é O(n), mesmo com o while interno. O número cumulativo de operações de push e pop nunca excede 2n.
Como mencionei, há muitos problemas semelhantes que a pilha monotônica acelera de O(n²) para O(n), como:
Em todos os casos, a ideia central é a mesma: a restrição monotônica permite descartar elementos que não influenciam mais os resultados futuros, podando o espaço de busca do quadrático para o linear.
A pilha é uma das primeiras estruturas de dados que todo programador aprende — e uma das últimas de que deixa de encontrar novos usos, ironicamente o oposto de sua natureza LIFO.
Neste artigo, vimos como essa restrição LIFO ajuda em vários cenários, de validar colchetes aninhados e conduzir travessias em profundidade a gerenciar estados de desfazer/refazer e otimizar problemas de arrays com pilhas monotônicas.
Se é para deixar uma recomendação, é esta: use collections.deque como sua implementação padrão de pilha em Python, a menos que você tenha um motivo específico para não usá-la.
Como próximo passo, recomendo fazer nosso curso de Data Structures and Algorithms in Python.
Cursos de Python
Curso
Curso
Programa
Tutorial
Sejal Jaiswal
24 min
Tutorial
Allan Ouko
7 min
Tutorial
Abid Ali Awan
7 min
Tutorial
Théo Vanderheyden
12 min
Tutorial
Laiba Siddiqui
6 min
Tutorial
Amberle McKee
12 min