Curso
Desarrollo de software con Cursor
1 h 30 min
4.2K
Qwen 3.5 es una familia de modelos multimodales diseñada para cubrir un amplio rango de escenarios de despliegue, desde modelos ligeros para el edge hasta sistemas de razonamiento de frontera.
La gama oficial de Qwen 3.5 incluye actualmente variantes 0.8B, 2B, 4B, 9B, 27B, 35B-A3B, 122B-A10B y 397B-A17B, además de checkpoints base y cuantizados para algunos modelos.
Elegir el modelo small adecuado depende del tipo de flujo de trabajo que quieras construir.
Para este tutorial hemos usado el modelo qwen3.5:9b, que ofrece un buen equilibrio entre capacidad, desplegado local y razonamiento multimodal, lo que lo hace ideal para construir una canalización de fotogramas de vídeo a juego en navegador sin depender de APIs externas.
También puedes leer nuestra guía sobre cómo ejecutar Qwen3.5 en local con una sola GPU.
También probé esta demo con el modelo qwen/qwen3.5-397b-a17b. Aunque este modelo es significativamente mayor y en general más capaz que la variante local de 9B, requiere inferencia vía API, lo que introduce dependencias externas y posible latencia.
En la práctica, si el tiempo de ejecución no es una restricción estricta, el tiempo total de generación difirió en torno a ~3 minutos entre ambos modelos en mis pruebas. El modelo más grande sí produjo una lógica de juego algo más fluida y una experiencia de previsualización más pulida, pero la mejora no fue drástica.
Teniendo en cuenta que el modelo 9B se ejecuta completamente en local, los resultados son sorprendentemente competitivos. A pesar de su tamaño mucho menor, es capaz de generar juegos jugables en el navegador con solo una ligera caída de calidad respecto al modelo 397B, mucho mayor.
Puedes leer nuestra guía completa sobre fine-tuning de Qwen3.5 small para aprender a sacarle más partido a la variante 0.8B.
En esta sección, construiremos una app de Streamlit que:
qwen3.5:9b a través de OllamaEsta configuración pone en valor las capacidades multimodales de Qwen para tareas como deducir la lógica a partir de metraje de juego y convertirla en código
Antes de crear la aplicación, primero debemos preparar un entorno local con las librerías necesarias para procesado de vídeo, inferencia multimodal y la interfaz interactiva.
pip install streamlit opencv-python ollama python-dotenv pydanticLa demo usa un conjunto pequeño de librerías de Python:
Streamlit para construir la interfaz web interactiva donde los usuarios suben vídeos de gameplay y previsualizan los juegos generados.OpenCV para decodificar el vídeo subido y extraer fotogramas representativos.Ollama para ejecutar el modelo local Qwen 3.5 y realizar razonamiento multimodal y generación de código.python-dotenv para gestionar variables de entorno si hacen falta.Pydantic para imponer un esquema estructurado a la especificación de juego inferida antes de generar código.A continuación, necesitamos descargar el propio modelo. Ollama lo pone fácil tirando del registro de modelos directamente:
ollama run qwen3.5:9bLa primera ejecución descarga el modelo y lo guarda en local. El qwen3.5:9B ocupa aproximadamente 6,6 GB, admite entradas de texto e imagen y ofrece una ventana de contexto de 256K tokens, lo que lo hace muy adecuado para flujos de trabajo multimodales.
Con el entorno local listo, el siguiente paso es importar las librerías que usaremos en toda la aplicación y crear una carpeta para guardar los artefactos generados.
import json
import base64
import tempfile
from pathlib import Path
from typing import List
import cv2
import ollama
import streamlit as st
import streamlit.components.v1 as components
from pydantic import BaseModel, Field, ValidationError
OUTPUT_DIR = Path("outputs_local")
OUTPUT_DIR.mkdir(exist_ok=True)
El bloque anterior reúne la pila principal del proyecto. Usamos json para formatear la especificación estructurada del juego, base64 para codificar los fotogramas extraídos antes de enviárselos al modelo y tempfile para guardar de forma segura los vídeos subidos durante la sesión. Path de pathlib nos da una forma clara de gestionar rutas, mientras que List de typing se usa para las anotaciones de tipo en las definiciones de esquema.
Después importamos las librerías principales de la aplicación: cv2 de OpenCV se encarga de leer el clip de gameplay y extraer fotogramas representativos; ollama es la interfaz para comunicar con el modelo qwen3.5:9b ejecutándose en local; streamlit aporta la interfaz web, y streamlit.components.v1 nos permite incrustar el juego HTML generado directamente en la app para su previsualización e interacción en vivo.
Por último, importamos BaseModel, Field y ValidationError de Pydantic. Se usan para definir y validar el esquema JSON estructurado que representa el diseño del juego inferido. En vez de confiar en que el modelo devuelva texto poco estructurado, lo forzamos a un esquema predecible antes de pasar ese resultado al generador de juego HTML.
Las dos últimas líneas crean un directorio outputs_local si aún no existe. Aquí guardamos artefactos generados como la especificación inferida y el archivo HTML final del juego, lo que facilita inspeccionar o descargar resultados tras cada ejecución.
En el siguiente paso definiremos las clases de esquema Pydantic que describen la especificación de juego que el modelo debe generar a partir de los fotogramas extraídos.
En esta fase definimos el esquema estructurado que el modelo debe seguir al describir las mecánicas de juego inferidas a partir de los fotogramas.
En lugar de pedir al modelo que genere directamente código HTML a partir de imágenes, primero le exigimos que produzca una especificación de juego estructurada. Esta representación intermedia hace que la canalización sea mucho más fácil de depurar, validar y ampliar.
class Entity(BaseModel):
    name: str
    role: str
    behavior: str
class Physics(BaseModel):
    gravity: str = ""
    jump_or_impulse: str = ""
    collision_style: str = ""
    movement_style: str = ""
class VisualStyle(BaseModel):
    perspective: str = ""
    palette: str = ""
    background: str = ""
    ui_elements: List[str] = Field(default_factory=list)
class GameSpec(BaseModel):
    title: str
    genre: str
    objective: str
    player_controls: List[str]
    gameplay_loop: List[str]
    entities: List[Entity]
    scoring_rules: List[str]
    win_condition: str
    lose_condition: str
    physics: Physics
    visual_style: VisualStyle
    assumptions: List[str]
    confidence_notes: List[str]
Este esquema define la estructura principal de la especificación de juego que el modelo debe generar.
Entity representa cualquier objeto presente en el juego, como el jugador, enemigos, obstáculos o elementos de UI. Cada entidad incluye un nombre, su rol dentro del juego y una breve descripción de su comportamiento.Physics describe cómo se mueven e interactúan los objetos en el mundo del juego. Estos campos capturan mecánicas básicas como la gravedad, el impulso/salto, el manejo de colisiones y los patrones de movimiento.VisualStyle recoge la presentación visual del juego: la perspectiva de cámara (por ejemplo, cenital o de desplazamiento lateral), la paleta de colores, el estilo del fondo y los elementos de UI visibles como marcadores de puntuación o indicadores de salud.GameSpec lo integra todo. Representa el diseño completo del juego inferido a partir de los fotogramas, incluyendo el objetivo, los controles, el bucle de juego, las entidades, el sistema de puntuación, las condiciones de victoria/derrota y las asunciones del modelo al interpretar los fotogramas.Al validar la salida del modelo contra este esquema, nos aseguramos de que el diseño inferido siga siempre una estructura predecible. Esto también facilita pasar la especificación a la siguiente etapa de la canalización.
Con el esquema listo, el siguiente paso es definir los prompts que guían al modelo a través de las dos etapas de nuestra canalización.
La primera etapa se centra en reconstruir las mecánicas de juego a partir de los fotogramas extraídos y producir una especificación estructurada.
La segunda etapa toma esa especificación y genera un juego jugable para navegador usando HTML, CSS y JavaScript.
El primer componente de nuestra estrategia de prompting son los system prompts, que definen el rol que el modelo debe desempeñar en cada etapa de la canalización.
SPEC_SYSTEM_PROMPT = """
You are an expert arcade game designer and gameplay reverse-engineering analyst.
You observe a few frames from a gameplay video and infer the smallest possible playable browser-game clone.
The gameplay is likely a simple arcade game like Pong, Breakout, Snake, or Flappy Bird.
Prefer these mechanics if uncertain.
Rules:
- Only infer mechanics that are strongly supported by visual evidence.
- Prefer a minimal playable prototype over a complex clone.
- Do not invent advanced systems unless clearly visible.
- Keep the result suitable for plain HTML5 canvas and JavaScript.
- Return strict JSON only.
- No markdown.
- No code fences.
""".strip()
CODE_SYSTEM_PROMPT = """
You are a senior JavaScript game developer.
Generate a complete single-file HTML game.
Requirements:
- Return raw HTML only.
- No markdown.
- No code fences.
- Use plain HTML, CSS, and JavaScript only.
- Use HTML5 canvas unless there is a strong reason not to.
- Keep the game simple, playable, and self-contained.
- No external libraries, no CDNs, no external assets.
- Use simple shapes/colors instead of images.
- Include score.
- Include restart support.
- Include instructions on screen.
- Keep keyboard controls simple.
- Make the game playable inside an iframe preview.
- IMPORTANT: the canvas must have tabindex="0".
- IMPORTANT: keyboard input must work inside an embedded iframe.
- IMPORTANT: focus the canvas automatically on load, on canvas click, and after pressing Start/Restart buttons.
- IMPORTANT: prevent default browser behavior for arrow keys and spacebar.
""".strip()
El primer system prompt instruye al modelo para que actúe como analista de gameplay. Hace hincapié en minimizar las suposiciones y le anima a inferir solo las mecánicas que estén claramente respaldadas por los fotogramas.
Como el modelo solo ve un número pequeño de imágenes muestreadas, el prompt lo sesga explícitamente hacia juegos arcade sencillos que se puedan implementar con lógica ligera en el navegador.
El segundo system prompt cambia el rol del modelo a desarrollador JavaScript. En esta fase, el modelo recibe una especificación estructurada del juego y es responsable de convertirla en un juego HTML completo.
Ahora definimos una función auxiliar que construye el prompt de usuario para la primera etapa de la canalización. Este prompt pide al modelo que analice los fotogramas extraídos y produzca una especificación de juego estructurada.
def build_spec_user_prompt(game_hint: str, extra_constraints: str, max_frames: int) -> str:
    return f"""
You are given a few still frames extracted from a gameplay video.
From these frames, infer a minimal, playable browser game design.
Use very simple 2D arcade-style mechanics.
If you are unsure, bias toward Pong / Breakout / Snake / Flappy Bird style games.
Output valid JSON with exactly this schema:
{{
  "title": "string",
  "genre": "string",
  "objective": "string",
  "player_controls": ["string"],
  "gameplay_loop": ["string"],
  "entities": [
    {{
      "name": "string",
      "role": "player|enemy|obstacle|projectile|ui|environment",
      "behavior": "string"
    }}
  ],
  "scoring_rules": ["string"],
  "win_condition": "string",
  "lose_condition": "string",
  "physics": {{
    "gravity": "string",
    "jump_or_impulse": "string",
    "collision_style": "string",
    "movement_style": "string"
  }},
  "visual_style": {{
    "perspective": "string",
    "palette": "string",
    "background": "string",
    "ui_elements": ["string"]
  }},
  "assumptions": ["string"],
  "confidence_notes": ["string"]
}}
Important:
- Only infer the simplest mechanics needed for a playable clone.
- Prefer a very simple game that can be rebuilt in one HTML file.
- Avoid menus, accounts, audio, networking, cutscenes, or multi-level progression.
Optional game hint from user:
{game_hint or "None"}
Extra constraints:
{extra_constraints or "None"}
You are seeing at most {max_frames} frames from the video, so stay simple and conservative.
Return JSON only.
""".strip()
Esta función construye el prompt que se enviará al modelo junto con los fotogramas extraídos del vídeo. Incluye varios elementos importantes:
GameSpecAl incrustar el esquema directamente en el prompt, fomentamos que el modelo produzca una salida que pueda validarse con Pydantic en la siguiente etapa de la canalización.
Una vez generada y validada la especificación del juego, necesitamos un segundo prompt para convertirla en un juego realmente jugable.
def build_code_user_prompt(game_spec: dict) -> str:
    spec_json = json.dumps(game_spec, indent=2)
    return f"""
Using the following game specification, generate a complete single-file HTML game.
Requirements:
- One self-contained HTML file.
- Inline CSS and inline JavaScript.
- Must be playable in a browser.
- Must render correctly in an iframe.
- Show score on screen.
- Show controls on screen.
- Add restart support using a button or key.
- Keep visuals simple and robust.
- Use requestAnimationFrame.
- Use canvas for gameplay rendering.
- No external assets.
- Make the game small but genuinely playable.
Game specification:
{spec_json}
Return raw HTML only.
""".strip()
La función build_code_user_prompt convierte el diccionario GameSpec a JSON formateado y lo inserta en el prompt. El modelo usa esta descripción estructurada como briefing de diseño para generar el juego HTML final.
Como la especificación ya define mecánicas, entidades, controles y objetivos, la tarea del modelo se simplifica: solo tiene que traducir ese diseño a lógica de juego en JavaScript y a un bucle de renderizado con canvas.
En el siguiente paso implementaremos la extracción de fotogramas con OpenCV, que convierte el vídeo subido en un conjunto reducido de imágenes representativas que el modelo Qwen 3.5 puede analizar.
Los modelos locales Qwen 3.5 de Ollama aceptan texto e imágenes, no vídeo crudo. Así que, en lugar de enviar el clip directamente, extraemos un conjunto pequeño de fotogramas espaciados uniformemente y se los pasamos al modelo.
def save_uploaded_video(uploaded_file) -> Path:
    suffix = Path(uploaded_file.name).suffix or ".mp4"
    with tempfile.NamedTemporaryFile(delete=False, suffix=suffix) as tmp:
        tmp.write(uploaded_file.read())
        return Path(tmp.name)
def extract_frames(video_path: Path, max_frames: int = 6):
    cap = cv2.VideoCapture(str(video_path))
    total_frames = int(cap.get(cv2.CAP_PROP_FRAME_COUNT))
    interval = max(1, total_frames // max_frames) if total_frames > 0 else 1
    frames = []
    frame_id = 0
    while True:
        ret, frame = cap.read()
        if not ret:
            break
        if frame_id % interval == 0:
            _, buffer = cv2.imencode(".jpg", frame)
            frames.append(base64.b64encode(buffer).decode())
        frame_id += 1
        if len(frames) >= max_frames:
            break
    cap.release()
    return frames
def extract_json_block(text: str) -> str:
    start = text.find("{")
    end = text.rfind("}")
    if start == -1 or end == -1 or end <= start:
        raise ValueError("No valid JSON object found in model response.")
    return text[start : end + 1]
def cleanup_html_response(text: str) -> str:
    html = text.strip()
    if html.startswith("```"):
        lines = html.splitlines()
        if lines and lines[0].startswith("```"):
            lines = lines[1:]
        if lines and lines[-1].startswith("```"):
            lines = lines[:-1]
        html = "\n".join(lines).strip()
    return html
def patch_html_for_iframe_keyboard(html: str) -> str:
    if 'tabindex="0"' not in html and "<canvas" in html:
        html = html.replace("<canvas", '<canvas tabindex="0"', 1)
    focus_patch = """
<script>
(function() {
  const canvas = document.querySelector("canvas");
  if (!canvas) return;
  if (!canvas.hasAttribute("tabindex")) {
    canvas.setAttribute("tabindex", "0");
  }
  function focusGame() {
    try { canvas.focus(); } catch (e) {}
  }
  window.addEventListener("load", focusGame);
  canvas.addEventListener("click", focusGame);
  document.addEventListener("keydown", function(e) {
    if (["ArrowUp","ArrowDown","ArrowLeft","ArrowRight"," "].includes(e.key)) {
      e.preventDefault();
    }
  }, { passive: false });
  const buttons = document.querySelectorAll("button");
  buttons.forEach(btn => {
    btn.addEventListener("click", () => {
      setTimeout(focusGame, 50);
    });
  });
})();
</script>
"""
    if "</body>" in html:
        html = html.replace("</body>", focus_patch + "\n</body>")
    else:
        html += focus_patch
    return html
Estas utilidades definen cinco componentes clave para extraer fotogramas representativos del vídeo subido:
save_uploaded_video() guarda el vídeo de gameplay subido como archivo temporal en disco. Como Streamlit sube los archivos en memoria, escribirlo en disco permite que OpenCV lo lea eficientemente durante la extracción de fotogramas, conservando la extensión original.extract_frames() carga el vídeo con OpenCV y toma un pequeño número de fotogramas espaciados uniformemente a lo largo de su duración. En lugar de procesar cada fotograma, calcula un intervalo de muestreo y extrae fotogramas representativos que capturan el gameplay. Cada fotograma se codifica como JPEG y se convierte a una cadena base64 para poder enviarlo directamente como entrada de imagen al modelo multimodal Qwen.extract_json_block() garantiza que la salida del modelo se pueda analizar correctamente. El contenido extraído se valida después contra el esquema GameSpec.cleanup_html_response() elimina formato markdown que el modelo puede incluir al generar código. Si el modelo envuelve la salida HTML en triple backticks, este helper los elimina para que el HTML pueda renderizarse directamente en la previsualización de Streamlit.patch_html_for_iframe_keyboard() inyecta un pequeño parche JavaScript en el HTML generado para asegurar que los controles de teclado funcionen correctamente dentro del iframe de Streamlit. Enfoca automáticamente el canvas, asigna un tabindex si falta y evita que el navegador intercepte las flechas y la barra espaciadora para usarlas como controles del juego.En conjunto, estas utilidades forman la capa de preprocesado de vídeo y manejo de respuestas de la canalización.
Con los fotogramas extraídos y las plantillas de prompts listas, podemos implementar la primera etapa de la canalización de razonamiento: convertir los fotogramas de gameplay en una especificación de juego estructurada.
def infer_game_spec(video_path: Path, game_hint: str, extra_constraints: str, max_frames: int) -> dict:
    frames = extract_frames(video_path, max_frames=max_frames)
    prompt = build_spec_user_prompt(game_hint, extra_constraints, max_frames)
    response = ollama.chat(
        model="qwen3.5:9b",
        messages=[
            {
                "role": "system",
                "content": SPEC_SYSTEM_PROMPT,
            },
            {
                "role": "user",
                "content": prompt,
                "images": frames,
            },
        ],
        options={
            "temperature": 0.1,
            "num_ctx": 8192,
        },
    )
    text = response["message"]["content"]
    parsed = json.loads(extract_json_block(text))
    validated = GameSpec(**parsed)
    return validated.model_dump()
La función anterior define cuatro etapas clave en la canalización de inferencia de la especificación del juego:
extract_frames() toma un conjunto reducido de fotogramas representativos del vídeo de gameplay subido. Estas imágenes actúan como evidencia visual para que el modelo infiera las mecánicas del juego.build_spec_user_prompt() crea dinámicamente el prompt de usuario usando la pista opcional, cualquier restricción extra y el número máximo de fotogramas extraídos. Este prompt da instrucciones claras al modelo para producir una especificación conforme al esquema.ollama.chat() envía tanto el prompt de texto como los fotogramas al modelo local qwen3.5:9b. La configuración usa una temperature baja para mantener la salida determinista y num_ctx=8192 para disponer de suficiente contexto para el prompt y la respuesta estructurada.GameSpec. Por último, devuelve la especificación validada como diccionario de Python.Ya tenemos una representación estructurada del juego que el modelo ha inferido a partir de los fotogramas. En el siguiente paso usaremos esta especificación validada como entrada para la generación del juego HTML.
En este punto, el modelo ya no tiene que inferir mecánicas a partir de imágenes. En su lugar, pedimos a qwen3.5:9b que produzca un único archivo HTML autocontenido que incluya maquetación, estilos, bucle del juego, controles y lógica de renderizado.
def generate_game_html(game_spec: dict) -> str:
    response = ollama.chat(
        model="qwen3.5:9b",
        messages=[
            {
                "role": "system",
                "content": CODE_SYSTEM_PROMPT,
            },
            {
                "role": "user",
                "content": build_code_user_prompt(game_spec),
            },
        ],
        options={
            "temperature": 0.2,
            "num_ctx": 8192,
        },
    )
    text = response["message"]["content"]
    html = cleanup_html_response(text)
    if "<html" not in html.lower():
        raise ValueError("Model did not return HTML")
    return patch_html_for_iframe_keyboard(html)
La función anterior realiza cuatro pasos para generar y preparar el juego HTML final:
game_spec validado y lo pasa a build_code_user_prompt(). Esto convierte la especificación del juego en un prompt de implementación detallado que instruye al modelo para generar un juego completo en un único archivo HTML.ollama.chat() envía el system prompt de generación de código y el prompt de usuario al modelo local qwen3.5:9b. Como la tarea ahora es solo generación de código, no de razonamiento multimodal, el modelo solo recibe texto. cleanup_html_response() para eliminar cualquier markdown o formato adicional. Luego comprobamos de forma sencilla que la salida contenga un documento HTML.patch_html_for_iframe_keyboard(), que inyecta un pequeño ajuste JavaScript para que el juego sea jugable dentro del iframe incrustado de Streamlit. Este paso es importante porque los juegos en navegador a menudo no capturan correctamente las flechas y la barra espaciadora si el canvas no es enfocables y no se enfoca automáticamente.Ya tenemos un juego HTML jugable en el navegador generado íntegramente a partir de la especificación inferida.
Como último paso, vamos a envolverlo todo en una interfaz sencilla de Streamlit para que cualquiera pueda probar el sistema sin tocar el código. La interfaz expone tres capacidades principales:
st.set_page_config(page_title="Qwen 3.5 9B (Ollama) - Video to Game", layout="wide")
st.title("Qwen 3.5 9B: Gameplay Video to Playable HTML Game")
st.write(
    "This local demo uses Ollama with qwen3.5:9b to turn a short gameplay clip "
    "into a minimal browser game."
)
with st.sidebar:
    st.header("Local generation settings")
    game_hint = st.text_input("Optional game hint", value="Simple Pong-like arcade game")
    extra_constraints = st.text_area(
        "Extra constraints",
        value="Keep the game extremely simple and easy to play with arrow keys or space bar.",
        height=120,
    )
    max_frames = st.slider("Frames extracted from video", 3, 8, 5)
uploaded_video = st.file_uploader(
    "Upload gameplay video",
    type=["mp4", "mov", "avi", "mkv", "webm"],
)
if "local_game_spec" not in st.session_state:
    st.session_state.local_game_spec = None
if "local_game_html" not in st.session_state:
    st.session_state.local_game_html = None
if uploaded_video is not None:
    video_path = save_uploaded_video(uploaded_video)
    col1, col2 = st.columns([1, 1])
    with col1:
        st.subheader("Uploaded video")
        st.video(str(video_path))
    with col2:
        st.subheader("Run local pipeline")
        if st.button("Generate game", type="primary"):
            try:
                with st.spinner("Extracting frames and inferring game mechanics (local model)..."):
                    game_spec = infer_game_spec(
                        video_path=video_path,
                        game_hint=game_hint,
                        extra_constraints=extra_constraints,
                        max_frames=max_frames,
                    )
                    st.session_state.local_game_spec = game_spec
                with st.spinner("Generating HTML game code with qwen3.5:9b..."):
                    game_html = generate_game_html(game_spec)
                    st.session_state.local_game_html = game_html
                    (OUTPUT_DIR / "local_game_spec.json").write_text(
                        json.dumps(game_spec, indent=2),
                        encoding="utf-8",
                    )
                    (OUTPUT_DIR / "local_generated_game.html").write_text(
                        game_html,
                        encoding="utf-8",
                    )
                st.success("Local game generated.")
            except ValidationError as e:
                st.error(f"Schema validation failed: {e}")
            except Exception as e:
                st.error(f"Local generation failed: {e}")
if st.session_state.local_game_spec:
    st.subheader("Inferred game spec")
    st.json(st.session_state.local_game_spec)
if st.session_state.local_game_html:
    tab1, tab2, tab3 = st.tabs(["Preview", "HTML Code", "Downloads"])
    with tab1:
        st.subheader("Playable preview")
        st.caption(
            "Click START GAME, then click once inside the game canvas so it captures keyboard input."
        )
        components.html(
            st.session_state.local_game_html,
            height=760,
            scrolling=False,
        )
    with tab2:
        st.subheader("Generated HTML (local)")
        st.code(st.session_state.local_game_html, language="html")
    with tab3:
        st.subheader("Download files (local)")
        st.download_button(
            label="Download HTML game (local)",
            data=st.session_state.local_game_html,
            file_name="local_generated_game.html",
            mime="text/html",
        )
        st.download_button(
            label="Download JSON spec (local)",
            data=json.dumps(st.session_state.local_game_spec, indent=2),
            file_name="local_game_spec.json",
            mime="application/json",
        )
El código anterior define cómo el usuario sube un clip de gameplay, aporta opcionalmente una pista sobre el tipo de juego y controla cuántos fotogramas deben extraerse del vídeo para su análisis. Una vez subido el vídeo, la app lo muestra junto a un botón Generate game que lanza toda la canalización.
Cuando el usuario ejecuta la canalización, la app primero extrae fotogramas e infiere las mecánicas con el modelo local qwen3.5:9b, produciendo una especificación de juego estructurada. En la segunda etapa, el modelo genera a partir de esa especificación un juego HTML completo. Los resultados se guardan en el estado de sesión de Streamlit para que persistan entre actualizaciones de la UI.
Cuando termina la generación, la interfaz muestra la especificación inferida, una previsualización jugable del juego generado, el HTML en bruto y botones para descargar tanto el juego HTML como la especificación JSON.
Para probarlo tú mismo, guarda el código como app.py y lanza:
streamlit run app.py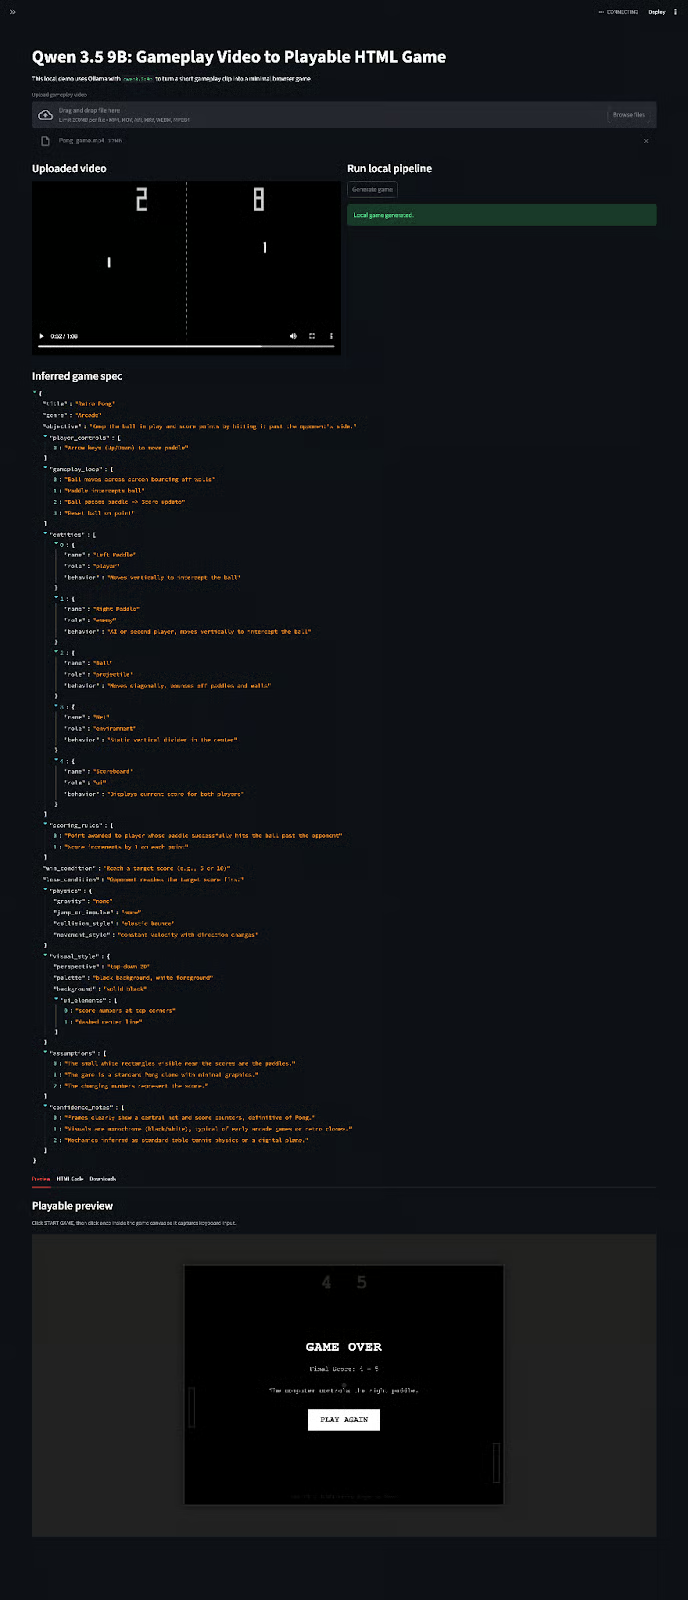
Qwen 3.5 es una de las familias de modelos multimodales más interesantes ahora mismo. En este tutorial, usamos qwen3.5:9b a través de Ollama para crear un generador totalmente local que convierte un vídeo de gameplay en un juego. La app extrae fotogramas de un clip corto, infiere un diseño de juego estructurado, genera un juego en un único archivo y lo previsualiza en Streamlit.
El modelo alojado qwen/qwen3.5-397b-a17b sigue siendo la opción más rápida y potente para esta tarea, pero el resultado con el 9B local es muy meritorio. Demuestra que un modelo multimodal pequeño ya puede hacer razonamiento visual y generación de código útiles en hardware de consumo.
Si quieres ir más allá, compara 9B con los modelos 4B y 27B, añade un bucle de refinamiento o convierte la salida en un mini motor que admita múltiples iteraciones a partir del mismo clip.
Top DataCamp Courses
Curso
Curso
Curso
blog
Abid Ali Awan
10 min
Tutorial
Ryan Ong
12 min
Tutorial
Zoumana Keita
15 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Abid Ali Awan
11 min
Tutorial
Abid Ali Awan
12 min