Curso
Desenvolvimento de Software com o Cursor
1 h 30 min
4.2K
Qwen 3.5 é uma família de modelos multimodais projetada para cobrir uma ampla gama de cenários de implantação, de modelos leves para edge a sistemas de raciocínio em larga escala.
A linha oficial do Qwen 3.5 atualmente inclui variantes 0.8B, 2B, 4B, 9B, 27B, 35B-A3B, 122B-A10B e 397B-A17B, além de checkpoints base e quantizados para alguns modelos.
A escolha do modelo small certo depende do tipo de workflow que você quer construir.
Para este tutorial, usamos o modelo qwen3.5:9b, que oferece um ótimo equilíbrio entre capacidade, facilidade de implantação local e raciocínio multimodal, sendo ideal para construir um pipeline de frames de vídeo para jogo no navegador sem depender de APIs externas.
Você também pode ler nosso guia sobre como rodar o Qwen3.5 localmente em uma única GPU.
Também testei este demo com o modelo qwen/qwen3.5-397b-a17b. Embora esse modelo seja significativamente maior e, em geral, mais capaz do que a variante local 9B, ele requer inferência via API, o que introduz dependências externas e possível latência.
Na prática, se o tempo de execução não for uma restrição rígida, o tempo total de geração diferiu em cerca de ~3 minutos entre os dois modelos nos meus testes. O modelo maior produziu uma lógica de gameplay um pouco mais fluida e uma experiência de preview mais polida, mas a melhoria não foi dramática.
Considerando que o modelo 9B roda totalmente local, os resultados são surpreendentemente competitivos. Apesar de ser muito menor, ele é capaz de gerar jogos jogáveis no navegador com apenas uma queda modesta de qualidade em comparação com o modelo 397B, muito maior.
Você pode ler nosso guia completo sobre fine-tuning do Qwen3.5 small para saber mais sobre como tirar o máximo da variante 0.8B.
Nesta seção, vamos criar um app em Streamlit que:
qwen3.5:9b via OllamaEssa configuração destaca as capacidades multimodais do Qwen para tarefas como engenharia reversa de lógica a partir de vídeos de gameplay e transformação disso em código
Antes de construir o aplicativo, precisamos preparar um ambiente local com as bibliotecas necessárias para processamento de vídeo, inferência multimodal e a interface interativa.
pip install streamlit opencv-python ollama python-dotenv pydanticO demo usa um conjunto enxuto de bibliotecas Python:
Streamlit para construir a interface web interativa onde os usuários enviam vídeos de gameplay e pré-visualizam os jogos gerados.OpenCV para decodificar o vídeo enviado e extrair frames representativos.Ollama para executar o modelo local Qwen 3.5 para raciocínio multimodal e geração de código.python-dotenv para gerenciar variáveis de ambiente, se necessário.Pydantic para impor um esquema estruturado à especificação de jogo inferida antes de gerar o código.Em seguida, precisamos baixar o próprio modelo. O Ollama facilita isso ao puxar o modelo diretamente do seu registry:
ollama run qwen3.5:9bA primeira execução baixa o modelo e o armazena localmente. O qwen3.5:9B tem aproximadamente 6,6 GB, aceita entradas de texto e imagem e oferece uma janela de contexto de 256K tokens, o que o torna bem adequado para workflows multimodais.
Com o ambiente local pronto, o próximo passo é importar as bibliotecas que usaremos no aplicativo e criar uma pasta para armazenar os artefatos gerados.
import json
import base64
import tempfile
from pathlib import Path
from typing import List
import cv2
import ollama
import streamlit as st
import streamlit.components.v1 as components
from pydantic import BaseModel, Field, ValidationError
OUTPUT_DIR = Path("outputs_local")
OUTPUT_DIR.mkdir(exist_ok=True)
O bloco acima reúne o stack central do projeto. Usamos json para formatar a especificação de jogo estruturada, base64 para codificar os frames extraídos antes de enviá-los ao modelo e tempfile para salvar com segurança os vídeos enviados durante a sessão. Path, de pathlib, nos dá uma forma limpa de gerenciar caminhos de arquivos, enquanto List, de typing, é usado para hints de tipo nas definições de esquema.
Depois, importamos as bibliotecas principais do aplicativo: cv2, do OpenCV, é responsável por ler o clipe de gameplay enviado e extrair frames representativos; ollama é a interface usada para se comunicar com o modelo local qwen3.5:9b. streamlit fornece a interface web, e streamlit.components.v1 permite incorporar o jogo HTML gerado diretamente no app para preview e interação ao vivo.
Por fim, importamos BaseModel, Field e ValidationError do Pydantic. Eles são usados para definir e validar o esquema JSON estruturado que representa o design de jogo inferido. Em vez de confiar que o modelo retorne texto pouco estruturado, forçamos a saída a seguir um esquema previsível antes de passá-la ao gerador do jogo em HTML.
As duas últimas linhas criam um diretório outputs_local caso ele ainda não exista. É nessa pasta que salvamos artefatos gerados, como a especificação de jogo inferida e o arquivo HTML final do jogo, facilitando a inspeção ou download dos resultados após cada execução.
No próximo passo, vamos definir as classes de esquema do Pydantic que descrevem a especificação de jogo que o modelo deve gerar a partir dos frames de gameplay extraídos.
Nesta etapa, definimos o esquema estruturado que o modelo deve seguir ao descrever as mecânicas de gameplay inferidas a partir dos frames do vídeo.
Em vez de pedir que o modelo gere diretamente código HTML a partir das imagens, primeiro exigimos que ele produza uma especificação de jogo estruturada. Essa representação intermediária torna o pipeline muito mais fácil de depurar, validar e estender.
class Entity(BaseModel):
    name: str
    role: str
    behavior: str
class Physics(BaseModel):
    gravity: str = ""
    jump_or_impulse: str = ""
    collision_style: str = ""
    movement_style: str = ""
class VisualStyle(BaseModel):
    perspective: str = ""
    palette: str = ""
    background: str = ""
    ui_elements: List[str] = Field(default_factory=list)
class GameSpec(BaseModel):
    title: str
    genre: str
    objective: str
    player_controls: List[str]
    gameplay_loop: List[str]
    entities: List[Entity]
    scoring_rules: List[str]
    win_condition: str
    lose_condition: str
    physics: Physics
    visual_style: VisualStyle
    assumptions: List[str]
    confidence_notes: List[str]
Esse esquema define a estrutura central da especificação de jogo que o modelo deve gerar.
Entity representa qualquer objeto presente no jogo, como o jogador, inimigos, obstáculos ou elementos de UI. Cada entidade inclui um nome, seu papel no jogo e uma breve descrição de seu comportamento.Physics descreve como os objetos se movem e interagem no mundo do jogo. Esses campos capturam mecânicas básicas como gravidade, impulso/pulo, tratamento de colisões e padrões de movimento.VisualStyle captura a apresentação visual do jogo. Isso inclui a perspectiva da câmera (como top-down ou side-scrolling), a paleta de cores, o estilo de fundo e quaisquer elementos de UI visíveis, como contadores de pontuação ou indicadores de vida.GameSpec reúne tudo. Ela representa o design completo do jogo inferido a partir dos frames, incluindo objetivo, controles, loop de gameplay, entidades, sistema de pontuação, condições de vitória/derrota e suposições feitas pelo modelo ao interpretar os frames.Ao validar a saída do modelo contra esse esquema, garantimos que o design inferido siga sempre uma estrutura previsível. Isso também facilita muito passar a especificação para a próxima etapa do pipeline.
Com o esquema pronto, o próximo passo é definir os prompts que orientam o modelo pelas duas etapas do nosso pipeline.
A primeira etapa foca em fazer engenharia reversa das mecânicas de gameplay a partir dos frames extraídos e produzir uma especificação de jogo estruturada.
A segunda etapa pega essa especificação e gera um jogo jogável no navegador usando HTML, CSS e JavaScript.
O primeiro componente da nossa estratégia de prompting são os system prompts, que definem o papel que o modelo deve desempenhar em cada etapa do pipeline.
SPEC_SYSTEM_PROMPT = """
You are an expert arcade game designer and gameplay reverse-engineering analyst.
You observe a few frames from a gameplay video and infer the smallest possible playable browser-game clone.
The gameplay is likely a simple arcade game like Pong, Breakout, Snake, or Flappy Bird.
Prefer these mechanics if uncertain.
Rules:
- Only infer mechanics that are strongly supported by visual evidence.
- Prefer a minimal playable prototype over a complex clone.
- Do not invent advanced systems unless clearly visible.
- Keep the result suitable for plain HTML5 canvas and JavaScript.
- Return strict JSON only.
- No markdown.
- No code fences.
""".strip()
CODE_SYSTEM_PROMPT = """
You are a senior JavaScript game developer.
Generate a complete single-file HTML game.
Requirements:
- Return raw HTML only.
- No markdown.
- No code fences.
- Use plain HTML, CSS, and JavaScript only.
- Use HTML5 canvas unless there is a strong reason not to.
- Keep the game simple, playable, and self-contained.
- No external libraries, no CDNs, no external assets.
- Use simple shapes/colors instead of images.
- Include score.
- Include restart support.
- Include instructions on screen.
- Keep keyboard controls simple.
- Make the game playable inside an iframe preview.
- IMPORTANT: the canvas must have tabindex="0".
- IMPORTANT: keyboard input must work inside an embedded iframe.
- IMPORTANT: focus the canvas automatically on load, on canvas click, and after pressing Start/Restart buttons.
- IMPORTANT: prevent default browser behavior for arrow keys and spacebar.
""".strip()
O primeiro system prompt instrui o modelo a se comportar como um analista de gameplay. Ele enfatiza suposições mínimas e incentiva o modelo a inferir apenas as mecânicas fortemente suportadas pelos frames.
Como o modelo vê apenas um pequeno número de imagens amostradas, o prompt o direciona explicitamente para jogos simples no estilo arcade que podem ser implementados com lógica leve de navegador.
O segundo system prompt muda o papel do modelo para desenvolvedor JavaScript. Nessa etapa, o modelo recebe uma especificação de jogo estruturada e é responsável por convertê-la em um jogo HTML completo.
Em seguida, definimos uma função auxiliar que constrói o prompt do usuário para a primeira etapa do pipeline. Esse prompt pede que o modelo analise os frames extraídos e produza uma especificação de jogo estruturada.
def build_spec_user_prompt(game_hint: str, extra_constraints: str, max_frames: int) -> str:
    return f"""
You are given a few still frames extracted from a gameplay video.
From these frames, infer a minimal, playable browser game design.
Use very simple 2D arcade-style mechanics.
If you are unsure, bias toward Pong / Breakout / Snake / Flappy Bird style games.
Output valid JSON with exactly this schema:
{{
  "title": "string",
  "genre": "string",
  "objective": "string",
  "player_controls": ["string"],
  "gameplay_loop": ["string"],
  "entities": [
    {{
      "name": "string",
      "role": "player|enemy|obstacle|projectile|ui|environment",
      "behavior": "string"
    }}
  ],
  "scoring_rules": ["string"],
  "win_condition": "string",
  "lose_condition": "string",
  "physics": {{
    "gravity": "string",
    "jump_or_impulse": "string",
    "collision_style": "string",
    "movement_style": "string"
  }},
  "visual_style": {{
    "perspective": "string",
    "palette": "string",
    "background": "string",
    "ui_elements": ["string"]
  }},
  "assumptions": ["string"],
  "confidence_notes": ["string"]
}}
Important:
- Only infer the simplest mechanics needed for a playable clone.
- Prefer a very simple game that can be rebuilt in one HTML file.
- Avoid menus, accounts, audio, networking, cutscenes, or multi-level progression.
Optional game hint from user:
{game_hint or "None"}
Extra constraints:
{extra_constraints or "None"}
You are seeing at most {max_frames} frames from the video, so stay simple and conservative.
Return JSON only.
""".strip()
Essa função constrói o prompt que será enviado ao modelo junto com os frames extraídos do vídeo. Ela inclui vários elementos importantes:
GameSpecAo incorporar o esquema diretamente no prompt, incentivamos o modelo a produzir uma saída que pode ser validada pelo Pydantic na próxima etapa do pipeline.
Quando a especificação do jogo estiver gerada e validada, precisamos de um segundo prompt para converter essa especificação em um jogo realmente jogável.
def build_code_user_prompt(game_spec: dict) -> str:
    spec_json = json.dumps(game_spec, indent=2)
    return f"""
Using the following game specification, generate a complete single-file HTML game.
Requirements:
- One self-contained HTML file.
- Inline CSS and inline JavaScript.
- Must be playable in a browser.
- Must render correctly in an iframe.
- Show score on screen.
- Show controls on screen.
- Add restart support using a button or key.
- Keep visuals simple and robust.
- Use requestAnimationFrame.
- Use canvas for gameplay rendering.
- No external assets.
- Make the game small but genuinely playable.
Game specification:
{spec_json}
Return raw HTML only.
""".strip()
A função build_code_user_prompt converte o dicionário GameSpec em JSON formatado e o insere no prompt. O modelo então usa essa descrição estruturada como briefing de design para gerar o jogo HTML final.
Como a especificação já define mecânicas, entidades, controles e objetivos, a tarefa do modelo fica bem mais simples. Ele só precisa traduzir esse design em lógica de jogo em JavaScript e um loop de renderização baseado em canvas.
No próximo passo, vamos implementar o pipeline de extração de frames com OpenCV, que converte o vídeo de gameplay enviado em um pequeno conjunto de imagens representativas que podem ser analisadas pelo modelo Qwen 3.5.
Os modelos locais Qwen 3.5 do Ollama aceitam texto e imagens, não vídeo bruto. Então, em vez de enviar o clipe diretamente, extraímos um pequeno conjunto de frames espaçados uniformemente e os passamos ao modelo.
def save_uploaded_video(uploaded_file) -> Path:
    suffix = Path(uploaded_file.name).suffix or ".mp4"
    with tempfile.NamedTemporaryFile(delete=False, suffix=suffix) as tmp:
        tmp.write(uploaded_file.read())
        return Path(tmp.name)
def extract_frames(video_path: Path, max_frames: int = 6):
    cap = cv2.VideoCapture(str(video_path))
    total_frames = int(cap.get(cv2.CAP_PROP_FRAME_COUNT))
    interval = max(1, total_frames // max_frames) if total_frames > 0 else 1
    frames = []
    frame_id = 0
    while True:
        ret, frame = cap.read()
        if not ret:
            break
        if frame_id % interval == 0:
            _, buffer = cv2.imencode(".jpg", frame)
            frames.append(base64.b64encode(buffer).decode())
        frame_id += 1
        if len(frames) >= max_frames:
            break
    cap.release()
    return frames
def extract_json_block(text: str) -> str:
    start = text.find("{")
    end = text.rfind("}")
    if start == -1 or end == -1 or end <= start:
        raise ValueError("No valid JSON object found in model response.")
    return text[start : end + 1]
def cleanup_html_response(text: str) -> str:
    html = text.strip()
    if html.startswith("```"):
        lines = html.splitlines()
        if lines and lines[0].startswith("```"):
            lines = lines[1:]
        if lines and lines[-1].startswith("```"):
            lines = lines[:-1]
        html = "\n".join(lines).strip()
    return html
def patch_html_for_iframe_keyboard(html: str) -> str:
    if 'tabindex="0"' not in html and "<canvas" in html:
        html = html.replace("<canvas", '<canvas tabindex="0"', 1)
    focus_patch = """
<script>
(function() {
  const canvas = document.querySelector("canvas");
  if (!canvas) return;
  if (!canvas.hasAttribute("tabindex")) {
    canvas.setAttribute("tabindex", "0");
  }
  function focusGame() {
    try { canvas.focus(); } catch (e) {}
  }
  window.addEventListener("load", focusGame);
  canvas.addEventListener("click", focusGame);
  document.addEventListener("keydown", function(e) {
    if (["ArrowUp","ArrowDown","ArrowLeft","ArrowRight"," "].includes(e.key)) {
      e.preventDefault();
    }
  }, { passive: false });
  const buttons = document.querySelectorAll("button");
  buttons.forEach(btn => {
    btn.addEventListener("click", () => {
      setTimeout(focusGame, 50);
    });
  });
})();
</script>
"""
    if "</body>" in html:
        html = html.replace("</body>", focus_patch + "\n</body>")
    else:
        html += focus_patch
    return html
As utilidades acima definem cinco componentes essenciais para extrair frames representativos do vídeo enviado:
save_uploaded_video() armazena o vídeo de gameplay enviado como um arquivo temporário em disco. Como o Streamlit envia arquivos em memória, gravar o arquivo em disco permite que o OpenCV o leia com eficiência durante a extração de frames, preservando a extensão original.extract_frames() carrega o vídeo com OpenCV e amostra um pequeno número de frames espaçados uniformemente ao longo da duração. Em vez de processar todos os frames, a função calcula um intervalo de amostragem e extrai frames representativos que capturam o gameplay. Cada frame é codificado como JPEG e convertido em string base64 para ser enviado diretamente como entrada de imagem ao modelo multimodal Qwen.extract_json_block() garante que a saída do modelo possa ser analisada corretamente. O conteúdo extraído pode então ser validado com segurança contra o esquema GameSpec.cleanup_html_response() remove formatação em markdown que o modelo pode incluir ao gerar código. Se o modelo envolver o HTML em cercas de código com crases triplas, essa função remove esses marcadores para que o HTML possa ser renderizado diretamente no preview do Streamlit.patch_html_for_iframe_keyboard() injeta um pequeno patch de JavaScript no HTML gerado para garantir que os controles de teclado funcionem corretamente dentro do iframe do Streamlit. Ela foca automaticamente o elemento canvas, atribui um tabindex se estiver faltando e impede que o navegador intercepte as setas e a barra de espaço, permitindo usá-las como controles do jogo.Juntas, essas utilidades formam a camada de pré-processamento de vídeo e de tratamento de respostas do pipeline.
Agora que temos os frames extraídos e os templates de prompt prontos, podemos implementar a primeira etapa do pipeline de raciocínio, ou seja, converter os frames do gameplay em uma especificação de jogo estruturada.
def infer_game_spec(video_path: Path, game_hint: str, extra_constraints: str, max_frames: int) -> dict:
    frames = extract_frames(video_path, max_frames=max_frames)
    prompt = build_spec_user_prompt(game_hint, extra_constraints, max_frames)
    response = ollama.chat(
        model="qwen3.5:9b",
        messages=[
            {
                "role": "system",
                "content": SPEC_SYSTEM_PROMPT,
            },
            {
                "role": "user",
                "content": prompt,
                "images": frames,
            },
        ],
        options={
            "temperature": 0.1,
            "num_ctx": 8192,
        },
    )
    text = response["message"]["content"]
    parsed = json.loads(extract_json_block(text))
    validated = GameSpec(**parsed)
    return validated.model_dump()
A função acima define quatro etapas-chave no pipeline de inferência da especificação do jogo:
extract_frames() amostra um pequeno conjunto de frames representativos do vídeo de gameplay enviado. Essas imagens funcionam como evidências visuais que o modelo usará para inferir as mecânicas do jogo.build_spec_user_prompt() cria dinamicamente o prompt do usuário usando a dica opcional, quaisquer restrições extras e o número máximo de frames extraídos. Esse prompt fornece ao modelo uma instrução clara para produzir uma especificação de jogo compatível com o esquema.ollama.chat() envia tanto o prompt de texto quanto os frames extraídos ao modelo local qwen3.5:9b. As configurações de geração usam temperature baixa para manter a saída determinística e num_ctx=8192 para oferecer espaço de contexto suficiente para o prompt e a resposta estruturada.GameSpec. Por fim, a especificação validada é retornada como um dicionário Python.Agora temos uma representação estruturada do jogo que o modelo inferiu a partir dos frames amostrados do vídeo. No próximo passo, usaremos essa especificação validada como entrada para a etapa de geração do jogo em HTML.
Neste ponto, o modelo não precisa mais inferir mecânicas a partir de imagens. Em vez disso, pedimos ao qwen3.5:9b que produza um único arquivo HTML autocontido que inclui layout, estilos, game loop, controles e lógica de renderização.
def generate_game_html(game_spec: dict) -> str:
    response = ollama.chat(
        model="qwen3.5:9b",
        messages=[
            {
                "role": "system",
                "content": CODE_SYSTEM_PROMPT,
            },
            {
                "role": "user",
                "content": build_code_user_prompt(game_spec),
            },
        ],
        options={
            "temperature": 0.2,
            "num_ctx": 8192,
        },
    )
    text = response["message"]["content"]
    html = cleanup_html_response(text)
    if "<html" not in html.lower():
        raise ValueError("Model did not return HTML")
    return patch_html_for_iframe_keyboard(html)
A função acima realiza quatro etapas para gerar e preparar o jogo HTML final:
game_spec validado e o passa para build_code_user_prompt(). Isso converte a especificação do jogo em um prompt de implementação detalhado que instrui o modelo a gerar um jogo HTML completo em arquivo único.ollama.chat() envia o system prompt de geração de código e o prompt do usuário ao modelo local qwen3.5:9b. Como a tarefa agora é apenas geração de código, e não raciocínio multimodal, o modelo recebe apenas texto. cleanup_html_response() para remover qualquer markdown ou formatação extra. Depois, fazemos uma checagem simples para confirmar que a saída contém um documento HTML.patch_html_for_iframe_keyboard(), que injeta um pequeno ajuste em JavaScript para tornar o jogo jogável dentro do iframe incorporado do Streamlit. Essa etapa é importante porque jogos de navegador frequentemente não capturam corretamente as setas e a barra de espaço, a menos que o canvas seja explicitamente focalizável e receba foco automaticamente.Agora temos um jogo em HTML jogável no navegador, gerado inteiramente a partir da especificação de jogo inferida.
Como etapa final, vamos empacotar tudo em uma interface simples no Streamlit, para que os usuários possam testar o sistema sem mexer no código. A interface expõe três capacidades principais:
st.set_page_config(page_title="Qwen 3.5 9B (Ollama) - Video to Game", layout="wide")
st.title("Qwen 3.5 9B: Gameplay Video to Playable HTML Game")
st.write(
    "This local demo uses Ollama with qwen3.5:9b to turn a short gameplay clip "
    "into a minimal browser game."
)
with st.sidebar:
    st.header("Local generation settings")
    game_hint = st.text_input("Optional game hint", value="Simple Pong-like arcade game")
    extra_constraints = st.text_area(
        "Extra constraints",
        value="Keep the game extremely simple and easy to play with arrow keys or space bar.",
        height=120,
    )
    max_frames = st.slider("Frames extracted from video", 3, 8, 5)
uploaded_video = st.file_uploader(
    "Upload gameplay video",
    type=["mp4", "mov", "avi", "mkv", "webm"],
)
if "local_game_spec" not in st.session_state:
    st.session_state.local_game_spec = None
if "local_game_html" not in st.session_state:
    st.session_state.local_game_html = None
if uploaded_video is not None:
    video_path = save_uploaded_video(uploaded_video)
    col1, col2 = st.columns([1, 1])
    with col1:
        st.subheader("Uploaded video")
        st.video(str(video_path))
    with col2:
        st.subheader("Run local pipeline")
        if st.button("Generate game", type="primary"):
            try:
                with st.spinner("Extracting frames and inferring game mechanics (local model)..."):
                    game_spec = infer_game_spec(
                        video_path=video_path,
                        game_hint=game_hint,
                        extra_constraints=extra_constraints,
                        max_frames=max_frames,
                    )
                    st.session_state.local_game_spec = game_spec
                with st.spinner("Generating HTML game code with qwen3.5:9b..."):
                    game_html = generate_game_html(game_spec)
                    st.session_state.local_game_html = game_html
                    (OUTPUT_DIR / "local_game_spec.json").write_text(
                        json.dumps(game_spec, indent=2),
                        encoding="utf-8",
                    )
                    (OUTPUT_DIR / "local_generated_game.html").write_text(
                        game_html,
                        encoding="utf-8",
                    )
                st.success("Local game generated.")
            except ValidationError as e:
                st.error(f"Schema validation failed: {e}")
            except Exception as e:
                st.error(f"Local generation failed: {e}")
if st.session_state.local_game_spec:
    st.subheader("Inferred game spec")
    st.json(st.session_state.local_game_spec)
if st.session_state.local_game_html:
    tab1, tab2, tab3 = st.tabs(["Preview", "HTML Code", "Downloads"])
    with tab1:
        st.subheader("Playable preview")
        st.caption(
            "Click START GAME, then click once inside the game canvas so it captures keyboard input."
        )
        components.html(
            st.session_state.local_game_html,
            height=760,
            scrolling=False,
        )
    with tab2:
        st.subheader("Generated HTML (local)")
        st.code(st.session_state.local_game_html, language="html")
    with tab3:
        st.subheader("Download files (local)")
        st.download_button(
            label="Download HTML game (local)",
            data=st.session_state.local_game_html,
            file_name="local_generated_game.html",
            mime="text/html",
        )
        st.download_button(
            label="Download JSON spec (local)",
            data=json.dumps(st.session_state.local_game_spec, indent=2),
            file_name="local_game_spec.json",
            mime="application/json",
        )
O código acima define como o usuário envia um clipe de gameplay, opcionalmente fornece uma dica sobre o tipo de jogo e controla quantos frames devem ser extraídos do vídeo para análise. Assim que um vídeo é enviado, o app o exibe ao lado de um botão Generate game, que dispara o pipeline completo.
Quando o usuário executa o pipeline, o app primeiro extrai frames e infere as mecânicas do jogo usando o modelo local qwen3.5:9b, produzindo uma especificação de jogo estruturada. Na segunda etapa, o modelo gera um jogo HTML completo a partir dessa especificação. Os resultados são armazenados no estado da sessão do Streamlit para persistirem entre atualizações da UI.
Após o término da geração, a interface exibe a especificação inferida do jogo, um preview jogável do jogo gerado, o código-fonte HTML bruto e botões de download para salvar tanto o jogo em HTML quanto a especificação em JSON.
Para testar por conta própria, salve o código como app.py e execute:
streamlit run app.py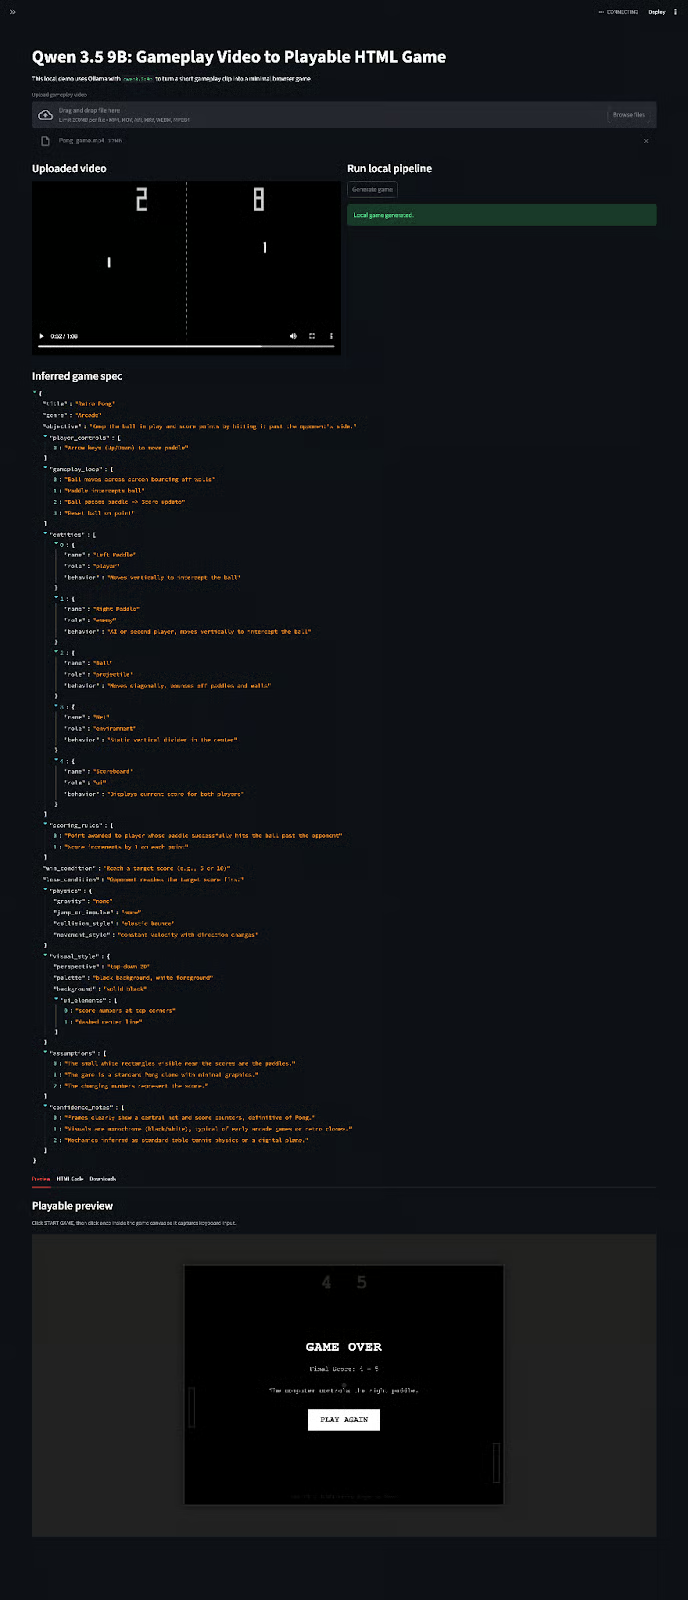
Qwen 3.5 é uma das famílias de modelos multimodais mais interessantes disponíveis hoje. Neste tutorial, usamos o qwen3.5:9b via Ollama para construir um gerador totalmente local de vídeo de gameplay para jogo. O app extrai frames de um clipe curto, infere um design de jogo estruturado, gera um jogo para navegador em arquivo único e o pré-visualiza no Streamlit.
O modelo hospedado qwen/qwen3.5-397b-a17b ainda é a opção mais rápida e mais forte para esta tarefa, mas o resultado local com 9B é impressionante por si só. Ele prova que um modelo multimodal pequeno já consegue executar raciocínio visual significativo e gerar código em hardware de consumidor.
Se quiser ir além, compare 9B com os modelos 4B e 27B, adicione um loop de refinamento ou transforme a saída em um mini game engine que suporte múltiplas iterações a partir do mesmo clipe.
Principais cursos da DataCamp
Curso
Curso
Curso
Tutorial
Ryan Ong
12 min
Tutorial
Abid Ali Awan
13 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Moez Ali
12 min
Tutorial
Josep Ferrer
11 min
Tutorial
Zoumana Keita
11 min