
Cours
Introduction à Tableau
6 h
327.4K
Comme pour les autres outils et logiciels de business intelligence, les superbes visualisations visibles dans Tableau, comme ce diagramme en cascade, reposent sur des processus robustes et intégrés en coulisses. La manière dont ces processus sont structurés constitue ce que l’on appelle l’architecture de Tableau, et c’est l’objet de ce guide complet.
Comprendre l’architecture de Tableau est essentiel pour les administrateurs serveur et les architectes de données. Les analystes de données y gagnent également : ils saisissent mieux les capacités et limites de l’outil et, en connaissant ses composants, identifient plus facilement l’origine des erreurs et leur signification.
Tableau propose plus de dix produits distincts, et ce nombre ne cesse d’augmenter. Ils se répartissent en deux grandes catégories. La première regroupe les produits orientés développement, dont Tableau Server ; la seconde rassemble les produits dédiés à la publication, dont Tableau Desktop.
Certains de ces produits partagent des interfaces similaires et des fonctionnalités qui se recoupent, mais chacun possède sa propre architecture. Bien qu’ils appartiennent à une même famille, certains ont été conçus pour fonctionner plus étroitement ensemble que d’autres. Tableau Desktop et Tableau Server en sont un exemple parlant : ce que vous créez dans Tableau Desktop est transmis à Tableau Server, où il peut être publié, stocké, géré et partagé pour collaborer.
En tant que praticien des données qui développe des rapports, Tableau Desktop est probablement la face de Tableau que vous connaissez le mieux. C’est le point de départ, installé sur votre ordinateur, où vous vous connectez à vos sources de données et créez des visualisations.
L’architecture de Tableau Desktop est relativement simple. Elle comprend trois grands composants, ou couches.
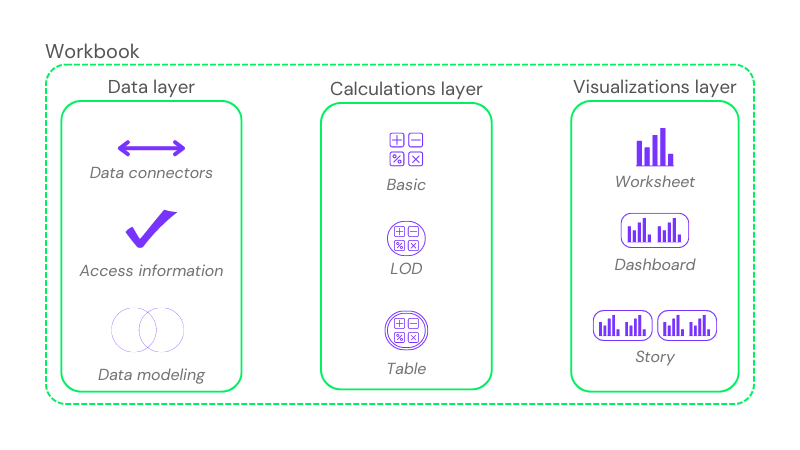 Architecture de Tableau Desktop
Examinons chacune de ces couches plus en détail.
La couche de données est l’endroit où vos données arrivent dans Tableau Desktop et se préparent pour l’analyse et la visualisation. Son fonctionnement dépend du mode de connexion retenu, car il existe deux types de connexions :
Quel que soit le type de connexion, Tableau Desktop propose 90 connecteurs pour accéder à vos données où qu’elles se trouvent, qu’il s’agisse de fichiers plats, de serveurs SQL ou de plateformes cloud de gestion documentaire.
La couche de données conserve également les informations d’accès (emplacement, identifiants) et offre des fonctions de modélisation des données, comme l’agrégation et la jointure de tables ou le changement de types de données.
Tableau dispose d’un puissant moteur de calculs qui vous permet de créer des champs personnalisés pour réaliser les analyses nécessaires à vos visualisations : agrégation, segmentation, filtrage, conversion de types, etc.
Trois grands types de calculs sont disponibles :
La couche de visualisations est l’endroit où vous créez, personnalisez et mettez en forme vos graphiques. Autrement dit, c’est là que tout se joue. Elle s’appuie sur trois structures hiérarchiques propres à Tableau pour construire vos visuels.
Ces trois couches de Tableau Desktop — données, calculs, visualisations — constituent ensemble un classeur Tableau. Vous pouvez enregistrer localement l’ensemble du classeur sous forme de fichier Tableau packaged workbook (.twbx) et le partager avec vos collègues pour consultation et collaboration.
Gardez toutefois à l’esprit que si vous transmettez simplement un fichier de classeur à un collègue, celui-ci devra avoir Tableau Desktop installé pour l’ouvrir. Par ailleurs, vous n’aurez aucun moyen de gérer ou de gouverner ce fichier. C’est pourquoi publier votre classeur sur Tableau Server est un moyen bien plus efficace de collaborer sur des projets Tableau. Sur ce point, explorons maintenant l’architecture de Tableau Server.
Tableau Server est un ensemble de processus qui forment une plateforme analytique complète. Il permet de publier, gérer, gouverner, sécuriser, explorer et modifier des rapports et des sources de données. Il peut être déployé sur site ou dans le cloud de votre choix. Votre organisation en assure alors la gestion et la sécurité de bout en bout.
L’architecture de Tableau Server comprend au moins 18 composants et sous-composants, un nombre susceptible d’évoluer au rythme des mises à jour. Dans le cadre de cet article, nous revenons sur les principaux éléments impliqués dans la publication d’un classeur ou l’accès à une vue. Nous en détaillerons huit en particulier.
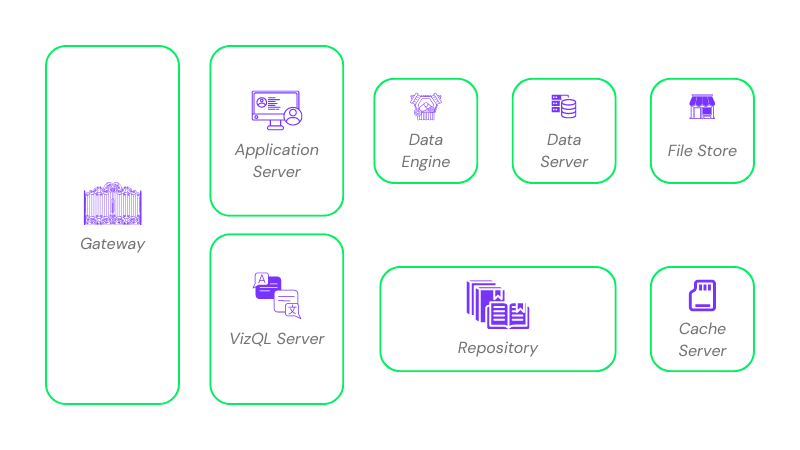 Architecture de Tableau Server
Le gateway joue le rôle de réception en tête de pont de Tableau Server. Lorsqu’un client envoie une requête, il l’oriente vers les composants pertinents pour exécuter la tâche. Le client peut être un utilisateur de Tableau Desktop qui souhaite publier son rapport, ou un lecteur qui veut se connecter et consulter un rapport.
Plus loin dans le processus, le gateway renvoie la réponse adéquate au client : vue demandée, résultat de requête, ou simple message confirmant la réussite de la publication.
L’application server est l’adjoint du gateway. Il récupère la requête et la prépare pour l’envoyer dans la bonne direction, telle que déterminée par le gateway.
Par exemple, lorsqu’un utilisateur souhaite publier un classeur, l’application server le décompose en deux fichiers : un fichier XML qui contient toutes les informations sur les visuels du classeur et qui est transmis au repository, et un fichier créé par Tableau, appelé Hyper, qui contient les données sources à stocker dans le file store.
Quand un lecteur veut accéder au serveur, l’application server vérifie d’abord si l’utilisateur est enregistré et son niveau d’accès en consultant les journaux d’utilisateurs dans le repository. Une fois ces informations confirmées, il prépare l’interface adaptée à cet utilisateur.
Le VizQL server est un composant original et emblématique de Tableau Server, inventé par deux des fondateurs de Tableau. Son nom signifie Visual Query Language ; il sert de traducteur entre le langage SQL des bases de données et le langage visuel des visualisations.
Par exemple, lorsqu’un client interagit avec une vue, le VizQL server interroge la source de données via le data engine et le data server. Il récupère aussi les métadonnées nécessaires dans le repository. Une fois données et métadonnées mises en correspondance, le VizQL server envoie le visuel au gateway, qui le livre à l’utilisateur.
Le repository est le centre névralgique de stockage et de gestion des métadonnées liées à Tableau Server. On y trouve, entre autres, les fichiers XML des classeurs publiés et les journaux utilisateurs (comptes, rôles, permissions). Il conserve aussi des informations d’usage des actifs sur le serveur, comme le nombre de vues ou les sources de données les plus utilisées.
Les seules données non stockées dans le repository sont les sources utilisées par les classeurs. Elles sont conservées dans le file store, que nous abordons ci-dessous.
Le file store gère le stockage des sources de données extraites dans Tableau Server. Dans certains environnements, il peut également créer et administrer des copies des extraits pour garantir la disponibilité des données en cas d’incident technique.
Il s’agit d’un moteur de base de données spécialement conçu pour traiter les sources de données extraites stockées dans le file store de Tableau Server. Le data engine transforme et optimise ces extraits grâce à Hyper afin d’assurer un stockage efficace dans le file store.
Le data engine sert aussi d’interface pour interroger le file store à toutes fins : consultation, mise à jour, actualisation des extraits ou des vues qui en dépendent.
Si un utilisateur consulte une vue basée sur des sources extraites, le data server envoie une requête au data engine, qui interroge alors la source depuis le file store, où la copie des données est stockée.
Si la vue repose sur des sources en direct, le data server appelle les connecteurs de données pour interroger la source externe.
Comme son nom l’indique, le cache server conserve en mémoire les vues et requêtes déjà consultées afin d’accélérer les réponses futures en servant les résultats en cache.
Lors du déploiement de Tableau, sachez d’abord que Tableau Server n’est pas la seule option pour publier et collaborer autour de vues et d’actifs de données. Vous pouvez aussi envisager Tableau Cloud.
Alors que Tableau Server doit être entièrement géré et sécurisé par votre organisation, Tableau Cloud propose une interface et des fonctionnalités similaires, mais la plateforme est entièrement hébergée, gérée et sécurisée par Tableau.
Ainsi, si votre organisation n’a pas de contraintes spécifiques en matière de sécurité et d’infrastructure IT, ou ne dispose pas des ressources humaines et techniques pour administrer un serveur, Tableau Cloud est souvent la meilleure option. Sinon, retroussez vos manches et optez pour Tableau Server.
D’un point de vue IT, Tableau met à disposition un document Blueprint et une enquête d’architecture d’entreprise listant l’ensemble des points à considérer avant tout déploiement. En parallèle de l’implication des équipes IT, voici quelques considérations générales côté gouvernance.
Dans cet article, nous avons présenté l’architecture des produits Tableau les plus utilisés, Tableau Desktop et Tableau Server, et passé en revue les considérations liées à un déploiement à l’échelle de l’organisation.
Pour approfondir votre compréhension de Tableau Server, explorez cet tableau de bord interactif de Tableau. Vous pouvez aussi regarder cette présentation de l’équipe Tableau.
Enfin, si vous débutez avec Tableau, découvrez notre cours Introduction to Tableau et tout le parcours Tableau Fundamentals. Si vous avez déjà de l’expérience, n’hésitez pas à suivre le parcours Data Analyst in Tableau, qui vous prépare à la certification Tableau Certified Data Analyst.
Apprenez Tableau avec DataCamp
Cours
Cours
Cours