
Cours
Concepts d’AWS
2 h
51.9K
Tout système complexe résulte de l’orchestration de multiples sous-systèmes. Concevoir et maintenir un tel système reste un défi courant, surtout dans le cloud.
Heureusement, une variété d’outils ont été développés pour fluidifier l’orchestration des workflows, quel que soit leur niveau de complexité. Parmi eux, AWS Step Functions se distingue par son utilité et ses nombreux atouts.
Cet article explique comment utiliser Step Functions pour orchestrer des workflows au sein d’AWS Cloud. Il commence par définir ce que sont les Step Functions, leurs bénéfices et leurs fonctionnalités clés.
Il vous guide ensuite pas à pas pour démarrer avec Step Functions, de la mise en place de votre environnement AWS à la prise en main de l’interface. Sur cette base, il détaille la création et le déploiement, étape par étape, d’un workflow concret.
AWS Step Functions est un service d’orchestration serverless conçu pour faciliter la création de workflows visuels, permettant de coordonner en toute transparence des fonctions AWS Lambda et d’autres ressources AWS.
Ses capacités d’intégration sont étendues : Amazon EC2, Amazon ECS, des serveurs on-premise, Amazon API Gateway ou encore les files d’attente Amazon SQS, pour n’en citer que quelques-uns. Résultat : des workflows complets capables d’interagir avec un large écosystème de services AWS.
La polyvalence d’AWS Step Functions le rend pertinent pour de nombreux cas d’usage. Qu’il s’agisse de gérer la préparation de commandes, de traiter des données, d’alimenter des applications web ou d’orchestrer une séquence complexe de tâches, Step Functions offre une solution robuste d’automatisation et de pilotage des workflows.
Avant d’entrer dans les aspects techniques d’AWS Step Functions, passons en revue ses principales caractéristiques et les bénéfices associés.
Step Functions propose de nombreuses fonctionnalités pour simplifier la création et la gestion des workflows ; en voici les principales :
Ces fonctionnalités clés d’AWS Step Functions offrent de multiples bénéfices aux développeurs et aux organisations pour améliorer leurs opérations et leurs cycles de développement.
|
Pour les développeurs |
Pour les organisations |
|
|
Au vu des fonctionnalités et avantages ci-dessus, nul doute que Step Functions peut jouer un rôle central dans de nombreux domaines, en aidant les entreprises à concevoir, automatiser et faire évoluer leurs workflows efficacement.
Cette section illustre comment différents secteurs utilisent AWS Step Functions pour gagner en compétitivité, en innovation et en efficacité.
Les organisations dont l’architecture repose sur des microservices s’appuient souvent sur AWS Step Functions pour gérer les interactions entre ces services.
Une entreprise de retail, par exemple, peut utiliser Step Functions pour orchestrer les étapes d’authentification, de gestion des stocks, de paiement et d’expédition des commandes, garantissant une expérience d’achat fluide.
AWS Step Functions peut automatiser des tâches répétitives telles que les contrôles de sécurité, les mises à jour système et les vérifications de conformité.
En sécurité IT, par exemple, Step Functions permet de concevoir des workflows de réponse aux incidents, réduisant les erreurs humaines et les temps de réponse en pilotant systématiquement chaque phase, de l’alerte initiale à la résolution.
Pour les entreprises data-intensive, AWS Step Functions orchestre le traitement de données et les tâches ETL. Cela peut inclure l’extraction depuis plusieurs sources, la transformation vers un format homogène, puis le chargement dans des plateformes analytiques ou des data lakes.
Un cabinet d’analytics, par exemple, peut automatiser son pipeline avec Step Functions, assurant une gestion efficace des données pour éclairer les décisions stratégiques.
Step Functions est également utile pour l’opérationnalisation du machine learning : préparation des données, entraînement, évaluation et déploiement des modèles.
Une healthtech peut, par exemple, gérer avec Step Functions le pipeline de réentraînement périodique de ses algorithmes de diagnostic, afin de maintenir les performances des modèles au fil de l’arrivée de nouvelles données.
Dans les médias et le divertissement, AWS Step Functions orchestre des workflows complexes de traitement : encodage vidéo, traitement d’images et analyse de contenu.
Une entreprise media peut faire en sorte que tout nouveau contenu importé déclenche automatiquement une conversion de format, l’extraction de vignettes et l’enrichissement de métadonnées avant publication.
Les sections suivantes abordent la combinaison de Step Functions avec d’autres services AWS. Il est donc nécessaire d’en maîtriser les bases avant d’aller plus loin.
Cette section vise à vous aider à démarrer avec AWS Step Functions, des briques de base à la navigation dans l’interface.
Tout système ou module est un assemblage de sous-composants, et Step Functions ne fait pas exception. Il repose sur deux blocs : (1) les machines d’état, et (2) les tâches.
Illustrons ces concepts par un exemple.
Considérons un cas d’usage : un processus d’inscription en crèche avec AWS Step Functions. Avant d’entrer dans le détail de l’implémentation, voici les grandes étapes :
Ce workflow comporte une machine d’état avec quatre tâches principales, explicites :
checkInformationcheckAgeRangecheckSpotsAvailabilityconfirmRegistration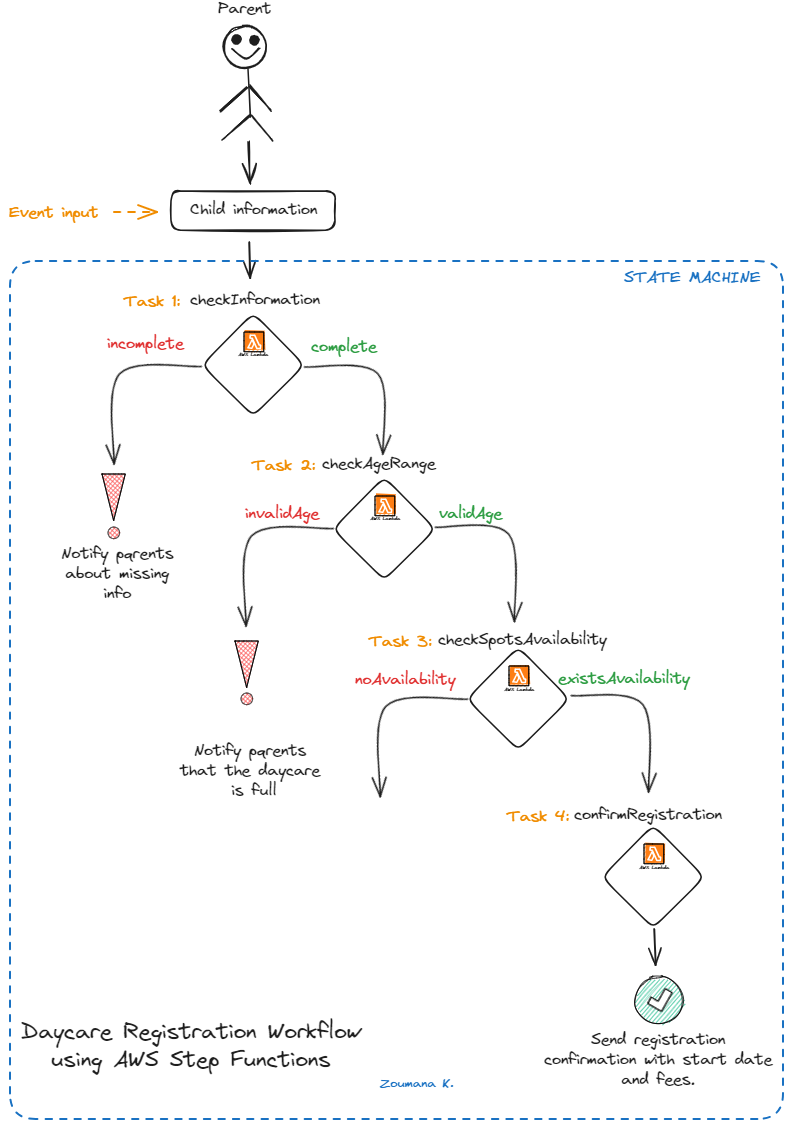
Workflow d’inscription en crèche avec AWS Step Functions
Les sections précédentes ont posé le cadre théorique ; passons maintenant à la pratique : des prérequis à l’implémentation d’un workflow bout en bout, jusqu’au déploiement.
Avant les détails du cas d’usage, voici les prérequis pour une implémentation réussie :
Commençons par parcourir l’interface Step Functions. Après connexion à votre compte AWS, procédez en quatre étapes :
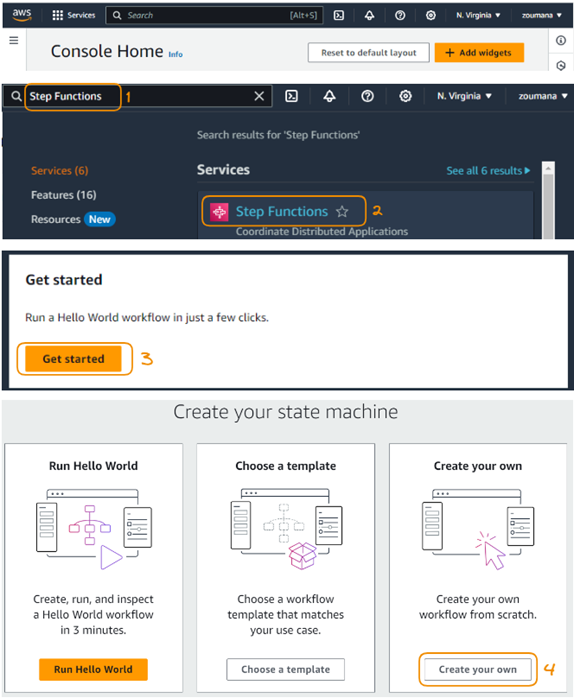
Quatre étapes pour accéder à l’interface Step Functions
Après la quatrième étape, nous pouvons concevoir la machine d’état via l’onglet « Design », qui regroupe trois grandes familles : « Actions », « Flow » et « Patterns ».
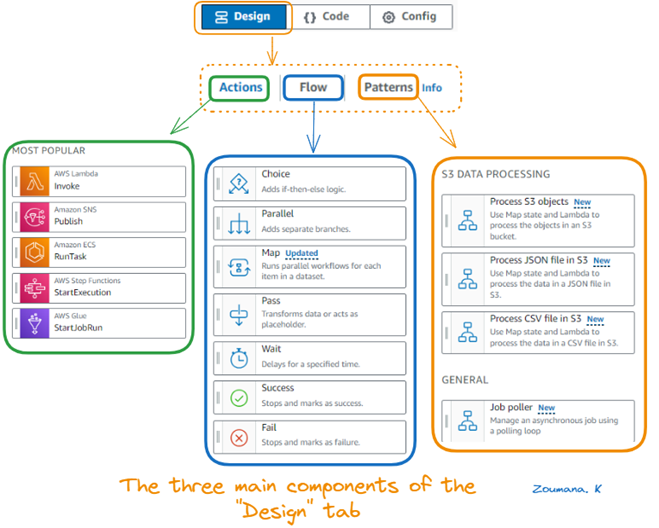
Les trois composants principaux de l’onglet « Design »
Le workflow initial présentait les principaux composants de la machine d’état. Voyons maintenant l’implémentation.
Nous avons besoin de quatre fonctions Lambda, chacune correspondant à une tâche précise.
Les sept étapes suivantes décrivent la procédure de création d’une fonction Lambda. Le processus est identique pour les quatre ; seules diffèrent leurs logiques internes.
L’intégralité du code est disponible sur la page GitHub. Même s’il est simple à lire, nous vous recommandons de suivre l’article dans son ensemble pour une meilleure expérience.
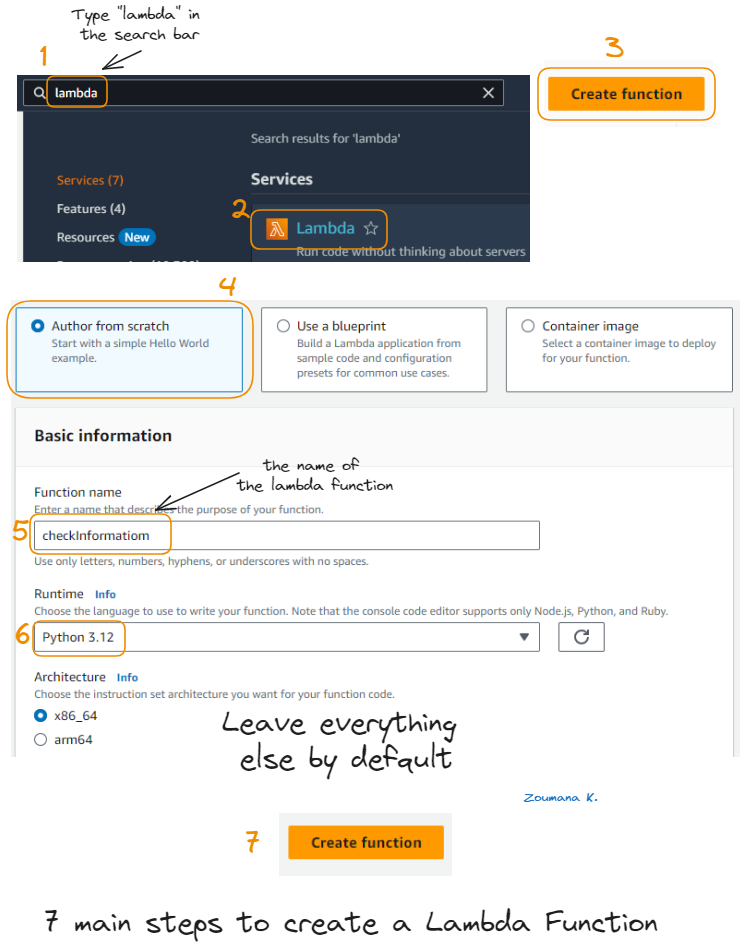
7 étapes pour créer une fonction Lambda
Une fois ces sept étapes terminées, la fenêtre suivante s’affiche, avec des informations clés :
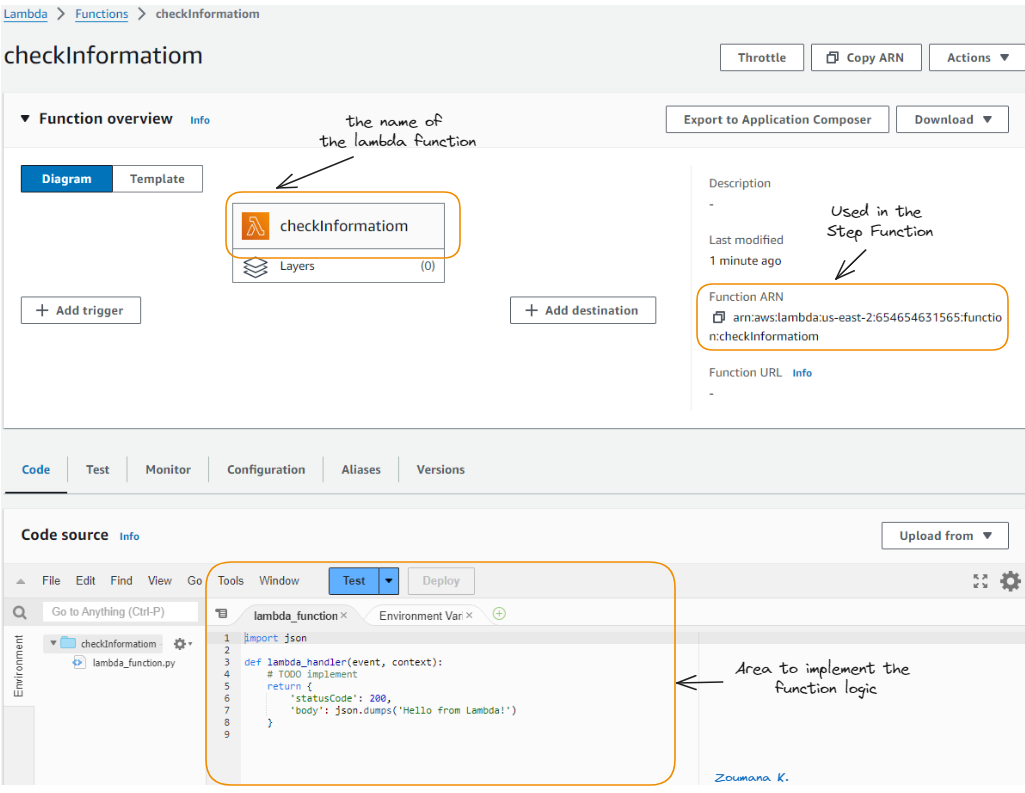
Détails de la fonction Lambda checkInformation
Répétez ensuite la même procédure pour les trois autres tâches (fonctions) : checkAgeRange, checkSpotsAvailability et confirmRegistration.
Un exemple de JSON d’entrée est donné ci-dessous. Il est essentiel de le comprendre, car il influence la façon d’implémenter les fonctions.
{
  "registration_info": {
	"child": {
  	"firstName": "Mohamed",
  	"lastName": "Diallo",
  	"dateOfBirth": "2016-07-01"
	},
	"parents": {
  	"mother": {
    	"firstName": "Aicha",
    	"lastName": "Cisse",
    	"email": "aicha.cisse@example.com",
    	"phone": "123-456-7890"
  	},
  	"father": {
    	"firstName": "Ibrahim",
    	"lastName": "Diallo",
    	"email": "ibrahim.diallo@example.com",
    	"phone": "098-765-4321"
  	}
	},
	"daysOfWeek": [
  	"Monday",
  	"Tuesday",
  	"Wednesday",
  	"Thursday",
  	"Friday"
	],
	"specialInstructions": "Mohamed has a peanut allergy."
  }
}
Chaque fonction Lambda est décrite ci-dessous :
|
Fonction |
Description |
|
|
|
|
|
|
|
|
|
|
|
|
L’implémentation de chaque fonction est fournie ci-dessous :
checkInformation function
 import json

 def checkInformation(event, context):
	 registration_info = event['registration_info']

	 required_fields = ['child', 'parents', 'daysOfWeek']
	 for field in required_fields:
    	if field not in registration_info:
        	return {
            	'statusCode': 400,
            	'body': f'Missing required field: {field}'
        	}

	 return {
    	'statusCode': 200,
    	'body': json.dumps(registration_info)
	 }
checkAgeRange function
 import json
 import datetime

 def checkAgeRange(event, context):

	registration_info = json.loads(event['body'])

	dob = registration_info['child']['dateOfBirth']

	today = datetime.date.today()
	dob_date = datetime.datetime.strptime(dob, '%Y-%m-%d').date()
	age = today.year - dob_date.year - ((today.month, today.day) < (dob_date.month, dob_date.day))

	if age < 2 or age > 5:
    	return {
        	'statusCode': 400,
        	'body': json.dumps('Child is not within the acceptable age range for this daycare.')
    	}


	registration_info['child']['age'] = age

	return {
    	'statusCode': 200,
    	'body': json.dumps(registration_info)
	}
checkSpotsAvailability function
import json

def checkSpotsAvailability(event, context):

	registration_info = json.loads(event['body'])

	spots_available = 20  # This should be dynamically determined, not hardcoded

	if spots_available <= 0:
    	return {
        	'statusCode': 400,
        	'body': json.dumps('No spots available in the daycare.')
    	}

	return {
    	'statusCode': 200,
    	'body': json.dumps(registration_info)
	}
confirmRegistration function
import json
import datetime

def confirmRegistration(event, context):

	registration_info = json.loads(event['body'])
	age = registration_info['child']['age']  # This was added in the checkAgeRange function

	if age >= 2 and age < 3:
    	fees = 800
	elif age >= 3 and age < 4:
    	fees = 750
	elif age >= 4 and age < 5:
    	fees = 700
	else:  # age >= 5
    	fees = 650

	start_date = datetime.date.today() + datetime.timedelta(weeks=2)

	confirmation_details = {
    	'fees': fees,
    	'start_date': start_date.isoformat()
	}

	response = {**registration_info, **confirmation_details}

	return {
    	'statusCode': 200,
    	'body': json.dumps(response)
	}
Avec tout cela en place, nous pouvons créer notre machine d’état de crèche via l’interface graphique de Step Functions.
Le résultat final est présenté ci-dessous. Voici les étapes clés qui mènent à ce workflow :
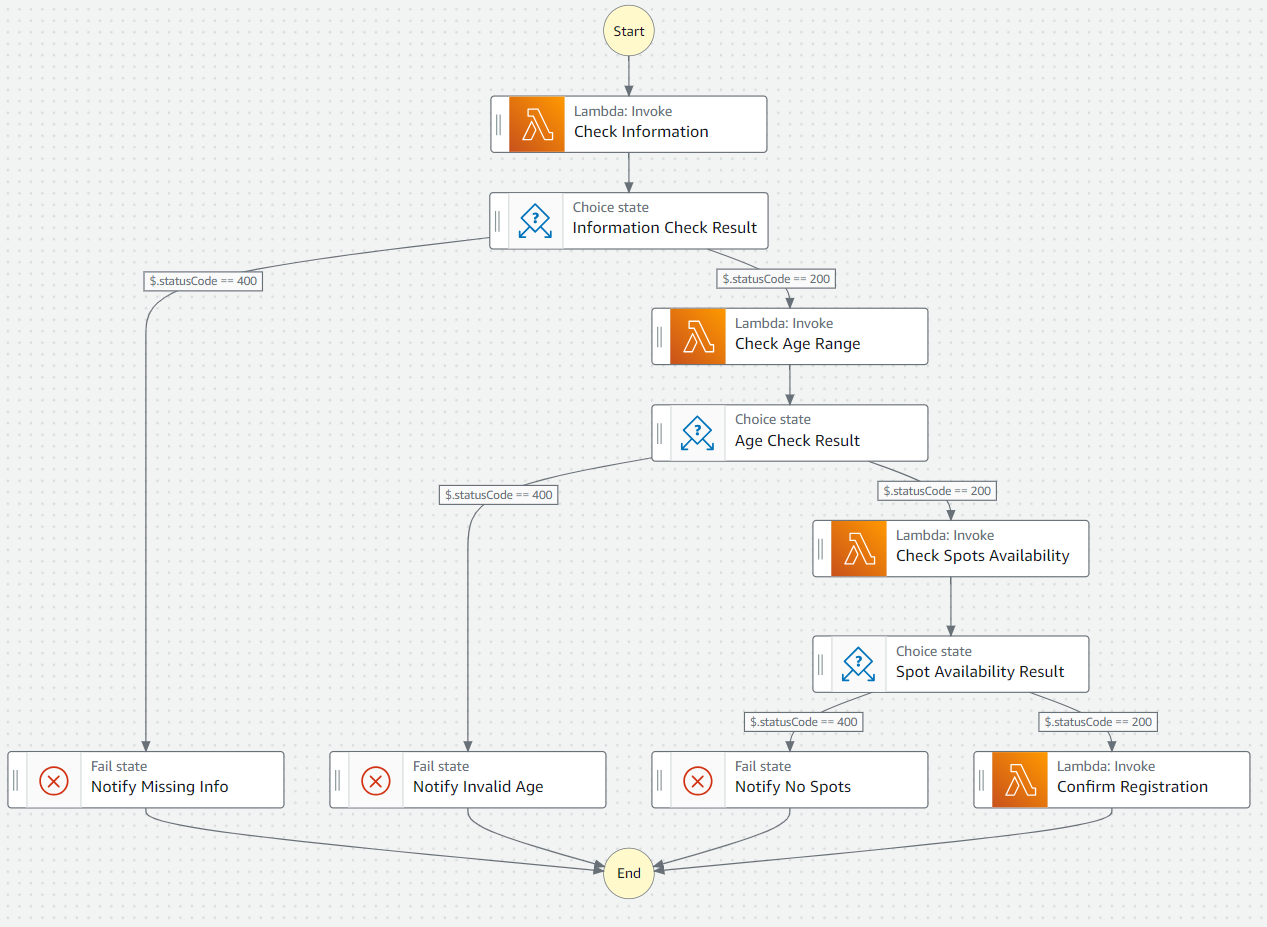
Workflow de machine d’état pour le cas d’usage crèche
Avant de commencer, notez que le champ statusCode en sortie d’une fonction Lambda détermine l’état suivant de la machine d’état.
statusCode est 400, le contrôle a échoué ; on renvoie alors un message pertinent selon la fonction exécutée.Check Information
Check Age Range
Check Spots Availability
Confirm Registration
Pour aller plus loin avec les fonctions Lambda, le cours Streaming Data with AWS Kinesis and Lambda montre comment traiter des données en streaming avec les technologies serverless d’AWS.
L’étape suivante consiste à définir les rôles IAM pour que les Step Functions puissent invoquer nos fonctions Lambda. Procédez ainsi :
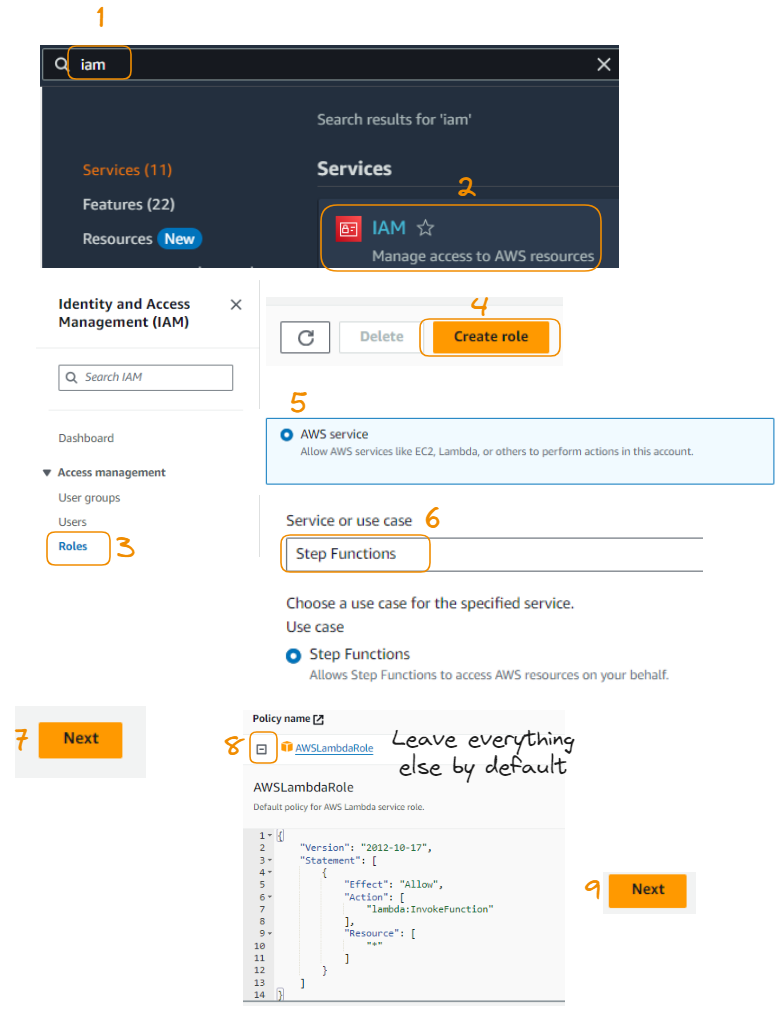
Neuf premières étapes pour créer un rôle IAM
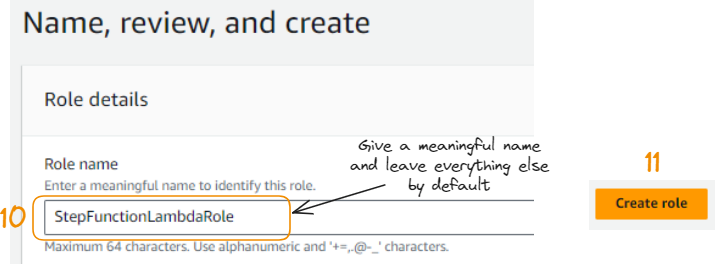
10e et 11e étapes pour créer un rôle IAM
Ce rôle IAM peut être attribué à la machine d’état comme suit, depuis l’onglet « Config ».
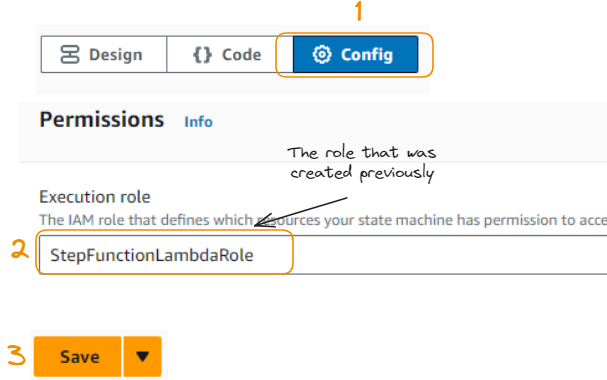
3 étapes pour accorder le rôle IAM
Après l’enregistrement, vous devriez voir le message suivant confirmant que tout s’est bien passé.
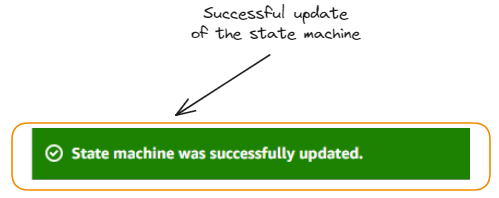
Message de succès de création de la machine d’état
Une fois satisfait de la machine d’état, cliquez sur le bouton « Create » en haut à droite pour la créer.
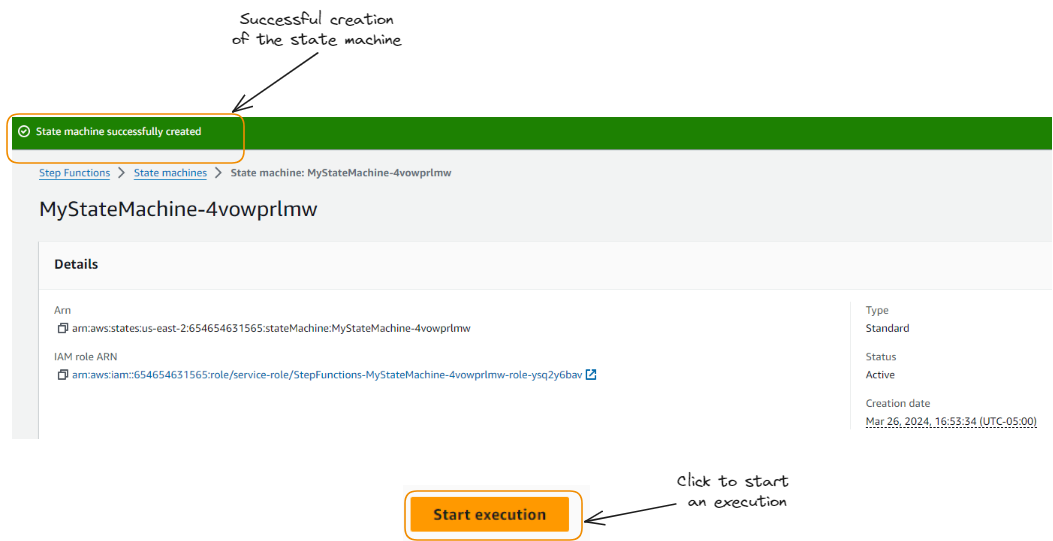
Illustration de l’exécution de la machine d’état
Notre workflow est déployé ; passons aux tests. Nous allons vérifier deux scénarios :
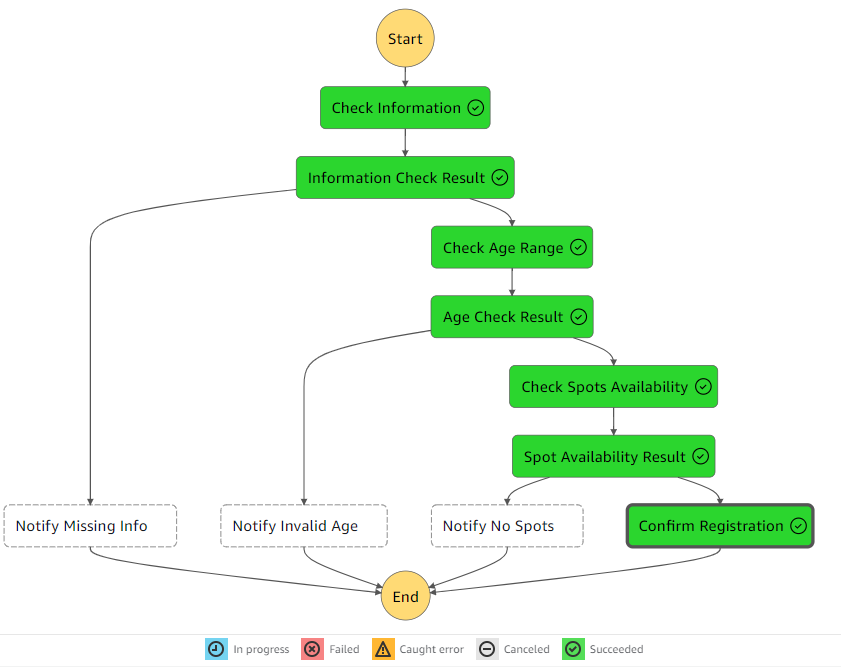
Résultat d’un cas de succès
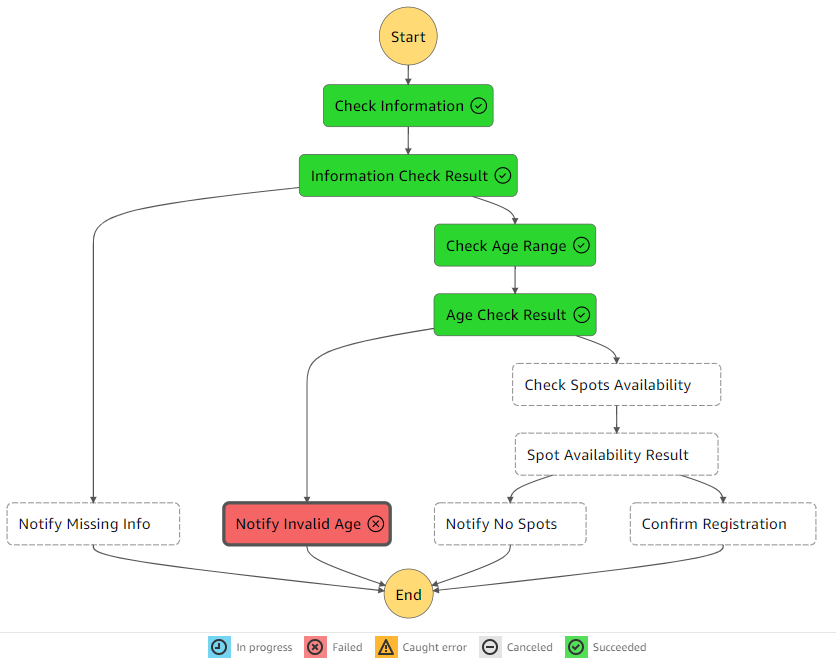
Résultat d’un cas d’échec
Optimiser un processus commence par l’adoption de bonnes pratiques, gages de performance et de maîtrise des coûts. Voici quelques recommandations pour tirer le meilleur d’AWS Step Functions.
Cet article vous a proposé un guide complet pour comprendre et utiliser AWS Step Functions. Il a commencé par présenter le service, ses fonctionnalités clés et ses bénéfices.
Il vous a ensuite accompagné dans la configuration de votre environnement AWS et la navigation dans l’interface d’AWS Step Functions.
Nous avons ensuite construit une première Step Function AWS, de la création d’un workflow basique à son déploiement et ses tests. Nous avons également abordé des fonctionnalités avancées et des cas d’usage, avant de voir comment les optimiser pour gagner en efficacité et en maîtrise budgétaire.
Nos articles AWS, Azure et GCP : comparaison des services pour la data et l’IA et Introduction to AWS Boto in Python constituent d’excellentes suites pour approfondir.
Le premier compare les principaux services nécessaires aux projets data et IA, de l’ingénierie des données à l’analyse et la data science, jusqu’à la création d’applications data. Ce pense-bête aide à comprendre le paysage des services cloud pour la data et l’IA sur les trois grandes plateformes.
Le second propose une introduction accessible à AWS Boto en Python et montre comment exploiter le cloud pour optimiser vos workflows de données. Une ressource idéale pour automatiser vos opérations AWS avec Python.
AWS regorge de services ; la clé pour maîtriser AWS Step Functions est de bien cerner les besoins de l’application et d’assembler la bonne combinaison de services et de fonctionnalités pour y répondre.
Poursuivez votre parcours AWS dès aujourd’hui !
Cours
Cours
Cours