Cours
Concevoir des systèmes d’IA avec l’API OpenAI
3 h
22.8K
Preference fine-tuning (PFT) est une technique ancienne pour affiner des LLM. OpenAI l’a récemment intégrée dans sa série de 12 jours de lancements de fonctionnalités.
Aux côtés du supervised fine-tuning (SFT) et du reinforcement fine-tuning (RFT), le PFT est une autre façon d’aligner les grands modèles de langage sur les préférences des utilisateurs.
Dans cet article, je vous explique rapidement le principe du preference fine-tuning et comment l’utiliser très simplement depuis le tableau de bord d’OpenAI.
Alors que l’objectif du supervised fine-tuning standard est d’amener le modèle à produire certains résultats donnés des entrées spécifiques, le preference fine-tuning (PFT) vise à orienter le modèle vers les réponses que l’on préfère et à écarter celles que l’on ne souhaite pas.
Direct preference optimization (DPO) est la technique de référence en PFT et s’est imposée pour sa simplicité et son efficacité.
Contrairement au reinforcement learning from human feedback (RLHF), la DPO n’exige pas de modèle de récompense complexe pour aligner le LLM : elle traite le problème d’alignement comme une optimisation « directe » d’une fonction de perte. Résultat : une mise en œuvre plus simple et plus efficace côté calcul.
Le jeu de données requis pour la DPO, comme pour d’autres méthodes d’alignement, contient pour un même prompt une paire de réponses « préférée » et « non préférée ». Avec le PFT d’OpenAI, comme pour les autres méthodes d’affinage, le jeu de données doit être au format JSONL et respecter la structure suivante :
{
  "input": {
    "messages": [
      {
        "role": "user",
        "content": "Hello, can you tell me how cold San Francisco is today?"
      }
    ],
    "tools": [],
    "parallel_tool_calls": true
  },
  "preferred_output": [
    {
      "role": "assistant",
      "content": "Today in San Francisco, it is not quite cold as expected. Morning clouds will give away to sunshine, with a high near 68°F (20°C) and a low around 57°F (14°C)."
    }
  ],
  "non_preferred_output": [
    {
      "role": "assistant",
      "content": "It is not particularly cold in San Francisco today."
    }
  ]
}
La documentation officielle d’OpenAI pour le PFT recommande de combiner SFT et PFT pour un meilleur alignement. Les techniques d’alignement comme le PFT sont généralement appliquées après un affinage supervisé. Associer SFT et PFT est devenu un standard du secteur, également prôné par OpenAI.
Avant toute chose, assurez-vous que votre jeu de données respecte le format requis par le preference fine-tuning d’OpenAI.
Il existe plusieurs façons de créer un jeu de préférences. L’une d’elles consiste à générer des paires de sorties de LLM en faisant varier les temperatures, le top_k ou les system prompts, puis à utiliser un autre LLM, idéalement plus performant, pour choisir une réponse « préférée » et l’autre « non préférée ».
Pour la démonstration de ce tutoriel, je vais télécharger un jeu de préférences depuis Hugging Face et le restructurer. J’utiliserai argilla/ultrafeedback-binarized-preferences, un jeu de données de préférences, mais je ne garderai que les 50 premières lignes.
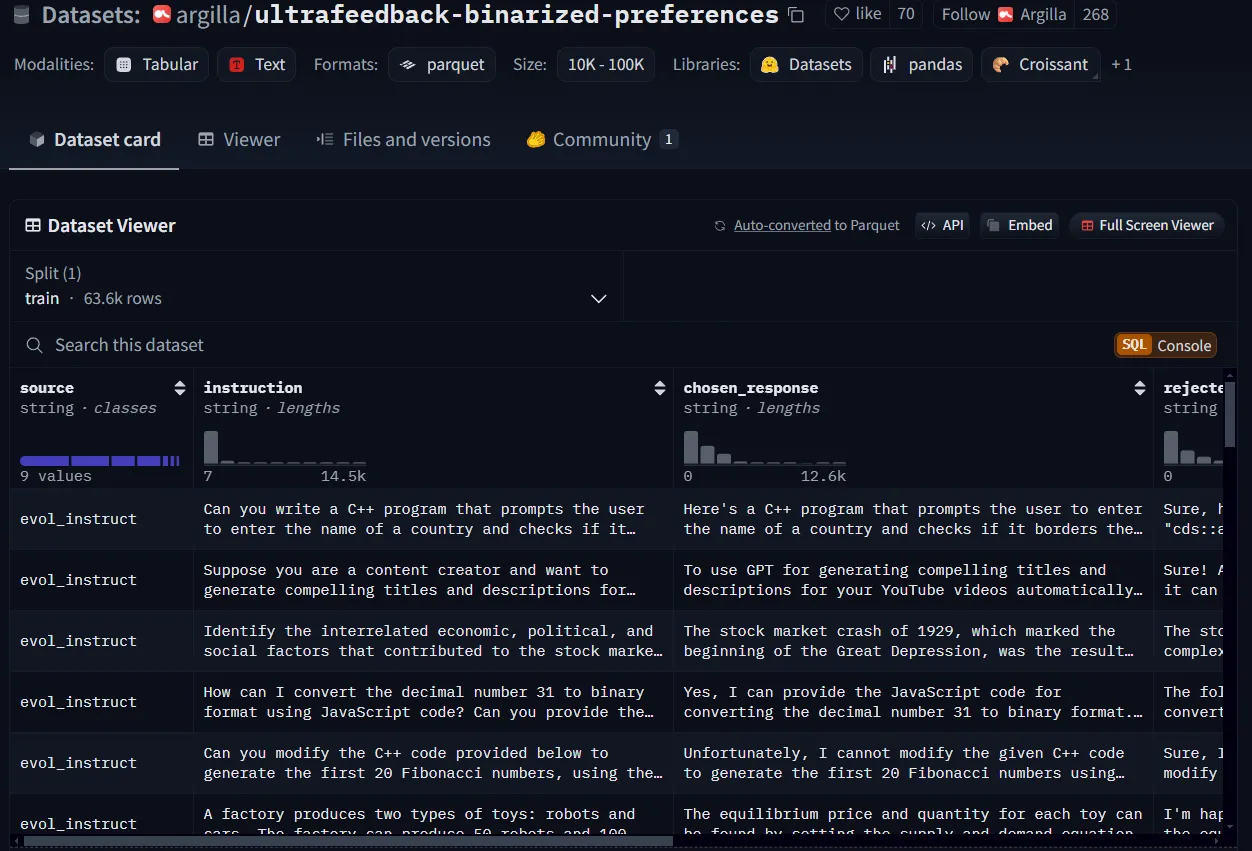
Exemple de jeu de données de préférences depuis Hugging Face.
Un simple script Python suffit pour convertir la structure du jeu de données au format requis par l’affinage d’OpenAI, mais vous pouvez opter pour une autre approche selon votre cas d’usage.
import datasets
import copy
import json

instance_structure = {
  "input": {
    "messages": [
      {
        "role": "user",
        "content": ""
      }
    ],
    "tools": [],
    "parallel_tool_calls": True
  },
  "preferred_output": [
    {
      "role": "assistant",
      "content": ""
    }
  ],
  "non_preferred_output": [
    {
      "role": "assistant",
      "content": ""
    }
  ]
}

ds = datasets.load_dataset("argilla/ultrafeedback-binarized-preferences", trust_remote_code=True, split="train")
ds_sample = ds.select(range(50)) #select the first 50 rows
ds_list = []
for sample in ds_sample:
  instance = copy.deepcopy(instance_structure)
  instance["input"]["messages"][0]["content"] = sample["instruction"]
  instance["preferred_output"][0]["content"] = sample["chosen_response"]
  instance["non_preferred_output"][0]["content"] = sample["rejected_response"]
  ds_list.append(instance)

with open("preference_dataset.jsonl", 'w') as out:
  for json_line in ds_list:
      jout = json.dumps(json_line) + '\\n'
      out.write(jout)
Vérifiez que votre jeu de données est au format jsonl et non json. Il est probable qu’une ligne vide figure en fin de fichier : pensez à la supprimer.
Une fois votre jeu de données prêt, suivez ces étapes pour lancer le preference fine-tuning :
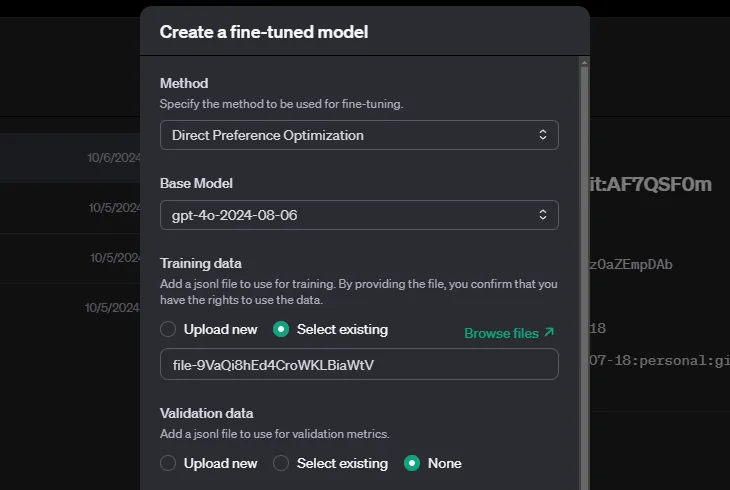
OpenAI vous permet de spécifier des hyperparamètres, mais vous pouvez également les laisser vides : le système choisira automatiquement. Selon la taille de votre jeu de données, l’entraînement peut prendre un certain temps.
La direct preference optimization est une nouveauté utile dans la boîte à outils d’affinage d’OpenAI : elle permet de contrôler explicitement le ton et le style des réponses de votre modèle et de mieux l’aligner sur les préférences des utilisateurs.
Comme pour la distillation d’OpenAI, le reinforcement fine-tuning et le supervised fine-tuning, votre principale contribution au preference fine-tuning consiste à préparer le jeu de données selon le format et la structure d’OpenAI ; leurs outils se chargent du reste :
Pour aller plus loin, je vous recommande ces ressources :
Formez-vous à l’IA avec ces cours !
Cours
Cours
Cours