
Cours
Concepts des grands modèles de langage (LLM)
2 h
109.8K
Même si la plupart des gens associent Google aux moteurs de recherche, l’entreprise est également profondément ancrée dans l’univers de la data science. Elle propose en continu des produits et des solutions de pointe pour tirer le meilleur parti des données. Lancé en 2021, Vertex AI fait partie de ces produits et vise à simplifier le machine learning à l’échelle de l’entreprise.
Dans ce tutoriel, nous allons découvrir comment démarrer avec la plateforme Vertex AI de Google et l’utiliser pour couvrir un large éventail de tâches du cycle de vie ML. À la fin, nous disposerons d’un modèle déployé auquel envoyer des requêtes pour générer des prédictions sur une tâche de classification.
Un cycle de vie typique en machine learning comporte de nombreuses étapes :
Toutes ces étapes et sous‑étapes nécessitent des outils différents et la coordination d’équipes aux expertises variées.
Vertex AI de Google Cloud rationalise et unifie l’ensemble de ce processus au sein d’une seule plateforme.
Si les applications ML à grande échelle requièrent des spécialistes aguerris, Vertex AI permet à chacun, quel que soit son niveau, d’agir efficacement :
Nous n’abordons pas tout ici : vous manipulerez vous‑même l’essentiel au fil de ce tutoriel.
Avant d’explorer la plateforme, rappelons son écosystème : les services Google Cloud. Google Cloud Services regroupe un large éventail de solutions de cloud computing couvrant le stockage, le réseau, les bases de données, l’analytique et les capacités de machine learning.
Ces services fonctionnent de concert avec Vertex AI pour unifier votre workflow de machine learning. Voici un aperçu des services souvent utilisés avec Vertex AI :
Les services Google Cloud sont accessibles depuis votre compte Google sur cloud.google.com. Si vous ne les avez jamais utilisés, cliquez sur « Get started for free » pour bénéficier de l’essai gratuit.
Sinon, rendez‑vous directement sur console.cloud.google.com pour commencer.
Avertissement : si vous suivez le tutoriel pas à pas, prévoyez un budget de 25 à 30 $ pour Vertex AI. Nous utiliserons les configurations les plus économiques.
À l’ouverture de Google Cloud Console, vous arriverez probablement sur la page d’accueil suivante :
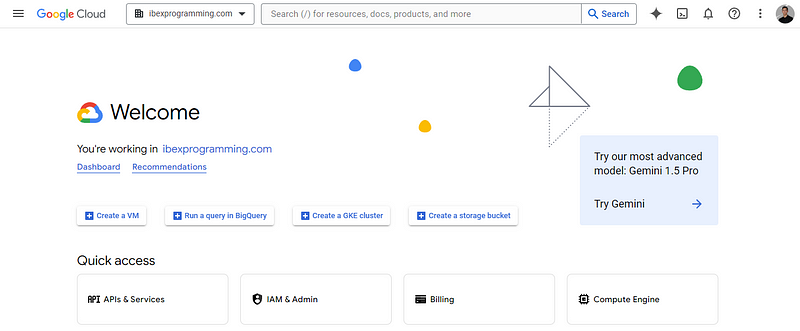
Vous y verrez le nom de votre espace de travail ; le mien est ibexprogramming.com.
Première étape : créer un projet. Les projets Google Cloud sont des unités d’organisation de haut niveau pour gérer les ressources d’une initiative donnée. Voici un GIF montrant la marche à suivre :
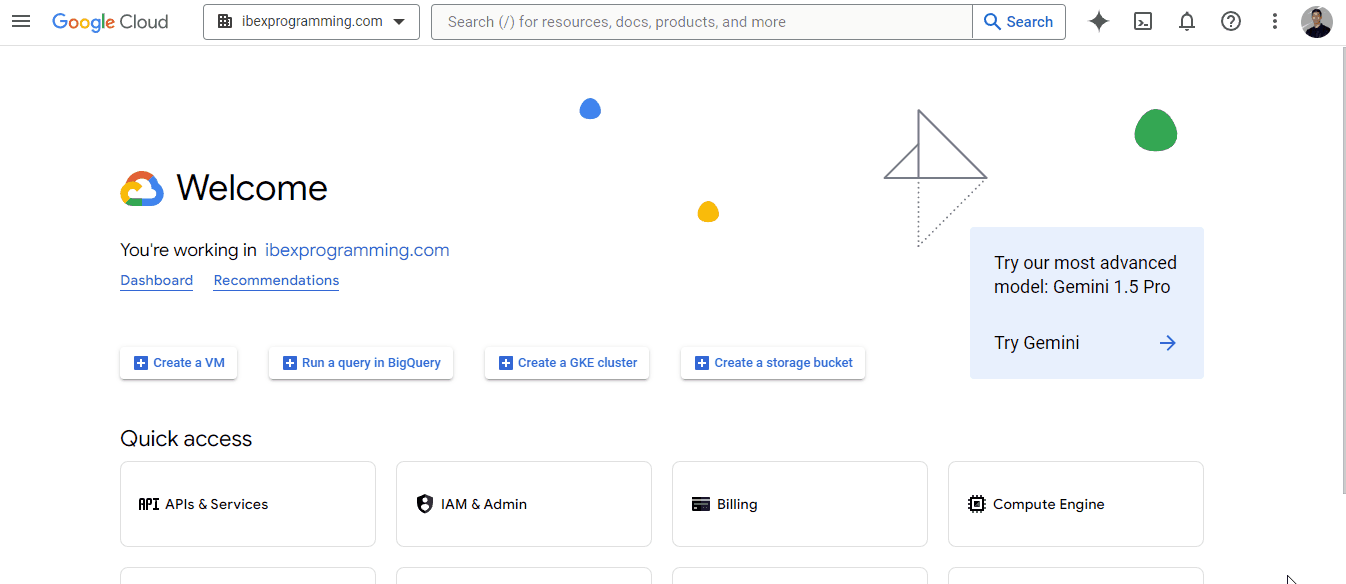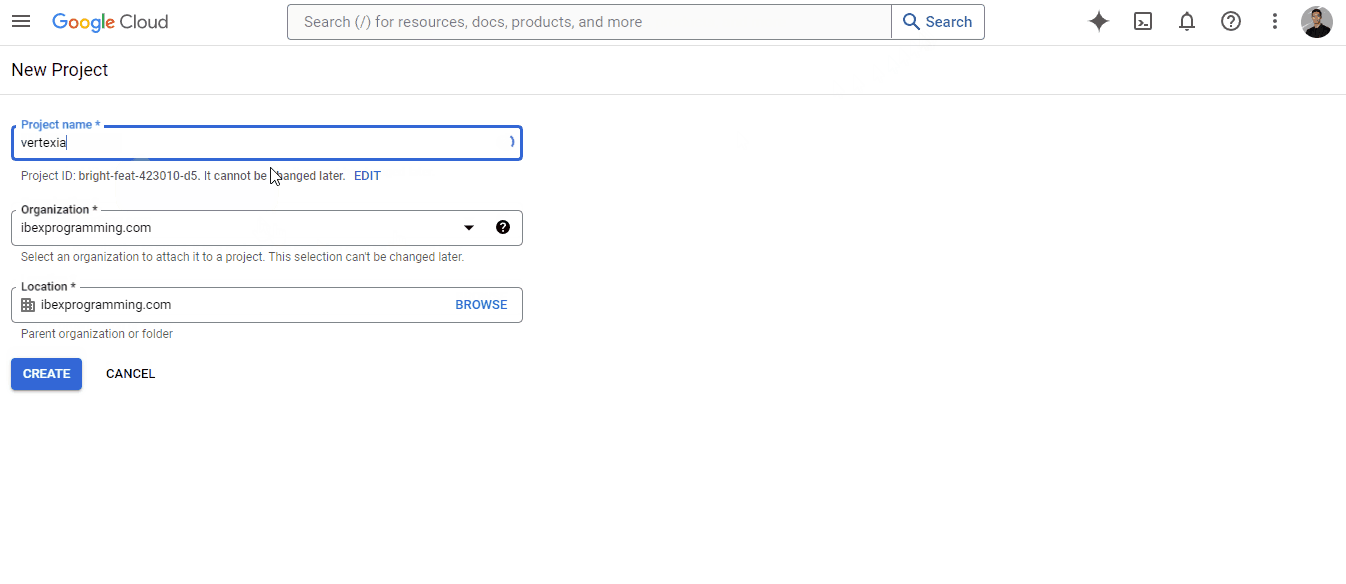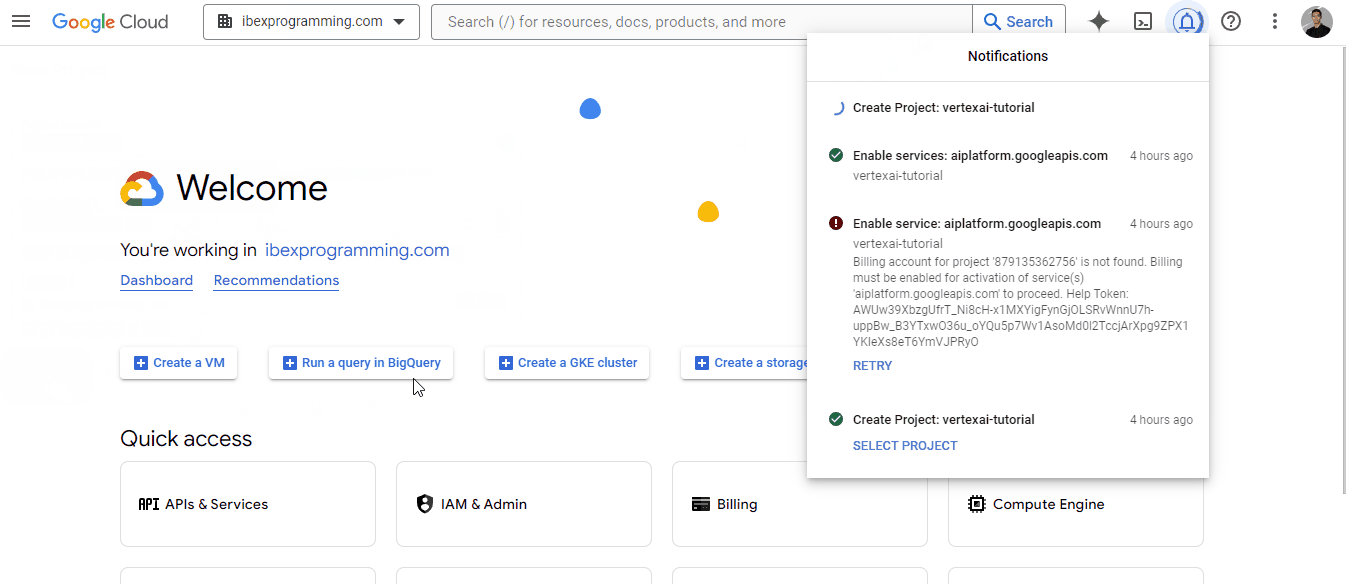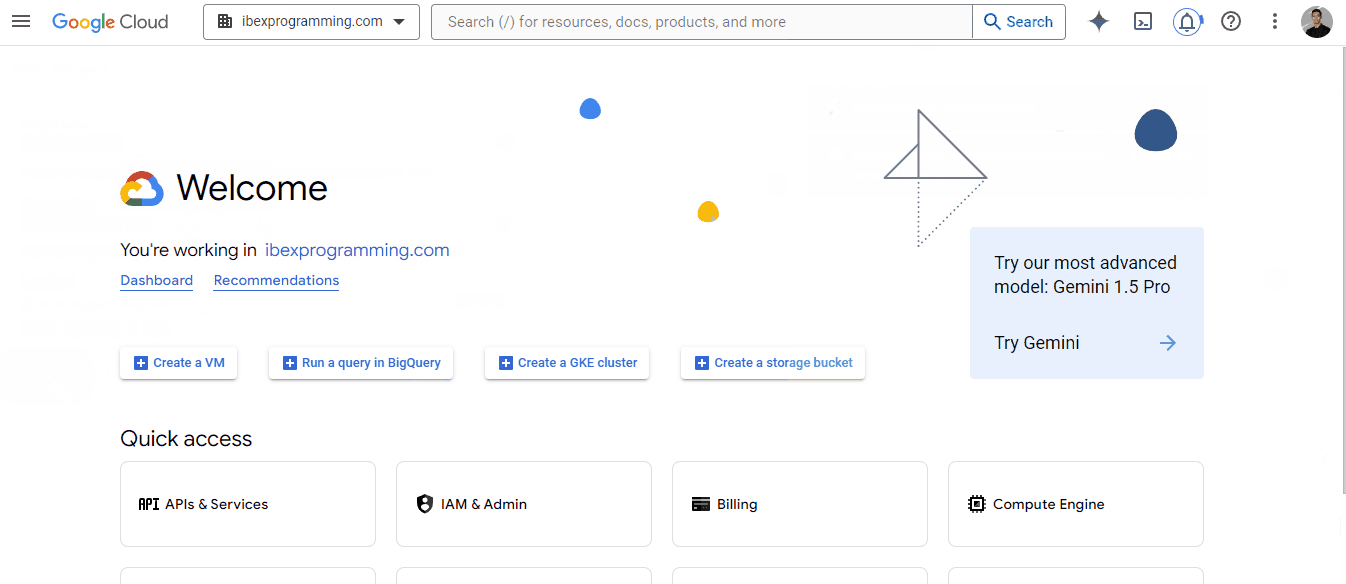
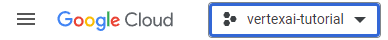
Une fois le projet créé, sélectionnez‑le afin que la barre supérieure de la page affiche ceci :
Vous devez maintenant créer un compte de facturation, car Vertex AI nécessite ces informations pour activer ses services. Rassurez‑vous : aucun frais ne sera engagé tant que vous n’utilisez pas de ressources payantes. Rendez‑vous sur https://console.cloud.google.com/billing:
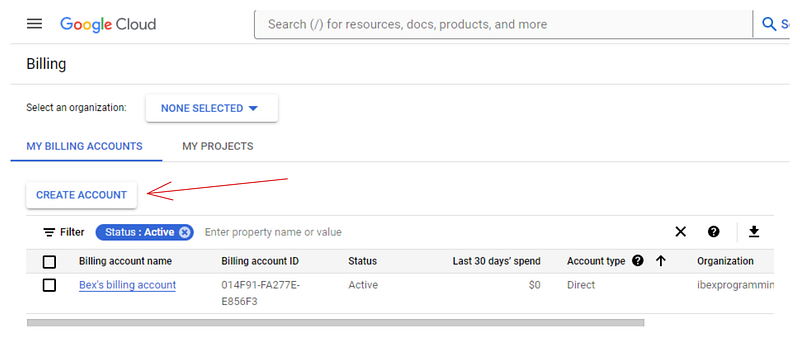
Si vous n’avez pas encore de compte comme moi, cliquez sur « Create account » et suivez les instructions. Nous lierons ce compte de facturation à notre projet dans la prochaine section.
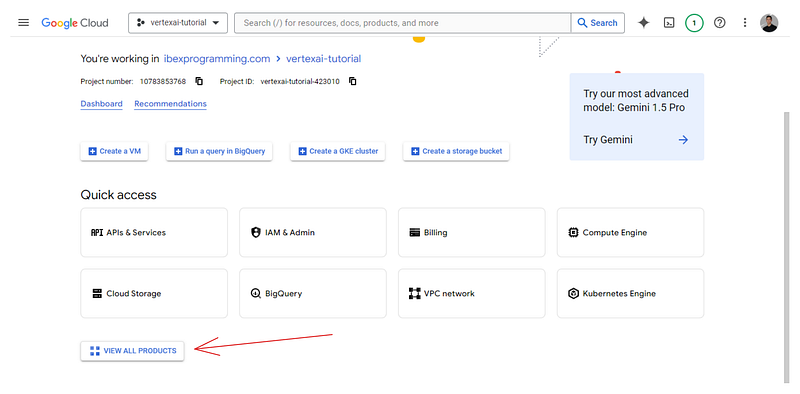
Ensuite, retournez sur https://console.cloud.google.com/ et cliquez sur le bouton « View all products » en bas de la page :
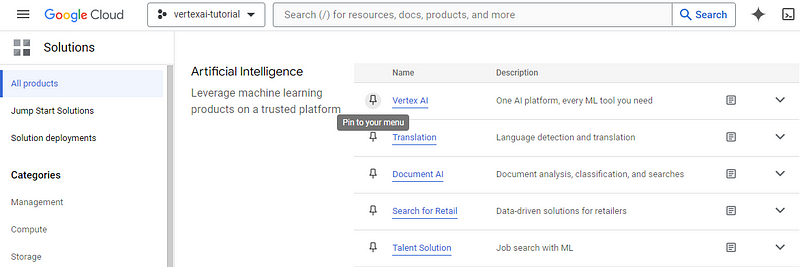
La page suivante liste tous les services Google Cloud disponibles pour votre projet. Recherchez « Vertex AI » (Ctrl + F) et épinglez‑le au menu pour un accès rapide. Puis cliquez sur le service :
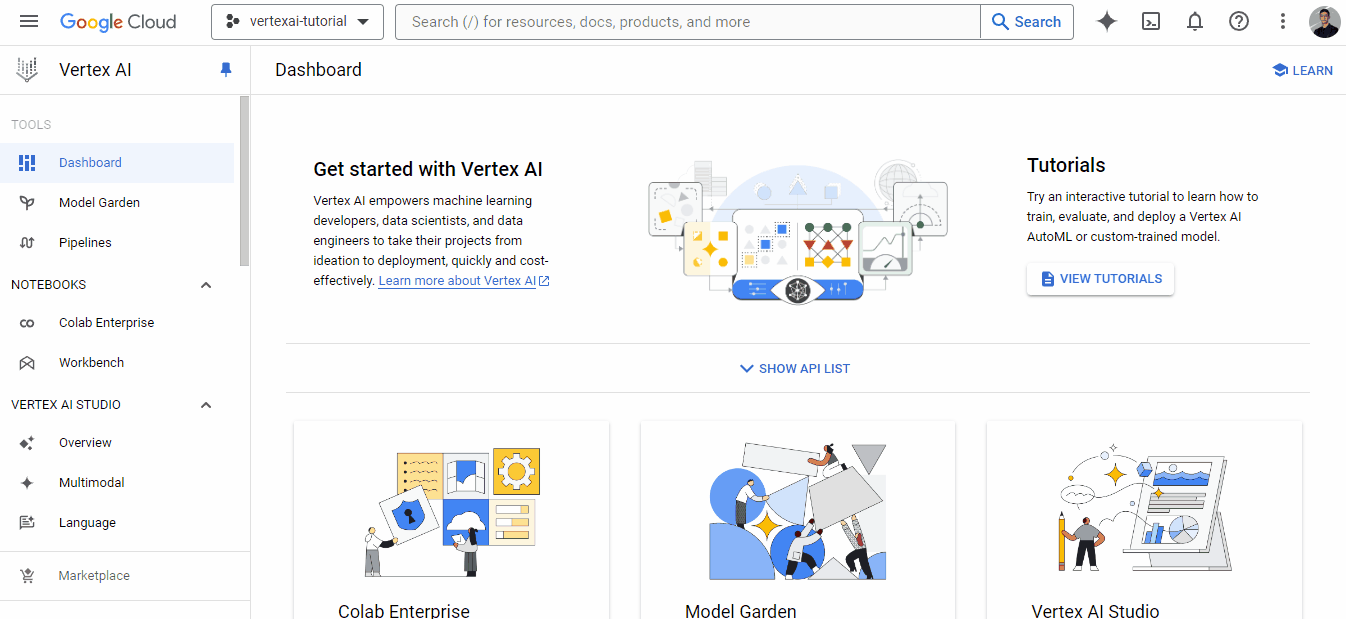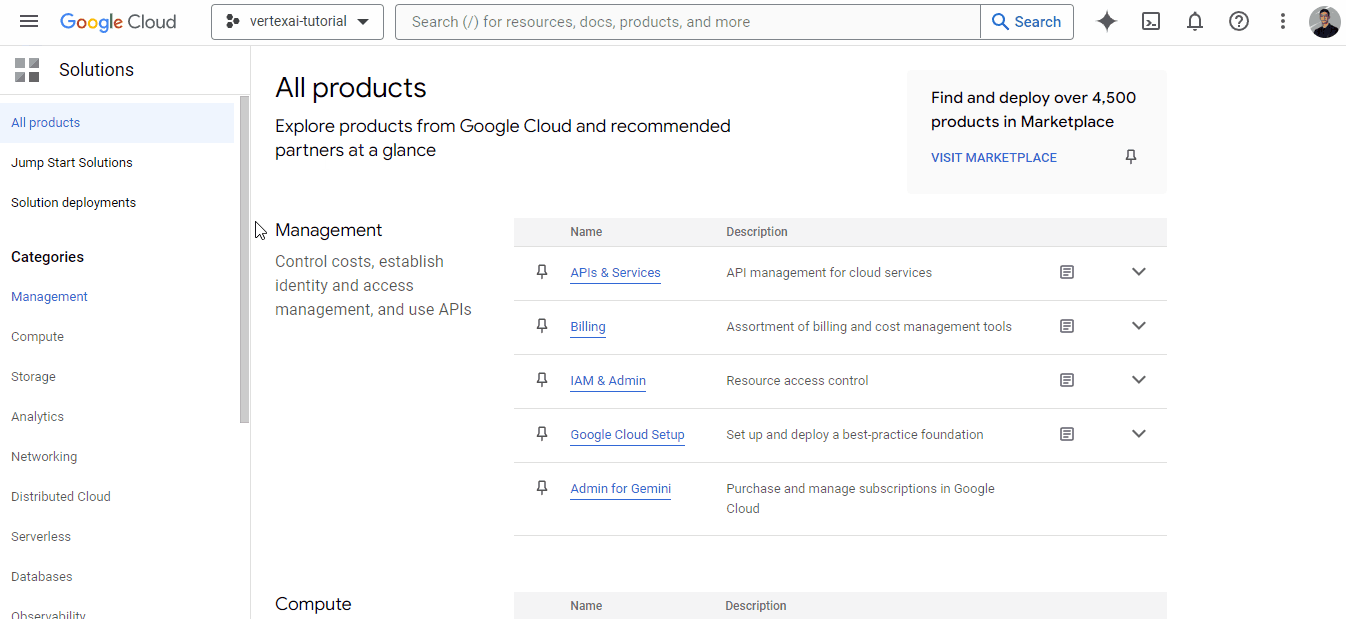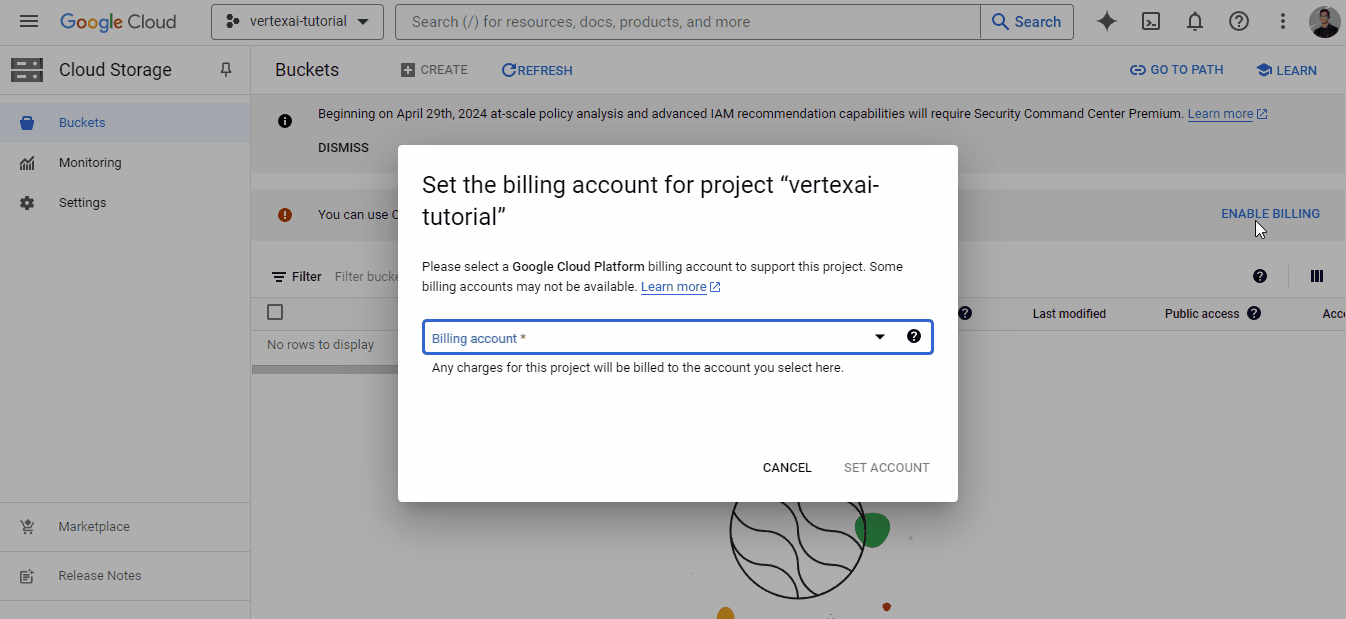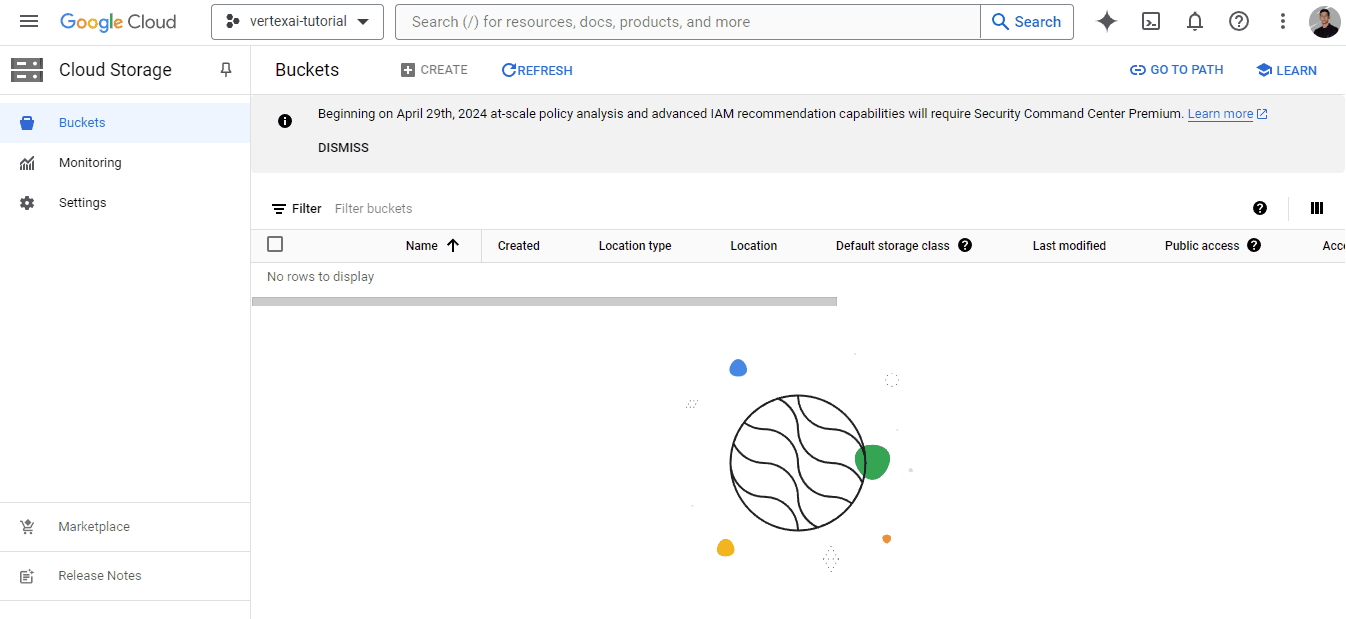
Vous serez redirigé vers le tableau de bord Vertex AI. Une fenêtre peut vous demander d’activer l’API Vertex AI : cliquez sur « Enable ». Si la fenêtre ne s’affiche pas, cliquez sur « Enable all API permissions » pour faire de même.
Nous sommes maintenant prêts à téléverser un jeu de données dans Vertex AI.
Il existe plusieurs méthodes pour ajouter un jeu de données à Vertex AI. Ici, nous utiliserons un fichier CSV local pour faire simple.
Pour cet article, nous utiliserons le jeu de données Dry Bean du référentiel UCI Machine Learning. Il contient 13 000 observations de haricots et 15 mesures numériques associées.
L’objectif est de les classer en sept types : Seker, Barbunya, Bombay, Cali, Dermosan, Horoz et Sira.
Après le téléchargement, enregistrez le fichier Excel contenu dans l’archive ZIP dans votre répertoire local :
from pathlib import Path

cwd = Path.cwd()
data_path = cwd / "data" / "Dry_Bean_Dataset.xlsx"
Ensuite, nous pouvons lire ce fichier avec pandas et le réenregistrer en CSV :
import pandas as pd

beans = pd.read_excel(data_path)

beans.shape
(13611, 17)Notez que la fonction read_excel nécessite l’installation de la bibliothèque openpyxl via PIP.
Parfait, nous avons le dataset sous forme de DataFrame. Enregistrons‑le en CSV :
beans.to_csv(cwd / "data" / "dry_bean.csv", index=False)Comme mentionné plus haut, nous avons besoin d’un bucket Google Cloud Storage pour stocker nos données brutes. Suivez le GIF ci‑dessous pour accéder au tableau de bord du produit :
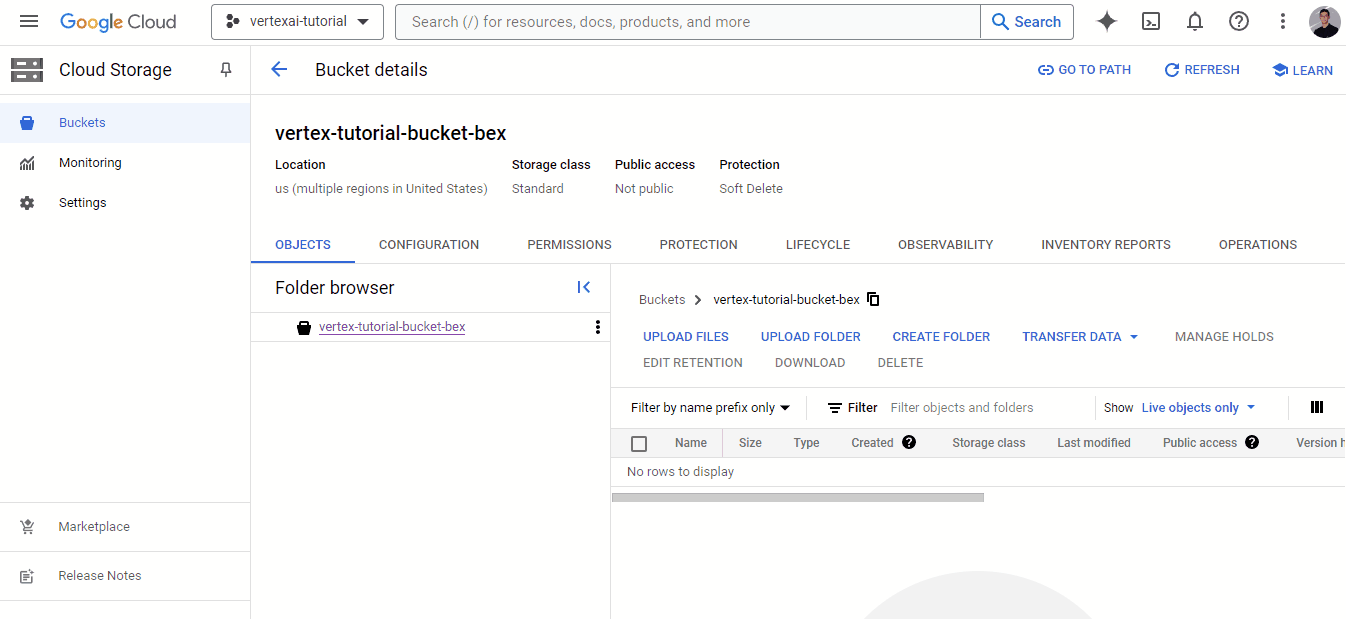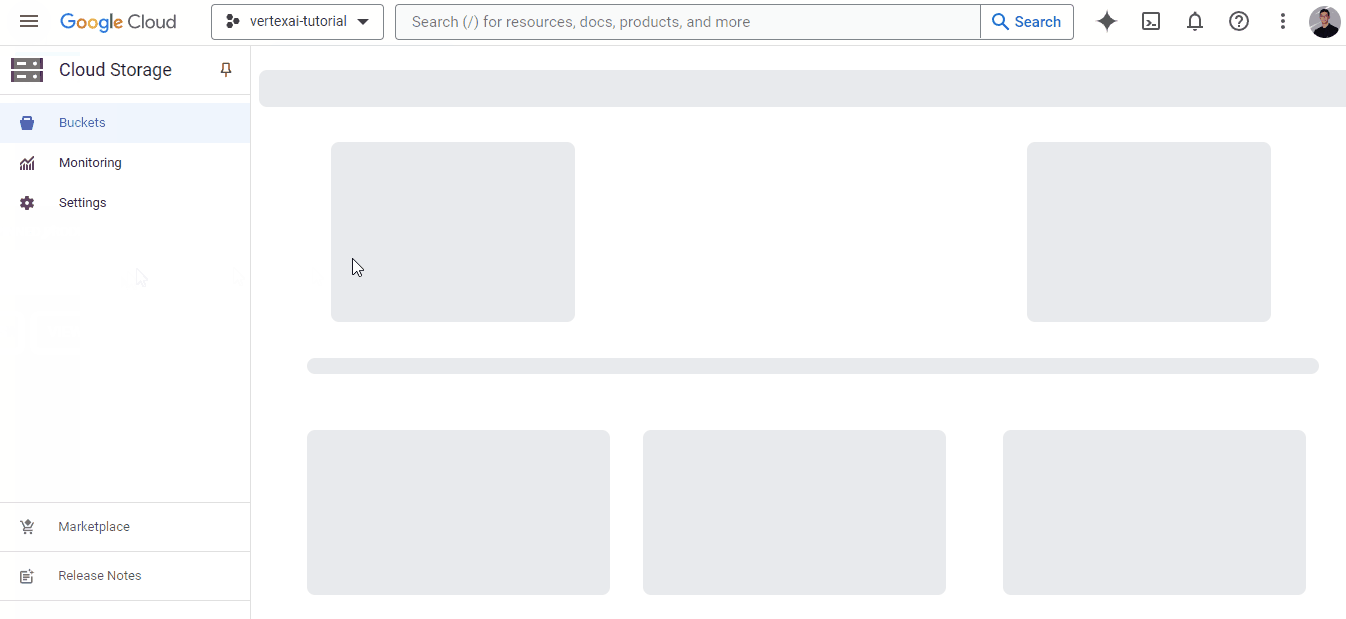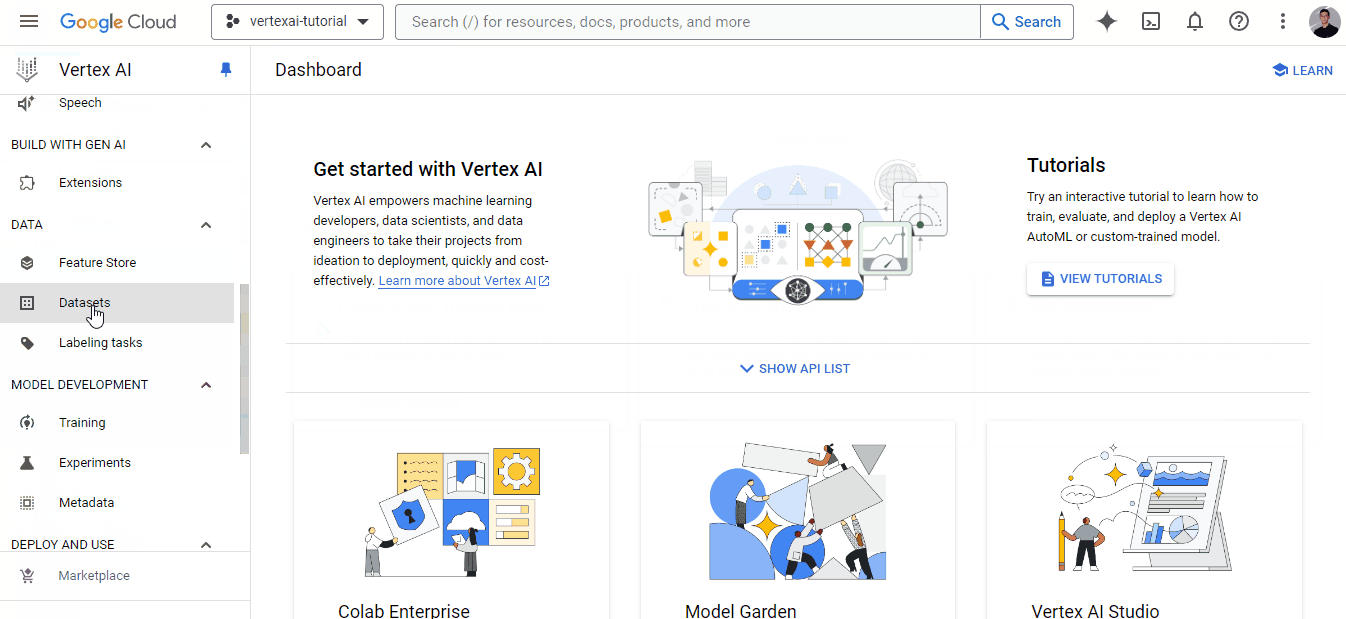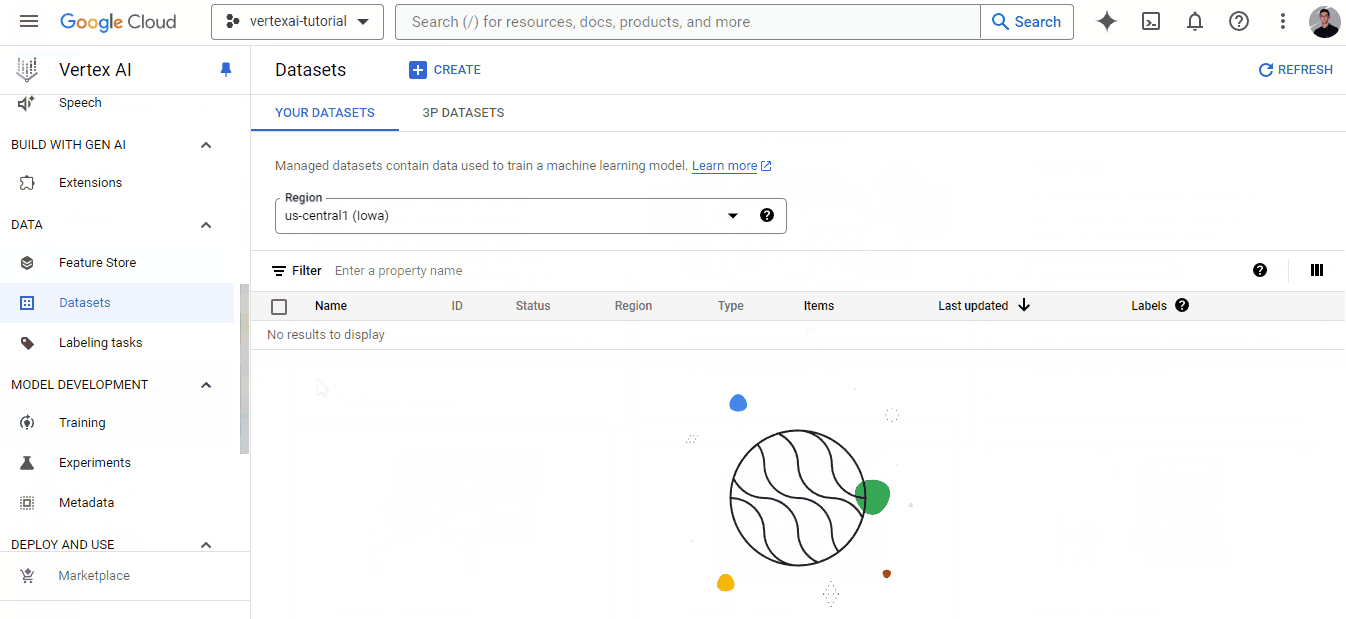
Le GIF montre que, pour commencer à utiliser les services de stockage, il faut lier un compte de facturation — utilisez celui créé plus tôt. Vous pourrez ensuite créer un bucket avec un nom unique à l’échelle mondiale :
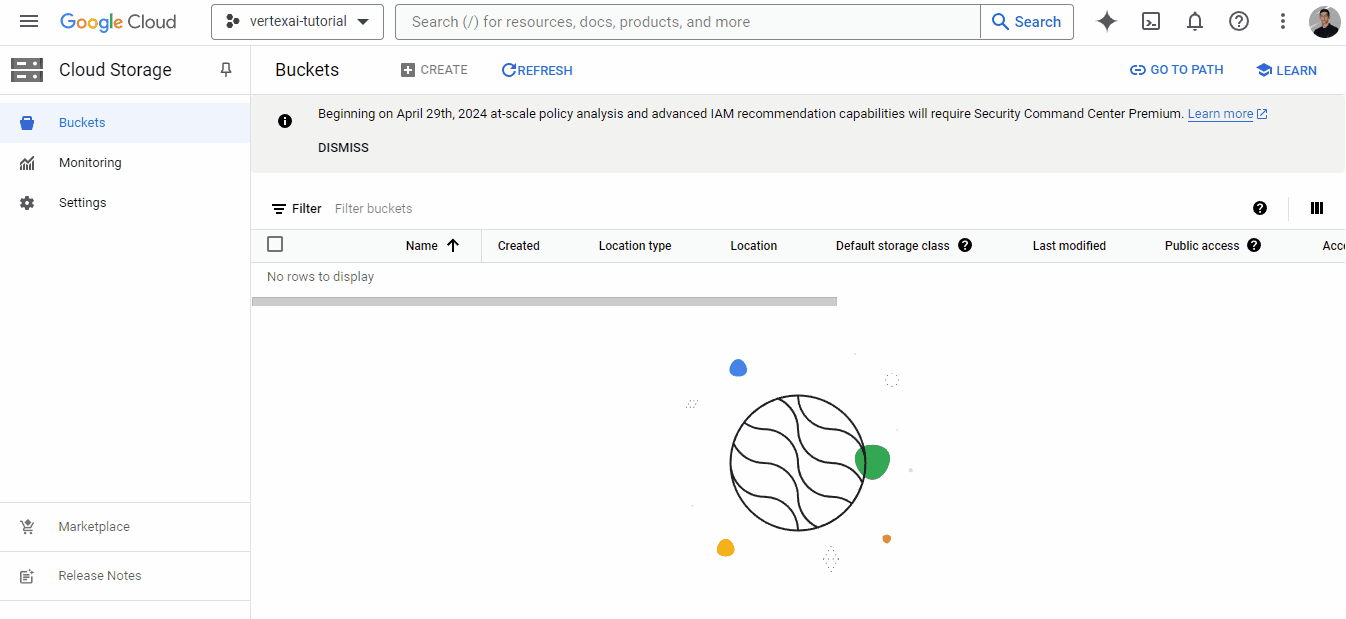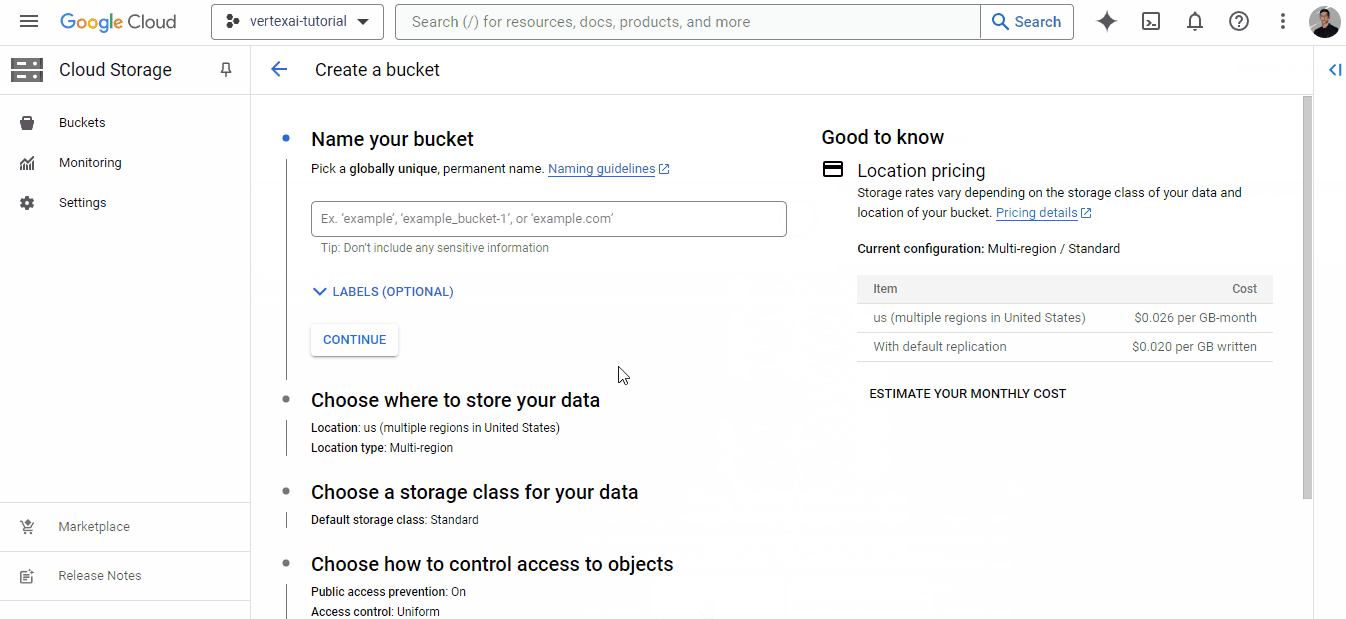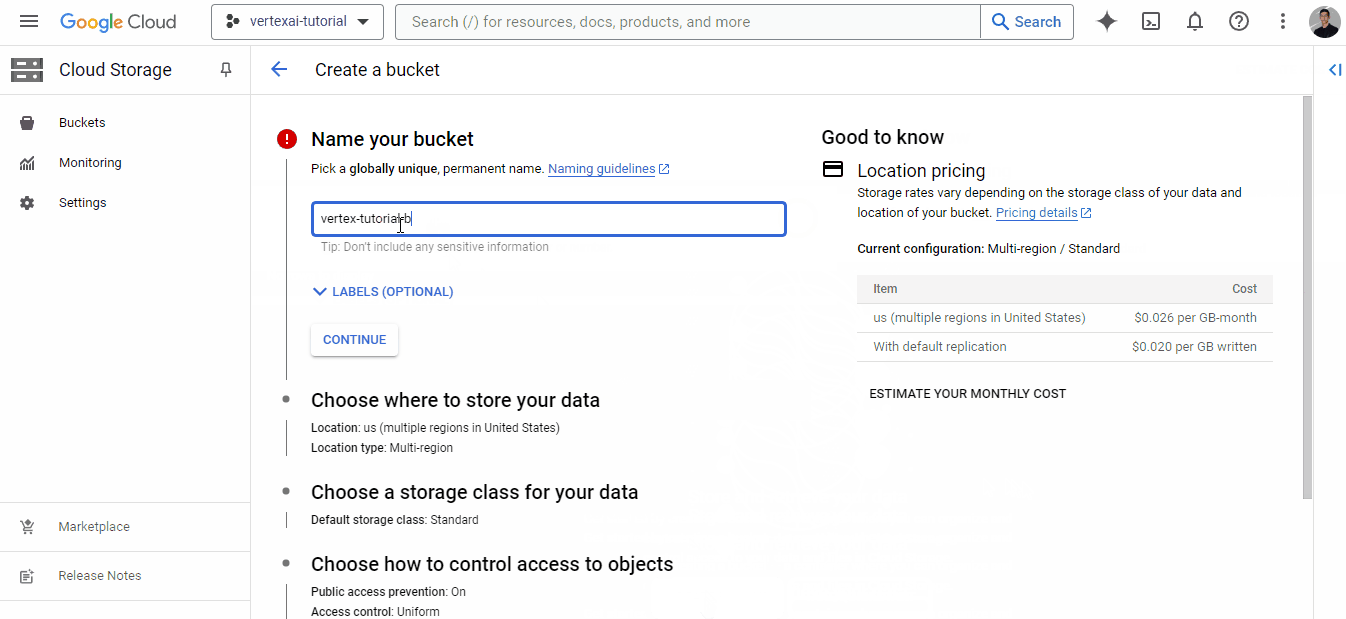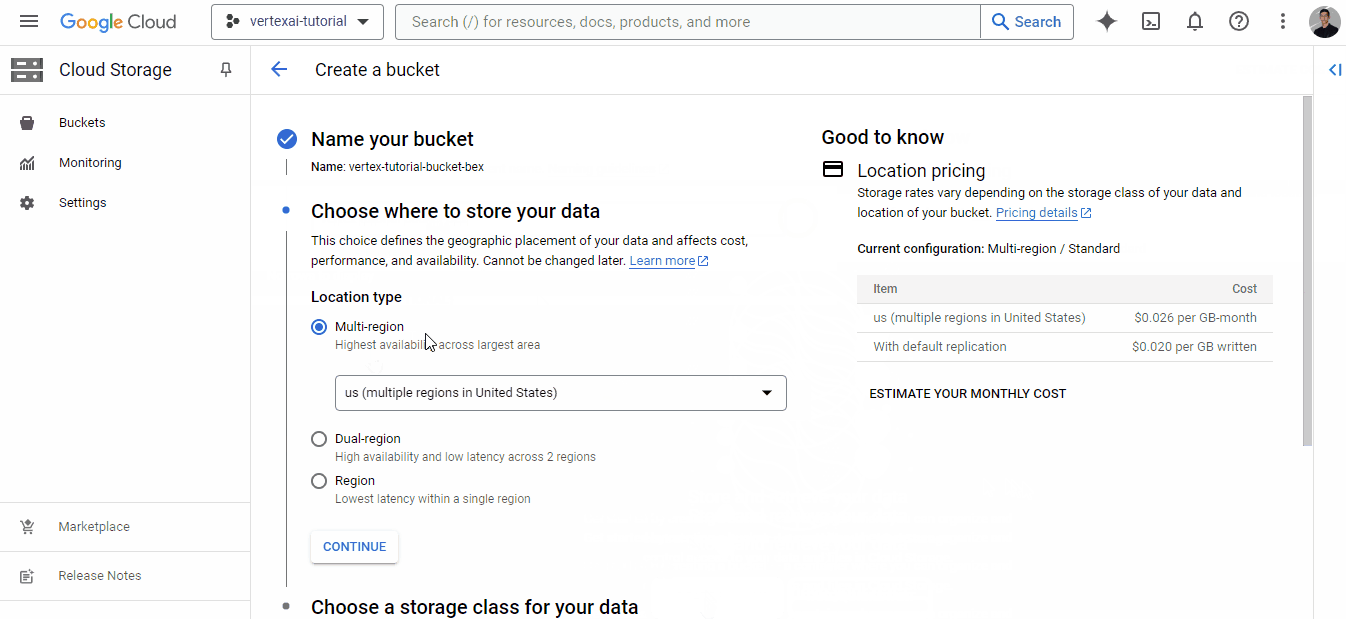
Une fois un nom unique trouvé, cliquez sur « Continue » jusqu’à la création du bucket — vous pouvez conserver les options par défaut pour tous les champs.
Nous sommes maintenant prêts à ingérer le fichier CSV enregistré à l’étape précédente.
Revenons au tableau de bord Vertex AI et ouvrez l’onglet Datasets :
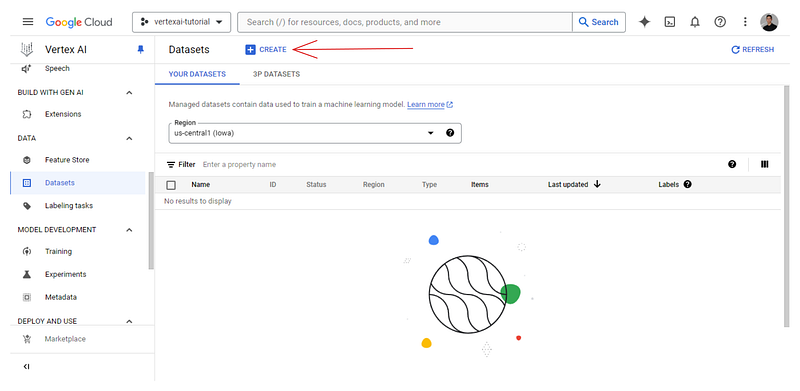
Il sera vide ; cliquez donc sur le bouton « +Create » :
Donnez un nom unique au dataset et choisissez l’option tabulaire :
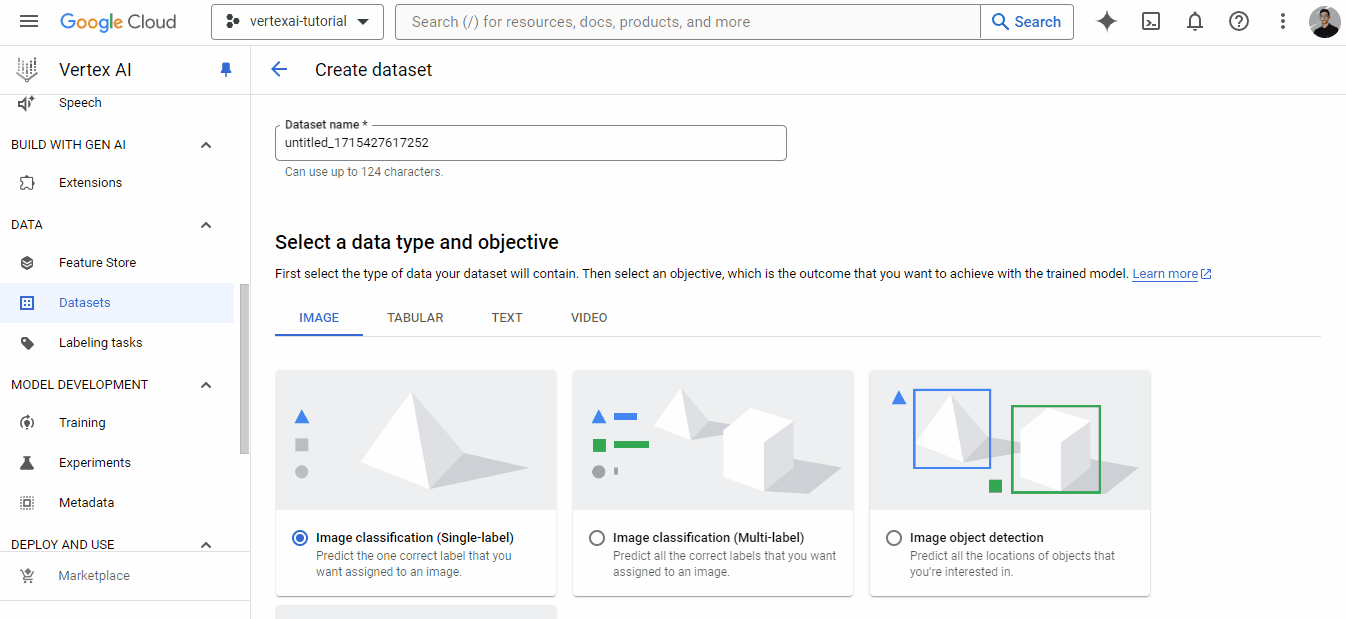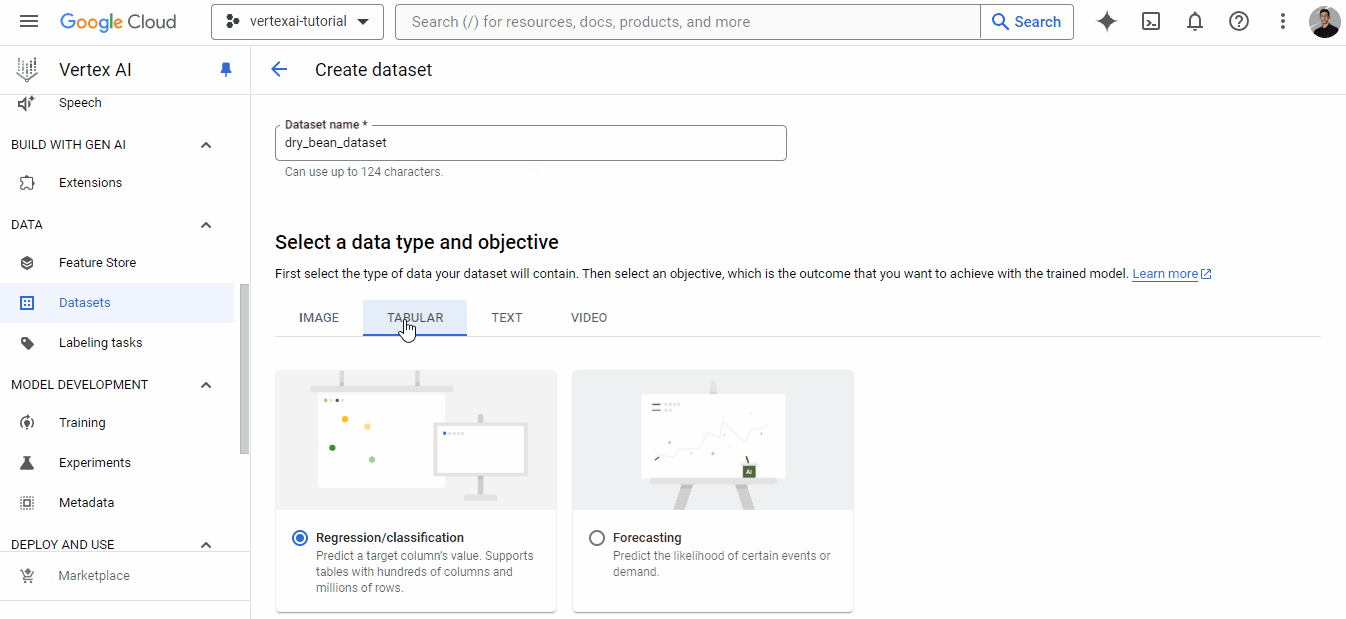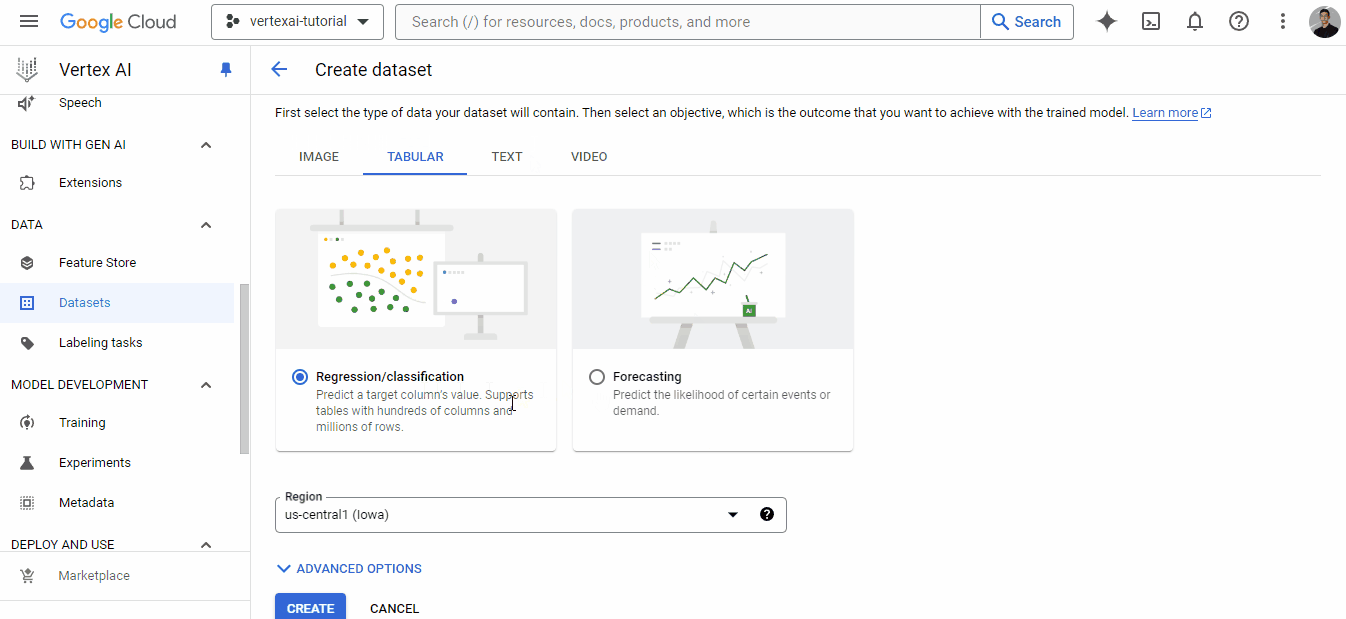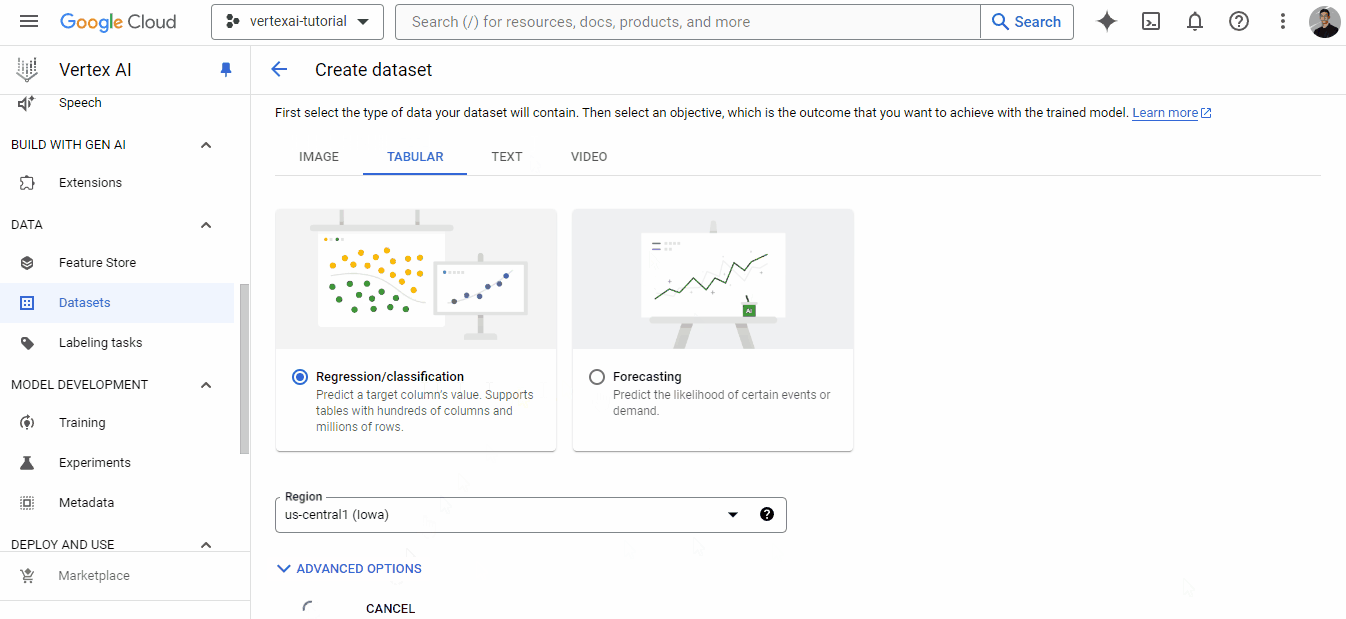
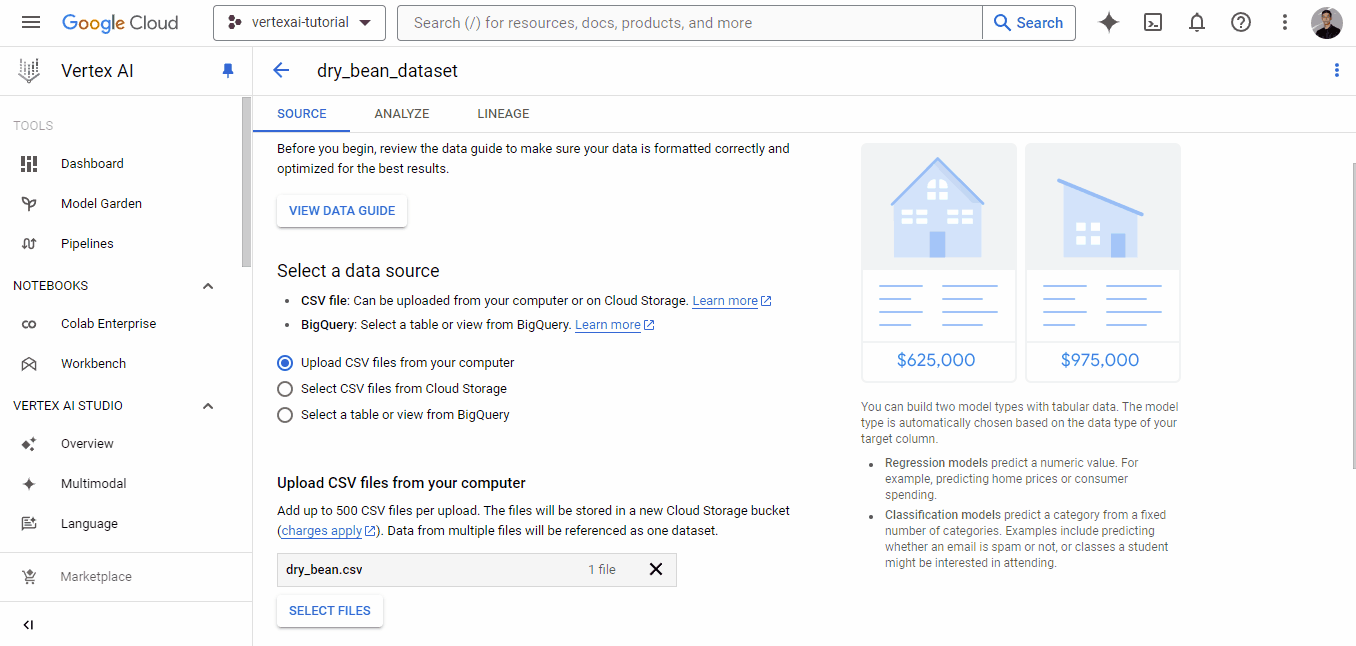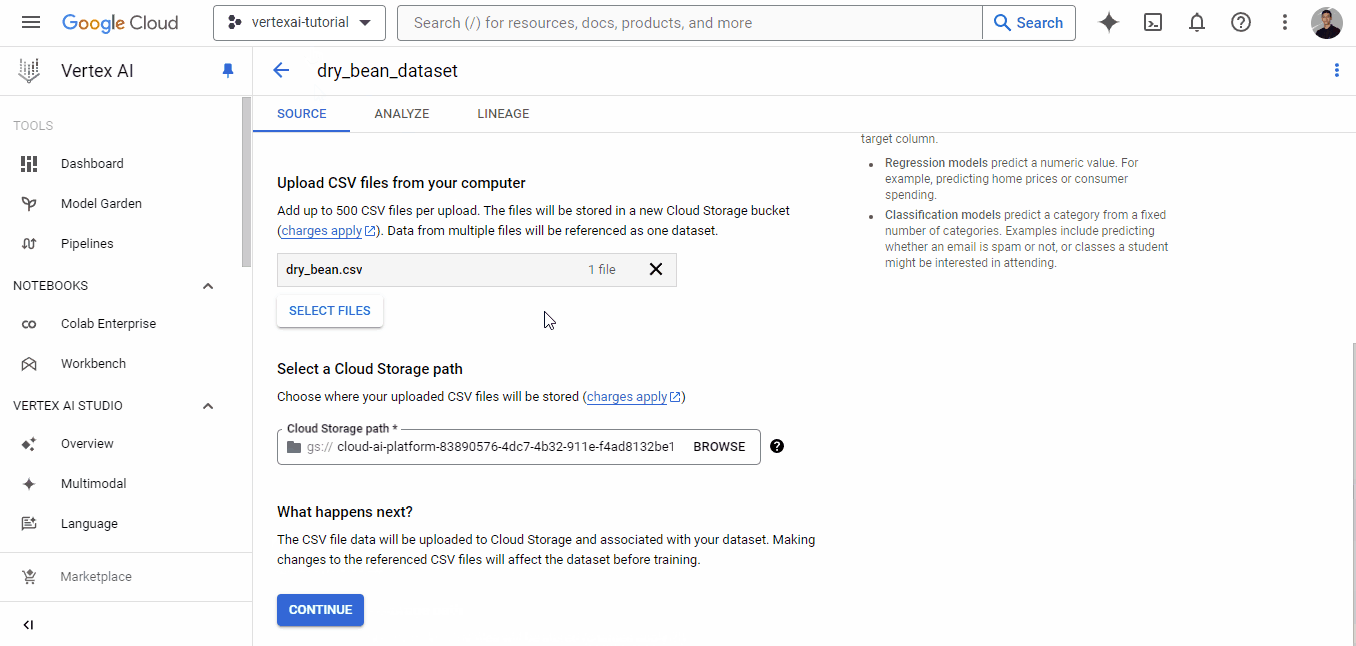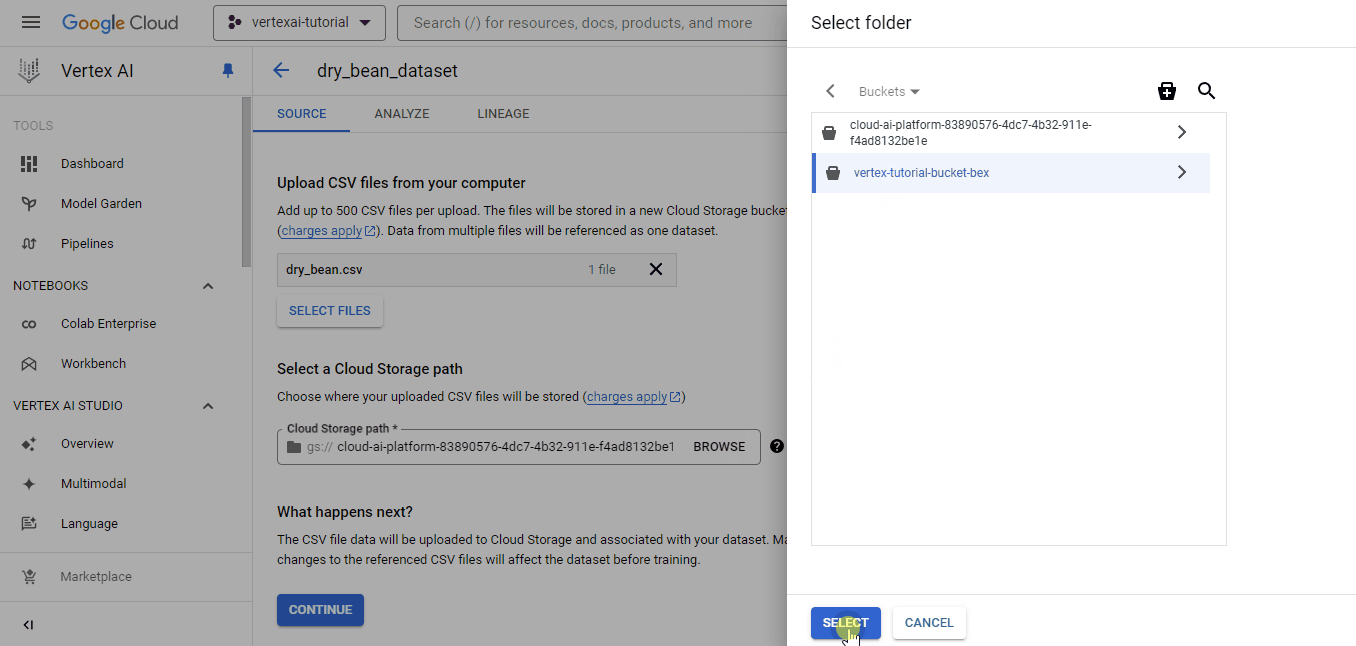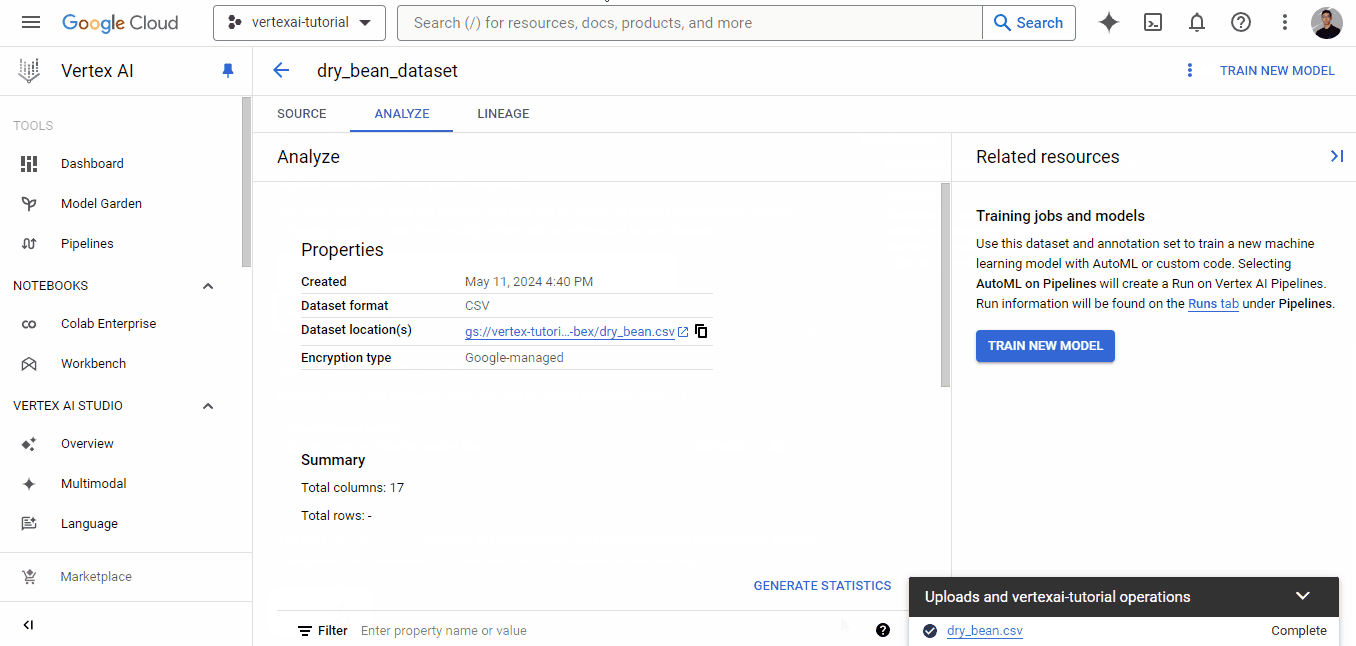
La plateforme vous propose ensuite les sources possibles. Choisissez d’uploader un fichier CSV local et, pour le chemin Cloud Storage, sélectionnez le bucket que vous venez de créer :
Une fois le dataset téléversé, vous verrez l’onglet « Analyze », qui affiche des métadonnées de base sur le fichier CSV. Vous verrez également un bouton « TRAIN NEW MODEL » pour lancer un entraînement AutoML.
Nous n’allons toutefois pas l’utiliser, car il s’adresse aux grands débutants en ML. Nous passerons plutôt par Vertex AI Workbench pour configurer un environnement JupyterLab et des ressources de calcul afin d’exécuter à la fois AutoML et des bibliothèques personnalisées.
Comme Vertex AI est une plateforme unifiée, elle propose aussi des environnements de développement, appelés workbenches. Pour créer un workbench, accédez à son onglet dédié et suivez les instructions du GIF ci‑dessous :
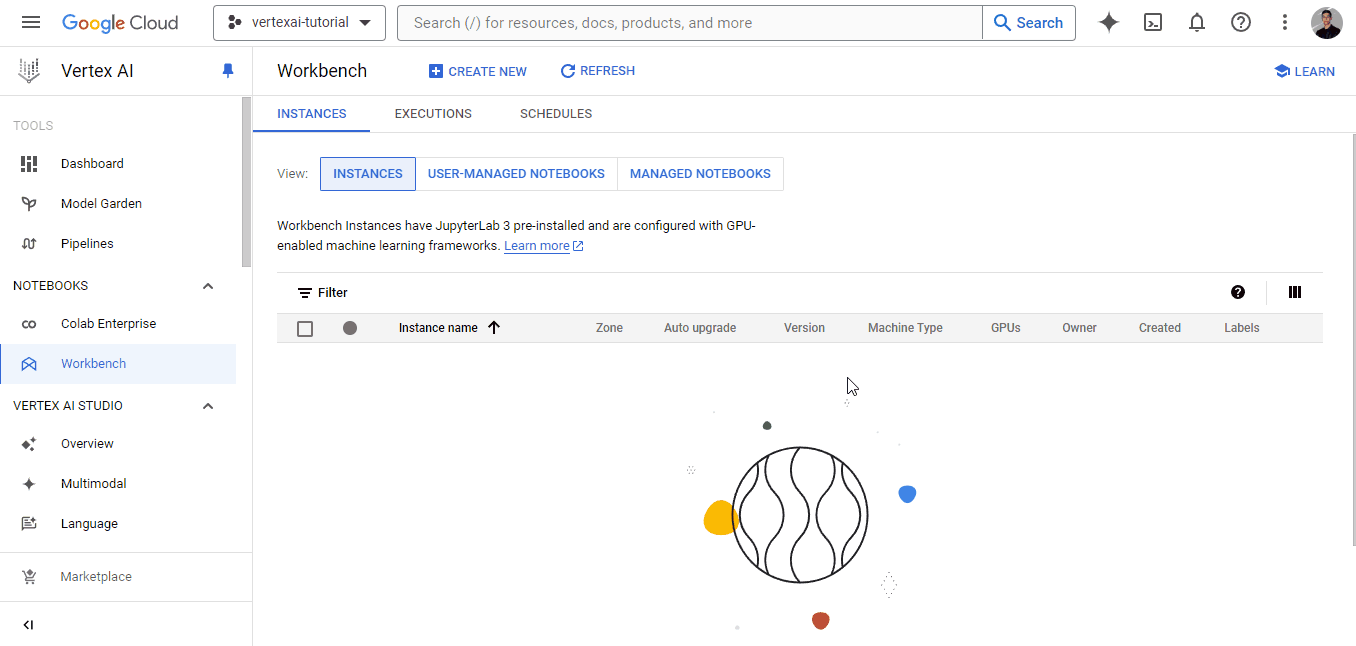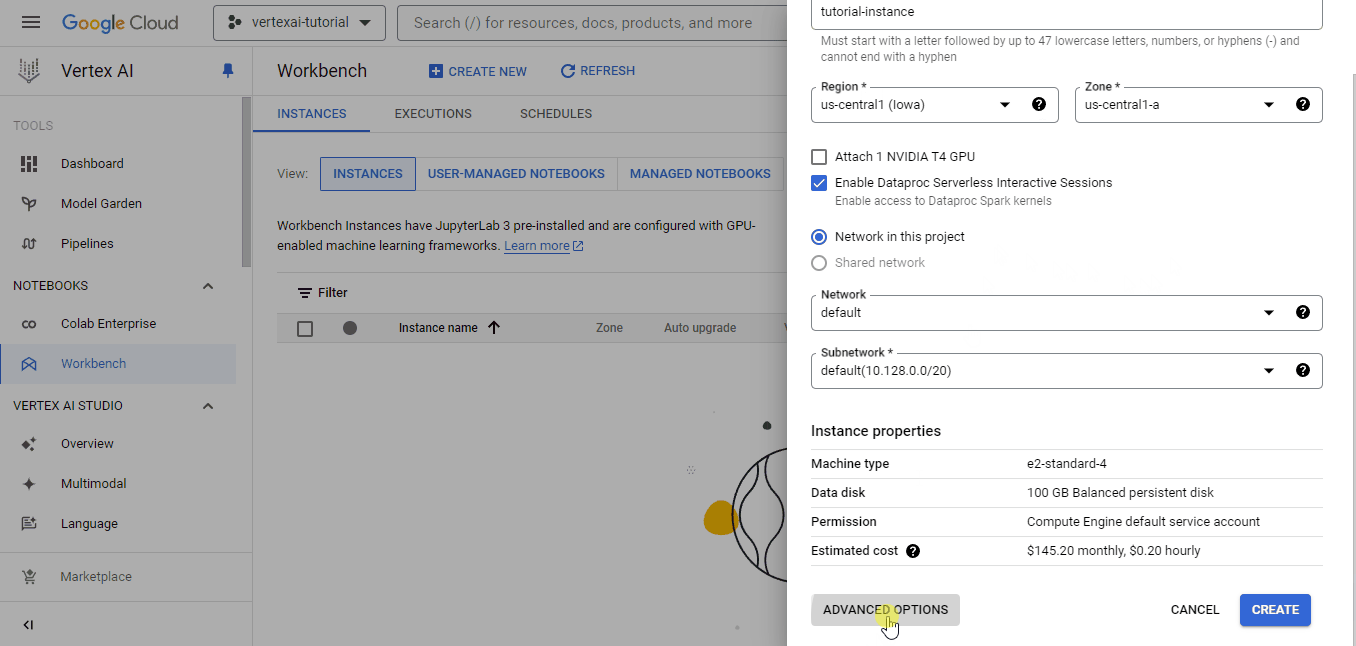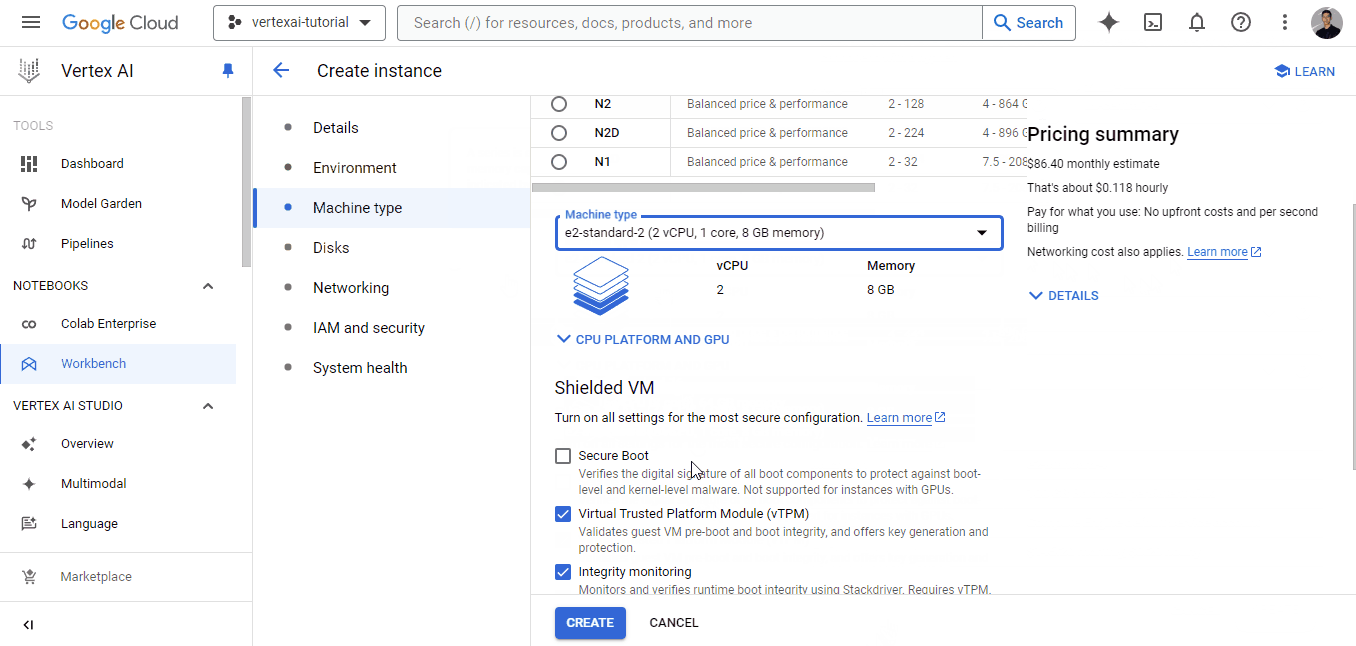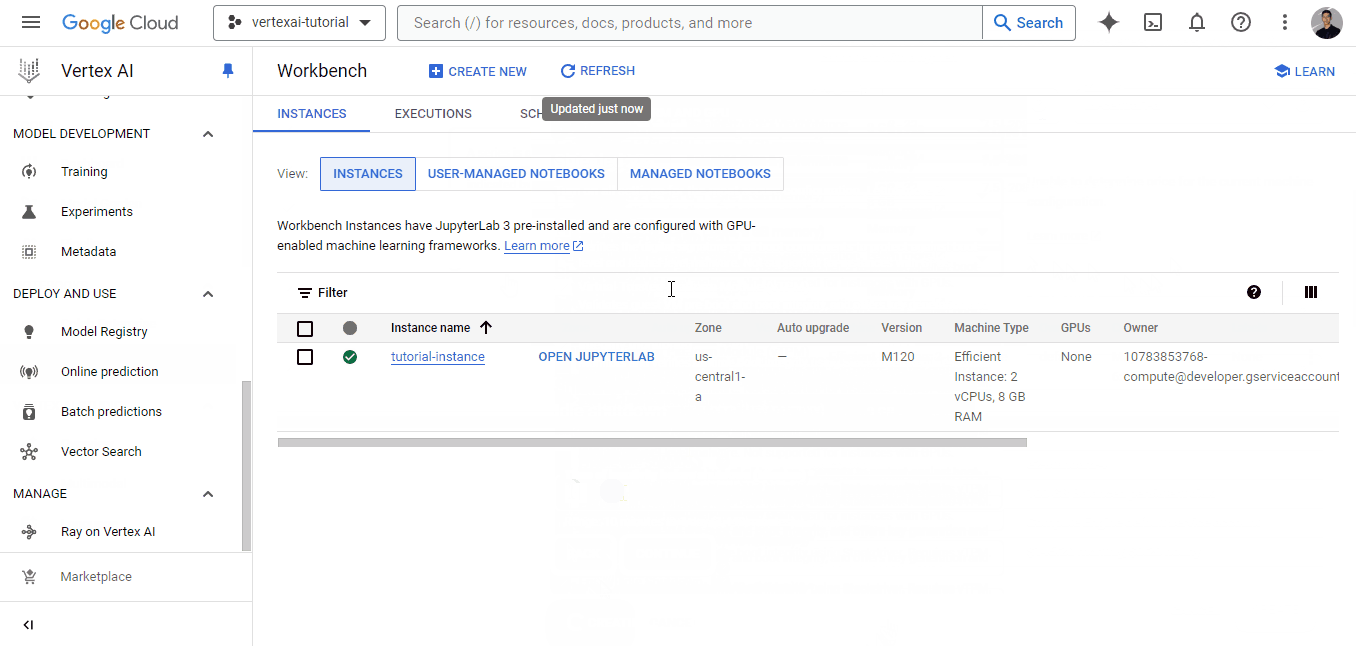
Chaque workbench est livré avec JupyterLab 3 préinstallé. Vous n’avez donc qu’à configurer le matériel en fonction de votre budget et de vos besoins. Notre dataset étant assez petit, j’ai choisi l’instance la plus modeste pour l’exemple, à ~0,12 $ de l’heure (je vous conseille une machine avec plus de cœurs CPU pour accélérer les calculs).
J’ai aussi réduit l’arrêt automatique à 10 minutes pour que l’environnement se coupe si j’oublie de le fermer.
L’initialisation du workbench prend quelques minutes. Une fois prête, le bouton « OPEN JUPYTERLAB » apparaît ; cliquez‑dessus :
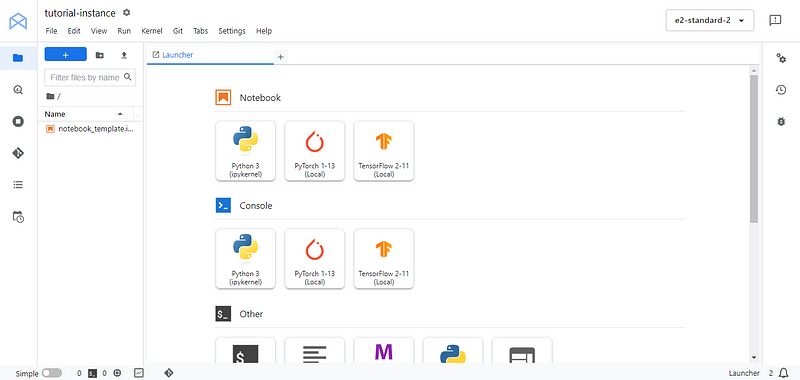
Vous retrouvez l’interface familière de JupyterLab. Créez un nouveau notebook Python 3 et renommez‑le comme vous le souhaitez. Dans la première cellule, installez/mettez à jour le SDK des services Google Cloud google-cloud-aiplatform :
!pip3 install --upgrade --quiet google-cloud-aiplatform
Puis, listez les projets disponibles avec gcloud config list :
!gcloud config list
[compute]
region = us-central1
[core]
account = # HIDDEN #
disable_usage_reporting = True
project = vertexai-tutorial-423010
[dataproc]
region = us-central1

Your active configuration is: [default]
gcloud et gsutil sont deux utilitaires de terminal disponibles dans tous les workbenches. Ils permettent de gérer efficacement vos services Google Cloud.
À partir de la sortie, enregistrez les informations suivantes dans des variables Python :
PROJECT_ID = 'vertexai-tutorial-423010'
BUCKET_URI = 'gs://vetex-tutorial-bucket-bex'
REGION = 'us-central1'
N’oubliez pas d’adapter BUCKET_URI au nom de votre bucket. Ensuite, importez le sous‑module aiplatform et initialisez‑le :
from google.cloud import aiplatform as ai

ai.init(project=PROJECT_ID, location=REGION, staging_bucket=BUCKET_URI)
aiplatform servira de SDK pour interagir avec les fonctionnalités Vertex AI.
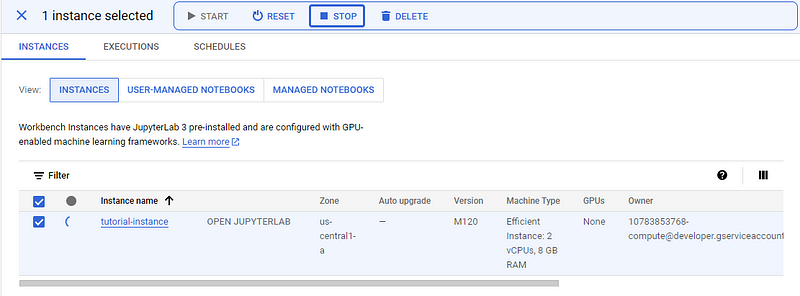
Lorsque vous terminez le tutoriel ou faites une pause, n’oubliez pas d’ARRÊTER l’instance pour éviter des coûts inattendus.
Passons à l’entraînement avec AutoML qui, comme mentionné, prend en charge la majeure partie du travail et renvoie le meilleur modèle possible pour le dataset fourni. Pour tirer pleinement parti d’AutoML, veillez à la qualité des données en entrée. Il peut donc être pertinent de consacrer du temps à l’ingénierie de variables et au prétraitement en amont.
AutoML prétraite le jeu de données en interne, mais ne peut pas corriger tous les problèmes de qualité.
Dans cette section, nous allons néanmoins entraîner un modèle de base AutoML, sans prétraitement ni feature engineering, pour rester concis.
Commençons par charger le CSV depuis notre bucket et par l’explorer brièvement. Rappelez‑vous : l’EDA est une étape clé — pour aller plus loin, consultez notre cours Exploratory Data Analysis in Python !
import pandas as pd

# Path to your CSV file in GCS bucket
gcs_path = "gs://vertex-tutorial-bucket-bex/dry_bean.csv"

beans = pd.read_csv(gcs_path)

beans.head()

Bonne nouvelle : pandas sait lire des fichiers depuis des chemins GCS. Seule contrainte, le code ci‑dessus ne fonctionne que dans les workbenches Vertex AI, déjà authentifiés avec vos identifiants Google Cloud.
Nous n’allons pas approfondir l’analyse, pour ne pas nous éloigner du cœur du sujet. Contentons‑nous de quelques statistiques et graphiques :
beans.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 13611 entries, 0 to 13610
Data columns (total 17 columns):
#   Column           Non-Null Count  Dtype
---  ------           --------------  -----
0   Area             13611 non-null  int64
1   Perimeter        13611 non-null  float64
2   MajorAxisLength  13611 non-null  float64
3   MinorAxisLength  13611 non-null  float64
4   AspectRation     13611 non-null  float64
5   Eccentricity     13611 non-null  float64
6   ConvexArea       13611 non-null  int64
7   EquivDiameter    13611 non-null  float64
8   Extent           13611 non-null  float64
9   Solidity         13611 non-null  float64
10  roundness        13611 non-null  float64
11  Compactness      13611 non-null  float64
12  ShapeFactor1     13611 non-null  float64
13  ShapeFactor2     13611 non-null  float64
14  ShapeFactor3     13611 non-null  float64
15  ShapeFactor4     13611 non-null  float64
16  Class            13611 non-null  object
dtypes: float64(14), int64(2), object(1)
memory usage: 1.8+ MB
Nous avons donc 15 variables numériques et une seule colonne cible — Class. Environ 13 k lignes et aucune valeur manquante : cela simplifie nettement l’entraînement.
Enregistrons les noms de variables dans une liste, au cas où :
feature_names = beans.columns.tolist()
Traçons maintenant une pair‑plot de quelques variables importantes :
import seaborn as sns

sns.pairplot(
   beans,
   vars=["Area", "MajorAxisLength", "MinorAxisLength", "Eccentricity", "roundness"],
   hue="Class",
);
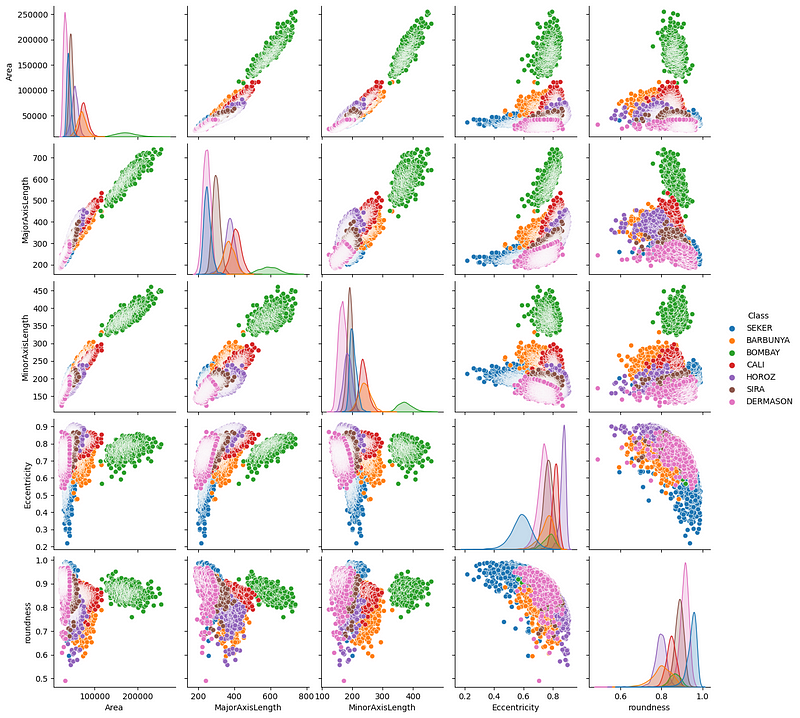
On observe quelques tendances intéressantes : notamment, les haricots Bombay (en vert) semblent nettement séparés des autres sur certaines mesures physiques.
Traçons aussi une matrice de corrélation :
import matplotlib.pyplot as plt

correlation = beans.corr(numeric_only=True)

# Create a square heatmap with center at 0
sns.heatmap(correlation, center=0, square=True, cmap="coolwarm", vmin=-1, vmax=1)

plt.show()
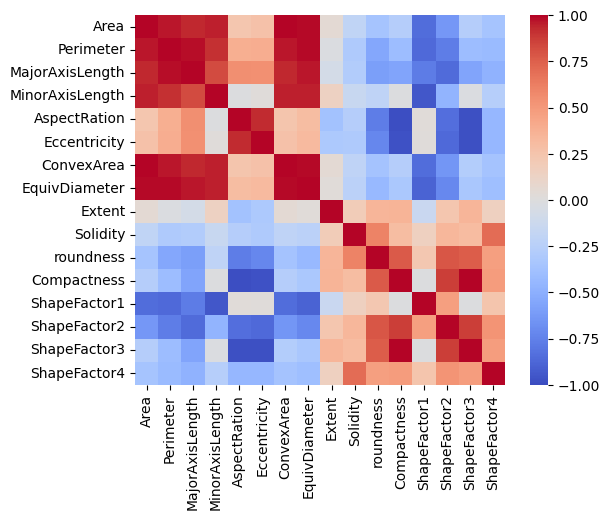
Certaines variables sont presque parfaitement corrélées, ce qui est logique étant donné qu’il s’agit de mesures physiques. D’autres paires montrent peu ou pas de corrélation.
À ce stade, à vous de poursuivre l’exploration et de formuler des questions à tester sur ce dataset.
Pour démarrer un entraînement AutoML, nous avons d’abord besoin d’un objet dataset compatible :
ds = ai.TabularDataset.create(
   display_name="dry_bean_dataset", gcs_source=gcs_path
)
TabularDataset created.
type(ds)google.cloud.aiplatform.datasets.tabular_dataset.TabularDataset
ds.resource_name
'projects/10783853768/locations/us-central1/datasets/4978116960081412096'
Nous utilisons la méthode TabularDataset.create pour l’initialiser (ds). Vertex AI lui attribue un identifiant accessible via l’attribut resource_name.
Initialisons maintenant le job avec la classe ai.AutoMLTabularTrainingJob. Elle requiert deux arguments :
job = ai.AutoMLTabularTrainingJob(
   display_name="dry-bean-classification",
   optimization_prediction_type="classification",
)
Ensuite, lançons la méthode run du job :
model = job.run(
   dataset=ds,
   target_column="Class",
   training_fraction_split=0.8,
   validation_fraction_split=0.1,
   test_fraction_split=0.1,
   model_display_name="baseline-classification-model",
   disable_early_stopping=False,
)
Les paramètres sont assez explicites. L’exécution demandera un certain temps (selon la puissance de calcul).
Dans l’onglet « MODEL DEVELOPMENT > TRAINING » du tableau de bord, en cliquant sur le nom du job, vous suivez la progression en direct. L’image ci‑dessous montre l’étape de prétraitement :
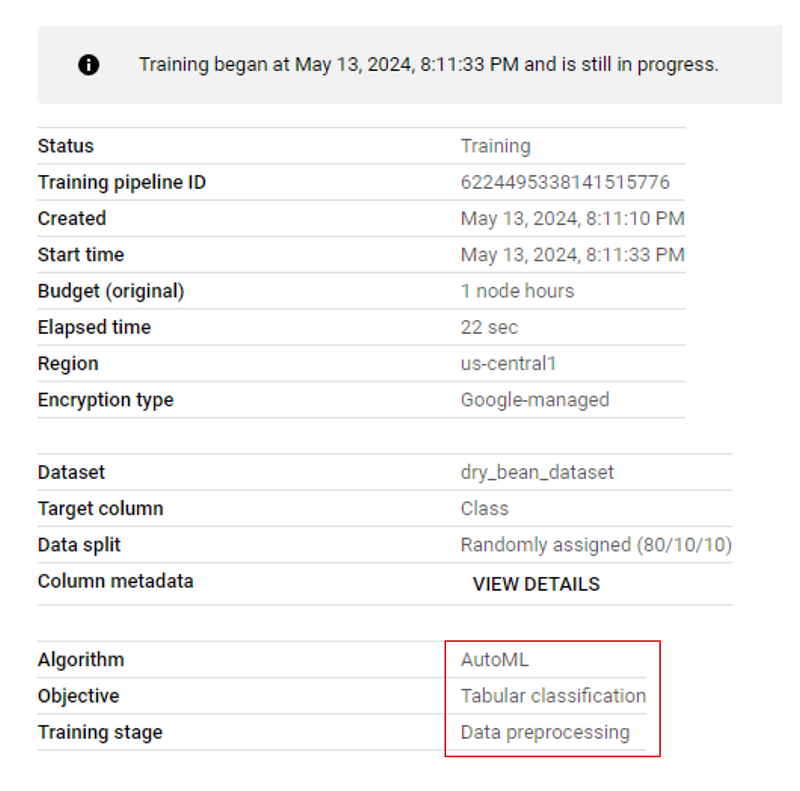
Une fois l’entraînement terminé, retournez dans l’onglet training et cliquez sur le nom du modèle. Vous verrez cette fois les métriques de performance associées :
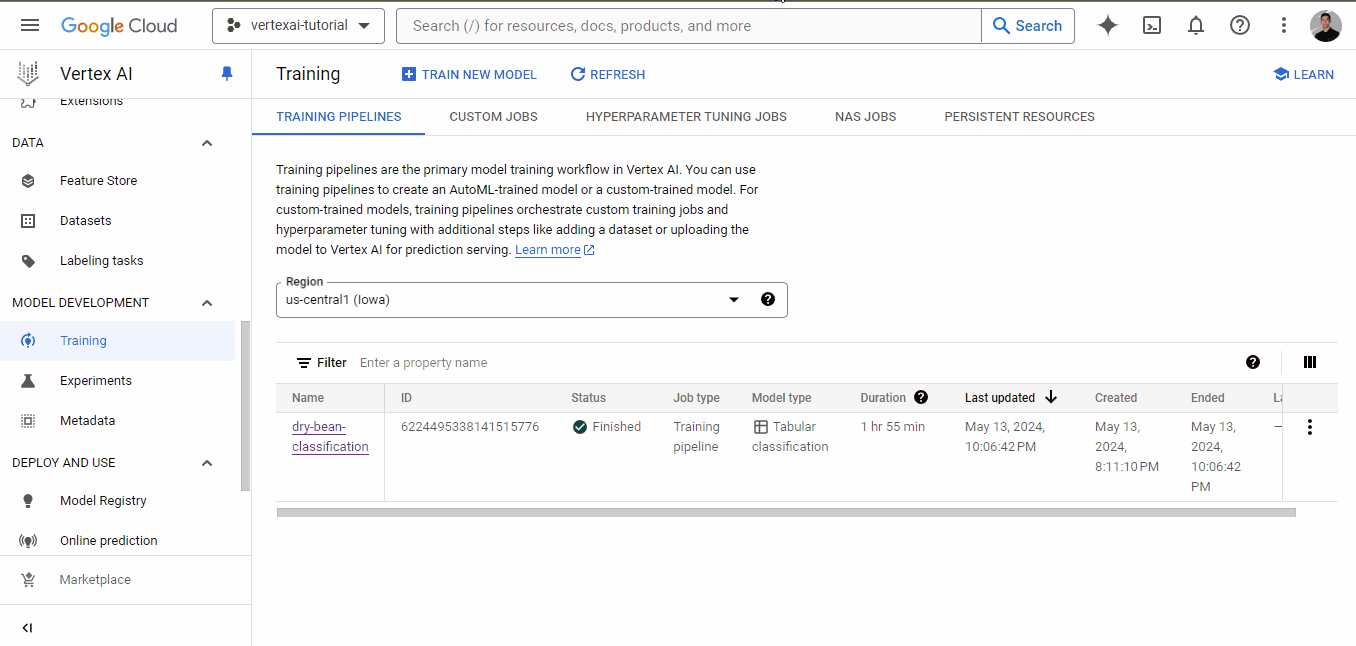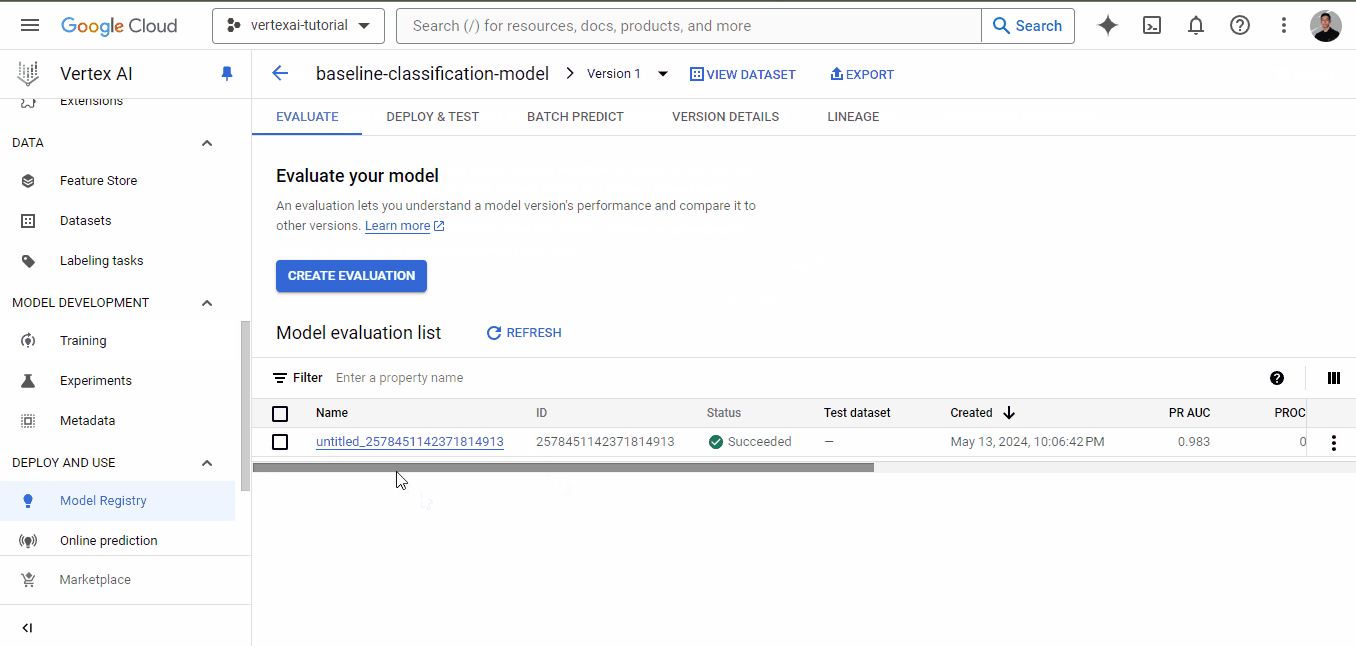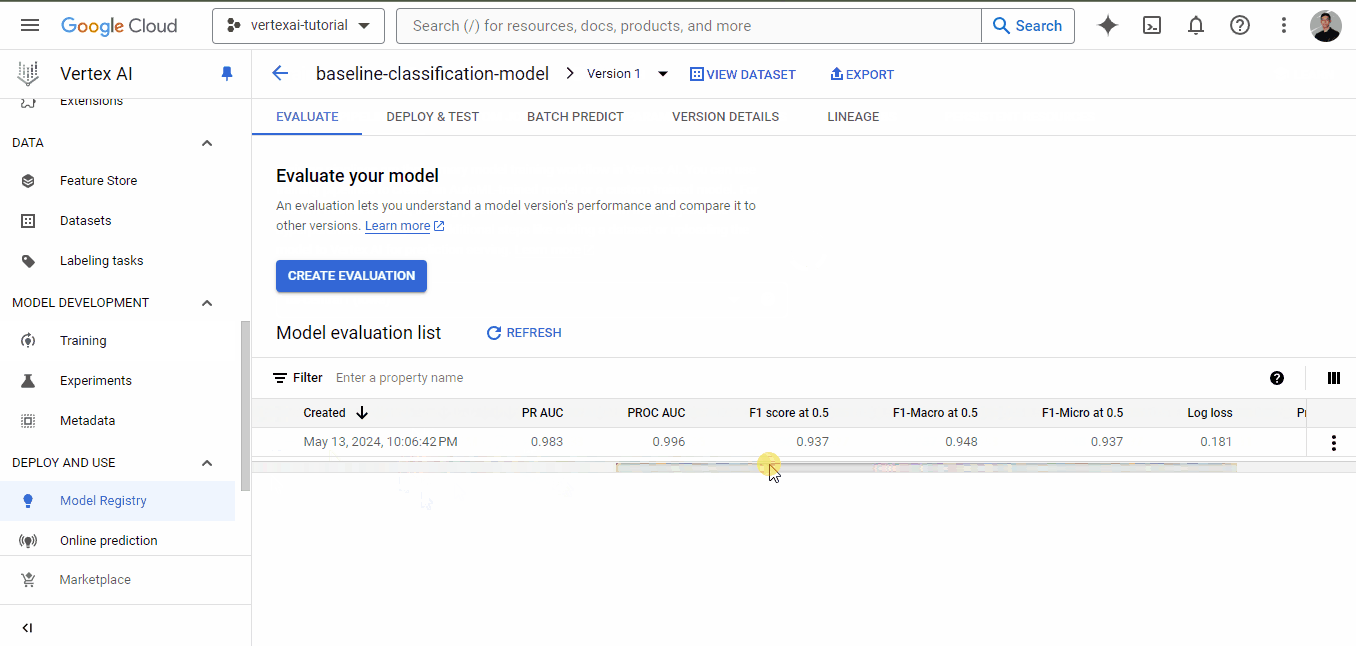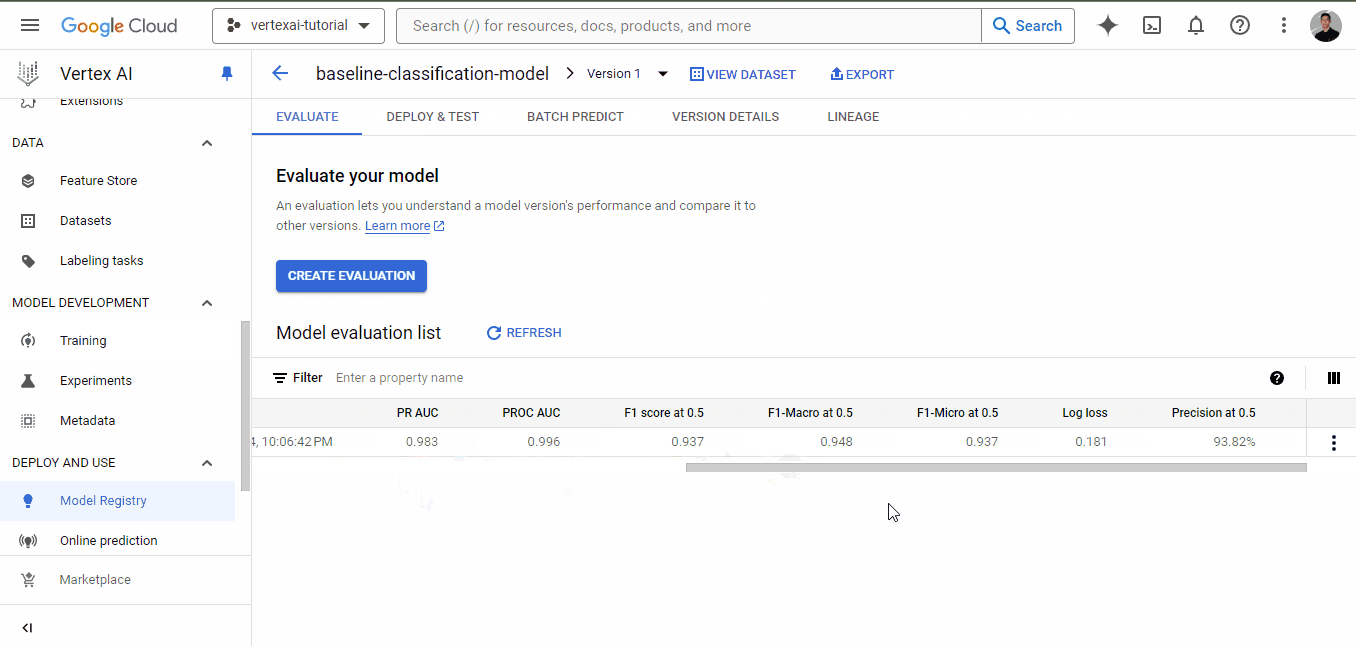
Comme vous le voyez, même pour un modèle de base, les métriques sont très bonnes, toutes au‑dessus de 0,90.
Nous pouvons maintenant déployer ce model en une seule ligne :
endpoint = model.deploy(machine_type="n1-standard-4")
La méthode deploy ne requiert qu’un argument : le type de machine pour l’inférence. Je ne vais pas exécuter cette ligne ici, car le déploiement engendre des coûts tant que le modèle reste en ligne.
Cependant, si vous la lancez, la méthode deploy renvoie un objet Endpoint auquel vous pouvez envoyer des requêtes :
prediction = endpoint.predict(
   [
       {
           "Area": "30099",
           "Perimeter": "638.8209999999999",
           "MajorAxisLength": "237.14191130827916",
           "MinorAxisLength": "162.3034300714102",
           "AspectRation": "1.4611022774068396",
           "Eccentricity": "0.7290928631259719",
           "ConvexArea": "30477",
           "EquivDiameter": "195.76321681302556",
           "Extent": "0.8036043251902283",
           "Solidity": "0.9875972044492568",
           "roundness": "0.9268374259664279",
           "Compactness": "0.8255108332939839",
           "ShapeFactor1": "0.007878730566074592",
           "ShapeFactor2": "0.002256976927384019",
           "ShapeFactor3": "0.6814681358857279",
           "ShapeFactor4": "0.9956946453228307",
       }
   ]
)

print(prediction)
Il expose une méthode predict qui accepte une liste d’échantillons à prédire. Les échantillons doivent être fournis en JSON.
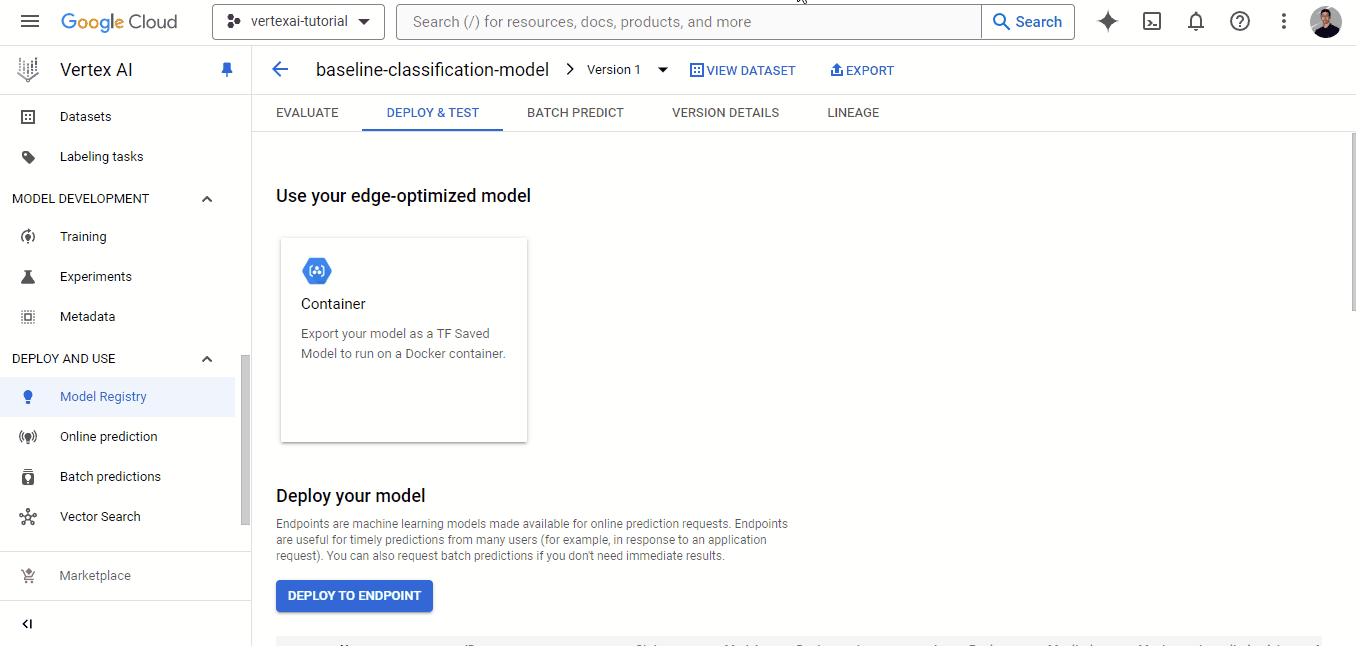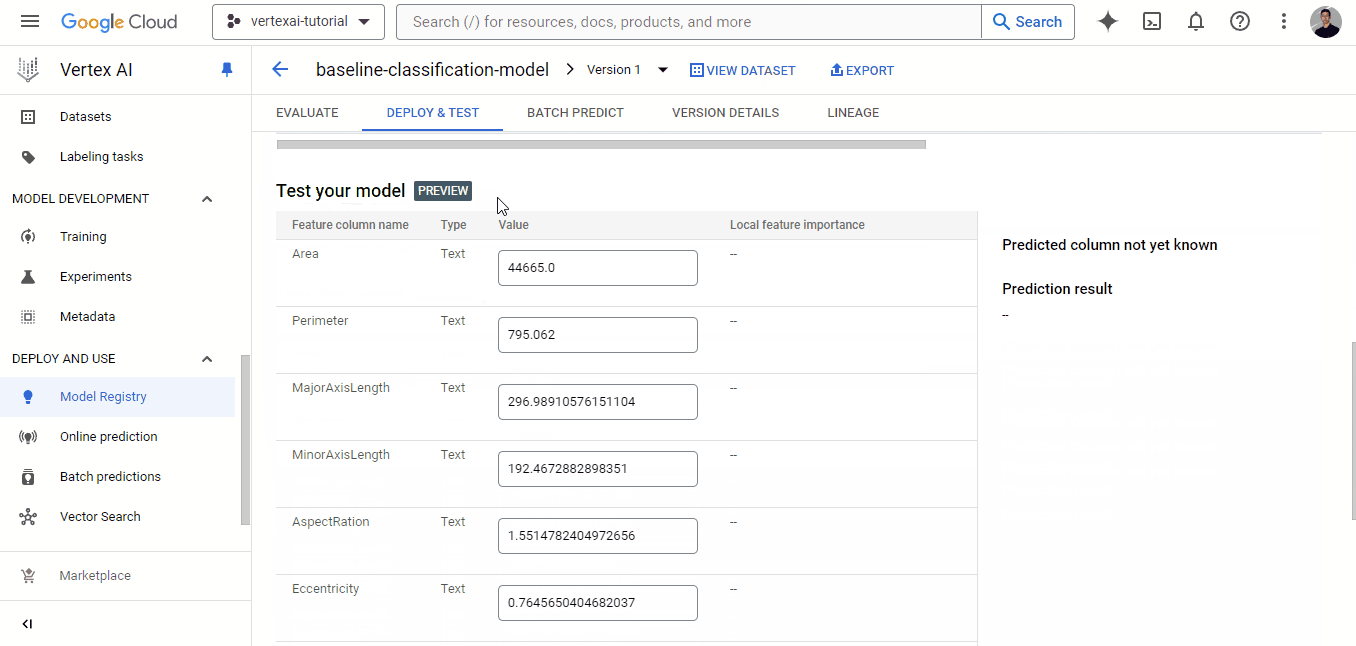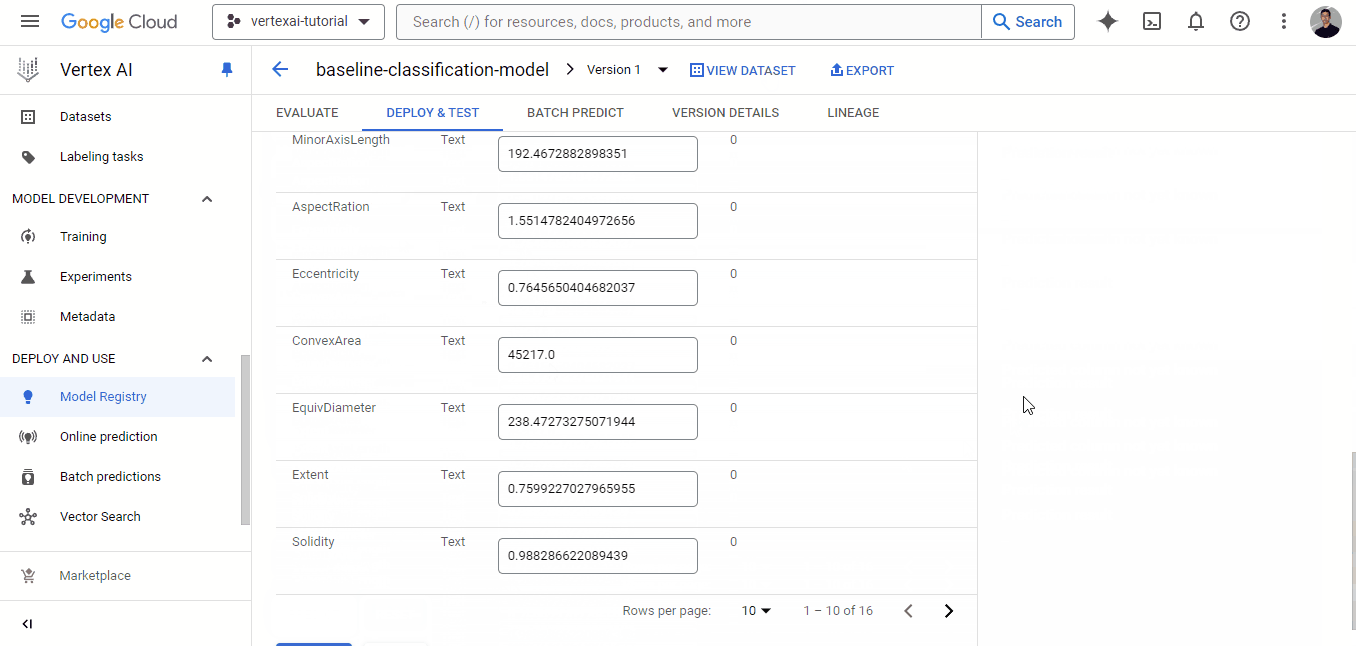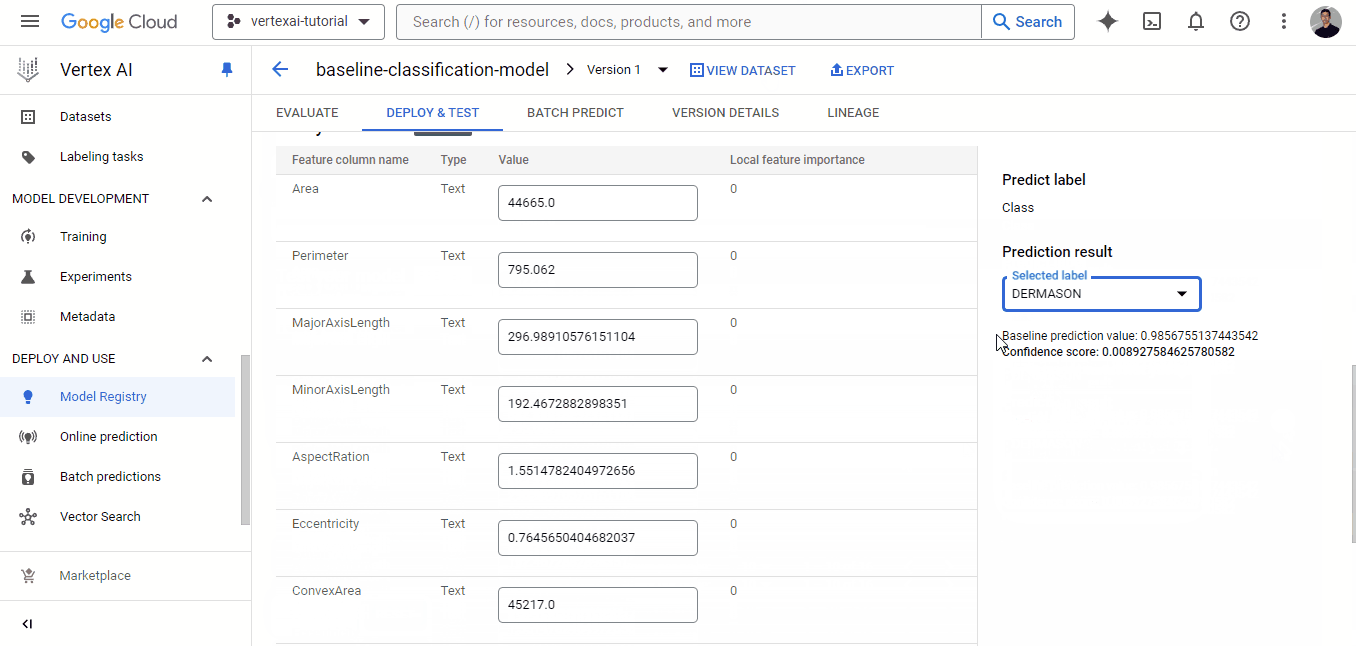
Vous pouvez également déployer via le tableau de bord. Dans l’onglet « MODEL REGISTRY », le modèle y figure. Cliquez sur son nom et ouvrez l’onglet « DEPLOY & TEST » :
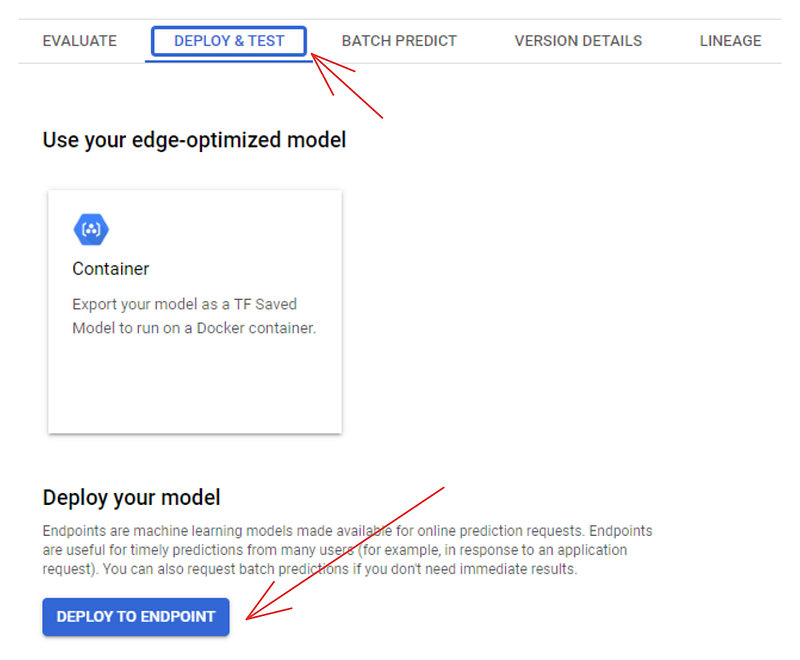
En cliquant sur « DEPLOY TO ENDPOINT », vous accédez à une page pour configurer la machine de déploiement. Avant cela, vous pouvez tester le modèle dans la zone située sous le bouton de déploiement :
Le déploiement de modèles personnalisés dans Vertex AI est plus exigeant que celui des modèles AutoML, et aussi plus coûteux, car il implique des conteneurs Docker en plus des coûts du Workbench et du déploiement. Si vous êtes partant, c’est parti !
Le custom training commence par un script d’entraînement sur mesure. Dans ce script, vous pouvez tout faire, à condition de :
Ce script d’entraînement doit ensuite être encapsulé dans un conteneur Docker et poussé vers Google Container Registry. À partir de là, on peut utiliser le SDK Python Vertex AI ou le tableau de bord pour lancer l’entraînement personnalisé.
Commençons par créer la structure de répertoires recommandée par ce codelab de Google. Dans votre workbench, ouvrez un terminal via un nouveau launcher :
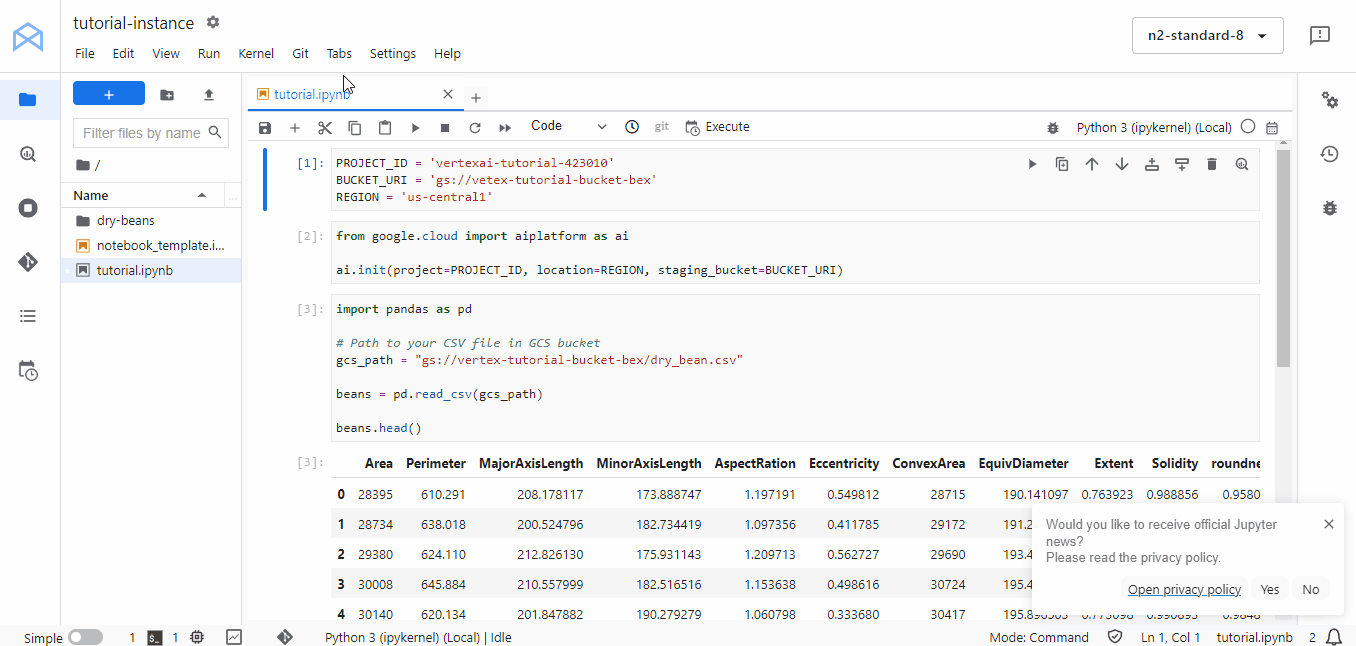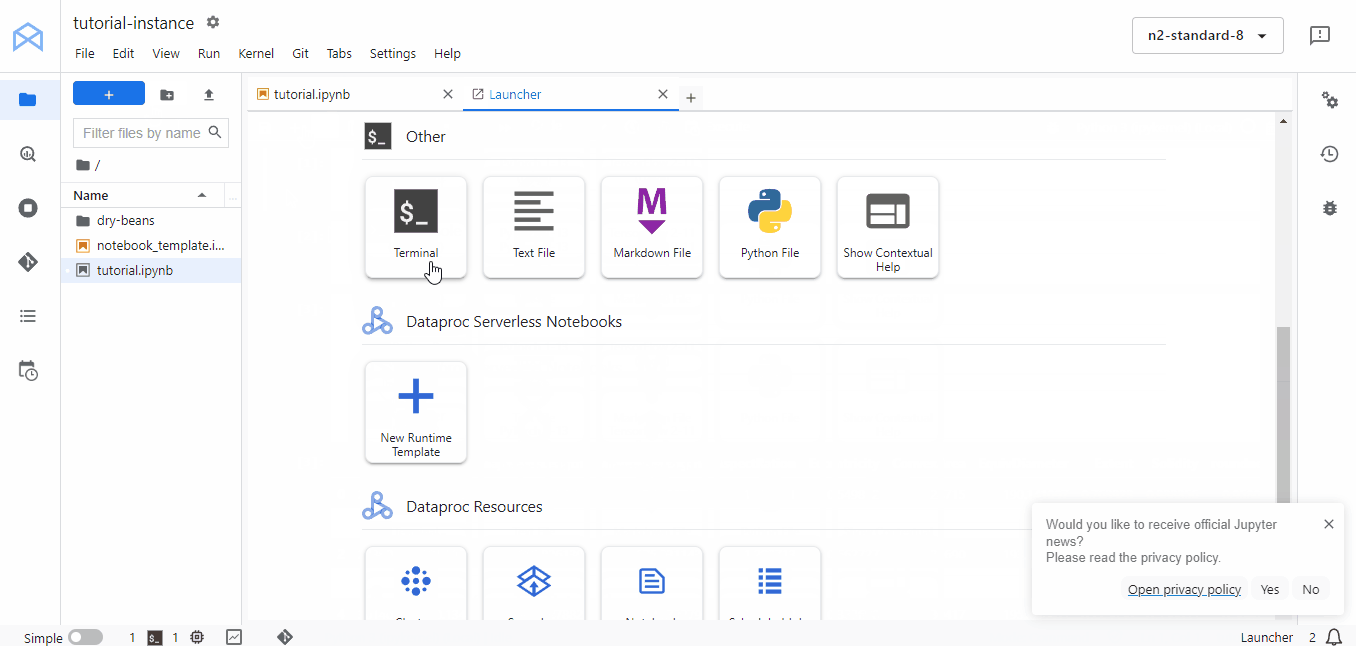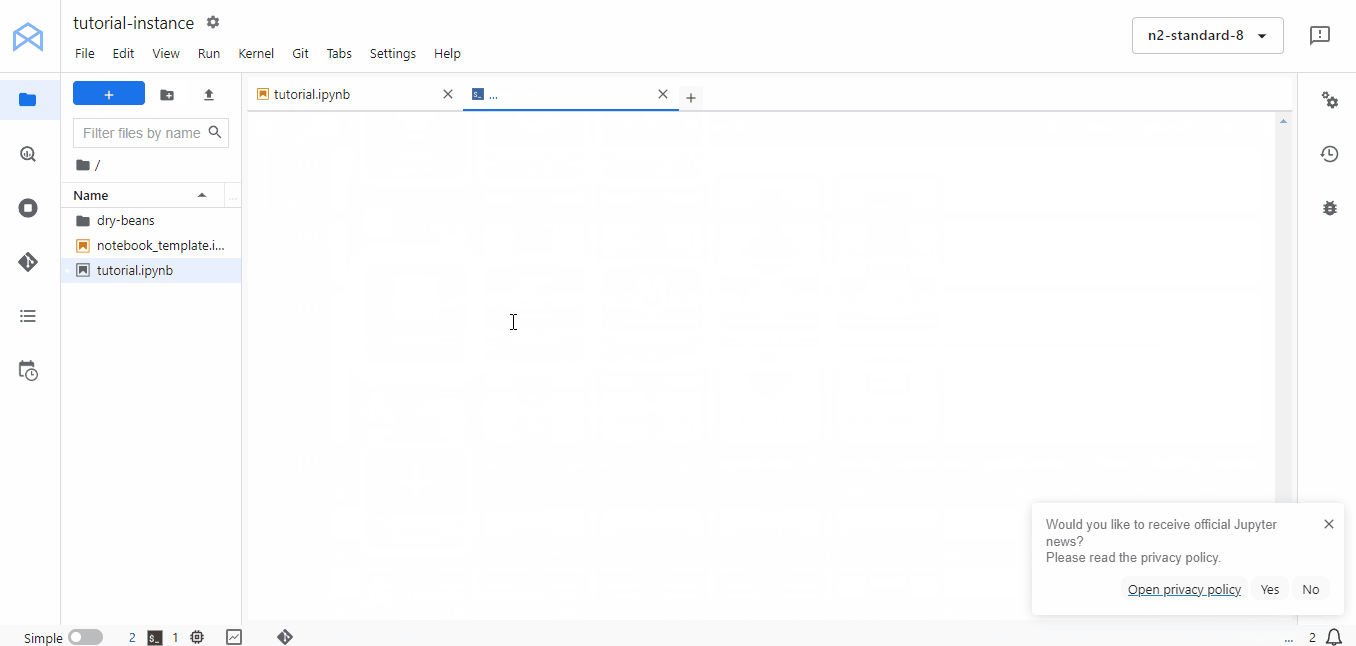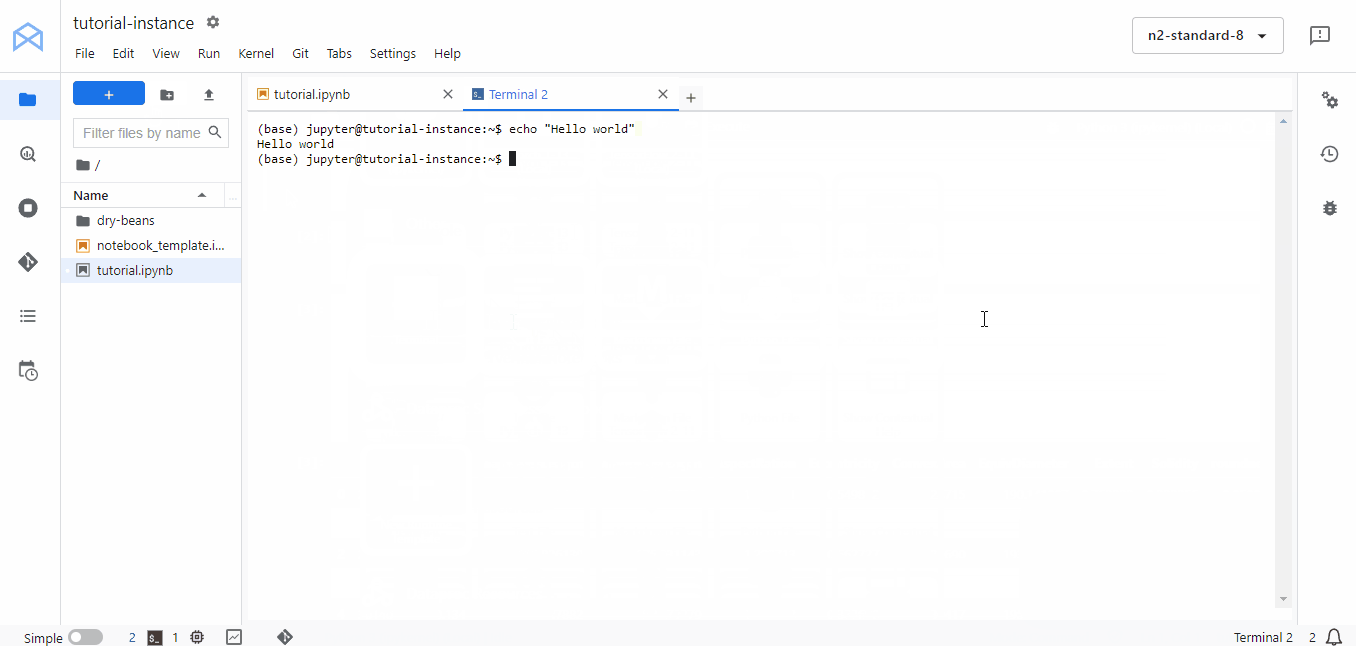
Créez ensuite un nouveau répertoire « dry-beans » et placez‑vous dedans :
$ mkdir dry-beans
$ cd dry-beans/
Dans dry-beans, créez un répertoire trainer et, à l’intérieur, le fichier Python train.py :
$ mkdir trainer
$ touch trainer/train.py
Créez ensuite un nouveau Dockerfile :
$ touch Dockerfile
Ouvrez le fichier et collez le contenu suivant :
FROM gcr.io/deeplearning-platform-release/tf2-cpu.2-6
WORKDIR /

# Copies the trainer code to the docker image.
COPY trainer /trainer

# Install XGBoost
RUN pip install xgboost==1.6.2

# Sets up the entry point to invoke the trainer.
ENTRYPOINT ["python", "-m", "trainer.train"]
Ce Dockerfile utilise l’image officielle de deep learning fournie par Google Container Registry avec TensorFlow. Il copie notre répertoire trainer, installe XGBoost, puis exécute notre script Python.
Le script doit charger le dataset Dry Beans depuis notre bucket GCP, entraîner un classifieur XGBoost et enregistrer le modèle dans le bucket. J’ai rédigé un script simple qui réalise ces étapes dans ce gist GitHub (non reproduit ici pour gagner de la place).
Copiez/collez le code du gist dans train.py. Puis, dans le terminal, installez XGBoost (non préinstallé dans le Workbench choisi) et exécutez le script :
$ pip install xgboost==1.6.2
$ python trainer/train.py
Si le script s’exécute sans erreur, poursuivez en définissant ces deux variables dans le terminal :
$ PROJECT_ID='vertexai-tutorial-423010'  # Remplacez par votre PROJECT_ID précédent
$ IMAGE_URI="gcr.io/$PROJECT_ID/dry-beans:v1"  # À conserver tel quel
Ces variables seront utilisées lors de la construction du conteneur :
$ docker build ./ -t $IMAGE_URI
La construction prend quelques minutes. Une fois terminée, lancez le conteneur pour vérifier que tout fonctionne :
$ docker run $IMAGE_URI
Model trained successfully!
Model uploaded successfully!
Si vous obtenez les messages ci‑dessus, le conteneur est prêt à être poussé :
$ docker push $IMAGE_URIÀ ce stade, l’essentiel est fait. Passons au tableau de bord pour créer un job d’entraînement personnalisé en utilisant le conteneur que nous venons de pousser. Rendez‑vous dans l’onglet « MODEL REGISTRY » et cliquez sur « CREATE » :
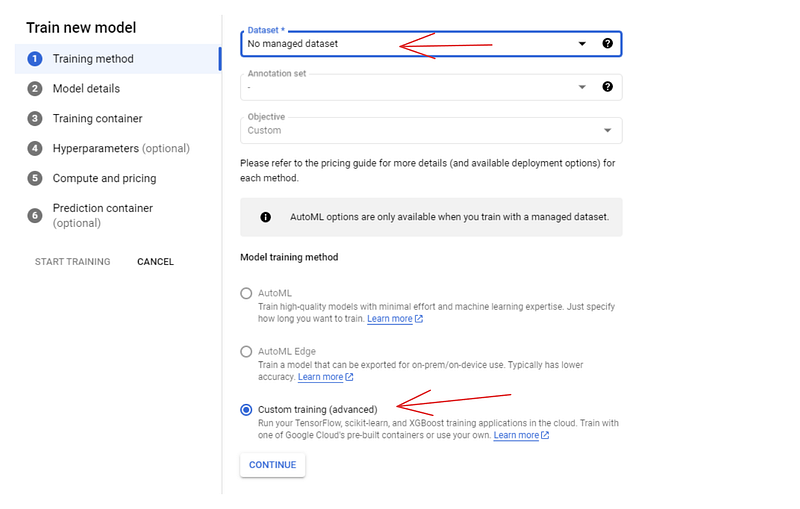
Pour la méthode d’entraînement, choisissez « No managed dataset » et « Custom training ». Dans l’étape suivante (Model details), donnez un nom au modèle — dry-beans-classifier.
Dans le volet du conteneur d’entraînement :
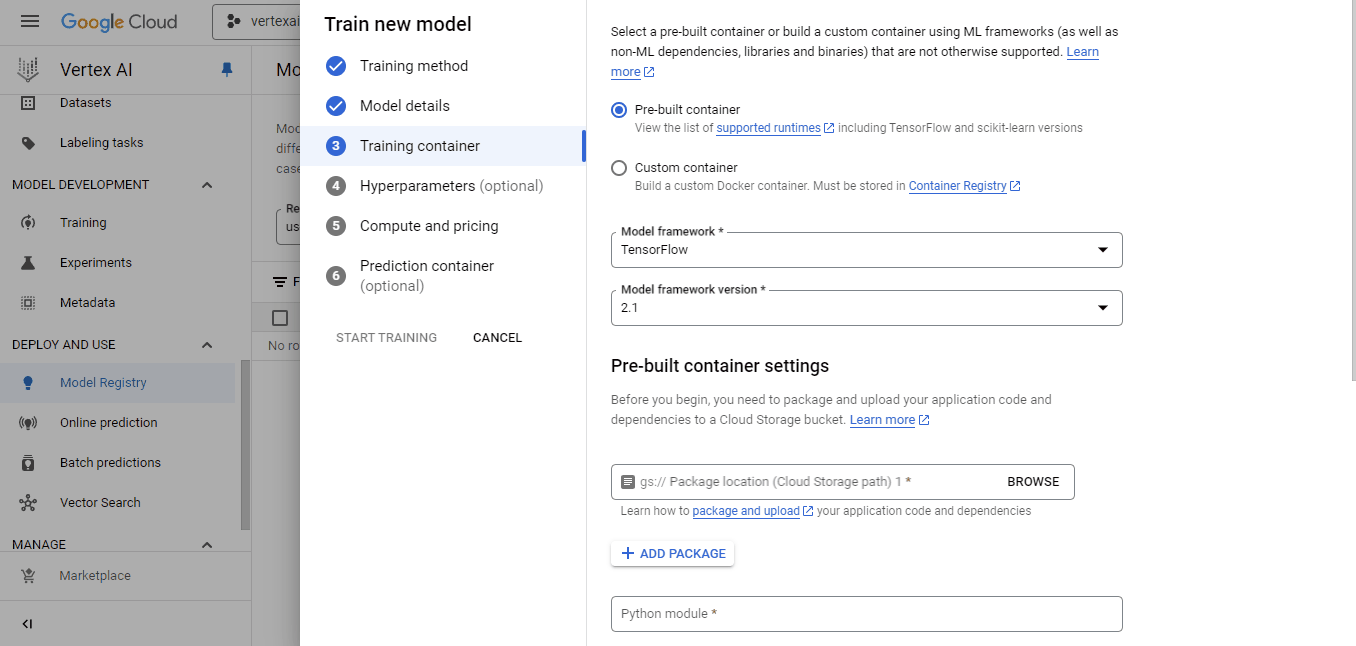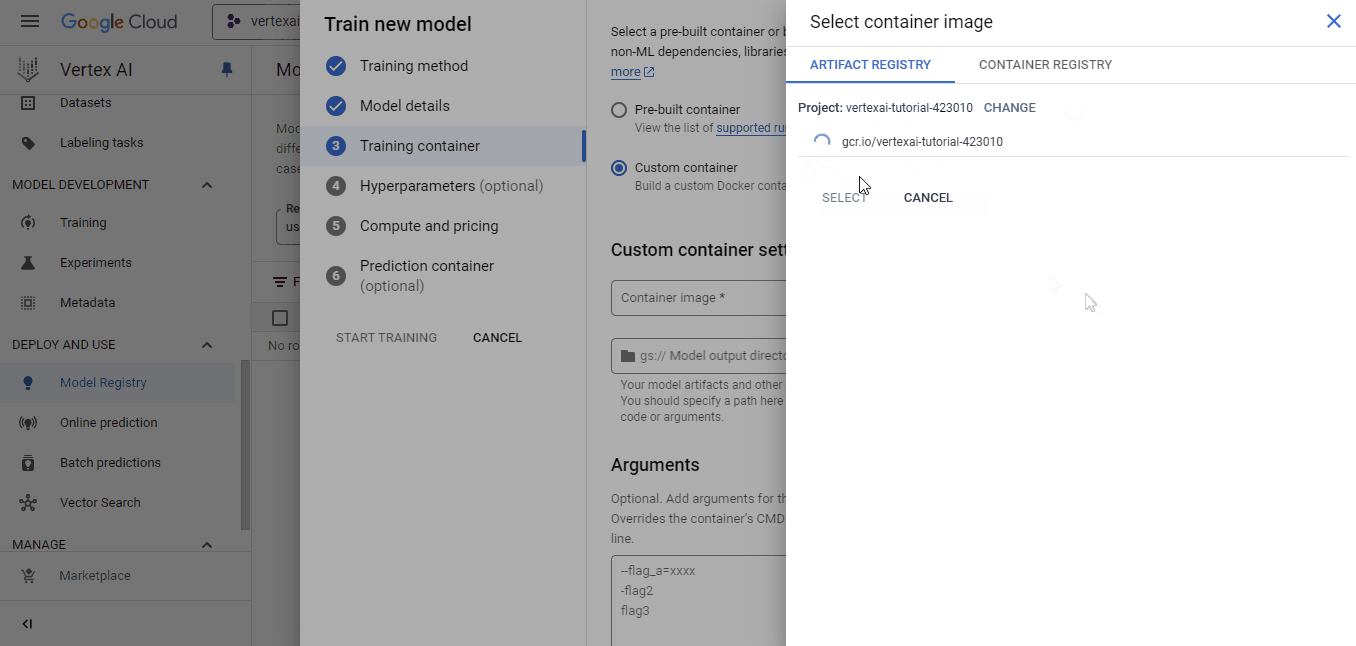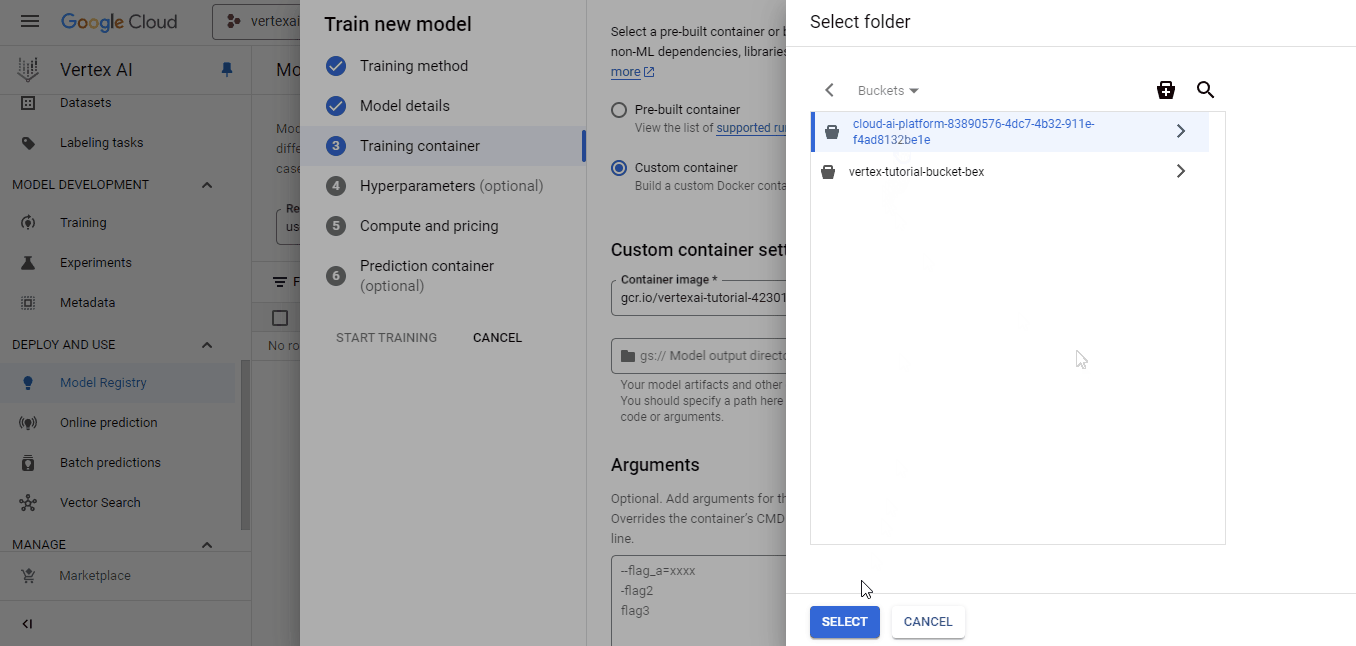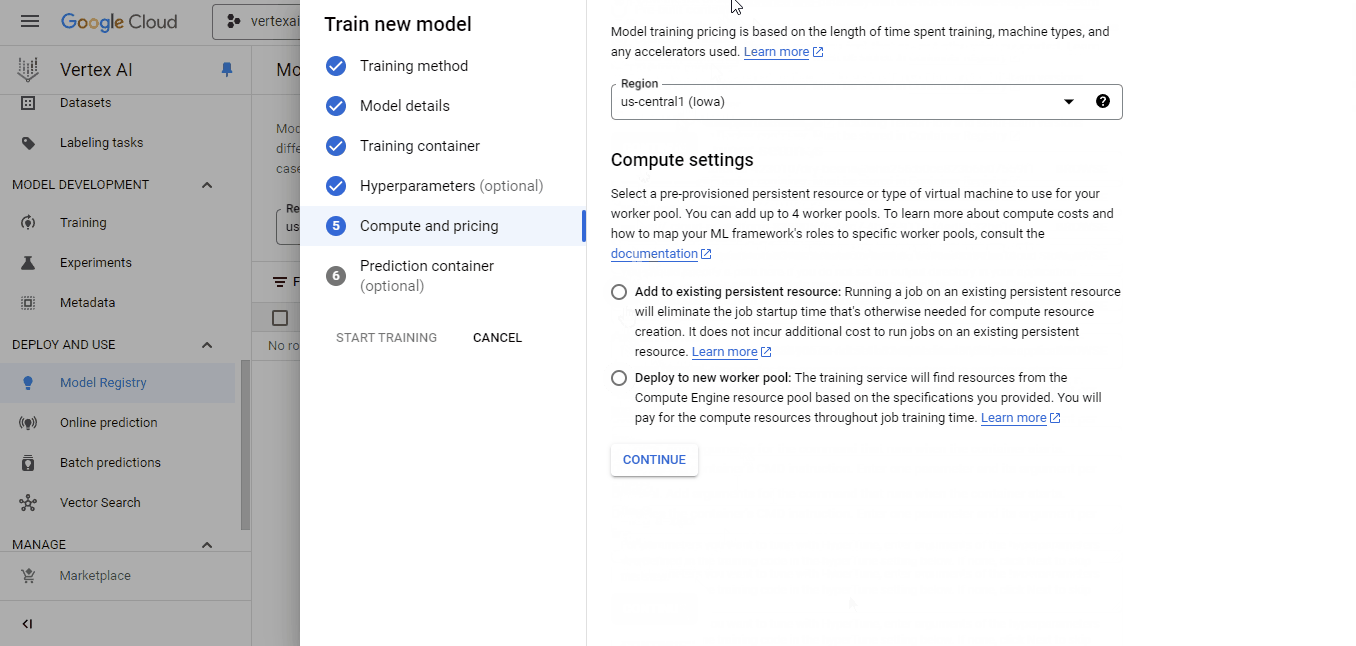
Sélectionnez l’image de conteneur que nous avons poussée pour l’image personnalisée et le bucket cloud-ai-platform pour la sortie du modèle. Cliquez ensuite sur Continue jusqu’au volet « Compute and pricing » :
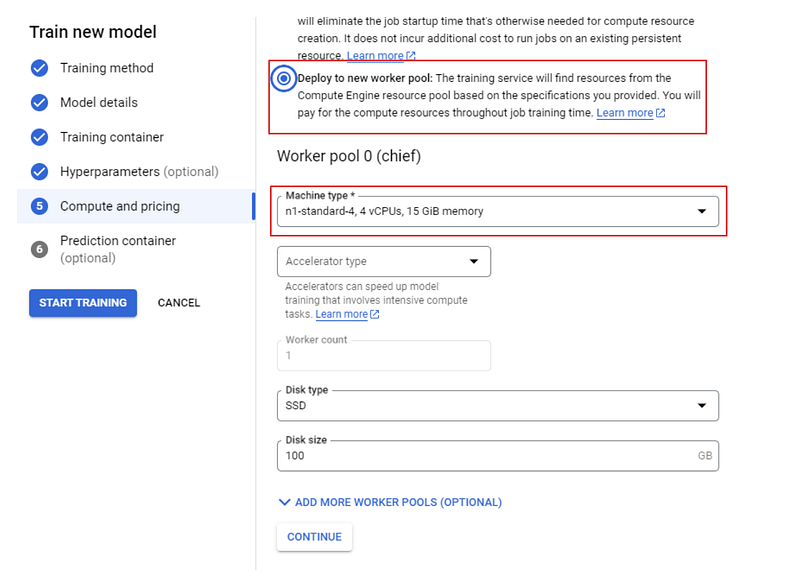
Choisissez une machine n1 standard avec 4 CPU et cliquez sur « START TRAINING ». Puis, passez à l’onglet « TRAINING » de votre tableau de bord.
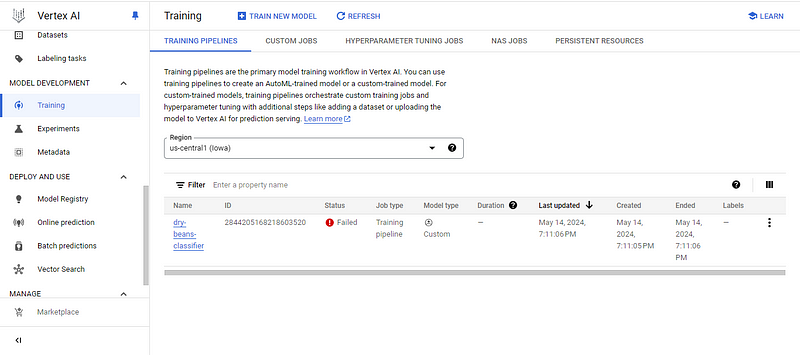
À ce stade, deux cas de figure :
Dans mon cas, c’est un échec ; examinons pourquoi en cliquant sur le nom du modèle :

L’erreur m’indique que j’ai dépassé le nombre de CPU autorisés pour l’entraînement personnalisé. En creusant, la conclusion est décevante.
Normalement, GCP accorde au moins 20 quotas CPU par région, mais, en vérifiant mon profil, j’ai découvert que mon quota était de 1 seul. Impossible donc d’exécuter un job personnalisé, puisque les machines proposées par Google ont au minimum deux CPU.
J’ai tenté d’augmenter mon quota en suivant les réponses de ce fil StackOverflow, sans succès. Le message reçu : les nouveaux utilisateurs Vertex AI ne disposent que d’une unité CPU. Pour augmenter le quota, il faut soumettre un ticket au support — ce qui nécessite un contrat de support payant.
Si vous êtes dans le même cas, essayez les solutions du fil SO, elles ont fonctionné pour certains. Sinon, il vous faudra contacter le support.
Si tout se passe bien et que votre entraînement aboutit, vous pourrez déployer le modèle en suivant les mêmes étapes que pour les modèles AutoML.
Vertex AI est une plateforme vaste et riche en fonctionnalités. Dans ce tutoriel, nous n’en avons qu’effleuré la surface, mais nous avons couvert ses briques essentielles. En maîtrisant la création de buckets de stockage, de workbenches et de jobs d’entraînement, vous serez bien armé pour explorer le reste de la plateforme.
Pour approfondir votre maîtrise des services Google Cloud, découvrez ces ressources recommandées :
Poursuivez votre parcours en IA dès aujourd’hui !
Cours
Cours
Cours