course
Claude मॉडलों का परिचय
3 घंटा
14.3K
पिछले कुछ दिनों से Anthropic की अगली रिलीज़ को लेकर अटकलें तेज़ थीं। बहुतों को Claude Sonnet 5 की उम्मीद थी, लेकिन साल की पहली रिलीज़ Claude Opus 4.6 के रूप में आई है।
1 मिलियन-टोकन कॉन्टेक्स्ट विंडो, अनुकूली सोच, बातचीत का संक्षेपण, और कई चार्ट-टॉपिंग बेंचमार्क्स के साथ, Claude Opus 4.6, Opus 4.5 पर एक सुधार है। Anthropic के शब्दों में कहें तो, उन्होंने अपने सबसे स्मार्ट मॉडल को अपग्रेड किया है। इस मॉडल के साथ ही, Anthropic ने Claude Code में एजेंट टीम्स और PowerPoint में Claude की भी घोषणा की है।
इस लेख में, हम Claude Opus 4.6 में नया क्या है, उस पर नज़र डालेंगे—नई विशेषताएं, बेंचमार्क्स, और कई हैंड्स-ऑन उदाहरणों के साथ इसे परखेंगे।
Claude की नवीनतम विशेषताओं के बारे में और जानने के लिए, मैं हमारे Claude Cowork और Claude Code गाइड देखने की सलाह देता/देती हूं, साथ ही हमारा OpenClaw ट्यूटोरियल भी। अन्य प्रतिस्पर्धियों की तुलना के लिए, हमारे Muse Spark बनाम Claude Opus 4.6 और GPT-5.4 बनाम Claude Opus 4.6 गाइड पढ़ें।
Claude Opus 4.6, Anthropic का नवीनतम लार्ज लैंग्वेज मॉडल है। Opus 4.5 के बाद यह कंपनी के ‘सबसे स्मार्ट’ मॉडल टियर का एक बड़ा अपग्रेड है।
रिलीज़ ब्लॉग के अनुसार, Anthropic ने एजेंटिक कोडिंग, गहन तर्क, और स्व-सुधार पर अधिक ध्यान दिया है। यानी, फोकस महज़ कार्रवाई से लगातार कार्रवाई की ओर शिफ्ट हो रहा है।
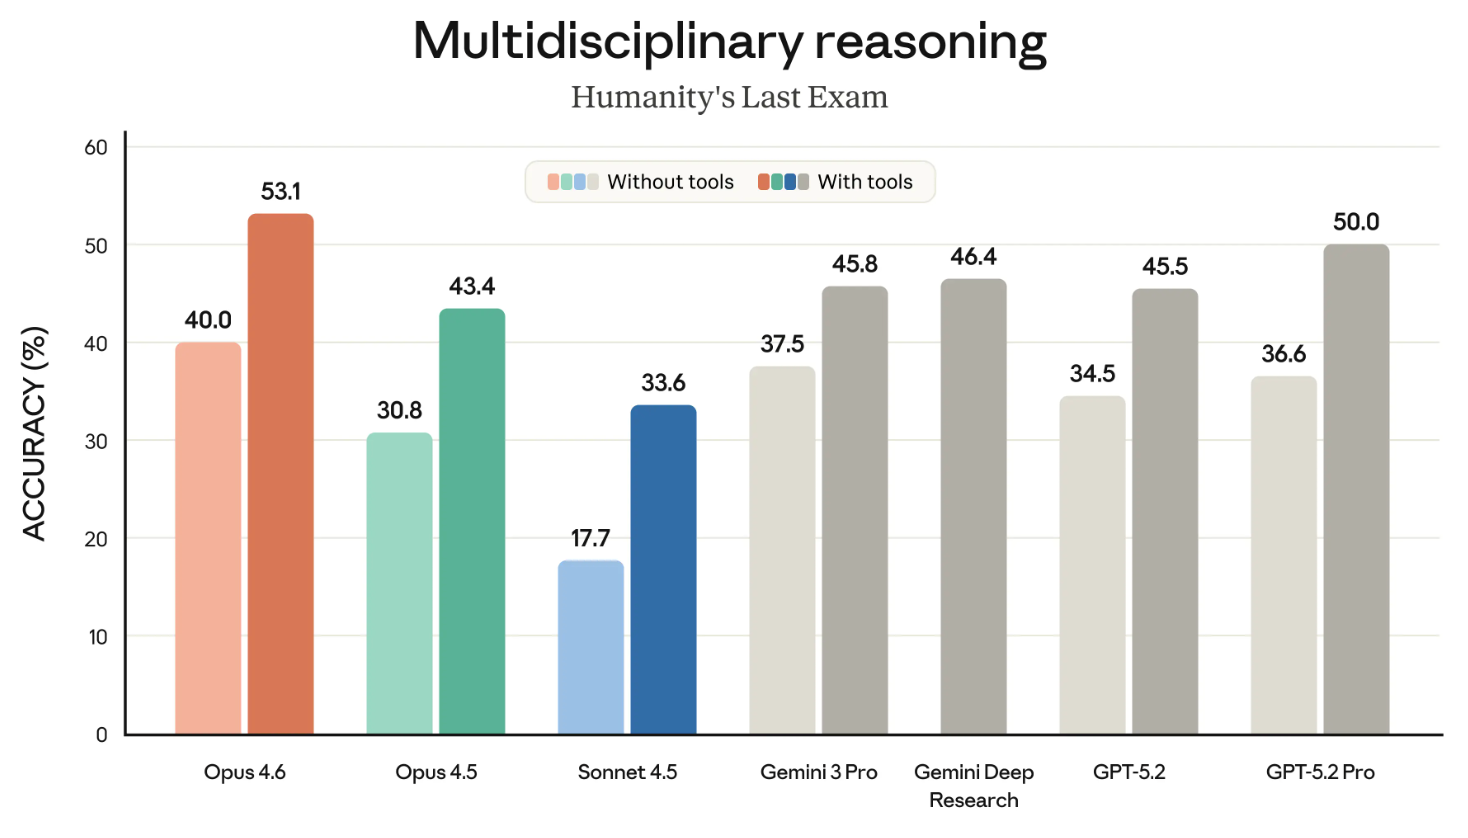
Opus 4.6 अधिक सावधानी से योजना बनाने, लंबे समय तक बेहतर सामंजस्य रखने, और अपनी ही कार्यप्रणाली में त्रुटियां पहचानने के लिए डिज़ाइन किया गया है। नतीजतन, Claude Opus 4.6 कई बेंचमार्क्स में शीर्ष पर है, जिनमें Terminal-Bench 2.0 कोडिंग मूल्यांकन में टॉप स्कोर और Humanity’s Last Exam पर सभी अन्य फ्रंटियर मॉडलों को पछाड़ना शामिल है।
मेरे लिए सबसे उल्लेखनीय बात इसका बेहतर कॉन्टेक्स्ट विंडो है। बीटा में 1 मिलियन टोकन के साथ, नया मॉडल Gemini 3 के बराबर आ जाता है, यानी यह संदर्भ खोए बिना अधिक जानकारी प्रोसेस कर सकता है।
इसी बीच, Anthropic ने Opus का उत्तरवर्ती संस्करण प्रकाशित कर दिया है। अप टू डेट रहने के लिए हमारा Claude Opus 4.7 गाइड पढ़ने की सलाह देता/देती हूं।
Claude Opus 4.6 में कई उल्लेखनीय नई विशेषताएं हैं, जिनमें से कई एजेंटिक वर्कफ्लो पर केंद्रित हैं। आइए कुछ प्रमुख बिंदुओं पर नज़र डालें:
एजेंट टीम्स, पहले के Claude संस्करणों में दिखे ‘सबएजेंट्स’ का उन्नत रूप हैं। एजेंट टीम्स आपको कई, पूरी तरह स्वतंत्र Claude इंस्टेंसेज़ स्पिन-अप करने देती हैं जो समानांतर में काम कर सकती हैं। एक सेशन ‘लीड’ एजेंट होता है जो समन्वय करता है, जबकि ‘टीममेट्स’ वास्तविक निष्पादन संभालते हैं।
सबसे दिलचस्प यह है कि हर टीम सदस्य की अपनी कॉन्टेक्स्ट विंडो होती है, जिससे निष्पादन अधिक ठोस होता है। हर टीममेट सीधे टीम में दूसरों से संवाद भी कर सकता है।
बेशक, इस फीचर का एक संभावित नकारात्मक पक्ष भी है—लागत। क्योंकि हर एजेंट की अपनी कॉन्टेक्स्ट विंडो है, टोकन खपत तेज़ी से बढ़ सकती है। इसलिए, Anthropic सलाह देता है कि इन्हें अधिक जटिलता वाले परिदृश्यों के लिए उपयोग करें।
Claude Opus 4.6 की एक अच्छी विशेषता है कॉन्टेक्स्ट कंपैक्शन। यह सुविधा लंबे वर्कफ्लोज़ के दौरान कॉन्टेक्स्ट विंडो की सीमा छूने पर आने वाली दिक्कतों से बचाती है। आमतौर पर आप एक ‘कॉन्टेक्स्ट वॉल’ से टकराते हैं, जहां परफॉर्मेंस गिरने लगता है।
कन्वर्सेशन कंपैक्शन के साथ, Claude Opus 4.6 अपने-आप पहचान सकता है कि बातचीत टोकन थ्रेशहोल्ड पर पहुंच रही है और मौजूदा बातचीत को संक्षिप्त ब्लॉक (कंपैक्शन ब्लॉक) में सारांशित कर सकता है।
यह फीचर आपकी इंटरैक्शन के आवश्यक हिस्सों को सहेजते हुए आगे काम जारी रखने के लिए जगह बनाता है। यदि आप लंबे समय तक चलने वाले टास्क-ओरिएंटेड एजेंट्स का उपयोग करने की योजना बना रहे हैं, तो बेहतर मेमोरी के साथ यह उन्हें ट्रैक पर रख सकता है।
Claude Opus 4.6 की दो विशेषताएं तय करती हैं कि उसे विस्तृत सोच का उपयोग करना है या नहीं, और ऐसी सोच में वह कितनी मेहनत करे।
अनुकूली सोच मॉडल को यह निर्धारित करने देती है कि आपका प्रॉम्प्ट कितना जटिल है। सरलता या जटिलता के आधार पर, वह तय करेगा कि विस्तृत सोच का उपयोग करना है या नहीं। मैनुअल रूप से टोकन की गिनती तय करने के बजाय, Claude हर अनुरोध की जटिलता के मुताबिक अपना बजट समायोजित करेगा।
Effort पैरामीटर आपको यह सेट करने देता है कि Claude टोकन खर्च करने में कितना उत्साही या संयमी हो। मूल रूप से, आप टोकन दक्षता और उत्तरों की गहराई के बीच संतुलन बना सकते हैं।
API में Claude Opus 4.6 का उपयोग करते समय, आप इन्हें मैन्युअली सेट कर सकते हैं। उदाहरण के लिए:
हाल ही में हमने Excel में Claude को कवर किया, जिसमें दिखाया गया कि ऐड-ऑन कैसे आपके Excel स्प्रेडशीट के साइड-पैनल में विभिन्न कार्यों में मदद कर सकता है। इस टूल की कार्यक्षमता में सुधार के साथ, Anthropic ने PowerPoint में Claude की भी घोषणा की।
यह इंटीग्रेशन आपके स्लाइड मास्टर्स, फ़ॉन्ट्स, और लेआउट का सम्मान करता है। आप इसे कॉर्पोरेट टेम्पलेट दे सकते हैं और किसी विशिष्ट सेक्शन को बनाने के लिए कह सकते हैं, या किसी स्लाइड को चुनकर घने टेक्स्ट को एक नैटिव, एडिटेबल डायग्राम में बदलने का अनुरोध कर सकते हैं।
सिर्फ "स्लाइड की तस्वीरें" बनाने के बजाय एडिटेबल PowerPoint ऑब्जेक्ट्स जनरेट करने पर जोर इसे महज़ एक कॉन्सेप्ट जेनरेटर नहीं, बल्कि एक वास्तविक उत्पादकता टूल बनाता है।
PowerPoint में Claude फिलहाल Max और एंटरप्राइज़ उपयोगकर्ताओं के लिए रिसर्च प्रीव्यू में है।
Opus 4.6 के कई प्रमुख दावे कठिन कोडिंग कार्यों और गहरे तर्क पर केंद्रित हैं। ये कौशल एक खास नींव पर टिके हैं: कई बाधाओं को एक साथ ध्यान में रखना, कई चरणों में तर्क करना, और गलतियों को पकड़ना।
इसी बात को ध्यान में रखते हुए, हमने Opus 4.6 को मल्टी-स्टेप लॉजिक, गणित, और कोडिंग चुनौतियों की एक श्रृंखला से गुजारा। हमारा लक्ष्य था कुछ ज्ञात और आम LLM कमजोरियों को उजागर करना—जैसे कैस्केडिंग कैलकुलेशन एरर, स्थानिक तर्क (हमेशा चुनौतीपूर्ण), और बाधाओं से जुड़े प्रश्न। हमने एक खास डीबगिंग कार्य भी शामिल किया, क्योंकि Anthropic की घोषणा में Opus 4.6 की रूट कॉज़ एनालिसिस और अन्य डीबगिंग मुद्दों पर पकड़ की काफी चर्चा थी।
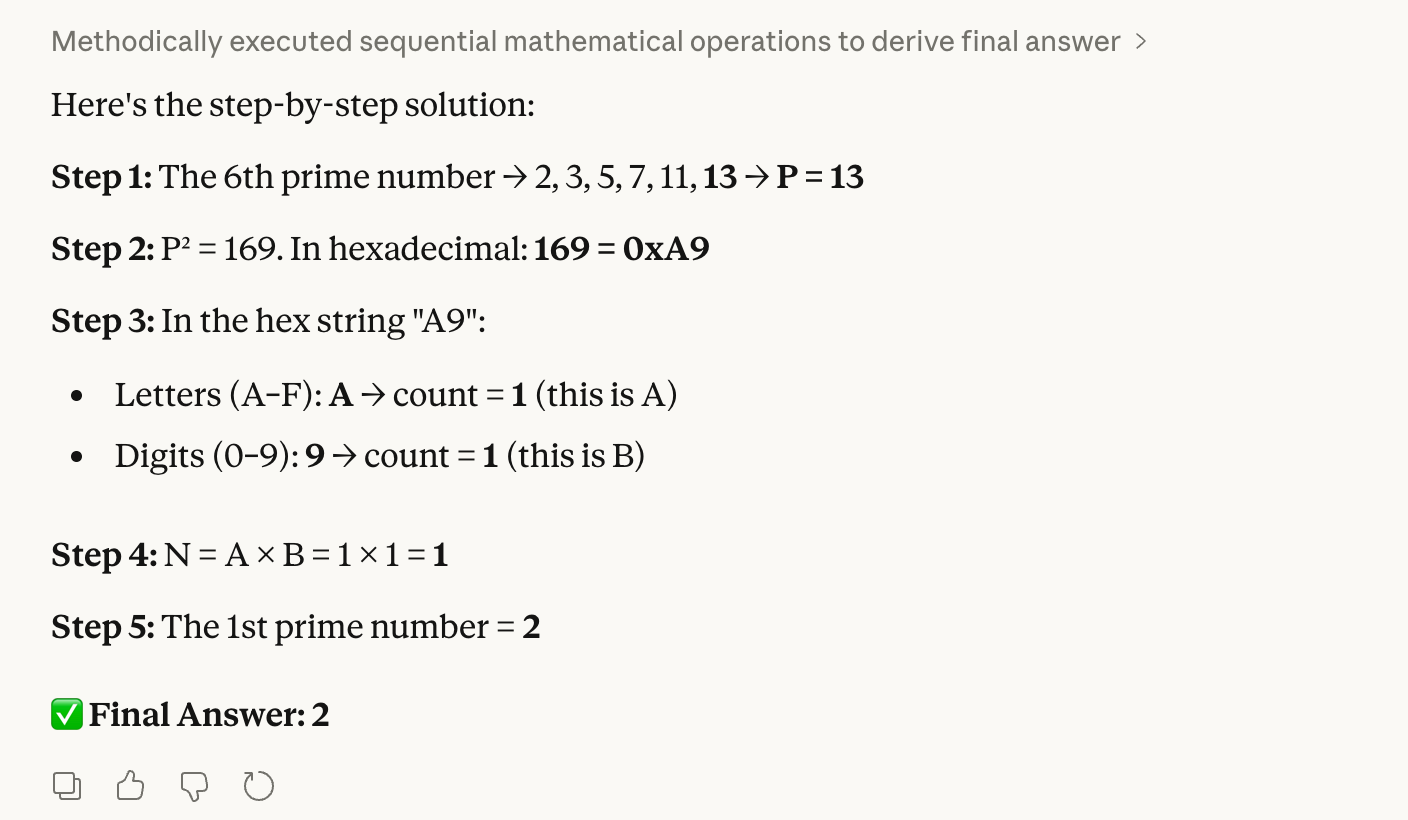
हमारा पहला टेस्ट अभाज्य संख्याएं, हेक्साडेसिमल, और काउंटिंग को जोड़ता है:
Step 1: Find the 6th prime number. Let this be P.
Step 2: Convert the square of P into hexadecimal.
Step 3: Count the letters (A–F) and digits (0–9) in that hex string. Let these be A and B.
Step 4: Multiply A × B. Let this be N.
Step 5: Find the Nth prime number.
यह थोड़ा जटिल लगता है, लेकिन हमारे लिए इसे सत्यापित करना काफी आसान है। सही उत्तर 2 है क्योंकि 6वीं अभाज्य संख्या 13 है; 13 का वर्ग 169 होता है, जो हेक्स में "A9" होता है। इसमें 1 अक्षर × 1 अंक है, जिसका गुणन 1 होता है, और पहली अभाज्य संख्या 2 है।
चिंता यह होती है कि मॉडल हेक्स कन्वर्ज़न में गलती कर सकता है, जिससे अंतिम उत्तर पूरी तरह गलत हो जाए। जैसा कि आप देख सकते हैं, Opus 4.6 को कोई दिक्कत नहीं हुई:
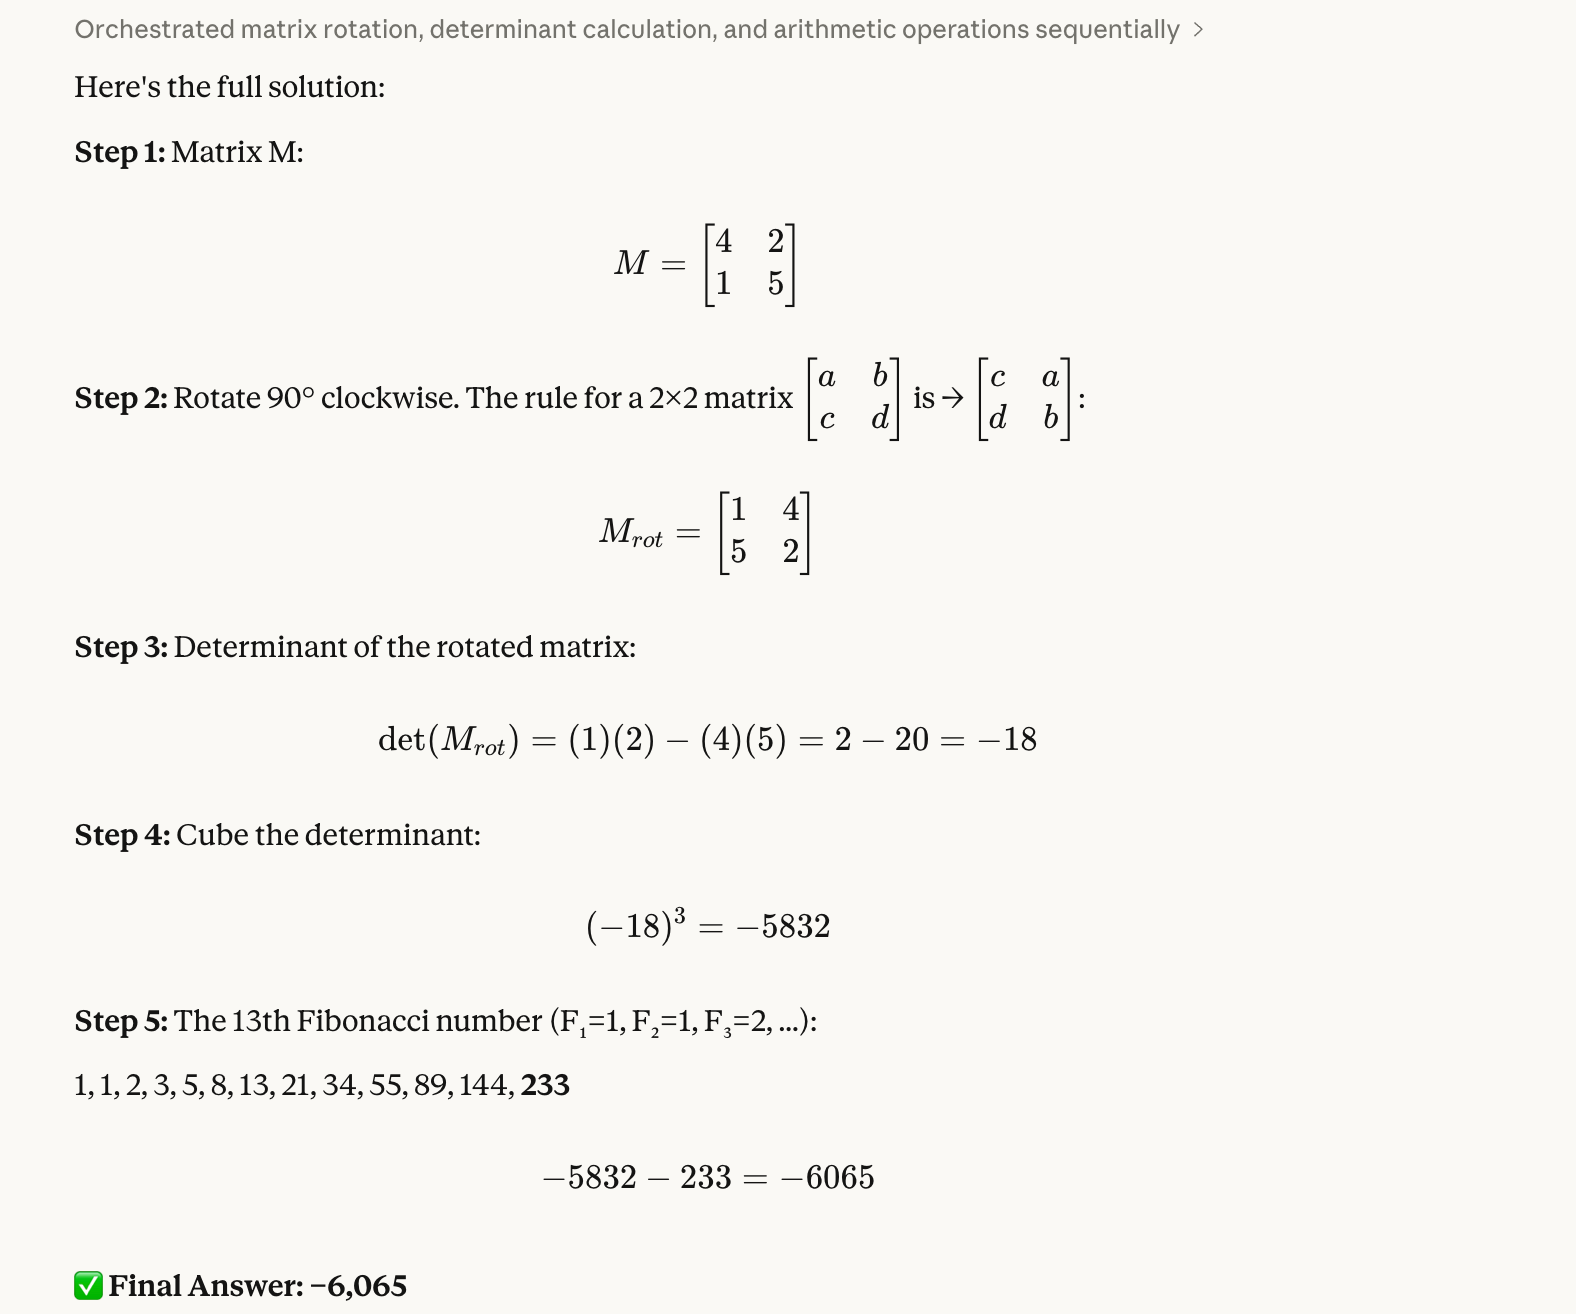
हमारा दूसरा टेस्ट स्थानिक तर्क और ऋणात्मक संख्याओं के प्रबंधन की जांच करता है:
Step 1: Create a 2×2 matrix M with top row [4, 2] and bottom row [1, 5].
Step 2: Rotate M 90 degrees clockwise.
Step 3: Calculate the determinant of the rotated matrix.
Step 4: Cube that determinant.
Step 5: Subtract the 13th Fibonacci number from the result.
इसे सत्यापित करने में हमें थोड़ा अधिक काम करना पड़ा। सही उत्तर -6,065 है। ऐसा इसलिए क्योंकि घुमाई गई मैट्रिक्स [[1, 4], [5, 2]] है; फिर हम Python से डिटर्मिनेंट निकालते हैं, जो -18 है; इसका घन -5,832 होता है; अंत में, 233 घटाते हैं और -6,065 मिलता है।
हमें यह टेस्ट इसलिए पसंद आया क्योंकि अनुभव से पता है कि मॉडल अक्सर मैट्रिक्स तत्वों को गलत तरीके से अदला-बदली कर देते हैं या बीच में ही ऋणात्मक चिन्ह खो देते हैं। फिर से, Opus 4.6 को कोई दिक्कत नहीं हुई:
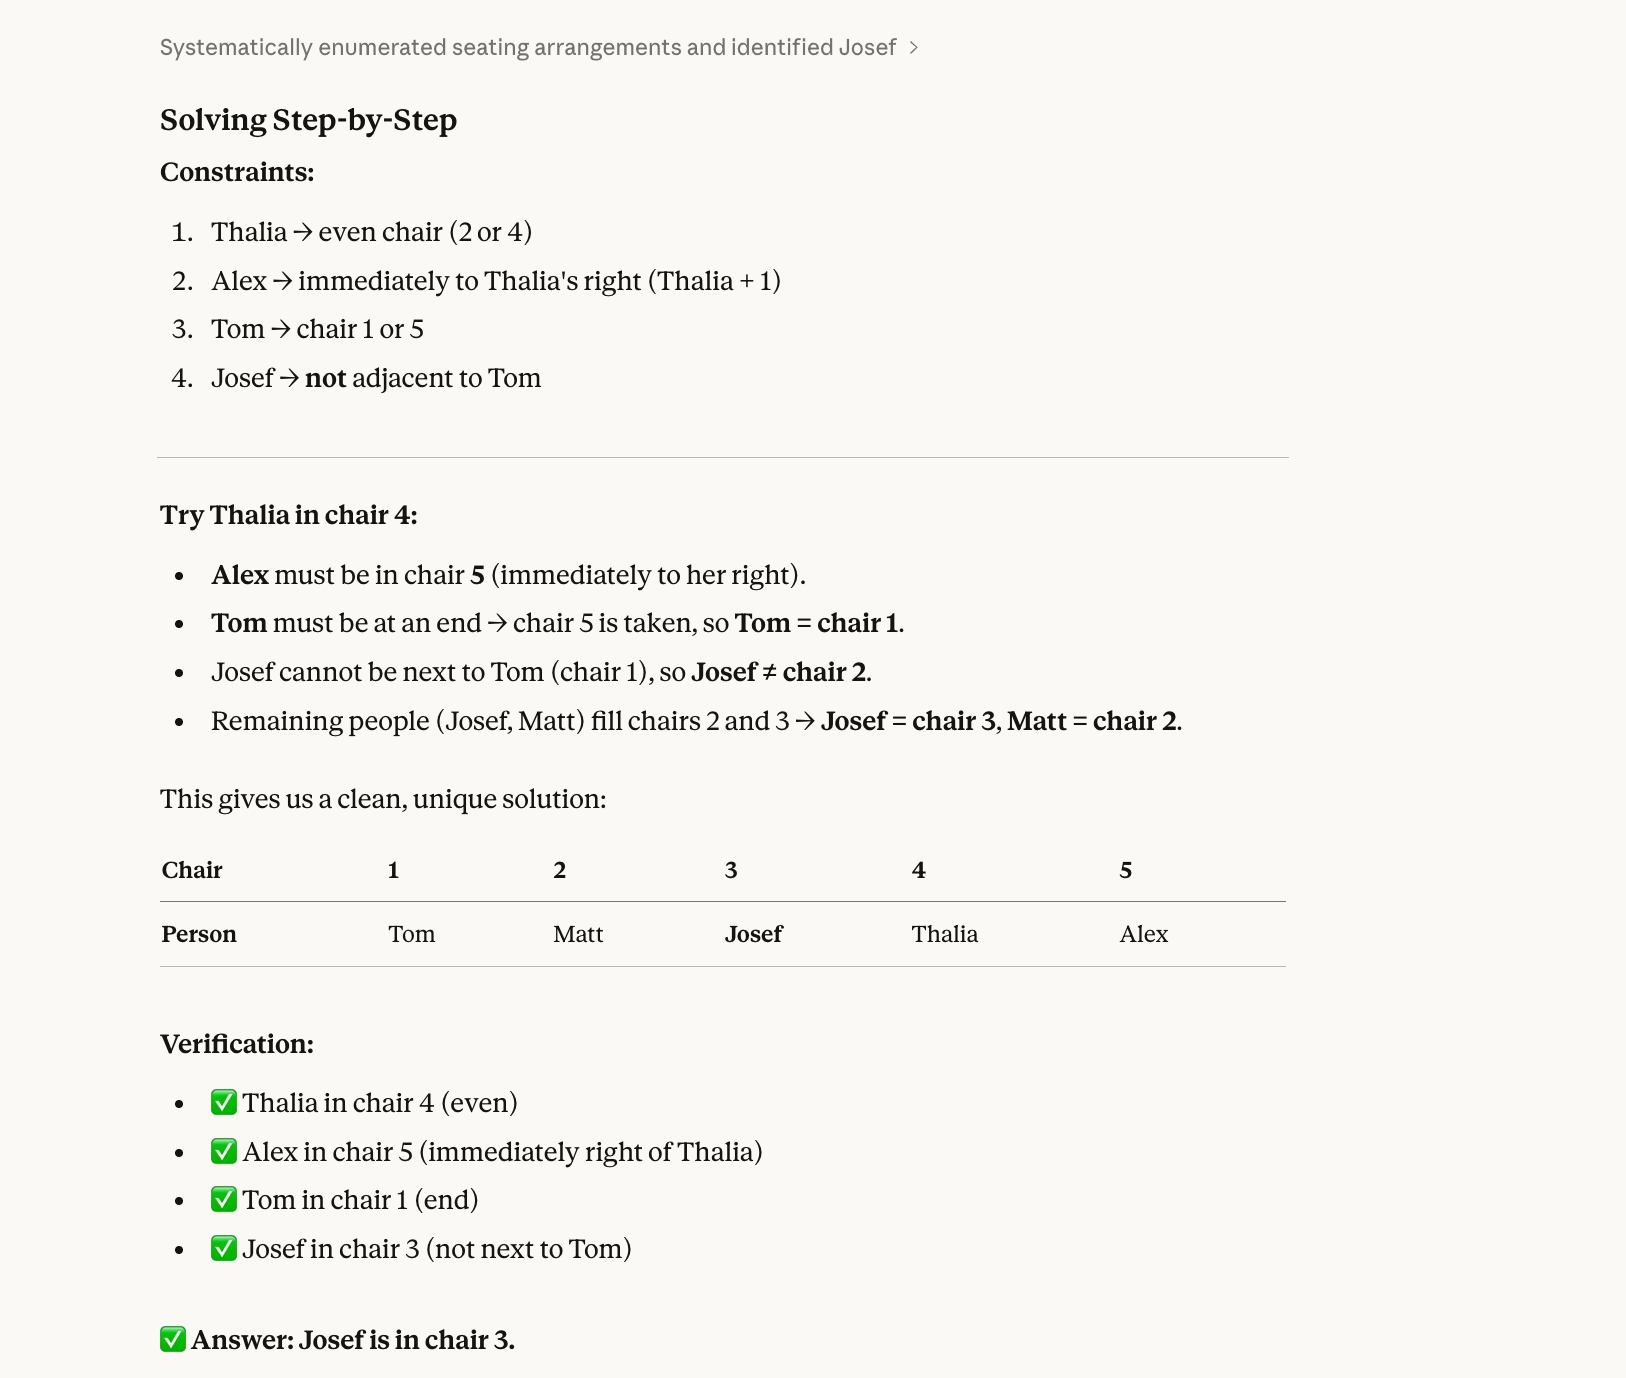
तीसरे टेस्ट में, हमने बैकट्रैकिंग मांगने वाली बाधा-संतुष्टि समस्या आजमाई:
Five people (Alex, Josef, Matt, Thalia, Tom) sit in chairs 1–5.
Thalia is in an even-numbered chair.Alex is immediately to Thalia’s right.Tom is at one end.Josef is not next to Tom.Who is in chair 3?
इसका सही उत्तर Josef है। (Alex-1, Matt-2, Josef-3, Thalia-4, Tom-5.) थोड़ा प्रयास कर आप इसे कागज़ पर निकाल सकते हैं।
मॉडल ऐसे प्रश्नों में इसलिए चूकते हैं क्योंकि वे ऐतिहासिक रूप से अनुक्रमिक, न कि समग्र, तरीके से हल करते हैं। वे "Thalia सम संख्या वाली कुर्सी पर है" पढ़कर एक कुर्सी चुन लेते हैं (मान लें, कुर्सी 2) बिना यह जांचे कि वह चयन बाकी बाधाओं से मेल खाता है या नहीं। फिर उसी पर अडिग रहते हुए और सीटें भरते जाते हैं, अंततः टकराव होता है, लेकिन तब तक वे खुद को एक कोने में लिख चुके होते हैं और Thalia को कुर्सी 4 पर आज़माने लौटते नहीं।
Opus 4.6 ने यह भी सही किया:
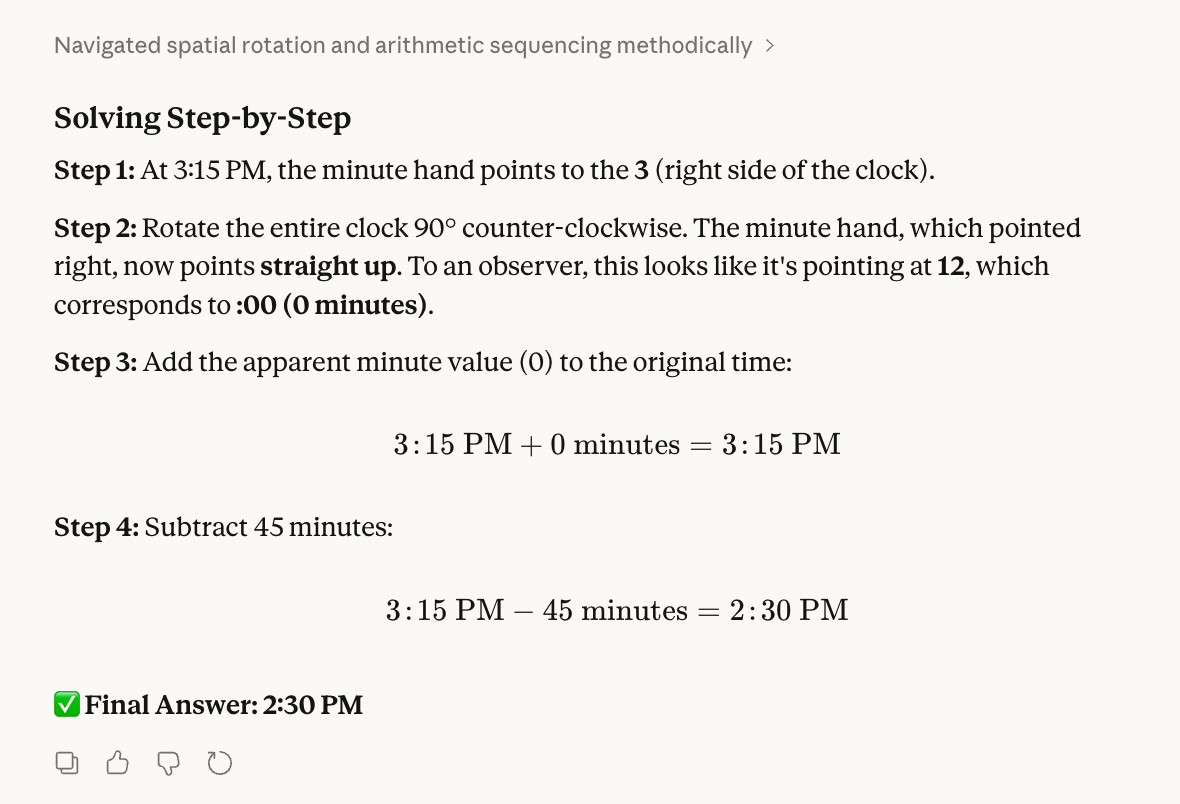
चौथा टेस्ट स्थानिक विज़ुअलाइज़ेशन और भौतिक सहजज्ञान का मूल्यांकन करता है:
Step 1: Imagine a clock currently showing 3:15 PM.
Step 2: Rotate the clock 90 degrees counter-clockwise (physically turning the whole clock face). After the rotation, what time does the minute hand appear to be pointing at?
Step 3: Take that new "apparent" minute value and add it to the original time (3:15 PM).
Step 4: Subtract 45 minutes from that result.
Step 5: What is the final time?
इसे सत्यापित करने के लिए, मैंने सचमुच अपनी कलाई घड़ी उतारी और घुमा दी।
सही उत्तर 2:30 PM है। 3:15 पर मिनट हैंड "3" पर होता है। जब मैंने 12 को अपने बाईं खिड़की की ओर घुमाया, तो "3" वहां आ गया जहां "12" था। फिर मैंने 3:15 में 0 जोड़ा, 45 मिनट घटाए, और 2:30 PM मिला।
टेस्ट डिज़ाइन करते समय, हमें उम्मीद थी कि मॉडल घड़ी के फेस को घुमाने और सुई को हिलाने में भ्रमित हो सकते हैं। हमने यह भी सुना है कि मॉडल 0 जोड़ने को संदिग्ध मानते हैं और किसी अन्य संख्या को थोपने की कोशिश करते हैं।
फिर भी, Opus 4.6 ने इसे हल कर लिया; इसे भी सही उत्तर मिला:
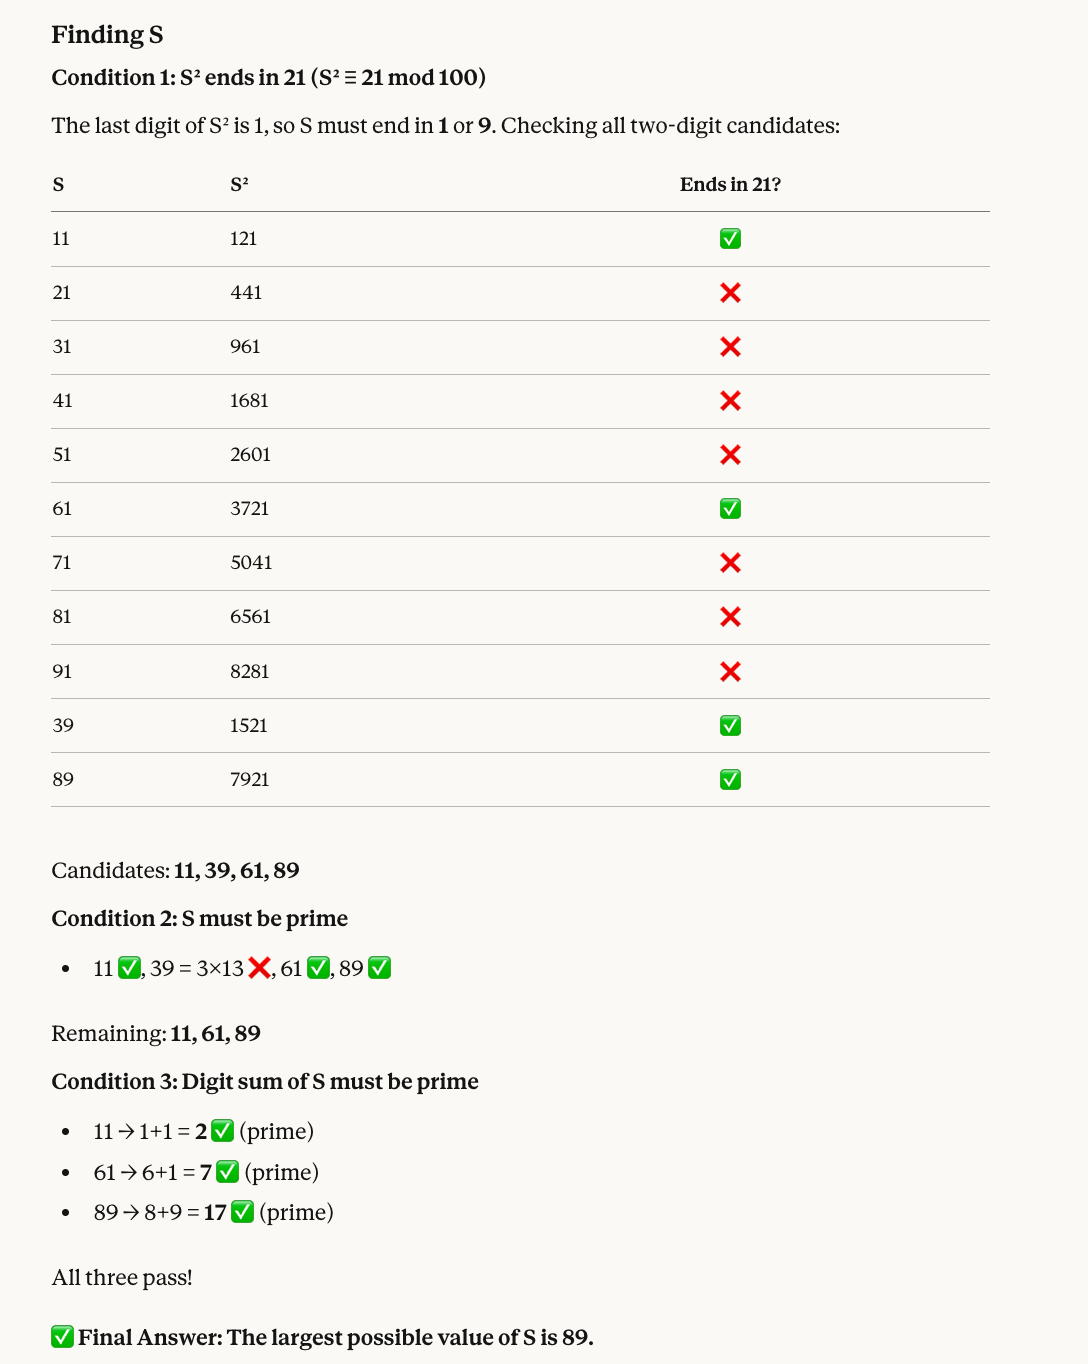
पाँचवां टेस्ट मापांक अंकगणित को अभाज्य फ़िल्टरिंग के साथ जोड़ता है:
Find a two-digit number S that satisfies all of the following:
* When S is squared, the last two digits of the result are 21.
* S must be a prime number.
* The sum of the digits of S must also be a prime number.
What is the largest possible value of S?
सही संख्या 89 क्यों है: जिन संख्याओं के वर्ग के अंतिम दो अंक 21 होते हैं, उनमें 11, 39, 61, और 89 शामिल हैं। इनमें 39 अभाज्य नहीं है, इसलिए 11, 61, और 89 बचते हैं। तीनों के अंकों के योग भी अभाज्य हैं (क्रमशः 2, 7, और 17), इसलिए सबसे बड़ा 89 है।
Opus 4.6 ने फिर सही उत्तर दिया, और इस बार एक उपयोगी दृश्य भी शामिल किया:
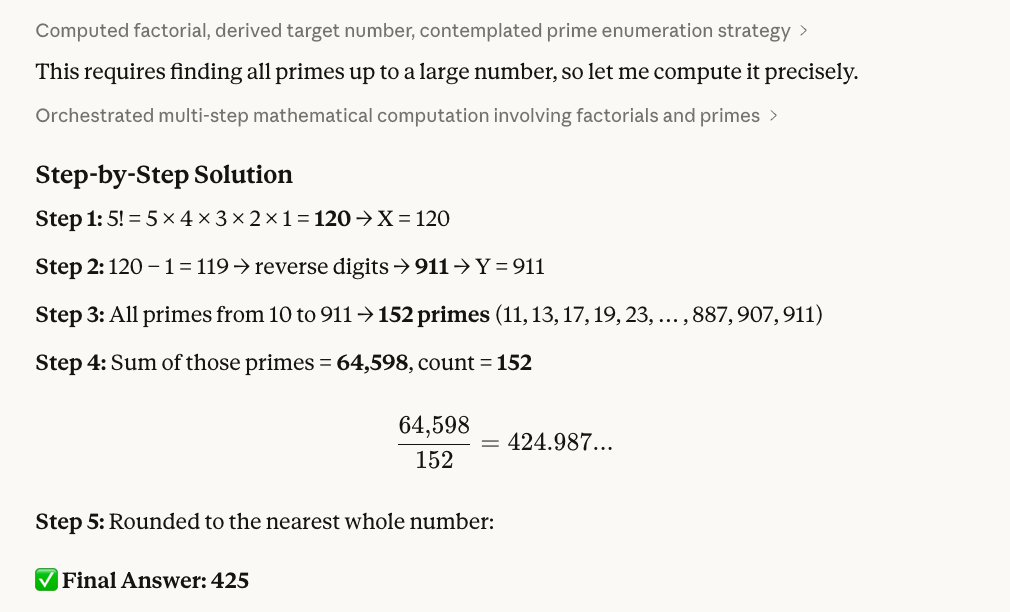
अगला टेस्ट फैक्टोरियल गणित, स्ट्रिंग मैनीपुलेशन, और प्राइम्स को जोड़ता है:
Step 1: Calculate 5! (5 factorial). Let this result be X.
Step 2: Take X, subtract 1, and reverse the digits of the result. Let this new number be Y.
Step 3: Identify all prime numbers (p) such that 10 ≤ p ≤ Y.
Step 4: Calculate the sum of these primes and divide it by the total count of primes found in that range.
Step 5: Provide the final average, rounded to the nearest whole number.
हमने 425 को सही उत्तर इस तरह सत्यापित किया: 5! = 120; 1 घटाकर 119; अंकों को उलटकर 911। फिर, नीचे दिए R कोड (यहां दिखाया गया) से पता चला कि 10 और 911 के बीच 152 प्राइम्स हैं, और उनका योग 64,598 है। अंत में, R से विभाजन और राउंड: 64,598 ÷ 152 ≈ 425।
यह रहा हमारा R स्क्रिप्ट:
# Step 1: Calculate 5!
X <- factorial(5)
cat("Step 1: X =", X, "\n")

# Step 2: Subtract 1 and reverse digits
result <- X - 1
Y <- as.numeric(paste0(rev(strsplit(as.character(result), "")[[1]]), collapse = ""))
cat("Step 2:", X, "- 1 =", result, "-> reversed ->", Y, "\n")

# Step 3: Find all primes between 10 and Y
is_prime <- function(n) {
  if (n < 2) return(FALSE)
  if (n == 2) return(TRUE)
  if (n %% 2 == 0) return(FALSE)
  for (i in 3:floor(sqrt(n))) {
    if (n %% i == 0) return(FALSE)
  }
  return(TRUE)
}

primes <- Filter(is_prime, 10:Y)
cat("Step 3: Found", length(primes), "primes between 10 and", Y, "\n")

# Step 4: Sum and average
total <- sum(primes)
count <- length(primes)
avg <- total / count
cat("Step 4: Sum =", total, ", Count =", count, ", Average =", avg, "\n")

# Step 5: Round
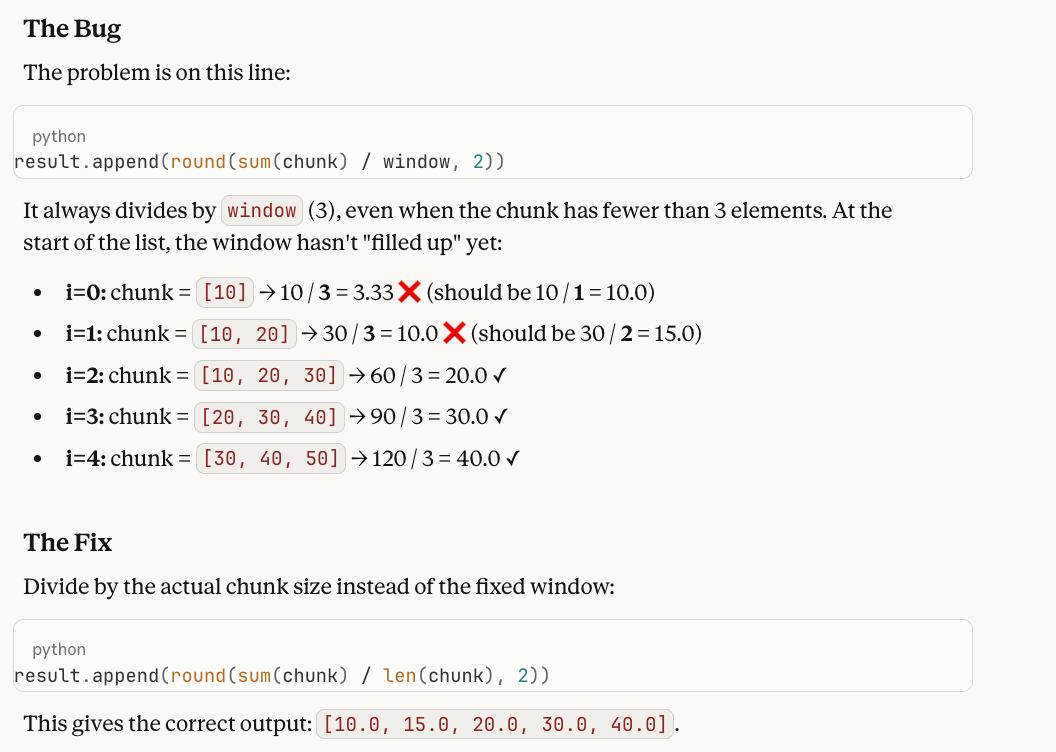
cat("Step 5: Rounded =", round(avg), "\n")अगला टेस्ट Opus 4.6 के एक बड़े दावे को टारगेट करता है: कोड में बग्स की पहचान। हमें पता है कि मॉडल अक्सर लाइन-बाय-लाइन कोड ट्रेस तो सही करते हैं, पर उस ट्रेस को मूल खामी से जोड़ने में चूक जाते हैं।
A developer wrote this Python function to compute a running average:

def running_average(data, window=3):
    result = []
    for i in range(len(data)):
        start = max(0, i - window + 1)
        chunk = data[start:i + 1]
        result.append(round(sum(chunk) / window, 2))
    return result
When called with running_average([10, 20, 30, 40, 50]), the first two values in the output seem wrong. Why? Please help me fix what is wrong!
यह उत्तर और यह टेस्ट क्यों काम करता है: फ़ंक्शन हमेशा window (3) से भाग देता है, भले ही सूची की शुरुआत में chunk में 3 से कम तत्व हों। बगी आउटपुट [3.33, 10.0, 20.0, 30.0, 40.0] होता है, जबकि पहले दो मान 10.0 और 15.0 होने चाहिए, क्योंकि उनके chunk क्रमशः केवल 1 और 2 तत्वों के हैं। सुधार है / window को / len(chunk) में बदलना।
यह टेस्ट हमें इसलिए पसंद है क्योंकि मॉडल अक्सर लूप को बखूबी ट्रेस करते हैं, लेकिन फिर कहते हैं "आउटपुट सही लगता है"—वे कदम-दर-कदम गणित को होते देखते हैं और यह नहीं झेंकते कि एक ही तत्व को 3 से भाग देना गलत है। इसमें मॉडल को उद्देश्य (रनिंग एवरेज क्या करना चाहिए) और निष्पादन (कोड वास्तव में क्या कर रहा है) दोनों को साथ रखकर उनके बीच का अंतर पकड़ना होता है।
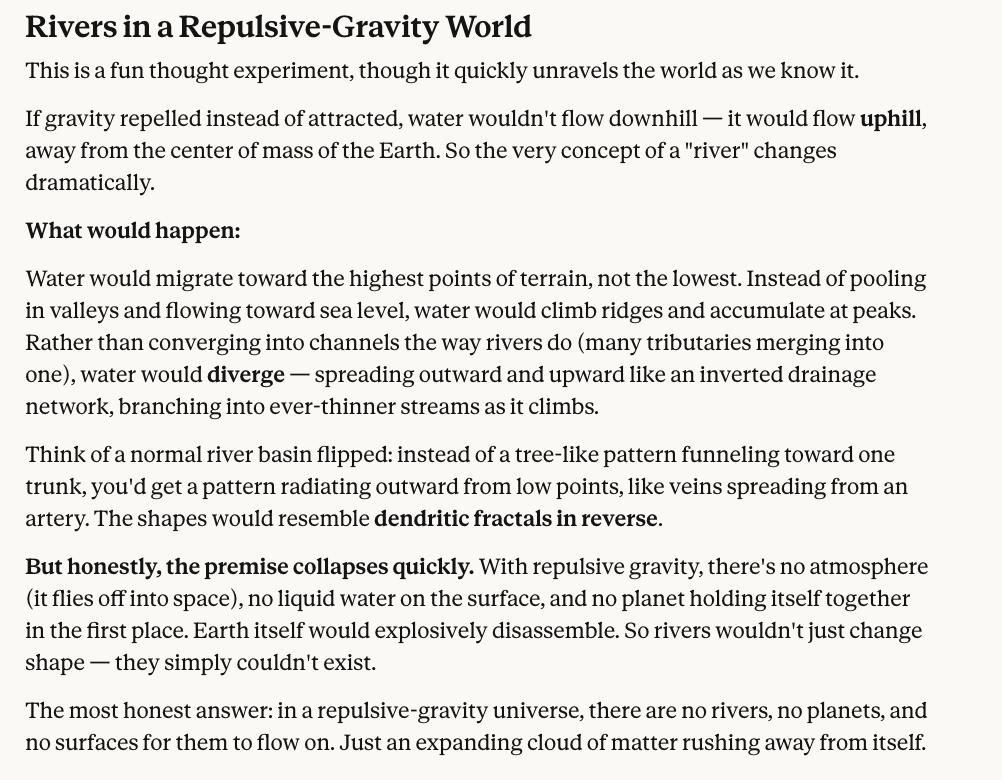
अंतिम टेस्ट में गणित नहीं है, केवल विपरीत-तथ्यात्मक तर्क है।
In a world where gravity repels objects instead of attracting them, what shape would rivers take?स्वीकार्य है, यहां कोई एक सही उत्तर नहीं है, और इसकी कल्पना करना भी कठिन है। पर हम चाहते थे कि मॉडल कम-से-कम निहितार्थों पर तर्क करे, और हमें लगता है कि Claude Opus 4.6 का उत्तर पर्याप्त रूप से तर्कसंगत था।
कुल मिलाकर, संक्षेप में कहें तो, Opus 4.6 ने परफेक्ट स्कोर किया, हालांकि, जैसा कि आपने देखा, हमने एक ऐसा प्रश्न शामिल किया था जहां उत्तर थोड़ा व्यक्तिपरक था, तो अंतिम निर्णय आप कर सकते हैं।
Opus 4.6 कम-से-कम चार महत्वपूर्ण बेंचमार्क्स में निर्विवाद लीडर है:
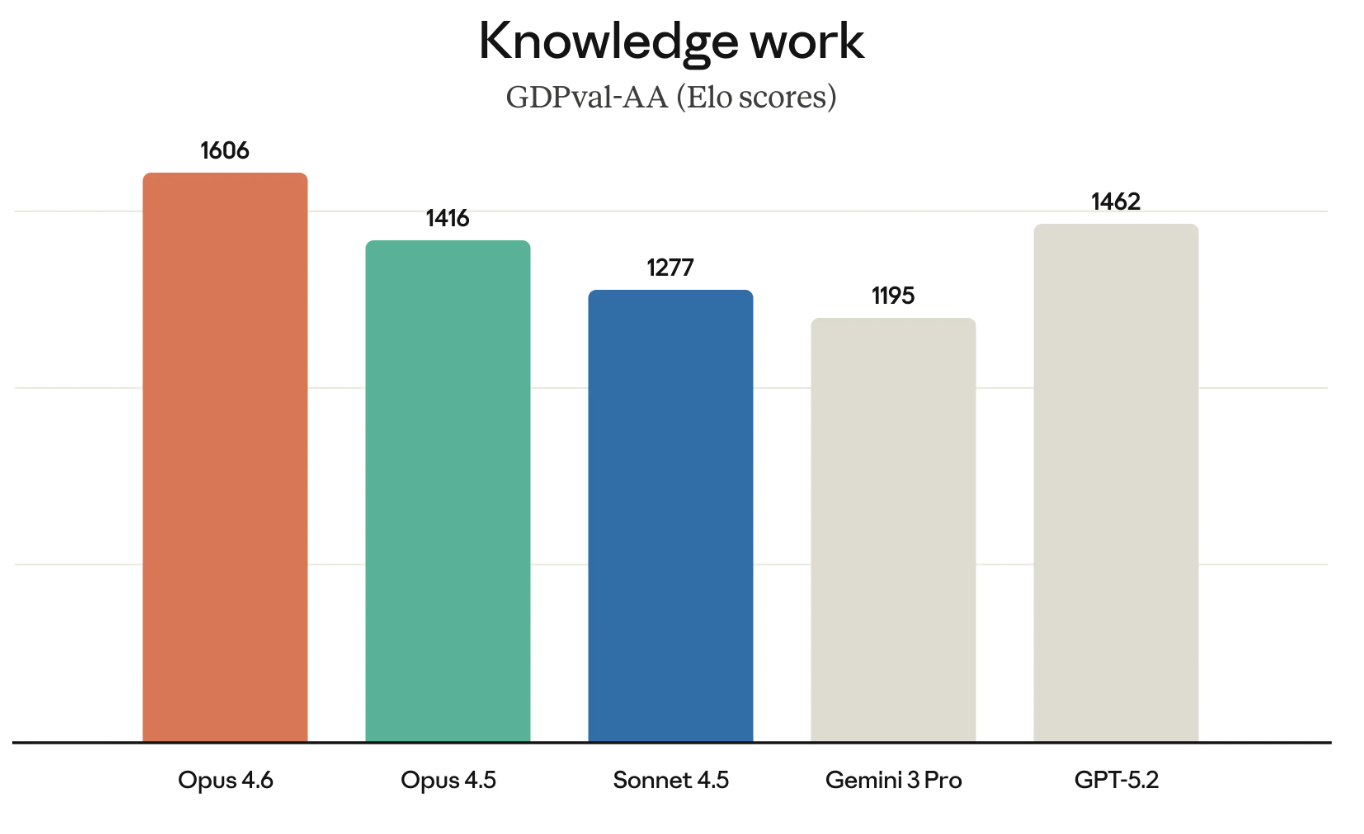
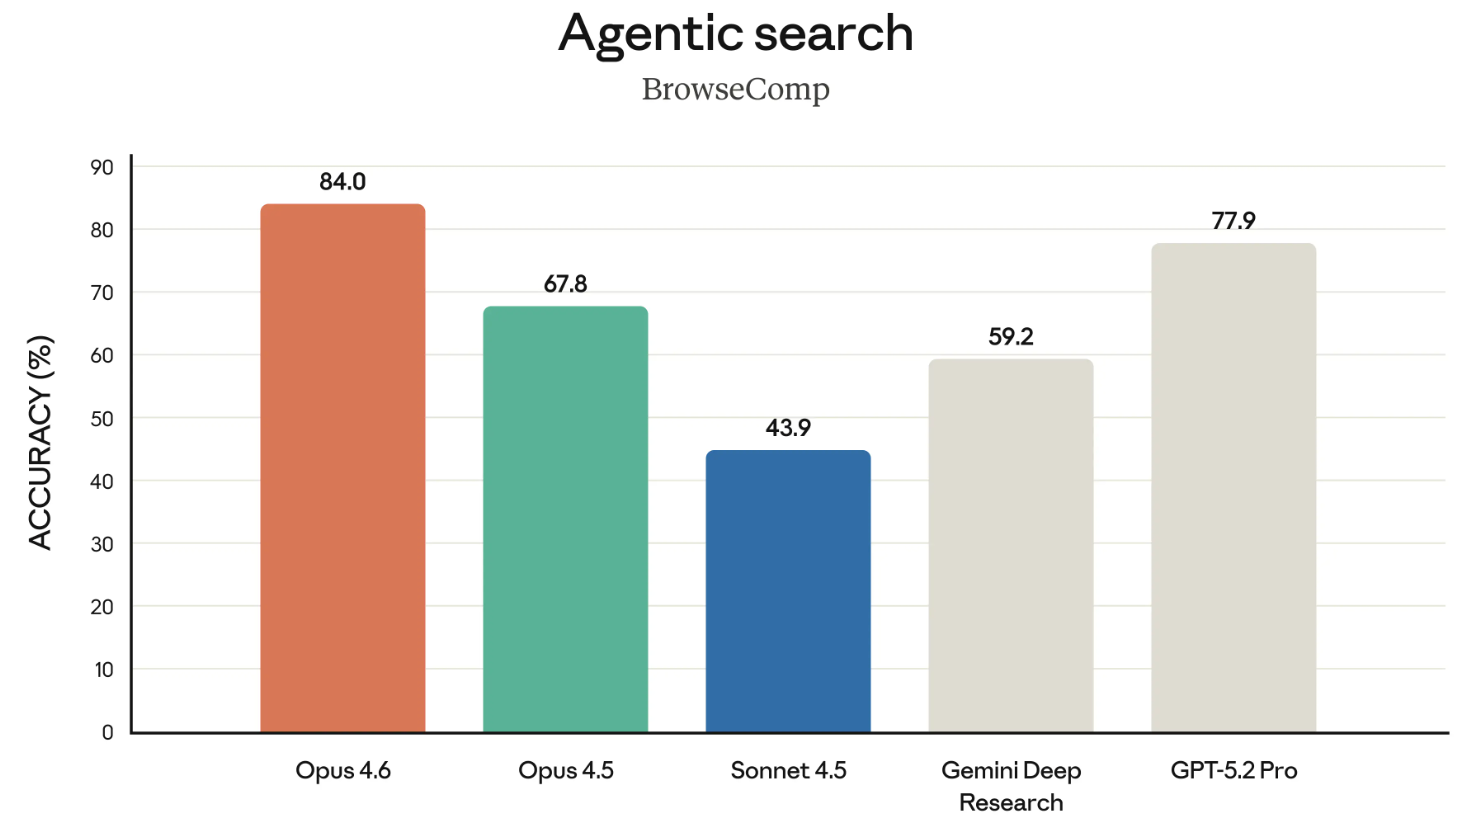
Terminal-Bench 2.0 एक एजेंटिक कोडिंग बेंचमार्क है; Humanity’s Last Exam जटिल तर्क का परीक्षण है; GDPval-AA, नॉलेज वर्क के प्रदर्शन को मापता है; BrowseComp किसी मॉडल की ऑनलाइन मुश्किल-से-मिलने वाली जानकारी खोजने की क्षमता मापता है।
Claude मॉडल्स सर्वश्रेष्ठ कोडर्स में से माने जाते हैं। तो आइए Terminal-Bench 2.0 बेंचमार्क के परिणाम देखें।
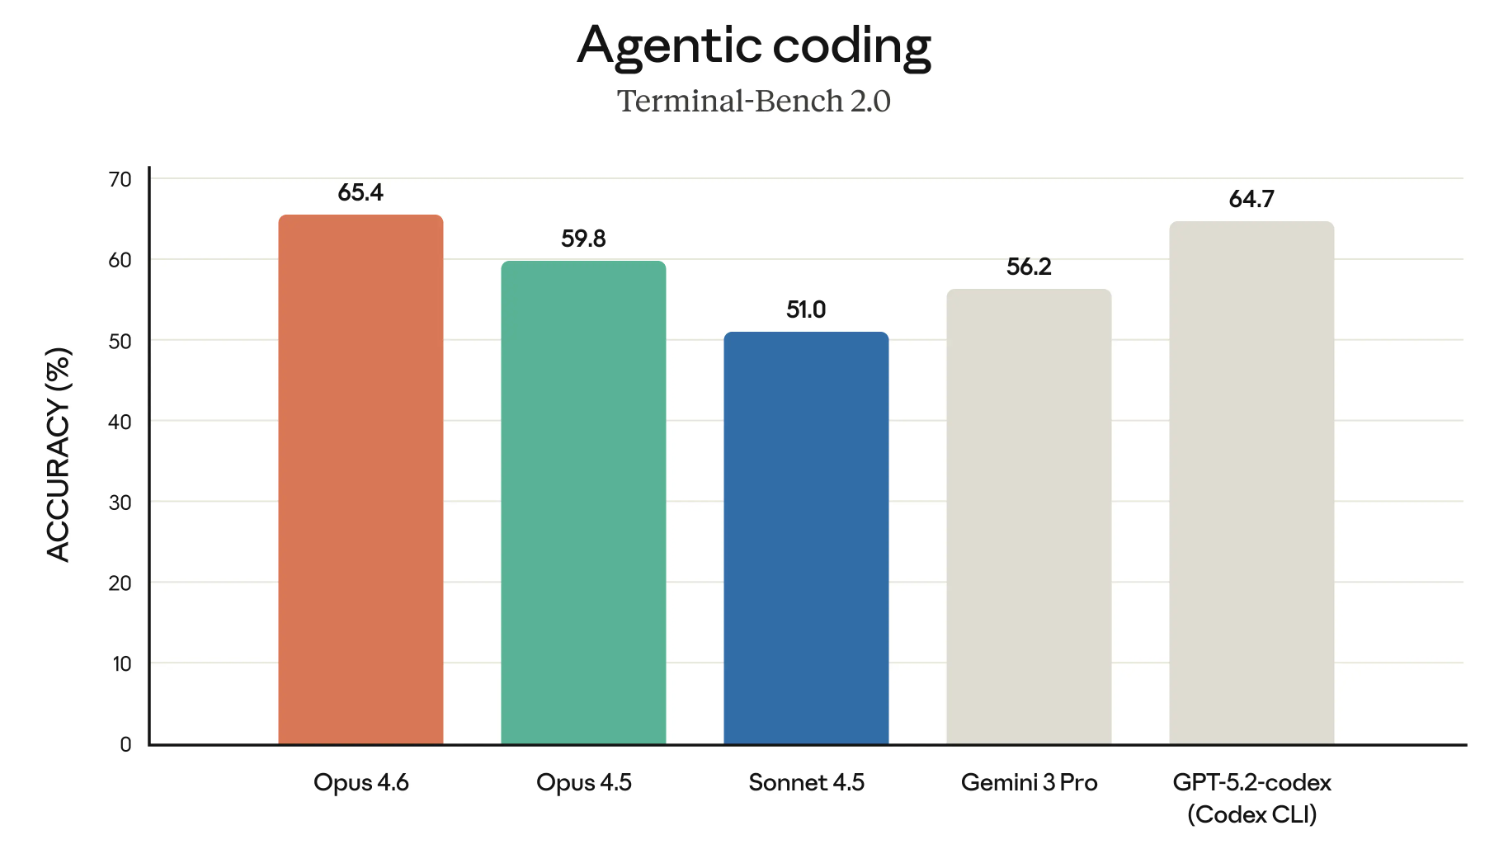
यदि ऊपर का ग्राफ Opus 4.6 को GPT-5.2-codex के संदर्भ में उजागर करता दिख रहा है—तो यह शायद जानबूझकर है। हाल में Anthropic ने कई क्षेत्रों में सीधे OpenAI को चुनौती दी है और एंटरप्राइज़ उपयोग के लिए अपना दावा पेश कर रहा है।
Humanity’s Last Exam सबसे प्रसिद्ध बेंचमार्क्स में से एक है, और हम सब इसे करीब से देखते हैं। यह किसी मॉडल की सामान्य रूप से तर्क करने की क्षमता मापता है।
निम्न ग्राफ दिखाता है कि HLE बेंचमार्क पर अलग-अलग फ्रंटियर मॉडल, टूल्स के साथ और बिना, कैसे सफल रहे। (‘टूल्स के साथ’ का मतलब है कि मॉडल को वेब सर्च और कोड निष्पादन जैसी बाहरी क्षमताएं उपयोग करने दी गईं।)
यह ग्राफ शायद दो ग्राफ होता तो बेहतर होता। उस मामूली बात के बावजूद, संदेश स्पष्ट है: Opus 4.6 ‘टूल्स के साथ’ और ‘टूल्स के बिना’ दोनों श्रेणियों में लीडर है।
GDPval-AA (नाम से ही स्पष्ट) आर्थिक रूप से मूल्यवान नॉलेज वर्क का टेस्ट है। जैसे वित्तीय मॉडल चलाना या रिसर्च करना।
GDPval-AA और अन्य, समान बेंचमार्क्स का महत्व बढ़ता जा रहा है क्योंकि ये वही काम मापते हैं जिनके लिए एंटरप्राइज़ वास्तव में भुगतान करते हैं। GDPval-AA पर Opus 4.6 की सफलता GPT मॉडल सूट के लिए एक सीधी चुनौती भी है क्योंकि OpenAI और Anthropic कई समान ग्राहकों के लिए प्रतिस्पर्धा कर रहे हैं।
BrowseComp इस रिलीज़ का अंतिम उल्लेखनीय बेंचमार्क है। यह किसी मॉडल की ऑनलाइन मुश्किल-से-मिलने वाली जानकारी ढूंढ़ने की क्षमता मापता है। थोड़ा इतिहास: OpenAI ने वास्तव में BrowseComp अपने मॉडलों की सर्च क्षमताएं दिखाने के लिए विकसित किया था।
एक नुकीले कदम में, इस रिलीज़ में Anthropic ने सीधे OpenAI की अप्रैल 2025 की BrowseComp घोषणा को लिंक किया, जब यह दिखा रहा था कि Opus 4.6 इस पर चार्ट्स में टॉप करता है। यह कुछ शेडी-सा कदम था—OpenAI के अपने बेंचमार्क को उन्हीं के खिलाफ उद्धृत करना।
इस लेख के समय, Opus 4.6 व्यापक रूप से उपलब्ध है। हालांकि, Opus 4.6 तक पहुंचने के लिए आपको प्रो अकाउंट में अपग्रेड करना होगा, जो अन्य फायदे भी देता है, जैसे Excel में Claude का उपयोग।
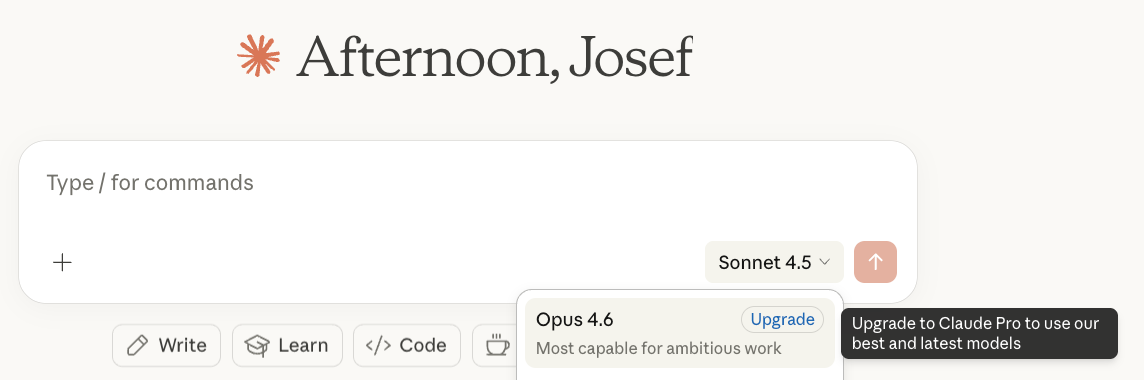
यदि आप डेवलपर हैं, तो Claude API में claude-opus-4-6 का उपयोग करें। प्राइसिंग नहीं बदली है: अब भी प्रति मिलियन टोकन $5/$25 है। यदि आप इन दो संख्याओं को लेकर उलझन में हैं, तो जान लें कि पहली संख्या वह है जो आप मॉडल को टोकन भेजने (यानी आपके प्रॉम्प्ट) के लिए देते हैं, और दूसरी वह है जो आप मॉडल द्वारा जेनरेट किए टोकन (रिस्पॉन्स) के लिए देते हैं।
Claude Opus 4.6, GPDVal-AA जैसे महत्वपूर्ण बेंचमार्क्स पर लीडरबोर्ड में शीर्ष पर है, जो मापता है कि कोई मॉडल आर्थिक रूप से महत्वपूर्ण कार्यों में कैसा करता है—यही बड़ी एंटरप्राइज़ कंपनियों की प्राथमिकता होती है। OpenAI इस विकास से असहज हो सकता है क्योंकि Opus 4.6 की रिलीज़ से कुछ ही घंटे पहले उन्होंने OpenAI Frontier की घोषणा की, जो प्रोडक्शन में AI एजेंट्स बनाने, तैनात करने, और प्रबंधित करने के लिए नया एंटरप्राइज़ प्लेटफ़ॉर्म है।
दूसरे शब्दों में, मॉडल बेंचमार्क्स पर सीधी प्रतिस्पर्धा करने के बजाय, Frontier दिखाता है कि OpenAI अपने मॉडल सूट के इर्द-गिर्द इन्फ्रास्ट्रक्चर पर केंद्रित है—खासतौर पर AI एजेंट्स को साझा बिज़नेस संदर्भ, परमिशन्स, और समय के साथ फीडबैक प्राप्त करने व उससे सीखने की क्षमता देकर। बेंचमार्क्स पर जमीन खोते हुए, OpenAI संकेत दे रहा है कि उसका प्लेटफ़ॉर्म कंपनियों में एजेंट्स को वास्तव में उपयोगी बनाने के लिए बेहतर स्थिति में है।
यह रणनीतिक बदलाव है या मॉडल रेस हारने की मौन स्वीकृति—यह निर्णय आप करें।
कुल मिलाकर, हम Anthropic के Claude Opus 4.6 से प्रभावित हैं, और एजेंट टीम्स के साथ हैंड्स-ऑन होने को उत्सुक हैं। यदि आप Claude परिवार के बारे में और सीखना चाहते हैं, तो Introduction to Claude Models कोर्स ज़रूर देखें।
DataCamp के साथ AI सीखें
course
course
course