
कोर्स
Large Language Models (LLMs) कॉन्सेप्ट्स
2 घंटा
112.1K
नए AI मॉडल लगभग हर हफ्ते लॉन्च होते हैं: Gemini 3, Claude Opus 4.5, GPT-5.2, Mistral Large 3। हर रिलीज के साथ बेंचमार्क स्कोर और किसी-न-किसी चीज़ में सर्वश्रेष्ठ होने के दावे आते हैं। दिक्कत यह है: ज़्यादातर लोगों को नहीं पता कि ये संख्याएँ क्या बताती हैं या इन्हें कैसे तुलना करें।
लार्ज लैंग्वेज मॉडल (LLM) बेंचमार्क मानकीकृत परीक्षण हैं जो मॉडलों के विशिष्ट कार्यों पर प्रदर्शन को मापते हैं—सामान्य ज्ञान प्रश्नोत्तरी से लेकर जटिल कोडिंग चुनौतियों और बहु-चरणीय तर्क तक। हर बेंचमार्क क्या मापता है, यह समझना आपको मार्केटिंग के शोर से परे देखने और अपनी वास्तविक जरूरत के लिए सही मॉडल चुनने में मदद करता है।
यह मार्गदर्शिका प्रमुख बेंचमार्क श्रेणियों को समझाती है, बताती है कि मौजूदा रैंकिंग कहाँ मिलेंगी, और यह भी दिखाती है कि आप अपने मूल्यांकन कैसे चला सकते हैं। अंत तक, आप लीडरबोर्ड पढ़ना और अपने उपयोग-मामले के अनुरूप AI चुनना जान जाएंगे।
यह समझने के लिए कि LLMs अंदर से कैसे काम करते हैं, हमारा LLMs Concepts कोर्स देखें।
LLM बेंचमार्क एक मानकीकृत परीक्षण है जो मापता है कि कोई भाषा मॉडल किसी खास प्रकार के कार्य को कितना अच्छी तरह संभालता है। एक ही सवाल और स्कोरिंग मानदंड हर उस मॉडल पर लागू किए जाते हैं जो यह टेस्ट लेता है।
मॉडल घोषणाओं में दिखने वाली संख्याएँ कुछ लोकप्रिय परीक्षणों से आती हैं। हर स्कोर एक अलग कहानी कहता है, और कोई एक बेंचमार्क पूरी तस्वीर नहीं देता।
तीन कारणों से बेंचमार्क ज़रूरी हैं:
मॉडल तुलना: जब OpenAI GPT-5.2 लाता है और Anthropic उसी महीने Claude Opus 4.5 जारी करता है, तो बेंचमार्क हमें साझा आधार देते हैं। वरना हम केवल हर कंपनी के अपने-अपने चुने उदाहरणों पर जीत के दावों में फँसे रहते।
प्रगति का आकलन: एक ही बेंचमार्क को समय के साथ चलाएँ, और आप देख पाएँगे कि मॉडल सच में बेहतर हो रहे हैं या नहीं। MMLU स्कोर 2022 में 70% से 2025 में 90% से ऊपर पहुँच गए।
कमजोरियाँ पकड़ना: कोई मॉडल सामान्य ज्ञान में बेहतरीन हो सकता है लेकिन बहु-चरणीय गणित में अटक सकता है। बेंचमार्क इन कमजोरियों को उजागर करते हैं।
बेंचमार्क स्कोर केवल कच्ची बुद्धिमत्ता नहीं दर्शाते। कई कारक लीडरबोर्ड पर दिखने वाली संख्याएँ तय करते हैं।
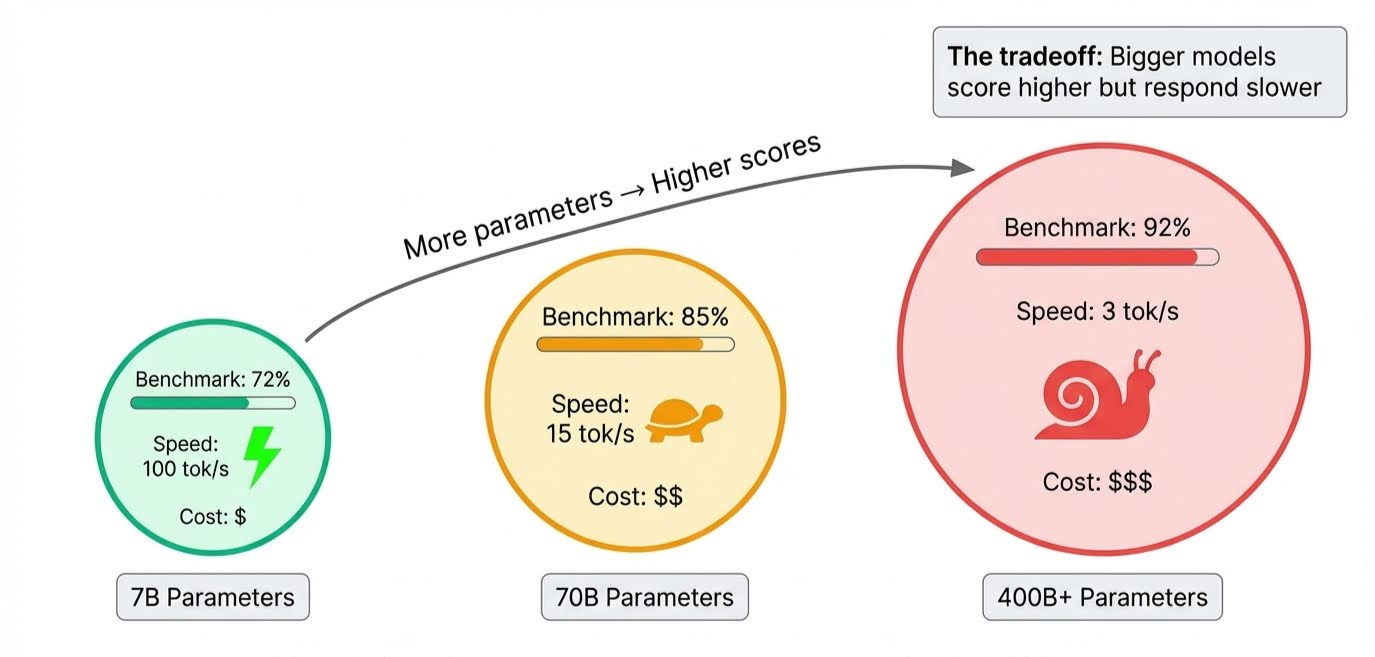
मॉडल का आकार सबसे स्पष्ट कारक है। पैरामीटर्स वह सब संग्रहीत करते हैं जो मॉडल सीखता है, और अग्रणी मॉडल्स में यह सैकड़ों अरब तक होते हैं। ज़्यादा पैरामीटर्स का मतलब अधिक जटिल तर्क और बारीकियों को संभालने की क्षमता—जो स्कोर बढ़ाती है।
इसका नुकसान इन्फरेंस के दौरान दिखता है, जब मॉडल वास्तव में जवाब बनाता है: उन सभी पैरामीटर्स को क्रम से सक्रिय होना पड़ता है, इसलिए बड़े मॉडल धीमे होते हैं। कोई मॉडल हर बेंचमार्क में आगे हो सकता है, पर उत्तर देने में कई सेकंड ले सकता है।
ट्रेनिंग अवधि और पेचीदा है। ट्रेनिंग डेटा पर हर पास को एपॉक कहते हैं। बहुत कम हुए तो मॉडल ने पर्याप्त नहीं सीखा होगा, बहुत अधिक हुए तो वह उदाहरण याद करने लगता है बजाय ऐसे पैटर्न सीखने के जो नए सवालों पर लागू हों। इसे ओवरफिटिंग कहते हैं—और बेंचमार्क डिजाइनर इसे पकड़ने के लिए जान-बूझकर ऐसे सवाल शामिल करते हैं जो मॉडल ने ट्रेनिंग के दौरान नहीं देखे होते।
आज उपयोग में दर्जनों बेंचमार्क हैं, इसलिए उन्हें उनकी जाँच सामग्री के आधार पर समूहबद्ध करना उपयोगी है।
बेंचमार्क मोटे तौर पर एक पदानुक्रम में बँटते हैं। आधार में, ज्ञान परीक्षण देखते हैं कि मॉडल क्या जानता है। उसके ऊपर, तर्क बेंचमार्क जाँचते हैं कि वह कितना अच्छा सोचता है। शीर्ष पर एजेंटिक और मल्टीमोडल परीक्षण हैं जो मापते हैं कि AI वास्तविक दुनिया में कार्य कर सकता है या पाठ के अलावा अन्य सूचना संसाधित कर सकता है।
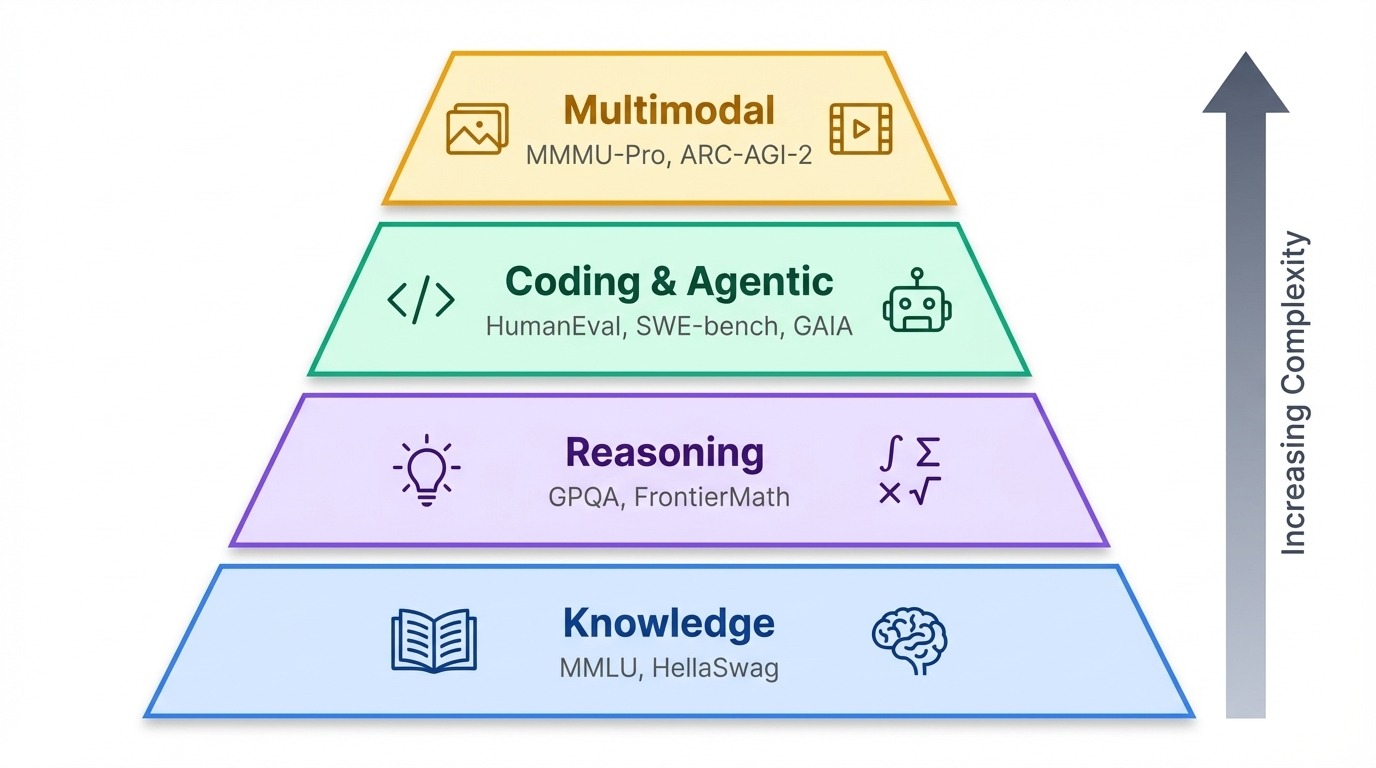
MMLU (Massive Multitask Language Understanding) हाई स्कूल से प्रोफ़ेशनल स्तर तक 57 अकादमिक विषयों को कवर करता है—अमूर्त बीजगणित से लेकर विश्व धर्मों तक। वर्षों तक यह सामान्य ज्ञान का मानक परीक्षण रहा, लेकिन अब अग्रणी मॉडल 88% से ऊपर सिमट गए हैं, जिससे उन्हें अलग करना मुश्किल हो गया है।
इस संतृप्ति ने शोधकर्ताओं को कठिन परीक्षणों की ओर धकेला। GPQA (Graduate-level Google-Proof Q&A) जीवविज्ञान, भौतिकी और रसायन में 448 प्रश्न पूछता है, जिन्हें विशेषज्ञों ने जान-बूझकर गूगल-प्रूफ बनाया है।
इस बेंचमार्क में तीन कठिनाई स्तर हैं, जिनमें Diamond सबसे कठिन है। भले ही वेब की असीमित पहुँच मिले, गैर-विशेषज्ञ केवल 34% स्कोर करते हैं—चार विकल्पों में अनुमान लगाने से अपेक्षित नतीजे से बस 9% ऊपर। दिसंबर 2025 तक, Gemini 3 Pro GPQA Diamond में 92.6% के साथ अग्रणी है।
OpenAI का GDPval (Gross Domestic Product-valued) बेंचमार्क कुछ अलग मापता है: वास्तविक दुनिया का कार्य-उत्पादन। यह $3 ट्रिलियन वार्षिक आर्थिक गतिविधि वाले क्षेत्रों में 44 व्यवसायों को कवर करता है, और बहुविकल्पीय प्रश्नों के बजाय मॉडलों से कानूनी ब्रीफ़, स्लाइड डेक, और इंजीनियरिंग स्पेक जैसी डिलिवरेबल्स बनवाता है। हाल ही में जारी GPT-5.2 यहाँ अग्रणी है।
HellaSwag सामान्य-बुद्धि तर्क को परखता है—यह रोज़मर्रा के दृश्य देता है और मॉडलों से सबसे संभावित अगला वाक्य चुनने को कहता है। उदाहरण: खाना बना रहा व्यक्ति पैन की ओर हाथ बढ़ाता है। आगे क्या होगा?
गलत उत्तर खास तौर पर AI को चकमा देने के लिए लिखे गए हैं: वे सांख्यिकीय रूप से सन्दर्भ में फिट बैठते हैं, लेकिन असंभव घटनाएँ बताते हैं (पैन उड़ जाता है, स्टोव बिल्ली बन जाता है)। इंसान 95.6% स्कोर करते हैं क्योंकि हमें रसोई का कामकाज पता है। मॉडल शब्दों की संभावना का अनुमान लगाते हैं, घटनाओं की नहीं—इसलिए वे फँस जाते हैं।
नए बेंचमार्क कठिनाई को और आगे बढ़ाते हैं:
FrontierMath में शोध गणितज्ञों के अभूतपूर्व सवाल हैं—जहाँ सर्वश्रेष्ठ मॉडल भी 20% से कम स्कोर करते हैं।
Humanity's Last Exam में 2,500 विशेषज्ञ-स्तरीय प्रश्न हैं, जिन्हें अनुमान लगाने का विरोध करने के लिए बनाया गया है।
MathArena 2025 की गणित प्रतियोगिताओं से समस्याएँ खींचता है ताकि ट्रेनिंग डेटा का शून्य ओवरलैप सुनिश्चित हो।
HumanEval क्लासिक कोडिंग टेस्ट है: इसमें 164 Python समस्याएँ हैं, जिनमें मॉडल्स डॉकस्ट्रिंग से फ़ंक्शंस लिखते हैं और यूनिट टेस्ट पास करने पर ग्रेड किए जाते हैं। अधिकतर मौजूदा अग्रणी मॉडल 85% से ऊपर हैं, इसलिए शोधकर्ताओं ने HumanEval+ जैसे कठिन संस्करण बनाए, जिनके टेस्ट केस और कठोर हैं।
SWE-bench (Software Engineering Benchmark) अलग दिशा में जाता है—यह पृथक फ़ंक्शंस से आगे बढ़कर मॉडलों को वास्तविक GitHub रिपॉज़िटरी में डालता है और असली बग ठीक करने को कहता है। मॉडल को कोडबेस में नेविगेट करना, समस्या समझना, और काम करता पैच बनाना होता है।
SWE-bench Verified मूल SWE-bench का छोटा, अत्यंत चयनित उपसमुच्चय है, जो मानव इंजीनियरों द्वारा जाँचे-परखे उच्च-गुणवत्ता वाले कार्यों को फ़िल्टर करता है। दिसंबर 2025 तक, Claude Opus 4.5 SWE-bench Verified में 80.9% के साथ 80% का आंकड़ा पार करने वाला पहला मॉडल है।
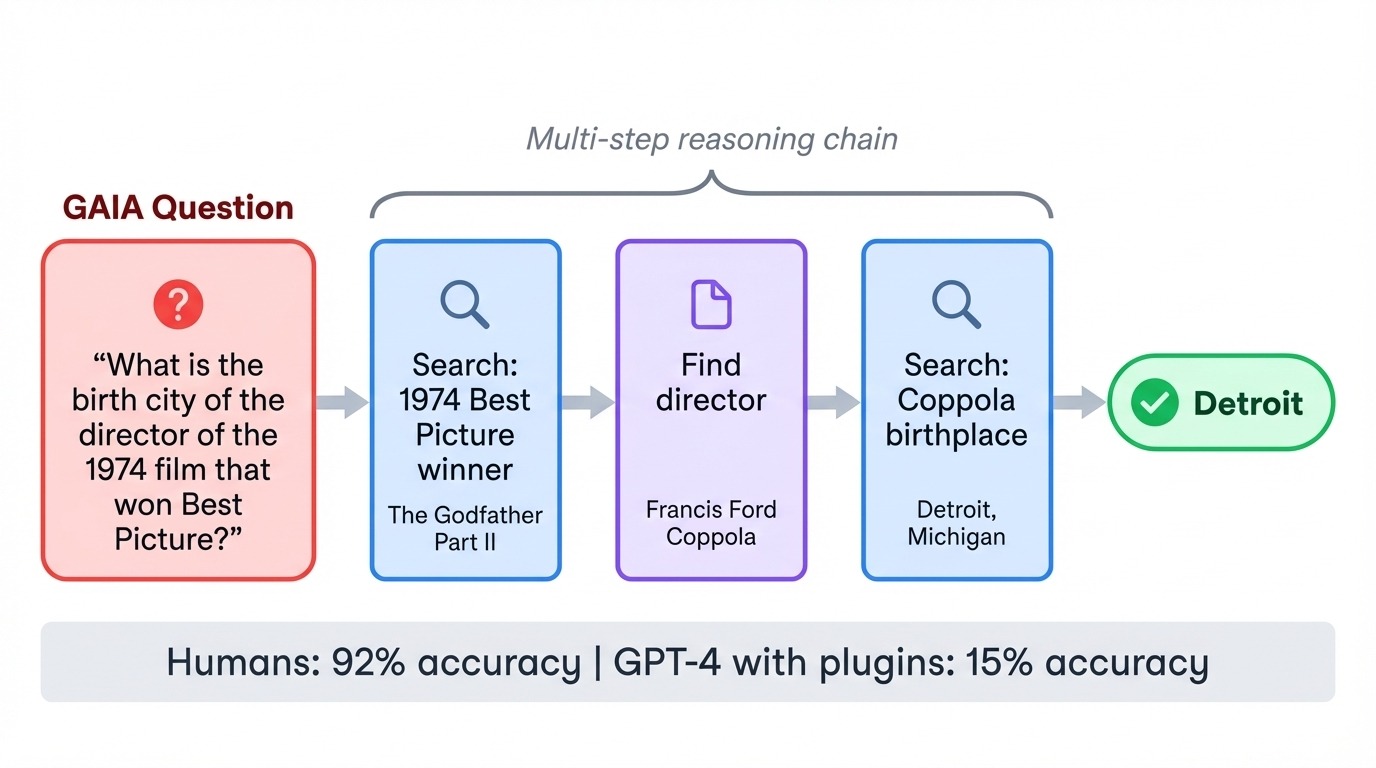
GAIA (General AI Assistants) सामान्य कठिनाई संबंध को उलट देता है। इसके 466 कार्य इंसानों के लिए बेहद आसान (92% सटीकता) लेकिन AI के लिए कठोर हैं। जब GPT-4 ने पहली बार प्लगइन्स के साथ GAIA आज़माया, तो वह केवल 15% स्कोर कर पाया। हर कार्य में कई कदम जोड़ना पड़ता है: वेब खोजना, दस्तावेज़ पढ़ना, गणना करना, और उत्तर संश्लेषित करना।
एक सामान्य प्रश्न 1970 के दशक की किसी फ़िल्म के निर्देशक के जन्म-नगर के बारे में पूछ सकता है—जिसके लिए मॉडल को पहले फ़िल्म पहचाननी, फिर निर्देशक ढूँढ़ना, और फिर जीवनी संबंधी विवरण खोजना होगा। यह बेंचमार्क जाँचता है कि मॉडल टूल्स का समन्वय कर सकता है और बहु-चरणीय योजना बिना धागा खोए चला सकता है या नहीं।
अंत में, WebArena मॉडलों को स्वयं-होस्टेड वेब वातावरण में तैनात करता है, जहाँ उन्हें ब्राउज़र इंटरफेस के साथ बातचीत करके उड़ानें बुक करने, कंटेंट सिस्टम प्रबंधित करने और ई-कॉमर्स साइटों पर नेविगेट करने जैसे कार्य पूरे करने पड़ते हैं।
केवल-पाठ बेंचमार्क एक उभरती सीमारेखा को मिस कर देते हैं। MMMU-Pro (Massive Multi-discipline Multimodal Understanding and Reasoning) 30 विषयों में दृश्य तर्क की जाँच करता है—प्रश्न सीधे चित्रों में एंबेड किए जाते हैं, जिससे मॉडलों को साथ-साथ दृश्य सूचना पढ़नी और व्याख्यायित करनी पड़ती है।
बेंचमार्क उन सवालों को फ़िल्टर कर देता है जिन्हें केवल-पाठ मॉडल हल कर सकते थे, ताकि विज़न वाकई मायने रखे। यहाँ Gemini 3 Pro 81% के साथ अग्रणी है।
कुछ बेंचमार्क दृश्य तर्क को अगले स्तर तक ले जाते हैं।
MathVista उदाहरण के लिए दृष्टि-धारणा को गणितीय तर्क के साथ मिलाता है—समस्याएँ फ़ंक्शन प्लॉट्स पढ़ने, वैज्ञानिक चार्ट समझने और आरेखों से ज्यामिति सुलझाने जैसी होती हैं। Video-MMMU इसे समय-आयामी समझ तक बढ़ाता है—जाँचता है कि मॉडल एकल चित्रों के बजाय वीडियो फ़्रेमों में कारण-कार्य और अनुक्रम पर तर्क कर सकते हैं या नहीं।
ARC-AGI-2 अब भी वह बेंचमार्क है जिसे AI नहीं तोड़ पाया। हर कार्य में कुछ इनपुट-आउटपुट ग्रिड उदाहरण दिए जाते हैं और मॉडल से रूपांतरण नियम निकालकर नए इनपुट पर लागू करने को कहा जाता है।
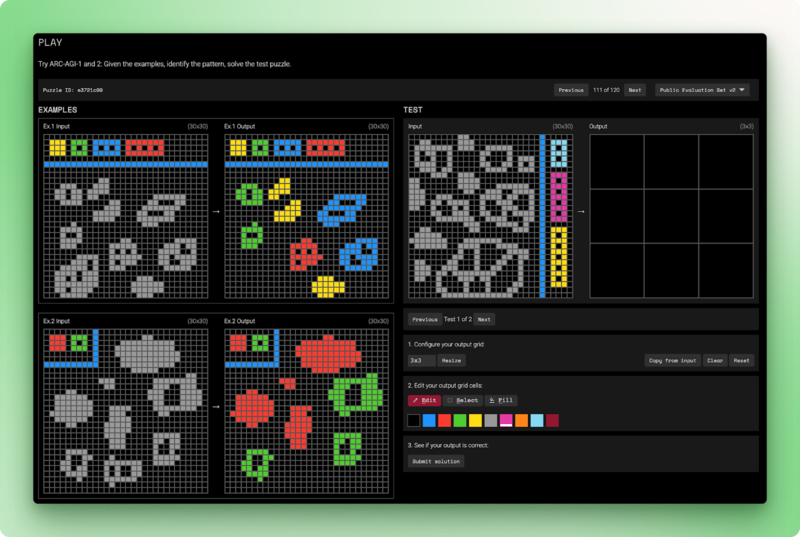
इंसान ये पहेलियाँ दो प्रयासों से कम में हल कर लेते हैं। शुद्ध भाषा मॉडल 0% स्कोर करते हैं। सर्वश्रेष्ठ हाइब्रिड सिस्टम 54% तक पहुँचते हैं—वह भी प्रति कार्य $30 की लागत पर। ARC-AGI-2 द्रव बुद्धिमत्ता परखता है: प्रशिक्षण के दौरान देखे पैटर्न मिलाने के बजाय प्रथम सिद्धांतों से तर्क करना।
बेंचमार्क स्कोर उत्पन्न करते हैं, पर लीडरबोर्ड उन्हें कैसे प्रस्तुत किया जाए, यह तय करते हैं। अलग प्लेटफ़ॉर्म अलग चीज़ों को प्राथमिकता देते हैं: मानव वरीयता, ओपन-सोर्स पारदर्शिता, या बहु-आयामी मूल्यांकन। आपको कौन-सा लीडरबोर्ड देखना चाहिए, यह इस पर निर्भर करता है कि आप क्या मापना चाहते हैं।
LMArena (LMSYS Chatbot Arena) स्वचालित बेंचमार्क से अलग तरीका अपनाता है। उत्तरों को रूब्रिक के विरुद्ध स्कोर करने के बजाय, यह मनुष्यों से बेहतर उत्तर चुनने को कहता है। उपयोगकर्ता एक प्रॉम्प्ट जमा करते हैं, दो गुमनाम मॉडलों के आउटपुट पाते हैं, और जिसको पसंद करते हैं उसे वोट देते हैं। ब्रांड पूर्वाग्रह से बचने के लिए वोट के बाद ही मॉडल का नाम दिखाया जाता है।
यह प्लेटफ़ॉर्म 50 लाख से अधिक जोड़ीदार वोटों को ब्रैडली-टेरी सांख्यिकीय मॉडल से रैंकिंग में बदलता है। दिसंबर 2025 तक, Gemini 3 Pro 1501 स्कोर के साथ समग्र एरीना में अग्रणी है, उसके बाद Grok 4.1 1483 पर, फिर Claude Opus 4.5 और GPT-5.2 आते हैं।
LMArena वह चीज़ पकड़ता है जो बेंचमार्क मिस करते हैं: क्या उत्तर वाकई मददगार लगता है। समझौता यह है कि लंबे, आत्मविश्वासी उत्तर कभी-कभी वोट जीत लेते हैं, भले ही कोई छोटा, अधिक सटीक उत्तर मौजूद हो।
Hugging Face का Open LLM Leaderboard ओपन-सोर्स मॉडलों पर केंद्रित है और EleutherAI Evaluation Harness का उपयोग करते हुए मानकीकृत परीक्षण चलाता है। संस्करण 2 जून 2024 में कठिनतर बेंचमार्क के साथ लॉन्च हुआ, क्योंकि अग्रणी मॉडल मूल टेस्ट सूट पर संतृप्त हो चुके थे।
वर्तमान बैटरी में GPQA, MATH Level 5, और MMLU-PRO शामिल हैं, जहाँ स्कोर सामान्यीकृत हैं—0 का अर्थ यादृच्छिक प्रदर्शन और 100 का अर्थ पूर्ण। शीर्ष ओपन मॉडल्स में Qwen3, Llama 3.3 70B, और DeepSeek V3.1 शामिल हैं, जो क्लोज़्ड-सोर्स नेताओं के काफ़ी क़रीब प्रतिस्पर्धा कर रहे हैं।
Stanford HELM (Holistic Evaluation of Language Models) केवल परिणामों की सटीकता ही नहीं मापता। हर परिदृश्य में हर मॉडल को सात आयामों पर आंका जाता है: सटीकता, कैलिब्रेशन, मजबूती, निष्पक्षता, पक्षपात, विषाक्तता, और दक्षता।
यह फ़्रेमवर्क 42 परिदृश्यों को कवर करता है और स्पष्ट रूप से जहाँ मॉडल असफल होते हैं, उसे भी ट्रैक करता है—सिर्फ उनकी सफलताएँ नहीं। HELM एक अलग सुरक्षा लीडरबोर्ड भी चलाता है जो हिंसा, धोखाधड़ी, और उत्पीड़न जैसे जोखिमों का आकलन करता है। दिसंबर 2025 तक, Claude 3.5 Sonnet समग्र सुरक्षा स्कोर में सबसे ऊपर है।
कोई एक कंपनी हर जगह नहीं जीतती। लेकिन जैसे ही आप कुछ लीडरबोर्ड्स का क्रॉस-रेफ़रेंस करते हैं, पैटर्न दिखने लगते हैं।
Google के Gemini मॉडल्स मल्टीमोडल बेंचमार्क और वैज्ञानिक तर्क में हावी हैं। Gemini 3 Pro GPQA Diamond में 91.9% के साथ आगे है और एरीना में भी शीर्ष पर है। Anthropic की Claude लाइन कोडिंग और सुरक्षा में उत्कृष्ट है। Claude Opus 4.5 SWE-bench Verified का 80.9% का रिकॉर्ड रखता है, और Claude 3.5 Sonnet HELM Safety में अग्रणी है।
OpenAI के GPT मॉडल मज़बूत जनरलिस्ट बने हुए हैं—अधिकांश बेंचमार्क में प्रतिस्पर्धी, बिना किसी स्पष्ट बड़ी कमजोरी के। Meta की Llama श्रृंखला दिखाती है कि ओपन-सोर्स कई कार्यों पर क्लोज़्ड मॉडलों की बराबरी कर सकता है—Llama 3.3 70B के आउटपुट कहीं-कहीं कहीं बड़े मालिकाना सिस्टम्स के समकक्ष हैं।
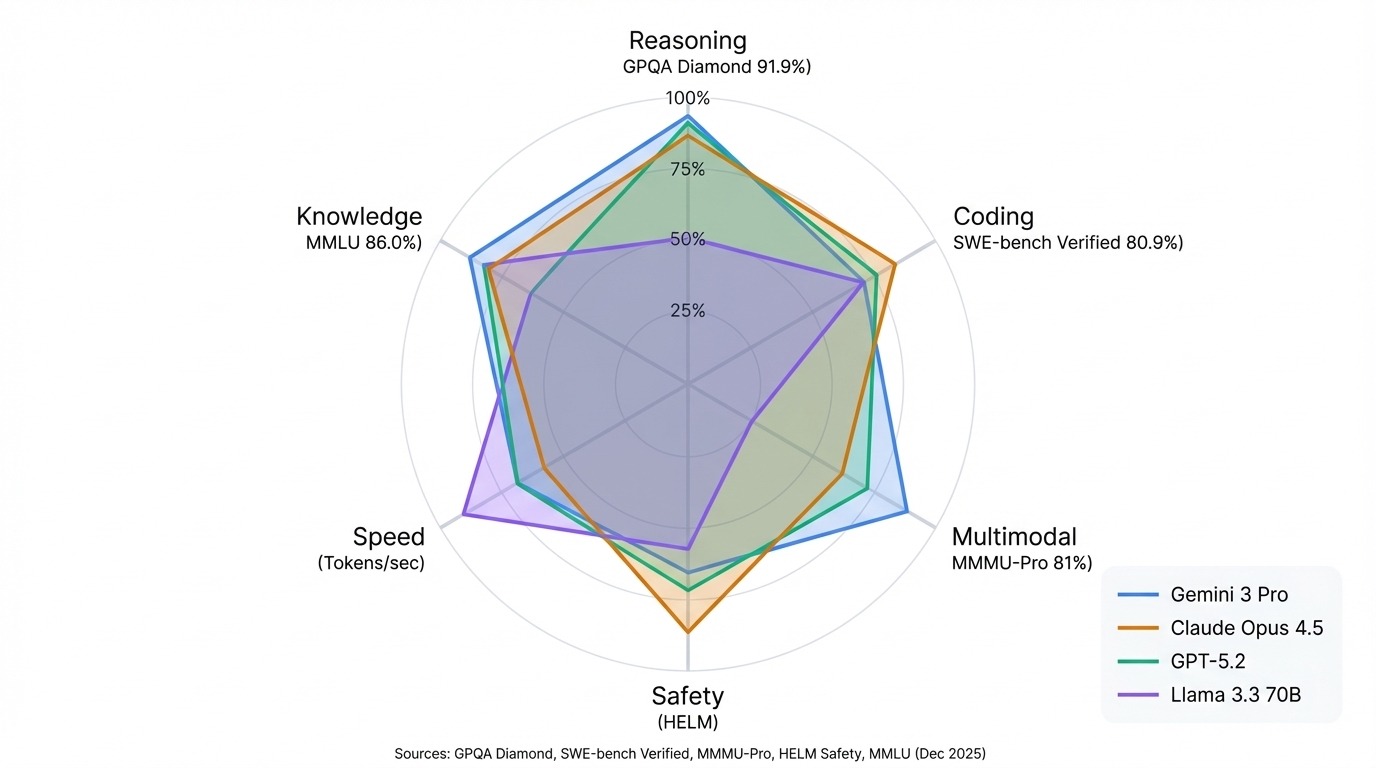
सबसे महत्वपूर्ण पैटर्न: अपने उपयोग-मामले से मेल खाता लीडरबोर्ड चुनें। एरीना रैंकिंग्स बातचीत की गुणवत्ता दर्शाती हैं। HELM स्कोर विश्वसनीयता और सुरक्षा बताते हैं। Hugging Face दिखाता है कि आप स्वयं क्या चला सकते हैं। जो मॉडल एक सूची में शीर्ष पर है, वह दूसरी में मध्यम हो सकता है—और यह रैंकिंग की खामी नहीं—बल्कि इसलिए कि अलग परीक्षण अलग चीज़ें मापते हैं।
लीडरबोर्ड बताते हैं कि मॉडल मानक परीक्षणों पर कैसे तुलना करते हैं, पर कई बार आपको अपनी स्थिति-विशेष के उत्तर चाहिए होते हैं।
आप अपने हार्डवेयर के लिए ओपन-सोर्स मॉडल्स में चयन कर रहे हों, या सत्यापित कर रहे हों कि कोई फाइन-ट्यून किया मॉडल सामान्य तर्क क्षमता नहीं खो बैठा। अन्य मामलों में, मानक बेंचमार्क आपके डोमेन को कवर ही नहीं करते।
इन सभी स्थितियों में, आप खुद LLMs का बेंचमार्क करना चाहेंगे। मैं बताऊँगा कैसे करें और किन बातों का ध्यान रखें।
EleutherAI LM Evaluation Harness इन मूल्यांकनों को लोकली चलाने का इंडस्ट्री स्टैंडर्ड है। यह Hugging Face Open LLM Leaderboard को शक्ति देता है और 60 से अधिक बेंचमार्क का समर्थन करता है।
यह अधिकतर लोगों के चैटबॉट से बातचीत करने के तरीके से अलग काम करता है। यह केवल मॉडल से "चैट" नहीं करता; यह अधिक नियतात्मक गणितीय विश्लेषण करता है।
बहुविकल्पीय प्रश्नों के लिए—जैसे MMLU या ARC के बेंचमार्क—हार्नेस मॉडल से "A," "B," "C," या "D" आउटपुट करने को नहीं कहता। इसके बजाय, यह हर विकल्प के लिए अलग प्रॉम्प्ट बनाता है और पूछता है कि हर एक की संभावना कितनी है। जिसका लॉग-लाइकलीहुड सबसे अधिक होता है, उसे मॉडल की पसंद माना जाता है।
अन्य बेंचमार्क जनरेटिव दृष्टिकोण माँगते हैं—जहाँ मॉडल पूरा टेक्स्ट उत्तर बनाता है। जेनरेशन के बाद हार्नेस रेगुलर एक्सप्रेशन (regex) से आउटपुट पार्स करता है और उत्तर कुंजी से मिलान के लिए जरूरी मान निकालता है।
आइए, अपना पहला LLM मूल्यांकन चलाना सीखते हैं।
आप pip का उपयोग करके इवैल्युएशन हार्नेस इंस्टॉल कर सकते हैं:
pip install lm-evalपूरे मूल्यांकन से पहले, पाइपलाइन को एक छोटे सैंपल से टेस्ट करें। --limit फ़्लैग बेंचमार्क को निर्दिष्ट उदाहरणों तक सीमित करता है। यह उदाहरण Qwen2.5-1.5B-Instruct का परीक्षण करता है—एक छोटा मॉडल जो अधिकतर हार्डवेयर पर हाई-एंड GPU के बिना चलता है—HellaSwag बेंचमार्क के साथ:
lm_eval --model hf \
	--model_args pretrained=Qwen/Qwen2.5-1.5B-Instruct \
	--tasks hellaswag \
	--device mps \
	--batch_size 4 \
--limit 10|
कार्य |
संस्करण |
फ़िल्टर |
n-shot |
मेट्रिक |
|
मान |
|
Stderr |
|
hellaswag |
1 |
none |
0 |
acc |
↑ |
0.3 |
± |
0.1528 |
|
none |
0 |
acc_norm |
↑ |
0.4 |
± |
0.1633 |
आउटपुट दो सटीकता मीट्रिक्स दिखाता है: acc कच्ची सटीकता है, जबकि acc_norm मॉडल के छोटे या लंबे समापन की ओर पक्षपात के लिए समायोजित करता है। साथ ही, मानक त्रुटि (standard error) भी दी जाती है, जो सैंपल आकार बढ़ने पर घटती है। हमारे पहले टेस्ट में केवल 10 सैंपल होने के कारण, ऊँचा Stderr (0.15) बताता है कि ये स्कोर मोटा अनुमान हैं।
पूरा बेंचमार्क चलाने के लिए --limit हटा दें। एक ही बार में कई बेंचमार्क चलाने के लिए, उन्हें कॉमा से लिखें:
lm_eval --model hf \
	--model_args pretrained=Qwen/Qwen2.5-1.5B-Instruct \
	--tasks hellaswag,mmlu,arc_easy \
	--device mps \
	--batch_size 8 \
	--output_path ./results
--device अपने हार्डवेयर के अनुसार सेट करें: mps Apple Silicon के लिए, cuda:0 NVIDIA GPUs के लिए, या cpu बैकअप के रूप में। पूर्ण MMLU एक आधुनिक GPU पर 1–2 घंटे लेता है; HellaSwag जैसे छोटे बेंचमार्क मिनटों में पूरे हो जाते हैं।
विलंबता और थ्रूपुट परीक्षण के लिए, Ollama मॉडल लोकली चलाता है और अलग-अलग क्वांटाइज़ेशन स्तरों पर टोकन-प्रति-सेकंड रिपोर्ट करता है। कोई 7B मॉडल V100 पर 100+ टोकन/सेकंड जेनरेट कर सकता है, जबकि 70B मॉडल एकल अंकों तक गिर जाता है।
LLM का बेंचमार्क करते समय कुछ श्रेष्ठ अभ्यास ध्यान रखने चाहिए।
सबसे पहले और सबसे महत्वपूर्ण, सुनिश्चित करें कि मॉडल ने ट्रेनिंग के दौरान मूल्यांकन प्रश्न नहीं देखे हों। अगर देखे हैं, तो आप मॉडल की तर्क-क्षमता नहीं, ओवरफिटिंग ही माप रहे हैं—जैसा कि शुरुआत में चर्चा हुई—और बेंचमार्क स्कोर अर्थहीन हो जाएँगे।
दोहराने योग्य नतीजों के लिए, मॉडल के उत्तरों में परिवर्तनशीलता जितनी कम हो सके उतनी रखें। यह तापमान (temperature) को शून्य पर सेट करके संभव है—जिससे रचनात्मकता पर सटीकता को तरजीह मिलती है।
हार्नेस हर बेंचमार्क के लिए मानकीकृत फ्यू-शॉट प्रॉम्प्ट्स देता है। अपने स्वयं के प्रॉम्प्ट लिखने के बजाय इन्हें ही उपयोग करें, क्योंकि शब्दों में छोटे बदलाव भी स्कोर पर अपेक्षा से अधिक असर डालते हैं। पर, डोमेन-विशिष्ट काम के लिए, प्रोडक्शन में मॉडल अपनाने से पहले हमेशा अपने क्षेत्र के वास्तविक उदाहरणों से एक छोटा टेस्ट सेट बनाइए।
मानक बेंचमार्क तथ्य-जांच में उत्कृष्ट हैं, पर सूक्ष्मताओं को मापने में संघर्ष करते हैं। सार-संक्षेपण या रचनात्मक लेखन जैसे खुले-समाप्ति वाले कार्यों के लिए, LLM-as-a-judge किसी अधिक शक्तिशाली मॉडल से आउटपुट को मददगारपन और सटीकता पर ग्रेड दिलाता है।
न्यायाधीश को आमतौर पर एक रूब्रिक दिया जाता है और या तो एक संख्यात्मक स्कोर (जैसे 1–10) देने या जोड़ीदार तुलना कर बेहतर उत्तर चुनने को कहा जाता है। यद्यपि यह परिपूर्ण नहीं, ये निर्णय मानव वरीयताओं से लगभग 80–85% तक मेल खाते हैं। इसलिए, LLM-as-a-judge महँगी मानवीय समीक्षा का एक स्केलेबल विकल्प प्रदान करता है।
AI मूल्यांकन उतनी ही तेज़ी से बदल रहा है जितनी तेज़ी से मॉडल बदल रहे हैं। जैसे-जैसे MMLU जैसे बेंचमार्क संतृप्त होते हैं, शोधकर्ता ऐसे कठिन परीक्षण बना रहे हैं जो रटे ज्ञान के बजाय तर्क की गहराई जाँचते हैं। FrontierMath और Humanity's Last Exam इस नई कठिनाई सीमा का प्रतिनिधित्व करते हैं, जहाँ सर्वश्रेष्ठ मॉडल भी जूझते हैं।
वृहत्तर संकेत एक दिशा में इशारा करते हैं: अधिक ट्रेनिंग कंप्यूट, स्मार्ट एल्गोरिद्म, और प्रगति के साथ कदम मिलाते बेंचमार्क सूट। मल्टीमोडल परीक्षणों से हम मॉडलों से और भी अपेक्षा करने लगे हैं—चार्ट पढ़ने से लेकर वीडियो अनुक्रम समझने तक।
पर निष्कर्ष सरल है: कोई एक स्कोर पूरी कहानी नहीं कहता। जो मॉडल एरीना में आगे है, वह SWE-bench में पीछे हो सकता है। शीर्ष कोडिंग मॉडल सुरक्षा में मध्यम स्कोर कर सकता है। अपने वास्तविक काम से मेल खाता बेंचमार्क चुनें—चाहे वह तर्क, कोड जेनरेशन, दृश्य समझ या कच्ची गति हो। तुलना में मायने सिर्फ यही रखता है।
बेंचमार्किंग से आगे अपनी क्षमताएँ ले जाने के लिए, खुद LLMs बनाना और फाइन-ट्यून करना सीखें—हमारे Developing Large Language Models स्किल ट्रैक के साथ।
LLM कोर्स
कोर्स
लर्निंग पाथ
लर्निंग पाथ