

{count, plural, one {लर्निंग पाथ} other {लर्निंग पाथ}}
सॉफ़्टवेयर इंजीनियरिंग के लिए AI
{hours} घंटा
Anthropic ने Claude Opus 4.7 जारी किया है, जो इसके फ्लैगशिप मॉडल टियर का नवीनतम संस्करण है। शीर्ष सुधार स्वायत्तता है: Anthropic इसे ऐसे मॉडल के रूप में पेश कर रहा है जिसे आप अपने सबसे कठिन, लंबे समय तक चलने वाले कोडिंग और एजेंट कार्य सौंप सकते हैं, वह भी बिना कड़ी निगरानी के।
इस रिलीज़ में हम यह भी जान रहे हैं कि Opus 4.7 के ऊपर एक छत है। Anthropic का आंतरिक Mythos Preview कई बेंचमार्क पर अधिक स्कोर करता है, लेकिन साइबर सुरक्षा उपायों का परीक्षण करते हुए इसे व्यापक रिलीज़ से रोका गया है। जो कोई भी Anthropic का आंतरिक शोधकर्ता नहीं है, उसके लिए Opus 4.7 वर्तमान छत है।
इस लेख में, हम देखेंगे कि Opus 4.7 में वास्तव में क्या नया है, बेंचमार्क परिणामों में झांकेंगे, और कुछ व्यावहारिक परीक्षण साझा करेंगे जिन्हें आप स्वयं चला सकते हैं। आप Meta के जैसे हाल ही में प्रकाशित प्रतिस्पर्धी मॉडलों के लिए हमारे गाइड भी देख सकते हैं Muse Spark, OpenAI का GPT-5.5, और Google का Gemini 3.1.
अपडेट: 28 मई, 2026 को Anthropic ने उत्तराधिकारी मॉडल जारी किया। हमारे Claude Opus 4.8 गाइड में इसके बारे में सब पढ़ें।
Claude Opus 4.7, Anthropic का नवीनतम फ्लैगशिप बड़े भाषा मॉडल है, जो Claude परिवार में Sonnet और Haiku के ऊपर बैठता है। यह Claude Opus 4.6 के बाद आता है और सबसे मांगलिक कार्यों के लिए डिज़ाइन किया गया है, जैसे जटिल एजेंटिक वर्कफ़्लो और बहु-चरणीय तर्क जिनमें लंबी सत्रों में लगातार प्रदर्शन चाहिए।
Opus 4.6 की तुलना में, 4.7 रिलीज़ तीन क्षेत्रों पर केंद्रित है:
Anthropic का आंतरिक Mythos Preview, जिसका हमने पहले उल्लेख किया और जिसके बारे में हमारा एक FAQ भी है, कई बेंचमार्क पर आगे है, लेकिन यह व्यापक रूप से उपलब्ध नहीं है। Opus 4.7 मूल रूप से एक सहोदर मॉडल है जिसे जानबूझकर कम साइबरसुरक्षा क्षमताओं के साथ प्रशिक्षित किया गया है।
Anthropic ने बताया कि Opus 4.7 में कई क्षमता क्षेत्रों में उल्लेखनीय सुधार हुए हैं।
Opus 4.7 पूर्ववर्ती मॉडलों की तुलना में निर्देशों का अधिक सख्ती से पालन करता है। यह, स्वाभाविक रूप से, किसी भी ऐसे वर्कफ़्लो के लिए सहायक है जो विश्वसनीयता पर निर्भर करता है, लेकिन इसके अनपेक्षित परिणाम भी हो सकते हैं: Anthropic उपयोगकर्ताओं से अपने प्रॉम्प्ट और हार्नेस फिर से ट्यून करने का आग्रह करता है, क्योंकि जिन निर्देशों को पहले मॉडल छोड़ देते थे या ढीले तौर पर समझते थे, अब उन्हें अक्षरश: लिया जाएगा।
हाई-रिज़ॉल्यूशन के लिए विज़न में सुधार किया गया है ताकि 3.75 मेगापिक्सेल तक की छवियों का समर्थन हो सके, जो पुराने मॉडलों की तुलना में तीन गुने से अधिक है। कंप्यूटर-यूज़ एजेंट और डेटा निष्कर्षण वर्कफ़्लो इस बढ़ी हुई सूक्ष्मता से काफी लाभ उठा सकते हैं, क्योंकि वे पठनीयता और शुद्धता पर निर्भर करते हैं, कभी-कभी पिक्सेल-स्तर तक।
Opus 4.7 फाइल सिस्टम-आधारित मेमोरी में बेहतर है, जिसका अर्थ है वह पैटर्न जिसमें मॉडल काम करते समय नोट्स फाइलों में लिखता है और भविष्य के रन पर उन्हें पढ़ता है।
Claude Code इसके लिए स्पष्ट सेटिंग है: प्रोजेक्ट की रूट में एक CLAUDE.md फाइल जिसे Claude सत्र शुरू होने पर पढ़ता है, निर्णय होते ही अपडेट करता है, और जब आप काम पर लौटते हैं तो इस्तेमाल करता है।
"बेहतर" का मतलब यहां यह है कि क्या लिखने लायक है इस पर बेहतर निर्णय और बाद के टर्न पर अधिक विश्वसनीय रिकॉल। Anthropic का कहना है कि इससे नए कार्यों को "कम प्रारंभिक संदर्भ" चाहिए — जो, यदि आपने कभी किसी मॉडल को अपनी परियोजना परंपराएं पांचवीं बार फिर से समझाई हों, जैसा कि हमने किया है, तो आप उसकी सराहना करेंगे।
तो, वास्तविक निचोड़: यदि आप Opus 4.7 का उपयोग मल्टी-सेशन कार्य के लिए कर रहे हैं, तो उसे नोट्स रखने दें। यह Opus 4.6 की तुलना में यह काम बेहतर करेगा, हालांकि हमें लगा था कि Opus 4.6 भी काफ़ी अच्छे नोट्स रखता था।
Anthropic हमें बताता है कि Claude Opus 4.7 ने इन क्षेत्रों में उल्लेखनीय सुधार किए हैं.
हमने उनके दावों को परखने के लिए अपने कुछ परीक्षण बनाए।
Opus 4.7 के निर्देश पालन का परीक्षण करने के लिए, हमने उसे नीचे दिया गया विस्तृत प्रॉम्प्ट दिया ताकि उसे स्ट्रेस-टेस्ट किया जा सके। इसमें 12 विशिष्ट बाधाएं हैं जिन्हें हम अंत में जांच सकते हैं।
You are writing a short briefing document for a new employee at a mid-sized accounting firm. Follow every instruction below.
Write a briefing about the firm's approach to client onboarding. The briefing must meet all of the following requirements:

The briefing must be exactly 4 paragraphs long.
-The second paragraph must begin with the word "Historically".
-Each paragraph must contain between 3 and 5 sentences. No paragraph may have fewer than 3 or more than 5.
-Do not use the words "streamline", "leverage", "robust", or "synergy" anywhere in the document.
-Include exactly two direct quotes from fictional senior partners. Attribute each quote to a named partner. Do not include any other quoted material.
-One of the partners quoted must have a surname that starts with the letter M.
-End the document with a single-sentence closing line on its own, separated from the fourth paragraph by a blank line. This closing line does not count toward the 4-paragraph requirement.
-The closing line must be a question.
-Use British English spelling throughout (e.g., "organisation", "colour", "realise").
-Do not use any bullet points, numbered lists, or headings.
-Mention a specific fictional client name exactly once, and italicise it using markdown asterisks.
-The total word count of the briefing, including the closing line, must be between 280 and 320 words. Do not include any preamble, explanation, or commentary before or after the briefing. Output only the briefing itself.
और यह रहा परिणाम:
Welcome to Harding & Whitcombe, where client onboarding is treated as the foundation of every successful long-term engagement. Our approach centres on understanding the organisation behind the numbers before any technical work begins, which means the first two weeks are devoted almost entirely to listening. New clients are assigned a dedicated onboarding lead who coordinates introductions across tax, audit, and advisory teams. This structure ensures that every colleague touching the account shares a consistent understanding of the client's priorities and sensitivities.

Historically, the firm operated a more transactional model, with onboarding handled piecemeal by whichever partner had signed the engagement letter. That changed in 2014, when senior leadership recognised that our competitors were winning work on relationships rather than fees alone. As Helena Marchbanks, our managing partner, often reminds new hires, "A client who feels understood in week one rarely questions the invoice in month six." The revised approach has measurably improved retention and referral rates across every service line.

In practical terms, you will be expected to attend the initial discovery meeting for any client you support, even in a purely observational capacity. You should familiarise yourself with the client's sector, recent filings, and any public commentary from their leadership before that first conversation. When we onboarded Thornbury Mills Ltd last spring, the junior associate who had read three years of their annual reports was the one who spotted the inventory anomaly that shaped our entire advisory brief. Preparation of that depth is the standard we expect, not the exception.

You will also notice that we emphasise candour from the outset, particularly around scope and realistic timelines. "We would rather lose a pitch than promise something we cannot deliver," says Rupert Castellane, head of our advisory practice, and that philosophy colours every onboarding conversation. Take the time to ask questions, observe the senior partners in action, and recognise that trust accumulates slowly but pays compounding dividends.

Are you ready to meet your first client?
अब इसे स्कोर करने का समय है। हमारा रूब्रिक साझा कर रहा/रही हूँ:
|
# |
बाधा |
कैसे जांचें |
|
1 |
सटीक 4 अनुच्छेद (प्लस समापन पंक्ति) |
अनुच्छेद ब्रेक गिनें |
|
2 |
अनुच्छेद 2 "Historically" से शुरू होता है |
पहला शब्द देखें |
|
3 |
हर अनुच्छेद में 3–5 वाक्य |
प्रति अनुच्छेद वाक्य गिनें |
|
4 |
कोई प्रतिबंधित शब्द नहीं |
प्रत्येक के लिए Ctrl+F |
|
5 |
सटीक 2 उद्धरण, दोनों अभिगणित, अन्य कोई उद्धृत सामग्री नहीं |
उद्धरण चिह्न गिनें |
|
6 |
एक पार्टनर का उपनाम M से शुरू |
अभिगणन जांचें |
|
7 |
समापन पंक्ति खाली लाइन से अलग |
दृश्य जांच |
|
8 |
समापन पंक्ति एक प्रश्न है |
"?" पर समाप्त |
|
9 |
ब्रिटिश वर्तनी |
"organization", "color", "realize" आदि के लिए Ctrl+F |
|
10 |
कोई बुलेट, नंबर, हेडिंग नहीं |
दृश्य जांच |
|
11 |
कल्पित क्लाइंट का नाम एक बार, इटैलिक |
आस्टरिस्क के लिए Ctrl+F |
|
12 |
शब्द गणना 280–320 |
वर्ड काउंटर में पेस्ट करें |
हम आपको यह मेहनत करने से बचाते हैं। मॉडल ने 11/12 स्कोर किया।
यह अंत तक पूरी तरह सही कर रहा था, लेकिन अंत में, यह शब्द गणना से थोड़ा सा ऊपर चला गया (325 शब्द, जबकि सीमा 320 शब्द थी)।
हमने वही परीक्षण Claude Sonnet 4.6 पर भी लगाया, और उसने भी 11/12 निर्देश सही किए, और वही जगह (शब्द गणना) पर असफल हुआ। लेकिन हम फिर भी Opus 4.7 को सुधार मानते हैं क्योंकि Sonnet 4.6 सीमा से बहुत, बहुत अधिक (400 शब्द) ऊपर चला गया।
अपने दूसरे परीक्षण के लिए, हमने Opus 4.7 को एक पढ़ने में कठिन छवि दी:
You are analysing a degraded image that may be blurry, low-resolution,
or otherwise difficult to read. Your job is to extract as much accurate
information as possible.

Complete all of the following tasks. Do not include any preamble,
explanation, or commentary. Output only the requested deliverable.

1. Describe what type of document or visualisation this appears to be
   (e.g. bar chart, dashboard, table, report page). State your confidence
   as High, Medium, or Low.

2. List every number you can make out, however partial. For each one,
   state what you believe it refers to and your confidence (High, Medium,
   or Low). If a number is ambiguous between two readings (e.g. could be
   138 or 188), state both possibilities.

3. List every piece of text you can make out — titles, labels, legends,
   footnotes — quoted as precisely as possible. Where a word or character
   is unclear, use [?] to mark the uncertain character, e.g. "Re[?]enue".

4. Describe the layout: how many distinct sections or panels are visible,
   and what does each appear to contain?

5. State what you believe the overall subject or story of the image is,
   in one sentence of no more than 25 words. Flag if your confidence is
   Low.

6. List anything you attempted to read but could not make out at all.
इन निर्देशों के साथ, हमने Opus 4.7 को Playfair के 1786 के स्कॉटलैंड व्यापार चार्ट का एक क्षीण स्क्रीनशॉट दिया, जिसे हमने अपने डेटा विज़ुअलाइज़ेशन उदाहरण लेख से लिया था।
हमें पता था कि हम आउटपुट का सत्यापन कर सकते हैं क्योंकि हमारे पास विकिपीडिया से उच्च-रिज़ॉल्यूशन संस्करण था। यह वह छवि है जो Opus 4.7 ने देखी:
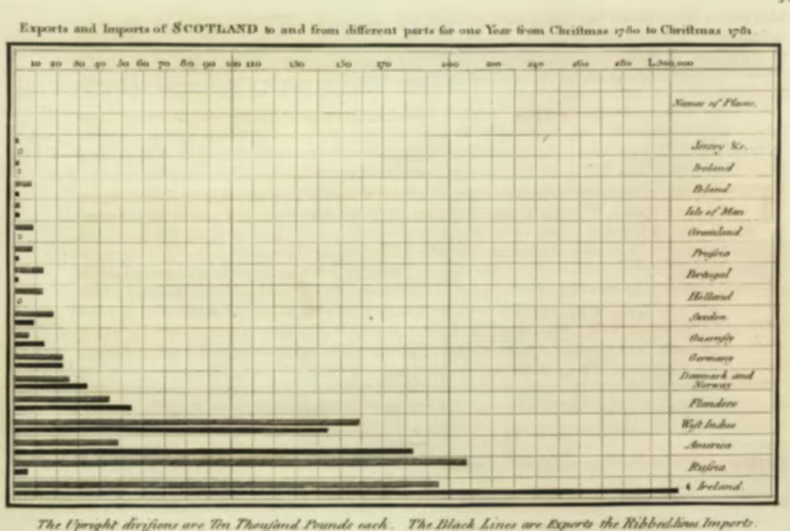
यह रहा Opus 4.7 का पठन:
Type: Horizontal bar chart, antique engraving. Confidence: High.

Numbers: X-axis ticks: 10, 20, 30…110, 130, 150, 170, 200, 220, 240, 260, 280, L.300,000 (High, but 130/220 uncertain).

Years "1780" and "1781" in title (High). "Ten Thousand Pounds" per division (High).

Title: "Exports and Imports of SCOTLAND to and from different parts for one Year from Christmas 1780 to Christmas 1781"

Header: "Names of Places"

Places: Jersey &c., Ireland, [?]oland, Isle of Man, Gr[oe]nland, Prussia, Portugal, Holland, Sweden, Guernsey, Germany, Denmark and Norway, Flanders, West Indies, America, Russia, Ireland (duplicate?)

Footnote: "The Upright divisions are Ten Thousand Pounds each. The Black Lines are Exports the Ribbed lines Imports."

Layout: Single panel — title, plot area with ~16 paired bars, right-hand place-name column, footnote below.

Subject: A 1780–81 trade chart showing Scotland's exports and imports by partner. Confidence: High.

Couldn't read: Top-right corner mark; exact bar values; first letter of "[?]oland"; whether bottom "Ireland" is a duplicate.
हमें पता था कि यह परीक्षण पेचीदा हो सकता है, क्योंकि Playfair के चार्ट का x-अक्ष वाकई बीच में गिनती बदलता है (110 तक हर 10, फिर विषम दहाइयां 130/150/170, फिर सम दहाइयां 200/220/240/260/280)। लेकिन Opus 4.7 ने पहली ही कोशिश में उस अक्ष को सही पढ़ लिया, जबकि वह अजीब था।
एक बात जो हमें अब भी मज़ेदार लगी: हमें पता है कि हमें अच्छा लगता है जब AI मॉडल अपनी अनिश्चितता दिखाते हैं, लेकिन “[?]oland” को आत्मविश्वास से “Poland” और "Gr[oe]nland" को “Greenland” पढ़ा जाना चाहिए था। हालांकि हमारे पास इसके लिए आधिकारिक रूब्रिक नहीं था, हम इसे निष्पक्ष रूप से 9/10 दे सकते हैं।
Opus 4.7 का मूल्यांकन 14 बेंचमार्क पर किया गया जो कोडिंग, तर्क, टूल उपयोग, कंप्यूटर उपयोग, और दृश्य तर्क को कवर करते हैं। नीचे दी गई तालिका Opus 4.6, GPT 5.4, Gemini 3.1 Pro, और अभी तक प्रकाशित न हुए Mythos Preview के साथ पूरी तुलना दिखाती है।
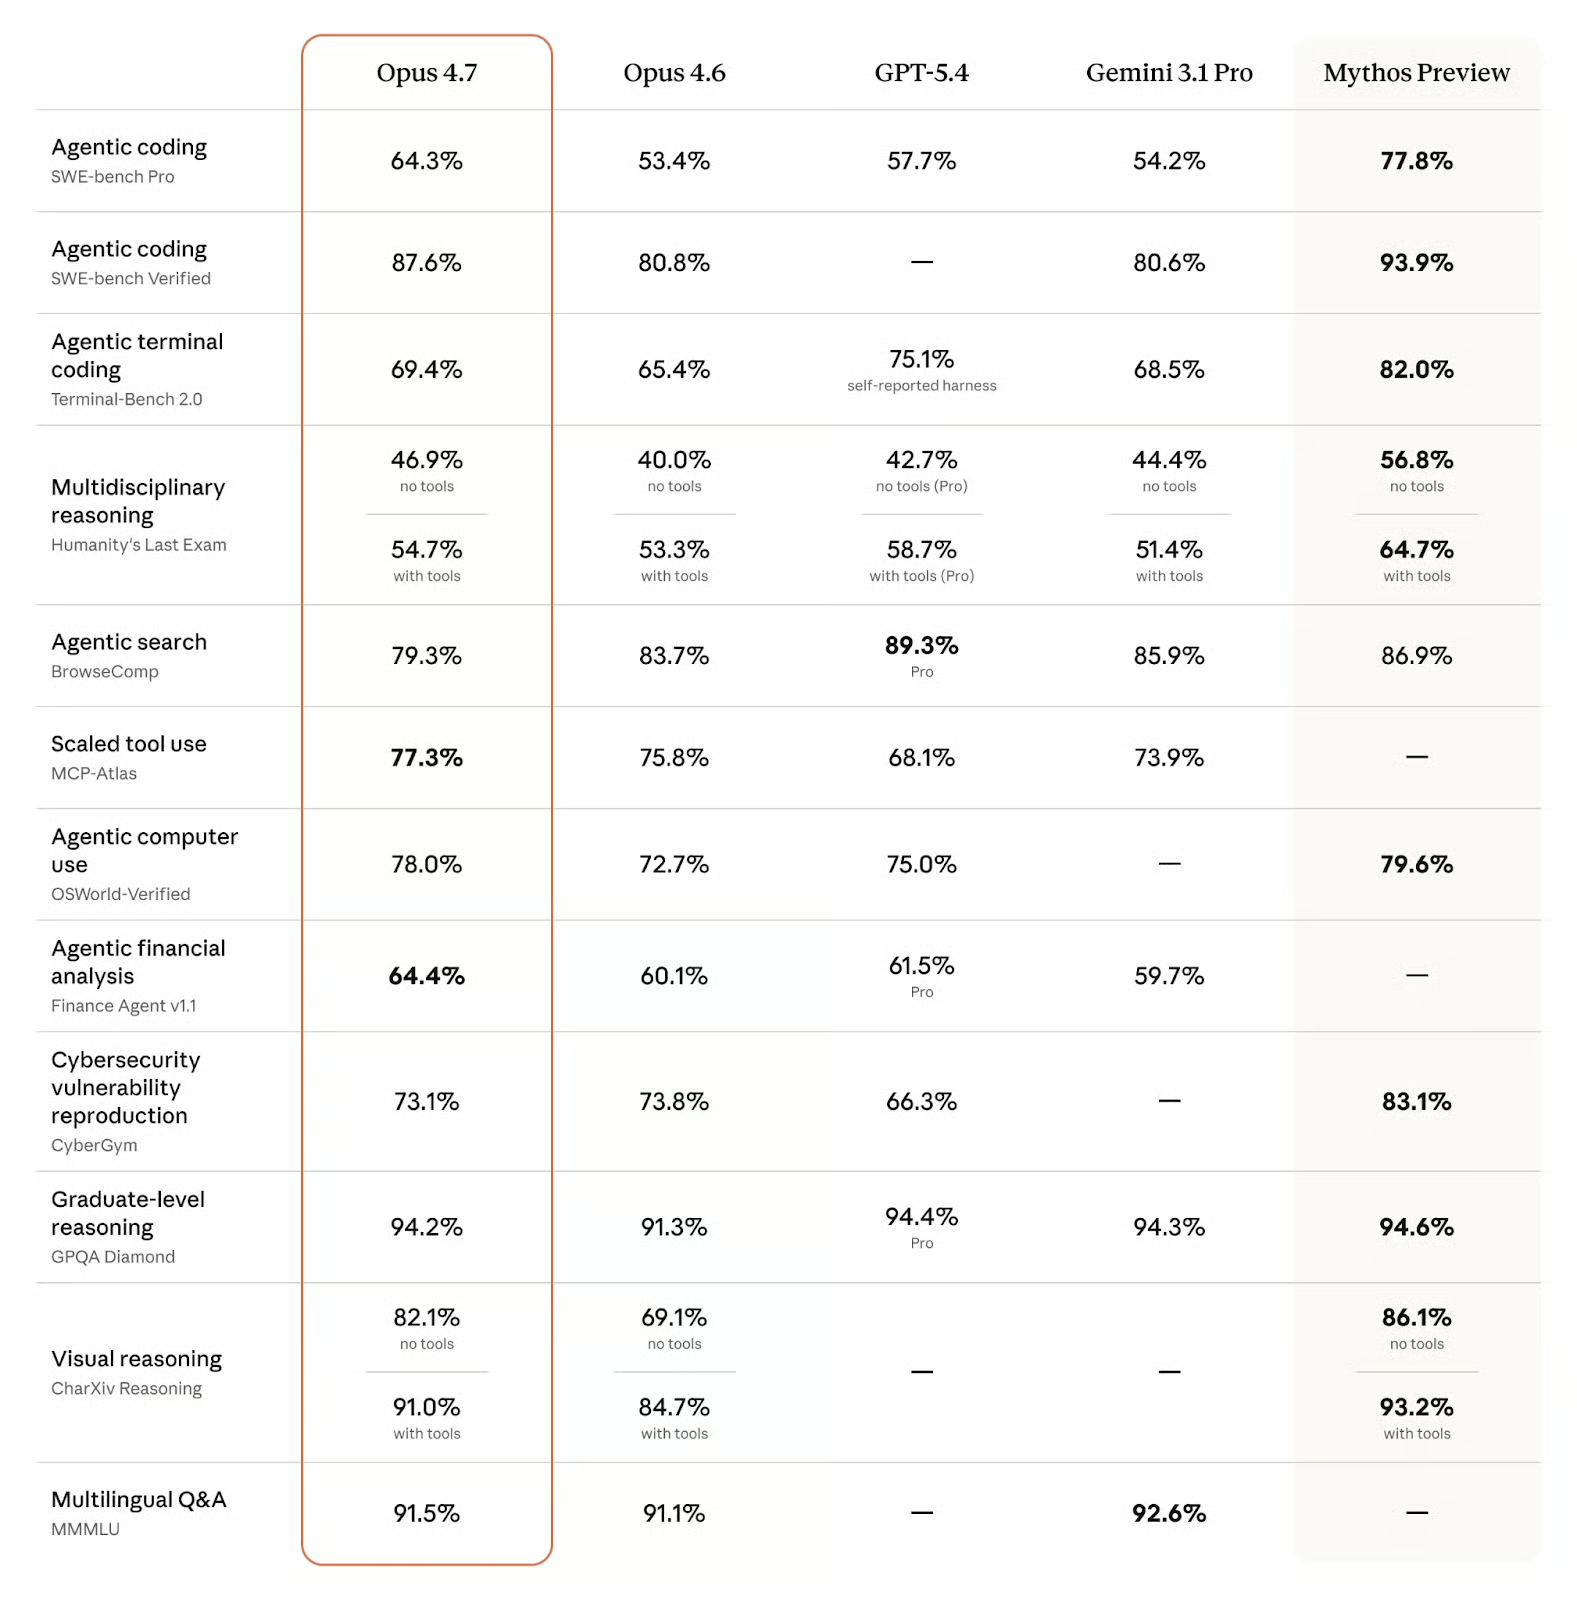
SWE-bench Pro पर, Opus 4.7 का स्कोर 64.3% है, जो GPT-5.4 के 57.7%, Gemini 3.1 Pro के 54.2%, और Opus 4.6 के 53.4% से आगे है। SWE-bench Verified पर, Opus 4.7 87.6% तक पहुंचता है जबकि Gemini 3.1 Pro 80.6% और Opus 4.6 80.8% पर हैं। इस तुलना में GPT-5.4 का SWE-bench Verified पर कोई प्रकाशित स्कोर नहीं है।
SWE-bench किसी मॉडल की क्षमता को ओपन-सोर्स Python रिपोजिटरी में वास्तविक GitHub मुद्दों को हल करने पर परखता है। Pro अधिक कठिन संस्करण है जिसमें अधिक जटिल मुद्दे होते हैं। SWE-bench Pro पर Opus 4.6 की तुलना में 10.9-पॉइंट की बढ़त इस रिलीज़ का सबसे बड़ा सुधार है (प्रतिशत अंक के हिसाब से) और Opus 4.7 को इस कार्य पर दोनों प्रमुख प्रतियोगियों से स्पष्ट रूप से आगे रखता है।
केवल Anthropic का आंतरिक Mythos Preview SWE-bench Pro पर 77.8% और SWE-bench Verified पर 93.9% स्कोर करता है, जो दर्शाता है कि Opus 4.7 के ऊपर अब भी हेडरूम है। फिर भी, Mythos व्यापक रूप से उपलब्ध नहीं है, इसलिए प्रोडक्शन उपयोग के लिए, Opus 4.7 वर्तमान छत है।
Terminal-Bench 2.0 के संदर्भ में परिणाम, जो टर्मिनल में एजेंटिक कोडिंग के लिए गो-टू बेंचमार्क है, काफ़ी रोचक हैं। Opus 4.7 अपने पूर्ववर्ती (69.4% बनाम 65.4%) की तुलना में थोड़ा सुधार करता है और Gemini 3.1 Pro को पार करता है, जिसका स्कोर 68.5% है।
इसके बावजूद, यह इस मामले में GPT-5.4 (75.1%) से मुकाबला नहीं कर सकता, हालांकि GPT-5.4 के स्कोर पर स्वयं-रिपोर्टेड कैविएट की तुलना करते समय याद रखना चाहिए। फिर भी, Anthropic के लिए यह निराशाजनक हो सकता है कि इसका नवीनतम (रिलीज़ हुआ) फ्लैगशिप मॉडल उस बेंचमार्क में शीर्ष पर नहीं है जो एजेंटिक सॉफ्टवेयर विकास के लिए केंद्रीय है।
Humanity's Last Exam विज्ञान, गणित और मानविकी के स्नातकोत्तर-स्तर के प्रश्नों का संग्रह है, जिसे वर्तमान फ्रंटियर मॉडलों के लिए कठिन बनने के लिए डिज़ाइन किया गया है। Opus 4.7 नो-टूल्स संस्करण में अग्रणी है, जो बाहरी रीट्रीवल के बिना कच्चे तर्क का परीक्षण करता है। टूल्स-के-साथ संस्करण में GPT-5.4 (58.7%) के पक्ष में अंतर वह क्षेत्र है जहां Opus 4.7 (54.7%) अग्रणी नहीं है।
स्नातकोत्तर-स्तर के तर्क को आमतौर पर GPQA-Diamond में मापा जाता है, जो आजकल काफ़ी सैचुरेटेड है: वर्तमान फ्रंटियर मॉडलों की तरह, सभी चार तुलना किए गए मॉडल 90% से ऊपर का स्कोर प्राप्त करते हैं और मूलतः बराबरी पर हैं।
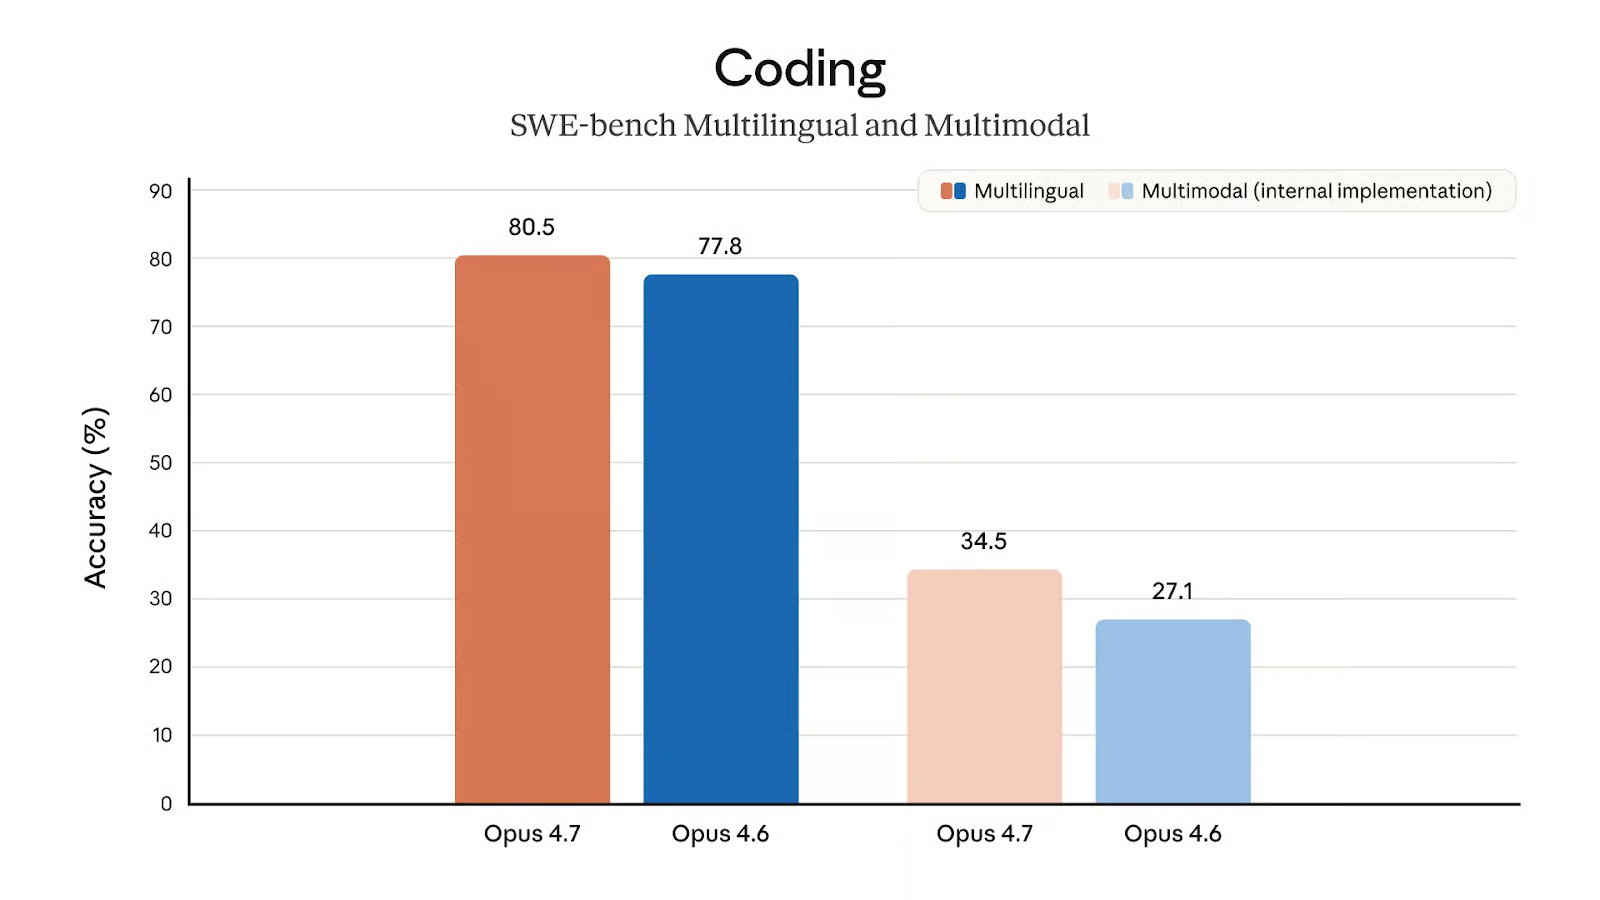
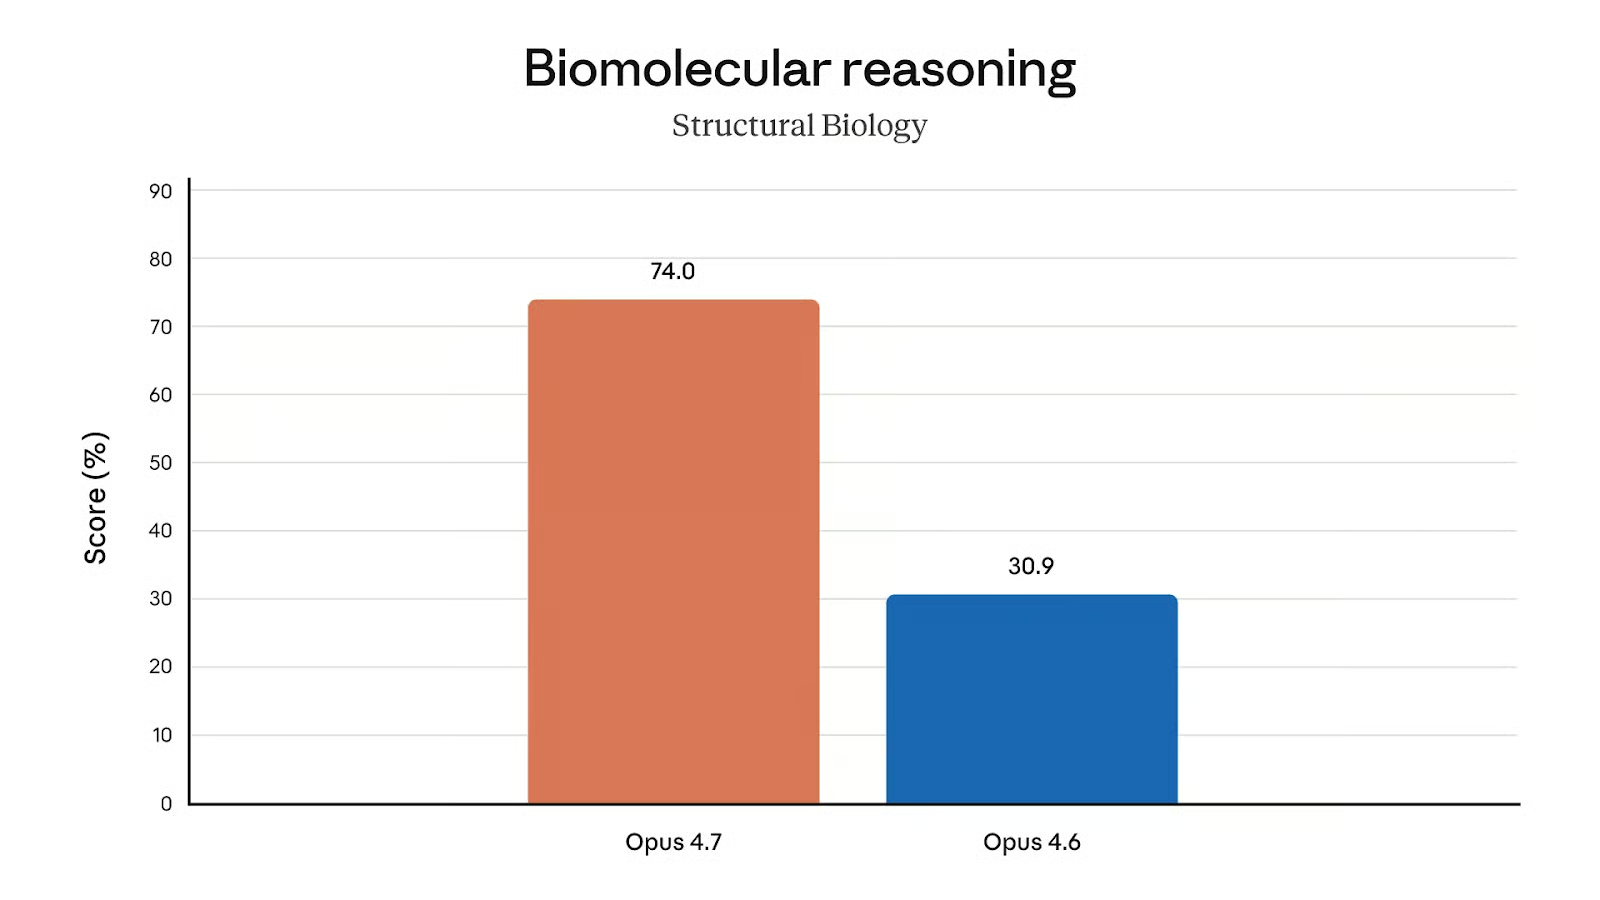
एक और रोचक बेंचमार्क परिणाम जीवविज्ञान को लक्षित करता है, जो GPQA-Diamond में भी परीक्षण किए गए क्षेत्रों में से एक है। जबकि हम इसे प्रतिस्पर्धी मॉडलों से तुलना नहीं कर सकते, Opus 4.6 (30.9%) और Opus 4.7 (74.0%) के बीच की छलांग निश्चित रूप से उल्लेखनीय है!
CharXiv बेंचमार्क में परिणाम, जो वैज्ञानिक चार्ट और फिगर पर दृश्य तर्क को मापता है, इस बात का प्रतिबिंब हैं कि यह Opus 4.7 के विकास में प्रमुख फोकस क्षेत्रों में से एक था।
13-पॉइंट नो-टूल्स सुधार इस रिलीज़ का सबसे बड़ा सापेक्षिक लाभ है। प्रतिस्पर्धी स्कोर न होने के कारण व्यापक परिदृश्य में Opus 4.7 की स्थिति बताना कठिन है, लेकिन Opus 4.6 पर सुधार ठोस है।
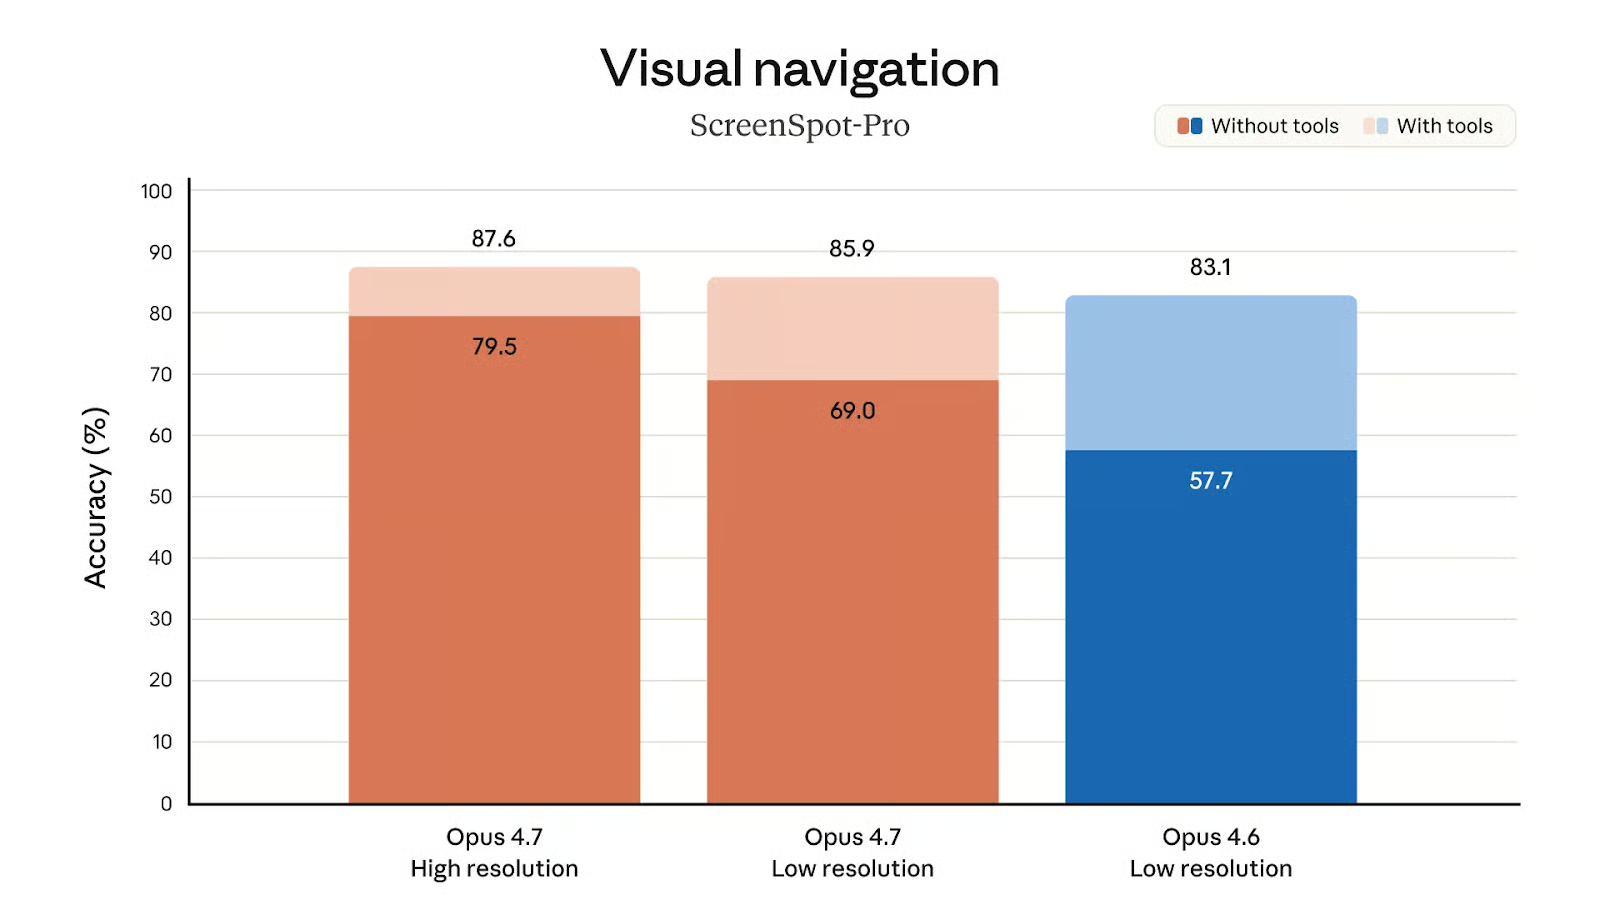
उच्च-रिज़ॉल्यूशन छवियों के समर्थन में वृद्धि संभवतः बेहतर दृश्य तर्क के कारणों में से एक है। विभिन्न रिज़ॉल्यूशन पर Screenspot-Pro स्कोर का चार्ट दर्शाता है कि उच्च रिज़ॉल्यूशन से Opus 4.7 को कितना बड़ा सटीकता बढ़ावा मिलता है, विशेषकर बिना टूल उपयोग के (79.5% बनाम 69.0%)।
MCP-Atlas जटिल, मल्टी-टूल वर्कफ़्लो में प्रदर्शन परखता है। यहां Opus 4.7 का स्कोर 77.3% है, जो तुलना में किसी भी मॉडल का सबसे अधिक है। Opus 4.7 के MCP-Atlas स्कोर से थोड़ा ऊपर केवल Muse Spark है, जिसका स्कोर 78.3% रिपोर्ट किया गया है।
OSWorld किसी मॉडल की यह क्षमता परखता है कि वह कंप्यूटर इंटरफेस को नियंत्रित करके, क्लिक करके, टाइप करके और एप्लिकेशन नेविगेट करके कार्य पूरे कर सके। Opus 4.7 का स्कोर 78.0% है, जो Opus 4.6 के 72.7% से ऊपर है। GPT-5.4 का स्कोर 75.0% है, और Gemini 3.1 Pro का इस बेंचमार्क पर कोई प्रकाशित स्कोर नहीं है। Mythos Preview का स्कोर 79.6% है, जो Opus 4.7 से थोड़ा ऊपर है।
यह निश्चित रूप से वह क्षेत्र है जहां Opus 4.7 उत्कृष्टता दिखाता है: यह MCP-Atlas और OSWorld-Verified दोनों में Google और OpenAI के प्रतिस्पर्धी फ्लैगशिप पर अर्थपूर्ण अंतर से आगे है, जो किसी भी ऐसे व्यक्ति के लिए मजबूत परिणाम है जो टूल ऑर्केस्ट्रेशन और कंप्यूटर-यूज़ एजेंट पर निर्भर प्रोडक्शन एजेंट सिस्टम बना रहा है।
मॉडल की वित्तीय विश्लेषण क्षमताओं को विशेष उल्लेख मिलना चाहिए: Opus 4.7 Finance Agent v1.1 लीडरबोर्ड (64.4%) में शीर्ष पर है, जो GPT-5.4 (61.5%) और Gemini 3.1 Pro (59.7%) दोनों से काफी आगे है।
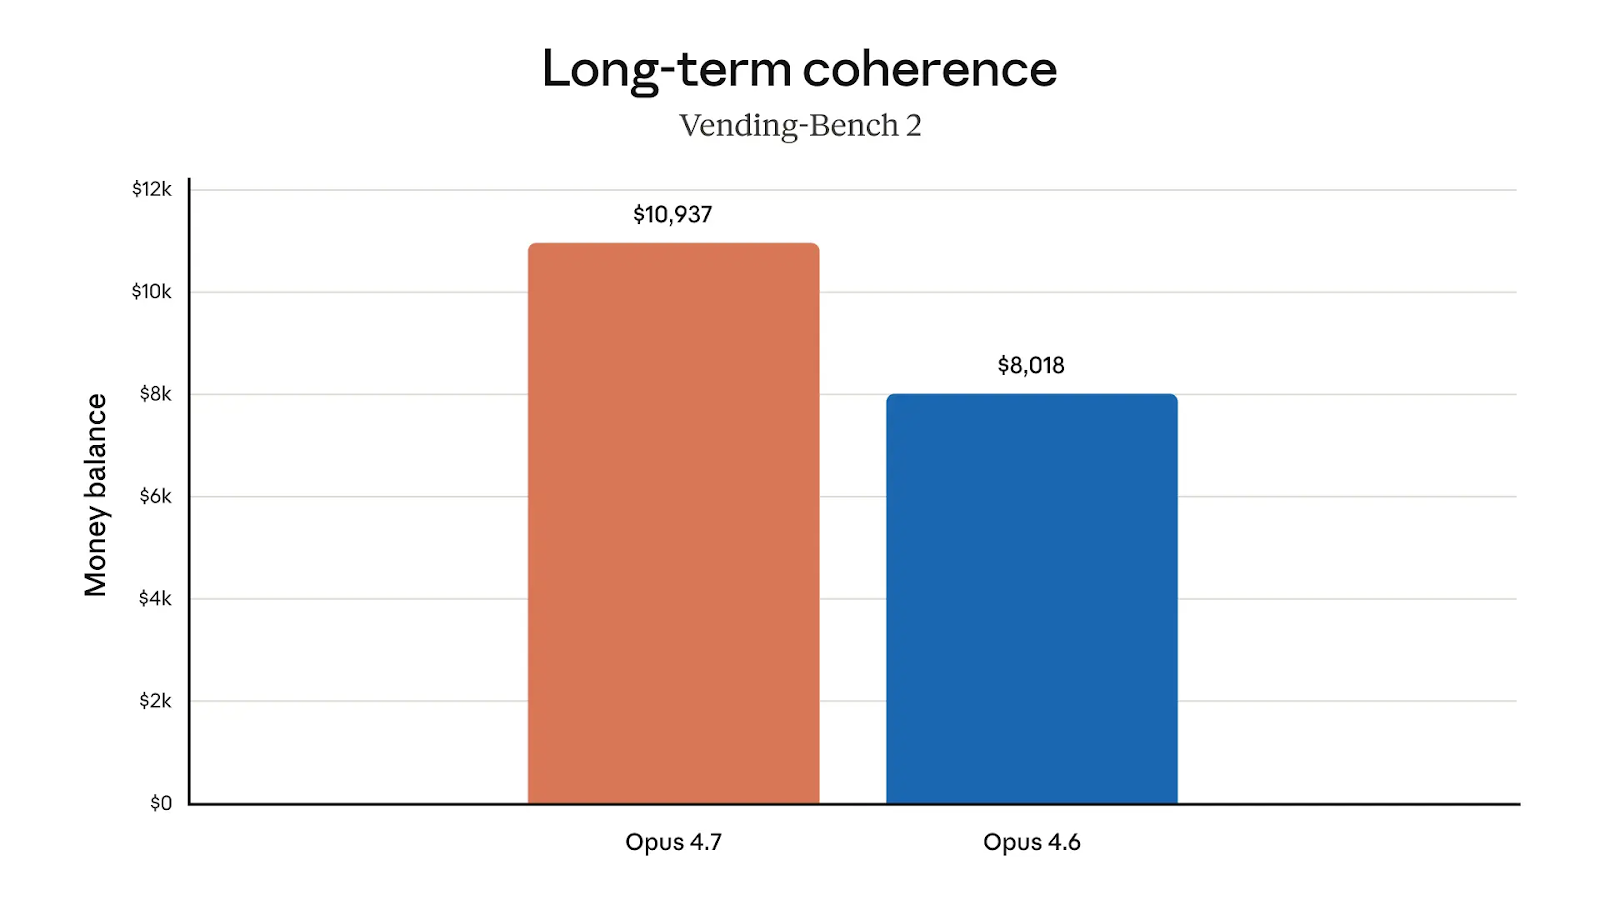
अधिक व्यावहारिक Vending-Bench 2 में, हम देखते हैं कि Opus 4.7 पैसों के साथ भी बेहतर है। औसतन, मॉडल $10,937 पर पहुंचा, जबकि Opus 4.6 के साथ $8,018 था।
Anthropic हमें इंतज़ार नहीं करा रहा। Opus 4.7 अब उपलब्ध है
सभी Claude उत्पादों में
Claude API (claude-opus-4-7)
Vertex AI, और
Microsoft Foundry
एक चिंता — खासकर अब — महंगाई को लेकर रहती है। लेकिन शुक्र है, कीमत Opus 4.6 जैसी ही है। यानी प्रति मिलियन इनपुट टोकन $5 और प्रति मिलियन आउटपुट टोकन $25। (Opus 4.6 और Opus 4.7 के बीच भी कोई कीमत वृद्धि नहीं हुई थी।)
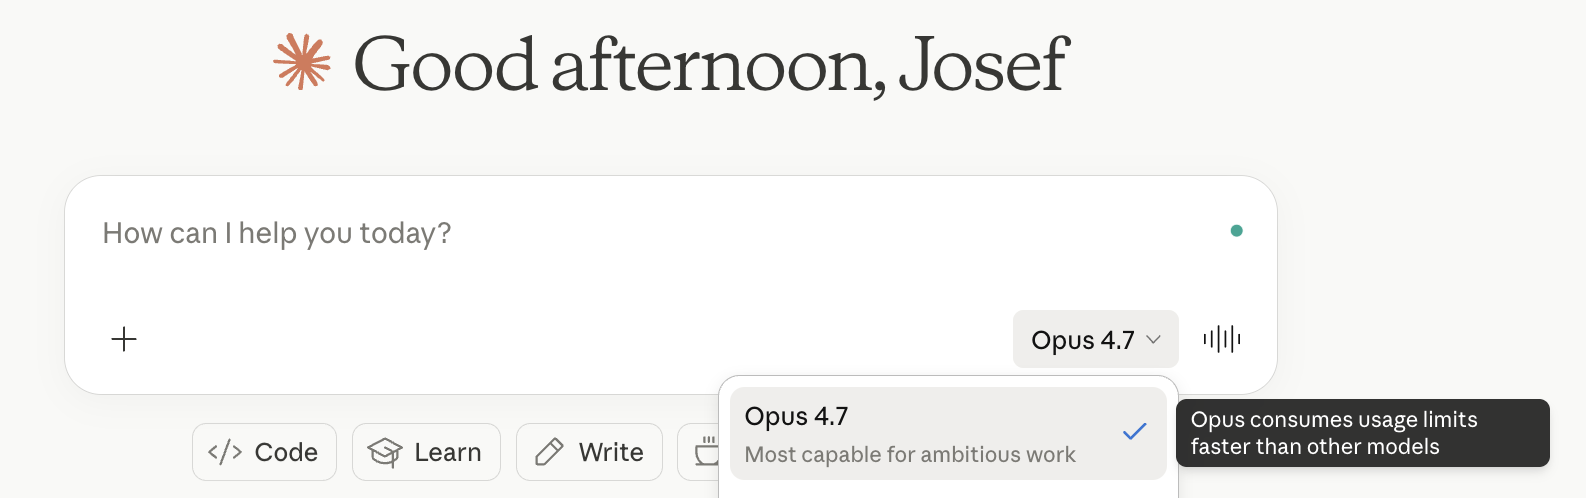
सामान्य याद दिलाने के तौर पर, यदि आप Claude.ai में Opus का उपयोग कर रहे हैं: आपका हर संदेश अब तक की पूरी बातचीत शामिल करता है (आपका नया प्रश्न + पहले का सारा आगे-पीछे) साथ ही मॉडल का उत्तर। यह सब टोकन में मापा जाता है। आपकी योजना, चाहे जो भी हो, का एक टोकन बजट होता है जो रोलिंग विंडो पर फिर से भरता रहता है।
अलग-अलग मॉडल उस बजट के खिलाफ अलग दरें लेते हैं। Opus सबसे महंगा है क्योंकि यह सबसे शक्तिशाली है। एक मोटा प्रकाशित अनुपात: प्रति टोकन लागत में Opus, Sonnet से लगभग 5× है।
Anthropic ने मॉडल के साथ-साथ कई अपडेट भी शिप किए जो जानने लायक हैं, कम से कम अगर आप Claude Code का उपयोग करते हैं या API पर बिल्ड करते हैं।
एक नया xhigh ("एक्स्ट्रा हाई") प्रयास स्तर अब high और max के बीच बैठता है। यह आपको तर्क की गहराई और विलंबता के बीच चुनते समय एक और विकल्प देता है। Claude Code में, डिफ़ॉल्ट प्रयास स्तर सभी योजनाओं में xhigh कर दिया गया है, और Anthropic कोडिंग और एजेंटिक कार्यों पर Opus 4.7 का परीक्षण करते समय high या xhigh से शुरुआत करने की सिफारिश करता है।
Claude Code में नया /ultrareview स्लैश कमांड आया है, जो आपके परिवर्तनों पर समर्पित समीक्षा पास चलाता है और उन बग या डिज़ाइन मुद्दों को चिह्नित करता है जिन्हें एक सतर्क मानव समीक्षक पकड़ता। Pro और Max उपयोगकर्ताओं को इसे आज़माने के लिए तीन मुफ्त अल्ट्रारिव्यू मिलते हैं।
अब Max उपयोगकर्ताओं को ऑटो मोड तक पहुंच मिलती है, एक अनुमति सेटिंग जहां Claude आपकी ओर से निर्णय लेता है। यह हर कदम को स्वीकृत करने और अनुमतियों को पूरी तरह छोड़ देने के बीच का मध्यम रास्ता है।
Claude API पर टास्क बजट अब पब्लिक बीटा में हैं। ये डेवलपर्स को किसी रन में Claude के टोकन खर्च को कैप करने देते हैं, जो खास तौर पर लंबे एजेंट वर्कफ़्लो के लिए उपयोगी है जहां आप चाहते हैं कि मॉडल अपना बजट फूंकने के बजाय खुद को गति दे।
हमने बेंचमार्क परिणामों को बारीकी से देखा, और उन परिणामों में अन्य मॉडलों के साथ तुलना शामिल थी। उच्च स्तर पर, आइए Opus 4.7 की GPT-5.4 से सीधे तुलना करें।
मूल निष्कर्ष यह है कि Opus 4.7 लंबी-अवधि की स्वायत्तता के लिए अनुकूलित है। GPT-5.4 एक एकीकृत सामान्य-उद्देश्य मॉडल है जिसमें व्यापक टूल समर्थन और सस्ते शॉर्ट-कॉन्टेक्स्ट प्राइसिंग है।
| Claude Opus 4.7 | GPT-5.4 | |
|---|---|---|
| सर्वश्रेष्ठ किसमें | लंबे कोडिंग रन, डेस्कटॉप कंप्यूटर उपयोग, घना विज़न |
ब्राउज़र रिसर्च, शॉर्ट-कॉन्टेक्स्ट कार्य, मिड-रिस्पॉन्स स्टीयरिंग |
| SWE-bench Pro | 64.3% | 57.7% |
| BrowseComp | 79.3% | 89.3% |
| प्राइसिंग | 1M कॉन्टेक्स्ट पर फ्लैट रेट | 272K से नीचे सस्ता, ऊपर जाने पर पूरा सत्र री-प्राइस |
| कॉन्टेक्स्ट विंडो | ~1M टोकन | ~1M टोकन |
OpenAI के उत्तराधिकारी मॉडल GPT-5.5 से पूरी तुलना के लिए हमारा ब्लॉग पोस्ट देखें: Claude Opus 4.7 बनाम GPT-5.5।
कुछ उपयोगकर्ता रिपोर्ट कर रहे हैं कि उनके पाइपलाइन गड़बड़ा रहे हैं क्योंकि Opus 4.7 पहले से अधिक अक्षरशः निर्देशों का पालन कर रहा है। Anthropic ने प्रॉम्प्ट्स को फिर से ट्यून करने की आवश्यकता के बारे में चेतावनी दी थी।
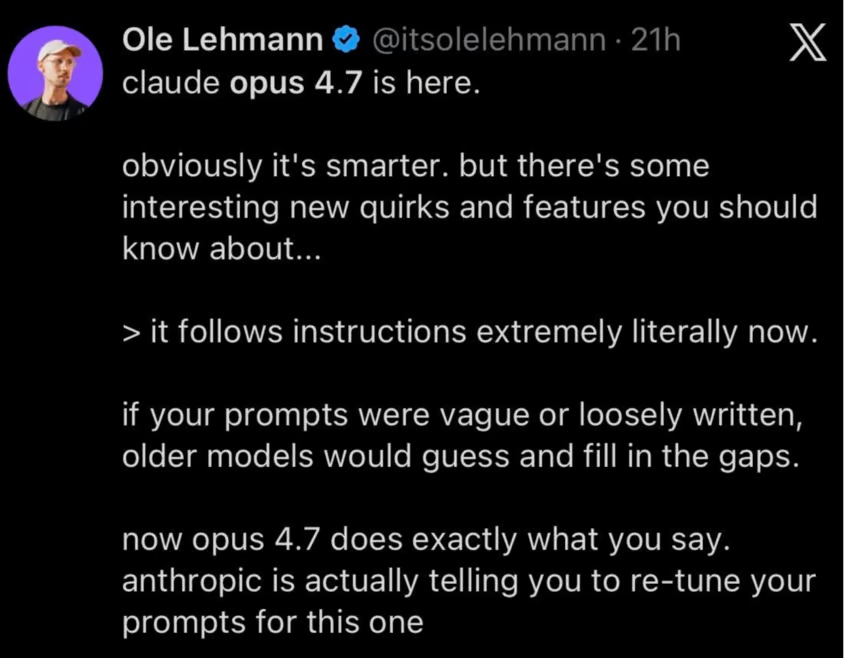
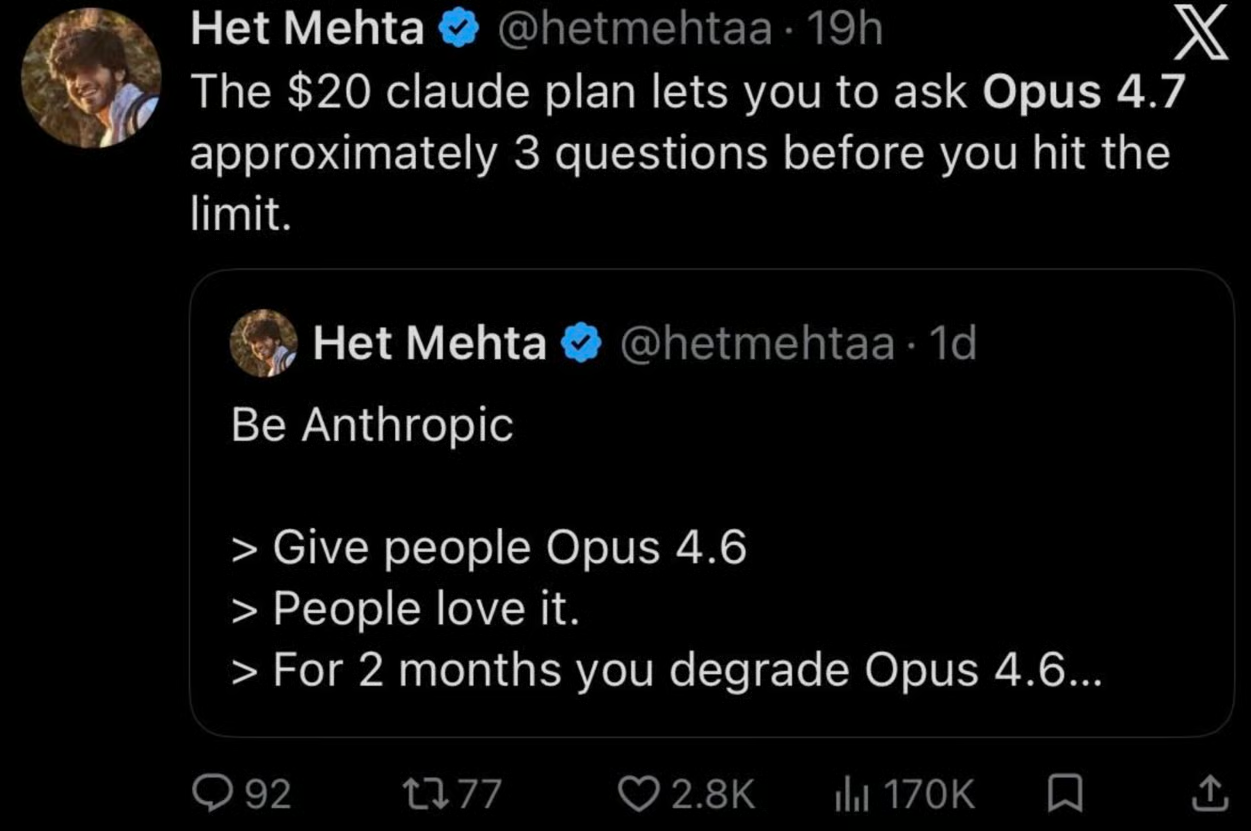
अन्य उपयोगकर्ता टोकन उपयोग को लेकर चिंतित थे। रिलीज़ के हिस्से के रूप में, Anthropic ने सभी उपयोगकर्ताओं के लिए रेट लिमिट बढ़ा दीं ताकि अधिक टोकन उपयोग का हिसाब रखा जा सके, लेकिन यह पूरी तरह स्पष्ट नहीं है कि यह वास्तविक ऑफ़सेट है या नहीं।
Claude Opus 4.7 वह सबसे सक्षम मॉडल है जिसे अधिकतर लोग अभी वास्तव में उपयोग कर सकते हैं। सभी सुधार एक ही दिशा में इशारा करते हैं: लंबे समय तक चलने वाला, कम पर्यवेक्षित एजेंट कार्य, जिसे मजबूत कोडिंग, पैनी विज़न, और बेहतर क्रॉस-सेशन मेमोरी समर्थित करती है।
जो इस रिलीज़ को दिलचस्प बनाता है वह है Mythos फ्रेमिंग। Opus 4.7 एक साइबर-सीमित टेस्ट वाहन है जो व्यापक Mythos-क्लास रिलीज़ की ओर जा रहा है, जिसका मतलब है कि अब इसके ऊपर एक स्पष्ट छत है जिसे आप एक्सेस नहीं कर सकते — लेकिन यह भी कि 4.7 के साथ शिप हो रही सेफगार्ड्स इस बात की झलक देती हैं कि Anthropic आगे चलकर फ्रंटियर रिलीज़ को कैसे संभालने की योजना बना रहा है।
DataCamp के साथ सीखें
{count, plural, one {लर्निंग पाथ} other {लर्निंग पाथ}}
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}