
कोर्स
काम के लिए AI परिचय
2 घंटा
127.2K
OpenAI ने GPT-6 Astra लॉन्च किया है, जिसे वह दुनिया का सबसे बुद्धिमान और अलायन्ड मॉडल कहता है।
Astra एक भीड़ भरे फ्रंटियर टियर में आता है जहाँ Anthropic के Claude Fable 5.1 (1 सितंबर, 2026 को जारी) और Claude Opus 5 को कोडिंग और एजेंटिक काम के संदर्भ बिंदु माना जाता है।
हेडलाइन दावे काफ़ी आक्रामक हैं।
Astra FrontierMath Tier 4 पर 97.6% स्कोर के साथ सैचुरेट करता है, OpenAI के प्रोवाइडर एडाप्टर हार्नेस के तहत ARC-AGI-3 पर 99.9% स्कोर सैचुरेट करता है, और ExploitBench पर 100% हिट करता है। यह कंप्यूटर और ब्राउज़र उपयोग पर भी नया फ्रंटियर स्थापित करता है, OSWorld 2.0 पर 72.6% स्कोर करते हुए, अपने पूर्ववर्ती GPT-5.6 Sol से प्रति टास्क लगभग 47% कम समय लेता है।
ARC-AGI-3 और FrontierMath Tier 4 दोनों को विशेष रूप से AI क्षमता से आगे बने रहने के लिए डिज़ाइन किया गया था, इसलिए उनका सैचुरेशन किसी मानक लीडरबोर्ड को मात देने से गुणात्मक रूप से अलग संकेत देता है।
इस लेख में, मैं GPT-6 Astra में जो कुछ भी नया है, उसे कवर करूंगा—नई सुविधाएँ, बेंचमार्क्स, और कुछ उपयोग-केस उदाहरण।
यदि आप मॉडल को कार्रवाई में देखना चाहते हैं, तो हमारे GPT-6 Astra API ट्यूटोरियल के साथ फॉलो करें और कुछ GPT-6 Astra प्रोजेक्ट्स देखें जिन्हें आप आज़मा सकते हैं। यह देखने के लिए कि यह प्रतिस्पर्धा के मुकाबले कैसा है, हमारा GPT-6 Astra बनाम Claude Fable 5.1 तुलना लेख पढ़ें। मैं हमारे Claude सीखने के मार्गदर्शक, नए Jev System One मॉडल की कवरेज, और Jev बनाम GPT-6 Astra की तुलना भी सुझाता हूँ।
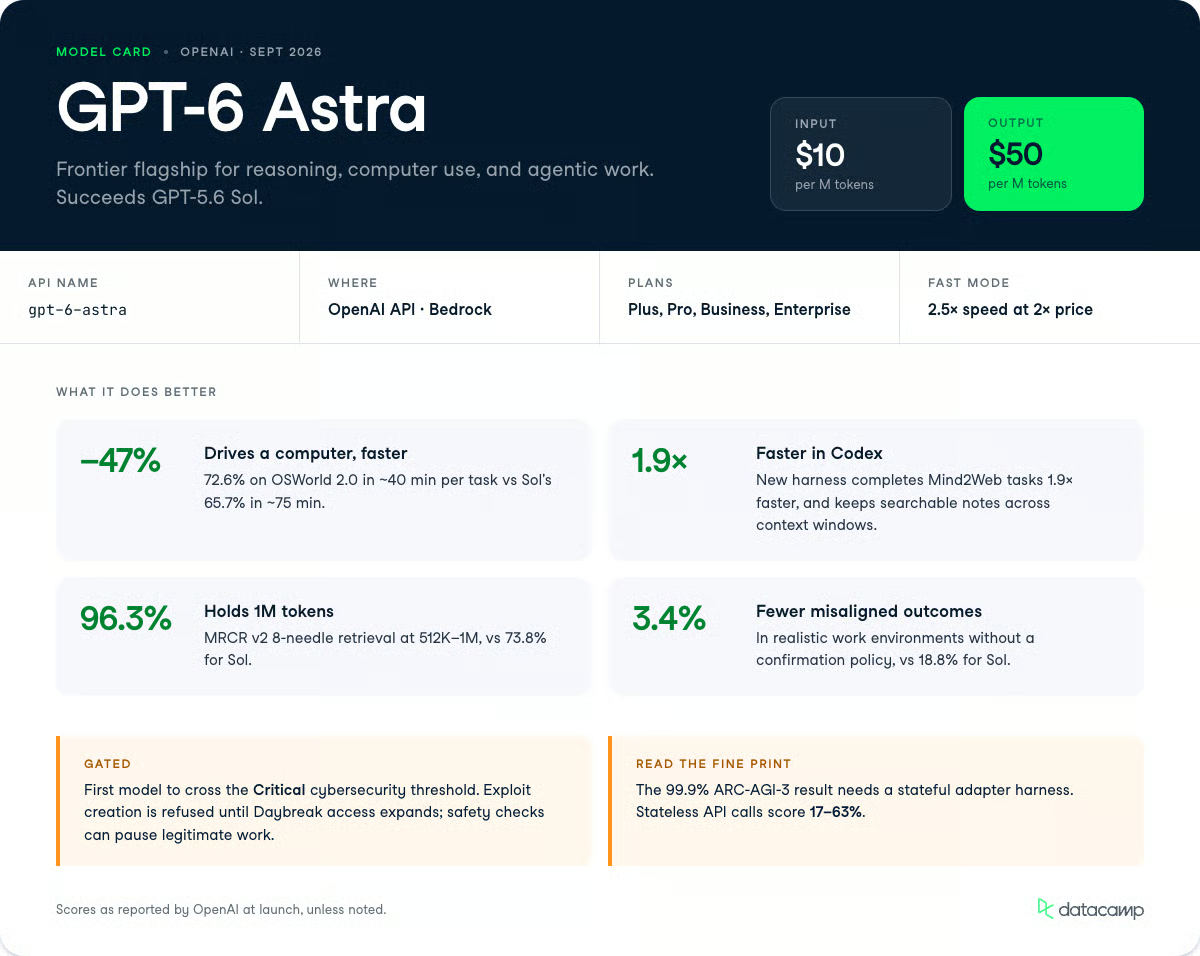
GPT-6 Astra OpenAI का नया फ्रंटियर फ्लैगशिप है, जो GPT-5.6 Sol का उत्तराधिकारी है और तर्क, कंप्यूटर उपयोग, तथा एजेंटिक कार्यों के लिए शीर्ष मॉडल है।
OpenAI इसे तीन क्षेत्रों के आसपास पोज़िशन करता है:
व्यावहारिक उपयोगकर्ताओं के लिए सबसे उपयोगी बेंचमार्क हेडलाइन OSWorld 2.0 है, जहाँ Astra प्रति टास्क लगभग 40 मिनट में 72.6% स्कोर करता है, जबकि GPT-5.6 Sol लगभग 75 मिनट में 65.7% पर था।
उच्च सटीकता और कम वॉल-क्लॉक समय का यह संयोजन उस फ़र्क़ जैसा है जो एक ऐसे एजेंट में होता है जिसे आपको लगातार संभालना पड़े बनाम वह जिसे आप काम सौंपकर छोड़ सकें।
Astra एक अपडेटेड Codex हार्नेस के साथ आता है, जिसके बारे में OpenAI का कहना है कि यह Mind2Web बेंचमार्क पर मौजूदा GPT-5.6 Sol अनुभव की तुलना में 1.9x तेज़ टास्क पूर्णता देता है।
यह OpenAI API में और Amazon Bedrock के माध्यम से gpt-6-astra के रूप में उपलब्ध है, और Pro, Business, तथा Enterprise प्लान्स के लिए GPT-6 Astra Pro टियर भी है।
यदि आप OpenAI के नवीनतम लोअर-टियर मॉडलों में भी रुचि रखते हैं, तो हमारा GPT-6 Sol और Luna गाइड देखें।
Astra के बदलाव एजेंटिक एक्ज़ीक्यूशन के इर्द-गिर्द केंद्रित हैं: कंप्यूटर का उपयोग, तैयार प्रोफेशनल आर्टिफैक्ट बनाना, लंबी कोडिंग सत्रों में संदर्भ बनाए रखना, और अधिकृत सीमाओं के भीतर रहना।
ये क्षमताएँ विशेष रूप से उल्लेखनीय हैं।
Astra सीधे कंप्यूटर चला सकता है, उस तरह के उबाऊ मल्टी-स्टेप काम को संभालते हुए जो आम तौर पर पूरा दोपहर खा जाता है।
कुछ अच्छे उदाहरणों में शामिल हैं:
OSWorld 2.0 पर लेटेंसी सिमुलेशंस में, Astra प्रति टास्क लगभग 40 मिनट में 72.6% तक पहुँचता है, जबकि GPT-5.6 Sol लगभग 75 मिनट में 65.7% पर था—प्रति टास्क समय में 47% की कटौती।
OSWorld 2.0 मापता है कि क्या कोई मॉडल वास्तव में कंप्यूटर चला सकता है—जैसे वास्तविक इंटरफेस में नेविगेट करना, क्लिक करना, टाइप करना, और मल्टी-स्टेप कार्यों को इंसान की तरह पूरा करना।
प्रति टास्क समय में 47% की कटौती सटीकता जितनी ही मायने रखती है, क्योंकि एजेंट की लागत वॉल-क्लॉक समय के साथ स्केल करती है; जो मॉडल 75 मिनट की बजाय 40 मिनट में खत्म कर देता है, वह न केवल तेज़ है, बल्कि उसी वर्कलोड पर चलाने में लगभग आधी कीमत का पड़ता है।
यह कहते हुए भी, स्वतंत्र ARC Prize परीक्षण दिखाते हैं कि Astra के हेडलाइन कंप्यूटर-उपयोग और तर्क संबंधी आंकड़े हार्नेस पर अत्यधिक निर्भर हैं।
ARC-AGI-3 पर, मानक स्टेटलेस हार्नेस ने तर्क टियर पर निर्भर करते हुए लगभग 17% से 63% तक स्कोर दिए, जबकि रीज़निंग स्टेट को सुरक्षित रखने वाला प्रोवाइडर एडाप्टर हार्नेस मार्केटेड ~99.9% तक पहुँचा।
यदि आप मॉडल को स्टेटलेस तरीके से कॉल करते हैं, तो लॉन्च चार्ट्स से कम आंकड़ों की उम्मीद रखें।
Astra को ऐसे प्रशिक्षित किया गया है कि वह आपके टेम्प्लेट्स का पालन करते हुए पॉलिश्ड प्रोफेशनल आर्टिफैक्ट दे, न कि जनरल फर्स्ट ड्राफ्ट।
यह दस्तावेज़, प्रस्तुतियाँ, स्प्रेडशीट्स, और विश्लेषण बनाता है जो आपकी लेखन और विज़ुअल शैली से मेल खाते हैं, और आउटपुट में केवल वही संदर्भ खींचता है जो मायने रखता है, न कि उसे अपनी सारी जानकारी से भर देता है।
OpenAI के अपने डेमो में, Astra ने कुछ टेम्प्लेट स्लाइड्स से एक काल्पनिक मॉडल पर स्लाइड डेक बनाया, जिसमें पूरे समय टोन और लेआउट सुसंगत रहे।
जिस किसी ने भी किसी LLM के मार्कडाउन डंप को कॉर्पोरेट टेम्प्लेट में फिर से फ़ॉर्मैट करने में एक घंटा लगाया है, उसके लिए टेम्प्लेट अनुपालन वह भाग है जिसे मैं सबसे पहले टेस्ट करना चाहूँगा।
ChatGPT में Sites के साथ, Astra केवल एक प्रॉम्प्ट से ही वेबसाइट्स, वेब ऐप्स, और गेम्स बना, होस्ट, और साझा कर सकता है, और पहले के मॉडलों की तुलना में रेंडरिंग्स पर बेहतर विज़ुअल जजमेंट लागू करता है।
Astra तय करता है कि कब आपसे सवाल पूछना है और कब समझदारीपूर्ण मान्यताओं पर आगे बढ़ना है।
जब निर्देशों में व्याख्या की गुंजाइश होती है, तो यह रोज़मर्रा की खाइयों को खुद भरता है और केवल तब केंद्रित सवाल पूछता है जब जवाब नतीजे को बदल सकता हो।
OpenAI की साइड-बाय-साइड में, GPT-5.6 Sol ने 13 मिनट 15 सेकंड में स्वतः एक व्यक्तिगत करियर वेबसाइट बना दी, जबकि Astra ने 20 सेकंड बाद रुककर पूछा कि उपयोगकर्ता किस करियर में जा रहा है।
Codex में, Astra असिंक्रोनस रूप से पूछ सकता है—ऐसा काम जारी रखते हुए जो आपके उत्तर पर निर्भर नहीं है और केवल निर्णायक बातों पर इंतज़ार करता है।
Astra किसी टास्क के बदलते ही उन्मुख भी रहता है।
पहले के मॉडल कभी-कभी बीच-टास्क दिशा-निर्देश संदेश को एक बिल्कुल नए लक्ष्य की तरह मान लेते थे और मूल बाधाएँ खो देते थे; Astra नई आवश्यकताओं को समाहित करता है और साइड सवालों के जवाब देता है, बिना व्यापक काम को छोड़े।
GPT-6 Astra Codex के लिए संदर्भ को सुरक्षित रखने और पुनः प्राप्त करने का नया तरीका पेश करता है—जब कॉन्टेक्स्ट विंडो भर जाती है, तो बार-बार समरीकरण के बजाय सर्चेबल नोट्स।
इतिहास적으로, मॉडल लंबे डीबगिंग सत्रों या बड़े रिफैक्टर्स को एकल समरी में संकुचित करने के लिए कम्पैक्शन का उपयोग करते हैं, जिससे यह विवरण छूट सकता है कि कोई फिक्स क्यों असफल हुआ या कोई घटक कैसे व्यवहार करता है।
Astra के साथ, Codex विंडोज़ के पार नोट्स रखता है और पहले की विंडोज़ को सर्चेबल छोड़ता है, ताकि वह किसी पहले संदेश से कोई आवश्यकता या टेस्ट परिणाम खोज सके, भले ही वह नोट में कैप्चर न हुआ हो।
आप अपने Codex के config.toml में इस प्रायोगिक फ़ीचर को सक्षम करते हैं, और OpenAI का कहना है कि आने वाले हफ्तों में यह Astra के लिए डिफ़ॉल्ट बन जाएगा।
OpenAI के Preparedness Framework के तहत साइबरसिक्योरिटी में Astra Critical थ्रेशहोल्ड तक पहुँचता है—जो इसकी सबसे मजबूत नई क्षमता भी है और सबसे अधिक प्रतिबंधित भी।
लॉन्च के समय, यह सुरक्षित कोड रिव्यू और पैचिंग में मदद करेगा, लेकिन प्रूफ़-ऑफ़-कॉन्सेप्ट एक्सप्लॉइट्स बनाने जैसे अधिक उन्नत कार्यों से इनकार करेगा।
OpenAI अपने Daybreak प्रोग्राम के माध्यम से कम प्रतिबंधात्मक सेफगार्ड्स के साथ पहुंच का विस्तार करने की योजना बनाता है, जिससे वल्नरेबिलिटी और प्रूफ़-ऑफ़-कॉन्सेप्ट वैलिडेशन, मैलवेयर विश्लेषण, और डिटेक्शन इंजीनियरिंग सक्षम होगी।
बढ़ते जोखिम के कारण, अतिरिक्त सेफ्टी चेक वैध कार्यों को भी रोक या विराम दे सकते हैं: ChatGPT या Codex में आपसे किसी कार्रवाई की समीक्षा करने के लिए कहा जा सकता है, और API में टास्क सीधे रुक जाएगा।
OpenAI के रिपोर्टेड इवैल्यूएशंस में Astra कंप्यूटर उपयोग, गणित, कोडिंग, और साइबरसिक्योरिटी में नए उच्च स्तर तय करता है, अक्सर GPT-5.6 Sol या Claude मॉडलों की तुलना में कम आउटपुट टोकन का उपयोग करते हुए।
नीचे दिए गए स्कोर OpenAI की लॉन्च टेबल्स से हैं, इसलिए इन्हें वेंडर-रिपोर्टेड मानेँ और जहाँ लागू हो, हार्नेस से संबंधित चेतावनियों पर ध्यान दें।
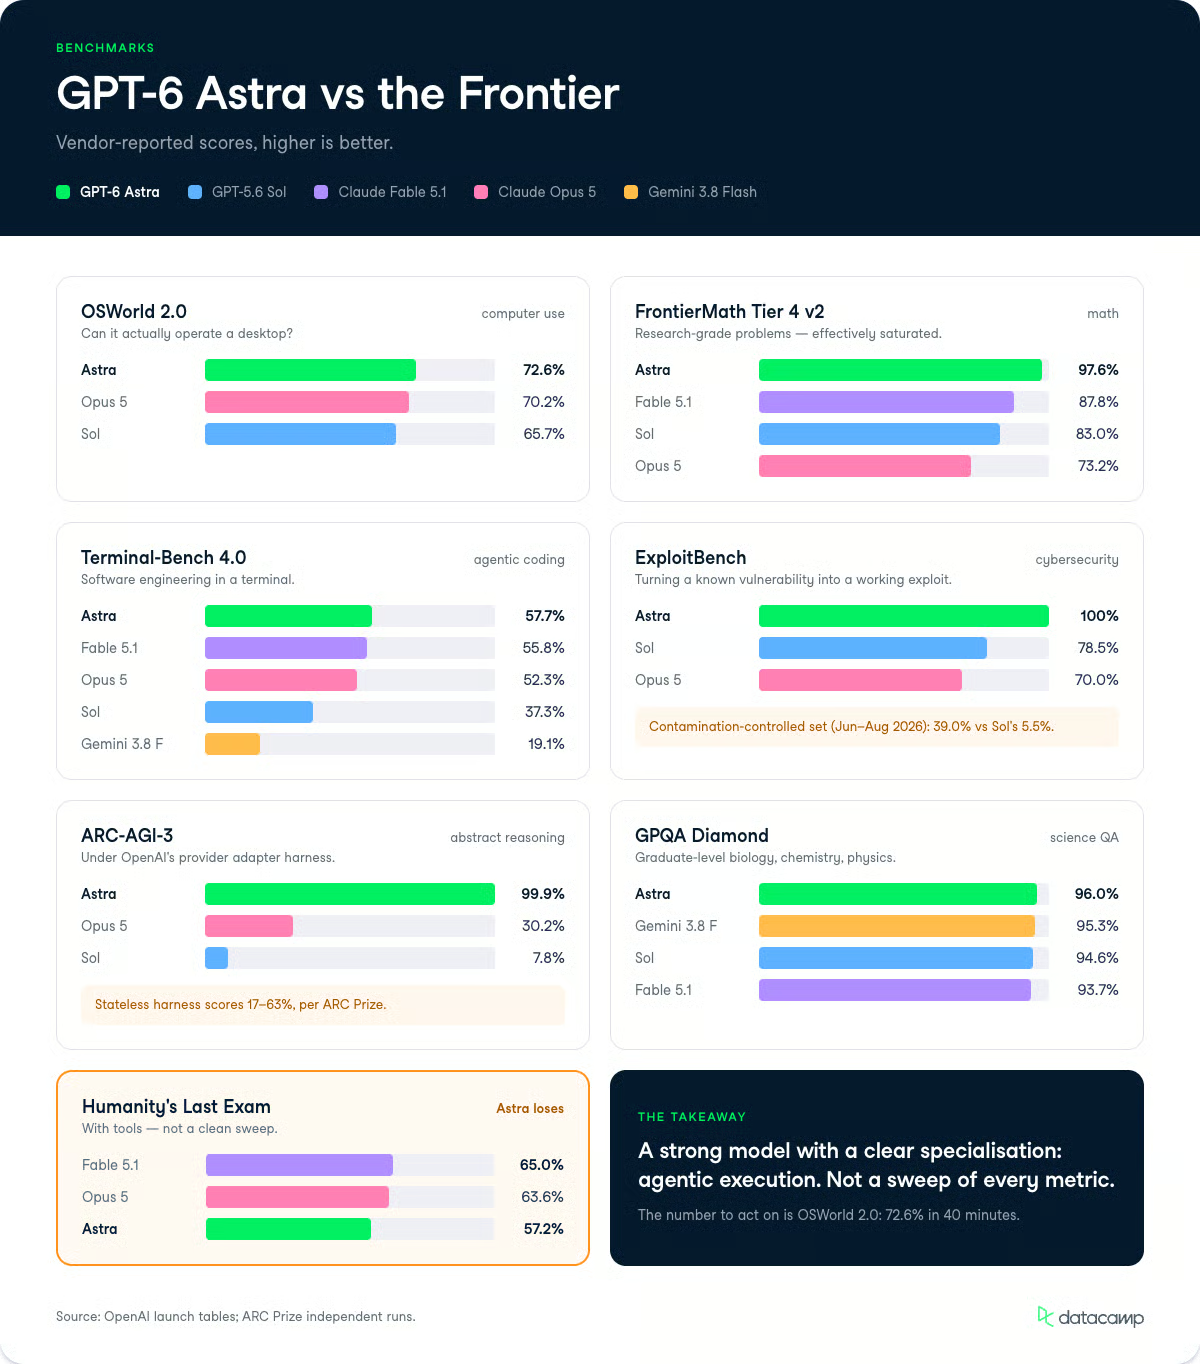
Astra OSWorld 2.0 ऑफ़लाइन सेट पर 72.6% स्कोर करता है, जबकि GPT-5.6 Sol 65.7% और Claude Opus 5 70.2% पर हैं।
OSWorld मापता है कि क्या कोई एजेंट वास्तविक डेस्कटॉप कार्य पूरे कर सकता है—जैसे ऐप्स में नेविगेट करना और फ़ाइलों में हेरफेर करना—इसलिए यह इस सवाल का सबसे नज़दीकी प्रतिनिधि है: "क्या यह वाकई मेरे लिए कंप्यूटर चला सकता है?"
ScreenSpot-Pro पर, जो बिना टूल्स के स्क्रीन पर UI एलिमेंट्स की ग्राउंडिंग को परखता है, Astra 92.7% पर हिट करता है, जबकि GPT-5.6 Sol 76.9% और Claude Fable 5 87.3% पर हैं।
Agents' Last Exam पर, यह 59.3% तक पहुँचता है, जो Claude Opus 5 के 55.5% और GPT-5.6 Sol के 53.6% से आगे है, जबकि Opus 5 की तुलना में लगभग 65% कम आउटपुट टोकन का उपयोग करता है।
Astra FrontierMath Tier 4 v2 पर 97.6% स्कोर करता है, जो एक रिसर्च-ग्रेड गणित बेंचमार्क की सबसे कठिन श्रेणी है, जबकि Claude Fable 5.1 और Fable 5 दोनों 87.8% और Claude Opus 5 73.2% पर हैं।
OpenAI इसे सैचुरेशन कहता है, और दिए गए सीलिंग के मद्देनज़र, यह उचित व्याख्या है।
GPQA Diamond पर, जो जीवविज्ञान, रसायन विज्ञान, और भौतिकी में स्नातकोत्तर स्तर के सवालों का सेट है, Astra 96.0% तक पहुँचता है, जबकि Gemini 3.8 Flash 95.3% और GPT-5.6 Sol 94.6% पर हैं।
हालाँकि यह हर मीट्रिक में शीर्ष पर नहीं है। Humanity's Last Exam (टूल्स के साथ) पर, Astra 57.2% स्कोर करता है, जो Claude Fable 5.1 के 65.0% और Opus 5 के 63.6% से पीछे है, इसलिए यह हर रीज़निंग इवैल पर नहीं छा रहा।
Terminal-Bench 4.0 पर, जो टर्मिनल में सॉफ़्टवेयर इंजीनियरिंग, सिस्टम कॉन्फ़िगरेशन, और डेटा विश्लेषण पर एजेंट्स का परीक्षण करता है, Astra 57.7% स्कोर करता है, जबकि GPT-5.6 Sol 37.3%, Claude Fable 5.1 55.8%, और Gemini 3.8 Flash 19.1% पर हैं।
यह Gemini Flash पर बड़ा अंतर है और Fable 5.1 पर मामूली बढ़त।
बाकी कोडिंग तस्वीर काफ़ी क़रीबी है।
FrontierCode 1.1 Main पर, Astra 53.3% स्कोर करता है, जबकि Fable 5 53.5% और Opus 5 53.4% पर हैं—व्यावहारिक रूप से टाई—और DeepSWE v1.1 पर यह 74.1% तक पहुँचता है, जबकि Gemini 3.8 Flash 73.8% और Fable 5 69.9% पर हैं।
जब हमने अपने Terra बनाम Claude Sonnet 5 तुलना में GPT-5.6 Terra की समीक्षा की, तो Terra ने Terminal-Bench 2.1 (एक अलग संस्करण) पर 87.4% हिट किया था, इसलिए यहाँ क्रॉस-वर्ज़न तुलना एक जैसी नहीं है।
Astra ExploitBench पर 100% स्कोर करता है, जबकि GPT-5.6 Sol 78.5% और Claude Opus 5 70% पर हैं, और ExploitGym पर 42.4% बनाम Sol के 30.3%।
ExploitBench मापता है कि क्या कोई मॉडल ज्ञात वल्नरेबिलिटी को वर्किंग एक्सप्लॉइट में बदल सकता है, इसलिए परफेक्ट स्कोर ही वह वजह है कि OpenAI लॉन्च पर इस क्षमता को गेट कर रहा है।
कंटैमिनेशन-कंट्रोल्ड ExploitBench (जून–अगस्त 2026), जो पिछले तीन महीनों की वल्नरेबिलिटीज से बना है, पर Astra 39.0% स्कोर करता है, जबकि Sol 5.5% पर है।
SRE-Bench पर, जो सोर्स के बिना बाइनरीज़ के रिवर्स-इंजीनियरिंग को मापता है, Astra एक प्रयास में 88.0% हल करता है, जबकि Sol 55.9% पर है।
स्वतंत्र लैब Irregular ने रिपोर्ट किया कि Astra ने 226 FrontierCyber चुनौतियों में से 86 हल कीं, जबकि Sol ने 34—जिनमें ब्राउज़र्स और एक क्लाउड डेटाबेस में ज़ीरो-डे खोजें शामिल हैं।
Astra OpenAI के प्रोवाइडर एडाप्टर हार्नेस के तहत ARC-AGI-3 पर 99.9% स्कोर करता है, जबकि GPT-5.6 Sol 7.8% और Claude Opus 5 30.2% पर हैं।
यह वह संख्या है जिसे सावधानी से पढ़ना चाहिए: ARC Prize की स्वतंत्र रनों में मानक स्टेटलेस हार्नेस पर तर्क टियर के अनुसार लगभग 17% से 63% तक स्कोर दिखते हैं, जबकि ~99.9% के लिए स्टेटफुल एडाप्टर हार्नेस और एक व्यापक रन चाहिए जो दसियों हज़ार डॉलर का पड़ता है।
लंबे कॉन्टेक्स्ट पर, Astra OpenAI MRCR v2 8-needle में 256K–512K बैंड पर 100% और 512K–1M बैंड पर 96.3% हिट करता है, जबकि GPT-5.6 Sol 91.5% और 73.8% पर है।
1M टोकन पर वह रिट्रीवल विश्वसनीयता, दस्तावेज़-प्रधान पाइपलाइनों के लिए Sol पर वास्तविक उन्नति है।
Astra OpenAI के आंतरिक कंप्यूटर-उपयोग सुरक्षा बेंचमार्क पर 2.4% (कम बेहतर है) पोस्ट करता है, जबकि GPT-5.6 Sol 22.0%, Fable 5.1 9.5%, और Opus 5 11.5% पर हैं।
यथार्थवादी कार्य परिवेशों में, बिना कन्फर्मेशन पॉलिसी के इसका ओवरऑल मिसअलायन्ड-आउटकम रेट 3.4% है, जबकि Sol 18.8% और GPT-5.6 Terra 13.5% पर हैं।
OpenAI जिस एक रिग्रेशन को फ़्लैग करता है वह है chain-of-thought मॉनिटरबिलिटी।
Astra छोटा, कम वर्बोज़ तर्क उत्पन्न करता है और Sol की तुलना में अपना CoT कहीं बेहतर नियंत्रित करता है; 750 से 1,250 टोकन के बीच CoT-Control पर, इसने 60.9% बार बाधाओं का पालन किया, जबकि Sol 16.1% पर था।
UK AISI ने पाया कि Astra शत्रुतापूर्ण प्रॉम्प्टिंग के तहत मॉनिटरिंग से बच सकता है, और OpenAI इस गिरावट को इतना गंभीर मानता है कि इसे शोध प्राथमिकता घोषित किया है।
यहाँ कुछ प्रमुख बेंचमार्क्स पर Astra के रिपोर्टेड स्कोर उन प्रतिद्वंद्वियों के मुकाबले दिए गए हैं जिन्हें यह लक्षित करता है।
| Benchmark | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Claude Opus 5 | Gemini 3.8 Flash |
|---|---|---|---|---|---|
| OSWorld 2.0 | 72.6% | 65.7% | - | 70.2% | - |
| FrontierMath Tier 4 v2 | 97.6% | 83.0% | 87.8% | 73.2% | - |
| GPQA Diamond | 96.0% | 94.6% | 93.7% | 93.7% | 95.3% |
| Terminal-Bench 4.0 | 57.7% | 37.3% | 55.8% | 52.3% | 19.1% |
| ExploitBench | 100.0% | 78.5% | - | 70.0% | - |
| ARC-AGI-3 (adapter harness) | 99.9% | 7.8% | - | 30.2% | - |
GPT-6 Astra पहले सीमित संगठनों के सेट को रोलआउट हो रहा है, फिर आने वाले दिनों में सभी ChatGPT Plus, Pro, Business, और Enterprise उपयोगकर्ताओं को, साथ ही OpenAI API और AWS पर उपलब्ध होगा।
एंटरप्राइज़ एडमिन इसे प्रति वर्कस्पेस सक्षम कर सकते हैं, और लॉन्च पर यह डिफ़ॉल्ट रूप से ऑफ़ है। Pro, Business, और Enterprise प्लान्स को GPT-6 Astra Pro भी मिलता है।
डेवलपर्स के लिए, मॉडल OpenAI API और Amazon Bedrock में gpt-6-astra के रूप में उपलब्ध है।
स्टैंडर्ड API प्राइसिंग:
संदर्भ के लिए, यह हमारे पहले की कवरेज के GPT-5.6 Terra के $2/$12 रेट्स से काफ़ी ऊपर है, और Claude Opus 5 के $5/$25 से भी ऊपर।
Astra की कीमत एक फ्रंटियर रीज़निंग और ऑटोमेशन मॉडल जैसी है, न कि थोक-पाठ कार्यों के वर्कहॉर्स जैसी।
यह योग्य API ग्राहकों के लिए Zero Data Retention को सपोर्ट करता है, और उपयोग मौजूदा सब्सक्रिप्शन अलाउंसेज़ में शामिल है, अतिरिक्त क्रेडिट्स खरीदने का विकल्प मौजूद है।
मेरे सभी सोशल मीडिया फ़ीड्स GPT-6 Astra उपयोग मामलों के उदाहरणों से गुलज़ार हैं। हालाँकि मैं अभी तक खुद इसे हाथों-हाथ नहीं आजमा पाया हूँ, कुछ दिलचस्प उदाहरण हैं जिनका यहाँ उल्लेख करना उचित है:
मैंने कई पोस्ट देखीं जहाँ लोगों ने Blender में GPT-6 Astra का उपयोग कर अत्यंत विस्तृत और यथार्थवादी 3D मॉडल बनाए।
नीचे दिए गए क्लिप में, X उपयोगकर्ता Tom Krcha ने GPT-6 को एक घर की छवि दी और कहा कि उसे 3D में सभी विवरणों सहित—खिलौने, उपकरण, और फर्नीचर—बनाएँ। यह Blender में ज्योमेट्री के साथ पूर्ण 3D मॉडल रिकंस्ट्रक्शन है, जिसे आप मैन्युअल रूप से ट्वीक कर सकते हैं और डिवाइस पर लोकली रेंडर्ड "गेम" के रूप में 60fps पर चला सकते हैं।
Top DataCamp Courses
कोर्स
कोर्स
लर्निंग पाथ