
LLMs को बेहतर करने के लिए RAG क्यों इस्तेमाल करें? एक उदाहरण
यह दिखाने के लिए कि RAG क्या है और यह तकनीक कैसे काम करती है, आइए एक ऐसा परिदृश्य लें जिसका सामना आज कई व्यवसाय करते हैं।
मान लीजिए आप एक इलेक्ट्रॉनिक्स कंपनी में एक कार्यकारी हैं जो स्मार्टफोन और लैपटॉप जैसे डिवाइस बेचती है। आप अपनी कंपनी के लिए एक कस्टमर सपोर्ट चैटबॉट बनाना चाहते हैं जो उत्पाद विनिर्देश, ट्रबलशूटिंग, वारंटी जानकारी, और अन्य सवालों के जवाब दे सके।
आप अपने चैटबॉट को संचालित करने के लिए एक LLM का उपयोग करना चाहेंगे। हालांकि, जैसा कि मैंने संकेत दिया, बड़े भाषा मॉडल्स की कुछ महत्वपूर्ण सीमाएँ होती हैं, जो अक्षम ग्राहक अनुभव की ओर ले जाती हैं:
विशिष्ट जानकारी की कमी
भाषा मॉडल अपने प्रशिक्षण डेटा के आधार पर सामान्य उत्तर देने तक सीमित होते हैं। यदि उपयोगकर्ता आपके सॉफ़्टवेयर से संबंधित विशिष्ट प्रश्न पूछें, या गहन ट्रबलशूटिंग कैसे करें इस पर सवाल करें, तो पारंपरिक LLM सटीक उत्तर देने में सक्षम नहीं हो सकता।
क्योंकि इन्हें आपकी संस्था-विशिष्ट डेटा पर प्रशिक्षित नहीं किया गया है। साथ ही, इन मॉडलों के प्रशिक्षण डेटा की एक कटऑफ तिथि होती है, जो नवीन उत्तर देने की क्षमता को सीमित करती है।
Hallucinations
LLMs “hallucinate” कर सकते हैं, यानी कल्पित तथ्यों के आधार पर आत्मविश्वास से गलत जवाब जनरेट कर देते हैं। यदि उपयोगकर्ता के प्रश्न का सटीक उत्तर न हो, तो ये एल्गोरिद्म विषयांतर भी कर सकते हैं, जिससे खराब ग्राहक अनुभव होता है।
सामान्यीकृत जवाब
भाषा मॉडल अक्सर ऐसे सामान्य उत्तर देते हैं जो विशिष्ट संदर्भों के अनुरूप नहीं होते। कस्टमर सपोर्ट परिदृश्य में यह बड़ी कमी है, क्योंकि व्यक्तिगत उपयोगकर्ता प्राथमिकताओं के आधार पर निजीकरण आवश्यक होता है।
RAG इन खाइयों को प्रभावी ढंग से पाटता है, क्योंकि यह LLMs के सामान्य ज्ञान-आधार को आपके उत्पाद डेटाबेस और यूजर मैनुअल जैसी विशिष्ट जानकारी तक पहुँच की क्षमता के साथ जोड़ देता है। यह पद्धति आपकी संस्था की आवश्यकताओं के अनुरूप अत्यधिक सटीक और विश्वसनीय उत्तर देती है।
RAG कैसे काम करता है?
एक सामान्य RAG पाइपलाइन में दो चरण होते हैं: ऑफ़लाइन इंडेक्सिंग चरण (आपके डेटा की तैयारी) और रियल-टाइम इन्फ़रेंस चरण (क्वेरी का उत्तर देना)। मुख्य कदम ये हैं।
चरण 1: डेटा संग्रह
पहले आपको अपने अनुप्रयोग के लिए आवश्यक सभी डेटा इकट्ठा करना होगा। इलेक्ट्रॉनिक्स कंपनी के कस्टमर सपोर्ट चैटबॉट के मामले में, इसमें यूजर मैनुअल, उत्पाद डेटाबेस, और FAQs की सूची शामिल हो सकती है।
चरण 2: डेटा चंकिंग
डेटा चंकिंग आपके डेटा को छोटे, अधिक प्रबंधनीय हिस्सों में बाँटने की प्रक्रिया है। उदाहरण के लिए, यदि आपके पास 100-पेज का लंबा यूजर मैनुअल है, तो आप इसे अलग-अलग सेक्शनों में बाँट सकते हैं, जिनमें से प्रत्येक संभावित रूप से अलग-अलग ग्राहक प्रश्नों का उत्तर देता है।
इस तरह, प्रत्येक डेटा चंक एक विशिष्ट विषय पर केंद्रित रहता है। जब स्रोत डेटासेट से कोई जानकारी निकाली जाती है, तो उसके उपयोगकर्ता की क्वेरी पर सीधे लागू होने की संभावना अधिक रहती है, क्योंकि हम पूरे दस्तावेज़ की अप्रासंगिक जानकारी शामिल करने से बचते हैं।
यह दक्षता भी बढ़ाता है, क्योंकि सिस्टम पूरे दस्तावेज़ों को प्रोसेस करने के बजाय सबसे प्रासंगिक हिस्सों को तेज़ी से प्राप्त कर सकता है।
चरण 3: डॉक्यूमेंट एम्बेडिंग्स
अब जब स्रोत डेटा छोटे हिस्सों में टूट चुका है, तो इसे वेक्टर प्रतिनिधित्व में बदला जाना चाहिए। इसमें पाठ डेटा को एम्बेडिंग्स में बदलना शामिल है, जो संख्यात्मक प्रतिनिधित्व हैं और पाठ के पीछे के सैमांतिक अर्थ को कैप्चर करते हैं।
डॉक्यूमेंट एम्बेडिंग्स सिस्टम को सटीक कीवर्ड मेल के बजाय अर्थ के आधार पर उपयोगकर्ता क्वेरी को प्रासंगिक जानकारी से मिलाने देती हैं। “fix my laptop screen” जैसी क्वेरी “display troubleshooting” वाले चंक से मेल खा सकती है, भले ही शब्द अलग हों।
यदि आप जानना चाहते हैं कि पाठ डेटा को वेक्टर प्रतिनिधित्व में कैसे बदला जाता है, तो हमारा OpenAI API के साथ टेक्स्ट एम्बेडिंग्स पर ट्यूटोरियल देखें।
चरण 4: उपयोगकर्ता क्वेरी हैंडल करना
जब कोई उपयोगकर्ता क्वेरी सिस्टम में आती है, तो उसे भी एम्बेडिंग या वेक्टर प्रतिनिधित्व में बदला जाना चाहिए। एक समानता सुनिश्चित करने के लिए डॉक्यूमेंट और क्वेरी—दोनों—की एम्बेडिंग हेतु वही मॉडल इस्तेमाल होना चाहिए।
क्वेरी को एम्बेडिंग में बदलने के बाद, सिस्टम क्वेरी एम्बेडिंग की तुलना डॉक्यूमेंट एम्बेडिंग्स से करता है। यह कोसाइन समानता और यूक्लिडियन दूरी जैसी मापों का उपयोग करके उन चंक्स को पहचानता और प्राप्त करता है जिनकी एम्बेडिंग्स क्वेरी एम्बेडिंग के सबसे अधिक समान होती हैं।
इन चंक्स को उपयोगकर्ता की क्वेरी के लिए सबसे प्रासंगिक माना जाता है।
चरण 5: LLM के साथ उत्तर जनरेट करना
प्राप्त किए गए टेक्स्ट चंक्स, शुरुआती उपयोगकर्ता क्वेरी के साथ, एक भाषा मॉडल में दिए जाते हैं। एल्गोरिद्म इस जानकारी का उपयोग चैट इंटरफ़ेस के माध्यम से उपयोगकर्ता के प्रश्नों का सुसंगत उत्तर जनरेट करने के लिए करता है।
यहाँ RAG के काम करने का सार बताने वाला एक सरल फ्लोचार्ट है:
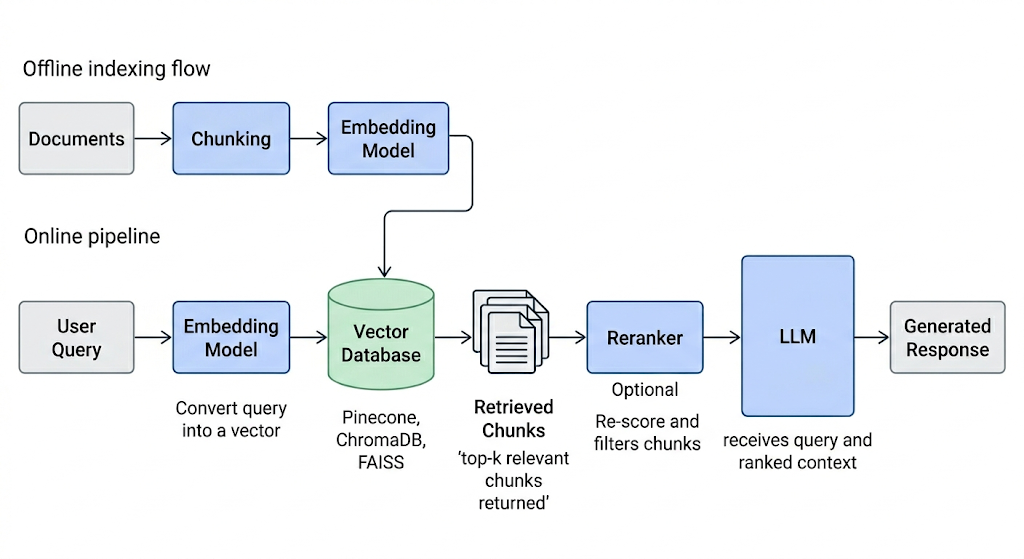
व्यवहार में यह पाइपलाइन बनाने के लिए, आप LlamaIndex या LangChain जैसे फ्रेमवर्क का उपयोग कर सकते हैं।
दोनों फ्रेमवर्क चंकिंग, एम्बेडिंग, रिट्रीवल, और प्रॉम्प्ट कंस्ट्रक्शन का ऑर्केस्ट्रेशन संभालते हैं, ताकि आप प्लंबिंग के बजाय अपने डेटा और उपयोग-केस पर ध्यान केंद्रित कर सकें।
RAG के व्यावहारिक उपयोग
उपरोक्त कस्टमर सपोर्ट चैटबॉट उदाहरण से आगे, RAG के कई अन्य व्यावहारिक अनुप्रयोग हैं:
टेक्स्ट सार-संक्षेप
RAG बाहरी स्रोतों की सामग्री का उपयोग करके सटीक सार-संक्षेप बना सकता है, जिससे काफी समय बचता है। उदाहरण के लिए, प्रबंधक और वरिष्ठ अधिकारी व्यस्त होते हैं और उनके पास विस्तृत रिपोर्टों को खंगालने का समय नहीं होता।
RAG-समर्थित अनुप्रयोग के साथ, वे पाठ डेटा से सबसे महत्वपूर्ण निष्कर्षों तक तेज़ी से पहुँच सकते हैं और लंबी डॉक्यूमेंट्स पढ़ने के बजाय अधिक कुशलता से निर्णय ले सकते हैं।
व्यक्तिगत अनुशंसाएँ
RAG सिस्टम ग्राहक डेटा—जैसे पिछले ख़रीद और समीक्षाएँ—का विश्लेषण करके उत्पाद अनुशंसाएँ जनरेट कर सकते हैं। इससे उपयोगकर्ता का समग्र अनुभव बेहतर होगा और अंततः संगठन के लिए अधिक राजस्व उत्पन्न होगा।
उदाहरण के लिए, RAG एप्लिकेशन उपयोगकर्ता के देखने के इतिहास और रेटिंग्स के आधार पर स्ट्रीमिंग प्लेटफॉर्म पर बेहतर फ़िल्में सुझा सकते हैं। ये ई-कॉमर्स प्लेटफॉर्म पर लिखी गई समीक्षाओं का विश्लेषण करने में भी इस्तेमाल किए जा सकते हैं।
चूँकि LLMs पाठ डेटा के पीछे के सैमांतिक अर्थ को समझने में उत्कृष्ट हैं, RAG सिस्टम पारंपरिक रिकमेंडेशन सिस्टम की तुलना में अधिक सूक्ष्म व्यक्तिगत सुझाव दे सकते हैं।
बिज़नेस इंटेलिजेंस
संगठन रिपोर्ट्स, वित्तीय वक्तव्यों और शोध दस्तावेज़ों में प्रतिस्पर्धियों के व्यवहार और बाज़ार रुझानों को ट्रैक करके व्यावसायिक निर्णय लेते हैं।
एक RAG एप्लिकेशन इन दस्तावेज़ों से मांग पर प्रासंगिक निष्कर्ष सामने ला सकता है, जिससे विश्लेषकों का सैकड़ों पन्ने पढ़ने में लगने वाला समय कम होता है।
RAG सिस्टम लागू करने की चुनौतियाँ और सर्वोत्तम प्रथाएँ
मूल retrieve-and-generate पैटर्न सरल उपयोग मामलों में अच्छा काम करता है, लेकिन प्रोडक्शन डिप्लॉयमेंट्स पाइपलाइन के हर चरण में इंजीनियरिंग चुनौतियाँ लाते हैं।
इंटीग्रेशन की जटिलता
रिट्रीवल सिस्टम को LLM से इंटीग्रेट करना कठिन हो सकता है। जब विभिन्न प्रारूपों में कई बाहरी डेटा स्रोत हों तो यह जटिलता बढ़ जाती है। RAG सिस्टम में डाला गया डेटा सुसंगत होना चाहिए और सभी स्रोतों में एम्बेडिंग्स का प्रारूप एक-सा होना चाहिए।
इस चुनौती से निपटने के लिए, अलग-अलग डेटा स्रोतों के लिए अलग मॉड्यूल डिज़ाइन किए जा सकते हैं। प्रत्येक मॉड्यूल के भीतर डेटा को एकरूपता के लिए प्रीप्रोसेस किया जा सकता है, और एक मानकीकृत मॉडल का उपयोग किया जा सकता है ताकि एम्बेडिंग्स का प्रारूप सुसंगत रहे।
स्केलेबिलिटी
जैसे-जैसे डेटा की मात्रा बढ़ती है, RAG सिस्टम की दक्षता बनाए रखना और चुनौतीपूर्ण होता जाता है। कई जटिल ऑपरेशंस करने पड़ते हैं—जैसे एम्बेडिंग्स बनाना, अलग-अलग टेक्स्ट के बीच अर्थ की तुलना करना, और रियल-टाइम में डेटा रिट्रीव करना।
ये कार्य कम्प्यूटेशनली भारी होते हैं और स्रोत डेटा का आकार बढ़ने पर सिस्टम को धीमा कर सकते हैं।
इस चुनौती का समाधान करने के लिए, आप कम्प्यूटेशनल लोड को अलग सर्वर्स में बाँट सकते हैं और मज़बूत हार्डवेयर इंफ्रास्ट्रक्चर में निवेश कर सकते हैं। प्रतिक्रिया समय सुधारने के लिए अक्सर पूछी जाने वाली क्वेरियों को कैश करना भी लाभदायक हो सकता है।
वेक्टर डेटाबेस जैसे Pinecone, ChromaDB, FAISS, और Weaviate इसी समस्या के लिए बनाए गए हैं। ये एम्बेडिंग्स संग्रहीत करते हैं और तेज़ approximate nearest-neighbor (ANN) सर्च करते हैं, जिससे लाखों दस्तावेज़ों में भी मिलीसेकंड्स में सबसे प्रासंगिक चंक्स वापस मिलते हैं।
हैंड्स-ऑन वॉकथ्रू के लिए हमारा Pinecone के साथ वेक्टर डेटाबेस ट्यूटोरियल देखें, या जानें कि LangChain और FastAPI के साथ एक सम्पूर्ण RAG सिस्टम कैसे बनाएँ।
डेटा गुणवत्ता
RAG सिस्टम की प्रभावशीलता काफी हद तक इसमें डाले जा रहे डेटा की गुणवत्ता पर निर्भर करती है। यदि एप्लिकेशन जिस स्रोत सामग्री तक पहुँचता है वह कमजोर है, तो जनरेट हुए उत्तर भी गलत होंगे।
संगठनों को मेहनती कंटेंट क्यूरेशन और फाइन-ट्यूनिंग प्रक्रिया में निवेश करना चाहिए। डेटा स्रोतों को परिष्कृत करना आवश्यक है ताकि उनकी गुणवत्ता बढ़ सके। व्यावसायिक अनुप्रयोगों के लिए, डेटासेट को RAG सिस्टम में उपयोग करने से पहले किसी विषय-विशेषज्ञ को समीक्षा और सूचना-अंतराल भरने में शामिल करना लाभदायक हो सकता है।
उन्नत RAG तकनीकें
बेसिक RAG पाइपलाइन काम करती है, लेकिन इसके कुछ ज्ञात विफलता-स्थितियाँ हैं: अप्रासंगिक रिट्रीवल, लंबे दस्तावेज़ों में संदर्भ का खोना, और एक से अधिक स्रोतों के पार तर्क करने में अक्षमता। इन खाइयों को पाटने के लिए कई तकनीकें उभरी हैं।
- Agentic RAG: एक AI एजेंट यह तय करता है कि कब और क्या रिट्रीव करना है, क्वेरियों को फिर से गढ़ता है, और कई रिट्रीवल स्टेप्स को एक साथ जोड़ता है। उपयोगी जब एक ही रिट्रीवल पास काफ़ी नहीं होता।
- GraphRAG: ज्ञान को सपाट चंक्स के बजाय ग्राफ़ के रूप में संरचित करता है, जिससे इकाइयों के बीच संबंध संरक्षित रहते हैं। ऐसे सवालों पर अच्छा प्रदर्शन करता है जिन्हें दस्तावेज़ों में फैले तथ्यों को जोड़ने की ज़रूरत होती है।
- Self-RAG: मॉडल तय करता है कि रिट्रीवल आवश्यक है या नहीं और अपने आउटपुट की तथ्यात्मकता की स्वयं समीक्षा करता है, जिससे अनावश्यक रिट्रीवल कॉल्स कम होती हैं।
- Corrective RAG (CRAG): जेनरेटर को पास करने से पहले प्राप्त दस्तावेज़ों की प्रासंगिकता का मूल्यांकन करता है, शोर को फ़िल्टर करता है।
- Multimodal RAG: रिट्रीवल को केवल टेक्स्ट से आगे बढ़ाकर इमेज, टेबल्स और अन्य मीडिया प्रकारों तक विस्तारित करता है।
- Contextual retrieval: एम्बेडिंग से पहले प्रत्येक चंक में दस्तावेज़-स्तरीय संदर्भ जोड़ता है, ताकि रिट्रीवर समझ सके कि व्यापक दस्तावेज़ में प्रत्येक चंक कहाँ फिट बैठता है।
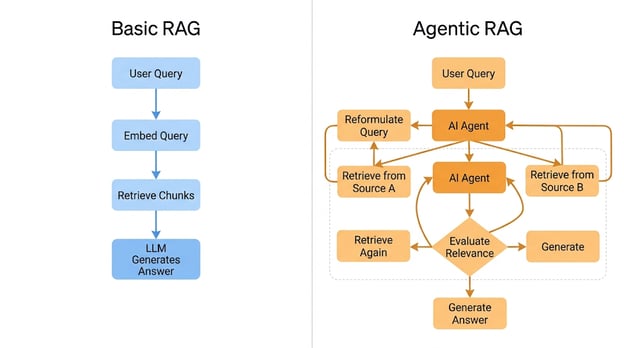
विस्तृत ऑप्टिमाइज़ेशन रणनीतियों के लिए, हमारा गाइड देखें: RAG प्रदर्शन कैसे सुधारें।
RAG बनाम फाइन-ट्यूनिंग
एक आम सवाल है कि LLM को कस्टमाइज़ करने के लिए RAG का उपयोग करें या फाइन-ट्यूनिंग का। संक्षिप्त उत्तर: ये अलग समस्याएँ सुलझाते हैं, और कई प्रोडक्शन सिस्टम दोनों का उपयोग करते हैं। विस्तृत तुलना के लिए हमारा गाइड देखें: RAG बनाम फाइन-ट्यूनिंग।
| मानदंड | RAG | फाइन-ट्यूनिंग |
|---|---|---|
| ज्ञान अपडेट | दस्तावेज़ बदलें, पुनः-प्रशिक्षण की आवश्यकता नहीं | नए डेटा पर पुनः-प्रशिक्षण आवश्यक |
| लागत | कम (GPU प्रशिक्षण की ज़रूरत नहीं) | ज़्यादा (GPU घंटे + डेटा तैयारी) |
| Hallucination नियंत्रण | मजबूत (जवाब प्राप्त दस्तावेज़ों में आधारित) | मध्यम (प्रशिक्षण डेटा पर निर्भर) |
| डोमेन अनुकूलन | तथ्यात्मक रिकॉल के लिए अच्छा | स्टाइल, टोन, और तर्क-पैटर्न के लिए बेहतर |
| लेटेंसी | अधिक (रिट्रीवल स्टेप समय जोड़ता है) | कम (रिट्रीवल ओवरहेड नहीं) |
| सर्वश्रेष्ठ उपयोग | डायनेमिक ज्ञान, FAQ बॉट्स, दस्तावेज़ Q&A | विशेषीकृत कार्य, सुसंगत आउटपुट फ़ॉर्मेट |
अंतिम विचार
RAG बाहरी ज्ञान में LLM आउटपुट को आधारित करने की सबसे व्यापक रूप से अपनाई गई तकनीक बनी हुई है। यह भाषा मॉडल्स की मुख्य सीमाओं—बासी प्रशिक्षण डेटा, hallucinations, और डोमेन-विशिष्टता की कमी—को फाइन-ट्यूनिंग की लागत और जटिलता के बिना सीधे संबोधित करता है।
यह कहा जाए तो, RAG उतना ही अच्छा है जितना अच्छा डेटा आप इसे देते हैं। निम्न-गुणवत्ता या पुरानी स्रोत सामग्री खराब उत्तर देगी, चाहे LLM कितना भी सक्षम क्यों न हो। विशेष रूप से उच्च-जोखिम अनुप्रयोगों में मानव निगरानी आवश्यक बनी रहती है।
अच्छी डेटा क्यूरेशन, डोमेन विशेषज्ञता के साथ मिलकर, एक उपयोगी RAG सिस्टम को उस सिस्टम से अलग करती है जो आत्मविश्वास से गलत उत्तर लौटाता है।
RAG पर हाथ आज़माने के लिए, मैं हमारे RAG with LangChain कोर्स की अनुशंसा करता हूँ, जो शून्य से एक संपूर्ण रिट्रीवल पाइपलाइन बनाना सिखाता है। LLM की बुनियाद में गहराई से जाने के लिए, LLMs Concepts कोर्स देखें।
Retrieval Augmented Generation (RAG) FAQs
Retrieval Augmented Generation (RAG) क्या है?
RAG एक तकनीक है जो प्री-ट्रेन्ड बड़े भाषा मॉडल्स (LLMs) की क्षमताओं को बाहरी डेटा स्रोतों के साथ जोड़ती है, जिससे अधिक सूक्ष्म और सटीक AI उत्तर मिलते हैं।
LLMs की कार्यक्षमता सुधारने में RAG क्यों महत्वपूर्ण है?
RAG LLMs की प्रमुख सीमाएँ जैसे सामान्यीकृत उत्तर देना, गलत जवाब (hallucinations) जनरेट करना, और विशिष्ट जानकारी की कमी को संबोधित करता है। LLMs को विशिष्ट बाहरी डेटा से जोड़कर, RAG अधिक सटीक, विश्वसनीय, और संदर्भ-विशिष्ट उत्तर देता है।
RAG कैसे काम करता है? इसके कार्यान्वयन में कौन-से चरण होते हैं?
RAG में कई चरण शामिल हैं: डेटा संग्रह, डेटा चंकिंग, डॉक्यूमेंट एम्बेडिंग्स, उपयोगकर्ता क्वेरियों को हैंडल करना, और LLM का उपयोग कर उत्तर जनरेट करना। यह प्रक्रिया सुनिश्चित करती है कि सिस्टम उपयोगकर्ता क्वेरियों को बाहरी डेटा स्रोतों से प्रासंगिक जानकारी से सटीकता से मिलाए।
RAG सिस्टम लागू करने में कौन-सी चुनौतियाँ आती हैं और उन्हें कैसे सुलझाया जा सकता है?
चुनौतियों में इंटीग्रेशन की जटिलता, स्केलेबिलिटी, और डेटा गुणवत्ता शामिल हैं। समाधान के रूप में अलग-अलग डेटा स्रोतों के लिए अलग मॉड्यूल बनाना, मज़बूत इंफ्रास्ट्रक्चर में निवेश करना, और मेहनती कंटेंट क्यूरेशन व फाइन-ट्यूनिंग सुनिश्चित करना शामिल है।
क्या RAG अलग-अलग प्रकार के भाषा मॉडल्स के साथ इंटीग्रेट किया जा सकता है?
हाँ, RAG अलग-अलग भाषा मॉडल्स के साथ काम कर सकता है, बशर्ते वे परिष्कृत भाषा समझ और जेनरेशन में सक्षम हों। प्रभावशीलता मॉडल की विशिष्ट क्षमताओं के साथ बदलती है।
RAG पारंपरिक सर्च इंजन या डेटाबेस से कैसे अलग है?
RAG सर्च इंजनों की रिट्रीवल क्षमता को भाषा मॉडल्स की सूक्ष्म समझ और उत्तर जेनरेशन के साथ जोड़ता है, जिससे केवल दस्तावेज़ लाने के बजाय संदर्भ-सचेत और विस्तृत उत्तर मिलते हैं।
नताशा एक डेटा कंसल्टेंट हैं जो डेटा साइंस और मार्केटिंग के संगम पर काम करती हैं। उनका मानना है कि समझदारी से इस्तेमाल किया गया डेटा व्यक्तियों और संगठनों के लिए असाधारण विकास को प्रेरित कर सकता है। एक स्व-अध्ययनित डेटा प्रोफेशनल के रूप में, नताशा ऐसे लेख लिखना पसंद करती हैं जो अन्य डेटा साइंस अभ्यर्थियों को इस उद्योग में प्रवेश करने में मदद करें। उनके निजी ब्लॉग और बाहरी प्रकाशनों पर प्रकाशित लेख औसतन 200 हजार मासिक दृश्य प्राप्त करते हैं।
Large language models (LLMs) ने उल्लेखनीय प्रगति की है, लेकिन इनकी कुछ सीमाएँ भी हैं: पुराना ज्ञान, hallucinations, और सामान्य-से जवाब। RAG इसे Retrieval Augmented Generation (RAG) के माध्यम से मॉडल के आउटपुट को वास्तविक डेटा में आधारित करके हल करता है।
इस ब्लॉग में, मैं बताऊँगा कि RAG कैसे काम करता है, प्रोडक्शन AI सिस्टम्स में यह क्यों महत्वपूर्ण है, और आज संगठन इसे कैसे अपना रहे हैं।
संक्षेप में
RAG क्या है?
Retrieval Augmented Generation (RAG) LLMs को बाहरी डेटा स्रोतों से जोड़ता है ताकि वे अपने जवाबों को नवीन, डोमेन-विशिष्ट जानकारी में आधारित कर सकें। केवल प्रशिक्षण डेटा पर निर्भर होने के बजाय, एक RAG सिस्टम क्वेरी के समय प्रासंगिक दस्तावेज़ों को प्राप्त करता है और उन्हें उपयोगकर्ता के प्रश्न के साथ मॉडल को देता है, जिससे अधिक सटीक और संदर्भ-संगत उत्तर मिलते हैं।
LLMs शक्तिशाली हैं, लेकिन इनमें कुछ अंतर्निहित सीमाएँ हैं:
RAG इन समस्याओं को संरचित और असंरचित डेटा स्रोतों—जैसे डेटाबेस, डॉक्यूमेंटेशन, और APIs—से नवीन और डोमेन-विशिष्ट जानकारी प्राप्त करने की क्षमता देकर दूर करता है।