
मशीन लर्निंग के विभिन्न प्रकार
अब जब हमने मशीन लर्निंग और इस क्षेत्र के अन्य चर्चित शब्दों के बीच इसके स्थान का एक अवलोकन दे दिया है, तो आइए मशीन लर्निंग एल्गोरिद्म के अलग-अलग प्रकारों पर गहराई से नज़र डालें। मशीन लर्निंग एल्गोरिद्म को व्यापक रूप से सुपरवाइज़्ड, अनसुपरवाइज़्ड, रिइनफोर्समेंट, और सेल्फ-सुपरवाइज़्ड लर्निंग में वर्गीकृत किया जाता है। इन्हें और इनके आम उपयोग-केस को विस्तार से समझते हैं।
सुपरवाइज़्ड मशीन लर्निंग
अधिकांश मशीन लर्निंग उपयोग मामलों में एल्गोरिद्म ऐतिहासिक डेटा से पैटर्न सीखते हैं और उन्हें भविष्यवाणियों के रूप में नए डेटा पर लागू करते हैं। इसे अक्सर सुपरवाइज़्ड लर्निंग कहा जाता है। सुपरवाइज़्ड लर्निंग एल्गोरिद्म को उस समस्या पर ऐतिहासिक इनपुट और आउटपुट दोनों दिखाए जाते हैं जिसे हम सुलझाने की कोशिश कर रहे हैं, जहाँ इनपुट मूलतः उन फीचर्स या डाइमेंशन्स को दर्शाते हैं जिनके आधार पर हम भविष्यवाणी करना चाहते हैं, और आउटपुट वे नतीजे होते हैं जिन्हें हम भविष्यवाणी करना चाहते हैं। इसे हमारे स्पैम डिटेक्शन उदाहरण से समझते हैं।
स्पैम डिटेक्शन उपयोग मामले में, सुपरवाइज़्ड लर्निंग एल्गोरिद्म को स्पैम ईमेल्स के डेटासेट पर प्रशिक्षित किया जाएगा। इनपुट होंगे ईमेल से संबंधित फीचर्स या डाइमेंशन्स, जैसे ईमेल की सब्जेक्ट लाइन, प्रेषक का ईमेल पता, ईमेल की सामग्री, क्या ईमेल में संदिग्ध लिंक हैं, और अन्य प्रासंगिक जानकारी जो यह संकेत दे सके कि ईमेल स्पैम है या नहीं।
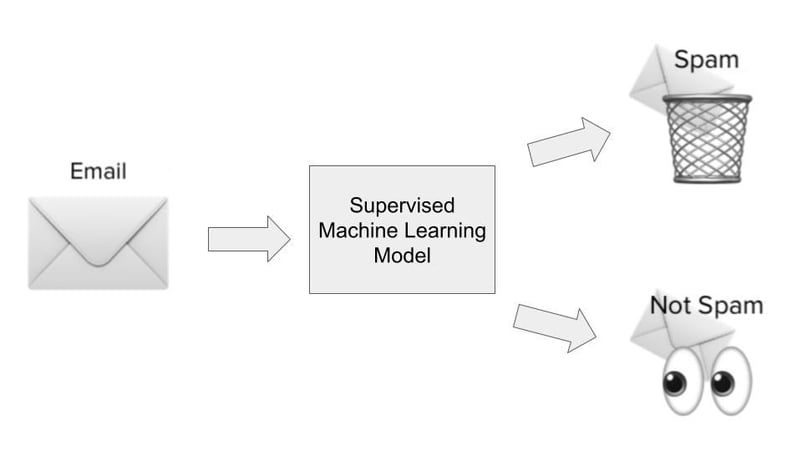
आउटपुट होगा कि वास्तव में वह ईमेल स्पैम था या नहीं। मॉडल लर्निंग चरण के दौरान, एल्गोरिद्म इनपुट वेरिएबल्स के सेट (स्पैम ईमेल के विभिन्न डाइमेंशन्स) और आउटपुट वेरिएबल (स्पैम था या नहीं) के बीच सांख्यिकीय संबंध को मैप करने वाला एक फ़ंक्शन सीखता है। फिर यही फ़ंक्शन पहले न देखे गए डेटा के आउटपुट की भविष्यवाणी करने में काम आता है।
सुपरवाइज़्ड लर्निंग उपयोग मामलों के दो व्यापक प्रकार हैं:
- रिग्रेशन: रिग्रेशन के उपयोग मामले तब होते हैं जब हम किसी सतत परिणाम की भविष्यवाणी करते हैं जो एक सीमा के भीतर आता है। एक अच्छा उदाहरण होगा घर की कीमत की भविष्यवाणी—कारपेट एरिया, लोकेशन, बेडरूम की संख्या और अन्य प्रासंगिक डाइमेंशन्स के आधार पर।
- क्लासिफिकेशन: क्लासिफिकेशन के उपयोग मामले तब होते हैं जब हम यह वर्गीकृत करते हैं कि कोई परिणाम दो या अधिक श्रेणियों में आता है या नहीं। स्पैम डिटेक्टर क्लासिफिकेशन मॉडल हैं (या तो स्पैम या नॉन-स्पैम) — अन्य क्लासिफिकेशन उपयोग मामलों में कस्टमर चर्न प्रिडिक्शन (चर्न करेगा या नहीं), तस्वीरों में कारों की पहचान (एकाधिक श्रेणियाँ), आदि शामिल हैं।
आगामी अनुभाग में, हम विशिष्ट सुपरवाइज़्ड लर्निंग एल्गोरिद्म और उनके कुछ उपयोग मामलों को विस्तार से देखेंगे।
अनसुपरवाइज़्ड मशीन लर्निंग
इनपुट को आउटपुट से मैप करने वाले पैटर्न सीखने के बजाय, अनसुपरवाइज़्ड लर्निंग एल्गोरिद्म बिना आउटपुट दिखाए डेटा में सामान्य पैटर्न खोजते हैं। अनसुपरवाइज़्ड लर्निंग एल्गोरिद्म का उपयोग आम तौर पर विभिन्न वस्तुओं और संस्थाओं को समूहित और क्लस्टर करने के लिए किया जाता है। अनसुपरवाइज़्ड लर्निंग का एक बढ़िया उदाहरण है कस्टमर सेगमेंटेशन। कंपनियों के पास अक्सर कई तरह के कस्टमर पर्सोना होते हैं। संगठन अपने कस्टमर सेगमेंट की पहचान तथ्य-आधारित तरीके से करना चाहते हैं ताकि उन्हें बेहतर सेवा दे सकें। यही पर अनसुपरवाइज़्ड लर्निंग काम आती है।
इस उपयोग मामले में, एक अनसुपरवाइज़्ड लर्निंग एल्गोरिद्म ग्राहकों को विभिन्न गुणों के आधार पर समूहित करना सीखेगा, जैसे उन्होंने किसी उत्पाद का कितनी बार उपयोग किया, उनकी जनसांख्यिकी, वे उत्पादों के साथ कैसे इंटरैक्ट करते हैं, आदि। फिर, वही एल्गोरिद्म उन्हीं डाइमेंशन्स के आधार पर नए ग्राहकों के संभावित सेगमेंट की भविष्यवाणी कर सकता है।
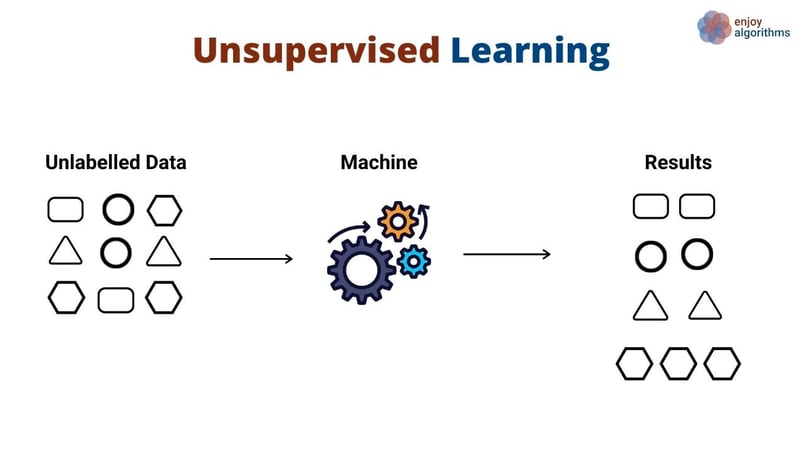
अनसुपरवाइज़्ड एल्गोरिद्म का उपयोग किसी डेटासेट में डाइमेंशन्स (यानी फीचर्स की संख्या) घटाने के लिए भी किया जाता है, जिसे डाइमेंशनलिटी रिडक्शन तकनीकें कहते हैं। इन एल्गोरिद्म का उपयोग अक्सर सुपरवाइज़्ड लर्निंग एल्गोरिद्म को प्रशिक्षित करने के मध्यवर्ती चरण के रूप में किया जाता है।
मशीन लर्निंग एल्गोरिद्म को प्रशिक्षित करते समय डेटा वैज्ञानिकों के सामने अक्सर एक बड़ा ट्रेडऑफ होता है—प्रदर्शन बनाम प्रिडिक्टिव सटीकता। सामान्यतः, किसी समस्या के बारे में अधिक जानकारी होना बेहतर होता है। हालांकि, इससे प्रशिक्षण समय और प्रदर्शन धीमा हो सकता है। डाइमेंशनलिटी रिडक्शन तकनीकें किसी डेटासेट में मौजूद फीचर्स की संख्या को प्रिडिक्टिव वैल्यू से समझौता किए बिना घटाने में मदद करती हैं।
रिइनफोर्समेंट लर्निंग
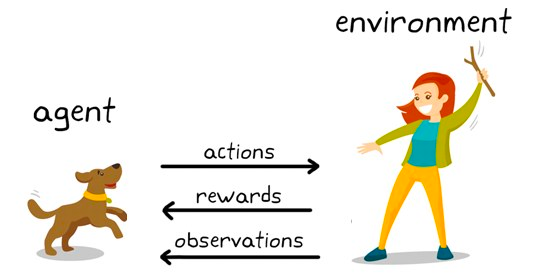
रिइनफोर्समेंट लर्निंग मशीन लर्निंग एल्गोरिद्म का वह उपसमूह है जो इच्छित व्यवहार या भविष्यवाणी को प्रोत्साहित करने के लिए रिवॉर्ड और अन्यथा पेनल्टी का उपयोग करता है। पहले शोध प्रयोगशालाओं तक सीमित, रिइनफोर्समेंट लर्निंग अब प्रोडक्शन सिस्टम्स को शक्ति देता है—Chess और Go में मानवीय स्तर से आगे खेलने वाले एजेंट्स से लेकर रिकमेंडेशन इंजन, रोबोटिक्स, और RLHF (मानव फीडबैक से रिइनफोर्समेंट लर्निंग) जैसे LLM एलाइनमेंट तकनीकों तक।
यह एक व्यवहारिक मॉडलिंग तकनीक है जहाँ मॉडल वातावरण के साथ निरंतर इंटरैक्ट करते हुए ट्रायल-एंड-एरर तंत्र से सीखता है। इसे शतरंज के उदाहरण से समझते हैं। उच्च स्तर पर, रिइनफोर्समेंट लर्निंग एल्गोरिद्म (अक्सर एजेंट कहा जाता है) को एक वातावरण (शतरंज की बिसात) दी जाती है जहाँ वह कई प्रकार के निर्णय (चालें चलना) कर सकता है।
हर चाल के साथ जुड़े कुछ स्कोर होते हैं—जीत की ओर ले जाने वाली क्रियाओं के लिए रिवॉर्ड और हार की ओर ले जाने वाली चालों के लिए पेनल्टी।
एजेंट वातावरण के साथ इंटरैक्ट करता रहता है ताकि वे क्रियाएँ सीखे जो सबसे अधिक रिवॉर्ड दिलाएँ, और उन क्रियाओं को दोहराता रहे। इस प्रोत्साहित व्यवहार की पुनरावृत्ति को एक्सप्लॉइटेशन चरण कहते हैं। जब एजेंट रिवॉर्ड कमाने के नए मार्ग ढूँढता है, तो इसे एक्सप्लोरेशन चरण कहते हैं। व्यापक रूप से, इसे एक्सप्लोरेशन-एक्सप्लॉइटेशन पैराडाइम कहा जाता है।
सेल्फ-सुपरवाइज़्ड मशीन लर्निंग
सेल्फ-सुपरवाइज़्ड लर्निंग एक डेटा-कुशल मशीन लर्निंग तकनीक है जिसमें मॉडल बिना लेबल वाले सैंपल डेटासेट से सीखता है। नीचे दिए उदाहरण में, पहले मॉडल को कुछ बिना लेबल वाली इनपुट इमेजेस दी जाती हैं, जिन्हें वह इन्हीं इमेजेस से जनरेट किए फीचर्स का उपयोग कर क्लस्टर करता है।
इन उदाहरणों में से कुछ के किसी क्लस्टर से संबंधित होने का विश्वास स्तर अधिक होगा जबकि अन्य का कम। दूसरे चरण में पहले चरण से उच्च-विश्वास वाले लेबल डेटा का उपयोग एक क्लासिफायर को प्रशिक्षित करने के लिए किया जाता है, जो एक-चरणीय क्लस्टरिंग अप्रोच से अधिक शक्तिशाली होता है।
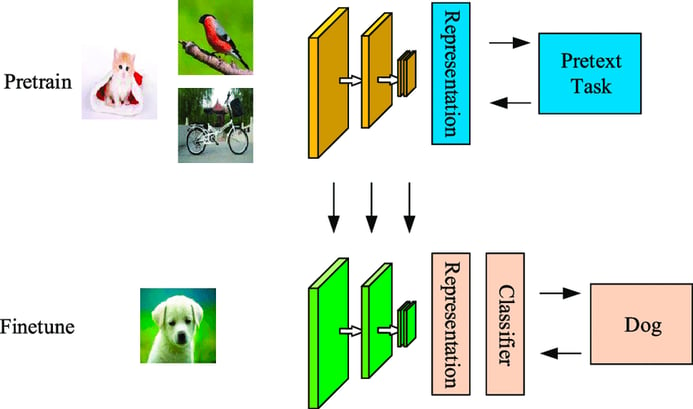
सेल्फ-सुपरवाइज़्ड और सुपरवाइज़्ड एल्गोरिद्म के बीच फर्क यह है कि पहले वाले में वर्गीकृत आउटपुट वास्तविक वस्तुओं से मैप नहीं होता। यह सुपरवाइज़्ड लर्निंग से इसलिए भिन्न है क्योंकि यह मैनुअली लेबल्ड सेट पर निर्भर नहीं करता और स्वयं लेबल जनरेट करता है, hence the name self-learning.
सेल्फ-सुपरवाइज़्ड लर्निंग आधुनिक बड़े भाषा मॉडलों (LLMs) की नींव भी है। GPT और Llama जैसे मॉडल विशाल बिना लेबल वाले पाठ पर प्री-ट्रेन होते हैं—मास्क्ड टोकन या अगले शब्द की भविष्यवाणी करके—यह सेल्फ-सुपरवाइज़्ड ऑब्जेक्टिव समृद्ध भाषा निरूपण सिखाता है, जिसके बाद लेबल्ड टास्क पर फाइन-ट्यूनिंग की जाती है।
सबसे लोकप्रिय मशीन लर्निंग एल्गोरिद्म का विवरण
नीचे हमने शीर्ष मशीन लर्निंग एल्गोरिद्म और उनके आम उपयोग मामलों का संक्षेप दिया है।
शीर्ष सुपरवाइज़्ड मशीन लर्निंग एल्गोरिद्म
1. लिनियर रिग्रेशन
एक सरल एल्गोरिद्म जो एक या अधिक व्याख्यात्मक वेरिएबल्स और एक सतत संख्यात्मक आउटपुट वेरिएबल के बीच रैखिक संबंध मॉडल करता है। अन्य मशीन लर्निंग एल्गोरिद्म की तुलना में इसे ट्रेन करना तेज़ है। इसका सबसे बड़ा लाभ यह है कि यह मॉडल की भविष्यवाणियों को समझाने और व्याख्या करने में सक्षम है। यह एक रिग्रेशन एल्गोरिद्म है जिसका उपयोग ग्राहक लाइफसायकल वैल्यू, हाउसिंग प्राइस, और स्टॉक प्राइस जैसी भविष्यवाणियों के लिए किया जाता है।
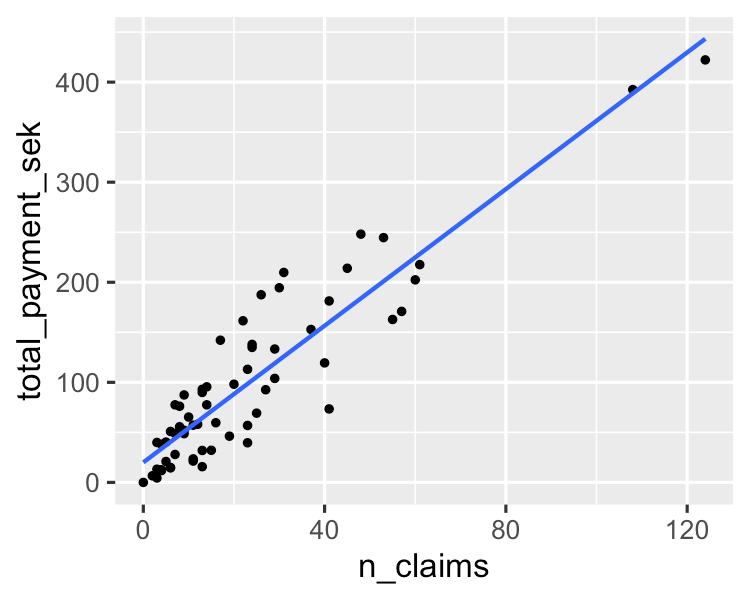
आप इसके बारे में और जान सकते हैं इस Python में लिनियर रिग्रेशन के आवश्यक तत्व ट्यूटोरियल में। यदि आप रिग्रेशन विश्लेषण को हैंड्स-ऑन सीखना चाहते हैं, तो DataCamp का यह बहुत लोकप्रिय कोर्स आपके लिए सही संसाधन है।
2. डिसीजन ट्री
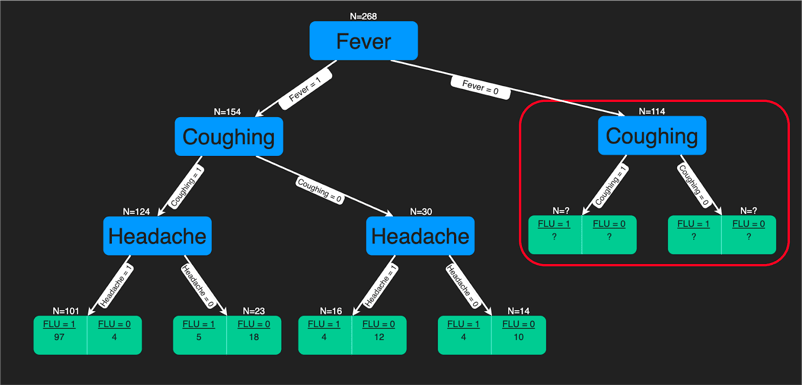
डिसीजन ट्री एल्गोरिद्म एक पेड़ जैसी संरचना है जिसमें इनपुट फीचर्स पर निर्णय नियम लागू कर संभावित परिणामों की भविष्यवाणी की जाती है। इसका उपयोग क्लासिफिकेशन या रिग्रेशन दोनों के लिए किया जा सकता है। डिसीजन ट्री की भविष्यवाणियाँ स्वास्थ्य-देखभाल विशेषज्ञों के लिए सहायक होती हैं क्योंकि यह समझना सीधा होता है कि वे भविष्यवाणियाँ कैसे की गईं।
यदि आप सीखना चाहते हैं कि Python का उपयोग कर डिसीजन ट्री क्लासिफायर कैसे बनाया जाए, तो इस ट्यूटोरियल को देखें। यदि आप R का उपयोग अधिक सहजता से करते हैं, तो यह ट्यूटोरियल उपयोगी होगा। DataCamp पर एक व्यापक डिसीजन ट्री कोर्स भी उपलब्ध है।
3. रैंडम फॉरेस्ट
यह संभवतः सबसे लोकप्रिय एल्गोरिद्म में से एक है और डिसीजन ट्री मॉडलों में प्रमुखता से दिखने वाली ओवरफिटिंग की कमी को दूर करता है। ओवरफिटिंग तब होती है जब एल्गोरिद्म ट्रेनिंग डेटा पर बहुत अधिक फिट हो जाता है और नए डेटा पर ठीक से सामान्यीकरण या सटीक भविष्यवाणी करने में विफल रहता है। रैंडम फॉरेस्ट डेटा से रैंडमली चुने गए सैंपल पर कई डिसीजन ट्री बनाकर ओवरफिटिंग की समस्या का समाधान करता है। अंतिम परिणाम यानी सर्वश्रेष्ठ भविष्यवाणी, फॉरेस्ट के सभी पेड़ों के बहुमत वोट से प्राप्त होती है।
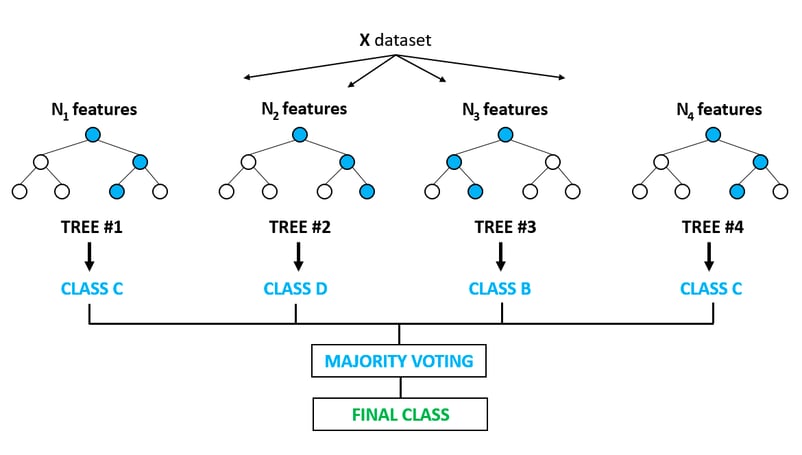
इसका उपयोग क्लासिफिकेशन और रिग्रेशन दोनों समस्याओं में किया जाता है। यह फीचर सेलेक्शन, रोग पहचान आदि में उपयोगी है। आप ट्री-आधारित मॉडल और एन्सेम्बल्स (विभिन्न व्यक्तिगत मॉडलों का संयोजन) के बारे में DataCamp के इस लोकप्रिय कोर्स से अधिक सीख सकते हैं। आप Python-आधारित इस ट्यूटोरियल में रैंडम फॉरेस्ट मॉडल का इम्प्लीमेंटेशन भी सीख सकते हैं।
4. सपोर्ट वेक्टर मशीन
सपोर्ट वेक्टर मशीन, जिसे आमतौर पर SVM कहा जाता है, का उपयोग सामान्यतः क्लासिफिकेशन समस्याओं के लिए किया जाता है। नीचे दिए उदाहरण में दिखाया गया है कि SVM एक हाइपरप्लेन (यहाँ एक रेखा) ढूँढता है, जो दो वर्गों (लाल और हरा) को अलग करता है और उनके बीच के मार्जिन (डॉटेड लाइनों के बीच की दूरी) को अधिकतम करता है।
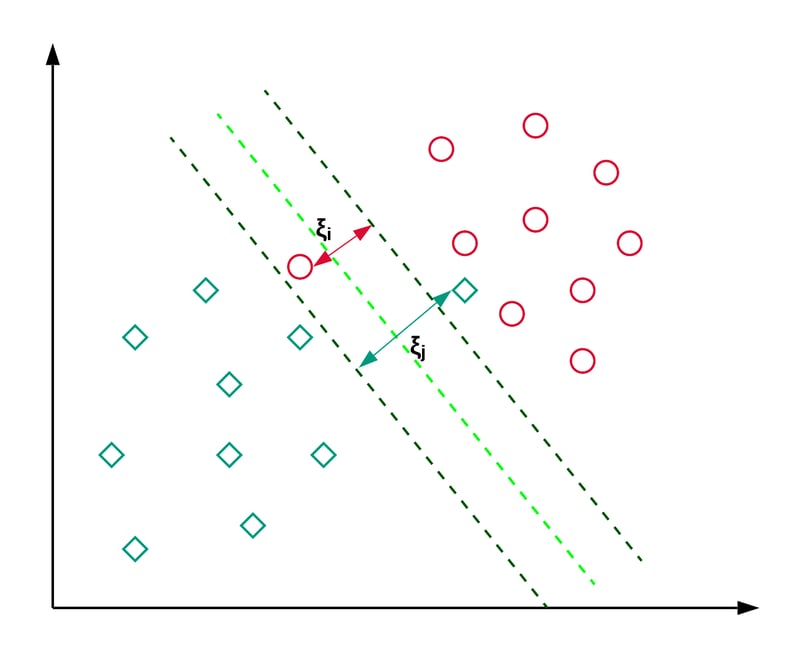
SVM सामान्यतः क्लासिफिकेशन में उपयोग होता है, लेकिन रिग्रेशन समस्याओं में भी काम लिया जा सकता है। इसका उपयोग समाचार लेखों को वर्गीकृत करने और हस्तलेखन पहचान में होता है। आप विभिन्न प्रकार के कर्नेल ट्रिक्स और Python इम्प्लीमेंटेशन के बारे में इस scikit-learn SVM ट्यूटोरियल में पढ़ सकते हैं। आप इस ट्यूटोरियल का भी अनुसरण कर सकते हैं, जिसमें आप R में SVM इम्प्लीमेंटेशन को दोहराएँगे
5. ग्रेडिएंट बूस्टिंग और XGBoost
ग्रेडिएंट बूस्टिंग रिग्रेशन एक एन्सेम्बल मॉडल है जो कई कमजोर लर्नर्स को मिलाकर एक सशक्त प्रिडिक्टिव मॉडल बनाता है। यह डेटा में नॉन-लिनियरिटी और मल्टीकोलिनियरिटी समस्याओं को संभालने में अच्छा है।
हालाँकि मूल विचार ग्रेडिएंट बूस्टिंग है, व्यवहार में आधुनिक इम्प्लीमेंटेशन ने बड़े पैमाने पर जेनेरिक रिग्रेसर को पीछे छोड़ दिया है:</i
- XGBoost: स्ट्रक्चर्ड/टेबुलर डेटा पर गति और परफॉर्मेंस के लिए अनुकूलित; Kaggle प्रतियोगिताओं और एंटरप्राइज ML पाइपलाइनों में व्यापक रूप से उपयोग।
- LightGBM: Microsoft का लीफ-वाइज़ बूस्टिंग वेरिएंट; बड़े डेटासेट पर तेज़ ट्रेनिंग समय के साथ उत्कृष्ट।
- CatBoost: श्रेणीकृत फीचर्स को नैटिव रूप से संभालता है; ई-कॉमर्स और ऐड-टेक में क्लिक-थ्रू रेट प्रिडिक्शन के लिए लोकप्रिय।
ये एल्गोरिद्म 2026 में टेबुलर प्रिडिक्शन टास्क के शीर्ष प्रदर्शनकर्ताओं में लगातार गिने जाते हैं। हमारी ग्रेडिएंट बूस्टिंग गाइड में मूल बातें सीखें और Python में XGBoost के साथ हैंड्स-ऑन हों।
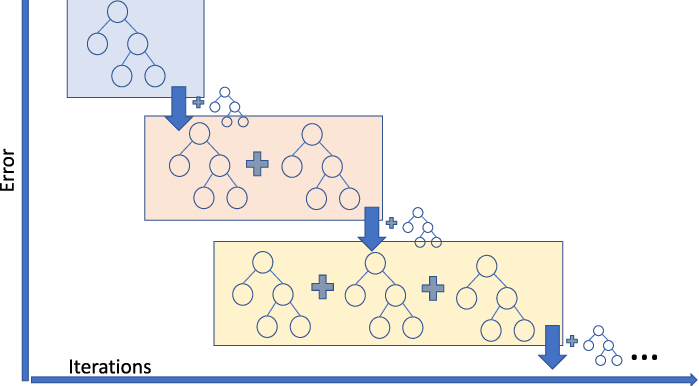
यदि आप राइड शेयरिंग व्यवसाय में हैं और आपको राइड किराये की राशि का पूर्वानुमान लगाना है, तो आप ग्रेडिएंट बूस्टिंग रिग्रेसर का उपयोग कर सकते हैं। यदि आप ग्रेडिएंट बूस्टिंग के विभिन्न फ्लेवर्स को समझना चाहते हैं, तो DataCamp पर यह वीडियो देखें।
शीर्ष अनसुपरवाइज़्ड मशीन लर्निंग एल्गोरिद्म
6. K-means क्लस्टरिंग
K-Means सबसे व्यापक रूप से उपयोग की जाने वाली क्लस्टरिंग पद्धति है—यह यूलिडियन दूरी के आधार पर K क्लस्टर निर्धारित करती है। यह कस्टमर सेगमेंटेशन और रिकमेंडेशन सिस्टम्स के लिए बहुत लोकप्रिय एल्गोरिद्म है।
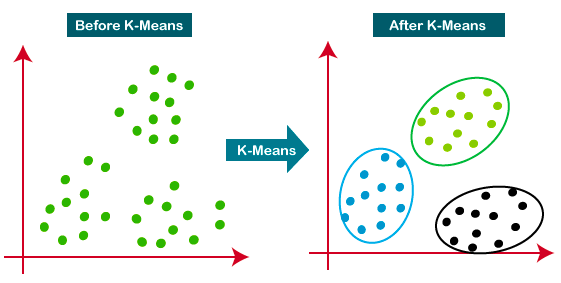
K-means क्लस्टरिंग के बारे में और जानने के लिए यह ट्यूटोरियल एक उत्तम संसाधन है।
7. प्रिंसिपल कंपोनेंट एनालिसिस
प्रिंसिपल कंपोनेंट एनालिसिस (PCA) एक सांख्यिकीय प्रक्रिया है जिसका उपयोग बड़े डेटासेट की जानकारी को एक निम्न-आयामी सबस्पेस पर प्रोजेक्ट करके संक्षेपित करने के लिए किया जाता है। इसे डाइमेंशनलिटी रिडक्शन तकनीक भी कहा जाता है, जो उच्च सूचना वाली डेटा की आवश्यक हिस्सों को बनाए रखते हुए सरलीकरण सुनिश्चित करती है।
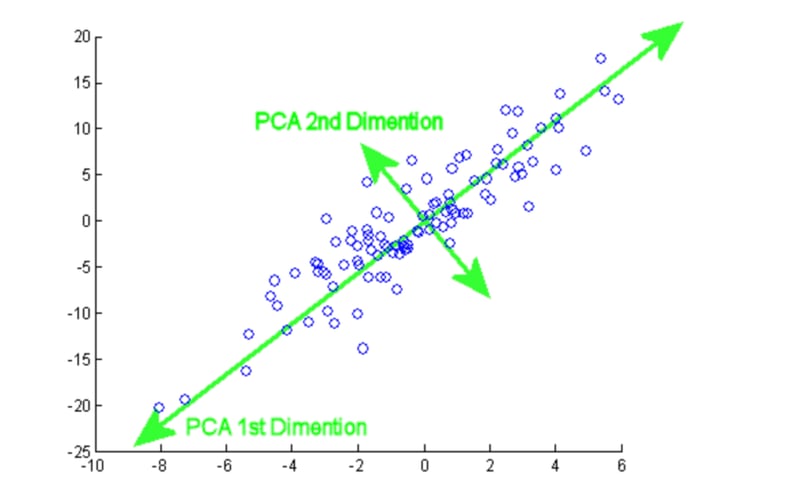
इस ट्यूटोरियल से आप दो लोकप्रिय डेटासेट—Breast Cancer और CIFAR-10—पर हैंड्स-ऑन PCA इम्प्लीमेंटेशन का अभ्यास कर सकते हैं।
8. हाइरार्किकल क्लस्टरिंग
यह एक बॉटम-अप अप्रोच है जहाँ हर डेटा पॉइंट को अपने आप में एक क्लस्टर माना जाता है, और फिर सबसे नज़दीकी दो क्लस्टर क्रमिक रूप से मर्ज किए जाते हैं। K-means क्लस्टरिंग पर इसका सबसे बड़ा लाभ यह है कि शुरुआत में उपयोगकर्ता को अपेक्षित क्लस्टर्स की संख्या बताने की आवश्यकता नहीं होती। इसका उपयोग समानता के आधार पर डॉक्यूमेंट क्लस्टरिंग में होता है।
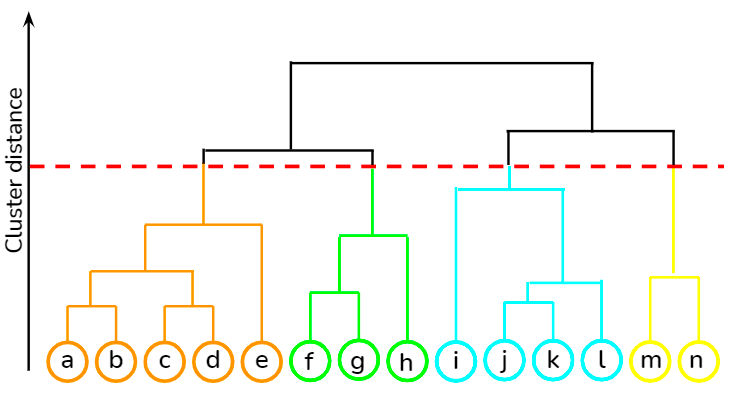
आप scipy लाइब्रेरी का उपयोग कर हाइरार्किकल क्लस्टरिंग और K-means क्लस्टरिंग जैसी विभिन्न अनसुपरवाइज़्ड लर्निंग तकनीकें DataCamp के इस कोर्स से सीख सकते हैं। इसके अलावा, आप इस कोर्स से R का उपयोग कर अनलेबल्ड डेटा से इनसाइट्स जनरेट करने हेतु क्लस्टरिंग तकनीकों को लागू करना भी सीख सकते हैं।
9. गॉसियन मिक्सचर मॉडल
यह किसी डेटासेट के भीतर सामान्य वितरण वाले क्लस्टर्स को मॉडल करने के लिए एक प्रायिकता-आधारित मॉडल है। यह मानक क्लस्टरिंग एल्गोरिद्म से अलग है क्योंकि यह किसी ऑब्ज़र्वेशन के किसी विशेष क्लस्टर से संबंधित होने की प्रायिकता का अनुमान लगाता है और फिर उसकी सब-पॉपुलेशन के बारे में निष्कर्ष निकालता है।
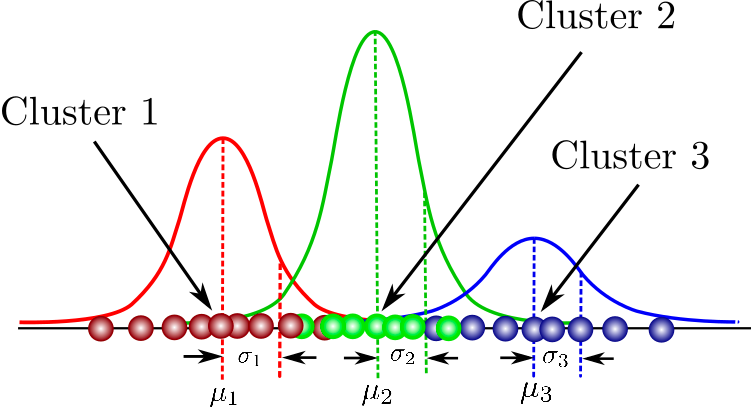
आप यहाँ कोर्सों का एक समेकित संग्रह पाएँगे, जो मॉडल-आधारित क्लस्टरिंग की बुनियादी अवधारणाओं, मिक्सचर मॉडल की संरचना, और उससे आगे को कवर करता है। आप flexmix पैकेज का उपयोग कर गॉसियन मिक्सचर मॉडलिंग का हैंड्स-ऑन अभ्यास भी करेंगे।
10. Apriori एल्गोरिद्म
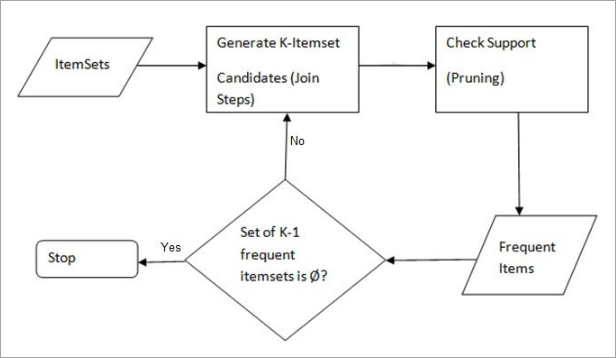
एक नियम-आधारित अप्रोच जो दिए गए डेटासेट में सबसे बार-बार आने वाले आइटमसेट की पहचान करता है, जहाँ आइटमसेट के गुणों के पूर्वज्ञान का उपयोग होता है। मार्केट बास्केट एनालिसिस इस एल्गोरिद्म का उपयोग करती है ताकि Amazon और Netflix जैसे दिग्गज अपने उपयोगकर्ताओं के बारे में ढेर सारी जानकारी को उत्पाद सिफारिशों के सरल नियमों में बदल सकें। यह लाखों उत्पादों के बीच संघों का विश्लेषण करता है और अंतर्दृष्टिपूर्ण नियमों का पता लगाता है।
DataCamp Python और R—दोनों भाषाओं में एक व्यापक कोर्स प्रदान करता है।
2026 में क्लासिक मशीन लर्निंग बनाम जनरेटिव AI
जनरेटिव AI और LLMs सुर्खियाँ बटोरते हैं, लेकिन इस लेख के एल्गोरिद्म अब भी अनिवार्य हैं। वे इस तरह साथ फिट होते हैं:
| उपयोग मामला | सर्वोत्तम-उपयुक्त एल्गोरिद्म | उदाहरण |
| टेबुलर प्रिडिक्शन (फ्रॉड, चर्न, प्राइसिंग) | XGBoost, रैंडम फॉरेस्ट, लॉजिस्टिक रिग्रेशन | क्रेडिट स्कोरिंग, कस्टमर चर्न |
| कस्टमर सेगमेंटेशन और क्लस्टरिंग | K-means, हाइरार्किकल क्लस्टरिंग, GMM | मार्केटिंग पर्सोना, उत्पाद सिफारिशें |
| टेक्स्ट, इमेज, और स्पीच जेनरेशन | डीप लर्निंग, ट्रांसफॉर्मर्स, सेल्फ-सुपरवाइज़्ड प्री-ट्रेनिंग | ChatGPT, इमेज जेनरेटर, स्पीच सिंथेसिस |
| सीक्वेंशियल निर्णय-निर्धारण | रिइनफोर्समेंट लर्निंग (Q-learning, PPO, RLHF) | रोबोटिक्स, गेम AI, LLM फाइन-ट्यूनिंग |
अधिकांश डेटा टीमें दोनों स्टैक्स का उपयोग करती हैं: स्ट्रक्चर्ड बिज़नेस डेटा के लिए ग्रेडिएंट बूस्टिंग और रैंडम फॉरेस्ट, और अनस्ट्रक्चर्ड कंटेंट के लिए डीप लर्निंग। गहन तुलना के लिए हमारा डीप लर्निंग बनाम मशीन लर्निंग गाइड पढ़ें।
मशीन लर्निंग कैसे सीखें
मशीन लर्निंग अब केवल एक चर्चित शब्द नहीं है। कई संगठन मशीन लर्निंग मॉडल तैनात कर रहे हैं और प्रिडिक्टिव इनसाइट्स से लाभ उठा रहे हैं। कहने की आवश्यकता नहीं कि बाज़ार में उच्च-कुशल मशीन लर्निंग प्रैक्टिशनर्स की बहुत मांग है। नीचे, आपको मशीन लर्निंग में अपस्किल करने के लिए संसाधनों की सूची मिलेगी:
- 2026 में पढ़ने के लिए 15 सर्वश्रेष्ठ मशीन लर्निंग पुस्तकें
- 2026 में पढ़ने के लिए शीर्ष 12 डीप लर्निंग पुस्तकें
- AI और मशीन लर्निंग में क्या अंतर है?
- मशीन लर्निंग क्या है?
- Python कैसे सीखें
- AI कैसे सीखें
- Lasso और Ridge Regression ट्यूटोरियल
- मशीन लर्निंग पाइपलाइनों की डिप्लॉयमेंट ट्यूटोरियल
- मशीन लर्निंग चीट शीट
- 2026 में मशीन लर्निंग कैसे सीखें
- सभी स्तरों के लिए 33 मशीन लर्निंग प्रोजेक्ट
FAQs
मशीन लर्निंग क्या है?
मशीन लर्निंग आर्टिफिशियल इंटेलिजेंस का उप-क्षेत्र है जहाँ कंप्यूटर, बिना स्पष्ट रूप से प्रोग्राम किए, डेटा से सीखे गए पैटर्न के आधार पर भविष्यवाणियाँ करते हैं।
सबसे अधिक प्रयुक्त मशीन लर्निंग एल्गोरिद्म कौन-सा है?
सबसे अधिक उपयोग किया जाने वाला मशीन लर्निंग एल्गोरिद्म उपयोग और डेटा की विशिष्टताओं पर निर्भर करता है, लेकिन लिनियर रिग्रेशन, डिसीजन ट्री, और लॉजिस्टिक रिग्रेशन अपनी सादगी, व्याख्यात्मकता और विविध समस्याओं में दक्षता के कारण सबसे अधिक प्रयुक्त हैं।
मुझे कैसे पता चले कि किस मशीन लर्निंग एल्गोरिद्म का उपयोग करूँ?
सही मशीन लर्निंग एल्गोरिद्म का चुनाव समस्या के प्रकार (क्लासिफिकेशन, रिग्रेशन, क्लस्टरिंग, आदि), डेटा के आकार, गुणवत्ता और फीचर प्रकारों पर निर्भर करता है। संख्यात्मक भविष्यवाणियों के लिए लिनियर रिग्रेशन या बाइनरी क्लासिफिकेशन के लिए लॉजिस्टिक रिग्रेशन जैसे सरल मॉडलों से शुरुआत करें। जटिल पैटर्न के लिए न्यूरल नेटवर्क पर विचार करें। रैंडम फॉरेस्ट जैसे एन्सेम्बल तरीकों से प्रिडिक्शन सटीकता बेहतर हो सकती है। अपने विशेष कार्य के लिए सर्वश्रेष्ठ एल्गोरिद्म खोजने में प्रयोग और क्रॉस-वैलिडेशन कुंजी हैं।
सुपरवाइज़्ड मशीन लर्निंग एल्गोरिद्म क्या हैं?
सुपरवाइज़्ड लर्निंग एल्गोरिद्म लेबल्ड डेटा से सीखते हैं, ऐतिहासिक डेटा के आधार पर भविष्यवाणियाँ करते हैं और उन्हें नए डेटा पर लागू करते हैं।
अनसुपरवाइज़्ड मशीन लर्निंग एल्गोरिद्म क्या हैं?
अनसुपरवाइज़्ड लर्निंग एल्गोरिद्म बिना लेबल वाले उदाहरणों के डेटा में पैटर्न या समूह ढूँढते हैं।
रिइनफोर्समेंट लर्निंग क्या है?
रिइनफोर्समेंट लर्निंग मशीन लर्निंग का वह प्रकार है जहाँ एल्गोरिद्म रिवॉर्ड और पेनल्टी पाकर निर्णय लेना सीखते हैं।
सेल्फ-सुपरवाइज़्ड लर्निंग क्या है?
सेल्फ-सुपरवाइज़्ड लर्निंग वह पद्धति है जिसमें मॉडल बिना लेबल वाले डेटा से सीखते हुए, सीखने की प्रक्रिया में स्वयं ही सुपरविजन बनाता है।
लिनियर रिग्रेशन का उपयोग किस लिए होता है?
लिनियर रिग्रेशन का उपयोग आश्रित वेरिएबल और एक या अधिक स्वतंत्र वेरिएबल्स के बीच संबंध को मॉडल करने में होता है; यह बिक्री या हाउसिंग प्राइस जैसे परिणामों की भविष्यवाणी में उपयोगी है।
डिसीजन ट्री कैसे काम करता है?
डिसीजन ट्री डेटा के फीचर्स के आधार पर निर्णय लेते हैं, डेटा को शाखाओं में बाँटते हुए परिणाम की भविष्यवाणी करते हैं।
रैंडम फॉरेस्ट क्या है?
रैंडम फॉरेस्ट क्लासिफिकेशन और रिग्रेशन के लिए एक एन्सेम्बल लर्निंग विधि है जो कई डिसीजन ट्री बनाकर कार्य करती है
K-means क्लस्टरिंग एल्गोरिद्म क्या है?
K-means एक अनसुपरवाइज़्ड लर्निंग एल्गोरिद्म है जिसका उपयोग समानता के आधार पर डेटा को समूहों में क्लस्टर करने के लिए किया जाता है।
न्यूरल नेटवर्क का उपयोग किस लिए होता है?
न्यूरल नेटवर्क जटिल पैटर्न की पहचान और क्लासिफिकेशन वाले कार्यों, जैसे इमेज और स्पीच रिकग्निशन, के लिए मानव मस्तिष्क की नकल करते हुए उपयोग किए जाते हैं।
प्रिंसिपल कंपोनेंट एनालिसिस (PCA) का उपयोग किस लिए होता है?
PCA का उपयोग डेटा की डाइमेंशनलिटी घटाने के लिए किया जाता है, ताकि अधिकांश वैरिएशन को बनाए रखते हुए विश्लेषण सरल हो सके।
मशीन लर्निंग को डेटा साइंस और आर्टिफिशियल इंटेलिजेंस के सबसे प्रमुख और दिखाई देने वाले उपयोग मामलों के लिए ज़िम्मेदार माना जाता है। Tesla की सेल्फ-ड्राइविंग कारों से लेकर DeepMind के AlphaFold एल्गोरिद्म तक, मशीन लर्निंग आधारित समाधानों ने चमत्कारिक नतीजे दिए हैं और काफी चर्चा बटोरी है। 2026 में, ग्रेडिएंट बूस्टिंग और रैंडम फॉरेस्ट जैसे पारंपरिक एल्गोरिद्म अब भी वित्त और मार्केटिंग में अधिकांश टेबुलर प्रिडिक्शन को शक्ति देते हैं, जबकि सेल्फ-सुपरवाइज़्ड डीप लर्निंग बड़े भाषा मॉडल और जनरेटिव AI की रीढ़ है। लेकिन मशीन लर्निंग है क्या? यह काम कैसे करती है? और सबसे अहम, क्या यह वाकई उतनी ही प्रभावशाली है जितनी चर्चा है? यह लेख प्रमुख मशीन लर्निंग एल्गोरिद्म की सहज समझ, उनके आम उपयोग-केस, और मशीन लर्निंग के साथ शुरुआत करने के संसाधन प्रस्तुत करता है।
संक्षेप में
मशीन लर्निंग क्या है?
संक्षेप में, मशीन लर्निंग आर्टिफिशियल इंटेलिजेंस का वह उप-क्षेत्र है जिसमें कंप्यूटर डेटा से सीधे पैटर्न सीखकर, बिना स्पष्ट रूप से प्रोग्राम किए गए, भविष्यवाणियाँ करते हैं। आप देखेंगे कि इस परिभाषा में मशीन लर्निंग, आर्टिफिशियल इंटेलिजेंस का उप-क्षेत्र है। इसलिए, आइए परिभाषाओं को थोड़ा विस्तार से समझें, क्योंकि अक्सर मशीन लर्निंग, आर्टिफिशियल इंटेलिजेंस, डीप लर्निंग, और यहाँ तक कि डेटा साइंस जैसे शब्द एक-दूसरे के स्थान पर इस्तेमाल किए जाते हैं।
आर्टिफिशियल इंटेलिजेंस
आर्टिफिशियल इंटेलिजेंस की बेहतरीन परिभाषाओं में से एक Andrew Ng, Google Brain के सह-संस्थापक और Baidu के पूर्व चीफ साइंटिस्ट, से आती है। Andrew के अनुसार, आर्टिफिशियल इंटेलिजेंस “कंप्यूटरों को बुद्धिमत्तापूर्वक व्यवहार करने के लिए उपकरणों का बहुत बड़ा सेट” है। इसमें स्पष्ट रूप से परिभाषित सिस्टम जैसे कैलकुलेटर से लेकर मशीन लर्निंग आधारित समाधान जैसे स्पैम ईमेल डिटेक्टर शामिल हो सकते हैं।
मशीन लर्निंग
जैसा कि ऊपर वर्णित है, मशीन लर्निंग आर्टिफिशियल इंटेलिजेंस का उप-क्षेत्र है जिसमें एल्गोरिद्म ऐतिहासिक डेटा से पैटर्न सीखते हैं और उन पैटर्नों को नए डेटा पर लागू कर भविष्यवाणियाँ देते हैं। पारंपरिक रूप से, कैलकुलेटर जैसे सरल, बुद्धिमान सिस्टम डेवलपरों द्वारा स्पष्ट चरणों और प्रक्रियाओं के रूप में प्रोग्राम किए जाते हैं (जैसे, यदि यह, तो वह)। हालाँकि, उन्नत समस्याओं के लिए यह न स्केलेबल है न संभव।
ईमेल स्पैम फिल्टर का उदाहरण लें। डेवलपर स्पैम फिल्टर को स्पष्ट रूप से परिभाषित करने की कोशिश कर सकते हैं। उदाहरण के लिए, वे ऐसा प्रोग्राम बना सकते हैं जो किसी खास सब्जेक्ट लाइन या कुछ खास लिंक्स वाले ईमेल पर स्पैम फ़िल्टर ट्रिगर करे। लेकिन जैसे ही स्पैमर अपनी तरकीबें बदलेंगे, यह सिस्टम अप्रभावी हो जाएगा।
दूसरी ओर, मशीन लर्निंग आधारित समाधान लाखों स्पैम ईमेल को इनपुट डेटा के रूप में लेकर, सांख्यिकीय सहसंबंध के माध्यम से स्पैम ईमेल की सबसे आम विशेषताएँ सीखता है और इन सीखे गए गुणों के आधार पर भविष्य के ईमेल पर भविष्यवाणी करता है।
डीप लर्निंग
डीप लर्निंग मशीन लर्निंग का उप-क्षेत्र है और संभवतः लोकप्रिय संस्कृति में दिखाई देने वाले अधिकांश मशीन लर्निंग उपयोग मामलों के लिए ज़िम्मेदार है। डीप लर्निंग एल्गोरिद्म मानव मस्तिष्क की संरचना से प्रेरित होते हैं और प्रशिक्षण के लिए विशाल मात्रा में डेटा की आवश्यकता होती है। इनका उपयोग अक्सर सबसे जटिल “संज्ञानात्मक” समस्याओं के लिए होता है, जैसे स्पीच डिटेक्शन, भाषा अनुवाद, सेल्फ-ड्राइविंग कारें, आदि। अधिक संदर्भ के लिए हमारा डीप लर्निंग बनाम मशीन लर्निंग तुलना देखें।
डेटा साइंस
मशीन लर्निंग, आर्टिफिशियल इंटेलिजेंस, और डीप लर्निंग के विपरीत, डेटा साइंस की परिभाषा काफी व्यापक है। संक्षेप में, डेटा साइंस डेटा से मूल्य और इनसाइट्स निकालने के बारे में है। यह मूल्य भविष्यवाणी करने वाले मॉडलों के रूप में हो सकता है जो मशीन लर्निंग का उपयोग करते हैं, लेकिन यह किसी डैशबोर्ड या रिपोर्ट के माध्यम से इनसाइट्स सतह पर लाने का भी अर्थ हो सकता है। इस लेख में डेटा वैज्ञानिकों के दैनिक कार्यों के बारे में और पढ़ें।
ईमेल स्पैम डिटेक्शन के अलावा, आम मशीन लर्निंग अनुप्रयोगों में डेमोग्राफिक डेटा के आधार पर कस्टमर सेगमेंटेशन (सेल्स और मार्केटिंग), स्टॉक प्राइस भविष्यवाणी (वित्त), क्लेम अप्रूवल ऑटोमेशन (बीमा), देखे गए कंटेंट के इतिहास के आधार पर सिफारिशें (मीडिया और एंटरटेनमेंट), और बहुत कुछ शामिल हैं। मशीन लर्निंग सर्वव्यापी हो गई है और हमारे दैनिक जीवन में विविध अनुप्रयोग पाती है।
लेख के अंत में, हम आपको मशीन लर्निंग शुरू करने के लिए कई संसाधन साझा करेंगे।