

कोर्स
Python में Dimensionality Reduction
4 घंटा
37.2K
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखेंएक्टिवेशन फंक्शन तय करते हैं कि कौन-से सिग्नल न्यूरल नेटवर्क में आगे जाएँ और कौन-से नहीं। गलत चुनाव करने पर आपका मॉडल या तो बहुत धीमे सीखता है या फिर जनरलाइज़ करने में नाकाम रहता है। वर्षों तक ReLU तर्कसंगत डिफ़ॉल्ट रहा क्योंकि यह तेज़ था और ज्यादातर कार्यों के लिए पर्याप्त अच्छा था।
GELU (Gaussian Error Linear Unit) ने यह बदल दिया। आज यह BERT और GPT सहित अब तक के कुछ सबसे सक्षम मॉडलों के पीछे का एक्टिवेशन फंक्शन है।
इस लेख में, मैं GELU के पीछे की सहज समझ, उसका सूत्र, अन्य एक्टिवेशन फंक्शनों से तुलना, और व्यवहार में आप इसे कहाँ उपयोग करेंगे—इन सब पर चर्चा करूँगा।
यदि आप मशीन लर्निंग में एक्टिवेशन फंक्शनों के लिए पूरी तरह नए हैं, तो हमारा रैक्टिफ़ाइड लीनियर यूनिट (ReLU) के लिए शुरुआती मार्गदर्शक ब्लॉग पोस्ट पढ़ें।
GELU, यानी Gaussian Error Linear Unit, एक एक्टिवेशन फंक्शन है जो इनपुट्स को उनकी परिमाण के आधार पर स्मूद और प्रायिकतामूलक तरीके से वेट करता है।
ज्यादातर एक्टिवेशन फंक्शन या तो सिग्नल को आगे बढ़ाते हैं या रोक देते हैं। उदाहरण के लिए, ReLU किसी भी नकारात्मक मान को शून्य कर देता है और बाकी सबको बिना बदले पास कर देता है। GELU अलग तरह से काम करता है। सख्त कटऑफ़ के बजाय, यह इनपुट को उनके छोटे-बड़े होने के आधार पर स्मूद तरीके से स्केल करता है, जिसका मतलब है कि हल्के नकारात्मक मान भी आउटपुट में योगदान कर सकते हैं।
ReLU से फर्क यह है कि GELU हर जगह स्मूद और सतत है। शून्य पर कोई तेज़ कोना नहीं, न ही अचानक परिवर्तन। यह स्मूदनेस ट्रेनिंग के दौरान मायने रखती है क्योंकि यह ऑप्टिमाइज़र को ज्यादा साफ़ ग्रेडिएंट जानकारी देती है।
GELU को ऐसे फ़िल्टर के रूप में सोचें जो सभी इनपुट्स को एक जैसा नहीं मानता।
ReLU सीधा-सादा है—जो भी नकारात्मक है, उसे हर बार शून्य कर देता है। दूसरी ओर, GELU पूछता है, “यह इनपुट मान कितना उपयोगी होने की संभावना रखता है?” जो मान स्पष्ट रूप से बड़े और सकारात्मक होते हैं वे लगभग बिना बदले पास हो जाते हैं। जो मान छोटे या नकारात्मक होते हैं उन्हें काटा नहीं जाता, बल्कि स्केल डाउन किया जाता है।
नतीजा यह होता है कि आपको एक स्मूद कर्व मिलता है जो कम प्रासंगिक सिग्नलों को दबा देता है, बिना उन्हें पूरी तरह फेंके।
मान लीजिए आप नौकरी आवेदनों के ढेर की समीक्षा कर रहे हैं। एक सख्त फ़िल्टर डिग्री नहीं होने पर किसी को भी बिना अपवाद हटा देगा। एक समझदार फ़िल्टर उन उम्मीदवारों पर भी विचार करेगा जो क़रीब हैं—शायद उनके पास प्रासंगिक अनुभव हो जो इसकी भरपाई कर दे। GELU समझदार फ़िल्टर जैसा काम करता है। यह सख्त कट नहीं लगाता, बल्कि इनपुट की परिमाण के आधार पर वज़न देता है और तय करता है कि कितना आगे जाने देना है।
यही क्रमिक और प्रायिकतामूलक स्केलिंग GELU को अलग बनाती है। यहाँ कोई तेज़ ट्रांज़िशन नहीं और न ही डेड न्यूरॉन्स—हर इनपुट मान के लिए स्मूद “पास या सप्रेस” निर्णय होता है।
GELU का सटीक सूत्र Gaussian cumulative distribution function (CDF) पर आधारित है, जिसे इस तरह लिखा जाता है:
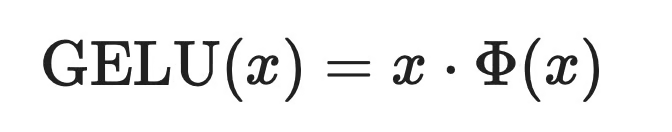
Gaussian cumulative distribution function
जहाँ x इनपुट मान है और Φ(x) वह प्रायिकता है कि मानक नार्मल वितरण से लिया गया रैंडम वेरिएबल x से कम या बराबर होगा। सरल शब्दों में, Φ(x) बताता है कि इनपुट मान कितना “सामान्य” या अपेक्षित है—और GELU इसी प्रायिकता का उपयोग इनपुट को स्केल करने के लिए करता है।
इनपुट जितना अधिक होगा, Φ(x) उतना ही 1 के पास होगा—मतलब इनपुट लगभग बिना बदले पास हो जाता है। इनपुट जितना कम होगा, Φ(x) उतना ही 0 के पास होगा—मतलब इनपुट सप्रेस हो जाता है।
सटीक सूत्र की समस्या यह है कि Φ(x) की गणना महँगी है। इसमें एरर फंक्शन शामिल होता है, जिसका सरल क्लोज़्ड फॉर्म नहीं है और बड़े पैमाने पर गणना में धीमा है।
डीप लर्निंग फ़्रेमवर्क इसके बजाय यह एप्रॉक्सिमेशन उपयोग करते हैं:
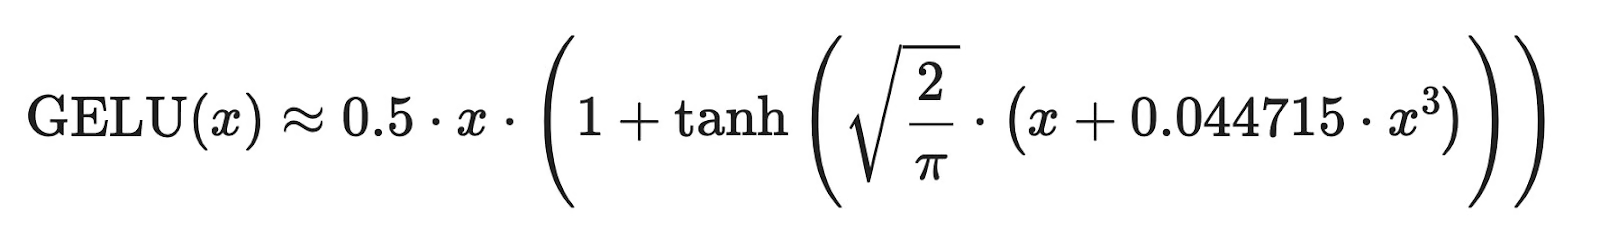
GELU एप्रॉक्सिमेशन सूत्र
यह एप्रॉक्सिमेशन tanh का उपयोग करता है, जो तेज़ है और आधुनिक हार्डवेयर पर अच्छी तरह सपोर्टेड है। व्यावहारिक इनपुट रेंज में इसका परिणाम सटीक सूत्र के लगभग समान होता है, इसलिए PyTorch और TensorFlow जैसे फ़्रेमवर्क इसे डिफ़ॉल्ट रूप से उपयोग करते हैं।
बेशक, आपको किसी भी सूत्र को याद रखने की ज़रूरत नहीं। लेकिन यह जानना कि एप्रॉक्सिमेशन मौजूद है—और क्यों—आपको समझने में मदद करता है कि जब आप अपने कोड में GELU कॉल करते हैं तब वास्तव में क्या हो रहा होता है।
हर एक्टिवेशन फंक्शन इनपुट्स को अलग तरह से हैंडल करता है, और यही फर्क इस बात में दिखता है कि आपका मॉडल कितना अच्छा ट्रेन होता है।
यहाँ टेक्स्ट में समझाने से पहले दृश्य रूप में फर्क कैसा दिखता है:
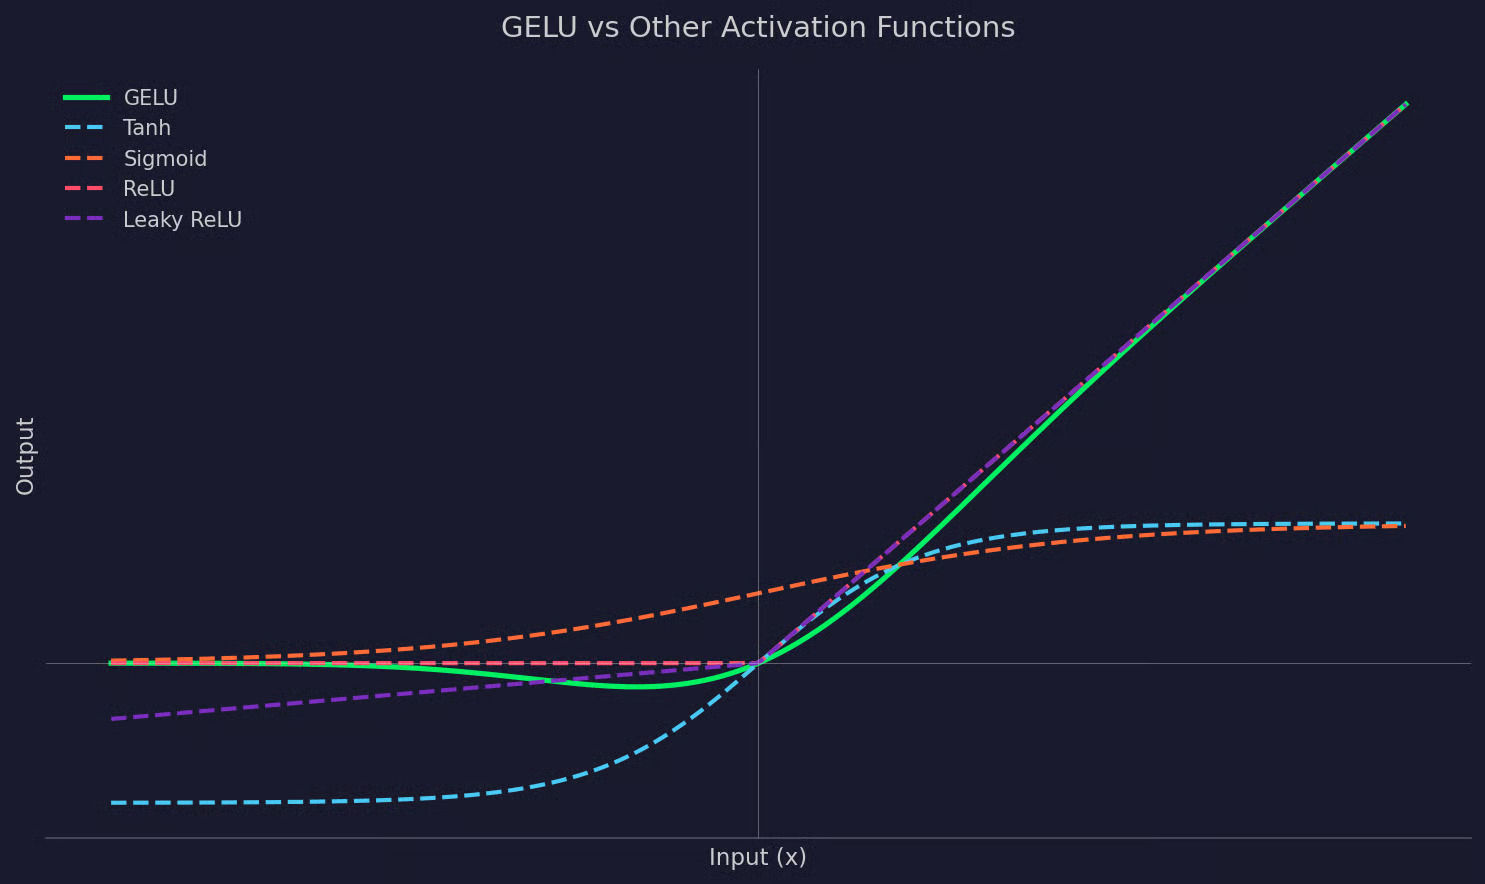
GELU बनाम अन्य एक्टिवेशन फंक्शन का ग्राफ
Sigmoid सभी इनपुट्स को 0 और 1 के बीच समेट देता है। यह स्मूद है, लेकिन एक जानी-पहचानी समस्या है: वैनिशिंग ग्रेडिएंट्स। बहुत बड़े या बहुत छोटे इनपुट्स के लिए ग्रेडिएंट शून्य के क़रीब चला जाता है, जिससे गहरे लेयर्स सीखना बंद कर देते हैं। GELU में यह समस्या नहीं होती क्योंकि इसका ग्रेडिएंट व्यापक इनपुट रेंज में सार्थक बना रहता है।
Tanh, Sigmoid जैसा ही है लेकिन शून्य-केंद्रित है, आउटपुट -1 से 1 के बीच देता है। यह नकारात्मक इनपुट्स को Sigmoid से बेहतर संभालता है, लेकिन सिरों पर वैनिशिंग ग्रेडिएंट्स की समस्या बनी रहती है। GELU एक स्मूद आउटपुट कर्व देता है और डीप नेटवर्क्स में बेहतर ग्रेडिएंट फ्लो सुनिश्चित करता है।
ReLU तेज़ और सरल है: सकारात्मक इनपुट्स बिना बदले पास होते हैं, नकारात्मक शून्य कर दिए जाते हैं। शून्य पर तेज़ कटऑफ़ ही “डाइंग न्यूरॉन” समस्या का कारण है—वे न्यूरॉन्स जिन्हें समय के साथ हमेशा नकारात्मक इनपुट मिलते हैं, पूरी तरह अपडेट होना बंद कर देते हैं। GELU नकारात्मक इनपुट्स को काटने के बजाय उन्हें स्केल करके इससे बचाता है।
Leaky ReLU नकारात्मक इनपुट्स का एक छोटा अंश गुजरने देकर डाइंग न्यूरॉन समस्या को ठीक करता है। यह ReLU से बेहतर है, लेकिन शून्य पर ट्रांज़िशन फिर भी तेज़ रहता है। GELU कुल मिलाकर ज्यादा स्मूद कर्व बनाता है, जो डीप आर्किटेक्चर में—जहाँ ग्रेडिएंट की गुणवत्ता अधिक मायने रखती है—अक्सर बेहतर काम करता है।
संक्षेप में, इन पाँच एक्टिवेशन फंक्शनों के बीच यही अंतर हैं:
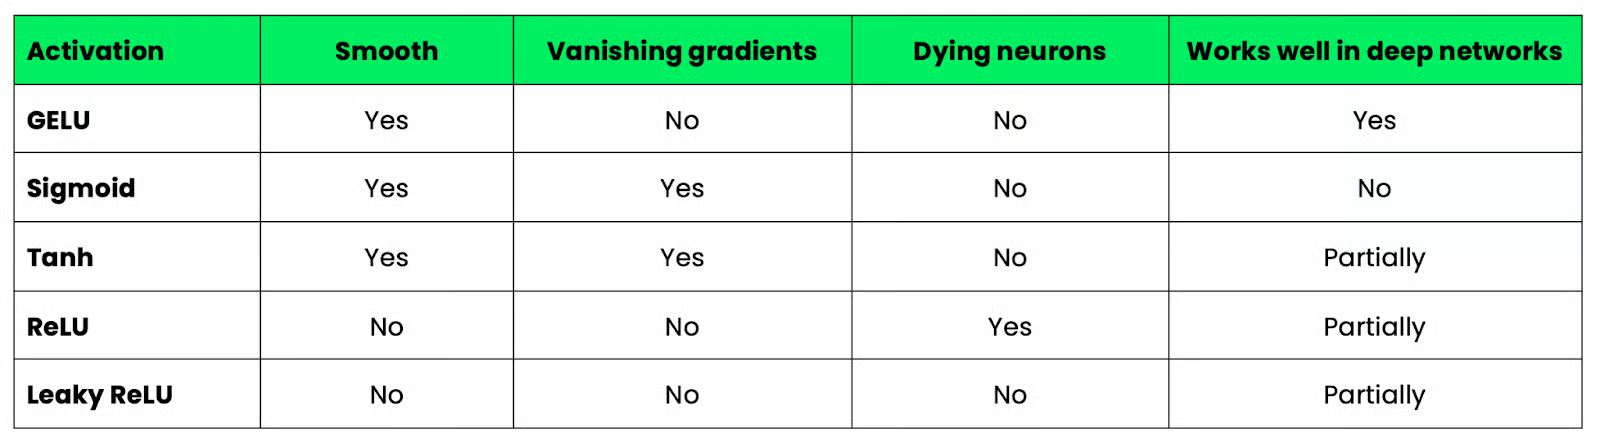
GELU बनाम अन्य एक्टिवेशन फंक्शनों की तालिका
ट्रांसफॉर्मर्स भी डीप न्यूरल नेटवर्क ही हैं। और आपका नेटवर्क जितना गहरा होगा, ग्रेडिएंट की गुणवत्ता उतनी ही महत्वपूर्ण होगी।
BERT और GPT जैसे मॉडल दर्जनों लेयर एक-दूसरे के ऊपर स्टैक करते हैं। इतनी गहराई पर, ग्रेडिएंट फ्लो की छोटी समस्याएँ भी बढ़ जाती हैं। अगर आपका एक्टिवेशन फंक्शन कुछ रेंज में अस्थिर या शून्य-के-नज़दीक ग्रेडिएंट पैदा करता है, तो नेटवर्क की शुरुआती लेयरें ट्रेनिंग के दौरान मुश्किल से अपडेट होती हैं—यानि वे बहुत कम सीखती हैं।
GELU इससे बचाता है क्योंकि यह व्यापक इनपुट रेंज में ग्रेडिएंट्स को स्मूद और नॉन-ज़ीरो रखता है। ReLU की तरह कोई कटऑफ़ नहीं है, इसलिए ऑप्टिमाइज़र को हर लेयर पर, केवल आउटपुट के पास ही नहीं, बल्कि हर जगह साफ़ सिग्नल मिलता है।
GELU ट्रांसफॉर्मर आर्किटेक्चर में एक और वजह से भी अच्छा फिट बैठता है।
ट्रांसफॉर्मर्स अटेंशन मैकेनिज़्म के जरिए इनपुट्स को प्रोसेस करते हैं, जो सकारात्मक और नकारात्मक—दोनों तरह के—विस्तृत एक्टिवेशन मान उत्पन्न करते हैं। एक स्मूद एक्टिवेशन फंक्शन इस रेंज को किसी तेज़ ट्रांज़िशन वाले फंक्शन से बेहतर संभालता है।
जब मूल BERT पेपर प्रकाशित हुआ, तो लेखकों ने ReLU के बजाय GELU चुना और अपने बेंचमार्क्स पर बेहतर परिणाम बताए। GPT ने भी यही चुनाव किया। तब से, GELU अधिकांश ट्रांसफॉर्मर-आधारित आर्किटेक्चर में डिफ़ॉल्ट बन गया है—क्योंकि यह नया है इसलिए नहीं, बल्कि इसलिए कि यह उन स्केल्स पर बेहतर काम करता है जिन पर ये मॉडल चलते हैं।
अपने मॉडलों में GELU का उपयोग किसी भी अन्य एक्टिवेशन फंक्शन जितना आसान है। PyTorch और TensorFlow—दोनों में बिल्ट-इन सपोर्ट है।
PyTorch में, आप GELU को एक स्टैंडअलोन मॉड्यूल की तरह या मॉडल परिभाषा के भीतर इनलाइन लगा सकते हैं। यहाँ GELU का उपयोग करता एक सरल फीडफ़ॉरवर्ड ब्लॉक है:
import torch
import torch.nn as nn

class FeedForwardBlock(nn.Module):
    def __init__(self, input_dim, hidden_dim):
        super().__init__()
        self.fc1 = nn.Linear(input_dim, hidden_dim)
        self.act = nn.GELU()
        self.fc2 = nn.Linear(hidden_dim, input_dim)

    def forward(self, x):
        return self.fc2(self.act(self.fc1(x)))

block = FeedForwardBlock(input_dim=512, hidden_dim=2048)
x = torch.randn(8, 512)
output = block(x)
nn.GELU() दो लीनियर लेयर्स के बीच है—यही जगह ट्रांसफॉर्मर के फीडफ़ॉरवर्ड सबलेयर में होती है। एक्टिवेशन पहली प्रोजेक्शन के बाद और दूसरी से पहले चलता है।
TensorFlow में, GELU Keras API के माध्यम से उपलब्ध है:
import tensorflow as tf
from tensorflow import keras

model = keras.Sequential([
    keras.layers.Dense(2048, input_shape=(512,)),
    keras.layers.Activation("gelu"),
    keras.layers.Dense(512)
])

x = tf.random.normal((8, 512))
output = model(x)
आप इसे सीधे Dense लेयर के स्ट्रिंग आर्ग्यूमेंट के रूप में भी पास कर सकते हैं:
keras.layers.Dense(2048, activation="gelu")दोनों तरीकों से समान परिणाम मिलता है।
GELU वहीँ लगता है जहाँ कोई भी एक्टिवेशन फंक्शन लगता है—सीधे लीनियर ट्रांसफॉर्मेशन के बाद और अगली लेयर से पहले। ट्रांसफॉर्मर आर्किटेक्चर में, इसका मतलब है फीडफ़ॉरवर्ड सबलेयर के भीतर, दो डेंस प्रोजेक्शनों के बीच। अन्य डीप नेटवर्क्स में, इसे अपनी लीनियर या कॉन्वॉल्यूशनल लेयर के बाद रखें और आउटपुट को आगे भेजने से पहले स्केल होने दें।
यदि आप अब तक पढ़ रहे हैं, तो आप जानते हैं कि अन्य एक्टिवेशन फंक्शनों की तुलना में GELU की प्रमुख खूबियाँ क्या हैं। यहाँ उनका संक्षिप्त पुनरावलोकन है:
GELU हर परिस्थिति के लिए सही विकल्प नहीं है। यहाँ कुछ सीमाएँ हैं जिनसे आपको अवगत होना चाहिए:
ReLU से गणना में महँगा: GELU में या तो एरर फंक्शन शामिल है या tanh आधारित एप्रॉक्सिमेशन—दोनों की लागत ReLU के सरल थ्रेशहोल्ड ऑपरेशन से अधिक है। कई लेयर्स वाले बड़े मॉडलों में यह लागत बढ़ सकती है।
कम सहज: ReLU जैसे फंक्शन सहज होते हैं—सकारात्मक मान पास होते हैं, नकारात्मक नहीं। GELU की प्रायिकतामूलक स्केलिंग को समझना कठिन हो सकता है।
हमेशा ज़रूरी नहीं: उथले नेटवर्क्स या सरल कार्यों के लिए, GELU कोई खास बढ़त नहीं देता। ReLU या Leaky ReLU अक्सर कम कम्प्यूटेशनल लागत पर उतना ही अच्छा प्रदर्शन करेंगे।
अंत में, यदि आप ट्रांसफॉर्मर या कोई अन्य डीप आर्किटेक्चर बना रहे हैं, तो GELU एक ठोस डिफ़ॉल्ट है। बाकी हर चीज़ के लिए, कमिट करने से पहले बेंचमार्क करें।
GELU कोई सर्वत्र अपग्रेड नहीं है, न ही यह ऐसा सर्वसमर्थ समाधान है जो ReLU की जगह ले ले। यह एक सोचा-समझा डिज़ाइन विकल्प है जो विशिष्ट संदर्भों—जैसे डीप नेटवर्क्स और ट्रांसफॉर्मर मॉडलों—में सार्थक साबित होता है।
यदि आप BERT, GPT, या किसी भी ट्रांसफॉर्मर-आधारित मॉडल के साथ काम कर रहे हैं, तो आप चाहें या न चाहें पहले से ही GELU का उपयोग कर रहे हैं। अब आप जानते हैं कि यह वहाँ क्यों है।
बाकी हर चीज़ के लिए, एक्टिवेशन फंक्शन का चुनाव ट्रेड-ऑफ़्स पर आता है। कोई एक फंक्शन हर बार नहीं जीतता, और कौन क्या करता है यह समझना आपको आदत से नहीं, आत्मविश्वास से निर्णय लेने में मदद करता है।
यदि आपको अब भी एक्टिवेशन फंक्शनों के बीच के अंतर उलझनभरे लगते हैं, तो हमारे Machine Learning Engineer ट्रैक में नामांकन करें और मशीन लर्निंग व MLOps में करियर-रेडी बनें।
DataCamp के साथ सीखें
कोर्स
कोर्स
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखें