
Last chance! 50% off DataCamp Premium
Sale ends in

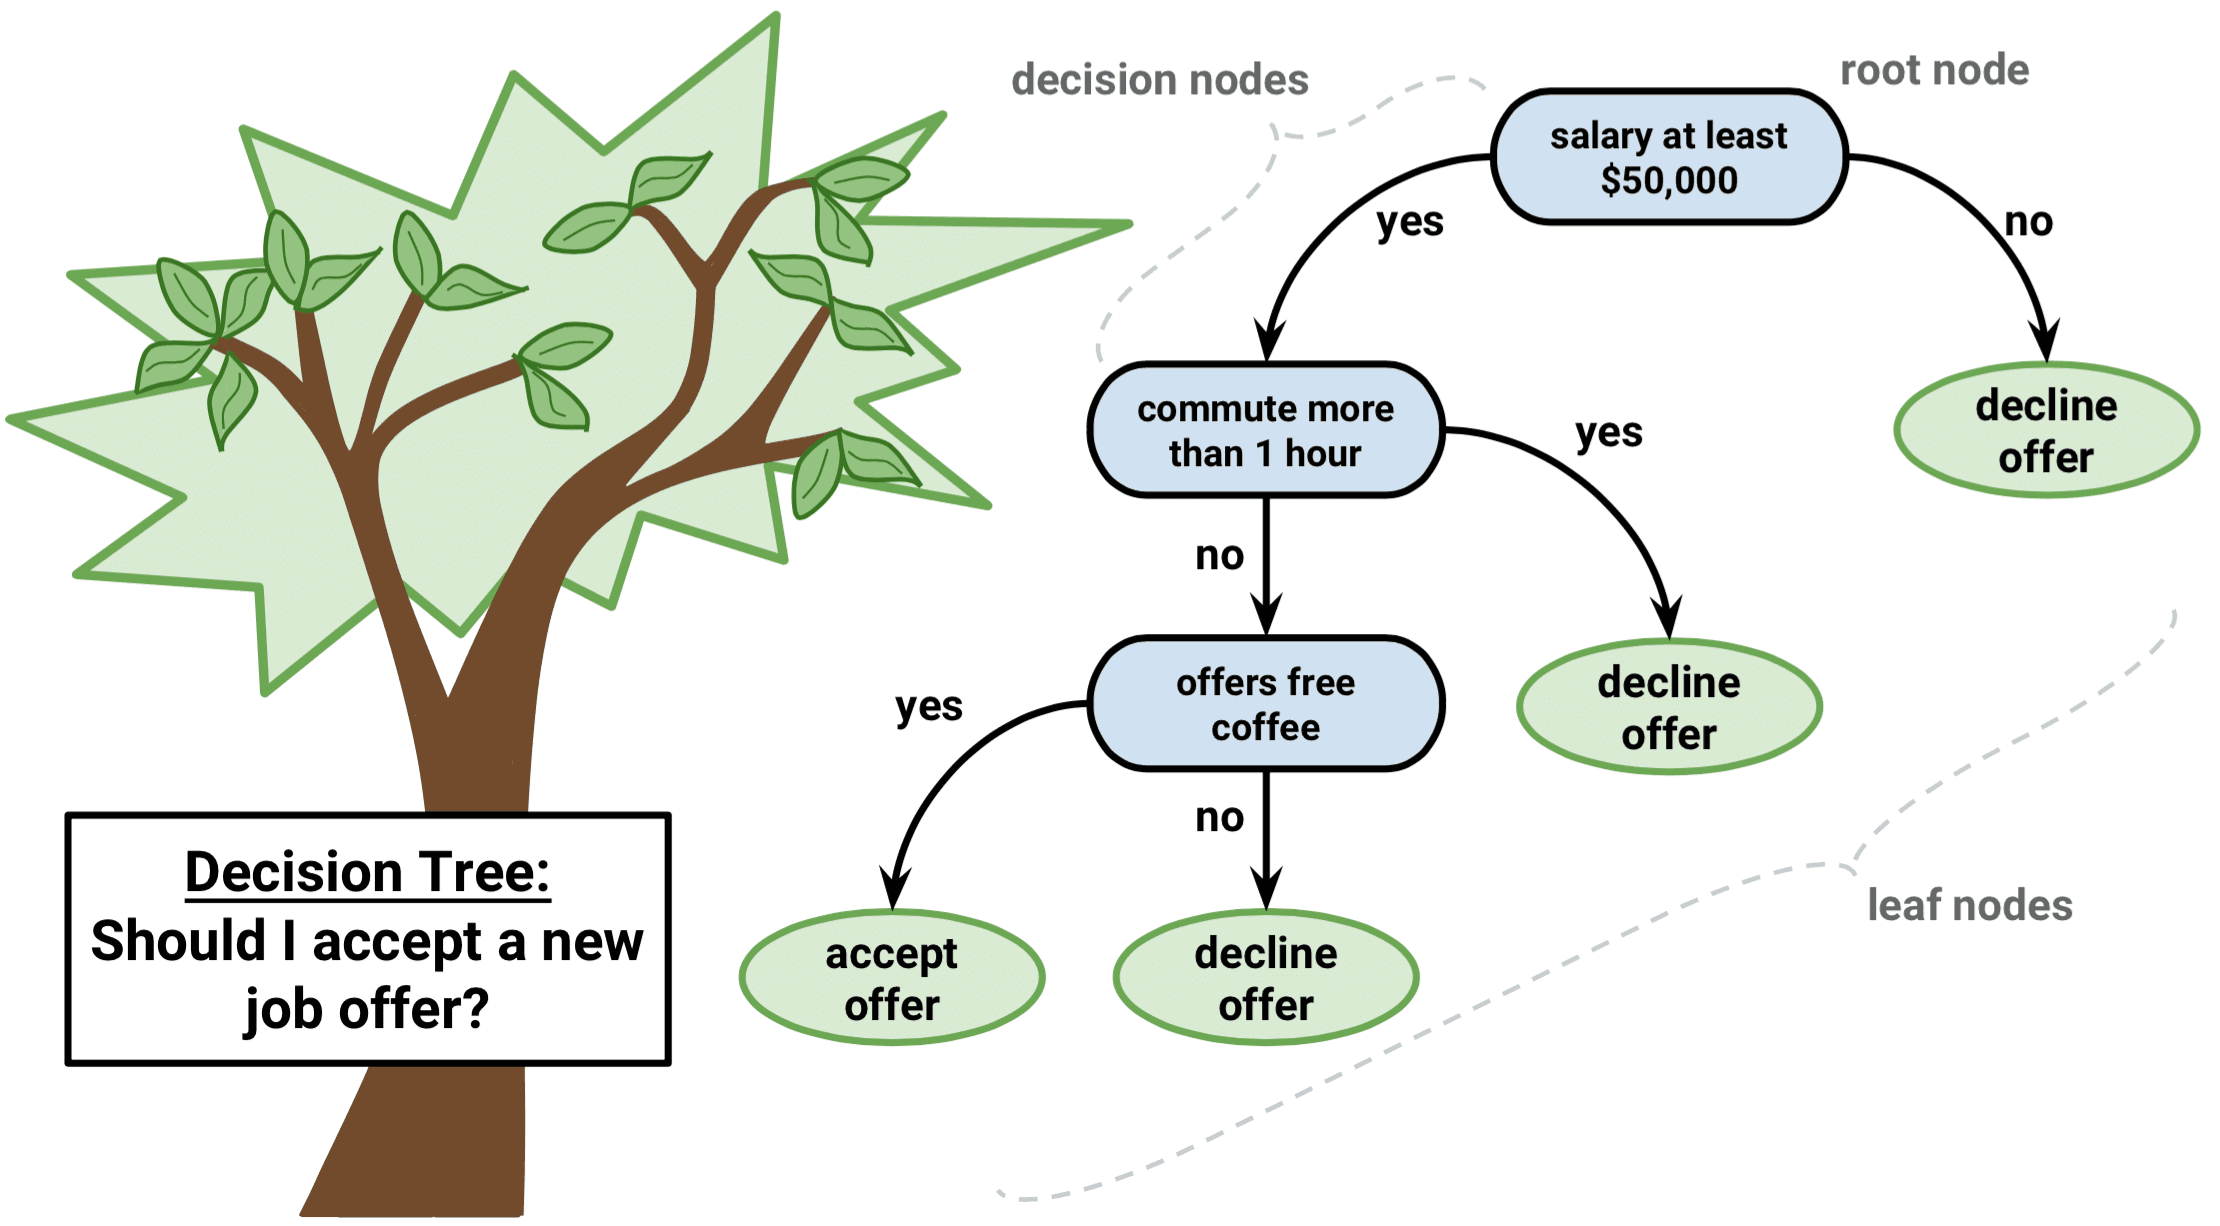
Bayangkan Anda menavigasi sebuah labirin. Di setiap langkah, Anda menghadapi keputusan yang membawa Anda lebih dekat ke pintu keluar atau semakin masuk ke dalam. Inilah gambaran algoritme pohon keputusan, metode machine learning yang kuat dan intuitif untuk membantu kita memahami data kompleks dan memilih tindakan terbaik.
Algoritme pohon keputusan memecah dataset menjadi subset yang makin kecil berdasarkan kondisi tertentu. Seperti pohon bercabang dengan daun dan simpul, ia dimulai dari satu simpul akar lalu berkembang menjadi banyak cabang, masing-masing mewakili keputusan berdasarkan nilai suatu fitur. Daun-daun terakhir pohon adalah kemungkinan hasil atau prediksi.
Artikel ini akan memperkenalkan Anda pada dunia pohon keputusan menggunakan bahasa pemrograman R. Kita akan membahas dasarnya, meninjau jenis algoritme pohon keputusan yang populer, mengeksplorasi metode berbasis pohon, dan memandu Anda melalui contoh langkah demi langkah. Pada akhirnya, Anda akan mampu memanfaatkan kekuatan pohon keputusan untuk membuat keputusan berbasis data yang lebih baik.
Pohon keputusan menonjol dalam machine learning karena kesederhanaan, keterjelasan interpretasi, dan versatilitasnya.
Ini adalah algoritme pembelajaran terawasi yang dapat digunakan untuk masalah regresi (memprediksi nilai kontinu) dan klasifikasi (memprediksi nilai kategorikal). Selain itu, pohon keputusan menjadi fondasi bagi teknik yang lebih maju seperti bagging, boosting, dan random forests.
Diagram berikut akan menggambarkan terminologi di balik pohon keputusan:
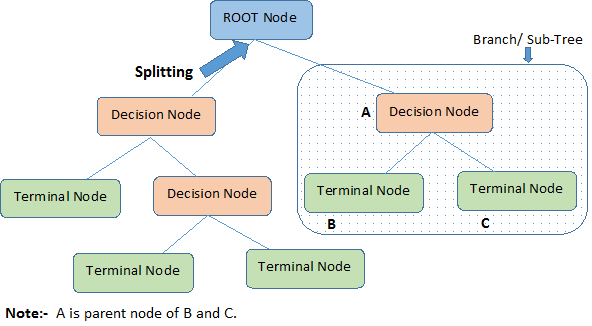
Sebuah pohon keputusan dimulai dengan simpul akar yang menandakan seluruh populasi atau sampel, yang kemudian dipisah menjadi dua atau lebih kelompok seragam melalui metode yang disebut splitting. Ketika sub-simpul mengalami pembagian lebih lanjut, mereka disebut simpul keputusan, sementara yang tidak terbagi disebut simpul terminal atau daun. Potongan dari pohon lengkap disebut cabang.
Kita sudah menetapkan bahwa pohon keputusan dapat digunakan untuk tugas regresi dan klasifikasi; maka mari pahami algoritme di balik masing-masing jenisnya.
Mari pahami secara intuitif pohon keputusan regresi dan klasifikasi: apa yang sama dan berbeda, serta fungsi error-nya.
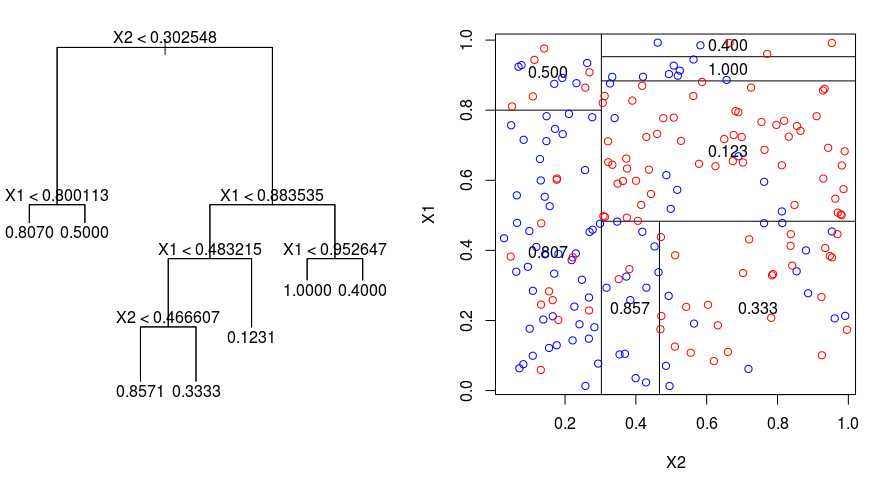
Mari lihat gambar di bawah yang membantu memvisualisasikan sifat pemartisian yang dilakukan oleh Pohon Regresi. Ini menunjukkan sebuah pohon yang belum dipangkas dan hasil fitting pohon regresi pada dataset acak. Kedua visualisasi menunjukkan serangkaian aturan pemisahan, dimulai dari puncak pohon. Perhatikan bahwa setiap pemisahan domain sejajar dengan salah satu sumbu fitur. Konsep pemisahan sejajar sumbu ini dapat digeneralisasi dengan mudah ke dimensi lebih dari dua. Untuk ruang fitur berukuran $p$, suatu subset dari $\mathbb{R}^p$, ruang dibagi menjadi $M$ wilayah, $R_{m}$, masing-masing merupakan "hyperblock" berdimensi $p$.
Untuk membangun pohon regresi, pertama Anda menggunakan recursive binary splitting untuk menumbuhkan pohon besar pada data latih, berhenti hanya ketika setiap simpul terminal memiliki lebih sedikit dari sejumlah minimum observasi. Recursive Binary Splitting adalah algoritme rakus dan top-down yang digunakan untuk meminimalkan Residual Sum of Squares (RSS), ukuran error yang juga digunakan dalam pengaturan regresi linear. RSS, dalam kasus ruang fitur yang dipartisi dengan M partisi, diberikan oleh:
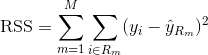
Dimulai dari puncak pohon, Anda membaginya menjadi 2 cabang, menciptakan partisi atas 2 ruang. Anda kemudian melakukan pemisahan ini berkali-kali di puncak pohon dan memilih pemisahan fitur yang meminimalkan RSS (saat ini).
Selanjutnya, Anda menerapkan cost complexity pruning pada pohon besar untuk memperoleh deret subtree terbaik sebagai fungsi dari $\alpha$. Gagasannya adalah memperkenalkan parameter penyetelan tambahan, dilambangkan $\alpha$, yang menyeimbangkan kedalaman pohon dan kecocokannya terhadap data latih.
Anda dapat menggunakan K-fold cross-validation untuk memilih $\alpha$. Teknik ini membagi observasi pelatihan menjadi K lipatan untuk memperkirakan tingkat error uji dari subtree. Tujuan Anda adalah memilih yang menghasilkan tingkat error terendah.
Pohon klasifikasi sangat mirip dengan pohon regresi, kecuali digunakan untuk memprediksi respons kualitatif alih-alih kuantitatif.
Ingat bahwa untuk pohon regresi, respons prediksi suatu observasi diberikan oleh nilai rata-rata respons dari observasi pelatihan yang berada di simpul terminal yang sama. Sebaliknya, untuk pohon klasifikasi, Anda memprediksi bahwa setiap observasi termasuk ke kelas yang paling sering muncul di wilayah tempat ia berada.
Dalam menginterpretasikan hasil pohon klasifikasi, Anda sering tertarik tidak hanya pada prediksi kelas yang sesuai dengan wilayah simpul terminal tertentu, tetapi juga pada proporsi kelas di antara observasi pelatihan yang jatuh ke wilayah tersebut.
Tugas menumbuhkan pohon klasifikasi cukup mirip dengan menumbuhkan pohon regresi. Sama seperti pada pengaturan regresi, Anda menggunakan recursive binary splitting untuk menumbuhkan pohon klasifikasi. Namun, dalam pengaturan klasifikasi, Residual Sum of Squares tidak dapat digunakan sebagai kriteria pemisahan biner. Sebagai gantinya, Anda dapat menggunakan salah satu dari 3 metode berikut:
E = 1 - argmaxc($\hat{\pi}_{mc}$)
di mana $\hat{\pi}_{mc}$ merepresentasikan fraksi data pelatihan di wilayah Rm yang termasuk kelas c.
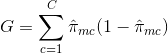
Cross-entropy akan bernilai mendekati nol jika $\hat{\pi}_{mc}$ semuanya mendekati 0 atau 1. Karena itu, seperti indeks Gini, cross-entropy akan bernilai kecil jika simpul ke-m murni. Faktanya, indeks Gini dan cross-entropy cukup mirip secara numerik.
Saat membangun pohon klasifikasi, biasanya indeks Gini atau cross-entropy digunakan untuk mengevaluasi kualitas suatu pemisahan, karena keduanya lebih sensitif terhadap kemurnian simpul dibanding tingkat error klasifikasi. Salah satu dari 3 pendekatan ini dapat digunakan saat memangkas pohon, tetapi tingkat error klasifikasi lebih disukai jika akurasi prediksi dari pohon hasil pemangkasan akhir adalah tujuannya.
Sebagus apa pun kita memahami algoritme dan kekuatannya, penting juga untuk memahami kelemahannya. Faktanya, pohon keputusan bukan pilihan terbaik untuk semua jenis algoritme machine learning, sebagaimana halnya algoritme lain.
Berikut kelebihan dan kekurangannya:
Terlepas dari kekurangannya, pohon keputusan tetap populer di banyak aplikasi karena kesederhanaan, keterjelasan, dan fleksibilitasnya.
Mari jelajahi metode ansambel berbasis pohon yang memanfaatkan kekuatan pohon keputusan sekaligus mengatasi beberapa keterbatasannya: bagging, boosting, dan random forests.
Pohon keputusan yang dibahas di atas memiliki varian tinggi, artinya jika Anda membagi data latih menjadi 2 bagian secara acak, lalu memasang pohon keputusan pada kedua bagian tersebut, hasilnya bisa sangat berbeda. Sebaliknya, prosedur dengan varian rendah akan menghasilkan hasil serupa jika diterapkan berulang pada dataset berbeda.
Bagging, atau bootstrap aggregation, adalah teknik untuk mengurangi varian prediksi dengan menggabungkan hasil beberapa classifier yang dimodelkan pada sub-sampel berbeda dari dataset yang sama. Berikut persamaan untuk bagging:
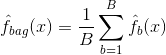
di mana Anda menghasilkan $B$ dataset pelatihan bootstrap yang berbeda. Anda kemudian melatih metode Anda pada set pelatihan bootstrap ke-$b$ untuk mendapatkan $\hat{f}_{b}(x)$, dan akhirnya merata-ratakan prediksinya.
Visual di bawah menunjukkan 3 langkah berbeda dalam bagging:
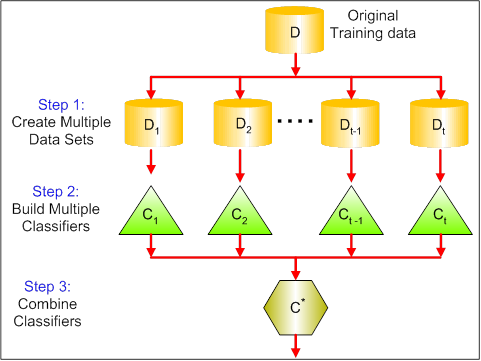
Langkah 1: Di sini Anda mengganti data asli dengan data baru. Data baru biasanya memiliki sebagian kolom dan baris dari data asli, yang kemudian dapat digunakan sebagai hyper-parameter dalam model bagging.
Langkah 2: Anda membangun classifier pada setiap dataset. Umumnya, Anda dapat menggunakan classifier yang sama untuk membuat model dan prediksi.
Langkah 3: Terakhir, Anda menggunakan nilai rata-rata untuk menggabungkan prediksi semua classifier, bergantung pada masalahnya. Secara umum, nilai gabungan ini lebih andal daripada satu model tunggal.
Walau bagging dapat meningkatkan prediksi untuk banyak metode regresi dan klasifikasi, teknik ini sangat berguna untuk pohon keputusan. Untuk menerapkan bagging pada pohon regresi/klasifikasi, Anda cukup membangun $B$ pohon regresi/klasifikasi menggunakan $B$ set pelatihan bootstrap, dan merata-ratakan prediksi yang dihasilkan. Pohon-pohon ini ditumbuhkan dalam (deep) dan tidak dipangkas. Maka setiap pohon individu memiliki varian tinggi tetapi bias rendah. Merata-ratakan $B$ pohon ini mengurangi varian.
Secara umum, bagging terbukti memberikan peningkatan akurasi yang mengesankan dengan menggabungkan ratusan bahkan ribuan pohon ke dalam satu prosedur.
Random Forests adalah metode machine learning serbaguna yang mampu melakukan tugas regresi dan klasifikasi. Ia juga melakukan metode reduksi dimensi, menangani nilai hilang, nilai outlier, dan langkah eksplorasi data penting lainnya dengan cukup baik.
Random Forests memperbaiki bagged trees dengan sedikit penyesuaian yang mendekorelasi pohon-pohon tersebut. Seperti pada bagging, Anda membangun sejumlah pohon keputusan pada sampel bootstrap pelatihan. Namun saat membangun pohon-pohon ini, setiap kali pemisahan pada sebuah pohon dipertimbangkan, sampel acak berukuran m prediktor dipilih sebagai kandidat pemisahan dari himpunan lengkap $p$ prediktor. Pemisahan hanya boleh menggunakan salah satu dari $m$ prediktor tersebut. Ini perbedaan utama antara random forests dan bagging; karena pada bagging, pilihan prediktor $m = p$.
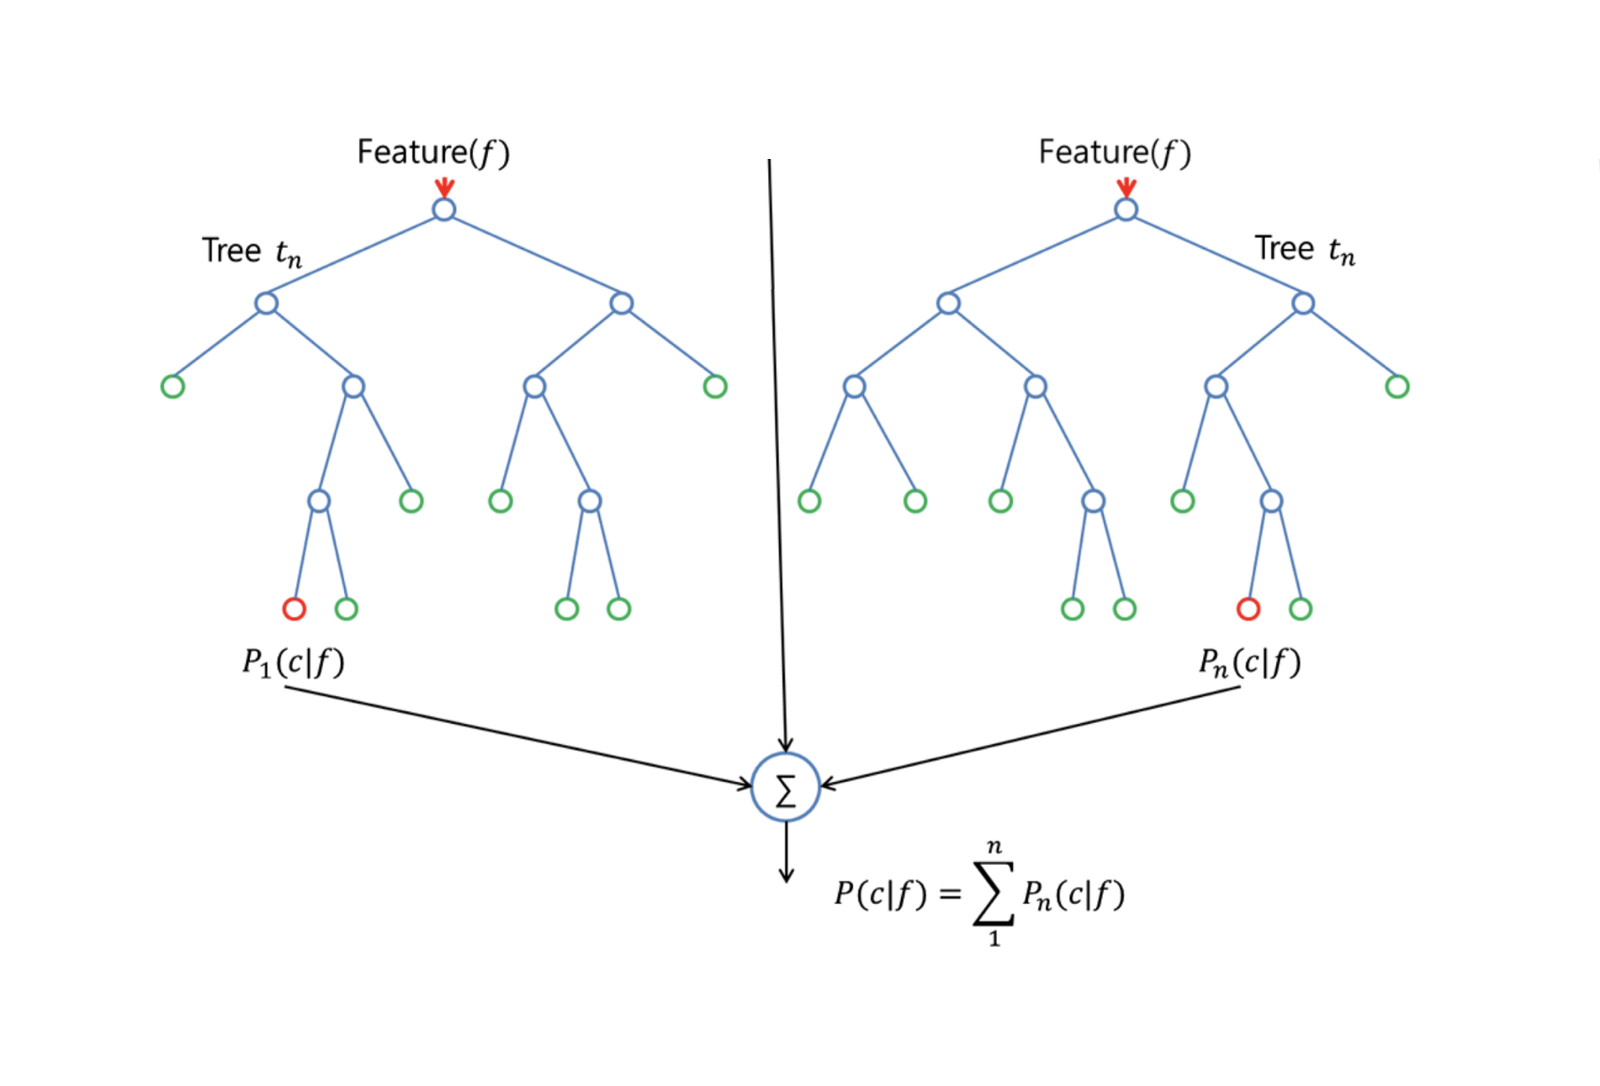
Untuk menumbuhkan random forest, Anda sebaiknya:
Mula-mula anggap jumlah kasus dalam set pelatihan adalah K. Lalu, ambil sampel acak dari K kasus ini, dan gunakan sampel tersebut sebagai set pelatihan untuk menumbuhkan pohon.
Jika ada $p$ variabel input, tentukan jumlah $m < p$ sehingga pada setiap simpul, Anda dapat memilih $m$ variabel acak dari $p$. Pemisahan terbaik pada $m$ variabel ini digunakan untuk membagi simpul.
Setiap pohon kemudian ditumbuhkan sejauh mungkin dan tidak perlu pemangkasan.
Terakhir, agregasikan prediksi dari pohon-pohon target untuk memprediksi data baru.
Random Forests sangat efektif dalam memperkirakan data hilang dan mempertahankan akurasi saat proporsi data yang hilang besar. Ia juga dapat menyeimbangkan error pada dataset dengan kelas tidak seimbang. Yang terpenting, ia dapat menangani dataset masif dengan dimensi besar. Namun, satu kekurangan penggunaan Random Forests adalah Anda bisa dengan mudah overfit pada dataset yang berisik, terutama pada kasus regresi.
Boosting adalah pendekatan lain untuk meningkatkan prediksi yang dihasilkan dari pohon keputusan. Seperti bagging dan random forests, ini adalah pendekatan umum yang dapat diterapkan pada banyak metode pembelajaran statistik untuk regresi atau klasifikasi. Ingat bahwa bagging melibatkan pembuatan banyak salinan dataset pelatihan asli menggunakan bootstrap, memasang pohon keputusan terpisah pada setiap salinan, lalu menggabungkan semua pohon untuk membuat satu model prediktif. Perlu dicatat, setiap pohon dibangun pada dataset bootstrap yang independen satu sama lain.
Boosting bekerja dengan cara yang mirip, kecuali pohon-pohon ditumbuhkan secara sekuensial: setiap pohon menggunakan informasi dari pohon yang sebelumnya ditumbuhkan. Boosting tidak melibatkan sampling bootstrap; sebaliknya, setiap pohon dipasangkan pada versi termodifikasi dari dataset asli.
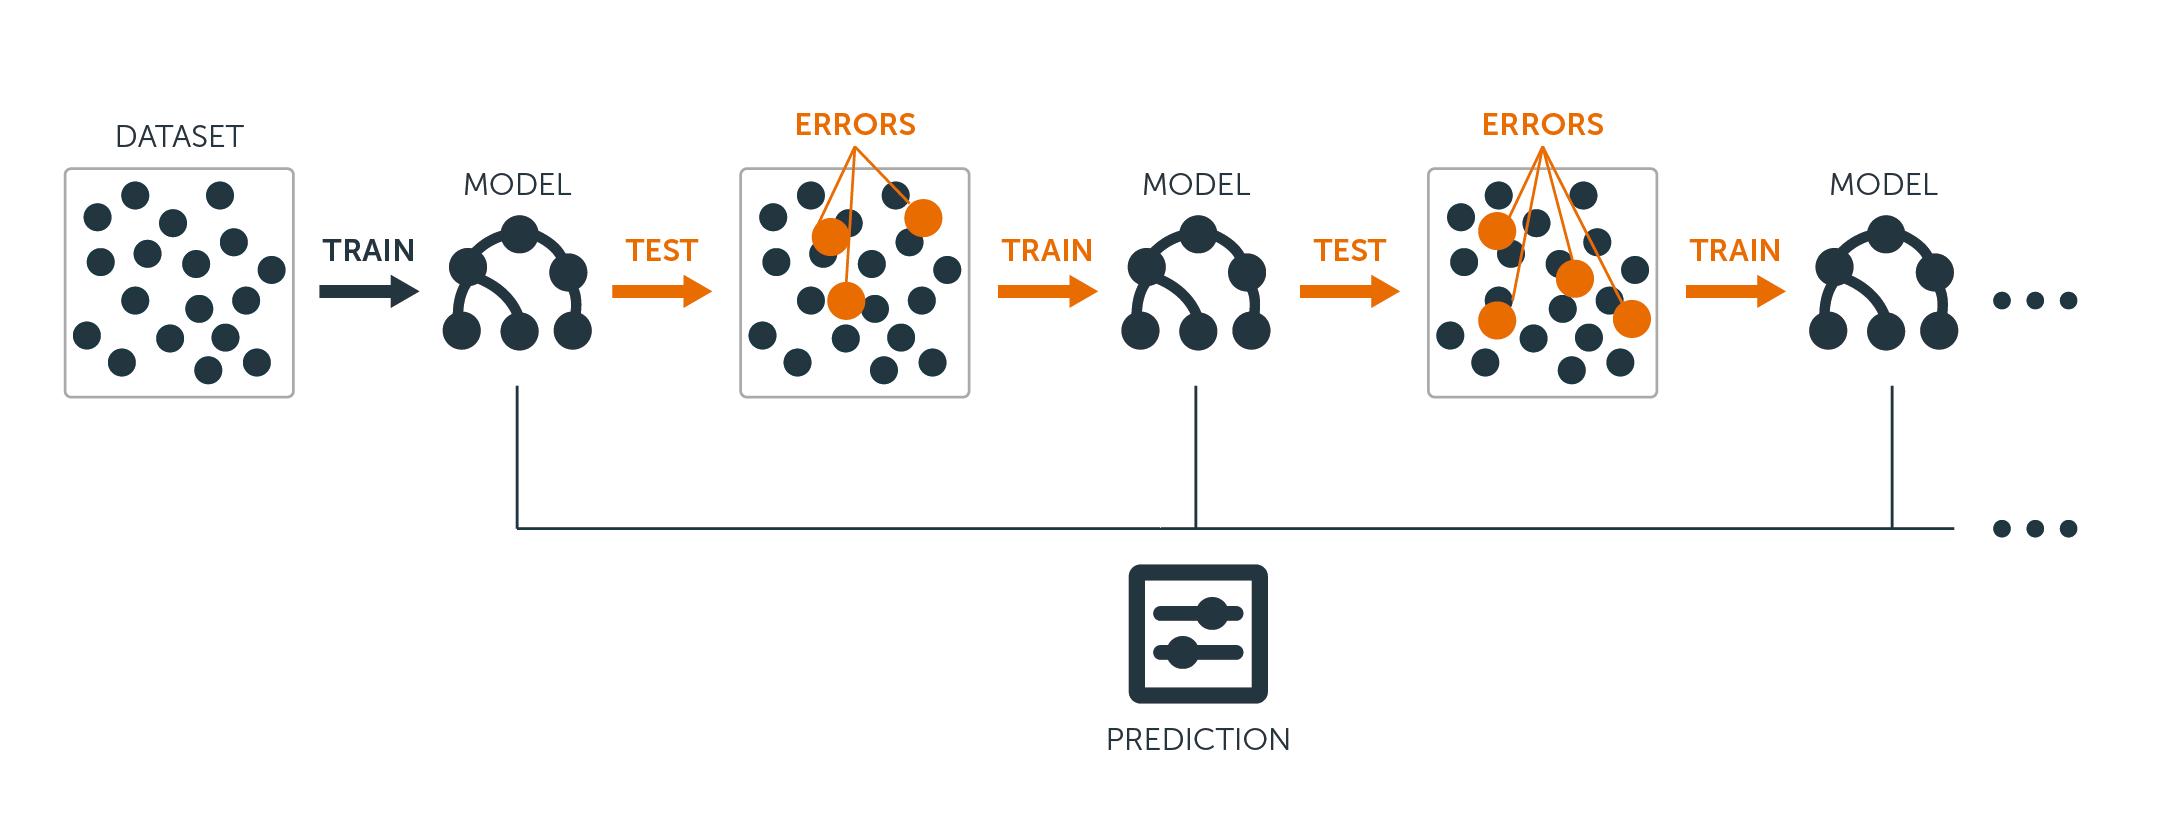
Untuk pohon regresi dan klasifikasi, boosting bekerja seperti ini:
Alih-alih memasang satu pohon keputusan besar pada data, yang berarti fitting keras dan berpotensi overfitting, pendekatan boosting belajar secara perlahan.
Dengan model saat ini, Anda memasang pohon keputusan pada residual dari model. Artinya, Anda memasang pohon menggunakan residual saat ini, bukan outcome $Y$, sebagai respons.
Kemudian Anda menambahkan pohon keputusan baru ini ke fungsi yang sudah dipasang untuk memperbarui residual. Masing-masing pohon ini bisa cukup kecil, dengan hanya beberapa simpul terminal, ditentukan oleh parameter $d$ dalam algoritme. Dengan memasang pohon kecil pada residual, Anda perlahan meningkatkan $\hat{f}$ di area tempat kinerjanya belum baik.
Parameter shrinkage $\nu$ semakin memperlambat proses, memungkinkan lebih banyak pohon dengan bentuk berbeda untuk menyerang residual.
Boosting sangat berguna ketika Anda memiliki banyak data dan memperkirakan pohon keputusan akan sangat kompleks. Boosting telah digunakan untuk menyelesaikan banyak masalah klasifikasi dan regresi yang menantang, termasuk analisis risiko, analisis sentimen, periklanan prediktif, pemodelan harga, estimasi penjualan, dan diagnosis pasien, antara lain.
Intinya, algoritme ini menggabungkan prediksi dari beberapa pohon keputusan untuk meningkatkan kinerja dan stabilitas keseluruhan. Setelah memahami algoritme lanjutan, untuk cakupan tutorial ini, kita akan melanjutkan dengan model pohon keputusan sederhana.
Kita telah mempelajari banyak teori dan intuisi di balik model pohon keputusan dan variasinya, tetapi tidak ada yang mengalahkan praktik langsung membangun model dan mengevaluasi kinerjanya secara bertahap.
Untuk contoh berikut, kita akan menggunakan Boston Housing Dataset yang populer.
Dataset Boston Housing berisi informasi tentang pasar perumahan di Boston, Massachusetts, pada tahun 1970-an. Terdapat 506 observasi dan 14 variabel, termasuk 13 fitur dan 1 variabel target.
Fitur dalam Boston Housing dataset adalah:
Variabel target adalah MEDV yang mewakili nilai median rumah milik (owner-occupied) dalam satuan $1000.
Tujuannya adalah memprediksi nilai median rumah milik (dalam ribuan dolar) berdasarkan fitur yang diberikan.
Di R, data ini tersedia dalam paket bernama “MASS.” Anda harus memasang beberapa paket untuk tutorial ini dan memuatnya. Karena ini akan berulang, mari demontrasikan prosesnya dengan paket MASS sekali, dan Anda akan mengulanginya setiap kali melihat paket baru digunakan dalam panduan ini.
# install the package
install.packages("MASS")

# Load the MASS package
library(MASS)

# Load the Boston Housing dataset
data(Boston)
Sering kali perlu mengeksplorasi data melalui visualisasi dan melakukan langkah pra-pemrosesan sebelum masuk ke pemodelan. Mari lihat distribusi variabel melalui histogram.
Berikut kodenya:
# Load the library
library(tidymodels)
library(tidyr)

# Prepare the dataset for ggplot2
boston_data_long <- Boston %>%
 pivot_longer(cols = everything(),
              names_to = "variable",
              values_to = "value")

# Create a histogram for all numeric variables in one plot
boston_histograms <- ggplot(boston_data_long, aes(x = value)) +
 geom_histogram(bins = 30, color = "black", fill = "lightblue") +
 facet_wrap(~variable, scales = "free", ncol = 4) +
 labs(title = "Histograms of Numeric Variables in the Boston Housing Dataset",
      x = "Value",
      y = "Frequency") +
 theme_minimal()

# Plot the histograms
print(boston_histograms)
Dan keluarannya terlihat seperti ini:

Kita memang melihat beberapa outlier, terutama pada kolom seperti RAD, TAX, dan NOX. Tujuan kita dalam tutorial ini adalah fokus pada tahap pemodelan pohon keputusan; maka mari bagi dataset menjadi set pelatihan dan pengujian.
# Split the data into training and testing sets

set.seed(123)
data_split <- initial_split(Boston, prop = 0.75)
train_data <- training(data_split)
test_data <- testing(data_split)
Sekarang mari masuk ke pemodelan dan evaluasi kinerja model.
Dengan fungsi decision_tree() dari paket Tidymodels di R, membuat spesifikasi model pohon keputusan lalu memasangnya pada data latih menjadi mudah.
# Create a decision tree model specification
tree_spec <- decision_tree() %>%
 set_engine("rpart") %>%
 set_mode("regression")

# Fit the model to the training data
tree_fit <- tree_spec %>%
 fit(medv ~ ., data = train_data)
Kita menggunakan mode “regression” di sini, dan untuk pohon keputusan klasifikasi, kita harus menggunakan mode “classification”.
Untuk mengevaluasi kinerja model, kita akan menggunakan paket Tidymodels untuk menghitung root mean squared error (RMSE) dan nilai R-squared pada data uji.
# Make predictions on the testing data
predictions <- tree_fit %>%
 predict(test_data) %>%
 pull(.pred)

# Calculate RMSE and R-squared
metrics <- metric_set(rmse, rsq)
model_performance <- test_data %>%
 mutate(predictions = predictions) %>%
 metrics(truth = medv, estimate = predictions)

print(model_performance)
Anda akan mendapatkan keluaran yang menampilkan dua metrik kinerja: Root Mean Squared Error (RMSE) dan R-squared (R²).
 .metric .estimator .estimate
 <chr>   <chr>          <dbl>
1 rmse    standard       5.22
2 rsq standard 0.689Jadi, apakah hasil model kita sudah cukup baik?
Kita juga dapat mengoptimalkan hyper-parameter untuk memeras performa lebih lanjut atau beralih ke model yang lebih kompleks seperti Random Forests dan XGBoost dengan konsekuensi berkurangnya interpretabilitas model.
Setelah Anda puas dengan modelnya, saatnya membiarkan model melakukan prediksi.
Caranya sama seperti yang kita lakukan pada data uji dengan fungsi predict(), tetapi kita harus menyediakan data baru yang meniru informasi tentang rumah baru di Boston. Ini adalah skenario yang mungkin terjadi ketika model dijalankan di lingkungan produksi.
# Make predictions on new data
new_data <- tribble(
 ~crim, ~zn, ~indus, ~chas, ~nox, ~rm, ~age, ~dis, ~rad, ~tax, ~ptratio, ~black, ~lstat,
 0.03237, 0, 2.18, 0, 0.458, 6.998, 45.8, 6.0622, 3, 222, 18.7, 394.63, 2.94
)
predictions <- predict(tree_fit, new_data)
print(predictions)
Dan Anda akan mendapatkan nilai median prediksi (dalam $1000) untuk rumah ini:
# A tibble: 1 × 1
 .pred
 <dbl>
1  37.8
Dengan itu, Anda telah dibekali langkah-langkah membangun model pohon keputusan — sekarang mari fokus pada cara menginterpretasikan apa yang terjadi di dalam model untuk Anda sendiri dan pemangku kepentingan yang menggunakan solusi yang baru kita bangun.
Kelebihan paling signifikan, seperti yang telah disebutkan, adalah keterinterpretasian model pohon keputusan. Mari memvisualisasikan pohon keputusan untuk memahami model lebih baik:
# Load the library
library(rpart.plot)

# Plot the decision tree
rpart.plot(tree_fit$fit, type = 4, extra = 101, under = TRUE, cex = 0.8, box.palette = "auto")
Anda akan melihat plot seperti ini:

Diagram keluaran dari fungsi rpart.plot menampilkan representasi pohon keputusan dari model. Dalam diagram ini, setiap simpul merepresentasikan pemisahan pada pohon berdasarkan variabel prediktor. Diagram mencakup beberapa informasi yang membantu kita menginterpretasikan pohon keputusan:
Simpul direpresentasikan oleh lingkaran dan dihubungkan oleh garis, menunjukkan struktur hierarkis pohon keputusan. Pohon dimulai dengan simpul akar di bagian atas, kemudian bercabang ke simpul internal, yang pada akhirnya mengarah ke simpul terminal atau daun di bagian bawah.
Setiap simpul internal menampilkan kriteria pemisahan, yakni variabel prediktor dan nilai yang digunakan untuk membagi data menjadi dua subset.
Contohnya, sebuah simpul mungkin menampilkan “RM < 6.8”, menandakan bahwa observasi dengan rata-rata jumlah kamar per hunian (RM) kurang dari 6,8 akan mengikuti cabang kiri, sedangkan observasi dengan RM lebih besar atau sama dengan 6,8 akan mengikuti cabang kanan.
Nilai n pada setiap simpul mewakili jumlah observasi dalam dataset yang jatuh ke simpul tersebut. Misalnya, jika sebuah simpul menampilkan "n = 100", berarti ada 100 observasi dalam dataset yang memenuhi kriteria dari simpul induknya.
Nilai persentase membantu Anda memahami ukuran relatif setiap simpul dibanding keseluruhan dataset, menunjukkan bagaimana data dipisah dan didistribusikan di seluruh pohon. Persentase yang lebih tinggi berarti proporsi data yang lebih besar mengikuti jalur keputusan menuju simpul tersebut, sementara persentase lebih rendah menunjukkan proporsi lebih kecil.
Nilai prediksi pada setiap simpul ditampilkan sebagai angka dalam lingkaran berwarna (simpul). Dalam pohon regresi, ini adalah nilai rata-rata variabel target untuk semua observasi yang jatuh ke simpul itu.
Misalnya, simpul daun terakhir menampilkan 47 artinya nilai rata-rata variabel target (dalam kasus kita, nilai median rumah milik) untuk semua observasi pada simpul tersebut adalah 47.
Saat menginterpretasikan hasil, mulailah dari simpul akar dan ikuti cabang berdasarkan kriteria pemisahan hingga mencapai simpul terminal. Nilai prediksi pada simpul terminal memberikan prediksi model untuk observasi tertentu serta alasan di balik keputusan tersebut.
Jika Anda lebih suka mengekstrak aturan dalam bentuk teks (alih-alih menelusuri diagram), Anda juga bisa, menggunakan pustaka yang sama dengan yang kita pakai untuk memplot diagram.
Berikut kodenya:
rules <- rpart.rules(tree_fit$fit)
print(rules)
Dan Anda akan melihat keluaran dengan nilai prediksi dan aturan yang diikutinya untuk mencapai nilai tersebut seperti di bawah ini:
medv
  11 when rm <  6.9        & lstat >= 15 & crim >= 7.5
  17 when rm <  6.9        & lstat >= 15 & crim <  7.5
  22 when rm <  6.5        & lstat <  15               & dis >= 1.6
  26 when rm is 6.9 to 7.4 & lstat >=  7
  27 when rm is 6.5 to 6.9 & lstat <  15
  34 when rm <  6.5        & lstat <  15               & dis <  1.6
  34 when rm is 6.9 to 7.4 & lstat <   7
  47 when rm >=        7.4
Kini setelah Anda melihat aturan-aturannya, Anda mungkin bertanya-tanya bagaimana keputusan dapat dibuat hanya dengan 3–4 variabel padahal kita memberikan jauh lebih banyak variabel ke pohon keputusan.
Ternyata beberapa variabel lebih penting daripada yang lain. Mari pahami konsep ini lebih baik.
Kita telah membedah diagram pohon dan cara kerja model. Satu aspek terakhir dari interpretasi adalah memahami variabel penting dari dataset.
Inilah alasannya penting:
Dalam pohon keputusan, pentingnya variabel biasanya ditentukan oleh fitur yang digunakan untuk pemisahan di simpul. Fitur yang digunakan untuk pemisahan lebih awal di pohon atau lebih sering digunakan dapat dianggap lebih penting.
Pentingnya variabel dapat dikuantifikasi oleh pengurangan ukuran impuritas (misalnya, indeks Gini atau mean squared error) yang dihasilkannya saat digunakan untuk pemisahan. Paket “VIP” di R telah menyederhanakan semuanya, dan plotnya dapat diperoleh melalui kode di bawah ini:
# Load the necessary library
library(vip)

# Create a variable importance plot
var_importance <- vip::vip(tree_fit, num_features = 10)
print(var_importance)
Dan Anda akan mendapatkan plot pentingnya variabel seperti di bawah:

Setelah melihat plotnya, Anda dapat melakukan riset lebih lanjut tentang mengapa variabel ini penting dengan berkolaborasi dengan pakar domain. Misalnya, berdasarkan plot di atas, kita dapat menyimpulkan 3 variabel teratas dan rasionalnya:
Jadi, ingatlah untuk memeriksa plot pentingnya variabel sebelum memfinalisasi model; ini dapat membantu Anda membuat dan memilih fitur yang lebih baik untuk mengoptimalkan performa.
Dalam tutorial ini, kita telah mengeksplorasi konsep dasar pohon keputusan dan tidak hanya membangun model tetapi juga menginterpretasikannya. Pohon keputusan adalah model yang kuat dan mudah diinterpretasikan untuk tugas klasifikasi dan regresi, menjadikannya alat penting di gudang data scientist.
Seiring Anda terus mengembangkan keterampilan, kami mendorong Anda untuk menyelami lebih dalam dunia pohon keputusan, mengeksplorasi algoritme alternatif, dan meningkatkan kemampuan pemrograman R Anda. Berikut beberapa sumber untuk langkah berikutnya:
Tanpa keraguan, memperluas pengetahuan dan bereksperimen dengan alat serta teknik baru akan memungkinkan Anda menghadapi beragam tantangan dan memberikan wawasan berharga bagi proyek Anda.
Kursus R
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt



