
Jenis Arsitektur Data Warehouse
Memilih arsitektur data warehouse yang tepat sangat penting untuk memenuhi kebutuhan kinerja, skalabilitas, dan integrasi organisasi Anda. Namun, arsitektur yang berbeda menawarkan keunggulan dan kompromi unik, bergantung pada berbagai faktor. Mari kita bahas di bagian ini.
Arsitektur satu tingkat
Dalam arsitektur satu tingkat, data warehouse dibangun di atas satu basis data terpusat yang mengonsolidasikan semua data dari berbagai sumber ke dalam satu sistem. Arsitektur ini meminimalkan jumlah lapisan dan menyederhanakan desain keseluruhan, sehingga pemrosesan dan akses data menjadi lebih cepat. Namun, arsitektur ini kurang fleksibel dan modular dibandingkan arsitektur yang lebih kompleks.
Arsitektur satu tingkat paling cocok untuk aplikasi skala kecil dan organisasi dengan kebutuhan pemrosesan data terbatas. Ideal bagi bisnis yang mengutamakan kesederhanaan dan implementasi cepat dibandingkan skalabilitas. Namun, seiring peningkatan volume data atau kebutuhan analitik yang lebih maju, arsitektur ini mungkin kesulitan memenuhi tuntutan tersebut secara efektif.
Arsitektur dua tingkat
Dalam arsitektur dua tingkat, data warehouse terhubung langsung ke alat BI, sering kali melalui sistem OLAP. Meskipun pendekatan ini menyediakan akses data yang lebih cepat untuk analisis, arsitektur ini dapat menghadapi tantangan dalam menangani volume data yang lebih besar karena skalanya menjadi sulit akibat koneksi langsung antara warehouse dan alat BI.
Arsitektur dua tingkat paling cocok untuk organisasi kecil hingga menengah yang membutuhkan akses data lebih cepat untuk analisis tetapi tidak memerlukan skalabilitas arsitektur yang lebih besar dan kompleks. Ideal bagi bisnis dengan volume data sedang dan kebutuhan pelaporan atau analitik yang relatif sederhana karena memungkinkan integrasi langsung antara data warehouse dan alat business intelligence.
Namun, saat data bertambah atau kebutuhan analitik menjadi lebih canggih, arsitektur ini mungkin kesulitan untuk skala dan menangani beban kerja yang meningkat secara efisien.
Arsitektur tiga tingkat
Arsitektur tiga tingkat adalah model yang paling umum dan banyak digunakan untuk data warehouse. Model ini memisahkan sistem ke dalam lapisan yang berbeda: lapisan sumber data, lapisan staging area, dan lapisan analitik. Pemisahan ini memungkinkan proses ETL yang efisien, diikuti dengan analitik dan pelaporan.
Arsitektur tiga tingkat ideal untuk lingkungan perusahaan skala besar yang memerlukan skalabilitas, fleksibilitas, dan kemampuan menangani volume data masif. Ini memungkinkan bisnis mengelola data dengan lebih efisien serta mendukung analitik tingkat lanjut, machine learning, dan pelaporan real-time. Pemisahan lapisan meningkatkan kinerja, menjadikannya cocok untuk lingkungan data yang kompleks.
Arsitektur data warehouse berbasis cloud
Dalam arsitektur data warehouse berbasis cloud, seluruh infrastruktur dihosting pada platform seperti Amazon Redshift, Google BigQuery, atau Snowflake. Arsitektur berbasis cloud menawarkan skalabilitas nyaris tanpa batas, dengan kemampuan menangani kumpulan data besar tanpa perlu perangkat keras lokal. Arsitektur ini juga menyediakan fleksibilitas biaya melalui model bayar sesuai pemakaian, sehingga dapat diakses oleh rentang bisnis yang lebih luas.
Arsitektur data warehouse berbasis cloud ideal untuk organisasi dari segala ukuran. Pendekatan ini ideal bagi bisnis yang mencari solusi fleksibel dan skalabel karena memungkinkan perusahaan menskalakan sumber daya penyimpanan dan komputasi secara dinamis.
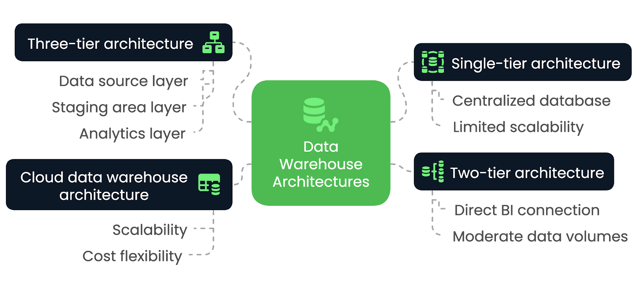
Perbandingan arsitektur data warehouse—gambar oleh Penulis.
Pola Desain Arsitektur Data Warehouse
Ada cukup banyak pola desain data warehouse, namun masing-masing melayani kebutuhan yang berbeda tergantung kompleksitas data dan jenis kueri yang dijalankan. Mari jelajahi beberapa yang paling umum dan pahami skenario paling tepat untuk menggunakannya demi efisiensi maksimal.
Skema bintang (star schema)
Star schema adalah salah satu pola desain data warehouse yang paling umum digunakan. Pola ini menata data menjadi:
- Tabel fakta pusat – Menyimpan data kuantitatif, seperti:
- Pendapatan penjualan
- Unit terjual
- Tabel dimensi di sekelilingnya – Berisi atribut deskriptif, termasuk:
- Detail produk (mis., nama produk, kategori)
- Informasi pelanggan (mis., ID pelanggan, demografi)
- Lokasi toko
- Periode waktu
Dalam skenario ritel, tabel fakta menyimpan data penjualan transaksional, sementara tabel dimensi menyediakan konteks tentang produk, pelanggan, toko, dan waktu. Skema ini meningkatkan kinerja kueri, sehingga ideal untuk lingkungan dengan kebutuhan pelaporan yang sering dan lugas.
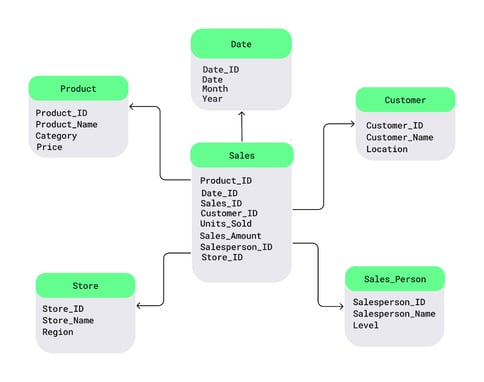
Contoh skema bintang. Sumber gambar: DataCamp.
Skema snowflake
Skema snowflake adalah pengembangan dari star schema, dengan menambahkan normalisasi pada tabel dimensi. Karakteristik utamanya mencakup:
- Tabel dimensi ternormalisasi – Tabel dimensi dipecah menjadi sub-dimensi untuk mengurangi redundansi.
- Efisiensi penyimpanan meningkat – Lebih sedikit data duplikat dibandingkan star schema.
- Kueri lebih kompleks – Join antar banyak tabel dapat memperlambat kinerja kueri.
Skema ini ideal untuk:
- Optimasi penyimpanan – Berguna saat pengurangan redundansi menjadi prioritas.
- Kumpulan data kompleks – Bermanfaat untuk data dengan banyak atribut yang perlu dinormalisasi.
- Lingkungan hemat biaya – Dipilih saat biaya penyimpanan tinggi.
- Kueri analitik mendetail – Mendukung analisis mendalam dengan konsekuensi kecepatan kueri.
Walau skema snowflake menghemat penyimpanan, skema ini dapat menyebabkan kueri yang lebih rumit karena strukturnya yang sangat terstruktur.
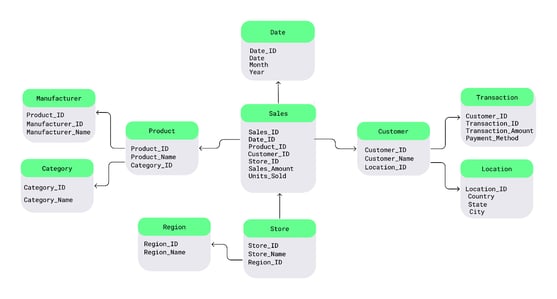
Contoh skema snowflake. Sumber gambar: DataCamp.
Pemodelan data vault
Pemodelan data vault adalah pola desain yang lebih baru dengan fokus pada fleksibilitas, skalabilitas, dan pelacakan data historis. Pendekatan ini membagi data warehouse menjadi tiga komponen inti:
- Hub (menyimpan entitas bisnis kunci)
- Link (mewakili hubungan antar entitas)
- Satellite (menyimpan atribut deskriptif)
Pendekatan ini sangat mudah beradaptasi terhadap perubahan proses bisnis, sehingga sangat cocok untuk lingkungan pengembangan yang agile.
Pola desain data vault kian populer karena kemampuannya menangani lingkungan data yang berkembang, mengakomodasi perubahan sumber data, dan mendukung skalabilitas jangka panjang. Ini menjadi solusi ideal bagi organisasi yang memerlukan pelacakan historis terperinci, perubahan skema yang sering, atau arsitektur yang sangat skalabel.
Praktik Terbaik untuk Membangun Arsitektur Data Warehouse
Menerapkan praktik terbaik sejak awal sangat penting untuk membangun arsitektur yang tangguh. Karena itu, bagian ini membahas beberapa praktik terbaik yang perlu diikuti saat membangun data warehouse berkinerja tinggi.
Rencanakan skalabilitas
Volume data dan kebutuhan bisnis pasti akan tumbuh seiring waktu, jadi penting memastikan arsitektur yang Anda pilih dapat menangani beban kerja yang meningkat. Ini dapat dilakukan dengan menggunakan solusi penyimpanan yang skalabel, seperti platform cloud, dan mempartisi tabel besar untuk kinerja yang lebih baik.
Optimalkan proses ETL
Sederhanakan pipeline ETL dengan meminimalkan transformasi data yang tidak perlu, memanfaatkan strategi pemuatan inkremental, dan menjalankan tugas ETL secara paralel bila memungkinkan. Ini memastikan data diambil, ditransformasikan, dan dimuat dengan cepat tanpa hambatan.
Pastikan kualitas dan konsistensi data
Memelihara kualitas data yang tinggi adalah hal yang mendasar bagi nilai sebuah data warehouse. Terapkan prosedur validasi data dan deduplikasi yang kuat untuk memastikan data yang masuk akurat dan konsisten. Audit dan pemeriksaan kualitas rutin harus menjadi bagian dari pipeline ETL untuk mencegah masalah yang dapat menyebabkan analisis yang keliru.
Fokus pada keamanan dan kepatuhan data
Keamanan data harus menjadi prioritas utama – terutama saat menangani informasi sensitif atau yang diatur. Ada tiga langkah penting yang harus Anda ambil:
- Terapkan enkripsi untuk data saat disimpan (at rest) dan saat transit.
- Terapkan kontrol akses berbasis peran untuk membatasi akses data hanya kepada pengguna yang berwenang.
- Pastikan arsitektur memenuhi standar regulasi (mis., GDPR, HIPAA, kebutuhan spesifik industri).
Pantau kinerja dan penggunaan
Untuk menjaga data warehouse tetap beroperasi secara efisien, pantau secara berkala hal-hal berikut:
- Kinerja kueri
- Pola akses pengguna
- Pemanfaatan penyimpanan
Alat pelacakan kinerja dapat membantu mengidentifikasi hambatan, sehingga Anda dapat melakukan penyesuaian proaktif jika diperlukan.
Arsitektur Data Warehouse Cloud vs. On-Premises
Haruskah Anda memilih data warehouse berbasis cloud atau mempertahankan semuanya di on-premise? Apa manfaat utama dan kompromi dari masing-masing pendekatan? Dan apakah solusi hibrida menjadi pilihan terbaik dari keduanya?
Di bagian ini, kita akan membahas pertanyaan-pertanyaan tersebut dan membantu Anda menentukan arsitektur yang tepat untuk kebutuhan Anda.
Arsitektur berbasis cloud
Data warehouse berbasis cloud memberikan skalabilitas dan fleksibilitas yang tak tertandingi. Platform-platform ini memungkinkan bisnis menskalakan sumber daya penyimpanan dan komputasi sesuai permintaan, menjadikannya ideal untuk menangani volume data besar dan dinamis tanpa biaya infrastruktur di awal.
Model harga bayar sesuai pemakaian juga membuat solusi cloud hemat biaya, terutama bagi bisnis dengan beban kerja yang berfluktuasi. Namun, lingkungan cloud dapat menimbulkan kekhawatiran tentang tata kelola dan kepatuhan data, terutama untuk industri yang sangat teregulasi.
Vendor cloud populer meliputi:
- Amazon Web Services (Redshift)
- Google Cloud (BigQuery)
- Microsoft Azure (Azure Synapse Analytics)
Arsitektur on-premises
Data warehouse on-premises paling cocok untuk organisasi yang memerlukan kontrol data yang ketat. Dengan arsitektur on-premises, perusahaan mempertahankan kendali penuh atas perangkat keras dan data mereka, yang penting bagi industri seperti keuangan, kesehatan, dan pemerintahan, di mana informasi sensitif harus dilindungi.
Namun ada catatannya. Meskipun sistem on-premises dapat menawarkan performa yang kuat, sistem ini sering kali membutuhkan biaya awal tinggi untuk perangkat keras dan pemeliharaan berkelanjutan. Skalabilitas juga menantang karena memerlukan peningkatan manual dan pengadaan perangkat keras, yang kurang fleksibel dibandingkan solusi cloud.
Arsitektur hibrida
Arsitektur data warehouse hibrida menggabungkan komponen cloud dan on-premises, menawarkan fleksibilitas lebih besar bagi organisasi yang perlu menyeimbangkan keamanan, kepatuhan, dan skalabilitas. Misalnya, data sensitif dapat disimpan on-premises, sementara data yang kurang kritis atau beban kerja analitik dapat diproses di cloud.
Arsitektur hibrida sangat berguna bagi bisnis yang perlu bertransisi ke cloud secara bertahap atau memiliki persyaratan privasi data yang spesifik. Model ini memberikan keunggulan dari kedua dunia, tetapi memerlukan orkestrasi yang cermat untuk memastikan integrasi data yang mulus antar lingkungan.
Tabel ringkasan: Arsitektur data warehouse cloud vs. on-premises vs. hibrida
|
Fitur |
Arsitektur Berbasis Cloud |
Arsitektur On-premises |
Arsitektur Hibrida |
|
Skalabilitas |
Sangat skalabel, alokasi sumber daya sesuai permintaan |
Dibatasi perangkat keras lokal, memerlukan peningkatan manual |
Menggabungkan sumber daya cloud yang skalabel dengan kendali on-premises |
|
Biaya |
Bayar sesuai pemakaian, biaya awal lebih rendah |
Investasi awal tinggi untuk perangkat keras dan pemeliharaan berkelanjutan |
Biaya hibrida, menyeimbangkan penghematan cloud dan pengeluaran on-premises |
|
Fleksibilitas |
Sangat fleksibel, ideal untuk beban kerja dinamis |
Kurang fleksibel, terbatasi infrastruktur fisik |
Fleksibel, menggabungkan kelincahan cloud dengan kendali on-prem |
|
Keamanan & Kepatuhan |
Dapat menimbulkan kekhawatiran untuk industri yang sangat teregulasi |
Kendali penuh atas keamanan data dan kepatuhan regulasi |
Memastikan kepatuhan untuk data sensitif sambil memanfaatkan cloud |
|
Performa |
Dapat bervariasi tergantung penyedia cloud dan konfigurasinya |
Performa tinggi tetapi bergantung pada investasi perangkat keras |
Performa seimbang bergantung distribusi beban kerja |
|
Pemeliharaan |
Pemeliharaan minimal, dikelola oleh penyedia cloud |
Memerlukan pemeliharaan TI internal yang berkelanjutan |
Pendekatan hibrida dengan sebagian pemeliharaan ditangani layanan cloud |
|
Use case |
Terbaik untuk bisnis dengan volume data besar dan berfluktuasi |
Terbaik untuk organisasi dengan kebutuhan keamanan dan kepatuhan yang ketat |
Ideal untuk organisasi yang bertransisi ke cloud atau dengan kebutuhan campuran |
Platform Data Warehouse Cloud Populer
Berikut gambaran beberapa platform data warehouse paling populer yang digunakan di cloud.
Amazon Redshift
Amazon Redshift adalah solusi data warehouse cloud yang sepenuhnya dikelola untuk analitik data skala besar. Arsitekturnya didasarkan pada sistem pemrosesan paralel masif, yang memungkinkan pengguna mengkueri kumpulan data yang sangat besar dengan cepat. Dengan kemampuannya untuk skala naik dan turun sesuai kebutuhan beban kerja, Redshift sangat cocok untuk organisasi yang memerlukan skalabilitas hemat biaya dan integrasi dengan layanan AWS lainnya.
Google BigQuery
Google BigQuery adalah platform data warehouse tanpa server (serverless) yang sangat skalabel untuk analitik cepat dan real-time. Arsitekturnya yang unik memisahkan penyimpanan dan komputasi, memungkinkan pengguna mengkueri data berukuran petabyte tanpa mengelola infrastruktur. Kemampuan BigQuery memproses analitik skala besar dengan overhead minimal menjadikannya ideal bagi organisasi dengan beban kerja data berat yang menuntut kueri cepat dan kompleks.
Snowflake
Snowflake menawarkan arsitektur berbagi data multi-kluster yang memisahkan komputasi dan penyimpanan, memberikan fleksibilitas untuk menskalakan sumber daya secara independen. Pendekatan cloud-native Snowflake memungkinkan bisnis menskalakan beban kerja secara dinamis, sehingga menjadi opsi menarik bagi organisasi yang membutuhkan fleksibilitas tinggi dan manajemen beban kerja lintas berbagai platform cloud.
Microsoft Azure Synapse
Microsoft Azure Synapse Analytics adalah platform manajemen data hibrida yang menggabungkan data warehousing dan big data analytics. Arsitekturnya terintegrasi dengan kerangka kerja big data seperti Apache Spark untuk menyediakan lingkungan terpadu dalam mengelola data lake dan data warehouse. Azure Synapse menawarkan integrasi mulus dengan layanan Microsoft lainnya dan ideal bagi bisnis dengan kebutuhan analitik data yang beragam.
Tabel ringkasan: Platform data warehouse
|
Platform |
Arsitektur |
Fitur Utama |
Use case |
|
Amazon Redshift |
Arsitektur MPP, ekosistem AWS |
Skalabel, kueri cepat, integrasi AWS |
Analitik skala besar, aplikasi cloud-native |
|
Google BigQuery |
Serverless, penyimpanan dan komputasi terpisah |
Analitik real-time, infrastruktur minimal |
Analitik cepat, pemrosesan data real-time |
|
Snowflake |
Arsitektur multi-kluster berbagi data, lintas cloud (AWS, Azure, GCP) |
Pemisahan komputasi-penyimpanan, penskalaan dinamis |
Skalabilitas fleksibel, beban kerja lintas platform cloud |
|
Azure Synapse |
Hibrida, integrasi big data |
Analitik terpadu, integrasi Spark |
Manajemen data hibrida, integrasi dengan alat Microsoft |
Tantangan dalam Arsitektur Data Warehouse
Walau data warehouse menyediakan kemampuan kuat bagi organisasi untuk menganalisis dan mengelola data dalam jumlah besar, arsitektur ini juga memiliki tantangan bawaan.
Berikut beberapa tantangan paling signifikan dan solusinya yang perlu dipertimbangkan saat merancang dan memelihara arsitektur data warehouse.
Integrasi data dari beragam sumber
Organisasi mengumpulkan data dari banyak sumber, masing-masing dengan format, skema, dan struktur yang berbeda, sehingga integrasi menjadi tantangan yang kompleks. Pertimbangan kunci meliputi:
- Mencampur data terstruktur dan tidak terstruktur – Mengombinasikan catatan basis data relasional dengan log, aliran media sosial, atau data sensor memerlukan transformasi yang cermat.
- Transformasi dan pembersihan data yang ekstensif – Data mentah sering perlu dibersihkan, diformat, dan distandardisasi sebelum dapat digunakan secara efektif.
- Lingkungan hibrida – Menyinkronkan data antara sistem on-premises dan platform cloud menambah lapisan kompleksitas lain.
Untuk mengatasi tantangan ini, bisnis memerlukan proses ETL yang fleksibel dan alat manajemen data yang mendukung beragam format data serta integrasi mulus lintas platform.
Kinerja pada skala besar
Seiring pertumbuhan data warehouse, menjaga kinerja kueri yang tinggi menjadi tantangan. Operasi skala besar harus memproses jutaan—bahkan miliaran—baris secara efisien sambil menghindari kueri lambat, biaya tinggi, dan penggunaan sumber daya yang tidak efisien.
Strategi optimasi kunci meliputi:
- Pengindeksan data – Mempercepat pengambilan data dengan membuat jalur pencarian terstruktur.
- Partisi – Mengorganisasikan data menjadi segmen yang lebih kecil dan mudah dikelola untuk kueri yang lebih cepat.
- Materialized view – Menyimpan hasil kueri yang telah dihitung sebelumnya untuk mengurangi waktu pemrosesan.
- Format penyimpanan kolumnar (mis., Parquet, ORC) – Meningkatkan kinerja baca untuk kueri analitik.
- Mesin optimasi kueri – Memperbaiki rencana eksekusi untuk kinerja yang lebih cepat.
Manajemen beban kerja
Saat lebih banyak pengguna mengakses data warehouse, alokasi sumber daya yang efisien menjadi krusial. Pertimbangan kunci meliputi:
- Manajemen konkurensi – Mencegah kemacetan kinerja saat banyak kueri berjalan bersamaan.
- Penskalaan dinamis – Warehouse berbasis cloud secara otomatis menyesuaikan sumber daya untuk memenuhi permintaan.
- Penanganan perebutan sumber daya – Sistem on-premises atau hibrida harus mengelola CPU, memori, dan disk secara cermat untuk menghindari perlambatan.
Dengan menerapkan strategi ini, organisasi dapat memastikan data warehouse mereka dapat diskalakan secara efektif dan mempertahankan kinerja tinggi seiring pertumbuhan volume data dan aktivitas pengguna.
Tata kelola dan keamanan data
Seiring data warehouse menyimpan semakin banyak informasi sensitif, langkah tata kelola dan keamanan yang kuat sangat penting untuk mencegah pelanggaran, memastikan kepatuhan, dan menjaga integritas data.
- Menerapkan kebijakan tata kelola yang konsisten
- Terapkan kontrol akses berbasis peran (RBAC) untuk membatasi akses data.
- Kelola katalog data untuk melacak lineage, kepemilikan, dan penggunaan data.
- Kepatuhan regulasi (GDPR, CCPA, HIPAA, dll.)
- Lindungi data pribadi dengan teknik anonimisasi dan masking.
- Terapkan kebijakan retensi data untuk memenuhi persyaratan hukum.
- Enkripsi dan praktik keamanan terbaik
- Enkripsi data saat disimpan dan saat transit untuk mencegah akses tidak sah.
- Kelola log audit terperinci untuk melacak akses ke data sensitif.
- Keamanan di lingkungan hibrida dan cloud
- Kelola kunci enkripsi secara efektif di sistem on-premises dan cloud.
- Amankan lalu lintas jaringan antara sistem cloud dan on-prem.
- Pastikan kepatuhan terhadap kebijakan keamanan penyedia pihak ketiga.
Kesimpulan
Dalam artikel ini, kita membahas komponen kunci arsitektur data warehouse, tantangan umum, dan strategi untuk mengatasinya. Pada akhirnya, data warehouse yang dirancang dengan baik tidak sekadar menyimpan data—tetapi memberdayakan organisasi untuk membuat keputusan berbasis data yang mendorong pertumbuhan dan inovasi.
Ingin menggali lebih dalam arsitektur data dan praktik terbaik? Lihat sumber daya berikut:
- Understanding Data Engineering – Pelajari dasar-dasar rekayasa data dan perannya dalam ekosistem data modern.
- Data Warehousing Concepts – Dapatkan wawasan tentang prinsip dan desain inti data warehousing.
- Understanding Modern Data Architecture – Jelajahi bagaimana arsitektur data berevolusi di era cloud.
- Database Design – Kuasai dasar-dasar merancang basis data yang efisien dan skalabel.
- ETL and ELT in Python – Pelajari cara membangun pipeline ETL/ELT yang efektif menggunakan Python.
FAQ
Apa perbedaan data warehouse dengan database?
Database dirancang untuk pemrosesan transaksional (OLTP), menangani operasi real-time seperti menyisipkan dan memperbarui catatan. Data warehouse, di sisi lain, dioptimalkan untuk pemrosesan analitik (OLAP), yang memungkinkan kueri kompleks dan analisis data historis.
Bagaimana data warehouse mendukung analitik real-time?
Data warehouse tradisional memproses pembaruan batch, tetapi arsitektur cloud modern (mis., Snowflake, BigQuery) memungkinkan analitik real-time dengan mengintegrasikan data streaming melalui alat seperti Apache Kafka, AWS Kinesis, atau Google Pub/Sub.
Apa peran metadata dalam data warehouse?
Metadata menyediakan informasi penting tentang struktur, garis keturunan, dan definisi data yang disimpan di warehouse. Metadata memastikan konsistensi, meningkatkan tata kelola data, dan membantu pengguna menemukan kumpulan data yang tepat secara efisien.
Dapatkah data warehouse menangani data tidak terstruktur?
Data warehouse terutama menyimpan data terstruktur, tetapi dapat mengintegrasikan format semi-terstruktur (mis., JSON, XML, Parquet). Namun, untuk data yang benar-benar tidak terstruktur (mis., gambar, video, teks mentah), organisasi sering menggunakan data lake bersama data warehouse.
Apa itu surrogate key, dan mengapa digunakan dalam desain data warehouse?
Surrogate key adalah pengidentifikasi unik yang dihasilkan sistem dan digunakan di tabel fakta dan dimensi sebagai pengganti kunci natural (seperti ID pelanggan atau kode produk). Surrogate key meningkatkan kinerja, konsistensi, dan fleksibilitas dalam desain skema.
Bagaimana materialized view meningkatkan kinerja data warehouse?
Materialized view menyimpan hasil kueri yang telah dihitung sebelumnya, sehingga mengurangi waktu pemrosesan untuk kueri berulang. Ini secara signifikan meningkatkan kinerja, terutama pada kueri analitik yang teragregasi atau kompleks.
Bagaimana data warehouse terintegrasi dengan AI dan machine learning?
Banyak warehouse modern mendukung beban kerja ML dan AI dengan menawarkan:
- Fungsi ML bawaan (mis., BigQuery ML, Redshift ML)
- Integrasi dengan kerangka kerja ML (mis., TensorFlow, PyTorch, Scikit-learn)
- Feature store yang memungkinkan analis menyajikan data terstruktur ke model ML secara efisien
Apa itu Slowly Changing Dimensions (SCD) dalam data warehouse?
SCD melacak perubahan historis dalam tabel dimensi. Jenis yang paling umum mencakup:
- SCD Tipe 1 – Menimpa data lama dengan data baru.
- SCD Tipe 2 – Menyimpan data historis dengan menambahkan catatan baru.
- SCD Tipe 3 – Mempertahankan riwayat terbatas menggunakan kolom tambahan.




Membangun arsitektur data warehouse yang solid sangat penting untuk menangani kumpulan data yang besar dan kompleks. Seiring pertumbuhan data, bisnis memerlukan pendekatan terstruktur untuk menyimpan, mengelola, dan menganalisis informasi secara efisien.
Tanpa arsitektur yang tepat, Anda dapat menemui kueri yang lambat, data yang tidak konsisten, dan tantangan yang membuat pengambilan keputusan lebih rumit daripada seharusnya.
Dalam artikel ini, saya akan memandu Anda melalui komponen-komponen kunci dari sebuah data warehouse, berbagai tipe arsitektur, serta praktik terbaik untuk membantu Anda merancang sistem yang sekaligus skalabel dan efisien. Baik Anda membangun data warehouse baru maupun mengoptimalkan yang sudah ada, memahami prinsip-prinsip ini akan mempersiapkan Anda untuk sukses.
Komponen Arsitektur Data Warehouse
Data warehouse yang dirancang dengan baik dibangun dari serangkaian komponen yang saling terhubung. Komponen-komponen ini bekerja sama untuk memproses data dari berbagai sumber, mentransformasikannya untuk analisis, dan menyediakannya kepada pengguna dalam format terstruktur. Di bawah ini, kita bahas blok bangunan penting dari arsitektur data warehouse.
Sumber data
Data warehouse mengumpulkan informasi dari berbagai sumber, termasuk data terstruktur dari basis data relasional dan data tidak terstruktur seperti log atau berkas teks. Sumber data umum meliputi:
Dengan mengintegrasikan beragam sumber ini ke dalam satu sistem, bisnis memperoleh pandangan yang lengkap dan terpadu atas operasional mereka.
Lapisan ETL
Proses ETL (atau ELT) merupakan komponen kunci dari arsitektur data warehouse. Ini mencakup:
Dalam ETL, data ditransformasikan sebelum dimuat, sedangkan dalam ELT, data mentah dimuat terlebih dahulu lalu ditransformasikan di dalam warehouse. ELT sering dipilih untuk warehouse berbasis cloud modern karena keunggulan skalabilitas dan kinerjanya.
Staging area
Staging area adalah ruang penyimpanan sementara dan opsional tempat data mentah disimpan sebelum diproses dan dimuat ke dalam data warehouse. Lapisan ini bertindak sebagai penyangga agar transformasi data dapat berlangsung tanpa langsung memengaruhi penyimpanan data utama.
Lapisan penyimpanan data
Inti dari data warehouse adalah lapisan penyimpanan, tempat data diorganisasikan ke dalam tabel fakta dan dimensi:
Data biasanya ditata dalam skema bintang (star) atau serpihan salju (snowflake) untuk mengoptimalkan kinerja kueri dan analisis.
Lapisan metadata
Lapisan metadata mengelola dan memelihara struktur serta relasi di dalam data warehouse. Intinya, metadata menyediakan informasi tentang sumber data, skema, dan transformasi. Ini memungkinkan pengguna dan sistem memahami konteks, garis keturunan data, dan penggunaan data di dalam warehouse.
Lapisan akses data dan analitik
Lapisan ini memungkinkan pengguna mengambil dan menganalisis data dari warehouse. Biasanya mencakup:
Sementara pelaporan dasar dan dasbor termasuk dalam akses data tradisional, alur kerja machine learning dan analitik prediktif yang lebih kompleks kadang dikategorikan terpisah sebagai lapisan analitik karena kebutuhan komputasi yang lebih lanjut.