
Typen datawarehouse-architectuur
De juiste datawarehouse-architectuur kiezen is essentieel om te voldoen aan de prestatie-, schaalbaarheids- en integratiebehoeften van je organisatie. Verschillende architecturen bieden echter unieke voordelen en afruilen, afhankelijk van diverse factoren. Laten we ze in dit onderdeel verkennen.
Eénlaagse architectuur
Bij een éénlaagse architectuur is het datawarehouse gebouwd op één gecentraliseerde database die alle data uit verschillende bronnen in één systeem consolideert. Deze architectuur minimaliseert het aantal lagen en vereenvoudigt het algehele ontwerp, wat leidt tot snellere dataverwerking en -toegang. Het mist echter de flexibiliteit en modulariteit van complexere architecturen.
De éénlaagse architectuur is het meest geschikt voor kleinschalige toepassingen en organisaties met beperkte dataverwerkingsbehoeften. Het is ideaal voor bedrijven die eenvoud en snelle implementatie boven schaalbaarheid verkiezen. Naarmate het datavolume toeneemt of geavanceerdere analytics nodig zijn, kan deze architectuur echter moeite hebben om aan die eisen te voldoen.
Tweelaagse architectuur
In een tweelaagse architectuur maakt het datawarehouse rechtstreeks verbinding met BI-tools, vaak via een OLAP-systeem. Dit biedt snellere toegang tot data voor analyse, maar kan uitdagingen hebben bij grotere datavolumes, omdat opschalen lastig wordt door de directe koppeling tussen warehouse en BI-tools.
De tweelaagse architectuur is vooral geschikt voor kleine tot middelgrote organisaties die snellere data-toegang voor analyses nodig hebben, maar niet de schaalbaarheid vereisen van grotere, complexere architecturen. Het is ideaal voor bedrijven met middelgrote datavolumes en relatief eenvoudige rapportage- of analysenoden, omdat het directe integratie tussen het datawarehouse en BI-tools mogelijk maakt.
Naarmate data groeit of analytische vereisten geavanceerder worden, kan deze architectuur echter moeite hebben met schalen en toenemende workloads efficiënt verwerken.
Drielagige architectuur
De drielagige architectuur is het meest voorkomende en breed toegepaste model voor datawarehouses. Het scheidt het systeem in afzonderlijke lagen: de databronnenlaag, de staginglaag en de analyticslaag. Deze scheiding maakt efficiënte ETL-processen mogelijk, gevolgd door analytics en rapportage.
De drielagige architectuur is ideaal voor grootschalige enterprise-omgevingen die schaalbaarheid, flexibiliteit en de verwerking van enorme datavolumes vereisen. Het stelt bedrijven in staat data efficiënter te beheren en ondersteunt geavanceerde analytics, machine learning en realtime rapportage. Het scheiden van lagen verhoogt de prestaties, waardoor het geschikt is voor complexe dataomgevingen.
Cloud-datawarehouse-architectuur
Bij een cloud-datawarehouse-architectuur draait de volledige infrastructuur op platforms zoals Amazon Redshift, Google BigQuery of Snowflake. Cloudgebaseerde architecturen bieden vrijwel onbeperkte schaalbaarheid en kunnen grote datasets aan zonder on-premises hardware. Ze bieden ook kostenflexibiliteit via pay-as-you-go-modellen, waardoor ze toegankelijk zijn voor een breder scala aan bedrijven.
Cloud-datawarehouse-architectuur is ideaal voor organisaties van elke omvang. Het is perfect voor bedrijven die een flexibele en schaalbare oplossing zoeken, omdat deze aanpak het dynamisch schalen van opslag- en computebronnen mogelijk maakt.
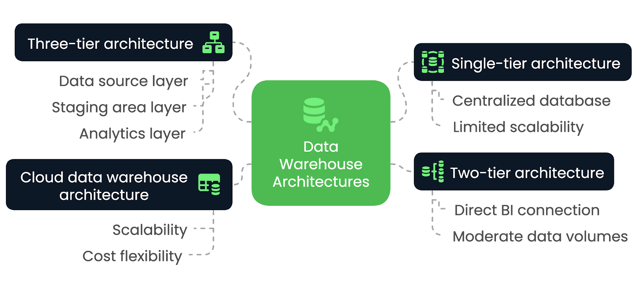
Datawarehouse-architecturen vergeleken—afbeelding door de auteur.
Designpatronen voor datawarehouse-architectuur
Er zijn behoorlijk wat designpatronen voor datawarehouses, maar elk voorziet in andere behoeften afhankelijk van de complexiteit van de data en het type queries. Laten we de meest gangbare bekijken en bepalen in welke scenario’s je ze het beste inzet voor maximale efficiëntie.
Sterschema
Het sterschema is een van de meest gebruikte designpatronen voor datawarehouses. Het structureert data in:
- Een centrale facttabel – Slaat kwantitatieve data op, zoals:
- Omzet uit verkoop
- Aantal verkochte eenheden
- Omringende dimensietabellen – Bevatten beschrijvende attributen, waaronder:
- Productdetails (bijv. productnaam, categorie)
- Klantinformatie (bijv. klant-ID, demografie)
- Winkellocaties
- Tijdperiodes
In een retailsituatie bevat de facttabel transactionele verkoopdata, terwijl dimensietabellen context geven over producten, klanten, winkels en tijd. Dit schema verbetert de queryprestaties en is ideaal voor omgevingen met frequente, rechttoe rechtaan rapportagebehoeften.
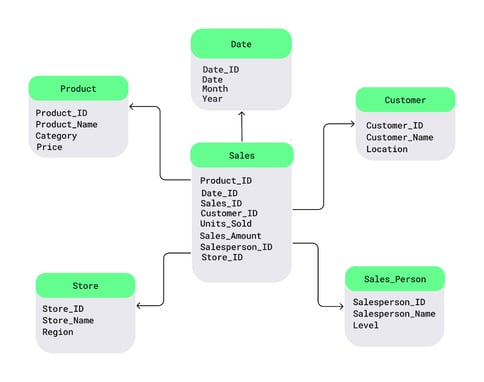
Voorbeeld van een sterschema. Afbeelding bron: DataCamp.
Sneeuwvlokschema
Het sneeuwvlokschema is een uitbreiding op het sterschema en introduceert extra normalisatie in dimensietabellen. Belangrijke kenmerken zijn onder meer:
- Genormaliseerde dimensietabellen – Dimensietabellen worden opgesplitst in subdimensies om redundantie te verminderen.
- Betere opslagefficiëntie – Minder dubbele data dan bij het sterschema.
- Complexere queries – Joins tussen meerdere tabellen kunnen de queryprestaties vertragen.
Dit schema is ideaal voor:
- Opslagoptimalisatie – Handig wanneer het verminderen van redundantie prioriteit heeft.
- Complexe datasets – Nuttig bij data met veel attributen die normalisatie vereisen.
- Kostengevoelige omgevingen – Gewenst wanneer opslagkosten hoog zijn.
- Gedetailleerde analytische queries – Ondersteunt diepgaande analyses ten koste van querysnelheid.
Hoewel het sneeuwvlokschema opslag bespaart, kan het door de hoge mate van structurering tot complexere queries leiden.
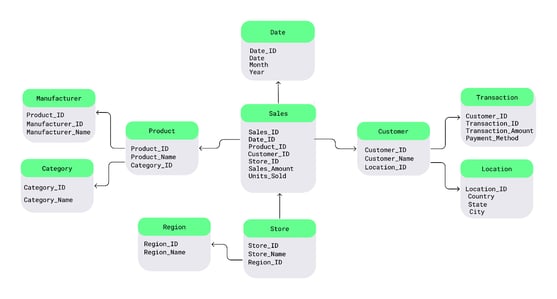
Voorbeeld van een sneeuwvlokschema. Afbeelding bron: DataCamp.
Data Vault-modellering
Data Vault-modellering is een recenter designpatroon met focus op flexibiliteit, schaalbaarheid en historische datatracking. Het splitst het datawarehouse in drie kerncomponenten:
- Hubs (waarin sleutelbedrijfsentiteiten worden opgeslagen)
- Links (die relaties tussen entiteiten representeren)
- Satellieten (die beschrijvende attributen bevatten)
Deze aanpak is zeer aanpasbaar aan veranderingen in bedrijfsprocessen en daardoor goed geschikt voor agile ontwikkelomgevingen.
Het Data Vault-designpatroon wint aan populariteit dankzij het vermogen om zich aan te passen aan evoluerende dataomgevingen, wijzigingen in databronnen op te vangen en op lange termijn schaalbaarheid te ondersteunen. Het is een ideale oplossing voor organisaties die gedetailleerde historische tracking, frequente schemawijzigingen of een zeer schaalbare architectuur nodig hebben.
Best practices voor het bouwen van een datawarehouse-architectuur
Het vroegtijdig toepassen van best practices is essentieel om een robuuste architectuur te bouwen. In dit onderdeel behandelen we enkele best practices voor het opzetten van een high-performance datawarehouse.
Plan voor schaalbaarheid
Datavolumes en bedrijfsbehoeften groeien onvermijdelijk in de tijd, dus het is essentieel dat de gekozen architectuur toenemende workloads aankan. Dit kan eenvoudig door schaalbare opslagoplossingen te gebruiken, zoals cloudplatforms, en door grote tabellen te partitioneren voor betere prestaties.
Optimaliseer ETL-processen
Stroomlijn de ETL-pijplijn door onnodige datatransformaties te minimaliseren, incrementele laadstrategieën te benutten en ETL-taken waar mogelijk te paralleliseren. Zo wordt data snel ingelezen, getransformeerd en geladen zonder knelpunten.
Zorg voor datakwaliteit en consistentie
Hoge datakwaliteit is fundamenteel voor de waarde van een datawarehouse. Implementeer sterke datavalidatie- en deduplicatieprocedures om te waarborgen dat de data die het warehouse binnenkomt accuraat en consistent is. Regelmatige audits en kwaliteitscontroles moeten deel uitmaken van de ETL-pijplijn om problemen te voorkomen die tot onjuiste analyses kunnen leiden.
Focus op dataveiligheid en compliance
Dataveiligheid moet een topprioriteit zijn – zeker bij gevoelige of gereguleerde informatie. Neem drie essentiële maatregelen:
- Pas encryptie toe voor data in rust en tijdens transport.
- Implementeer op rollen gebaseerde toegangscontrole om data te beperken tot geautoriseerde gebruikers.
- Zorg dat de architectuur voldoet aan regelgeving (bijv. AVG, HIPAA, industriespecifieke vereisten).
Monitor prestaties en gebruik
Om het datawarehouse efficiënt te laten draaien, monitor je regelmatig het volgende:
- Queryprestaties
- Gebruikerstoegangspatronen
- Opslaggebruik
Tools voor prestatiemonitoring helpen knelpunten te identificeren, zodat je waar nodig proactief kunt bijsturen.
Cloud versus on-premises datawarehouse-architectuur
Kies je voor een cloudgebaseerd datawarehouse of houd je alles on-premises? Wat zijn de belangrijkste voordelen en afruilen van elke aanpak? En is een hybride oplossing het beste van twee werelden?
In dit onderdeel verkennen we deze vragen en helpen we je de juiste architectuur voor jouw behoeften te bepalen.
Cloudgebaseerde architectuur
Cloudgebaseerde datawarehouses bieden ongeëvenaarde schaalbaarheid en flexibiliteit. Deze platforms stellen bedrijven in staat om opslag en compute on demand te schalen, ideaal voor het verwerken van grote, dynamische datavolumes zonder voorafgaande infrastructuurkosten.
Het pay-as-you-go-prijsmodel maakt cloudoplossingen ook kostenefficiënt, vooral voor bedrijven met fluctuerende workloads. Cloudomgevingen kunnen echter zorgen oproepen rond datagovernance en compliance, met name in sterk gereguleerde sectoren.
Populaire cloudvendors zijn onder meer:
- Amazon Web Services (Redshift)
- Google Cloud (BigQuery)
- Microsoft Azure (Azure Synapse Analytics)
On-premises architectuur
On-premises datawarehouses zijn het meest geschikt voor organisaties die strikte datacontrole vereisen. Met een on-premises architectuur behouden bedrijven volledige controle over hun hardware en data, essentieel voor sectoren als financiën, gezondheidszorg en overheid, waar gevoelige informatie moet worden beschermd.
Er is echter een keerzijde. Hoewel on-premises systemen robuuste prestaties kunnen bieden, brengen ze vaak hoge initiële hardwarekosten en doorlopende onderhoudslasten met zich mee. Schalen kan ook uitdagend zijn, omdat dit handmatige upgrades en hardware-aanschaf vereist, wat minder flexibel is dan cloudoplossingen.
Hybride architectuur
Hybride datawarehouse-architecturen combineren cloud- en on-premises componenten en bieden meer flexibiliteit voor organisaties die veiligheid, compliance en schaalbaarheid willen balanceren. Zo kun je gevoelige data on-premises opslaan, terwijl minder kritieke data of analytics-workloads in de cloud worden verwerkt.
Hybride architecturen zijn vooral nuttig voor bedrijven die geleidelijk naar de cloud willen migreren of specifieke privacyvereisten hebben. Dit model biedt het beste van twee werelden, maar vereist zorgvuldige orkestratie om naadloze dataintegratie tussen omgevingen te garanderen.
Samenvattende tabel: cloud vs. on-premises vs. hybride datawarehouse-architectuur
|
Kenmerk |
Cloudgebaseerde architectuur |
On-premises architectuur |
Hybride architectuur |
|
Schaalbaarheid |
Zeer schaalbaar, resources on-demand |
Beperkt door on-site hardware, handmatige upgrades nodig |
Combineert schaalbare cloudresources met on-premises controle |
|
Kosten |
Pay-as-you-go, lage initiële kosten |
Hoge initiële hardware-investering en doorlopend onderhoud |
Hybride kosten, balans tussen cloudbesparingen en on-premises uitgaven |
|
Flexibiliteit |
Zeer flexibel, ideaal voor dynamische workloads |
Minder flexibel, beperkt door fysieke infrastructuur |
Flexibel, combineert cloudagiliteit met on-prem-controle |
|
Beveiliging & compliance |
Kan zorgen opleveren voor sterk gereguleerde sectoren |
Volledige controle over databeveiliging en naleving |
Borgt naleving voor gevoelige data en benut de cloud |
|
Prestaties |
Variabel, afhankelijk van provider en configuratie |
Hoge prestaties, maar afhankelijk van hardware-investeringen |
Gebalanceerde prestaties op basis van workloadverdeling |
|
Onderhoud |
Minimaal onderhoud, beheerd door cloudprovider |
Doorlopend intern IT-onderhoud vereist |
Hybride aanpak, waarbij cloudservices deels onderhoud overnemen |
|
Use-cases |
Beste keuze voor bedrijven met grote, fluctuerende datavolumes |
Beste keuze voor organisaties met strikte beveiligings- en compliance-eisen |
Ideaal voor organisaties die naar de cloud migreren of gemengde behoeften hebben |
Populaire cloud-datawarehouseplatforms
Hier is een overzicht van enkele van de populairste datawarehouseplatforms in de cloud.
Amazon Redshift
Amazon Redshift is een volledig beheerde cloud-datawarehouseoplossing voor grootschalige data-analytics. De architectuur is gebaseerd op massively parallel processing, waardoor gebruikers snel enorme datasets kunnen bevragen. Dankzij het kunnen opschalen op basis van workload is Redshift geschikt voor organisaties die kosteneffectieve schaalbaarheid en integratie met andere AWS-services nodig hebben.
Google BigQuery
Google BigQuery is een serverless, zeer schaalbaar datawarehouseplatform voor snelle realtime analytics. De unieke architectuur ontkoppelt opslag en compute, waardoor gebruikers petabytes aan data kunnen bevragen zonder infrastructuurbeheer. BigQuery’s vermogen om grootschalige analytics met minimale overhead te verwerken, maakt het ideaal voor organisaties met zware dataworkloads en behoefte aan snelle, complexe queries.
Snowflake
Snowflake biedt een multi-cluster, shared-data-architectuur die compute en opslag scheidt, wat flexibiliteit geeft om resources onafhankelijk te schalen. Snowflake’s cloud-native aanpak stelt bedrijven in staat workloads dynamisch te schalen en is daarmee aantrekkelijk voor organisaties die hoge flexibiliteit en workloadmanagement over meerdere cloudplatforms nodig hebben.
Microsoft Azure Synapse
Microsoft Azure Synapse Analytics is een hybride dataplatform dat datawarehousing en big data-analytics combineert. De architectuur integreert met big data-frameworks zoals Apache Spark en biedt een uniforme omgeving voor het beheren van datalakes en datawarehouses. Azure Synapse integreert naadloos met andere Microsoft-services en is ideaal voor bedrijven met uiteenlopende data-analyticsbehoeften.
Samenvattende tabel: datawarehouseplatforms
|
Platform |
Architectuur |
Belangrijkste features |
Use-cases |
|
Amazon Redshift |
MPP-architectuur, AWS-ecosysteem |
Schaalbaar, snelle queries, AWS-integratie |
Grootschalige analytics, cloud-native applicaties |
|
Google BigQuery |
Serverless, ontkoppelde opslag en compute |
Realtime analytics, weinig infrastructuurbeheer |
Snelle analytics, realtime dataverwerking |
|
Snowflake |
Multicluster, shared-data-architectuur, cross-cloud (AWS, Azure, GCP) |
Scheiding van compute en opslag, dynamisch schalen |
Flexibel schalen, workloads over meerdere cloudplatforms |
|
Azure Synapse |
Hybride, integratie met big data |
Geünificeerde analytics, Spark-integratie |
Hybride datamanagement, integratie met Microsoft-tools |
Uitdagingen bij datawarehouse-architectuur
Hoewel datawarehouses krachtige mogelijkheden bieden om enorme hoeveelheden data te analyseren en te beheren, brengen ze ook inherente uitdagingen met zich mee.
Hier zijn enkele van de belangrijkste uitdagingen en oplossingen om te overwegen bij het ontwerpen en onderhouden van een datawarehouse-architectuur.
Dataintegratie uit diverse bronnen
Organisaties verzamelen data uit meerdere bronnen, elk met verschillende formaten, schema’s en structuren, wat integratie complex maakt. Belangrijke aandachtspunten:
- Mix van gestructureerde en ongestructureerde data – Het combineren van relationele databaserecords met logs, socialmediastreams of sensordata vereist zorgvuldige transformatie.
- Uitgebreide datatransformatie en opschoning – Ruwe data moet vaak worden opgeschoond, geformatteerd en gestandaardiseerd voordat deze effectief kan worden gebruikt.
- Hybride omgevingen – Het synchroniseren van data tussen on-premises systemen en cloudplatforms voegt extra complexiteit toe.
Om deze uitdagingen aan te pakken, hebben bedrijven flexibele ETL-processen en datamanagementtools nodig die diverse dataformaten ondersteunen en naadloze integratie over platforms mogelijk maken.
Prestaties op schaal
Naarmate datawarehouses groeien, wordt het handhaven van hoge queryprestaties een uitdaging. Grootschalige operaties moeten miljoenen—of zelfs miljarden—rijen efficiënt verwerken, zonder trage queries, hoge kosten en inefficiënt resourcegebruik.
Belangrijke optimalisatiestrategieën zijn onder meer:
- Data-indexering – Versnelt dataopvraging door gestructureerde zoekpaden te creëren.
- Partitionering – Organiseert data in kleinere, beheersbare segmenten voor snellere queries.
- Gematerialiseerde views – Slaan vooraf berekende queryresultaten op om verwerkingstijd te verminderen.
- Kolomgebaseerde opslagformaten (bijv., Parquet, ORC) – Verbetert leesprestaties voor analytische queries.
- Query-optimalisatie-engines – Verbeteren uitvoeringsplannen voor snellere prestaties.
Workloadmanagement
Naarmate meer gebruikers toegang krijgen tot het datawarehouse, wordt efficiënte toewijzing van resources cruciaal. Belangrijke overwegingen zijn:
- Gelijktijdigheidsbeheer – Voorkomt prestatieknelpunten wanneer meerdere queries tegelijk draaien.
- Dynamisch schalen – Cloudwarehouses passen resources automatisch aan de vraag aan.
- Omgang met resourcecontentendie – On-premises of hybride systemen moeten CPU, geheugen en schijf zorgvuldig beheren om vertragingen te voorkomen.
Met deze strategieën zorgen organisaties ervoor dat hun datawarehouse effectief schaalt en hoge prestaties behoudt naarmate datavolume en gebruikersactiviteit groeien.
Datagovernance en beveiliging
Naarmate datawarehouses steeds meer gevoelige informatie opslaan, zijn sterke governance- en beveiligingsmaatregelen essentieel om inbreuken te voorkomen, naleving te waarborgen en dataintegriteit te behouden.
- Consistente governancebeleid afdwingen
- Implementeer role-based access control (RBAC) om datatoegang te beperken.
- Onderhoud datacatalogi om dataherkomst, eigenaarschap en gebruik bij te houden.
- Regelgeving (AVG, CCPA, HIPAA, enz.)
- Bescherm persoonsgegevens met anonimisering en masking.
- Implementeer bewaartermijnen om aan wettelijke vereisten te voldoen.
- Encryptie en security best practices
- Versleutel data in rust en tijdens transport om ongeautoriseerde toegang te voorkomen.
- Onderhoud gedetailleerde auditlogs om toegang tot gevoelige data te volgen.
- Beveiliging in hybride en cloudomgevingen
- Beheer encryptiesleutels effectief over on-premises en cloudsystemen.
- Beveilig netwerkverkeer tussen cloud- en on-prem-systemen.
- Zorg voor naleving van de beveiligingsrichtlijnen van derde partijen.
Conclusie
In dit artikel hebben we de belangrijkste componenten van datawarehouse-architectuur, veelvoorkomende uitdagingen en strategieën om die te overwinnen verkend. Uiteindelijk doet een goed ontworpen datawarehouse meer dan alleen data opslaan—het stelt organisaties in staat om onderbouwde, datagedreven beslissingen te nemen die groei en innovatie stimuleren.
Wil je dieper duiken in data-architectuur en best practices? Bekijk deze resources:
- Understanding Data Engineering – Leer de basis van data engineering en de rol ervan in moderne data-ecosystemen.
- Data Warehousing Concepts – Krijg inzicht in kernprincipes en ontwerp van datawarehousing.
- Understanding Modern Data Architecture – Ontdek hoe data-architecturen in het cloudtijdperk zijn ontwikkeld.
- Database Design – Beheers de basis van het ontwerpen van efficiënte en schaalbare databases.
- ETL and ELT in Python – Leer effectieve ETL/ELT-pijplijnen bouwen met Python.
FAQs
Hoe verschilt een datawarehouse van een database?
Een database is ontworpen voor transactionele verwerking (OLTP) en handelt realtime operaties af zoals het invoegen en bijwerken van records. Een datawarehouse daarentegen is geoptimaliseerd voor analytische verwerking (OLAP) en maakt complexe queries en historische data-analyse mogelijk.
Hoe ondersteunt een datawarehouse realtime analytics?
Traditionele datawarehouses verwerken batchupdates, maar moderne cloudarchitecturen (bijv. Snowflake, BigQuery) maken realtime analytics mogelijk door streamingdata te integreren via tools zoals Apache Kafka, AWS Kinesis of Google Pub/Sub.
Welke rol speelt metadata in een datawarehouse?
Metadata biedt essentiële informatie over de structuur, herkomst en definities van data die in het warehouse is opgeslagen. Het zorgt voor consistentie, verbetert datagovernance en helpt gebruikers om snel de juiste datasets te vinden.
Kan een datawarehouse ongestructureerde data verwerken?
Datawarehouses slaan primair gestructureerde data op, maar kunnen semi-gestructureerde formaten integreren (bijv. JSON, XML, Parquet). Voor puur ongestructureerde data (bijv. afbeeldingen, video’s, ruwe tekst) gebruiken organisaties vaak datalakes in combinatie met een datawarehouse.
Wat zijn surrogaatsleutels en waarom worden ze gebruikt in datawarehouse-ontwerp?
Surrogaatsleutels zijn door het systeem gegenereerde unieke identificatoren die in fact- en dimensietabellen worden gebruikt in plaats van natuurlijke sleutels (zoals klant-ID of productcode). Ze verbeteren prestaties, consistentie en flexibiliteit in schemadesign.
Hoe verbeteren gematerialiseerde views de prestaties van een datawarehouse?
Gematerialiseerde views slaan vooraf berekende queryresultaten op, waardoor de verwerkingstijd voor repetitieve queries afneemt. Dit verbetert de prestaties aanzienlijk, vooral bij geaggregeerde of complexe analytische queries.
Hoe integreert een datawarehouse met AI en machine learning?
Veel moderne warehouses ondersteunen ML- en AI-workloads door het bieden van:
- Ingebouwde ML-functies (bijv. BigQuery ML, Redshift ML)
- Integratie met ML-frameworks (bijv. TensorFlow, PyTorch, Scikit-learn)
- Feature stores waarmee analisten gestructureerde data efficiënt aan ML-modellen kunnen aanbieden
Wat zijn Slowly Changing Dimensions (SCD) in een datawarehouse?
SCD’s volgen historische wijzigingen in dimensietabellen. De meest voorkomende typen zijn:
- SCD Type 1 – Overschrijft oude data met nieuwe data.
- SCD Type 2 – Behoudt historische data door nieuwe records toe te voegen.
- SCD Type 3 – Behoudt beperkte historie via extra kolommen.



Een solide datawarehouse-architectuur bouwen is cruciaal voor het verwerken van grote en complexe datasets. Naarmate data blijft groeien, hebben bedrijven een gestructureerde aanpak nodig om informatie efficiënt op te slaan, te beheren en te analyseren.
Zonder de juiste architectuur kun je te maken krijgen met trage queries, inconsistente data en uitdagingen die besluitvorming lastiger maken dan nodig is.
In dit artikel neem ik je mee door de belangrijkste componenten van een datawarehouse, verschillende architectuurtypen en best practices om je te helpen een systeem te ontwerpen dat zowel schaalbaar als efficiënt is. Of je nu een nieuw datawarehouse opzet of een bestaand optimaliseert, met dit inzicht leg je de basis voor succes.
Componenten van een datawarehouse-architectuur
Een goed ontworpen datawarehouse is opgebouwd uit een reeks onderling verbonden componenten. Deze componenten werken samen om data uit diverse bronnen te verwerken, te transformeren voor analyse en in een gestructureerd formaat beschikbaar te maken voor gebruikers. Hieronder bespreken we de essentiële bouwstenen van een datawarehouse-architectuur.
Databronnen
Een datawarehouse verzamelt informatie uit verschillende bronnen, waaronder gestructureerde data uit relationele databases en ongestructureerde data zoals logs of tekstbestanden. Veelvoorkomende databronnen zijn:
Door deze diverse bronnen in één systeem te integreren, krijgen bedrijven een volledig en eenduidig beeld van hun operaties.
ETL-laag
Het ETL- (of ELT-)proces is een kernonderdeel van een datawarehouse-architectuur. Het omvat:
Bij ETL wordt data vóór het laden getransformeerd, terwijl bij ELT ruwe data eerst wordt geladen en daarna binnen het warehouse wordt getransformeerd. ELT heeft vaak de voorkeur bij moderne cloudgebaseerde warehouses dankzij schaalbaarheid en prestatievoordelen.
Staging area
De staging area is een optionele, tijdelijke opslagruimte waar ruwe data wordt bewaard voordat deze wordt verwerkt en in het datawarehouse geladen. Deze laag fungeert als buffer zodat transformaties kunnen plaatsvinden zonder de hoofdopslag direct te beïnvloeden.
Datalaag voor opslag
In de kern van het datawarehouse ligt de opslaglaag, waar data wordt georganiseerd in fact- en dimensietabellen:
Data wordt meestal in een ster- of sneeuwvlokschema gerangschikt om queryprestaties en analyses te optimaliseren.
Metadatalayer
De metadata-laag beheert en onderhoudt de structuur en relaties binnen het datawarehouse. In de kern biedt metadata informatie over databronnen, schema en transformaties. Dit stelt gebruikers en systemen in staat de context, herkomst en het gebruik van de data binnen het warehouse te begrijpen.
Data access- en analyticslaag
Deze laag stelt gebruikers in staat om data uit het warehouse op te halen en te analyseren. Meestal omvat dit:
Terwijl basisrapportages en dashboards onder traditionele data-access vallen, worden complexere machine learning- en voorspellende analytics-workflows soms afzonderlijk als analyticslaag gecategoriseerd vanwege hun geavanceerde rekeneisen.