
Tipi di architettura di Data Warehouse
Scegliere l'architettura di data warehouse giusta è essenziale per soddisfare le esigenze della tua organizzazione in termini di prestazioni, scalabilità e integrazione. Tuttavia, architetture diverse offrono vantaggi e compromessi unici, a seconda di vari fattori. Esploriamole in questa sezione.
Architettura a singolo livello
In un'architettura a singolo livello, il data warehouse è costruito su un unico database centralizzato che consolida tutti i dati da varie fonti in un solo sistema. Questa architettura riduce al minimo il numero di livelli e semplifica il design complessivo, portando a un'elaborazione e a un accesso ai dati più rapidi. Tuttavia, manca della flessibilità e modularità presenti nelle architetture più complesse.
L'architettura a singolo livello si adatta meglio ad applicazioni su piccola scala e organizzazioni con esigenze limitate di elaborazione dei dati. È ideale per le aziende che privilegiano semplicità e implementazione rapida rispetto alla scalabilità. Tuttavia, con l'aumento del volume dei dati o la necessità di analisi più avanzate, questa architettura potrebbe non riuscire a soddisfare efficacemente tali richieste.
Architettura a due livelli
In un'architettura a due livelli, il data warehouse si collega direttamente agli strumenti BI, spesso tramite un sistema OLAP. Questo approccio fornisce un accesso più rapido ai dati per l'analisi, ma può incontrare difficoltà nella gestione di volumi maggiori, poiché la scalabilità diventa complicata a causa della connessione diretta tra warehouse e strumenti BI.
L'architettura a due livelli è più adatta a organizzazioni piccole e medie che necessitano di un accesso rapido ai dati per l'analisi ma non richiedono la scalabilità di architetture più grandi e complesse. È ideale per aziende con volumi di dati moderati e esigenze di reportistica o analytics relativamente semplici, poiché consente un'integrazione diretta tra data warehouse e strumenti di business intelligence.
Tuttavia, con la crescita dei dati o il rafforzarsi dei requisiti analitici, questa architettura potrebbe faticare a scalare e a gestire carichi di lavoro crescenti in modo efficiente.
Architettura a tre livelli
L'architettura a tre livelli è il modello più comune e diffuso per i data warehouse. Separa il sistema in livelli distinti: livello delle sorgenti dati, livello della staging area e livello di analytics. Questa separazione consente processi ETL efficienti, seguiti da analytics e reportistica.
L'architettura a tre livelli è ideale per ambienti enterprise su larga scala che richiedono scalabilità, flessibilità e la capacità di gestire volumi di dati massicci. Permette di gestire i dati in modo più efficiente e supporta analisi avanzate, machine learning e reportistica in tempo reale. La separazione dei livelli migliora le prestazioni, rendendola adatta a contesti dati complessi.
Architettura di data warehouse in cloud
Nell'architettura di data warehouse in cloud, l'intera infrastruttura è ospitata su piattaforme come Amazon Redshift, Google BigQuery o Snowflake. Le architetture basate su cloud offrono una scalabilità praticamente illimitata, con la possibilità di gestire grandi dataset senza necessità di hardware on-premises. Offrono inoltre flessibilità nei costi grazie ai modelli pay-as-you-go, rendendole accessibili a un'ampia gamma di aziende.
L'architettura di data warehouse in cloud è ideale per organizzazioni di tutte le dimensioni. È perfetta per le aziende in cerca di una soluzione flessibile e scalabile, poiché consente di scalare dinamicamente le risorse di storage e compute.
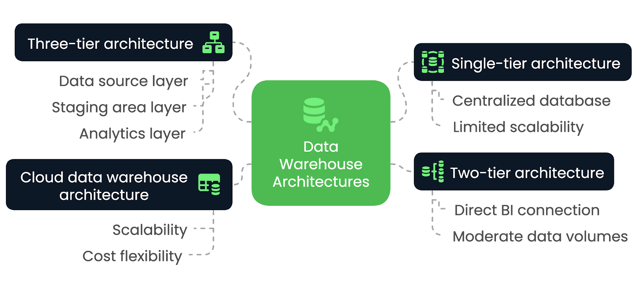
Confronto tra architetture di data warehouse — immagine dell'Autore.
Design pattern per l'architettura di Data Warehouse
Esistono diversi design pattern per i data warehouse, ognuno pensato per esigenze diverse in base alla complessità dei dati e ai tipi di query eseguite. Esploriamo i più comuni e capiamo gli scenari più adatti per utilizzarli al massimo dell'efficienza.
Schema a stella
Lo schema a stella è uno dei design pattern più utilizzati per i data warehouse. Struttura i dati in:
- Una tabella dei fatti centrale – memorizza dati quantitativi, come:
- Ricavi delle vendite
- Unità vendute
- Tabelle delle dimensioni circostanti – contengono attributi descrittivi, tra cui:
- Dettagli del prodotto (ad es., nome prodotto, categoria)
- Informazioni sul cliente (ad es., ID cliente, dati demografici)
- Sedi dei negozi
- Periodi temporali
In uno scenario retail, la tabella dei fatti contiene i dati transazionali delle vendite, mentre le tabelle delle dimensioni forniscono contesto su prodotti, clienti, negozi e tempo. Questo schema migliora le prestazioni delle query, rendendolo ideale per ambienti con esigenze frequenti di reportistica semplice.
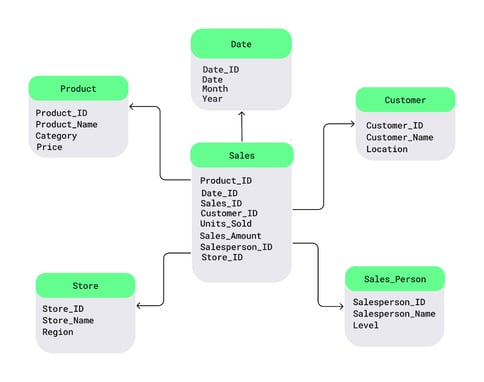
Esempio di schema a stella. Image source: DataCamp.
Schema a fiocco di neve
Lo schema a fiocco di neve è un'estensione dello schema a stella, introducendo ulteriore normalizzazione nelle tabelle delle dimensioni. Le caratteristiche principali includono:
- Tabelle delle dimensioni normalizzate – le tabelle delle dimensioni sono suddivise in sotto-dimensioni per ridurre la ridondanza.
- Maggiore efficienza di archiviazione – meno dati duplicati rispetto allo schema a stella.
- Query più complesse – i join tra più tabelle possono rallentare le prestazioni delle query.
Questo schema è ideale per:
- Ottimizzazione dello storage – utile quando la riduzione della ridondanza è una priorità.
- Dataset complessi – vantaggioso per dati con molti attributi che richiedono normalizzazione.
- Contesti attenti ai costi – preferibile quando i costi di archiviazione sono elevati.
- Query analitiche dettagliate – supporta analisi approfondite a scapito della velocità delle query.
Pur conservando spazio, lo schema a fiocco di neve può portare a query più articolate a causa della sua natura altamente strutturata.
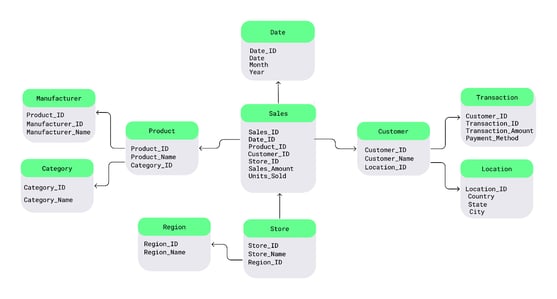
Esempio di schema a fiocco di neve. Image source: DataCamp.
Data vault modeling
Il data vault modeling è un design pattern più recente incentrato su flessibilità, scalabilità e tracciamento storico dei dati. Suddivide il data warehouse in tre componenti principali:
- Hub (che memorizzano le entità di business chiave)
- Link (che rappresentano le relazioni tra entità)
- Satellite (che contengono attributi descrittivi)
Questo approccio è altamente adattabile ai cambiamenti dei processi aziendali, rendendolo adatto ad ambienti di sviluppo agili.
Il design pattern del data vault sta guadagnando popolarità grazie alla capacità di gestire ambienti dati in evoluzione, accogliere cambiamenti nelle fonti dati e supportare la scalabilità a lungo termine. È diventato una soluzione ideale per organizzazioni che richiedono tracciamento storico dettagliato, modifiche frequenti agli schemi o un'architettura altamente scalabile.
Best practice per costruire un'architettura di Data Warehouse
Applicare le best practice fin dall'inizio è essenziale per costruire un'architettura robusta. In questa sezione vedremo alcune delle migliori pratiche da seguire per realizzare un data warehouse ad alte prestazioni.
Progetta per la scalabilità
Volumi di dati ed esigenze di business cresceranno inevitabilmente nel tempo, quindi è fondamentale assicurarsi che l'architettura scelta possa gestire carichi di lavoro crescenti. Si può ottenere utilizzando soluzioni di storage scalabili, come piattaforme cloud, e partizionando le tabelle grandi per migliorare le prestazioni.
Ottimizza i processi ETL
Snellisci la pipeline ETL minimizzando trasformazioni non necessarie, sfruttando strategie di caricamento incrementale e parallelizzando i task ETL quando possibile. In questo modo i dati vengono acquisiti, trasformati e caricati rapidamente senza colli di bottiglia.
Garantisci qualità e coerenza dei dati
Mantenere un'alta qualità dei dati è fondamentale per il valore di un data warehouse. Implementa procedure rigorose di validazione e deduplicazione per assicurare che i dati in ingresso siano accurati e coerenti. Audit e controlli di qualità regolari dovrebbero far parte della pipeline ETL per prevenire problemi che potrebbero portare ad analisi errate.
Concentrati su sicurezza e conformità
La sicurezza dei dati deve essere una priorità assoluta – soprattutto quando si trattano informazioni sensibili o regolamentate. Ci sono tre misure essenziali da adottare:
- Applicare la crittografia per i dati a riposo e in transito.
- Implementare controlli di accesso basati sui ruoli per limitare l'accesso ai soli utenti autorizzati.
- Garantire che l'architettura soddisfi gli standard normativi (ad es., GDPR, HIPAA, requisiti specifici del settore).
Monitora prestazioni e utilizzo
Per mantenere il data warehouse efficiente, monitora regolarmente quanto segue:
- Prestazioni delle query
- Modelli di accesso degli utenti
- Utilizzo dello storage
Strumenti di monitoraggio delle prestazioni possono aiutare a individuare i colli di bottiglia, consentendoti di intervenire in modo proattivo dove necessario.
Data Warehouse in cloud vs. on-premises
Meglio optare per un data warehouse basato su cloud o mantenere tutto on-premise? Quali sono i principali vantaggi e compromessi di ciascun approccio? E una soluzione ibrida è davvero il meglio di entrambi i mondi?
In questa sezione, esploreremo queste domande per aiutarti a determinare l'architettura più adatta alle tue esigenze.
Architettura basata su cloud
I data warehouse basati su cloud offrono una scalabilità e una flessibilità senza pari. Queste piattaforme consentono alle aziende di scalare storage e risorse di calcolo on demand, rendendole ideali per gestire volumi di dati grandi e dinamici senza costi infrastrutturali iniziali.
Il modello di prezzo pay-as-you-go rende inoltre le soluzioni cloud convenienti, soprattutto per le aziende con carichi di lavoro variabili. Tuttavia, gli ambienti cloud possono sollevare preoccupazioni in merito a governance e conformità dei dati, in particolare per i settori altamente regolamentati.
I fornitori cloud più diffusi includono:
- Amazon Web Services (Redshift)
- Google Cloud (BigQuery)
- Microsoft Azure (Azure Synapse Analytics)
Architettura on-premises
I data warehouse on-premises sono più adatti alle organizzazioni che richiedono un controllo rigoroso sui dati. Con un'architettura on-premises, le aziende mantengono il pieno controllo sull'hardware e sui dati, aspetto essenziale per settori come finanza, sanità e pubblica amministrazione, in cui le informazioni sensibili devono essere protette.
C'è però un rovescio della medaglia. Sebbene i sistemi on-premises possano offrire prestazioni robuste, comportano spesso costi iniziali elevati per l'hardware e una manutenzione continua. Anche la scalabilità può essere impegnativa, poiché richiede aggiornamenti manuali e approvvigionamento di hardware, risultando meno flessibile rispetto alle soluzioni cloud.
Architettura ibrida
Le architetture ibride di data warehouse combinano componenti cloud e on-premises, offrendo maggiore flessibilità alle organizzazioni che devono bilanciare sicurezza, conformità e scalabilità. Ad esempio, i dati sensibili possono essere archiviati on-premises, mentre i dati meno critici o i carichi analitici possono essere elaborati nel cloud.
Le architetture ibride sono particolarmente utili per le aziende che devono migrare gradualmente al cloud o hanno specifici requisiti di privacy dei dati. Questo modello offre il meglio di entrambi i mondi, ma richiede un'orchestrazione accurata per garantire un'integrazione fluida dei dati tra gli ambienti.
Tabella riassuntiva: data warehouse in cloud vs. on-premises vs. ibrido
|
Caratteristica |
Architettura basata su cloud |
Architettura on-premises |
Architettura ibrida |
|
Scalabilità |
Altamente scalabile, allocazione delle risorse on demand |
Limitata dall'hardware in sede, richiede aggiornamenti manuali |
Combina risorse cloud scalabili con controllo on-premises |
|
Costo |
Prezzi pay-as-you-go, costi iniziali ridotti |
Alto investimento iniziale in hardware e manutenzione continua |
Costi ibridi, bilanciando risparmi cloud e spese on-premises |
|
Flessibilità |
Estremamente flessibile, ideale per carichi dinamici |
Meno flessibile, vincolata all'infrastruttura fisica |
Flessibile, unisce agilità del cloud e controllo on-prem |
|
Sicurezza e conformità |
Può sollevare dubbi per settori altamente regolamentati |
Controllo completo su sicurezza dei dati e conformità normativa |
Garantisce conformità per i dati sensibili sfruttando il cloud |
|
Prestazioni |
Possono variare in base al provider cloud e alla configurazione |
Alte prestazioni ma dipendenti dagli investimenti hardware |
Prestazioni bilanciate in base alla distribuzione dei carichi |
|
Manutenzione |
Minima manutenzione, gestita dal provider cloud |
Richiede manutenzione IT interna continua |
Approccio ibrido con parte della manutenzione gestita dal cloud |
|
Casi d'uso |
Ideale per aziende con volumi di dati grandi e variabili |
Ideale per organizzazioni con stringenti esigenze di sicurezza e conformità |
Ideale per organizzazioni in transizione al cloud o con esigenze miste |
Piattaforme cloud popolari per Data Warehouse
Ecco una panoramica di alcune delle piattaforme di data warehouse più utilizzate nel cloud.
Amazon Redshift
Amazon Redshift è una soluzione di data warehouse cloud completamente gestita per l'analisi di dati su larga scala. La sua architettura si basa su un sistema di elaborazione massivamente parallelo, che consente di interrogare rapidamente dataset enormi. Grazie alla capacità di scalare verso l'alto o il basso in base al carico, Redshift è adatto a organizzazioni che necessitano di scalabilità conveniente e integrazione con altri servizi AWS.
Google BigQuery
Google BigQuery è una piattaforma di data warehouse senza server, altamente scalabile, costruita per analytics rapide e in tempo reale. La sua architettura unica disaccoppia storage e compute, permettendo di interrogare petabyte di dati senza gestire l'infrastruttura. La capacità di BigQuery di elaborare analytics su larga scala con un overhead minimo lo rende ideale per organizzazioni con carichi di lavoro dati pesanti che richiedono query veloci e complesse.
Snowflake
Snowflake offre un'architettura a multi-cluster e dati condivisi che separa calcolo e storage, fornendo flessibilità nello scalare le risorse in modo indipendente. L'approccio cloud-native di Snowflake consente alle aziende di scalare dinamicamente i carichi di lavoro, rendendolo un'opzione interessante per organizzazioni che necessitano di elevata flessibilità e gestione dei carichi su più piattaforme cloud.
Microsoft Azure Synapse
Microsoft Azure Synapse Analytics è una piattaforma ibrida di gestione dei dati che combina data warehousing e big data analytics. La sua architettura si integra con framework per big data come Apache Spark per offrire un ambiente unificato per la gestione di data lake e data warehouse. Azure Synapse offre un'integrazione fluida con altri servizi Microsoft ed è ideale per aziende con esigenze analitiche eterogenee.
Tabella riassuntiva: piattaforme di data warehouse
|
Piattaforma |
Architettura |
Caratteristiche principali |
Casi d'uso |
|
Amazon Redshift |
Architettura MPP, ecosistema AWS |
Scalabile, query rapide, integrazione con AWS |
Analytics su larga scala, applicazioni cloud-native |
|
Google BigQuery |
Serverless, storage e compute disaccoppiati |
Analytics in tempo reale, basso overhead infrastrutturale |
Analytics veloci, elaborazione di dati in tempo reale |
|
Snowflake |
Architettura multi-cluster a dati condivisi, cross-cloud (AWS, Azure, GCP) |
Separazione compute-storage, scaling dinamico |
Scalabilità flessibile, carichi multi-cloud |
|
Azure Synapse |
Ibrida, integrazione big data |
Analytics unificati, integrazione con Spark |
Gestione dati ibrida, integrazione con strumenti Microsoft |
Sfide nell'architettura di Data Warehouse
Sebbene i data warehouse offrano potenti funzionalità per analizzare e gestire grandi quantità di dati, presentano anche sfide intrinseche.
Ecco alcune delle sfide più rilevanti e le soluzioni da considerare quando si progetta e si mantiene un'architettura di data warehouse.
Integrazione dei dati da fonti eterogenee
Le organizzazioni raccolgono dati da più fonti, ognuna con formati, schemi e strutture differenti, rendendo l'integrazione una sfida complessa. Aspetti chiave includono:
- Combinare dati strutturati e non strutturati – unire record di database relazionali con log, flussi social o dati da sensori richiede trasformazioni accurate.
- Estese trasformazioni e pulizia dei dati – i dati grezzi spesso necessitano di pulizia, formattazione e standardizzazione prima di poter essere utilizzati efficacemente.
- AmbientI ibridi – sincronizzare i dati tra sistemi on-premises e piattaforme cloud aggiunge un ulteriore livello di complessità.
Per affrontare queste sfide, servono processi ETL flessibili e strumenti di gestione dei dati che supportino formati eterogenei e un'integrazione senza soluzione di continuità tra le piattaforme.
Prestazioni su larga scala
Con la crescita dei data warehouse, mantenere alte prestazioni di query diventa una sfida. Le operazioni su larga scala devono elaborare in modo efficiente milioni — o persino miliardi — di righe evitando query lente, costi elevati e uso inefficiente delle risorse.
Le strategie di ottimizzazione chiave includono:
- Indicizzazione dei dati – accelera il recupero creando percorsi di lookup strutturati.
- Partizionamento – organizza i dati in segmenti più piccoli e gestibili per query più rapide.
- Viste materializzate – memorizzano risultati di query precomputati per ridurre i tempi di elaborazione.
- Formati di archiviazione colonnari (ad es., Parquet, ORC) – migliorano le prestazioni in lettura per query analitiche.
- Motori di ottimizzazione delle query – migliorano i piani di esecuzione per prestazioni più veloci.
Gestione dei carichi di lavoro
Con l'aumentare degli utenti che accedono al data warehouse, l'allocazione efficiente delle risorse diventa critica. Aspetti chiave includono:
- Gestione della concorrenza – previene colli di bottiglia quando più query vengono eseguite simultaneamente.
- Scaling dinamico – i warehouse cloud regolano automaticamente le risorse per soddisfare la domanda.
- Gestione della contesa delle risorse – i sistemi on-premises o ibridi devono gestire con cura CPU, memoria e disco per evitare rallentamenti.
Implementando queste strategie, le organizzazioni possono garantire che il proprio data warehouse scali efficacemente e mantenga alte prestazioni con l'aumentare dei volumi di dati e dell'attività degli utenti.
Data governance e sicurezza
Man mano che i data warehouse archiviano quantità crescenti di informazioni sensibili, solide misure di governance e sicurezza sono essenziali per prevenire violazioni, garantire la conformità e mantenere l'integrità dei dati.
- Applicazione di policy di governance coerenti
- Implementa controlli di accesso basati sui ruoli (RBAC) per limitare l'accesso ai dati.
- Mantieni cataloghi dati per tracciare lineage, proprietà e utilizzo dei dati.
- Conformità normativa (GDPR, CCPA, HIPAA, ecc.)
- Proteggi i dati personali con tecniche di anonimizzazione e masking.
- Implementa policy di retention dei dati per rispettare i requisiti legali.
- Crittografia e best practice di sicurezza
- Crittografa i dati a riposo e in transito per prevenire accessi non autorizzati.
- Mantieni log di audit dettagliati per tracciare l'accesso ai dati sensibili.
- Sicurezza in ambienti ibridi e cloud
- Gestisci efficacemente le chiavi di crittografia tra sistemi on-premises e cloud.
- Proteggi il traffico di rete tra sistemi cloud e on-prem.
- Garantisci la conformità alle policy di sicurezza dei provider terzi.
Conclusione
In questo articolo abbiamo esplorato i componenti chiave dell'architettura di un data warehouse, le sfide comuni e le strategie per superarle. In definitiva, un data warehouse ben progettato fa molto più che archiviare dati: consente alle organizzazioni di prendere decisioni informate e data-driven che alimentano crescita e innovazione.
Vuoi approfondire l'architettura dei dati e le best practice? Dai un'occhiata a queste risorse:
- Understanding Data Engineering – Impara le basi del data engineering e il suo ruolo negli ecosistemi dati moderni.
- Data Warehousing Concepts – Approfondisci i principi fondamentali e il design del data warehousing.
- Understanding Modern Data Architecture – Scopri come le architetture dati si sono evolute nell'era del cloud.
- Database Design – Padroneggia le basi per progettare database efficienti e scalabili.
- ETL and ELT in Python – Impara a costruire pipeline ETL/ELT efficaci con Python.
FAQ
In cosa un data warehouse differisce da un database?
Un database è progettato per l'elaborazione transazionale (OLTP), gestendo operazioni in tempo reale come inserimenti e aggiornamenti. Un data warehouse, invece, è ottimizzato per l'elaborazione analitica (OLAP), abilitando query complesse e analisi storiche dei dati.
Come un data warehouse supporta l'analisi in tempo reale?
I data warehouse tradizionali elaborano aggiornamenti batch, ma le architetture moderne basate su cloud (ad es., Snowflake, BigQuery) abilitano analytics in tempo reale integrando dati in streaming tramite strumenti come Apache Kafka, AWS Kinesis o Google Pub/Sub.
Qual è il ruolo dei metadati in un data warehouse?
I metadati forniscono informazioni essenziali sulla struttura, la lineage e le definizioni dei dati archiviati nel warehouse. Assicurano coerenza, migliorano la governance e aiutano gli utenti a trovare rapidamente i dataset giusti.
Un data warehouse può gestire dati non strutturati?
I data warehouse memorizzano principalmente dati strutturati, ma possono integrare formati semi-strutturati (ad es., JSON, XML, Parquet). Tuttavia, per dati puramente non strutturati (ad es., immagini, video, testo grezzo), le organizzazioni spesso utilizzano data lake in combinazione con un data warehouse.
Cosa sono le surrogate key e perché si usano nel design di un data warehouse?
Le surrogate key sono identificatori univoci generati dal sistema usati nelle tabelle dei fatti e delle dimensioni al posto delle chiavi naturali (come ID cliente o codice prodotto). Migliorano prestazioni, coerenza e flessibilità del design dello schema.
Come migliorano le viste materializzate le prestazioni di un data warehouse?
Le viste materializzate memorizzano risultati di query precomputati, riducendo i tempi di elaborazione per le query ripetitive. Questo migliora sensibilmente le prestazioni, soprattutto per query analitiche aggregate o complesse.
Come si integra un data warehouse con AI e machine learning?
Molti warehouse moderni supportano carichi di lavoro di ML e AI offrendo:
- Funzioni ML integrate (ad es., BigQuery ML, Redshift ML)
- Integrazione con framework ML (ad es., TensorFlow, PyTorch, Scikit-learn)
- Feature store che permettono agli analisti di servire dati strutturati ai modelli ML in modo efficiente
Cosa sono le Slowly Changing Dimensions (SCD) in un data warehouse?
Le SCD tracciano i cambiamenti storici nelle tabelle delle dimensioni. Le tipologie più comuni includono:
- SCD Tipo 1 – Sovrascrive i dati vecchi con quelli nuovi.
- SCD Tipo 2 – Mantiene i dati storici aggiungendo nuovi record.
- SCD Tipo 3 – Mantiene una storia limitata usando colonne aggiuntive.





Costruire un'architettura solida di data warehouse è fondamentale per gestire dataset ampi e complessi. Con la crescita continua dei dati, le aziende hanno bisogno di un approccio strutturato per archiviare, gestire e analizzare le informazioni in modo efficiente.
Senza la giusta architettura, potresti ritrovarti con query lente, dati incoerenti e difficoltà che rendono il processo decisionale più complicato del necessario.
In questo post, ti guiderò attraverso i componenti chiave di un data warehouse, le diverse tipologie di architettura e le best practice per aiutarti a progettare un sistema sia scalabile sia efficiente. Che tu stia impostando un nuovo data warehouse o ottimizzandone uno esistente, comprendere questi principi ti metterà sulla strada giusta.
Componenti di un'architettura di Data Warehouse
Un data warehouse ben progettato si basa su una serie di componenti interconnessi. Questi componenti lavorano insieme per elaborare i dati da varie fonti, trasformarli per l'analisi e renderli disponibili agli utenti in un formato strutturato. Di seguito, analizziamo i blocchi fondamentali di un'architettura di data warehouse.
Sorgenti dati
Un data warehouse raccoglie informazioni da varie fonti, incluse dati strutturati da database relazionali e dati non strutturati come log o file di testo. Le fonti dati comuni includono:
Integrando queste fonti eterogenee in un unico sistema, le aziende ottengono una visione completa e unificata delle proprie operazioni.
Livello ETL
Il processo ETL (o ELT) è un componente chiave dell'architettura di un data warehouse. Comprende:
Nell'ETL i dati vengono trasformati prima del caricamento, mentre nell'ELT i dati grezzi vengono prima caricati e poi trasformati all'interno del warehouse. L'ELT è spesso preferito per i data warehouse moderni basati su cloud grazie ai vantaggi in termini di scalabilità e prestazioni.
Staging area
La staging area è uno spazio di archiviazione temporaneo e opzionale in cui i dati grezzi vengono conservati prima di essere elaborati e caricati nel data warehouse. Questo livello funge da buffer per consentire le trasformazioni dei dati senza influire direttamente sull'archiviazione principale.
Livello di archiviazione dei dati
Al centro del data warehouse si trova il livello di archiviazione, in cui i dati sono organizzati in tabelle dei fatti e tabelle delle dimensioni:
I dati sono solitamente organizzati in uno schema a stella o a fiocco di neve per ottimizzare le prestazioni delle query e l'analisi.
Livello di metadati
Il livello di metadati gestisce e mantiene la struttura e le relazioni all'interno del data warehouse. In sostanza, i metadati forniscono informazioni su fonti dati, schema e trasformazioni. Ciò consente a utenti e sistemi di comprendere il contesto, la lineage e l'utilizzo dei dati all'interno del warehouse.
Livello di accesso ai dati e analytics
Questo livello consente agli utenti di recuperare e analizzare i dati dal warehouse. In genere include:
Mentre reportistica di base e dashboard rientrano nell'accesso tradizionale ai dati, i flussi di lavoro più complessi di machine learning e analisi predittiva sono talvolta classificati separatamente come livello di analytics a causa delle loro esigenze computazionali avanzate.