
Veri Ambarı Mimari Türleri
Doğru veri ambarı mimarisini seçmek, kuruluşunuzun performans, ölçeklenebilirlik ve entegrasyon ihtiyaçlarını karşılamak için esastır. Ancak farklı mimariler, çeşitli faktörlere bağlı olarak kendine özgü avantajlar ve ödünleşimler sunar. Bu bölümde bunları inceleyelim.
Tek katmanlı mimari
Tek katmanlı mimaride, veri ambarı; çeşitli kaynaklardan gelen tüm verileri tek bir sistemde birleştiren, merkezi bir veritabanı üzerinde kuruludur. Bu mimari, katman sayısını en aza indirir ve genel tasarımı basitleştirir; bu da daha hızlı veri işleme ve erişim sağlar. Ancak daha karmaşık mimarilerde bulunan esneklik ve modülerlikten yoksundur.
Tek katmanlı mimari, küçük ölçekli uygulamalar ve sınırlı veri işleme gereksinimleri olan kuruluşlar için en uygunudur. Ölçeklenebilirlikten ziyade sadeliği ve hızlı uygulamayı önceliklendiren işletmeler için idealdir. Ancak veri hacmi arttıkça veya daha gelişmiş analitik gerektikçe bu mimari, bu talepleri etkili bir şekilde karşılamakta zorlanabilir.
İki katmanlı mimari
İki katmanlı mimaride, veri ambarı genellikle bir OLAP sistemi aracılığıyla doğrudan BI araçlarına bağlanır. Bu yaklaşım, analize yönelik verilere daha hızlı erişim sağlasa da, ambar ile BI araçları arasındaki doğrudan bağlantı nedeniyle ölçekleme zorlaştığından daha büyük veri hacimlerinde zorluklarla karşılaşabilir.
İki katmanlı mimari; analize yönelik daha hızlı veri erişimine ihtiyaç duyan ancak daha büyük, daha karmaşık mimarilerin ölçeklenebilirliğine ihtiyaç duymayan küçük ve orta ölçekli kuruluşlar için en uygunudur. Orta düzeyde veri hacmine ve nispeten basit raporlama veya analitik ihtiyaçlara sahip işletmeler için idealdir; çünkü veri ambarı ile iş zekâsı araçları arasında doğrudan entegrasyona olanak tanır.
Ancak veri büyüdükçe veya analitik gereksinimler daha sofistike hâle geldikçe, bu mimari ölçeklenmekte ve artan iş yüklerini verimli bir şekilde yönetmekte zorlanabilir.
Üç katmanlı mimari
Üç katmanlı mimari, veri ambarları için en yaygın ve en çok kullanılan modeldir. Sistemi, veri kaynak katmanı, hazırlık alanı katmanı ve analitik katmanı olarak ayrı katmanlara ayırır. Bu ayrım, ETL süreçlerinin verimli bir şekilde yürütülmesini; ardından analitik ve raporlamayı mümkün kılar.
Üç katmanlı mimari; ölçeklenebilirlik, esneklik ve büyük veri hacimlerini yönetme yeteneği gerektiren kurumsal ölçekteki ortamlarda idealdir. İşletmelerin veriyi daha verimli yönetmesini sağlar ve gelişmiş analitik, makine öğrenmesi ve gerçek zamanlı raporlamayı destekler. Katmanların ayrılması performansı artırır ve karmaşık veri ortamları için uygun hâle getirir.
Bulut veri ambarı mimarisi
Bulut veri ambarı mimarisinde, tüm altyapı Amazon Redshift, Google BigQuery veya Snowflake gibi platformlarda barındırılır. Bulut tabanlı mimariler, şirket içi donanıma ihtiyaç duymadan büyük veri kümelerini işleme yeteneğiyle neredeyse sınırsız ölçeklenebilirlik sunar. Ayrıca kullanıma göre ödeme modelleri sayesinde maliyet esnekliği sağlar ve daha geniş bir işletme yelpazesi için erişilebilir hâle gelir.
Bulut veri ambarı mimarisi her ölçekteki kuruluş için uygundur. Esnek ve ölçeklenebilir bir çözüm arayan işletmeler için idealdir; zira bu yaklaşım, depolama ve işlem kaynaklarının dinamik olarak ölçeklendirilmesine imkân tanır.
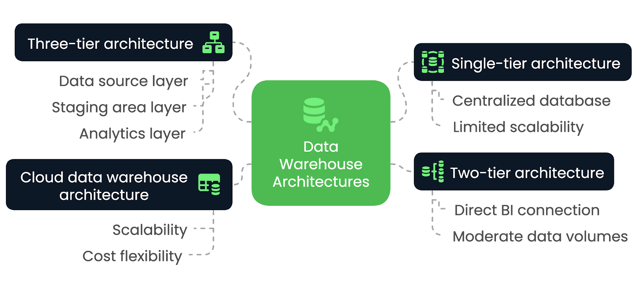
Veri ambarı mimarilerinin karşılaştırması—Görsel: Yazar.
Veri Ambarı Mimari Tasarım Kalıpları
Oldukça fazla veri ambarı tasarım kalıbı vardır; ancak her biri, verinin karmaşıklığına ve yürütülen sorgu türlerine bağlı olarak farklı ihtiyaçlara hizmet eder. En yaygın olan bazılarını keşfedelim ve maksimum verimlilik için hangi senaryolarda en uygun olduklarını çözüml eyelim.
Yıldız şeması
Yıldız şeması, en yaygın kullanılan veri ambarı tasarım kalıplarından biridir. Veriyi şu şekilde yapılandırır:
- Merkezi bir olgu tablosu – Şu tür nicel verileri depolar:
- Satış geliri
- Satılan birim sayısı
- Etrafını saran boyut tabloları – Şu tür betimleyici öznitelikleri içerir:
- Ürün ayrıntıları (örn. ürün adı, kategori)
- Müşteri bilgileri (örn. müşteri kimliği, demografi)
- Mağaza konumları
- Zaman dönemleri
Perakende senaryosunda, olgu tablosu işlemsel satış verilerini tutarken boyut tabloları ürünler, müşteriler, mağazalar ve zamana dair bağlam sağlar. Bu şema, sorgu performansını iyileştirir ve sık, doğrudan raporlama ihtiyaçları olan ortamlar için idealdir.
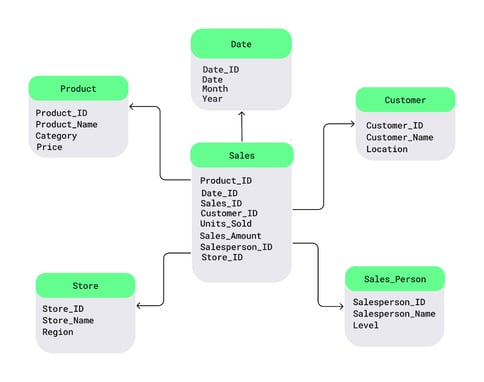
Yıldız şeması örneği. Görsel kaynak: DataCamp.
Kar tanesi şeması
Kar tanesi şeması, yıldız şemasının bir uzantısıdır ve boyut tablolarına ek normalleştirme getirir. Temel özellikler şunlardır:
- Normalleştirilmiş boyut tabloları – Boyut tabloları, yinelenmeyi azaltmak için alt boyutlara bölünür.
- Geliştirilmiş depolama verimliliği – Yıldız şemasına kıyasla daha az yinelenen veri.
- Daha karmaşık sorgular – Birden çok tablo arasındaki birleştirmeler, sorgu performansını yavaşlatabilir.
Bu şema şu durumlar için idealdir:
- Depolama optimizasyonu – Yinelenmeyi azaltmak öncelik olduğunda kullanışlıdır.
- Karmaşık veri kümeleri – Birçok özniteliğe sahip ve normalleştirme gerektiren veriler için faydalıdır.
- Maliyet duyarlı ortamlar – Depolama maliyetlerinin yüksek olduğu durumlarda tercih edilir.
- Ayrıntılı analitik sorgular – Sorgu hızından ödün vererek derinlemesine analizi destekler.
Kar tanesi şeması depolamayı korurken, yüksek derecede yapılandırılmış doğası nedeniyle daha karmaşık sorgulara yol açabilir.
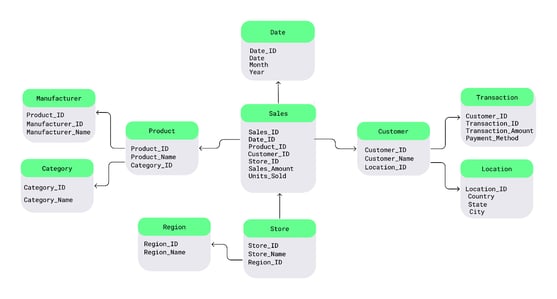
Kar tanesi şeması örneği. Görsel kaynak: DataCamp.
Data vault modelleme
Data vault modelleme, esneklik, ölçeklenebilirlik ve tarihsel veri takibine odaklanan daha yeni bir tasarım kalıbıdır. Veri ambarını üç temel bileşene ayırır:
- Hub'lar (temel iş varlıklarını depolar)
- Link'ler (varlıklar arasındaki ilişkileri temsil eder)
- Uydu'lar (betimleyici öznitelikleri tutar)
Bu yaklaşım, iş süreçlerindeki değişikliklere son derece uyumludur ve çevik geliştirme ortamları için uygundur.
Data vault modelleme tasarım kalıbı, gelişen veri ortamlarını yönetebilme, veri kaynaklarındaki değişiklikleri karşılayabilme ve uzun vadeli ölçeklenebilirliği destekleme kabiliyeti sayesinde popülerlik kazanmaktadır. Ayrıntılı tarihsel takip, sık şema değişiklikleri veya yüksek derecede ölçeklenebilir bir mimari gerektiren kuruluşlar için ideal bir çözüm hâline gelmiştir.
Bir Veri Ambarı Mimarisi Kurmada En İyi Uygulamalar
En başta en iyi uygulamaları hayata geçirmek, sağlam bir mimari kurmak için elzemdir. Bu bölümde, yüksek performanslı bir veri ambarı inşa ederken izlenmesi gereken bazı en iyi uygulamaları ele alacağız.
Ölçeklenebilirliği planlayın
Veri hacimleri ve iş gereksinimleri zamanla kaçınılmaz olarak artacaktır; bu nedenle seçtiğiniz mimarinin artan iş yüklerini karşılayabileceğinden emin olmak önemlidir. Bunu, bulut tabanlı platformlar gibi ölçeklenebilir depolama çözümleri kullanarak ve daha iyi performans için büyük tabloları bölümleyerek sağlayabilirsiniz.
ETL süreçlerini optimize edin
ETL hattını gereksiz veri dönüşümlerini en aza indirerek, artımlı yükleme stratejilerinden yararlanarak ve mümkün olduğunda ETL görevlerini paralelleştirerek yalınlaştırın. Bu, verinin darboğazlar olmadan hızlıca alınmasını, dönüştürülmesini ve yüklenmesini sağlar.
Veri kalitesi ve tutarlılığını sağlayın
Yüksek veri kalitesini sürdürmek, bir veri ambarının değerinin temelidir. Ambar içine giren verinin doğru ve tutarlı olmasını sağlamak için güçlü veri doğrulama ve yineleme giderme (deduplikasyon) prosedürleri uygulayın. Yanlış analizlere yol açabilecek sorunları önlemek için düzenli denetimler ve kalite kontrolleri ETL hattının parçası olmalıdır.
Veri güvenliği ve uyumluluğa odaklanın
Veri güvenliği en önemli öncelik olmalıdır – özellikle hassas veya düzenlemeye tabi bilgiler söz konusu olduğunda. Üç temel önlem almanız gerekir:
- Veriyi durağan hâlde ve aktarım sırasında şifreleyin.
- Yetkili kullanıcılarla sınırlamak için role dayalı erişim kontrolleri uygulayın.
- Mimariyi düzenleyici standartlarla uyumlu hâle getirin (örn. GDPR, HIPAA, sektöre özgü gereksinimler).
Performansı ve kullanımı izleyin
Veri ambarının verimli çalışmasını sürdürmek için düzenli olarak şunları izleyin:
- Sorgu performansı
- Kullanıcı erişim kalıpları
- Depolama kullanımı
Performans takibi için kullanılan araçlar, darboğazları belirlemeye yardımcı olur ve gerekli yerlerde proaktif ayarlamalar yapmanızı sağlar.
Bulut ve Şirket İçi (On-Premises) Veri Ambarı Mimarisi
Bulut tabanlı bir veri ambarını mı tercih etmelisiniz yoksa her şeyi şirket içinde mi tutmalısınız? Her yaklaşımın temel faydaları ve ödünleşimleri nelerdir? Peki hibrit bir çözüm iki dünyanın en iyisini sunar mı?
Bu bölümde bu soruları inceleyerek ihtiyaçlarınıza uygun mimariyi belirlemenize yardımcı olacağız.
Bulut tabanlı mimari
Bulut tabanlı veri ambarları benzersiz bir ölçeklenebilirlik ve esneklik sunar. Bu platformlar, işletmelerin depolama ve işlem kaynaklarını talebe göre ölçeklemesine olanak tanır; böylece, ön maliyet gerektiren altyapı yatırımları olmadan büyük ve dinamik veri hacimlerini yönetmek için idealdir.
Kullanıma göre ödeme fiyatlandırma modeli, özellikle iş yükleri dalgalanan işletmeler için bulut çözümlerini maliyet açısından verimli kılar. Ancak bulut ortamları, özellikle yüksek derecede düzenlenen sektörlerde veri yönetişimi ve uyumluluk konusunda endişelere yol açabilir.
Popüler bulut sağlayıcıları şunlardır:
- Amazon Web Services (Redshift)
- Google Cloud (BigQuery)
- Microsoft Azure (Azure Synapse Analytics)
Şirket içi mimari
Şirket içi veri ambarları, sıkı veri kontrolü gerektiren kuruluşlar için en uygunudur. Şirket içi mimaride, şirketler donanım ve verileri üzerinde tam denetime sahiptir; bu da finans, sağlık ve kamu gibi hassas bilgilerin korunması gereken sektörler için esastır.
Ancak küçük bir ayrıntı var. Şirket içi sistemler güçlü performans sunabilse de genellikle donanım için yüksek peşin maliyetler ve sürekli bakım gerektirir. Ölçekleme de zordur; manuel yükseltmeler ve donanım tedariki gerektirir ve bu da bulut çözümlerine göre daha az esnektir.
Hibrit mimari
Hibrit veri ambarı mimarileri, güvenlik, uyumluluk ve ölçeklenebilirlik arasında denge kurması gereken kuruluşlar için daha fazla esneklik sunacak şekilde bulut ve şirket içi bileşenleri birleştirir. Örneğin, hassas veriler şirket içinde saklanabilirken, daha az kritik veriler veya analitik iş yükleri bulutta işlenebilir.
Hibrit mimariler, kademeli olarak buluta geçmesi gereken veya belirli veri gizliliği gereksinimleri olan işletmeler için özellikle kullanışlıdır. Bu model iki dünyanın en iyisini sunar; ancak ortamlar arasında sorunsuz veri entegrasyonunu sağlamak için dikkatli orkestrasyon gerektirir.
Özet tablo: Bulut vs. şirket içi vs. hibrit veri ambarı mimarisi
|
Özellik |
Bulut Tabanlı Mimari |
Şirket İçi Mimari |
Hibrit Mimari |
|
Ölçeklenebilirlik |
Yüksek ölçeklenebilirlik, isteğe bağlı kaynak tahsisi |
Şirket içi donanımla sınırlı, manuel yükseltme gerektirir |
Bulutun ölçeklenebilirliğini şirket içi kontrolle birleştirir |
|
Maliyet |
Kullandıkça öde, düşük peşin maliyet |
Donanım için yüksek peşin yatırım ve sürekli bakım |
Hibrit maliyetler, bulut tasarrufu ile şirket içi giderleri dengeler |
|
Esneklik |
Son derece esnek, dinamik iş yükleri için ideal |
Daha az esnek, fiziksel altyapıyla kısıtlı |
Esnek, bulut çevikliğini şirket içi kontrolle birleştirir |
|
Güvenlik ve Uyumluluk |
Yüksek derecede düzenlenen sektörler için endişe yaratabilir |
Veri güvenliği ve yasal uyum üzerinde tam kontrol |
Hassas veriler için uyumluluk sağlarken buluttan yararlanır |
|
Performans |
Bulut sağlayıcısı ve yapılandırmaya göre değişkenlik gösterebilir |
Yüksek performans ancak donanım yatırımlarına bağlı |
İş yükü dağılımına bağlı dengeli performans |
|
Bakım |
Asgari bakım, bulut sağlayıcı tarafından yönetilir |
Sürekli dahili BT bakımı gerektirir |
Bulut servislerinin bir kısmını üstlendiği hibrit bakım |
|
Kullanım Senaryoları |
Büyük, dalgalanan veri hacimlerine sahip işletmeler için en iyisi |
Sıkı güvenlik ve uyumluluk gereksinimleri olan kuruluşlar için en iyisi |
Buluta geçiş yapan veya karma ihtiyaçları olan kuruluşlar için ideal |
Popüler Bulut Veri Ambarı Platformları
İşte bulutta kullanılan en popüler veri ambarı platformlarından bazılarının genel bir görünümü.
Amazon Redshift
Amazon Redshift, büyük ölçekli veri analitiği için tamamen yönetilen bir bulut veri ambarı çözümüdür. Mimarisi, kullanıcıların çok büyük veri kümelerini hızla sorgulamasını sağlayan, son derece paralel işlemeye (MPP) dayanır. İş yükü gereksinimlerine göre ölçeklenebilme yeteneğiyle Redshift; uygun maliyetli ölçeklenebilirliğe ve diğer AWS servisleriyle entegrasyona ihtiyaç duyan kuruluşlar için uygundur.
Google BigQuery
Google BigQuery, hızlı ve gerçek zamanlı analitik için oluşturulmuş, sunucusuz ve yüksek ölçeklenebilir bir veri ambarı platformudur. Benzersiz mimarisi, depolama ve işlemi ayrıştırır; böylece kullanıcılar altyapıyı yönetmeden petabaytlarca veriyi sorgulayabilir. BigQuery'nin, asgari ek yükle büyük ölçekli analitiği işlemesi; hızlı ve karmaşık sorgular talep eden ağır veri iş yüklerine sahip kuruluşlar için ideal olmasını sağlar.
Snowflake
Snowflake, kaynakları bağımsız olarak ölçeklendirme esnekliği sağlayan, işlemi ve depolamayı ayıran çok kümeli, paylaşımlı veri mimarisi sunar. Snowflake'in bulut yerlisi yaklaşımı, işletmelerin iş yüklerini dinamik olarak ölçeklendirmesine imkân tanır ve böylece birden çok bulut platformunda yüksek esneklik ve iş yükü yönetimi gerektiren kuruluşlar için cazip bir seçenek hâline gelir.
Microsoft Azure Synapse
Microsoft Azure Synapse Analytics, veri ambarcılığı ve büyük veri analitiğini bir araya getiren hibrit bir veri yönetim platformudur. Mimarisi, Apache Spark gibi büyük veri çerçeveleriyle entegre olur ve veri gölleri ile veri ambarlarını yönetmek için birleşik bir ortam sağlar. Azure Synapse, diğer Microsoft servisleri ile kesintisiz entegrasyon sunar ve çeşitli veri analitiği ihtiyaçları olan işletmeler için idealdir.
Özet tablo: Veri ambarı platformları
|
Platform |
Mimari |
Temel Özellikler |
Kullanım Senaryoları |
|
Amazon Redshift |
MPP mimarisi, AWS ekosistemi |
Ölçeklenebilir, hızlı sorgular, AWS entegrasyonu |
Büyük ölçekli analitik, bulut yerel uygulamalar |
|
Google BigQuery |
Sunucusuz, ayrıştırılmış depolama ve işlem |
Gerçek zamanlı analitik, düşük altyapı gereksinimi |
Hızlı analitik, gerçek zamanlı veri işleme |
|
Snowflake |
Çok kümeli, paylaşımlı veri mimarisi, bulutlar arası (AWS, Azure, GCP) |
İşlem-depolama ayrımı, dinamik ölçekleme |
Esnek ölçekleme, bulutlar arası platform iş yükleri |
|
Azure Synapse |
Hibrit, büyük veri entegrasyonu |
Birleşik analitik, Spark entegrasyonu |
Hibrit veri yönetimi, Microsoft araçlarıyla entegrasyon |
Veri Ambarı Mimarisinde Zorluklar
Veri ambarları, kuruluşların büyük miktarda veriyi analiz etmesi ve yönetmesi için güçlü olanaklar sunarken, doğası gereği bazı zorlukları da beraberinde getirir.
İşte bir veri ambarı mimarisi tasarlarken ve sürdürürken göz önünde bulundurulması gereken en önemli zorluklar ve çözümler.
Farklı kaynaklardan veri entegrasyonu
Kuruluşlar; her biri farklı format, şema ve yapılara sahip çok sayıda kaynaktan veri toplar; bu da entegrasyonu karmaşık bir zorluk hâline getirir. Temel hususlar şunlardır:
- Yapılandırılmış ve yapılandırılmamış veriyi harmanlama – İlişkisel veritabanı kayıtlarının günlükler, sosyal medya akışları veya sensör verileriyle birleştirilmesi dikkatli dönüşüm gerektirir.
- Kapsamlı veri dönüştürme ve temizleme – Ham verinin, etkili bir şekilde kullanılmadan önce temizlenmesi, biçimlendirilmesi ve standartlaştırılması gerekir.
- Hibrit ortamlar – Şirket içi sistemlerle bulut platformları arasında veri senkronizasyonu ek bir karmaşıklık katmanı ekler.
Bu zorlukları aşmak için işletmelerin, çeşitli veri formatlarını destekleyen ve platformlar arası sorunsuz entegrasyona olanak tanıyan esnek ETL süreçlerine ve veri yönetim araçlarına ihtiyacı vardır.
Ölçekte performans
Veri ambarları büyüdükçe, yüksek sorgu performansını korumak zorlaşır. Büyük ölçekli işlemler, milyonlarca—hatta milyarlarca—satırı yavaş sorgular, yüksek maliyetler ve verimsiz kaynak kullanımı olmadan verimli bir şekilde işlemelidir.
Temel optimizasyon stratejileri şunlardır:
- Veri indeksleme – Yapılandırılmış arama yolları oluşturarak veri erişimini hızlandırır.
- Bölümleme (partitioning) – Veriyi daha küçük, yönetilebilir parçalara ayırarak sorgulamayı hızlandırır.
- Materyalize görünümler – Önceden hesaplanmış sorgu sonuçlarını saklayarak işlem süresini azaltır.
- Kolon bazlı depolama formatları (örn., Parquet, ORC) – Analitik sorgular için okuma performansını artırır.
- Sorgu optimizasyon motorları – Daha hızlı performans için yürütme planlarını iyileştirir.
İş yükü yönetimi
Daha fazla kullanıcı veri ambarına eriştikçe, verimli kaynak tahsisi kritik hâle gelir. Temel hususlar şunlardır:
- Eşzamanlılık yönetimi – Aynı anda birden çok sorgu çalıştığında performans darboğazlarını önler.
- Dinamik ölçekleme – Bulut tabanlı ambarlar, talebi karşılamak için kaynakları otomatik olarak ayarlar.
- Kaynak çekişmesini yönetme – Şirket içi veya hibrit sistemler, yavaşlamaları önlemek için CPU, bellek ve disk kaynaklarını dikkatle yönetmelidir.
Bu stratejileri uygulayarak kuruluşlar, veri ambarlarının etkili bir şekilde ölçeklenmesini ve veri hacmi ile kullanıcı etkinliği arttıkça yüksek performansın korunmasını sağlayabilir.
Veri yönetişimi ve güvenlik
Veri ambarları giderek daha fazla hassas bilgi depoladıkça; ihlalleri önlemek, uyumluluğu sağlamak ve veri bütünlüğünü korumak için güçlü yönetişim ve güvenlik önlemleri esastır.
- Tutarlı yönetişim politikalarını uygulamak
- Veri erişimini kısıtlamak için role dayalı erişim kontrolleri (RBAC) uygulayın.
- Veri soy zinciri, sahiplik ve kullanımı takip etmek için veri katalogları tutun.
- Mevzuata uyum (GDPR, CCPA, HIPAA vb.)
- Kişisel verileri anonimleştirme ve maskeleme teknikleriyle koruyun.
- Yasal gereklilikleri karşılamak için veri saklama politikaları uygulayın.
- Şifreleme ve güvenlik en iyi uygulamaları
- İzinsiz erişimi önlemek için veriyi durağan hâlde ve aktarım sırasında şifreleyin.
- Hassas veriye erişimi izlemek için ayrıntılı denetim günlükleri tutun.
- Hibrit ve bulut ortamlarda güvenlik
- Şirket içi ve bulut sistemleri arasında şifreleme anahtarlarını etkin bir şekilde yönetin.
- Bulut ve şirket içi sistemler arasındaki ağ trafiğini güvence altına alın.
- Üçüncü taraf sağlayıcıların güvenlik politikalarıyla uyumu sağlayın.
Sonuç
Bu makalede, veri ambarı mimarisinin temel bileşenlerini, yaygın zorlukları ve bunların üstesinden gelme stratejilerini ele aldık. Sonuç olarak, iyi tasarlanmış bir veri ambarı yalnızca veriyi depolamaz—kuruluşların büyümeyi ve yeniliği tetikleyen, bilgiye dayalı kararlar almasını sağlar.
Veri mimarisi ve en iyi uygulamalar konusunda daha derine inmek mi istiyorsunuz? Daha fazla bilgi için şu kaynaklara göz atın:
- Understanding Data Engineering – Veri mühendisliğinin temellerini ve modern veri ekosistemlerindeki rolünü öğrenin.
- Data Warehousing Concepts – Temel veri ambarcılığı ilkeleri ve tasarımı hakkında içgörüler edinin.
- Understanding Modern Data Architecture – Veri mimarilerinin bulut çağında nasıl evrildiğini keşfedin.
- Database Design – Verimli ve ölçeklenebilir veritabanları tasarımının temellerinde ustalaşın.
- ETL and ELT in Python – Python kullanarak etkili ETL/ELT hatları oluşturmayı öğrenin.
FAQs
Bir veri ambarı bir veritabanından nasıl farklıdır?
Veritabanı, kayıt ekleme ve güncelleme gibi gerçek zamanlı işlemleri (OLTP) yapan işlemsel işleme için tasarlanmıştır. Veri ambarı ise analitik işleme (OLAP) için optimize edilmiştir ve karmaşık sorgular ile tarihsel veri analizini mümkün kılar.
Bir veri ambarı gerçek zamanlı analitiği nasıl destekler?
Geleneksel veri ambarları toplu güncellemeleri işler; ancak modern bulut tabanlı mimariler (örn. Snowflake, BigQuery), Apache Kafka, AWS Kinesis veya Google Pub/Sub gibi araçlarla akış verisini entegre ederek gerçek zamanlı analitiği mümkün kılar.
Meta veriler bir veri ambarında ne rol oynar?
Meta veriler, ambar içinde depolanan verilerin yapısı, soy zinciri ve tanımları hakkında temel bilgiler sağlar. Tutarlılığı güvence altına alır, veri yönetişimini iyileştirir ve kullanıcıların doğru veri kümelerini verimli şekilde bulmasına yardımcı olur.
Vekil anahtarlar (surrogate keys) nedir ve veri ambarı tasarımında neden kullanılır?
Vekil anahtarlar (surrogate keys), doğal anahtarlar (ör. müşteri kimliği veya ürün kodu) yerine olgu ve boyut tablolarında kullanılan, sistem tarafından üretilen benzersiz tanımlayıcılardır. Şema tasarımında performansı, tutarlılığı ve esnekliği artırırlar.
Materyalize görünümler veri ambarı performansını nasıl iyileştirir?
Materyalize görünümler, önceden hesaplanmış sorgu sonuçlarını depolar ve tekrarlayan sorgular için işlem süresini azaltır. Bu, özellikle toplamalar içeren veya karmaşık analitik sorgularda performansı önemli ölçüde iyileştirir.
Bir veri ambarı, yapay zekâ ve makine öğrenmesiyle nasıl entegre olur?
Birçok modern ambar, şu yollarla ML ve AI iş yüklerini destekler:
- Yerleşik ML işlevleri (örn. BigQuery ML, Redshift ML)
- ML çerçeveleriyle entegrasyon (örn. TensorFlow, PyTorch, Scikit-learn)
- Analistlerin yapılandırılmış veriyi ML modellere verimli şekilde sunmasını sağlayan özellik mağazaları (feature store)
Bir veri ambarında Yavaş Değişen Boyutlar (SCD) nedir?
SCD'ler, boyut tablolarındaki tarihsel değişiklikleri izler. En yaygın türler şunlardır:
- SCD Tip 1 – Eski veriyi yeni veriyle üzerine yazar.
- SCD Tip 2 – Yeni kayıtlar ekleyerek tarihsel veriyi tutar.
- SCD Tip 3 – Ek sütunlar kullanarak sınırlı geçmişi korur.
What are Slowly Changing Dimensions (SCD) in a data warehouse?
SCDs track historical changes in dimension tables. The most common types include:
- SCD Type 1 – Overwrites old data with new data.
- SCD Type 2 – Keeps historical data by adding new records.
- SCD Type 3 – Maintains limited history using additional columns.




Sağlam bir veri ambarı mimarisi kurmak, büyük ve karmaşık veri kümelerini yönetmek için kritik öneme sahiptir. Veri hacmi büyümeye devam ettikçe işletmelerin bilgiyi verimli bir şekilde depolamak, yönetmek ve analiz etmek için yapılandırılmış bir yaklaşıma ihtiyacı vardır.
Doğru mimari olmazsa yavaş sorgular, tutarsız veriler ve karar almayı olması gerekenden daha karmaşık hale getiren zorluklarla karşılaşabilirsiniz.
Bu yazıda, bir veri ambarının önemli bileşenlerini, farklı mimari türlerini ve ölçeklenebilir ve verimli bir sistem tasarlamanıza yardımcı olacak en iyi uygulamaları ele alacağım. İster yeni bir veri ambarı kuruyor olun ister mevcut olanı optimize ediyor olun, bu ilkeleri anlamak başarınızın temelini atacaktır.
Veri Ambarı Mimarisi Bileşenleri
İyi tasarlanmış bir veri ambarı, birbirine bağlı bir dizi bileşen üzerine inşa edilir. Bu bileşenler, veriyi çeşitli kaynaklardan işler, analize uygun hâle getirmek için dönüştürür ve kullanıcılara yapılandırılmış bir formatta sunar. Aşağıda, bir veri ambarı mimarisinin temel yapı taşlarını inceliyoruz.
Veri kaynakları
Bir veri ambarı; ilişkisel veritabanlarından gelen yapılandırılmış veri ve günlükler veya metin dosyaları gibi yapılandırılmamış veri dâhil olmak üzere çeşitli kaynaklardan bilgi toplar. Yaygın veri kaynakları şunlardır:
Bu çeşitli kaynakları tek bir sistemde entegre ederek işletmeler, operasyonlarına ilişkin eksiksiz ve birleşik bir görünüm elde eder.
ETL katmanı
The ETL (veya ELT) süreci, veri ambarı mimarisinin temel bir bileşenidir. Şunları içerir:
ETL'de veri, yüklemeden önce dönüştürülür; ELT'de ise ham veri önce yüklenir ve ardından ambar içinde dönüştürülür. ELT, ölçeklenebilirlik ve performans avantajları nedeniyle modern bulut tabanlı ambarlarda sıklıkla tercih edilir.
Hazırlık (staging) alanı
Hazırlık alanı, ham verinin işlenip veri ambarına yüklenmeden önce tutulduğu isteğe bağlı, geçici bir depolama alanıdır. Bu katman, ana veri depolamayı doğrudan etkilemeden veri dönüşümlerinin gerçekleşmesine olanak tanıyan bir tampon görevi görür.
Veri depolama katmanı
Veri ambarının çekirdeğinde, verinin olgu ve boyut tablolarında organize edildiği depolama katmanı bulunur:
Veri, sorgu performansı ve analiz için optimize etmek amacıyla genellikle yıldız veya kar tanesi şemasında düzenlenir.
Meta veri katmanı
The metadata katmanı, veri ambarı içindeki yapı ve ilişkileri yönetir ve sürdürür. Özünde meta veriler, veri kaynakları, şema ve dönüşümler hakkında bilgi sağlar. Bu, kullanıcıların ve sistemlerin ambar içindeki verinin bağlamını, soy zincirini ve kullanımını anlamasına imkân tanır.
Veri erişimi ve analitik katmanı
Bu katman, kullanıcıların ambar içinden veriyi almasına ve analiz etmesine olanak tanır. Tipik olarak şunları içerir:
Temel raporlama ve panolar geleneksel veri erişimi kapsamına girerken, daha karmaşık makine öğrenmesi ve öngörücü analitik iş akışları, ileri düzey hesaplama gereksinimleri nedeniyle bazen ayrı bir analitik katmanı olarak sınıflandırılır.