
Lewati ke konten utama

Apa Itu Analitik Penipuan? Teknik, Alur Kerja, dan Alat

Pelajari teknik, alur kerja, dan alat analitik penipuan yang membantu bisnis mendeteksi dan mencegah aktivitas penipuan secara real time di berbagai industri.
Diperbarui 28 Sep 2026  · 15 mnt Baca

Jelajahi bersama AI

ChatGPTClaudePerplexity

Sistem ekonomi yang sehat bergantung pada kepercayaan antara pembeli dan penjual barang serta jasa. Ketika kepercayaan ini rusak, biaya berbisnis meningkat. Pelaku tidak jujur melakukan transaksi menipu untuk merugikan bisnis. Ada juga kelompok penipu yang canggih menargetkan industri tertentu.

Dalam artikel ini, kami membahas berbagai jenis penipuan yang terdeteksi melalui analitik dan teknik yang digunakan untuk mendeteksinya. Kami juga mengulas alur kerja deteksi penipuan yang umum serta perangkat lunak yang populer digunakan untuk analitik penipuan.

Pelajari bagaimana AI dapat memengaruhi organisasi Anda dan cara menerapkan strategi AI yang sukses melalui whitepaper kami, Panduan Literasi AI untuk Learning Leader.

Apa itu Analitik Penipuan?

Analitik penipuan merujuk pada teknik statistik dan machine learning untuk mengidentifikasi dan menandai transaksi yang berpotensi curang, biasanya secara real time. 

Menemukan aktivitas penipuan menantang karena: 

  • Para penipu menggunakan berbagai teknik untuk menyamarkan transaksi mereka agar terlihat sah. Jadi, penjual memerlukan alat teknologi dan statistik untuk mendeteksi transaksi yang berpotensi curang. 
  • Transaksi curang hanya sebagian kecil dari total transaksi. Dengan demikian, pendekatan otomatis diperlukan untuk menandai transaksi yang berpotensi tidak jujur. 

Bisnis perlu menggunakan alat deteksi penipuan yang menggabungkan fitur-fitur ini. Alat-alat tersebut menandai transaksi yang sangat mungkin curang. Penyelidik manusia kemudian meninjau transaksi yang ditandai dan mengambil keputusan akhir. 

Mendeteksi potensi penipuan mencakup menemukan perilaku yang: 

  • Sesuai dengan aktivitas penipuan yang sudah diketahui.
  • Menyimpang secara signifikan dari rentang normal.

Jenis Penipuan Umum yang Terdeteksi Melalui Analitik

Pada bagian ini, kita menelusuri kategori luas dari transaksi penipuan, membahas contoh penipuan umum dalam tiap kategori, serta cara menggunakan alat analitik untuk mendeteksi dan mencegahnya.

Penipuan finansial

Penipuan finansial mungkin adalah bentuk penipuan yang paling dikenal dan paling luas terjadi. Korbannya biasanya lembaga keuangan dan para nasabahnya. Pelakunya umumnya penipu yang menyamar sebagai nasabah atau perwakilan lembaga keuangan. 

Penipuan kartu kredit adalah penggunaan kartu tanpa izin untuk membeli barang atau menarik uang di ATM. Dalam banyak kasus, ini dilakukan menggunakan detail kartu yang dicuri. Analitik penipuan dapat membantu mendeteksi penipuan kartu dengan mencari pola umum seperti:

  • Lonjakan tiba-tiba dalam frekuensi dan volume transaksi.
  • Transaksi berurutan di banyak lokasi.

Pencurian identitas terjadi ketika informasi pribadi seseorang (seperti nomor rekening bank, nomor identitas yang dikeluarkan pemerintah, kata sandi email, dll.) dicuri. Informasi ini dapat digunakan untuk menyamar sebagai individu tersebut guna mengambil pinjaman, membuka rekening overdraft, dan terlibat dalam transaksi finansial besar lainnya. Analitik penipuan membantu dalam situasi seperti ini dengan menandai perilaku mencurigakan seperti:

  • Membuka banyak rekening dalam waktu singkat.
  • Menyimpang dari perilaku masa lalu individu yang sudah diketahui.

Penipuan pembayaran adalah penggunaan cara-cara menipu untuk meyakinkan individu atau bisnis agar melakukan pembayaran untuk sesuatu yang sebenarnya tidak mereka beli. Ini mencakup:

  • Mengirim faktur palsu ke perusahaan.
  • Mengirim pesan autentikasi multifaktor palsu untuk mengonfirmasi pembayaran yang tertunda.
  • Menyamar sebagai staf bank untuk mendapatkan informasi rahasia terkait rekening.

Analitik dapat membantu menangani penipuan pembayaran dengan memantau dan menandai transaksi yang:

  • Menyimpang secara signifikan dari perilaku dan aktivitas pembayaran biasa suatu rekening.
  • Berasal dari alamat IP dan ID perangkat yang mencurigakan.

Penipuan asuransi

Penipuan asuransi mencakup klaim pembayaran besar untuk insiden kecil dan membayar premi kecil untuk polis berisiko. Korbannya biasanya perusahaan asuransi, sementara pelakunya menyamar sebagai nasabah atau agen asuransi. 

Klaim palsu berkaitan dengan kecelakaan yang tidak pernah terjadi. Untuk mendeteksi klaim seperti itu, alat analitik:

  • Memeriksa silang insiden yang dilaporkan, seperti bencana alam atau kecelakaan lalu lintas, dengan sumber lain untuk memverifikasi kebenaran laporan.
  • Menganalisis pola dalam klaim yang dibuat oleh individu tertentu atau di lokasi tertentu.

Klaim yang dibesar-besarkan melebih-lebihkan kerusakan yang terjadi dan nilai klaim pada insiden kecil. Alat analitik penipuan dapat membantu mengurangi klaim yang dibesar-besarkan dengan cara:

  • Mengestimasi jumlah klaim tipikal untuk berbagai jenis kecelakaan berdasarkan data historis.
  • Mencocokkan kecelakaan yang dilaporkan dengan jumlah klaim tipikal untuk jenis kecelakaan tersebut. 

Surveyor asuransi memverifikasi secara manual klaim yang berpotensi dibesar-besarkan.

Penghindaran premi melibatkan pemberian informasi palsu kepada perusahaan asuransi untuk secara artifisial menurunkan profil risiko dan membayar premi lebih rendah untuk suatu polis. Alat analitik penipuan dapat membantu untuk:

  • Memvalidasi informasi yang diberikan dalam aplikasi polis terhadap sumber lain. 
  • Mendeteksi pola umum yang digunakan dalam penghindaran premi. Misalnya, jika model kendaraan yang umum dipakai untuk aktivitas komersial diasuransikan untuk penggunaan pribadi, alat analitik menandainya untuk penyelidikan lebih lanjut.

Polis palsu adalah polis tiruan yang dibuat dan dijual oleh penipu yang menyamar sebagai agen asuransi. Nasabah baru menyadarinya saat mengajukan klaim. Perangkat lunak analitik penipuan mendeteksi polis palsu dengan:

  • Memeriksa silang detail polis yang tersimpan di sistem dengan yang disajikan oleh nasabah. 

Perusahaan asuransi juga memiliki tanggung jawab sosial untuk mengidentifikasi pola polis palsu yang diterbitkan atas nama mereka. Menyajikan analisis ini kepada aparat penegak hukum membantu mengungkap jaringan polis palsu.

Penipuan layanan kesehatan

Penipuan layanan kesehatan dapat terjadi di bagian mana pun dari sistem kesehatan, termasuk asuransi kesehatan publik. Korbannya adalah pihak pembayar, yang bisa merupakan satu atau lebih dari berbagai kelompok:

  • Pasien
  • Pemberi kerja pasien dalam skema co-pay
  • Pemerintah dalam sistem kesehatan yang didanai publik
  • Perusahaan asuransi

Pelakunya sering kali penyedia layanan kesehatan atau pasien. Penipuan layanan kesehatan biasanya dilakukan melalui klaim palsu, termasuk penagihan untuk layanan yang tidak diberikan dan upcoding. 

Penagihan untuk layanan yang tidak diberikan merujuk pada penagihan kepada pembayar untuk layanan (seperti tes dan perawatan) yang tidak dilakukan pada pasien. Untuk mendeteksi penipuan jenis ini, alat analitik dapat:

  • Menggunakan pengenalan pola untuk membandingkan faktur dengan jumlah dan item yang biasanya ditagihkan rekan industri untuk keluhan serupa.
  • Memeriksa silang layanan yang ditagihkan dengan log layanan penyedia kesehatan dan catatan perawatan pasien.
  • Mengidentifikasi penyedia dengan rekam jejak jumlah tagihan yang tidak biasa tinggi dan meneliti pengajuan mereka. 

Upcoding merujuk pada malapraktik menagih kategori layanan yang lebih mahal daripada yang diberikan. Alat analitik penipuan menggunakan berbagai metode untuk mendeteksi upcoding, seperti:

  • Analisis statistik untuk membandingkan rasio tes rutin dan tes mahal (atau perawatan) terhadap standar industri. Misalnya, penyedia yang sebagian besar menagih untuk pemeriksaan lanjutan dan sedikit pemeriksaan reguler patut dicurigai.
  • Membandingkan faktur dengan catatan pasien dan rumah sakit yang biasanya memuat detail prosedur atau tes yang dilakukan.
  • Membandingkan jumlah tagihan dengan data historis penyedia untuk memeriksa lonjakan mendadak pada kategori upcoding tertentu.

Penipuan e-commerce dan ritel

Banyak penjual e-commerce adalah usaha kecil dan menengah yang belum tentu andal secara teknologi. Karena itu, tanggung jawab ada pada platform e-commerce untuk mendeteksi dan menekan aktivitas penipuan. Penipuan e-commerce dan ritel dapat terjadi dalam berbagai bentuk: 

Pengambilalihan akun terjadi ketika pengguna kehilangan kendali atas akunnya kepada penipu yang menyalahgunakannya dengan melakukan pembelian tanpa izin. Ini biasanya terjadi karena kesalahan pengguna atau kurangnya perhatian pada aspek keamanan seperti kata sandi dan penipuan phishing. 

Platform e-commerce dapat mendeteksi pengambilalihan akun menggunakan teknik seperti:

  • Analisis perilaku untuk memeriksa penyimpangan dari perilaku tipikal, seperti waktu login, kategori pembelian, riwayat penelusuran, dll.
  • Aktivitas anomali (seperti banyak upaya login gagal) yang dikombinasikan dengan perubahan pengaturan akun (seperti ID email dan alamat pengiriman). 

Pengembalian palsu terjadi ketika pelaku jahat mengembalikan barang yang berbeda dari yang dibeli, seperti memesan barang mahal lalu mengembalikan barang tiruan. Ini juga mencakup pengembalian produk bekas yang tidak dapat dijual kembali. Untuk melindungi dari pengembalian palsu, analitik penipuan dapat:

  • Menganalisis pola pengembalian untuk mengidentifikasi pembeli yang sering mengembalikan barang.
  • Membandingkan pembelian asli untuk memverifikasi bahwa barang yang dikembalikan sama dengan yang dibeli.
  • Memastikan barang yang dikembalikan dalam kondisi belum digunakan. 

Pembelian curang melibatkan transaksi tanpa izin menggunakan informasi pembayaran yang dicuri atau palsu serta akun yang terkompromi. Ini dapat menimbulkan kerugian bagi penjual dan pembeli yang tidak mengetahui. Analitik penipuan dapat membantu menandai pembelian yang berpotensi curang dengan memantau transaksi untuk mengidentifikasi pola seperti:

  • Login yang sering dari banyak akun menggunakan alamat IP yang sama.
  • Mencoba berbagai nomor kartu kredit secara cepat berurutan.
  • Pembelian yang tidak biasa besar, jika melihat riwayat akun.

Penipuan chargeback melibatkan penyalahgunaan kebijakan chargeback kartu kredit untuk mengklaim pengembalian dana atas pembelian yang sah. Analitik penipuan dapat membantu melindungi dari penipuan chargeback dengan menggunakan:

  • Pengenalan pola untuk mengidentifikasi pengguna yang sering melakukan chargeback.
  • Machine learning untuk mendeteksi perilaku mencurigakan seperti banyak pembelian berturut-turut dengan cepat, terutama pada akun baru dan detail pembayaran yang baru diperbarui. 

Teknik yang Digunakan dalam Analitik Penipuan

Alat analitik penipuan menggunakan serangkaian teknik umum dengan menyesuaikannya ke berbagai konteks, himpunan data, dan perilaku penipu dalam domain tersebut. 

Semua metode analitik penipuan memiliki dua tujuan utama: 

  • Mendeteksi dan mencegah penipuan
  • Memfasilitasi pelanggan yang sah

Deteksi anomali

Para penipu sering menampilkan perilaku yang sangat berbeda dibanding pelanggan yang sah. Deteksi anomali membantu mengidentifikasi perilaku tidak biasa yang mengarah pada potensi aktivitas penipuan. Ini mencakup berbagai metode: 

  • Deteksi pencilan statistik membantu mengidentifikasi titik data yang sangat berbeda dari distribusi lainnya. Perilaku mencurigakan sering ditunjukkan oleh pencilan dalam berbagai metrik, seperti:
    • Frekuensi transaksi per jam.
    • Jumlah kode pos tempat kartu digesek dalam sehari. 
  • Isolation forest terdiri dari banyak isolation tree. Setiap isolation tree bekerja sebagai berikut:
    • Secara acak memilih suatu atribut data dan secara acak mempartisi titik data berdasarkan nilai atribut tersebut. 
    • Untuk setiap partisi, pilih atribut acak lain dan partisi lebih lanjut.
    • Proses ini berlanjut secara iteratif hingga setiap titik data terisolasi ke dalam partisi yang hanya berisi titik tersebut.
    • Diamati bahwa titik anomali dengan nilai ekstrem terisolasi (ke partisi individual) dalam iterasi yang lebih sedikit daripada titik data normal.
  • Local outlier factor adalah metode untuk mengidentifikasi perilaku anomali dengan menghitung kepadatan titik di berbagai area distribusi. 
    • Saat dataset perilaku pelanggan direpresentasikan secara grafis, ia membentuk klaster padat, masing-masing mewakili kelompok pelanggan.
    • Setiap titik data (pelanggan) dalam sebuah klaster menunjukkan perilaku yang serupa, namun tidak identik. Sering diamati bahwa data penipuan juga membentuk klaster yang terpisah dari klaster pelanggan normal.

Lihat kursus Anomaly Detection in Python untuk memahami teknik ini lebih lanjut.
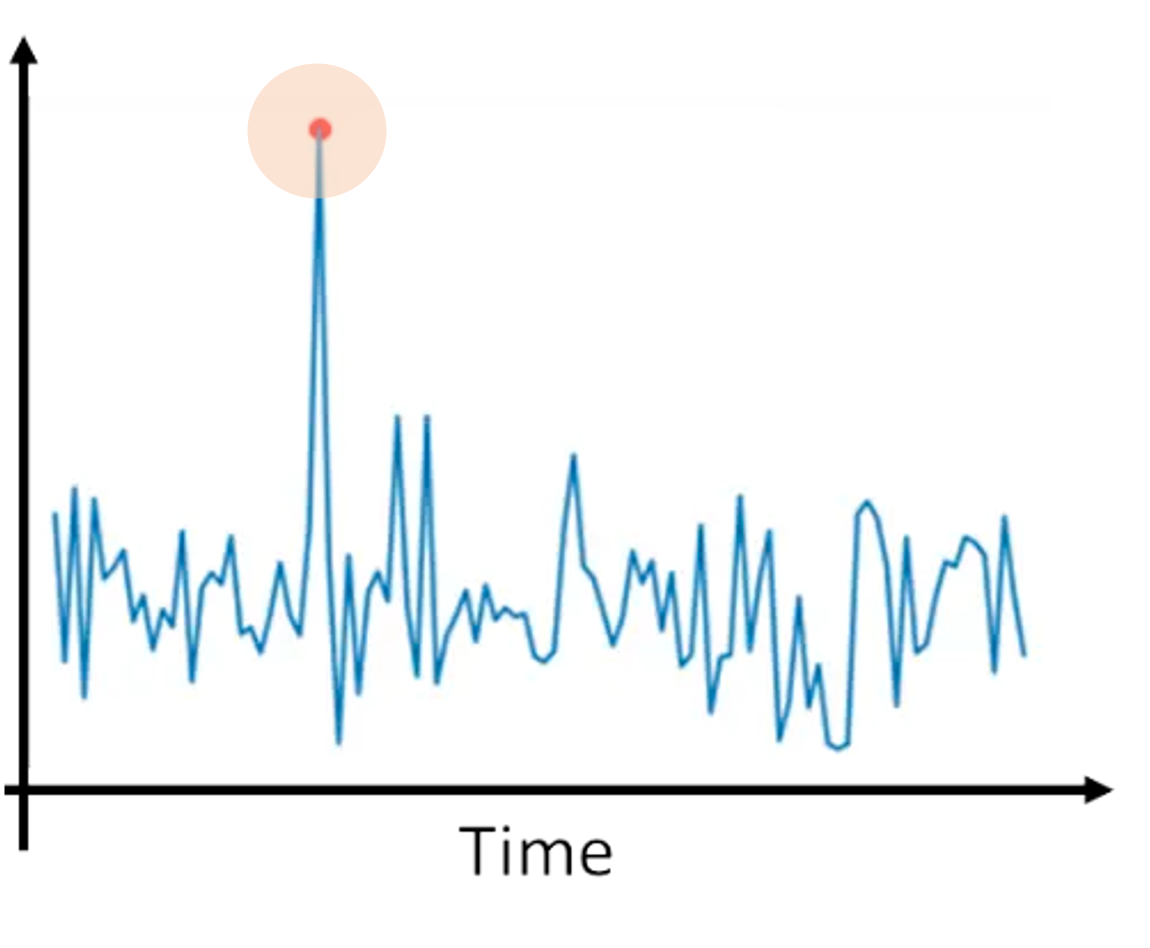
Ilustrasi deteksi anomali

Ilustrasi deteksi anomali. Sumber gambar: Understanding AI

Supervised machine learning

Supervised machine learning adalah metode teruji untuk deteksi anomali. Manusia memberi label dataset berdasarkan contoh perilaku penipuan di masa lalu yang telah diketahui. Algoritme machine learning kemudian dilatih pada dataset berlabel untuk memprediksi kemungkinan suatu transaksi baru bersifat curang.
  • Regresi logistik memprediksi probabilitas bahwa suatu titik data termasuk ke salah satu dari dua kelompok, seperti sah dan berpotensi curang. 
    • Setiap titik dalam dataset pelatihan diberi label sebagai penipuan atau sah. 
    • Selama pelatihan, model mempelajari pola dalam fitur yang mengarah pada transaksi penipuan. 
    • Ketika disajikan dengan data baru, model dapat memprediksi kemungkinan titik data tersebut bersifat curang.
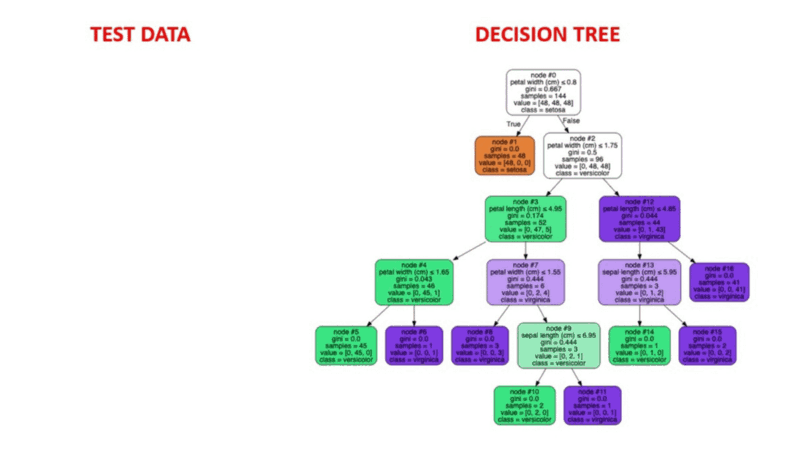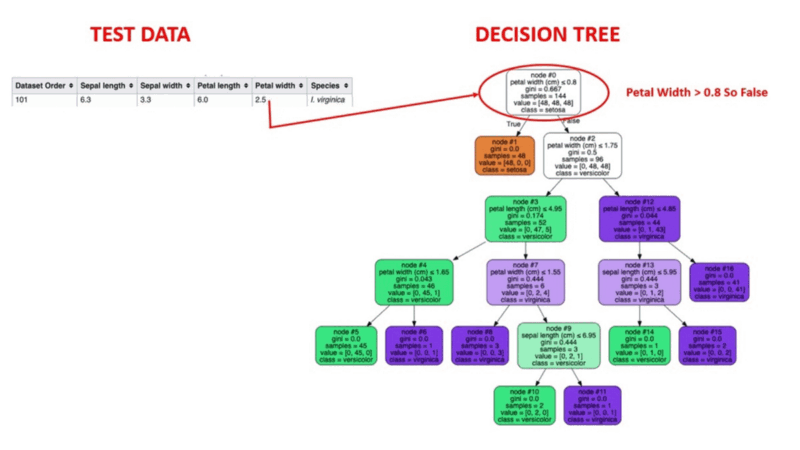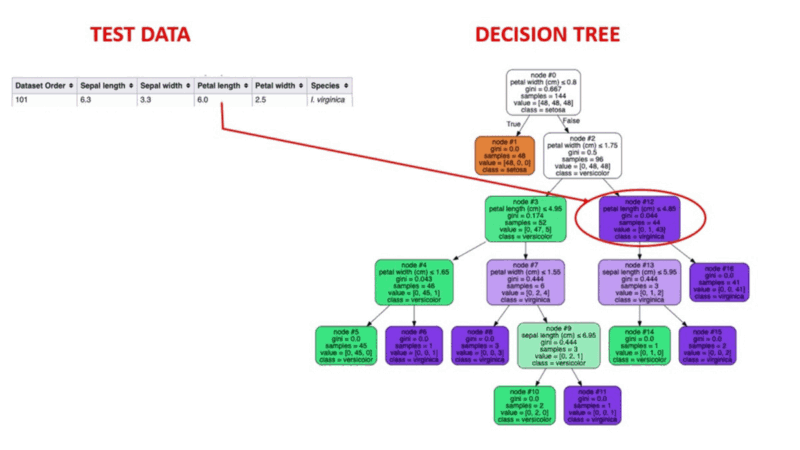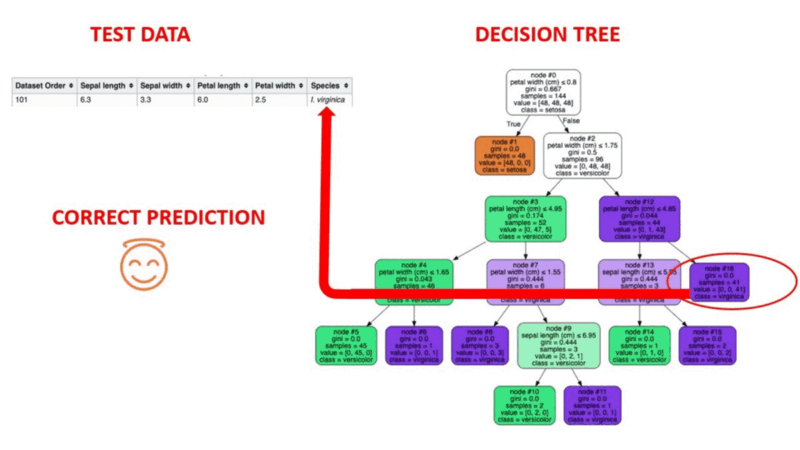
  • Decision tree memecah dataset secara rekursif menjadi subset. Setiap node membagi titik data menjadi dua cabang sesuai nilai satu atribut tertentu (seperti frekuensi transaksi atau volume transaksi bulanan). 
    • Setelah serangkaian pembagian, setiap cabang berakhir pada dua node daun - penipuan dan sah. 
    • Selama pelatihan, model mempelajari aturan untuk setiap node guna membagi dataset. 
    • Model mengklasifikasikan setiap transaksi baru sesuai aturan ini dan memprediksi apakah kemungkinan bersifat curang atau sah. 
  • Random forest terdiri dari banyak decision tree. Sebuah decision tree menerapkan serangkaian kondisi if…else untuk memutuskan apakah suatu transaksi curang. Kondisi if…else ini didasarkan pada fitur dalam dataset. 
    • Setiap pohon dalam random forest dilatih secara independen dengan menggunakan subset fitur acak untuk memprediksi transaksi penipuan. 
    • Prediksi forest didasarkan pada pengagregasian keluaran dari semua pohon individual. 
    • Pendekatan ini menghindari masalah overfitting yang umum pada decision tree dengan mempertimbangkan subset dari himpunan fitur. 

Ilustrasi animasi cara kerja decision tree

Ilustrasi animasi cara kerja decision tree. Sumber gambar: Supervised Machine Learning

Lihat jalur kursus Supervised Machine Learning in Python untuk mempelajari lebih lanjut teknik-teknik ini.

Unsupervised machine learning

Algoritme supervised machine learning, yang melakukan prediksi berdasarkan perilaku masa lalu, menjadi kurang efektif ketika penipu mengadopsi metode baru.

Unsupervised machine learning membantu memprediksi pola yang tidak diketahui dalam data. Keunggulan lain dari metode tanpa pengawasan adalah Anda tidak perlu menghabiskan sumber daya manusia untuk memberi label dataset besar. Algoritme mendeteksi pola secara mandiri.
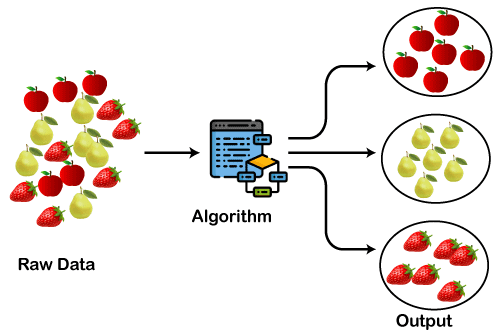
  • K-means clustering mengelompokkan seluruh dataset transaksi ke dalam berbagai klaster berdasarkan nilai titik data beserta berbagai atributnya. 
    • Titik data dalam setiap klaster memiliki atribut yang serupa, seperti frekuensi transaksi. Transaksi penipuan teramati tidak masuk ke klaster utama lainnya. 
    • Secara visual, mereka cenderung jauh dari klaster lain. Transaksi yang berpotensi curang dapat diidentifikasi dengan menganalisis klaster pencilan ini. 
  • Density-based spatial clustering of applications with noise (DBSCAN) melibatkan representasi dataset transaksi dalam ruang fitur. Dalam representasi ini, titik data terpisah menjadi wilayah berkepadatan tinggi dan rendah. 
    • Wilayah berkepadatan tinggi dianggap sebagai klaster, dan wilayah jarang dianggap sebagai pencilan. 
    • Titik data yang jatuh di wilayah jarang ditandai sebagai berpotensi curang. Titik-titik ini kemudian dianalisis untuk bukti lebih lanjut atas aktivitas mencurigakan.

Ilustrasi clustering dalam machine learning

Cara kerja clustering. Sumber gambar: Clustering in Machine Learning

Lihat Unsupervised Learning in Python untuk mempelajari lebih lanjut teknik-teknik yang disebutkan.

Analisis jaringan

Metode tradisional deteksi penipuan dengan pencocokan pola untuk perilaku mencurigakan efektif untuk akun individual. Namun, para penipu sering beroperasi sebagai kelompok individu yang menggunakan serangkaian perangkat, akun email, dan alamat fisik, sehingga sulit melacak perilaku mencurigakan saat akun tersebut dipertimbangkan secara terpisah. 

  • Fraud ring adalah kelompok individu yang melakukan serangan terkoordinasi. Misalnya, anggota ring dapat menggunakan sepuluh perangkat dan alamat IP berbeda untuk melakukan sepuluh transaksi berturut-turut. Analisis jaringan dapat mendeteksi hubungan antar berbagai entitas untuk membuat peta hubungan entitas dan mengidentifikasi fraud ring. 
  • Peta hubungan entitas adalah struktur mirip grafik dengan node yang mewakili entitas dan edge yang mewakili relasinya. Entitas dapat berupa individu, akun, ID email, ID perangkat, alamat IP, alamat fisik, dan lainnya. Relasi antar entitas menunjukkan kesamaan atau perilaku serupa, seperti:
    • Berbagai alamat IP menggunakan detail pembayaran curian yang sama.
    • Berbagai akun melakukan pesanan curang ke alamat fisik yang sama.

Lihat kursus Introduction to Network Analysis in Python untuk pemahaman lebih mendalam tentang teknik ini. 

Text mining dan natural language processing (NLP)

Banyak bentuk penipuan, seperti klaim asuransi palsu, ulasan pelanggan palsu, email phishing, dan sejenisnya, berbasis pada blok teks. Menganalisis konten teksnya sering mengarah pada petunjuk untuk membedakan aktivitas pelanggan yang sah dari upaya penipuan. 

  • Natural language processing (NLP) terdiri dari teknik seperti analisis sentimen dan named entity recognition (NER). NLP digunakan dalam aplikasi seperti:
    • Klaim asuransi curang sering mengandung ketidakkonsistenan dalam deskripsi klaim. NLP dapat mengidentifikasi pernyataan yang bertentangan dan bahasa yang tidak biasa, sementara NER dapat menunjukkan hubungan antara tempat, tanggal, dan orang. 
    • Ulasan pelanggan palsu sering dikirimkan oleh berbagai akun untuk produk yang sama atau oleh akun yang sama untuk berbagai produk. Ulasan ini cenderung berisi bahasa yang serupa, yang dapat diidentifikasi menggunakan analisis sentimen dan deteksi nada. 
    • Email phishing dan upaya peretasan lain berbasis rekayasa sosial sering mengikuti pola bahasa serupa yang dirancang untuk mengekstrak informasi sensitif dari penerima. Metode NLP standar berguna untuk mengidentifikasi pola tersebut dan memperingatkan penerima. 
  • Algoritme text mining memproses volume besar teks tidak terstruktur, seperti email, klaim, dan ulasan, untuk mendeteksi kemunculan umum pola bahasa mencurigakan dan terminologi spesifik yang lazim pada aktivitas penipuan.
    • Asumsi kunci di balik text mining adalah bahwa sebagian besar aktivitas penipuan termasuk dalam sejumlah kategori terbatas dan dijalankan oleh sekelompok kecil individu. Dengan demikian, mengidentifikasi kesamaan dengan mencari pola dalam konten teks merupakan metode yang layak untuk menandai potensi upaya penipuan. 

Lihat jalur keterampilan Natural Language Processing in Python untuk pemahaman lebih mendalam tentang topik ini.
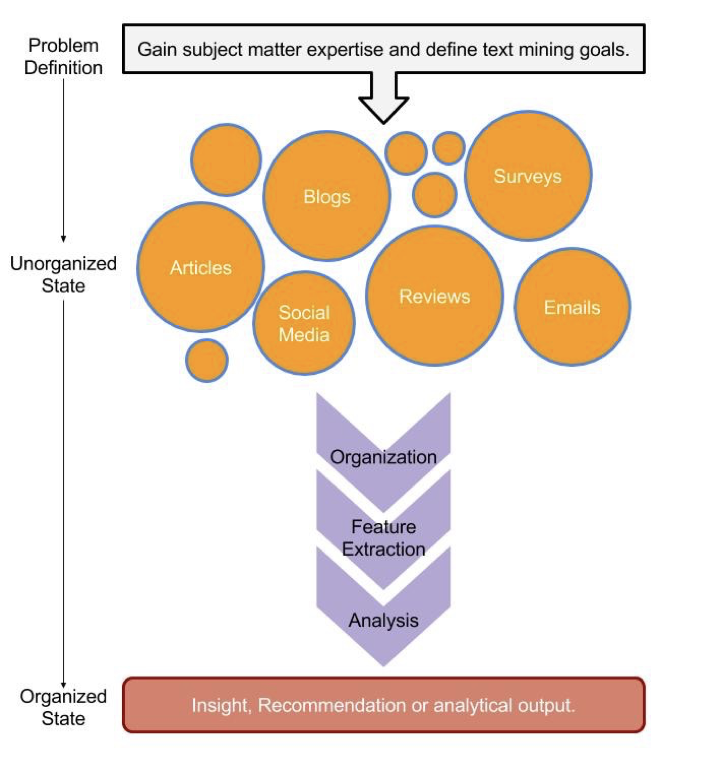
Ilustrasi alur kerja text mining

Ilustrasi alur kerja text mining. Sumber gambar: Text Mining with Bag-of-Words in R

Alur Kerja Deteksi Penipuan

Pada bagian ini, kami memberikan gambaran tingkat tinggi tentang prinsip-prinsip praktis penerapan alur kerja deteksi penipuan.

Pengumpulan data

Semua algoritme deteksi penipuan didasarkan pada analisis dan identifikasi pola yang diamati dalam dataset besar. Karenanya, dataset yang berkualitas tinggi, relevan, dan terkurasi seperti log transaksi dan profil pelanggan sangat penting untuk melatih algoritme ini. 

  • Log transaksi digunakan untuk menganalisis transaksi historis dan menemukan pola berdasarkan detail seperti jumlah, volume, frekuensi, alamat IP, stempel waktu, dan lainnya. 
  • Database pelanggan berisi alamat, detail pembayaran, riwayat penelusuran, riwayat pembelian, ulasan yang ditinggalkan, pengembalian, dan lainnya.
  • Sumber data pihak ketiga berguna untuk mengonfirmasi temuan berdasarkan dataset internal dan meningkatkan kualitas data.

Prapemrosesan data

Setelah mengumpulkan data, langkah logis berikutnya adalah menggunakannya untuk melatih model deteksi penipuan. Data mentah umumnya tidak cocok untuk melatih model. Karena itu, pembersihan dan normalisasi data sebelum digunakan sebagai dataset pelatihan adalah hal yang diperlukan. Prapemrosesan data, bersama rekayasa fitur, mencakup langkah-langkah ini.

  • Pembersihan data menangani nilai hilang, nilai yang salah format (misalnya angka diformat sebagai teks), catatan duplikat, nilai salah, dan lainnya. Membiarkan nilai seperti ini dalam dataset menghasilkan model yang dilatih buruk. Jadi, pembersihan data adalah langkah pertama untuk memastikan dataset yang dapat digunakan. 
  • Normalisasi data melibatkan pengekspresian nilai numerik dalam skala yang seragam. Ini juga dapat mencakup menerjemahkan peringkat berbasis huruf ke nilai numerik. Ini sangat penting saat sumber data digabungkan untuk membentuk dataset yang lebih besar.
  • Rekayasa fitur mentransformasikan informasi yang tersedia menjadi bentuk yang lebih berguna.

Pelatihan dan evaluasi model

Algoritme analitik penipuan pada dasarnya dibangun di atas teknik machine learning. Data historis adalah dasar untuk melatih algoritme machine learning. Setelah mengumpulkan dan membersihkan data, langkah selanjutnya adalah melatih model. Selama pelatihan, model belajar memprediksi transaksi atau profil pengguna mana yang lebih mungkin curang. 

Selain menandai perilaku yang berpotensi curang, sama pentingnya untuk tidak menghambat pengguna reguler. False positive terjadi ketika model menandai transaksi sah sebagai penipuan. Meminimalkan false positive penting untuk menjaga pengalaman pelanggan yang baik. Untuk memastikan hal ini, model yang dilatih dievaluasi menggunakan berbagai metrik.

Deteksi penipuan real time

Setelah penipuan terjadi, akan semakin sulit untuk memulihkan dana atau barang yang dicuri dari pelaku. Oleh karena itu, tujuannya adalah mendeteksi dan mencegah penipuan secara real time sebelum transaksi dieksekusi. Mengintegrasikan analitik penipuan ke dalam pipeline pemrosesan transaksi memungkinkan deteksi real time. Ada dua cara untuk melakukan ini: 

  • Mengalirkan data dari pipeline transaksi ke sistem analitik penipuan real time: Alat streaming peristiwa seperti Apache Kafka memungkinkan transmisi data transaksi real time ke sistem analitik penipuan. Platform analitik penipuan real time menandai transaksi mencurigakan untuk validasi manusia. Pipeline pemrosesan transaksi juga menerima konfirmasi dari sistem analitik penipuan sebelum memfinalisasi transaksi.
  • Menerapkan analitik penipuan di dalam pipeline pemrosesan transaksi: Ini dilakukan dengan alat seperti Apache Flink. Flink menawarkan kemampuan pemrosesan event-time pada aliran data, yang dalam konteks analitik penipuan disebut pemrosesan stream real time atas data transaksi. Flink juga terintegrasi dengan model machine learning.

Pelaporan dan pemantauan

Para pemangku kepentingan seperti manajemen perusahaan, data scientist, petugas kepatuhan, analis penipuan, dan tim keamanan memantau hasil upaya deteksi penipuan yang sedang berlangsung. Alat seperti dasbor, peringatan real time, dan laporan otomatis memfasilitasi pemantauan dan pengawasan. 

  • Dasbor menampilkan metrik penting secara visual, seperti jumlah transaksi curang, tingkat keberhasilan dan kegagalan alat analitik penipuan, kerugian moneter yang ditimbulkan, dan lainnya. Dasbor memudahkan menyoroti informasi penting tanpa menyelami laporan terperinci. 
  • Ketika perangkat lunak mencurigai adanya aktivitas penipuan, ia mengirim peringatan real time untuk memberi tahu manusia yang bertanggung jawab atas pemantauan transaksi. Semua prediksi algoritmik memiliki tingkat keyakinan tertentu—dalam banyak kasus, penilaian manusia penting untuk pengambilan keputusan. Selain itu, dalam beberapa kasus, diperlukan langkah perbaikan untuk mencegah kerusakan lebih lanjut, seperti memblokir transaksi pada kartu yang diduga dicuri. Pembaruan real time mempercepat proses tersebut. 
  • Laporan otomatis secara berkala mengumpulkan informasi tentang aktivitas alat analitik penipuan. Laporan ini memudahkan pemantauan kinerja dan melakukan intervensi jika perlu.
  • Notifikasi pelanggan memberi tahu pelanggan saat aktivitas penipuan dicurigai pada akun mereka. Terkadang, perangkat lunak analitik salah mendeteksi aktivitas pelanggan yang sah sebagai berpotensi curang. Diperlukan konfirmasi manual dari pelanggan sebelum memproses transaksi tersebut. Dalam kasus lain, penting untuk memberi tahu pelanggan bahwa akun mereka ditangguhkan karena aktivitas mencurigakan dan mereka perlu mengaktifkannya kembali. 

Alat dan Platform untuk Analitik Penipuan

Mengingat signifikansi dan luasnya penerapan analitik penipuan, banyak perangkat lunak digunakan di bidang ini. Ini mencakup alat open-source maupun sistem proprietari. Pada bagian ini, kami memberikan gambaran umum alat dan platform yang paling umum digunakan dalam analitik penipuan.

Python, SQL, dan R

Data pelanggan dan log transaksi biasanya disimpan dalam penyimpanan data relasional. 

  • SQL adalah alat yang kuat dan fleksibel untuk mengekstrak dataset yang relevan. SQL memungkinkan pengembang menulis dan mengoptimalkan kueri untuk mengambil dataset yang memenuhi berbagai kriteria. Dataset ini dianalisis untuk menemukan tren dan pola yang mengarah pada potensi aktivitas penipuan. 
  • Python, karena ekosistem pustakanya yang besar dan komunitas pengembang yang luas, sering menjadi alat pilihan untuk membangun dan menguji berbagai algoritme analitik. Secara umum, Python juga digunakan untuk banyak aplikasi berbasis keuangan. 
  • Analisis statistik berada di inti banyak metode deteksi penipuan. Karena itu, R, dengan pustaka fungsi statistiknya yang besar, ideal untuk berbagai analisis data ad-hoc guna mendeteksi penipuan. 

Dengan demikian, Python, SQL, dan R memberikan seperangkat alat yang ideal bagi pengembang untuk membangun sistem analitik penipuan khusus. Namun, alat-alat ini dapat kesulitan memproses dataset besar secara efisien. Implementasi sistem analitik sering menggunakan perangkat lunak khusus lain seperti Apache Spark (dibahas di bawah).

Selain itu, alat yang dibangun di atas Python dan SQL mungkin kurang cocok untuk audiens non-teknis seperti analis penipuan dan petugas kepatuhan. Umum untuk menyampaikan solusi terintegrasi yang dibangun menggunakan alat pihak ketiga seperti SAS (dibahas kemudian).

Apache Spark

Banyak teknik analitik penipuan berbasis pada algoritme machine learning yang dilatih pada log transaksi dan dataset pelanggan. Mendeteksi pola secara real time memerlukan pemrosesan data dalam volume besar. Misalnya, pemroses kartu kredit menangani jutaan transaksi per hari. Untuk mendeteksi suatu fraud ring, sistem analitik harus memproses data transaksi selama banyak hari secara efisien.

Apache Spark adalah mesin pemrosesan data open-source yang diskalakan secara horizontal di seluruh klaster. Berkat kemampuan komputasi in-memory, Spark dapat menangani dataset besar tanpa harus bergantung pada pemrosesan batch. 

Spark menerima data masukan dari berbagai sumber data, seperti Cassandra dan Amazon S3. Spark juga menawarkan API dalam banyak bahasa, termasuk Python dan Java. Dengan demikian, Spark sangat cocok untuk kasus penggunaan big data seperti analitik penipuan. 

Lihat kursus Introduction to PySpark untuk mempelajari bahasa pemrosesan data yang kuat ini hari ini.

Tableau dan Power BI

Analitik penipuan melibatkan dataset besar dan analisis kompleks. Visualisasi membuat informasi ini lebih mudah dan lebih cepat dipahami manusia. Tableau dan Power BI adalah alat visualisasi data yang dapat terhubung ke berbagai sumber data. Keduanya digunakan untuk tugas pelaporan dan analisis. 

  • Alat-alat ini membuat dasbor interaktif untuk melaporkan metrik penting seperti tren, tingkat keberhasilan dan kegagalan, jumlah kerugian, dan volume transaksi. Visualisasi juga dapat mengkategorikan informasi ini berdasarkan jenis penipuan dan wilayah geografis. 
  • Selain pelaporan, Power BI dan Tableau juga memfasilitasi analisis penipuan dengan menyajikan informasi secara visual tentang potensi fraud ring, analisis jaringan, dan berbagai probabilitas.
  • Alat-alat ini juga memungkinkan analis mengontrol secara visual berbagai filter, kriteria deteksi, dan tingkat keyakinan. Ini membantu membuat keputusan cepat apakah transaksi sah atau curang. 

Alat-alat ini dirancang sebagai alat visualisasi serbaguna dengan modul dan antarmuka pengguna spesifik untuk analitik penipuan. Anda dapat mulai belajar PowerBI hari ini dengan mengikuti jalur keterampilan PowerBI Fundamentals.

SAS Fraud Management

SAS adalah rangkaian perangkat lunak statistik yang dibuat oleh SAS Institute. Institusi ini juga membuat paket khusus domain untuk berbagai aplikasi, termasuk analitik penipuan. 

SAS Fraud Management menggunakan teknik statistik dan algoritme machine learning untuk memprediksi dan mencegah penipuan. Algoritme ini diproduktan agar orang seperti analis penipuan dan petugas kepatuhan yang tidak memiliki latar belakang machine learning juga dapat menggunakan metode ML dan statistik untuk deteksi penipuan.

H2O.ai

H2O.ai menawarkan layanan machine learning berbasis cloud yang terotomasi. Perangkat lunak H2O.ai menandai aktivitas yang berpotensi curang, memberi skor kemungkinan penipuan, dan menetapkan kode alasan untuk menunjukkan mengapa algoritme mencurigai penipuan. 

Pedoman ini membantu penyelidik manusia menggali lebih dalam untuk memverifikasi transaksi. Dalam banyak kasus, pedoman ini juga membantu memberi lampu hijau pada transaksi yang sah untuk mempercepat pemrosesannya. 

IBM Safer Payments

IBM Safer Payments adalah sistem deteksi penipuan yang secara khusus ditujukan untuk industri pembayaran. 

Karena menggunakan basis data NoSQL in-memory, sistem ini dapat memantau pembayaran secara real time. Sistem ini mencegah penipuan dalam sistem pembayaran non-tunai, seperti pembayaran kartu kredit, dengan menganalisis aliran transaksi secara real time dan memblokir transaksi yang berpotensi curang sebelum dieksekusi.

Kesimpulan

Artikel ini memberikan gambaran tentang berbagai jenis penipuan dan peran analitik penipuan dalam mendeteksi serta mencegahnya. Artikel ini membahas teknik yang umum digunakan untuk mendeteksi kasus potensi penipuan dan alur kerja deteksi penipuan. Terakhir, artikel memperkenalkan beberapa aplikasi perangkat lunak yang umum digunakan di domain ini.

Untuk mempelajari cara membangun sistem deteksi penipuan menggunakan Python, ikuti kursus Fraud Detection in Python. Untuk mendapatkan pengantar luas tentang Python untuk aplikasi keuangan, ikuti kursus Introduction to Python for Finance. Untuk mempelajari lebih lanjut tentang fungsi statistik di R yang digunakan untuk aplikasi deteksi penipuan, ikuti kursus Fraud Detection in R.

FAQs

Dapatkah analitik penipuan sepenuhnya menghilangkan penipuan?

Tidak, analitik penipuan secara signifikan mengurangi penipuan tetapi tidak dapat menghilangkannya sepenuhnya. Analitik membantu menandai transaksi berisiko tinggi, namun pengawasan manusia tetap diperlukan.

Bagaimana bisnis menangani transaksi yang ditandai secara real time?

Transaksi yang ditandai sering ditinjau oleh penyelidik manusia. Sistem otomatis juga dapat memblokir transaksi mencurigakan sambil menunggu tinjauan lebih lanjut.

Data apa yang penting untuk deteksi penipuan yang efektif?

Data kunci mencakup log transaksi, profil pelanggan, sumber validasi pihak ketiga, dan data perangkat. Data yang berkualitas tinggi dan bersih meningkatkan akurasi deteksi.

Bagaimana model unsupervised machine learning berkembang mengikuti pola penipuan baru?

Model tanpa pengawasan terus beradaptasi dengan perilaku baru dengan mengidentifikasi pola dan anomali yang tidak diketahui, sehingga lebih efektif mendeteksi metode penipuan yang muncul.

Bagaimana sistem deteksi penipuan menyeimbangkan kecepatan dan akurasi?

Sistem menggunakan alat pemrosesan data real time seperti Apache Flink untuk menganalisis transaksi secara instan sambil meminimalkan false positive dengan menyempurnakan algoritme dari waktu ke waktu.


Arun Nanda's photo
Author
Arun Nanda
LinkedIn

Arun adalah mantan pendiri startup yang gemar membangun hal-hal baru. Saat ini ia mengeksplorasi landasan teknis dan matematis Kecerdasan Buatan. Ia senang berbagi apa yang dipelajarinya, sehingga ia menulis tentang topik tersebut.

Selain di DataCamp, Anda dapat membaca publikasinya di Medium, Airbyte, dan Vultr.

Topik
Analisis Data
Machine Learning

Pelajari lebih lanjut tentang analitik dan machine learning melalui kursus-kursus ini!

Kursus

Memahami Machine Learning

2 jam
311.6K
Pengantar machine learning tanpa perlu coding.
Lihat DetailRight Arrow
Mulai Kursus
Lihat SelengkapnyaRight Arrow
Terkait

blogs

Spaghetti Plot dan Jalur Badai

Temukan alasan mengapa Anda sebaiknya (tidak) menggunakan spaghetti plot untuk menyampaikan ketidakpastian jalur prediksi badai serta dampaknya terhadap interpretasi.
Hugo Bowne-Anderson's photo

Hugo Bowne-Anderson

13 mnt

blogs

Tutorial Korelasi di R

Dapatkan pengenalan dasar-dasar korelasi di R: pelajari lebih lanjut tentang koefisien korelasi, matriks korelasi, plotting korelasi, dan sebagainya.
David Woods's photo

David Woods

13 mnt

blogs

12 Alternatif ChatGPT Terbaik yang Bisa Anda Coba pada 2026

Artikel ini menyajikan daftar alternatif ChatGPT yang akan meningkatkan produktivitas Anda.
Javier Canales Luna's photo

Javier Canales Luna

14 mnt

blogs

40 Pertanyaan Wawancara DBMS Teratas di 2026

Kuasai pertanyaan wawancara basis data, dari konsep SQL dasar hingga skenario desain sistem tingkat lanjut. Panduan mendalam ini mencakup semua yang Anda perlukan untuk sukses di wawancara DBMS dan meraih peran berikutnya.
Dario Radečić's photo

Dario Radečić

15 mnt

Lihat SelengkapnyaLihat Selengkapnya
