
Veelvoorkomende vormen van fraude die via analytics worden opgespoord
In deze sectie verkennen we brede categorieën van frauduleuze transacties, bespreken we veelvoorkomende voorbeelden binnen elke categorie en hoe je analytics-tools kunt gebruiken om ze te detecteren en te voorkomen.
Financiële fraude
Financiële fraude is wellicht de bekendste en meest wijdverspreide vorm van fraude. Slachtoffers zijn doorgaans financiële instellingen en hun klanten. De daders doen zich meestal voor als klanten of als medewerkers van financiële instellingen.
Creditcardfraude is het ongeautoriseerd gebruik van een kaart om goederen te kopen of geld op te nemen bij een geldautomaat. Dit gebeurt meestal met gestolen kaartgegevens. Fraudanalytics kan kaartfraude opsporen door te letten op patronen zoals:
- Plotselinge pieken in de frequentie en omvang van transacties.
- Opeenvolgende transacties op meerdere locaties.
Identiteitsdiefstal ontstaat wanneer iemands persoonlijke informatie (zoals bankrekeningnummers, door de overheid uitgegeven ID-nummers, e-mailwachtwoorden, enz.) wordt gestolen. Die informatie kan worden gebruikt om de persoon te imiteren om leningen af te sluiten, roodstandfaciliteiten te openen en andere grote financiële transacties te doen. Fraudanalytics helpt in zulke situaties door verdacht gedrag te markeren, zoals:
- Meerdere accounts openen in korte tijd.
- Afwijken van het bekende eerdere gedrag van de persoon.
Betaalfraude is het gebruik van misleiding om een persoon of bedrijf te laten betalen voor iets dat niet wordt gekocht. Dit omvat:
- Valse facturen naar bedrijven sturen.
- Valse berichten voor multifactorauthenticatie sturen om een lopende betaling te bevestigen.
- Zich voordoen als bankmedewerker om vertrouwelijke rekeninginformatie los te peuteren.
Analytics kan bij betaalfraude helpen door transacties te monitoren en te markeren die:
- Sterk afwijken van het gebruikelijke gedrag en de betalingsactiviteit van de rekening.
- Afkomstig zijn van verdachte IP-adressen en apparaat-ID's.
Verzekeringsfraude
Verzekeringsfraude omvat het claimen van hoge uitkeringen voor kleine incidenten en het betalen van lage premies voor risicovolle polissen. Het slachtoffer is doorgaans de verzekeraar, terwijl de daders zich voordoen als klanten of verzekeringsagenten.
Frauduleuze claims gaan over ongevallen die nooit hebben plaatsgevonden. Om zulke claims te detecteren doen analytics-tools het volgende:
- Gerapporteerde incidenten, zoals een natuurramp of een verkeersongeluk, kruisvalidatie met andere bronnen om de juistheid van het rapport te verifiëren.
- Patronen analyseren in claims die door specifieke personen of op bepaalde locaties worden ingediend.
Opgeblazen claims vergroten de geleden schade en de geclaimde uitkering bij kleine incidenten. Fraudanalytics-tools kunnen helpen om opgeblazen claims te beperken door:
- Op basis van historische data typische claimbedragen voor verschillende ongevalstypen te schatten.
- Het gemelde ongeval te vergelijken met de gebruikelijke claimbedragen voor dat type ongeval.
Verzekeringsinspecteurs verifiëren mogelijk opgeblazen claims handmatig.
Premieontduiking houdt in dat onjuiste informatie aan de verzekeraar wordt gegeven om het risicoprofiel kunstmatig te verlagen en lagere premies te betalen voor een bepaalde polis. Fraudanalytics-tools kunnen helpen om:
- De informatie in de polisaanvraag te valideren aan de hand van andere bronnen.
- Veelvoorkomende patronen in premieontduiking te detecteren. Zo wordt een voertuigmodel dat vaak voor commerciële activiteiten wordt gebruikt en als particulier gebruik is opgegeven, door analytics-tools gemarkeerd voor nader onderzoek.
Valse polissen zijn vervalste polissen die worden gemaakt en verkocht door oplichters die zich voordoen als verzekeringsagenten. De klant ontdekt dit wanneer hij of zij een claim wil indienen. Fraudesoftware spoort valse polissen op door:
- De polisgegevens in het systeem te vergelijken met de gegevens die de klant aanlevert.
Verzekeraars hebben ook een maatschappelijke taak om patronen van valse polissen op hun naam te identificeren. Door deze analyses te delen met de autoriteiten kunnen bendes met valse polissen worden opgerold.
Zorgfraude
Zorgfraude kan in elk onderdeel van het zorgstelsel plaatsvinden, ook bij publieke zorgverzekeraars. Het slachtoffer is de betaler, en dat kunnen verschillende partijen zijn:
- De patiënt
- De werkgever van de patiënt in een meebetaalconstructie
- De overheid in publiek gefinancierde zorgstelsels
- De verzekeraar
De daders zijn vaak zorgverleners of patiënten. Zorgfraude wordt meestal gepleegd via valse declaraties, zoals factureren voor niet-geleverde zorg en upcoding.
Factureren voor niet-geleverde zorg betekent dat betalers worden belast voor diensten (zoals testen en behandelingen) die niet bij de patiënt zijn uitgevoerd. Om dit soort fraude te detecteren kunnen analytics-tools:
- Patroonherkenning gebruiken om facturen te vergelijken met bedragen en posten die branchegenoten doorgaans in rekening brengen voor vergelijkbare klachten.
- Gefactureerde diensten kruisvalidatie met servicelogboeken van de zorgverlener en patiëntendossiers.
- Zorgverleners met opvallend hoge declaratiebedragen identificeren en hun indieningen nauwlettender bekijken.
Upcoding verwijst naar de misstand waarbij een duurdere zorgcategorie wordt gedeclareerd dan feitelijk is geleverd. Fraudanalytics-tools gebruiken verschillende methoden om upcoding op te sporen, zoals:
- Statistische analyse om de verhouding tussen routineonderzoeken en dure onderzoeken (of behandelingen) te vergelijken met branchestandaarden. Een aanbieder die vooral uitgebreide en zelden reguliere controles factureert, is verdacht.
- Facturen vergelijken met patiënt- en ziekenhuisdossiers die doorgaans details bevatten over de uitgevoerde procedure of test.
- Gefactureerde bedragen vergelijken met de historische data van de aanbieder om plotselinge stijgingen in specifieke upcodingcategorieën te detecteren.
E-commerce- en detailhandelfraude
Veel e-commerceverkopers zijn kleine en middelgrote bedrijven die niet per se tech-savvy zijn. Daarom ligt de verantwoordelijkheid bij e-commerceplatforms om frauduleuze activiteiten te detecteren en in te dammen. E-commerce- en retailfraude kan verschillende vormen aannemen:
Accountovernames betekenen dat een gebruiker de controle over zijn account verliest aan fraudeurs die ongeautoriseerde aankopen doen. Dit gebeurt meestal door gebruikersfouten of onoplettendheid rond beveiliging, zoals wachtwoorden en phishing.
E-commerceplatforms kunnen accountovernames detecteren met technieken zoals:
- Gedragsanalyse om afwijkingen van typisch gedrag te controleren, zoals inlogtijden, categorieën van aankopen, browsegeschiedenis, enz.
- Anomalieën (zoals meerdere mislukte inlogpogingen) in combinatie met wijzigingen in accountinstellingen (zoals e-mailadressen en bezorgadressen).
Valse retouren ontstaan wanneer kwaadwillenden iets anders retourneren dan wat is gekocht, zoals een duur product bestellen en een namaakexemplaar terugsturen. Het omvat ook het retourneren van gebruikte producten die niet opnieuw verkocht kunnen worden. Om valse retouren tegen te gaan, kan fraudanalytics het volgende doen:
- Retourpatronen analyseren om kopers te identificeren die vaak artikelen terugsturen.
- De oorspronkelijke aankoop vergelijken om te verifiëren dat het geretourneerde artikel hetzelfde is als het gekochte.
- Controleren dat het geretourneerde artikel ongebruikt is.
Frauduleuze aankopen betreffen ongeautoriseerde transacties met gestolen of valse betaalinformatie en gecompromitteerde accounts. Ze kunnen zowel voor verkopers als nietsvermoedende kopers tot verliezen leiden. Fraudanalytics kan mogelijk frauduleuze aankopen markeren door transacties te monitoren en patronen te herkennen zoals:
- Veelvuldige logins op meerdere accounts vanaf hetzelfde IP-adres.
- In korte tijd verschillende creditcardnummers uitproberen.
- Ongebruikelijk grote aankopen, gelet op de geschiedenis van het account.
Terugboekingsfraude (chargeback) houdt misbruik van het terugboekingsbeleid van creditcards in om terugbetalingen te claimen voor legitieme aankopen. Fraudanalytics kan hiertegen beschermen met:
- Patroonherkenning om gebruikers te identificeren die vaak terugboekingen aanvragen.
- Machine learning om verdacht gedrag te detecteren, zoals meerdere aankopen in korte tijd, vooral bij nieuwe accounts en recent bijgewerkte betaalgegevens.
Technieken die worden gebruikt in fraudanalytics
Fraudanalytics-tools gebruiken een reeks gangbare technieken die ze aanpassen aan verschillende contexten, datasets en het gedrag van fraudeurs in dat domein.
Alle methoden voor fraudanalytics hebben twee hoofddoelen:
- Fraude detecteren en voorkomen
- Echte klanten faciliteren
Anomaliedetectie
Fraudeurs vertonen vaak aanzienlijk ander gedrag dan legitieme klanten. Anomaliedetectie helpt ongebruikelijke gedragingen te identificeren die kunnen wijzen op frauduleuze activiteit. Het omvat verschillende methoden:
- Statistische uitschieterdetectie helpt datapunten te vinden die significant afwijken van de rest van de distributie. Verdacht gedrag blijkt vaak uit uitschieters in verschillende metrics, zoals:
- De transactiefrequentie per uur.
- Het aantal postcodes waar een kaart op één dag wordt gebruikt.
- Isolation forests bestaan uit meerdere isolatiebomen. Elke isolatieboom werkt als volgt:
- Kies willekeurig een attribuut van de data en partitioneer datapunten willekeurig op basis van de waarde van dat attribuut.
- Kies voor elke partitie een volgend willekeurig attribuut en partitioneer verder.
- Dit proces gaat iteratief door totdat elk datapunt is geïsoleerd in een partitie met alleen dat punt.
- Er wordt waargenomen dat afwijkende punten met extreme waarden in minder iteraties geïsoleerd worden dan normale datapunten.
- Local outlier factor is een methode om afwijkend gedrag te identificeren door de dichtheid van punten in verschillende delen van de distributie te berekenen.
- Wanneer een dataset met klantgedrag grafisch wordt weergegeven, ontstaan dichte clusters, elk overeenkomend met een klantgroep.
- Elk datapunt (klant) in een cluster vertoont vergelijkbaar, maar niet identiek gedrag. Vaak blijkt dat frauduleuze data ook een cluster vormt dat gescheiden is van de clusters van normale klanten.
Bekijk de cursus Anomaly Detection in Python om deze techniek verder te begrijpen.
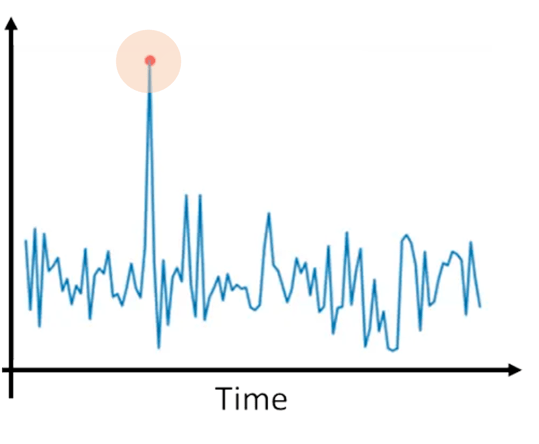
Illustratie van anomaliedetectie. Beeldbron: Understanding AI
Supervised machine learning
Supervised machine learning is een beproefde methode voor anomaliedetectie. Mensen labelen datasets op basis van bekende gevallen van eerder frauduleus gedrag. Vervolgens worden machinelearningalgoritmen getraind op gelabelde datasets om te voorspellen hoe waarschijnlijk het is dat een nieuwe transactie frauduleus is.
- Logistische regressie voorspelt de kans dat een datapunt tot één van twee groepen behoort, zoals legitiem of mogelijk frauduleus.
- Elk punt in de trainingsset is gelabeld als frauduleus of legitiem.
- Tijdens de training leert het model patronen in de features die wijzen op frauduleuze transacties.
- Bij nieuwe data kan het model voorspellen hoe waarschijnlijk het is dat het datapunt frauduleus is.
- Beslisbomen splitsen de dataset recursief in deelsets. Elke knoop splitst datapunten in twee takken volgens de waarden van één bepaald attribuut (zoals transactiefrequentie of maandelijks transactievolume).
- Na een reeks van zulke splitsingen eindigt elke tak in twee bladknopen: frauduleus en legitiem.
- Tijdens de training leert het model de regels per knoop om de dataset te splitsen.
- Het model classificeert elke nieuwe transactie volgens deze regels en voorspelt of die waarschijnlijk frauduleus of legitiem is.
- Random forests bestaan uit meerdere beslisbomen. Een beslisboom past een reeks if…else-voorwaarden toe om te beslissen of een transactie frauduleus is. Deze if…else-voorwaarden zijn gebaseerd op de features van de dataset.
- Elke boom in een random forest wordt onafhankelijk getraind met een willekeurige subset van features om frauduleuze transacties te voorspellen.
- De voorspelling van het bos is gebaseerd op het aggregeren van de uitkomsten van alle individuele bomen.
- Deze aanpak voorkomt overfitting, een veelvoorkomend probleem bij beslisbomen, door subsets van de feature-set te beschouwen.
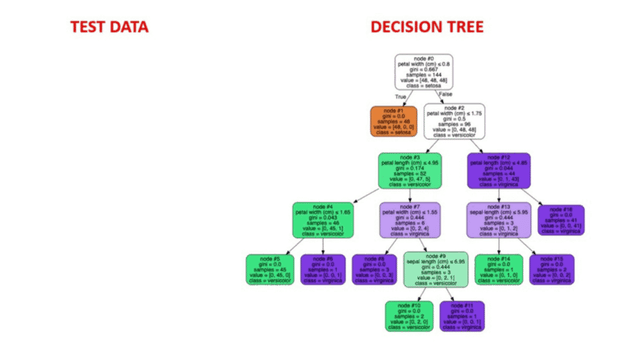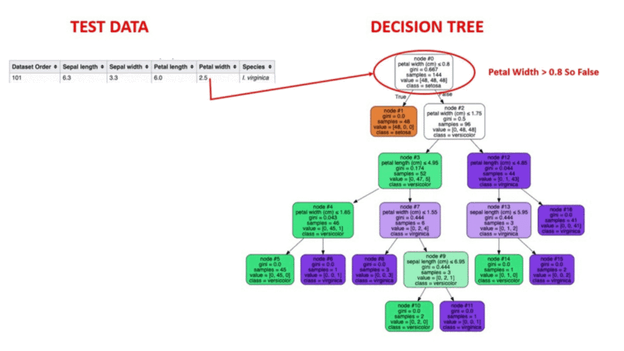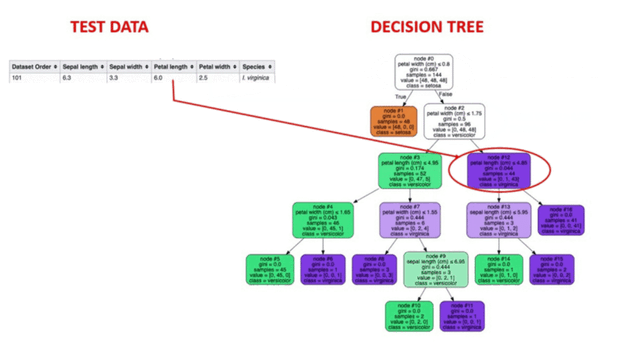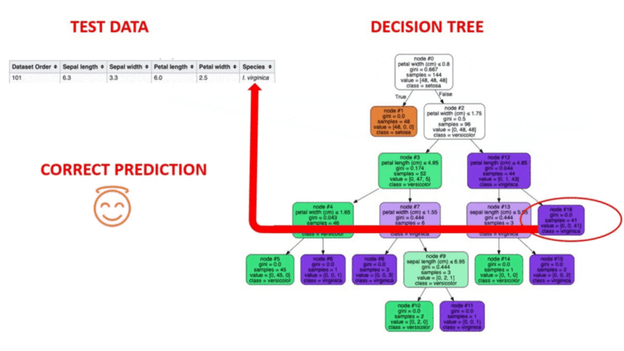
Geanimeerde illustratie van hoe beslisbomen werken. Beeldbron: Supervised Machine Learning
Bekijk het leerpad Supervised Machine Learning in Python om meer over deze technieken te leren.
Unsupervised machine learning
Supervised machinelearningalgoritmen, die voorspellen op basis van eerder gedrag, worden minder effectief naarmate fraudeurs nieuwe methoden aannemen.
Unsupervised machine learning is nuttig om onbekende patronen in de data te voorspellen. Een ander voordeel is dat je geen mensen hoeft in te zetten om grote datasets te labelen. Het algoritme detecteert zelf patronen.
- K-means-clustering groepeert de volledige dataset met transacties in verschillende clusters op basis van de waarden van de datapunten op verschillende attributen.
- Datapunten binnen een cluster hebben vergelijkbare attributen, zoals transactiefrequentie. Frauduleuze transacties vallen vaak niet binnen de andere grote clusters.
- Visueel liggen ze vaak ver van de andere clusters. Mogelijk frauduleuze transacties kunnen worden geïdentificeerd door deze outlier-clusters te analyseren.
- Density-based spatial clustering of applications with noise (DBSCAN) houdt in dat transactiedatasets worden weergegeven in een feature-ruimte. In deze weergave scheiden datapunten zich in hoge- en lagedichtheidsregio's.
- Regio's met hogere dichtheid worden beschouwd als clusters en schaarse regio's als uitschieters.
- Datapunten die in schaarse regio's vallen, worden gemarkeerd als mogelijk frauduleus. Deze worden vervolgens geanalyseerd op verdere aanwijzingen voor verdacht gedrag.
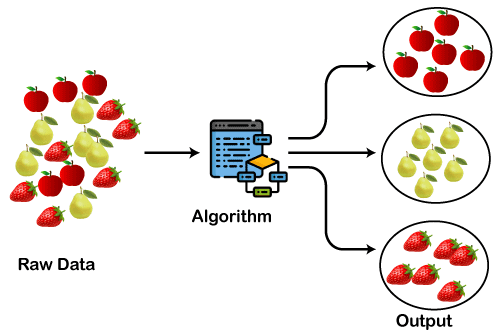
Hoe clustering werkt. Beeldbron: Clustering in Machine Learning
Bekijk de cursus Unsupervised Learning in Python om meer te leren over de genoemde technieken.
Netwerkanalyse
Traditionele methoden voor fraudedetectie via patroonmatching van verdacht gedrag zijn effectief voor individuele accounts. Maar fraudeurs opereren vaak in groepen met een set apparaten, e-mailaccounts en fysieke adressen, waardoor het lastig is om verdacht gedrag te traceren als je een account geïsoleerd bekijkt.
- Frauderingen zijn groepen personen die gecoördineerde aanvallen uitvoeren. Leden kunnen bijvoorbeeld met tien verschillende apparaten en IP-adressen tien opeenvolgende transacties doen. Netwerkanalyse kan relaties tussen verschillende entiteiten detecteren om entiteitsrelatiekaarten te maken en frauderingen te identificeren.
- Entiteitsrelatiekaarten zijn grafiekachtige structuren waarbij de knopen entiteiten voorstellen en de randen hun relaties. Entiteiten kunnen individuen, accounts, e-mailadressen, apparaat-ID's, IP-adressen, fysieke adressen en meer zijn. Relaties tussen entiteiten duiden op gemeenschappelijkheid of soortgelijk gedrag, zoals:
- Diverse IP-adressen die dezelfde gestolen betaalgegevens gebruiken.
- Verschillende accounts die frauduleuze bestellingen plaatsen naar hetzelfde fysieke adres.
Bekijk de cursus Introduction to Network Analysis in Python voor een diepgaander begrip van deze technieken.
Tekstanalyse en natural language processing (NLP)
Veel vormen van fraude, zoals valse verzekeringsclaims, nepbeoordelingen van klanten, phishingmails en dergelijke, zijn gebaseerd op tekst. Door de tekstinhoud te analyseren, vind je vaak aanwijzingen om echte klantactiviteit te onderscheiden van fraude.
- Natural language processing (NLP) omvat technieken zoals sentimentanalyse en named entity recognition (NER). NLP wordt gebruikt in toepassingen zoals:
- Frauduleuze verzekeringsclaims bevatten vaak inconsistenties in de omschrijving. NLP kan tegenstrijdige uitspraken en ongebruikelijke taal identificeren, terwijl NER relaties tussen plaatsen, datums en personen kan aanwijzen.
- Nepbeoordelingen worden vaak door verschillende accounts voor hetzelfde product ingediend of door hetzelfde account voor verschillende producten. Deze reviews bevatten vaak vergelijkbare taal, wat te herkennen is met sentimentanalyse en toondetectie.
- Phishingmails en andere hackpogingen op basis van social engineering volgen vaak vergelijkbare taalpatronen die bedoeld zijn om gevoelige informatie te ontfutselen. Standaard NLP-methoden zijn nuttig om zulke patronen te herkennen en de ontvanger te waarschuwen.
- Tekstmining-algoritmen verwerken grote hoeveelheden ongestructureerde tekst, zoals e-mails, claims en reviews, om veelvoorkomende verdachte taalpatronen en specifieke terminologie te detecteren die vaak bij frauduleuze activiteiten voorkomen.
- De kernveronderstelling bij tekstmining is dat de meeste fraude in een beperkt aantal categorieën valt en wordt uitgevoerd door een relatief kleine groep personen. Daarom is het identificeren van overeenkomsten op basis van patronen in de tekstinhoud een goede methode om pogingen tot fraude te markeren.
Bekijk het vaardigheidspad Natural Language Processing in Python voor een diepere kennismaking met het onderwerp.
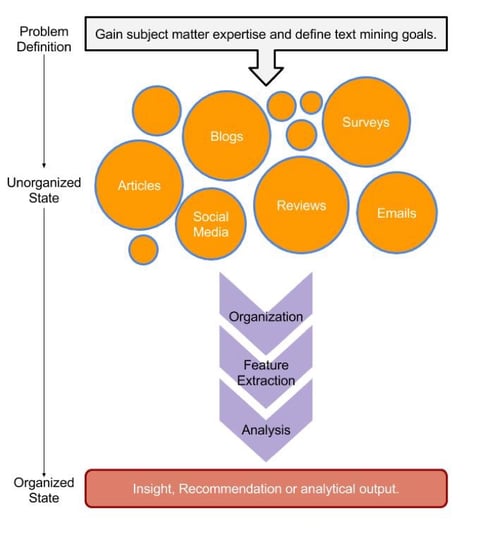
Illustratie van de tekstmining-workflow. Beeldbron: Text Mining with Bag-of-Words in R
Workflow voor fraudedetectie
In deze sectie geven we een hoog-over overzicht van de praktische principes achter het opzetten van workflows voor fraudedetectie.
Dataverzameling
Alle fraudedetectiealgoritmen zijn gebaseerd op het analyseren en identificeren van patronen in grote datasets. Daarom zijn hoogwaardige, relevante en gecureerde datasets, zoals transactie-logs en klantprofielen, cruciaal om deze algoritmen te trainen.
- Transactie-logs worden gebruikt om historische transacties te analyseren en patronen bloot te leggen op basis van details zoals bedragen, volumes, frequentie, IP-adressen, tijdstempels en meer.
- Klantdatabases bevatten adressen, betaalgegevens, browsegeschiedenis, aankoopgeschiedenis, geplaatste reviews, retouren en meer.
- Externe databronnen zijn nuttig om bevindingen op basis van interne datasets te bevestigen en de datakwaliteit te verhogen.
Datavoorbewerking
Na het verzamelen van data is de volgende logische stap deze te gebruiken om modellen voor fraudedetectie te trainen. Ruwe data is meestal ongeschikt voor training. Daarom is het nodig de data te schonen en te normaliseren voordat je die als trainingsset gebruikt. Datavoorbewerking, samen met feature engineering, dekt deze stappen af.
- Dataschoning pakt missende waarden, verkeerd geformatteerde waarden (bijvoorbeeld cijfers als tekst), dubbele records, foutieve waarden en meer aan. Zulke waarden in de dataset laten staan leidt tot slecht getrainde modellen. Dataschoning is dus de eerste stap richting een bruikbare dataset.
- Datanormalisatie houdt in dat numerieke waarden op een uniforme schaal worden uitgedrukt. Het kan ook inhouden dat letterlijke rangen naar numerieke waarden worden vertaald. Dit is vooral belangrijk wanneer databronnen worden samengevoegd tot één grote dataset.
- Feature engineering transformeert beschikbare informatie in nuttigere vormen.
Modeltraining en -evaluatie
Algoritmen voor fraudanalytics zijn in de kern gebaseerd op machinelearningtechnieken. Historische data vormt de basis om machinelearningalgoritmen te trainen. Na het verzamelen en schonen van de data is de volgende stap het trainen van de modellen. Tijdens de training leert het model te voorspellen welke transacties of gebruikersprofielen waarschijnlijker frauduleus zijn.
Naast het markeren van mogelijk frauduleus gedrag is het net zo belangrijk om reguliere gebruikers niet te hinderen. Een false positive is wanneer het model een legitieme transactie als frauduleus markeert. Het minimaliseren van false positives is belangrijk voor een goede klantervaring. Om dit te borgen wordt het getrainde model geëvalueerd met verschillende metrics.
Realtime fraudedetectie
Na het plegen van fraude wordt het steeds moeilijker om de gestolen gelden of goederen terug te krijgen. Het doel is daarom om fraude in realtime te detecteren en te voorkomen voordat de transactie wordt uitgevoerd. Door fraudanalytics te integreren in de transactieverwerking kun je realtime detectie mogelijk maken. Dat kan op twee manieren:
- Data streamen vanuit de transactiepijplijn naar een realtime fraudanalytics-systeem: Event streaming-tools zoals Apache Kafka mogen het verzenden van realtime transactiedata naar fraudanalytics-systemen. Het realtime platform markeert verdachte transacties voor menselijke validatie. De transactiepijplijn ontvangt ook bevestiging van het fraudanalytics-systeem voordat de transactie wordt afgerond.
- Fraudanalytics toepassen binnen de transactiepijplijn: Dit gebeurt met tools zoals Apache Flink. Flink biedt event-time processing op datastromen, wat in de context van fraudanalytics neerkomt op realtime streamverwerking van transactiedata. Het integreert ook met machinelearningmodellen.
Rapportage en monitoring
Stakeholders zoals het management, dataspecialisten, compliance officers, fraude-analisten en securityteams monitoren de resultaten van lopende fraudedetectie. Tools zoals dashboards, realtime meldingen en geautomatiseerde rapporten ondersteunen monitoring en toezicht.
- Dashboards tonen visueel belangrijke metrics, zoals het aantal frauduleuze transacties, de succes- en faalpercentages van de tools, de geleden financiële schade en meer. Dashboards maken het eenvoudig om belangrijke informatie te belichten zonder in detailrapporten te duiken.
- Wanneer de software fraude vermoedt, stuurt het realtime alerts om de verantwoordelijken voor transactiemonitoring te informeren. Alle algoritmische voorspellingen hebben een bepaalde betrouwbaarheidswaarde—vaak is menselijk oordeel essentieel voor besluitvorming. Bovendien zijn in sommige gevallen maatregelen nodig om verdere schade te voorkomen, zoals het blokkeren van transacties op een vermoedelijk gestolen kaart. Realtime updates versnellen zulke processen.
- Geautomatiseerde rapporten verzamelen periodiek informatie over de activiteiten van fraudanalytics-tools. Ze helpen bij het monitoren van hun prestaties en het ingrijpen indien nodig.
- Klantmeldingen informeren klanten wanneer fraude op hun account wordt vermoed. Soms detecteert de software legitieme klantactiviteit onterecht als mogelijk frauduleus. Het is dan nodig om handmatige bevestiging van de klant te krijgen voordat zulke transacties worden verwerkt. In andere gevallen is het cruciaal om de klant te informeren dat zijn account is opgeschort wegens verdachte activiteit en dat heractivatie nodig is.
Tools en platforms voor fraudanalytics
Gezien het belang en de brede toepassingsgebieden van fraudanalytics worden er veel softwareprogramma's gebruikt. Dit omvat zowel open-sourcetools als propriëtaire systemen. In deze sectie geven we een overzicht van de meest gebruikte tools en platforms in fraudanalytics.
Python, SQL en R
Klantdata en transactie-logs worden doorgaans opgeslagen in relationele datastores.
- SQL is een krachtig en flexibel hulpmiddel om relevante datasets te extraheren. Ontwikkelaars kunnen queries schrijven en optimaliseren om datasets op te halen die aan verschillende criteria voldoen. Deze datasets worden geanalyseerd om trends en patronen te ontdekken die mogelijk op fraude wijzen.
- Python is, dankzij het grote ecosysteem aan libraries en de grote ontwikkelaarscommunity, vaak de voorkeurskeuze om diverse analyticsalgoritmen te bouwen en te testen. Algemeen geldt dat Python ook voor veel toepassingen in finance wordt gebruikt.
- Statistische analyse staat centraal in veel methoden voor fraudedetectie. Daarom is R, met zijn grote bibliotheek aan statistische functies, ideaal voor allerlei ad-hocdata-analyses om fraude op te sporen.
Samen bieden Python, SQL en R ontwikkelaars de perfecte toolset om eigen systemen voor fraudanalytics te bouwen. Toch kunnen deze tools moeite hebben met het efficiënt verwerken van zeer grote datasets. De implementatie van analytics-systemen maakt daarom vaak gebruik van andere gespecialiseerde software, zoals Apache Spark (hieronder besproken).
Bovendien zijn tools gebouwd op Python en SQL niet altijd geschikt voor niet-technische doelgroepen zoals fraude-analisten en compliance officers. Geïntegreerde oplossingen op basis van tools van derden, zoals SAS (later besproken), zijn dan gangbaar.
Apache Spark
Veel technieken in fraudanalytics zijn gebaseerd op machinelearningmodellen die zijn getraind op transactie-logs en klantdatasets. Patronen in realtime detecteren vereist het verwerken van grote datavolumes. Creditcardverwerkers verwerken bijvoorbeeld miljoenen transacties per dag. Om een fraudering te detecteren, moet het systeem efficiënt transactiedata van vele dagen kunnen verwerken.
Apache Spark is een open-source gegevensverwerkingsengine die horizontaal schaalt over clusters. Dankzij in-memory computing kan het grote datasets verwerken zonder terug te vallen op batchverwerking.
Spark accepteert inputdata uit meerdere bronnen, zoals Cassandra en Amazon S3. Het biedt ook API's in veel talen, waaronder Python en Java. Het is dus bij uitstek geschikt voor bigdata-use-cases zoals fraudanalytics.
Bekijk de cursus Introduction to PySpark om vandaag nog met deze krachtige verwerkingsengine aan de slag te gaan.
Tableau en Power BI
Fraudanalytics omvat grote datasets en complexe analyses. Visualisaties maken het voor mensen makkelijker en sneller om deze informatie te begrijpen. Tableau en Power BI zijn datavisualisatietools die met verschillende databronnen kunnen koppelen. Ze worden gebruikt voor zowel rapportage als analyse.
- Deze tools maken interactieve dashboards met belangrijke metrics zoals trends, succes- en faalpercentages, schadebedragen en transactievolumes. Visualisaties kunnen deze informatie ook indelen naar fraudetypen en regio's.
- Naast rapportage ondersteunen Power BI en Tableau ook fraudanalyse door informatie over mogelijke frauderingen, netwerkanalyses en verschillende waarschijnlijkheden visueel te presenteren.
- Analisten kunnen met deze tools ook visueel verschillende filters, detectiecriteria en betrouwbaarheidsniveaus instellen. Dit helpt om snel te beslissen of een transactie legitiem of frauduleus is.
Deze tools zijn ontworpen als algemene visualisatietools met specifieke modules en interfaces voor fraudanalytics. Je kunt vandaag beginnen met Power BI via het vaardigheidspad PowerBI Fundamentals.
SAS Fraud Management
SAS is een statistische software-suite van het SAS Institute. Het instituut maakt ook domeinspecifieke pakketten voor uiteenlopende toepassingen, waaronder fraudanalytics.
SAS Fraud Management gebruikt statistische technieken en machinelearningalgoritmen om fraude te voorspellen en te voorkomen. Deze algoritmen zijn geproductiseerd zodat ook mensen zonder ML-achtergrond, zoals fraude-analisten en compliance officers, ML en statistische methoden kunnen inzetten voor fraudedetectie.
H2O.ai
H2O.ai biedt een geautomatiseerde cloudgebaseerde machinelearningdienst. De software van H2O.ai markeert mogelijk frauduleuze activiteiten, scoort de waarschijnlijkheid van fraude en kent een redencode toe om aan te geven waarom het algoritme fraude vermoedt.
Deze aanwijzingen helpen menselijke onderzoekers om dieper te graven en de transactie te verifiëren. In veel gevallen helpen ze ook om legitieme transacties sneller groen licht te geven.
IBM Safer Payments
IBM Safer Payments is een fraudedetectiesysteem dat specifiek op de betaalindustrie is gericht.
Omdat het een NoSQL in-memory database gebruikt, kan het betalingen in realtime monitoren. Het voorkomt fraude in contantloze betaalsystemen, zoals creditcardbetalingen, door transactiestromen in realtime te analyseren en mogelijk frauduleuze transacties te blokkeren voordat ze worden uitgevoerd.
Conclusie
Dit artikel gaf een overzicht van verschillende soorten fraude en de rol van fraudanalytics bij het detecteren en voorkomen ervan. Het besprak technieken die vaak worden gebruikt om potentiële fraudegevallen op te sporen en de workflow voor fraudedetectie. Tot slot introduceerde het een aantal softwaretoepassingen die in dit domein gangbaar zijn.
Wil je leren hoe je met Python systemen voor fraudedetectie bouwt? Volg dan de cursus Fraud Detection in Python. Voor een brede introductie tot Python voor financiële toepassingen, volg de cursus Introduction to Python for Finance. Meer weten over statistische functies in R die worden gebruikt bij fraudedetectie? Volg de cursus Fraud Detection in R.
FAQs
Kan fraudanalytics fraude volledig uitbannen?
Nee, fraudanalytics vermindert fraude aanzienlijk, maar kan het niet volledig uitbannen. Het helpt hoog-risicotransacties te markeren, maar menselijk toezicht blijft nodig.
Hoe gaan bedrijven in realtime om met gemarkeerde transacties?
Gemarkeerde transacties worden vaak beoordeeld door menselijke onderzoekers. Geautomatiseerde systemen kunnen ook verdachte transacties blokkeren in afwachting van verdere beoordeling.
Welke data is cruciaal voor effectieve fraudedetectie?
Belangrijke data zijn transactie-logs, klantprofielen, externe validatiebronnen en apparaatgegevens. Hoogwaardige, schone data verbetert de detectienauwkeurigheid.
Hoe evolueren unsupervised machinelearningmodellen met nieuwe fraudepatronen?
Unsupervised modellen passen zich continu aan nieuw gedrag aan door onbekende patronen en anomalieën te identificeren, waardoor ze effectiever zijn in het detecteren van opkomende fraudemethoden.
Hoe vinden fraudedetectiesystemen een balans tussen snelheid en nauwkeurigheid?
Systemen gebruiken realtime dataverwerkingstools zoals Apache Flink om transacties direct te analyseren, terwijl ze false positives minimaliseren door algoritmen in de tijd te verfijnen.



Een gezonde economie drijft op vertrouwen tussen kopers en verkopers van goederen en diensten. Als dat vertrouwen wordt geschaad, nemen de kosten van zakendoen toe. Onbetrouwbare partijen plegen bedrieglijke transacties om bedrijven te benadelen. Daarnaast zijn er georganiseerde groepen fraudeurs die zich op specifieke sectoren richten.
In dit artikel bespreken we verschillende vormen van fraude die via analytics worden opgespoord en de technieken die worden gebruikt om fraude te detecteren. We behandelen ook gangbare workflows voor fraudedetectie en de softwaretools die vaak worden ingezet voor fraudanalytics.
Ontdek hoe AI impact kan hebben op jouw organisatie en hoe je succesvolle AI-strategieën implementeert met onze whitepaper, The Learning Leader's Guide to AI Literacy.
Wat is fraudanalytics?
Fraudanalytics verwijst naar statistische en machinelearningtechnieken om mogelijk frauduleuze transacties te identificeren en te markeren, meestal in realtime.
Fraude opsporen is lastig omdat:
Bedrijven moeten fraudedetectietools gebruiken die deze mogelijkheden bevatten. Deze tools markeren transacties die zeer waarschijnlijk frauduleus zijn. Menselijke onderzoekers beoordelen de gemarkeerde transacties vervolgens handmatig en nemen de eindbeslissing.
Potentiële fraude detecteren komt neer op het ontdekken van gedrag dat: