
Vai al contenuto principale

Che cos'è la Fraud Analytics? Tecniche, workflow e strumenti

Scopri tecniche, workflow e strumenti di fraud analytics che aiutano le aziende a rilevare e prevenire attività fraudolente in tempo reale, in vari settori.
Aggiornato 29 set 2026  · 15 min leggi

Scopri con l'IA

ChatGPTClaudePerplexity

Un sistema economico sano si basa sulla fiducia tra chi compra e chi vende beni e servizi. Quando questa fiducia si rompe, il costo di fare impresa aumenta. Attori disonesti portano avanti transazioni ingannevoli per truffare le aziende. Esistono anche gruppi sofisticati di truffatori che prendono di mira settori specifici.

In questo articolo, analizziamo diversi tipi di frode individuati tramite analytics e le tecniche utilizzate per rilevarli. Trattiamo anche i tipici workflow di rilevamento frodi e i software comunemente impiegati nella fraud analytics.

Scopri come l'IA può incidere sulla tua organizzazione e come implementare strategie di successo con il nostro whitepaper, The Learning Leader's Guide to AI Literacy.

Che cos'è la Fraud Analytics?

La fraud analytics comprende tecniche statistiche e di machine learning per identificare e segnalare potenziali transazioni fraudolente, di solito in tempo reale. 

Scoprire attività fraudolente è difficile perché: 

  • I truffatori usano varie tecniche per far apparire legittime le loro transazioni. Il venditore ha quindi bisogno di strumenti tecnologici e statistici per rilevare le transazioni potenzialmente fraudolente. 
  • Le transazioni fraudolente rappresentano una piccola percentuale del totale. È quindi necessario un approccio automatizzato per segnalare le operazioni potenzialmente disoneste. 

Le aziende devono usare strumenti di rilevamento frodi che incorporino queste caratteristiche. Questi strumenti segnalano le transazioni con alta probabilità di essere fraudolente. Gli investigatori umani poi analizzano manualmente le operazioni segnalate e prendono la decisione finale. 

Rilevare potenziali frodi significa scoprire comportamenti che: 

  • Corrispondono ad attività fraudolente già note.
  • Deviano in modo significativo dall'intervallo normale.

Tipi comuni di frode rilevati tramite analytics

In questa sezione esploriamo ampie categorie di transazioni fraudolente, con esempi ricorrenti per ciascuna e come usare gli strumenti di analytics per rilevarle e prevenirle.

Frodi finanziarie

Le frodi finanziarie sono probabilmente la forma di frode più nota e diffusa. Le vittime sono in genere gli istituti finanziari e i loro clienti. I colpevoli di solito si spacciano per clienti o per rappresentanti di istituti finanziari. 

Frode con carta di credito è l'uso non autorizzato di una carta per acquistare beni o prelevare contanti a un bancomat. Nella maggior parte dei casi, avviene usando dati di carta rubati. La fraud analytics può aiutare a rilevarla cercando pattern comuni come:

  • Picchi improvvisi nella frequenza e nell'importo delle transazioni.
  • Transazioni successive in più località.

Furto d'identità si verifica quando vengono rubate informazioni personali (come numeri di conto, numeri di documenti, password email, ecc.). Queste informazioni possono essere usate per impersonare la persona e ottenere prestiti, aprire fidi e portare avanti altre grandi operazioni finanziarie. La fraud analytics aiuta segnalando comportamenti sospetti come:

  • Apertura di più conti in poco tempo.
  • Deviazione dal comportamento passato noto dell'individuo.

Frode nei pagamenti è l'uso di mezzi fraudolenti per convincere una persona o un'azienda a effettuare un pagamento per qualcosa che non stanno acquistando. Include:

  • Invio di fatture false alle aziende.
  • Invio di falsi messaggi di autenticazione a più fattori per confermare un pagamento in sospeso.
  • Impersonare il personale della banca per estrarre informazioni riservate sul conto.

Le analytics possono aiutare contro la frode nei pagamenti monitorando e segnalando transazioni che:

  • Deviano significativamente dal comportamento e dall'attività di pagamento abituali del conto.
  • Originano da indirizzi IP e ID dispositivo sospetti.

Frodi assicurative

Le frodi assicurative comprendono il richiedere indennizzi elevati per incidenti minori e pagare premi bassi per polizze rischiose. La vittima è in genere la compagnia assicurativa, mentre i colpevoli si spacciano per clienti o agenti. 

Sinistri fraudolenti riguardano incidenti mai avvenuti. Per rilevarli, gli strumenti di analytics:

  • Verificano gli eventi segnalati, come calamità naturali o incidenti stradali, con altre fonti per confermarne la veridicità.
  • Analizzano pattern nei sinistri presentati da persone specifiche o in determinate località.

Gonfiamento dei sinistri consiste nell'esagerare i danni e l'indennizzo richiesto in incidenti minori. Gli strumenti di fraud analytics possono aiutare a mitigare il gonfiamento dei sinistri:

  • Stimando gli importi tipici dei sinistri per vari tipi di incidenti basandosi sui dati storici.
  • Confrontando l'incidente riportato con gli importi tipici per quel tipo di evento. 

I periti assicurativi verificano manualmente i sinistri potenzialmente gonfiati.

Evasione del premio significa fornire informazioni false alla compagnia per ridurre artificialmente il profilo di rischio e pagare premi più bassi per una determinata polizza. Gli strumenti di fraud analytics possono aiutare a:

  • Validare le informazioni fornite nella proposta di polizza confrontandole con altre fonti. 
  • Rilevare pattern ricorrenti nell'evasione del premio. Ad esempio, se un modello di veicolo comunemente usato per attività commerciali è assicurato per uso personale, gli strumenti lo segnalano per ulteriori verifiche.

Polizze false sono polizze contraffatte create e vendute da truffatori che si fingono agenti assicurativi. Il cliente lo scopre quando presenta un sinistro. Il software di fraud analytics rileva le polizze false:

  • Confrontando i dettagli della polizza archiviati nel sistema con quelli presentati dal cliente. 

Le compagnie hanno anche un dovere verso la società: identificare pattern di polizze false emesse a loro nome. Presentare queste analisi alle forze dell'ordine aiuta a smantellare le reti di polizze fasulle.

Frodi sanitarie

La frode sanitaria può verificarsi in qualsiasi parte del sistema, compresi gli assicuratori pubblici. La vittima è il pagatore, che può essere uno o più tra diversi soggetti:

  • Il paziente
  • Il datore di lavoro del paziente in un regime di co-pay
  • Il governo in sistemi sanitari pubblici
  • La compagnia assicurativa

I colpevoli sono spesso erogatori di servizi sanitari o pazienti. La frode sanitaria si manifesta tipicamente tramite false richieste, inclusa la fatturazione per servizi non erogati e l'upcoding. 

Fatturazione di servizi non erogati indica l'addebito al pagatore di servizi (come test e trattamenti) non effettuati sul paziente. Per rilevare questo tipo di frode, gli strumenti di analytics possono:

  • Usare il riconoscimento di pattern per confrontare le fatture con importi e voci tipicamente addebitati dai pari del settore per disturbi simili.
  • Confrontare i servizi fatturati con i registri dei servizi del fornitore e le cartelle cliniche del paziente.
  • Identificare i fornitori con storici di importi insolitamente elevati e analizzare con attenzione le loro pratiche. 

Upcoding indica la cattiva pratica di fatturare una categoria di servizio più costosa di quella effettivamente erogata. Gli strumenti di fraud analytics usano vari metodi per rilevarlo, ad esempio:

  • Analisi statistica per confrontare il rapporto tra test di routine e test (o trattamenti) costosi con gli standard del settore. Ad esempio, un fornitore che fattura soprattutto visite prolungate e poche visite ordinarie è sospetto.
  • Confronto delle fatture con i registri di pazienti e ospedali, che di solito contengono i dettagli della procedura o del test eseguito.
  • Confronto degli importi fatturati con i dati storici del fornitore per verificare aumenti improvvisi in categorie specifiche soggette a upcoding.

Frodi e-commerce e retail

Molti venditori online sono piccole e medie imprese non necessariamente esperte di tecnologia. Perciò, spetta spesso alle piattaforme e-commerce rilevare e arginare le attività fraudolente. Le frodi e-commerce e retail possono assumere varie forme: 

Account takeover indica la perdita di controllo dell'account da parte dell'utente a favore di truffatori che lo usano per acquisti non autorizzati. Di solito accade per errore dell'utente o scarsa attenzione alla sicurezza, come password e phishing. 

Le piattaforme e-commerce possono rilevare l'account takeover con tecniche come:

  • Analisi comportamentale per cercare deviazioni dal comportamento tipico, come orari di accesso, categorie di acquisto, cronologia di navigazione, ecc.
  • Attività anomale (come molteplici tentativi di accesso falliti) combinate a cambiamenti nelle impostazioni dell'account (come email e indirizzi di consegna). 

Resi fraudolenti avvengono quando attori malevoli restituiscono articoli diversi da quelli acquistati, ad esempio ordinano un prodotto costoso e restituiscono un falso. Include anche il reso di prodotti usati non rivendibili. Per proteggersi, la fraud analytics può:

  • Analizzare i pattern di reso per identificare acquirenti che restituiscono spesso gli articoli.
  • Confrontare l'acquisto originale per verificare che l'articolo restituito sia lo stesso acquistato.
  • Assicurarsi che l'articolo restituito sia in condizioni di non utilizzo. 

Acquisti fraudolenti implicano transazioni non autorizzate usando dati di pagamento rubati o falsi e account compromessi. Possono causare perdite sia ai venditori che ai compratori inconsapevoli. La fraud analytics può segnalare acquisti potenzialmente fraudolenti monitorando le transazioni per identificare pattern come:

  • Accessi frequenti da più account effettuati dallo stesso indirizzo IP.
  • Prove di numeri di carte diverse in rapida successione.
  • Acquisti insolitamente elevati rispetto alla cronologia dell'account.

Chargeback fraud consiste nell'abusare della politica di chargeback della carta per ottenere rimborsi su acquisti legittimi. La fraud analytics può proteggere dal chargeback fraud usando:

  • Riconoscimento dei pattern per identificare utenti che effettuano chargeback frequenti.
  • Machine learning per rilevare comportamenti sospetti come acquisti multipli in rapida successione, soprattutto con account nuovi e dettagli di pagamento aggiornati di recente. 

Tecniche usate nella Fraud Analytics

Gli strumenti di fraud analytics usano un insieme comune di tecniche, adattandole a contesti, dataset e comportamenti dei truffatori specifici di ciascun dominio. 

Tutti i metodi di fraud analytics hanno due obiettivi chiave: 

  • Rilevare e prevenire le frodi
  • Agevolare i clienti genuini

Rilevamento anomalie

I truffatori spesso mostrano comportamenti molto diversi dai clienti legittimi. Il rilevamento delle anomalie aiuta a individuare comportamenti inusuali che indicano possibili attività fraudolente. Comprende una gamma di metodi: 

  • Rilevamento statistico degli outlier aiuta a identificare punti dati significativamente diversi dal resto della distribuzione. Il comportamento sospetto è spesso indicato da outlier in varie metriche, come:
    • La frequenza delle transazioni per ora.
    • Il numero di CAP in cui una carta viene strisciata in un giorno. 
  • Isolation forest consiste in più alberi di isolamento. Ogni albero di isolamento funziona così:
    • Scegli casualmente un attributo dei dati e partiziona casualmente i punti in base al valore di quell'attributo. 
    • Per ogni partizione, scegli un altro attributo casuale e partiziona ulteriormente.
    • Questo processo continua iterativamente finché ogni punto dati è isolato in una partizione che contiene solo quel punto.
    • Si osserva che i punti anomali con valori estremi vengono isolati (in partizioni individuali) in meno iterazioni rispetto ai punti normali.
  • Local Outlier Factor è un metodo per identificare comportamenti anomali calcolando la densità dei punti in varie aree della distribuzione. 
    • Quando un dataset di comportamenti dei clienti è rappresentato graficamente, forma cluster densi, ognuno corrispondente a un gruppo di clienti.
    • Ogni punto dati (cliente) in un cluster mostra comportamenti simili, ma non identici. Spesso si osserva che anche i dati fraudolenti formano un cluster separato dai cluster dei clienti normali.

Dai un'occhiata al corso Anomaly Detection in Python per approfondire questa tecnica.
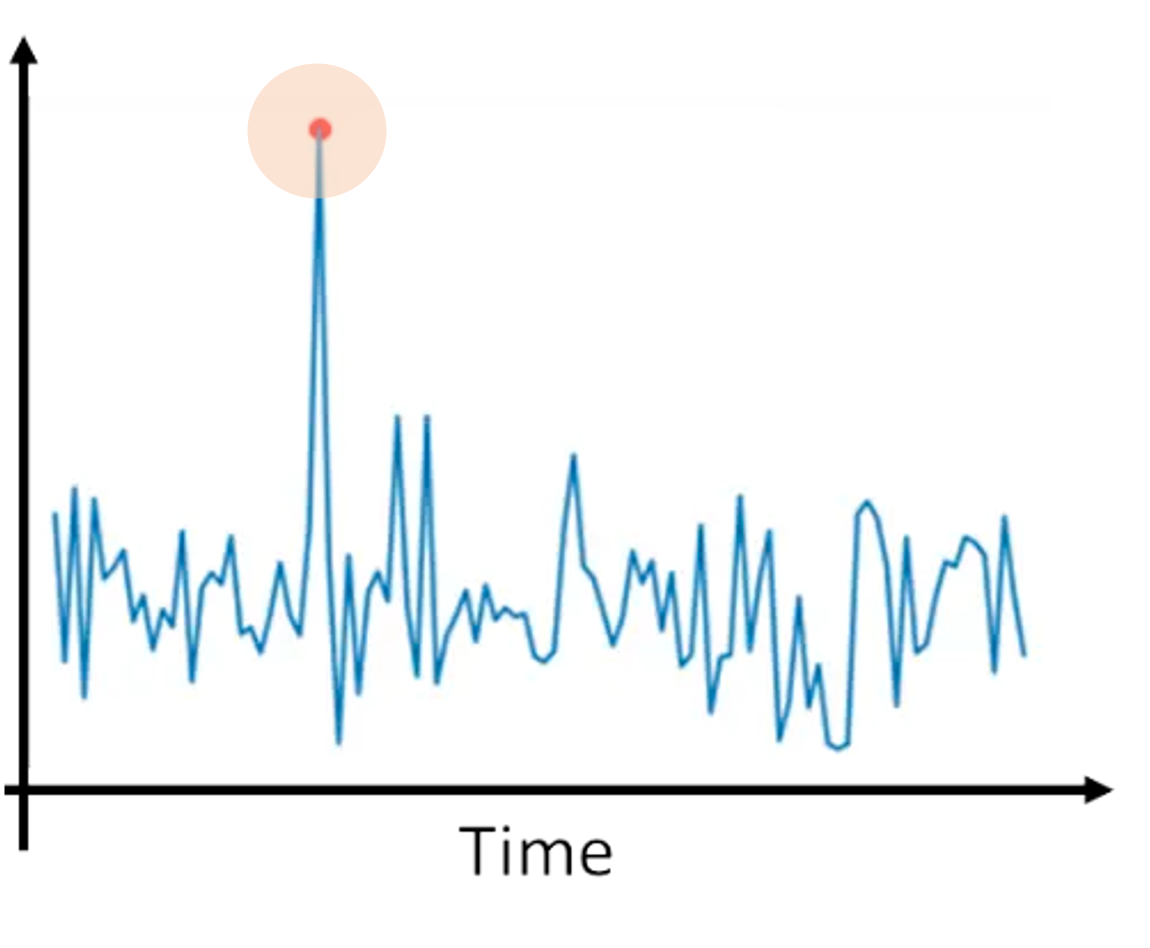
Illustrazione del rilevamento delle anomalie

Illustrazione del rilevamento delle anomalie. Fonte immagine: Understanding AI

Machine learning supervisionato

Il machine learning supervisionato è un metodo consolidato di rilevamento anomalie. Gli esseri umani etichettano i dataset in base a casi noti di comportamenti fraudolenti passati. Gli algoritmi di machine learning vengono quindi addestrati su dataset etichettati per prevedere la probabilità che una nuova transazione sia fraudolenta.
  • Regressione logistica predice la probabilità che un punto dati appartenga a uno di due gruppi, ad esempio genuino o potenzialmente fraudolento. 
    • Ogni punto nel dataset di training è etichettato come fraudolento o genuino. 
    • Durante l'addestramento, il modello apprende pattern nelle feature che indicano transazioni fraudolente. 
    • Con nuovi dati, il modello può prevedere la probabilità che il punto sia fraudolento.
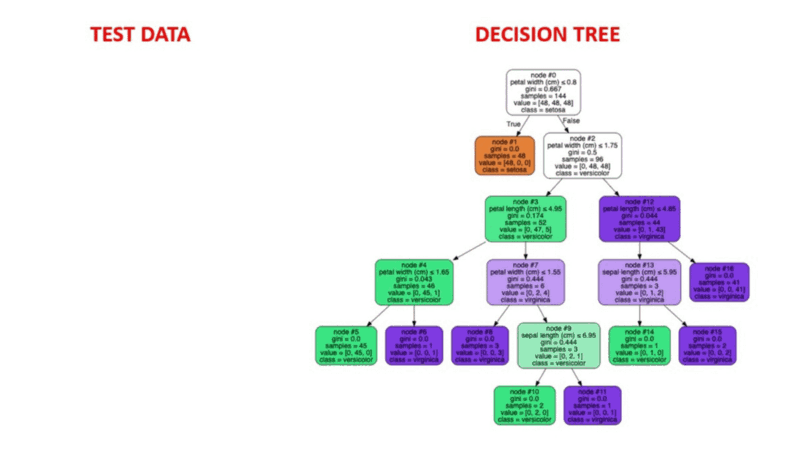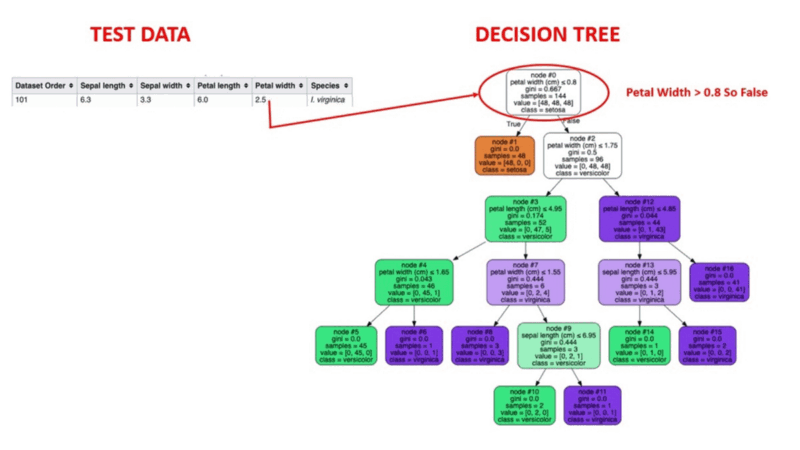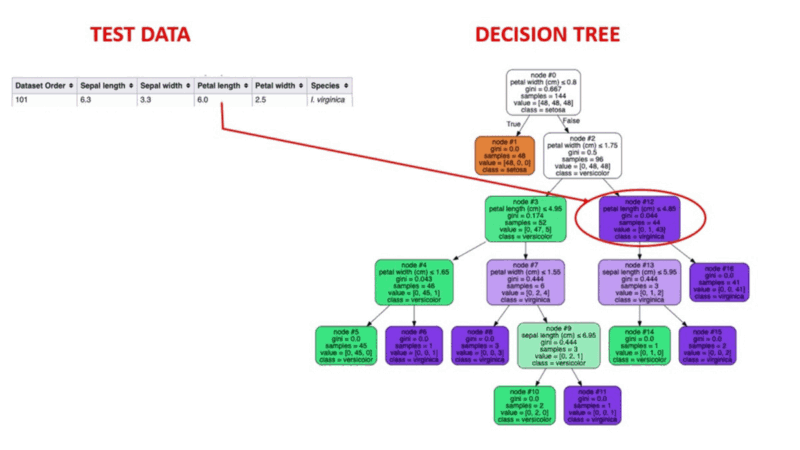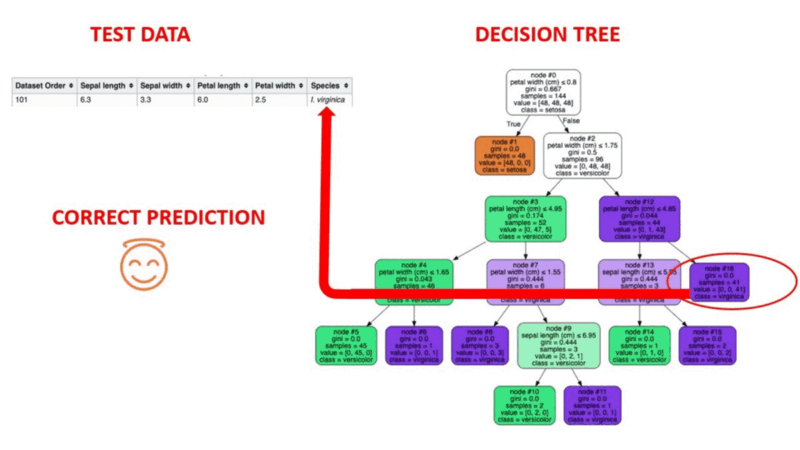
  • Decision tree dividono ricorsivamente il dataset in sottoinsiemi. Ogni nodo separa i punti dati in due rami in base ai valori di un attributo specifico (come frequenza o volume mensile delle transazioni). 
    • Dopo una serie di divisioni, ogni ramo termina in due foglie: fraudolento e genuino. 
    • Durante l'addestramento, il modello apprende le regole per ciascun nodo per dividere il dataset. 
    • Il modello classifica ogni nuova transazione secondo queste regole e predice se sia probabilmente fraudolenta o genuina. 
  • Random forest sono composte da più decision tree. Un decision tree applica una serie di condizioni if…else per decidere se una transazione sia fraudolenta. Queste condizioni if…else si basano sulle feature del dataset. 
    • Ogni albero in una random forest è addestrato in modo indipendente usando un sottoinsieme casuale di feature per prevedere le transazioni fraudolente. 
    • La previsione della foresta si basa sull'aggregazione dell'output di tutti gli alberi individuali. 
    • Questo approccio evita il problema dell'overfitting tipico dei decision tree considerando sottoinsiemi del set di feature. 

Illustrazione animata di come funzionano i decision tree

Illustrazione animata di come funzionano i decision tree. Fonte immagine: Supervised Machine Learning

Consulta il percorso Supervised Machine Learning in Python per saperne di più su queste tecniche.

Machine learning non supervisionato

Gli algoritmi supervisionati, che prevedono in base a comportamenti passati, diventano meno efficaci quando i truffatori adottano nuovi metodi.

Il machine learning non supervisionato è utile per prevedere pattern sconosciuti nei dati. Un altro vantaggio è che non serve impiegare risorse umane per etichettare grandi dataset. L'algoritmo rileva i pattern in autonomia.
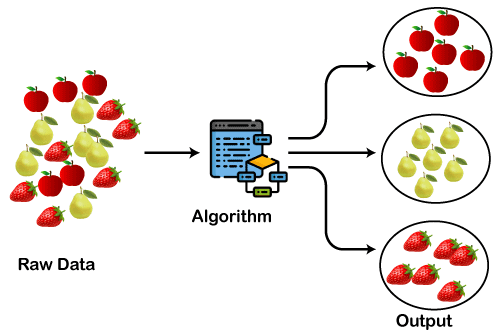
  • K-means clustering raggruppa l'intero dataset di transazioni in diversi cluster in base ai valori dei punti dati rispetto a diversi attributi. 
    • I punti dati all'interno di ciascun cluster hanno attributi simili, come la frequenza delle transazioni. Si osserva che le transazioni fraudolente non rientrano negli altri cluster principali. 
    • Visivamente, tendono a essere molto lontane dagli altri cluster. Le transazioni potenzialmente fraudolente si identificano analizzando questi cluster outlier. 
  • DBSCAN (Density-Based Spatial Clustering of Applications with Noise) prevede di rappresentare i dataset di transazioni in uno spazio delle feature. In questa rappresentazione, i punti dati si separano in regioni ad alta e bassa densità. 
    • Le regioni ad alta densità sono considerate cluster, e le regioni sparse sono considerate outlier. 
    • I punti dati che cadono in regioni sparse vengono segnalati come potenzialmente fraudolenti. Vengono poi analizzati per ulteriori evidenze di attività sospette.

Illustrazione del clustering nel machine learning

Come funziona il clustering. Fonte immagine: Clustering in Machine Learning

Consulta il corso Unsupervised Learning in Python per approfondire le tecniche citate.

Analisi di rete

I metodi tradizionali di rilevamento frodi tramite pattern sospetti sono efficaci per i singoli account. Tuttavia, i truffatori spesso operano in gruppi di individui usando insiemi di dispositivi, account email e indirizzi fisici, rendendo difficile tracciare i comportamenti sospetti quando si considera un account isolatamente. 

  • Fraud ring sono gruppi di persone che compiono attacchi coordinati. Ad esempio, i membri del gruppo possono usare dieci dispositivi e IP diversi per effettuare dieci transazioni successive. L'analisi di rete può rilevare relazioni tra varie entità per creare mappe delle relazioni e identificare i fraud ring. 
  • Mappe delle relazioni tra entità sono strutture simili a grafi, con nodi che rappresentano le entità e archi che rappresentano le loro relazioni. Le entità possono essere individui, account, email, ID dispositivo, indirizzi IP, indirizzi fisici e altro. Le relazioni tra entità indicano elementi in comune o comportamenti simili, come:
    • Diversi indirizzi IP che usano gli stessi dettagli di pagamento rubati.
    • Diversi account che effettuano ordini fraudolenti allo stesso indirizzo fisico.

Consulta il corso Introduction to Network Analysis in Python per comprendere più a fondo queste tecniche. 

Text mining e NLP (natural language processing)

Molte forme di frode, come i falsi sinistri assicurativi, le recensioni fasulle, le email di phishing e simili, si basano su testi. Analizzarne il contenuto testuale spesso fornisce indizi per distinguere l'attività genuina dai tentativi di frode. 

  • Natural language processing (NLP) comprende tecniche come analisi del sentiment e named entity recognition (NER). L'NLP è usato in applicazioni come:
    • I sinistri fraudolenti spesso contengono incoerenze nella descrizione. L'NLP può identificare affermazioni contraddittorie e linguaggio inusuale, mentre la NER può evidenziare relazioni tra luoghi, date e persone. 
    • Le recensioni fasulle sono spesso inviate da vari account per lo stesso prodotto o dallo stesso account per vari prodotti. Tendono a contenere linguaggio simile, identificabile tramite analisi del sentiment e rilevamento del tono. 
    • Email di phishing e altri tentativi di hacking basati sull'ingegneria sociale seguono spesso schemi linguistici simili pensati per estrarre informazioni sensibili dal destinatario. Metodi NLP standard sono utili per identificare tali pattern e avvisare il destinatario. 
  • Text mining algoritmi elaborano grandi volumi di testo non strutturato, come email, sinistri e recensioni, per rilevare occorrenze comuni di linguaggi sospetti e terminologie specifiche ricorrenti nelle attività fraudolente.
    • L'assunto alla base del text mining è che la maggior parte delle frodi rientri in un numero limitato di categorie ed è messa in atto da un gruppo ristretto di individui. Pertanto, individuare le comunanze cercando pattern nel testo è un metodo valido per segnalare potenziali tentativi di frode. 

Consulta il percorso Natural Language Processing in Python per una comprensione più approfondita dell'argomento.
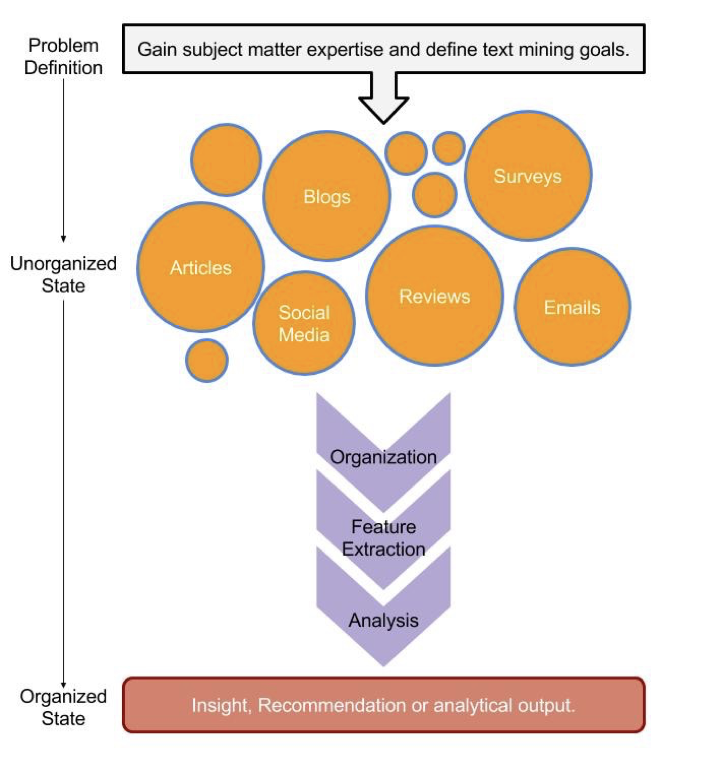
Illustrazione del workflow di text mining

Illustrazione del workflow di text mining. Fonte immagine: Text Mining with Bag-of-Words in R

Workflow di rilevamento frodi

In questa sezione, forniamo una panoramica di alto livello dei principi pratici per implementare workflow di rilevamento frodi.

Raccolta dati

Tutti gli algoritmi di rilevamento frodi si basano sull'analisi e l'identificazione di pattern osservati in grandi dataset. Perciò, dataset di qualità, pertinenti e curati come i log delle transazioni e i profili dei clienti sono cruciali per addestrare questi algoritmi. 

  • Log delle transazioni servono per analizzare le operazioni storiche e scoprire pattern basati su dettagli come importi, volumi, frequenza, indirizzi IP, timestamp e altro. 
  • Database clienti contengono indirizzi, dettagli di pagamento, cronologie di navigazione e di acquisto, recensioni lasciate, resi e altro.
  • Fonti dati di terze parti sono utili per confermare osservazioni basate su dataset interni e migliorare la qualità dei dati.

Preprocessing dei dati

Dopo aver raccolto i dati, il passo successivo è usarli per addestrare i modelli di rilevamento frodi. I dati grezzi sono in genere inadatti all'addestramento. È quindi necessario pulirli e normalizzarli prima di usarli come dataset di training. Il preprocessing dei dati, insieme alla feature engineering, copre questi passaggi.

  • Data cleaning tratta valori mancanti, formati errati (ad esempio numeri come testo), record duplicati, valori sbagliati e altro. Lasciare tali valori nel dataset porta a un modello addestrato male. Il data cleaning è quindi il primo passo per garantire un dataset utilizzabile. 
  • Normalizzazione significa esprimere i valori numerici su una scala uniforme. Può includere anche la traduzione di ranghi alfabetici in valori numerici. È particolarmente importante quando si combinano più fonti in un dataset più ampio.
  • Feature engineering trasforma le informazioni disponibili in forme più utili.

Addestramento e valutazione dei modelli

Gli algoritmi di fraud analytics sono, alla base, costruiti su tecniche di machine learning. I dati storici sono la base per addestrare gli algoritmi di machine learning. Dopo aver raccolto e pulito i dati, il passo successivo è addestrare i modelli. Durante l'addestramento, il modello impara a prevedere quali transazioni o profili utente hanno maggiore probabilità di essere fraudolenti. 

Oltre a segnalare comportamenti potenzialmente fraudolenti, è altrettanto importante non ostacolare gli utenti regolari. Un falso positivo si verifica quando il modello segnala come fraudolenta una transazione genuina. Ridurre i falsi positivi è fondamentale per mantenere una buona esperienza utente. Per questo, il modello addestrato viene valutato con varie metriche.

Rilevamento frodi in tempo reale

Dopo che una frode è stata commessa, recuperare fondi o beni diventa sempre più difficile. L'obiettivo è quindi rilevare e prevenire la frode in tempo reale, prima che la transazione sia eseguita. Integrare la fraud analytics nella pipeline di elaborazione delle transazioni abilita il rilevamento in tempo reale. Ci sono due modi per farlo: 

  • Inviare in streaming i dati dalla pipeline di transazione a un sistema di fraud analytics in tempo reale: Gli strumenti di event streaming come Apache Kafka consentono di trasmettere i dati delle transazioni in tempo reale ai sistemi di fraud analytics. La piattaforma segnala le transazioni sospette per la validazione umana. La pipeline di elaborazione riceve inoltre conferma dal sistema di analytics prima di finalizzare la transazione.
  • Applicare la fraud analytics all'interno della pipeline di elaborazione: si fa con strumenti come Apache Flink. Flink offre elaborazione in event-time su stream di dati, che nel contesto della fraud analytics è chiamata elaborazione in tempo reale dei flussi di transazioni. Si integra anche con modelli di machine learning.

Reportistica e monitoraggio

Stakeholder come management, data scientist, responsabili compliance, analisti antifrode e team di sicurezza monitorano i risultati degli sforzi in corso. Strumenti come dashboard, avvisi in tempo reale e report automatizzati facilitano monitoraggio e supervisione. 

  • Dashboard mostrano visivamente metriche importanti, come numero di transazioni fraudolente, tassi di successo e insuccesso degli strumenti di analytics, perdite monetarie e altro. Rendono facile evidenziare le informazioni chiave senza dover leggere report dettagliati. 
  • Quando il software sospetta attività fraudolente, invia avvisi in tempo reale per informare chi è incaricato del monitoraggio. Tutte le previsioni algoritmiche hanno un certo livello di confidenza—spesso il giudizio umano è essenziale. Inoltre, in alcuni casi servono misure correttive per prevenire ulteriori danni, come bloccare le transazioni su una carta sospetta di furto. Gli aggiornamenti in tempo reale accelerano questi processi. 
  • Report automatizzati raccolgono periodicamente informazioni sulle attività degli strumenti di fraud analytics. Facilitano il monitoraggio delle performance e l'intervento quando necessario.
  • Notifiche ai clienti informano i clienti quando si sospetta attività fraudolenta sui loro account. A volte, il software rileva erroneamente come fraudolente attività legittime: è necessario ottenere una conferma manuale dal cliente prima di procedere. In altri casi, è fondamentale informare il cliente che il suo account è stato sospeso per attività sospetta e che deve riattivarlo. 

Strumenti e piattaforme per la Fraud Analytics

Dato il peso e la diffusione della fraud analytics, in questo campo si usano molti software, sia open-source sia proprietari. In questa sezione forniamo una panoramica degli strumenti e piattaforme più comuni.

Python, SQL e R

I dati dei clienti e i log delle transazioni sono in genere archiviati in archivi relazionali. 

  • SQL è uno strumento potente e flessibile per estrarre dataset pertinenti. Consente di scrivere e ottimizzare query per recuperare dataset che soddisfano vari criteri. Questi dataset vengono analizzati per scoprire tendenze e pattern che indicano possibili attività fraudolente. 
  • Python, grazie al suo vasto ecosistema di librerie e alla grande community, è spesso lo strumento preferito per costruire e testare vari algoritmi di analytics. Più in generale, Python è usato anche in molte applicazioni finanziarie. 
  • L'analisi statistica è al cuore di molti metodi di rilevamento frodi. R, con la sua ampia libreria di funzioni statistiche, è quindi ideale per vari tipi di analisi ad hoc per scoprire frodi. 

Insieme, Python, SQL e R forniscono agli sviluppatori il set di strumenti perfetto per costruire sistemi personalizzati di fraud analytics. Tuttavia, possono incontrare difficoltà nel processare in modo efficiente grandi dataset. L'implementazione di sistemi di analytics spesso usa altri software specializzati come Apache Spark (vedi sotto).

Inoltre, strumenti basati su Python e SQL potrebbero non essere adatti a pubblici non tecnici come analisti antifrode e responsabili compliance. È comune fornire soluzioni integrate costruite con strumenti di terze parti come SAS (vedi più avanti).

Apache Spark

Molte tecniche di fraud analytics si basano su algoritmi di machine learning addestrati su log di transazioni e dataset dei clienti. Rilevare pattern in tempo reale richiede l'elaborazione di volumi elevati di dati. Ad esempio, i processori di carte di credito gestiscono milioni di transazioni al giorno. Per rilevare un fraud ring, il sistema deve elaborare in modo efficiente molti giorni di dati.

Apache Spark è un motore open-source di elaborazione dati che scala orizzontalmente su cluster. Grazie al computing in memoria, può gestire grandi dataset senza ricorrere al batch processing. 

Accetta dati in input da molte fonti, come Cassandra e Amazon S3. Offre API in diversi linguaggi, tra cui Python e Java. È quindi particolarmente adatto a casi d'uso di big data come la fraud analytics. 

Consulta il corso Introduction to PySpark per imparare oggi stesso questo potente linguaggio di elaborazione dati.

Tableau e Power BI

La fraud analytics coinvolge grandi dataset e analisi complesse. Le visualizzazioni rendono più semplice e rapido comprendere queste informazioni. Tableau e Power BI sono strumenti di data visualization che si collegano a varie fonti dati. Si usano sia per reportistica sia per analisi. 

  • Questi strumenti creano dashboard interattive per riportare metriche importanti come trend, tassi di successo e insuccesso, importi delle perdite e volumi di transazioni. Le visualizzazioni possono anche categorizzare le informazioni per tipo di frode e area geografica. 
  • Oltre alla reportistica, Power BI e Tableau agevolano l'analisi delle frodi presentando visivamente informazioni su potenziali fraud ring, analisi di rete e varie probabilità.
  • Consentono anche di controllare visivamente filtri, criteri di rilevamento e livelli di confidenza, aiutando a decidere rapidamente se una transazione è genuina o fraudolenta. 

Questi strumenti sono progettati come soluzioni di visualizzazione generiche con moduli e interfacce specifiche per la fraud analytics. Puoi iniziare a imparare PowerBI oggi seguendo il percorso PowerBI Fundamentals.

SAS Fraud Management

SAS è una suite di software statistico sviluppata dal SAS Institute, che realizza anche pacchetti specifici per vari domini, inclusa la fraud analytics. 

SAS Fraud Management usa tecniche statistiche e algoritmi di machine learning per prevedere e prevenire le frodi. Questi algoritmi sono resi fruibili in prodotto in modo che figure come analisti antifrode e responsabili compliance, anche senza background in ML, possano usare metodi statistici e di ML per il rilevamento.

H2O.ai

H2O.ai offre un servizio di machine learning automatizzato basato su cloud. Il software di H2O.ai segnala attività potenzialmente fraudolente, attribuisce un punteggio di probabilità e un codice motivo per indicare perché l'algoritmo sospetta una frode. 

Queste indicazioni aiutano gli investigatori a approfondire per verificare la transazione. In molti casi, aiutano anche ad approvare rapidamente le operazioni genuine.

IBM Safer Payments

IBM Safer Payments è un sistema di rilevamento frodi rivolto specificamente all'industria dei pagamenti. 

Poiché usa un database NoSQL in memoria, può monitorare i pagamenti in tempo reale. Previene le frodi nei sistemi di pagamento cashless, come i pagamenti con carta, analizzando i flussi di transazioni in tempo reale e bloccando le operazioni potenzialmente fraudolente prima dell'esecuzione.

Conclusione

Questo articolo ha fornito una panoramica dei diversi tipi di frode e del ruolo della fraud analytics nel rilevarli e prevenirli. Ha esaminato le tecniche comunemente usate per individuare i casi potenziali e il workflow di rilevamento. Infine, ha presentato alcune applicazioni software comunemente impiegate in questo ambito.

Per imparare a costruire sistemi di rilevamento frodi con Python, segui il corso Fraud Detection in Python. Per un'introduzione ampia a Python per la finanza, segui il corso Introduction to Python for Finance. Per saperne di più sulle funzioni statistiche in R usate nelle applicazioni di rilevamento frodi, segui il corso Fraud Detection in R.

FAQ

La fraud analytics può eliminare completamente le frodi?

No, la fraud analytics riduce significativamente le frodi ma non può eliminarle del tutto. Aiuta a segnalare le transazioni ad alto rischio, ma serve comunque il controllo umano.

Come gestiscono le aziende le transazioni segnalate in tempo reale?

Le transazioni segnalate vengono spesso revisionate da investigatori umani. I sistemi automatizzati possono anche bloccarle in attesa di ulteriori verifiche.

Quali dati sono cruciali per un rilevamento efficace delle frodi?

I dati chiave includono log delle transazioni, profili clienti, fonti di validazione di terze parti e dati dei dispositivi. Dati di alta qualità e puliti migliorano l'accuratezza del rilevamento.

Come evolvono i modelli non supervisionati con i nuovi pattern di frode?

I modelli non supervisionati si adattano continuamente a nuovi comportamenti identificando pattern sconosciuti e anomalie, risultando più efficaci nel rilevare metodi emergenti di frode.

Come bilanciano velocità e accuratezza i sistemi di rilevamento frodi?

I sistemi usano strumenti di elaborazione dati in tempo reale come Apache Flink per analizzare istantaneamente le transazioni, minimizzando i falsi positivi perfezionando gli algoritmi nel tempo.


Arun Nanda's photo
Author
Arun Nanda
LinkedIn

Arun è un ex fondatore di startup a cui piace creare cose nuove. Attualmente sta esplorando le basi tecniche e matematiche dell’Intelligenza Artificiale. Ama condividere ciò che ha imparato, quindi ne scrive.

Oltre a DataCamp, puoi leggere i suoi articoli su Medium, Airbyte e Vultr.

Argomenti
Analisi dei dati
Machine Learning

Approfondisci analytics e machine learning con questi corsi!

Corso

Capire il Machine Learning

2 ore
311.4K
Un'introduzione all'apprendimento automatico senza bisogno di programmare.
Vedi i dettagliRight Arrow
Inizia Il Corso
Mostra altroRight Arrow
Correlato

blog

Che cos'è Snowflake? Guida per principianti alla piattaforma dati cloud

Esplora le basi di Snowflake, la piattaforma dati cloud. Scopri la sua architettura, le sue funzionalità e come integrarla nelle tue pipeline di dati.
Tim Lu's photo

Tim Lu

12 min

blog

Tokenizzazione nel NLP: come funziona, sfide e casi d'uso

Guida al preprocessing NLP nel machine learning. Copriamo spaCy, i transformer di Hugging Face e come funziona la tokenizzazione in casi d'uso reali.
Abid Ali Awan's photo

Abid Ali Awan

10 min

blog

I 15 migliori server MCP remoti che ogni AI builder dovrebbe conoscere nel 2026

Scopri i 15 migliori server MCP remoti che stanno trasformando lo sviluppo AI nel 2026. Scopri come migliorano automazione, ragionamento, sicurezza e velocità dei workflow.
Abid Ali Awan's photo

Abid Ali Awan

15 min

Mostra AltroMostra Altro

